


Sehen Sie sich die Datenherkunft an, um die Beziehungen zwischen den Ressourcen Ihres Projekts und den Prozessen, die sie erstellt haben, zu verstehen. Diese Beziehungen zeigen, wie Daten-Assets wie Tabellen und Datasets durch Prozesse wie Abfragen und Pipelines transformiert werden. In diesem Leitfaden wird beschrieben, wie Sie Details zur Datenherkunft in der Google Cloud Console aufrufen oder mit der Data Lineage API abrufen.
Rollen und Berechtigungen
Die Datenherkunft verfolgt Herkunftsinformationen automatisch, wenn Sie die Data Lineage API aktivieren. Sie benötigen keine Administrator- oder Bearbeiterrollen, um die Herkunft Ihrer Daten-Assets zu erfassen.
Zum Aufrufen der Datenherkunft benötigen Sie bestimmte IAM-Berechtigungen (Identity and Access Management). Herkunftsinformationen werden projektübergreifend erfasst. Sie benötigen daher Berechtigungen in mehreren Projekten.
Wenn Sie die Datenherkunft in Knowledge Catalog, BigQuery oder Vertex AI aufrufen, benötigen Sie Berechtigungen zum Aufrufen von Datenherkunftsinformationen in dem Projekt, in dem Sie sie aufrufen.
Wenn Sie die Datenherkunft ansehen, die in anderen Projekten aufgezeichnet wurde, benötigen Sie Berechtigungen zum Ansehen von Datenherkunftsinformationen in den Projekten, in denen sie aufgezeichnet wurde.
Bitten Sie Ihren Administrator, Ihnen die folgenden IAM-Rollen zuzuweisen, um die Berechtigungen zu erhalten, die Sie zum Aufrufen der Datenherkunft benötigen:
-
Alle: Data Lineage-Betrachter (
roles/datalineage.viewer) für das Projekt, in dem die Datenherkunft aufgezeichnet wird, und das Projekt, in dem die Datenherkunft angezeigt wird -
BigQuery-Tabellendetails ansehen:
BigQuery-Metadatenbetrachter (
roles/bigquery.metadataViewer) für das Speicherprojekt der Tabelle -
BigQuery-Jobdetails ansehen:
BigQuery Resource Viewer (
roles/bigquery.resourceViewer) für das Compute-Projekt des Jobs -
Details zu anderen katalogisierten Assets aufrufen:
Dataplex Catalog Viewer (
roles/dataplex.catalogViewer) für das Projekt, in dem Katalogeinträge gespeichert sind
Weitere Informationen zum Zuweisen von Rollen finden Sie unter Zugriff auf Projekte, Ordner und Organisationen verwalten.
Diese vordefinierten Rollen enthalten die Berechtigungen, die zum Aufrufen der Datenherkunft erforderlich sind. Maximieren Sie den Abschnitt Erforderliche Berechtigungen, um die notwendigen Berechtigungen anzuzeigen:
Erforderliche Berechtigungen
Die folgenden Berechtigungen sind erforderlich, um die Datenherkunft aufzurufen:
-
BigQuery-Tabellendetails ansehen:
bigquery.tables.get– das Speicherprojekt der Tabelle -
BigQuery-Jobdetails aufrufen:
bigquery.jobs.get– das Compute-Projekt des Jobs
Sie können diese Berechtigungen auch mit benutzerdefinierten Rollen oder anderen vordefinierten Rollen erhalten.
Arten von Datenherkunftsansichten
Sie können Herkunftsinformationen als interaktives Diagramm oder als strukturierte Liste in der Google Cloud Console aufrufen.
Eine detaillierte Beschreibung der Diagrammelemente (z. B. Knoten, Kanten, Prozesssymbole und Labels) und der in den Listenansichten verfügbaren Spalten finden Sie unter Informationen zur Visualisierung der Datenherkunft in Knowledge Catalog.
Datenherkunft aktivieren
Aktivieren Sie die Datenherkunft, um automatisch Herkunftsinformationen für unterstützte Systeme zu erfassen. Wenn Sie die API aktivieren, wird standardmäßig das Herkunfts-Tracking für die meisten unterstützten Dienste aktiviert. Weitere Informationen finden Sie unter Automatisches Datenherkunfts-Tracking und Informationen zur Steuerung der Datenherkunftsaufnahme.
Die Data Lineage API wird unter der Knowledge Catalog Premium Processing-SKU abgerechnet. Weitere Informationen finden Sie unter Knowledge Catalog – Preise.
Sie müssen die Data Lineage API sowohl in dem Projekt, in dem Sie die Datenherkunft ansehen, als auch in den Projekten, in denen die Datenherkunft aufgezeichnet wird, aktivieren. Weitere Informationen finden Sie unter Projekttypen.
- So erfassen Sie Informationen zur Datenherkunft:
-
Wählen Sie in der Google Cloud Console auf der Seite Projektauswahl das Projekt aus, in dem Sie die Herkunft aufzeichnen möchten.
Aktivieren Sie die Data Lineage API.
- Wiederholen Sie die vorherigen Schritte für jedes Projekt, für das Sie die Herkunft aufzeichnen möchten.
-
Aktivieren Sie in dem Projekt, in dem Sie die Datenherkunft ansehen, die Data Lineage API und die Dataplex API.
Herkunftsaufnahme für einen Dienst steuern
Sie können das automatische Lineage-Tracking für bestimmte Dienste auf Projekt-, Ordner- oder Organisationsebene selektiv aktivieren oder deaktivieren.
Weitere Informationen dazu, wie diese Konfigurationen hierarchisch über den Ressourcenbaum angewendet werden, finden Sie unter Steuerung der Datenherkunftserfassung.
Herkunft ansehen
Wenn Sie nachvollziehen möchten, wie Daten transformiert und zwischen Systemen verschoben werden, können Sie die Datenherkunft über die Google Cloud Console oder die API aufrufen.
Console
Sie können in der Google Cloud Console von verschiedenen Startpunkten aus auf Informationen zur Datenherkunft zugreifen:
- Knowledge Catalog: Rufen Sie die Seite Suchen im Knowledge Catalog auf, wählen Sie Knowledge Catalog als Suchmodus aus, suchen Sie nach dem Eintrag, den Sie sich ansehen möchten, und klicken Sie darauf. Weitere Informationen finden Sie unter Nach Daten-Assets in Knowledge Catalog suchen.
- BigQuery: Rufen Sie die Seite BigQuery auf und öffnen Sie die Tabelle, für die Sie die Datenherkunft sehen möchten.
- Vertex AI: Rufen Sie die Seite Datasets oder Model Registry auf und klicken Sie auf das Dataset oder Modell, für das Sie die Datenherkunft sehen möchten.
So rufen Sie das Herkunftsdiagramm auf:
Klicken Sie auf den Tab Lineage.
Die Standardansicht Grafik wird geöffnet. Sie zeigt die Lineage auf Tabellenebene über Systeme und Regionen hinweg. Weitere Informationen finden Sie unter Herkunftsdiagrammansicht.
Wenn Sie das Herkunftsdiagramm manuell untersuchen möchten, klicken Sie neben einem Knoten auf Maximieren, um jeweils fünf weitere Knoten zu laden.
Weitere Informationen finden Sie unter Herkunftsdiagramm ansehen.
Klicken Sie in der Ansicht Grafik auf einen Knoten.
Der Bereich Details wird mit Informationen zum Asset geöffnet, z. B. dem vollständig qualifizierten Namen und dem Typ. Weitere Informationen finden Sie unter Details zu Herkunftsknoten ansehen.
Klicken Sie in der Ansicht Grafik auf eine Kante mit einem Prozesssymbol.
Der Bereich Abfrage wird geöffnet. Weitere Informationen finden Sie unter Transformationslogik prüfen und Audit und Verlauf von Ausführungen.
- Klicken Sie auf den Tab Details, um die Transformationslogik zu prüfen.
- Klicken Sie auf den Tab Ausführungen, um die Audit- und Ausführungsverläufe aufzurufen.
Wählen Sie im Bereich Lineage Explorer Filterkriterien aus, z. B. Richtung, Abhängigkeitstyp oder Zeitraum, und klicken Sie dann auf Anwenden.
Dadurch wird eine fokussierte Ansicht innerhalb einer bestimmten Region geöffnet (Vorabversion). In dieser Ansicht wird das Diagramm automatisch auf bis zu drei Knotenebenen erweitert. Weitere Informationen finden Sie unter Datenherkunftsansichten filtern und hervorheben.
Wählen Sie in der fokussierten Diagrammansicht einen Knoten aus und klicken Sie dann im Detailbereich des Knotens auf Pfad visualisieren, um den Lineage-Pfad vom ausgewählten Knoten zurück zum Stammeintrag zu visualisieren (nur in der fokussierten Ansicht).
Weitere Informationen finden Sie unter Datenherkunftspfad visualisieren.
So rufen Sie die Herkunft auf Spaltenebene auf (nur für BigQuery- und Managed Service for Apache Spark-Jobs):
- Klicken Sie in einer fokussierten Diagrammansicht auf das Spaltensymbol in einer Tabelle.
Spaltensymbol - Filtern Sie im Bereich Lineage Explorer nach Spaltenname und klicken Sie auf Anwenden.
Weitere Informationen finden Sie unter Wann die Herkunft auf Spaltenebene verwendet werden sollte.
- Klicken Sie in einer fokussierten Diagrammansicht auf das Spaltensymbol in einer Tabelle.
Klicken Sie auf Zurücksetzen.
Dadurch werden alle angewendeten Filter entfernt und Sie gelangen zum Anfang der Diagrammansicht.
Klicken Sie auf Liste, um zur Listenansicht zu wechseln.
Die Listenansicht bietet vereinfachte und detaillierte tabellarische Darstellungen der Herkunft sowohl auf Tabellen- als auch auf Spaltenebene, die mit der Diagrammansicht synchronisiert sind. Standardmäßig wird die vereinfachte Listenansicht angezeigt. Sie können zur detaillierten Listenansicht wechseln, um einzelne Quell-Ziel-Beziehungen zu analysieren. Sie können konfigurieren, welche Spalten angezeigt werden, und Herkunftsdaten exportieren. Weitere Informationen finden Sie unter Listenansicht der Herkunft.
Java
import com.google.api.gax.rpc.ApiException;
import com.google.cloud.datacatalog.lineage.v1.BatchSearchLinkProcessesRequest;
import com.google.cloud.datacatalog.lineage.v1.EntityReference;
import com.google.cloud.datacatalog.lineage.v1.EventLink;
import com.google.cloud.datacatalog.lineage.v1.LineageClient;
import com.google.cloud.datacatalog.lineage.v1.LineageEvent;
import com.google.cloud.datacatalog.lineage.v1.Link;
import com.google.cloud.datacatalog.lineage.v1.ListLineageEventsRequest;
import com.google.cloud.datacatalog.lineage.v1.ListRunsRequest;
import com.google.cloud.datacatalog.lineage.v1.LocationName;
import com.google.cloud.datacatalog.lineage.v1.ProcessLinks;
import com.google.cloud.datacatalog.lineage.v1.Run;
import com.google.cloud.datacatalog.lineage.v1.SearchLinksRequest;
import java.io.IOException;
import java.util.ArrayList;
import java.util.HashSet;
import java.util.LinkedList;
import java.util.List;
import java.util.Queue;
import java.util.Set;

public class ViewLineageExample {

  public static void main(String[] args) throws IOException {
    // TODO(developer): Replace these variables before running the sample.
    String projectId = "my-project-id";
    String location = "us";
    String targetFullyQualifiedName = "bigquery:my-project-id.my_dataset.my_table";
    int maxDepth = 3;

    viewLineage(projectId, location, targetFullyQualifiedName, maxDepth);
  }

  static class Node {
    String fqn;
    int depth;
    Node(String fqn, int depth) {
      this.fqn = fqn;
      this.depth = depth;
    }
  }

  public static void viewLineage(
      String projectId, String location, String targetFullyQualifiedName, int maxDepth)
      throws IOException {
    // Initialize client that will be used to send requests. This client only needs
    // to be created once, and can be reused for multiple requests.
    try (LineageClient client = LineageClient.create()) {
      String parent = LocationName.of(projectId, location).toString();

      Set<String> visitedNodes = new HashSet<>();
      Queue<Node> queue = new LinkedList<>();

      visitedNodes.add(targetFullyQualifiedName);
      queue.offer(new Node(targetFullyQualifiedName, 0));

      while (!queue.isEmpty()) {
        Node current = queue.poll();
        System.out.printf("\nExploring node (Depth %d): %s\n", current.depth, current.fqn);

        if (current.depth >= maxDepth) {
          continue;
        }

        EntityReference targetEntity =
            EntityReference.newBuilder().setFullyQualifiedName(current.fqn).build();
        SearchLinksRequest searchLinksRequest =
            SearchLinksRequest.newBuilder().setParent(parent).setTarget(targetEntity).build();

        List<String> linkNames = new ArrayList<>();
        try {
          // 1. Search for links related to the target entity
          for (Link link : client.searchLinks(searchLinksRequest).iterateAll()) {
            linkNames.add(link.getName());
          }
        } catch (ApiException e) {
          System.out.printf("  Failed to retrieve links for %s: %s\n", current.fqn, e.getMessage());
          continue;
        }

        if (linkNames.isEmpty()) {
          continue;
        }

        // 2. Batch search for processes in chunks of 100
        for (int i = 0; i < linkNames.size(); i += 100) {
          List<String> batch = linkNames.subList(i, Math.min(linkNames.size(), i + 100));
          BatchSearchLinkProcessesRequest batchSearchRequest =
              BatchSearchLinkProcessesRequest.newBuilder()
                  .setParent(parent)
                  .addAllLinks(batch)
                  .build();

          try {
            for (ProcessLinks processLinks :
                client.batchSearchLinkProcesses(batchSearchRequest).iterateAll()) {
              String processName = processLinks.getProcess();
              System.out.printf("  Process: %s\n", processName);

              // 3. List runs for the process
              ListRunsRequest runsRequest =
                  ListRunsRequest.newBuilder().setParent(processName).build();
              for (Run run : client.listRuns(runsRequest).iterateAll()) {
                System.out.printf("    Run: %s\n", run.getName());

                // 4. List events for the run
                ListLineageEventsRequest eventsRequest =
                    ListLineageEventsRequest.newBuilder().setParent(run.getName()).build();
                for (LineageEvent event : client.listLineageEvents(eventsRequest).iterateAll()) {
                  for (EventLink eventLink : event.getLinksList()) {
                    String sourceFqn = eventLink.getSource().getFullyQualifiedName();
                    // If exploring upstream, queue the source
                    if (!sourceFqn.isEmpty() && !visitedNodes.contains(sourceFqn)) {
                      visitedNodes.add(sourceFqn);
                      queue.offer(new Node(sourceFqn, current.depth + 1));
                    }
                  }
                }
              }
            }
          } catch (ApiException e) {
            System.out.printf("  Failed to retrieve processes/runs: %s\n", e.getMessage());
          }
        }
      }
    }
  }
}
Python
from google.cloud import datacatalog_lineage_v1
from google.api_core.exceptions import GoogleAPICallError

def view_lineage(project_id: str, location: str, target_fully_qualified_name: str, max_depth: int = 3):
    """Retrieves lineage for a given entity using a depth-limited search."""
    client = datacatalog_lineage_v1.LineageClient()
    parent = f"projects/{project_id}/locations/{location}"

    # Store visited nodes to avoid infinite loops in cyclic graphs
    visited_nodes = set([target_fully_qualified_name])
    queue = [(target_fully_qualified_name, 0)]

    while queue:
        current_node, current_depth = queue.pop(0)
        print(f"\nExploring node (Depth {current_depth}): {current_node}")

        if current_depth >= max_depth:
            continue

        target_entity = datacatalog_lineage_v1.EntityReference(
            fully_qualified_name=current_node
        )
        search_links_request = datacatalog_lineage_v1.SearchLinksRequest(
            parent=parent,
            target=target_entity,
        )

        try:
            links = list(client.search_links(request=search_links_request))
        except GoogleAPICallError as e:
            print(f"  Failed to retrieve links for {current_node}: {e.message}")
            continue

        if not links:
            continue

        # Extract link names to query processes in batches
        link_names = [link.name for link in links]

        # Batch max size is 100
        for i in range(0, len(link_names), 100):
            batch = link_names[i:i + 100]
            batch_request = datacatalog_lineage_v1.BatchSearchLinkProcessesRequest(
                parent=parent,
                links=batch
            )

            try:
                for process_links in client.batch_search_link_processes(request=batch_request):
                    process_name = process_links.process
                    print(f"  Process: {process_name}")

                    runs_request = datacatalog_lineage_v1.ListRunsRequest(parent=process_name)
                    for run in client.list_runs(request=runs_request):
                        print(f"    Run: {run.name}")

                        events_request = datacatalog_lineage_v1.ListLineageEventsRequest(parent=run.name)
                        for event in client.list_lineage_events(request=events_request):
                            for event_link in event.links:
                                source_fqn = event_link.source.fully_qualified_name

                                # If exploring upstream, queue the source
                                if source_fqn and source_fqn not in visited_nodes:
                                    visited_nodes.add(source_fqn)
                                    queue.append((source_fqn, current_depth + 1))

            except GoogleAPICallError as e:
                 print(f"  Failed to retrieve processes/runs: {e.message}")
Herkunftsvisualisierung verfeinern
Wenn Sie die Visualisierung der Herkunft verfeinern möchten, können Sie im Herkunfts-Explorer Hervorhebungs- und Filteroptionen verwenden:
Wenn Sie nach bestimmten Projekten, Datasets oder Entitätsnamen suchen möchten, verwenden Sie den Bereich Filter.
Nachdem Sie Filter angewendet haben, werden Herkunftsknoten, die Ihren Filterkriterien entsprechen, als übereinstimmende Knoten betrachtet. Sie können die Darstellung übereinstimmender und nicht übereinstimmender Knoten verfeinern.
Klicken Sie im Herkunftsdiagramm auf das Symbol Weitere Aktionen neben der Schaltfläche Filter löschen, um die Anzeigeoptionen aufzurufen.
Wählen Sie eine oder beide der folgenden Optionen aus:
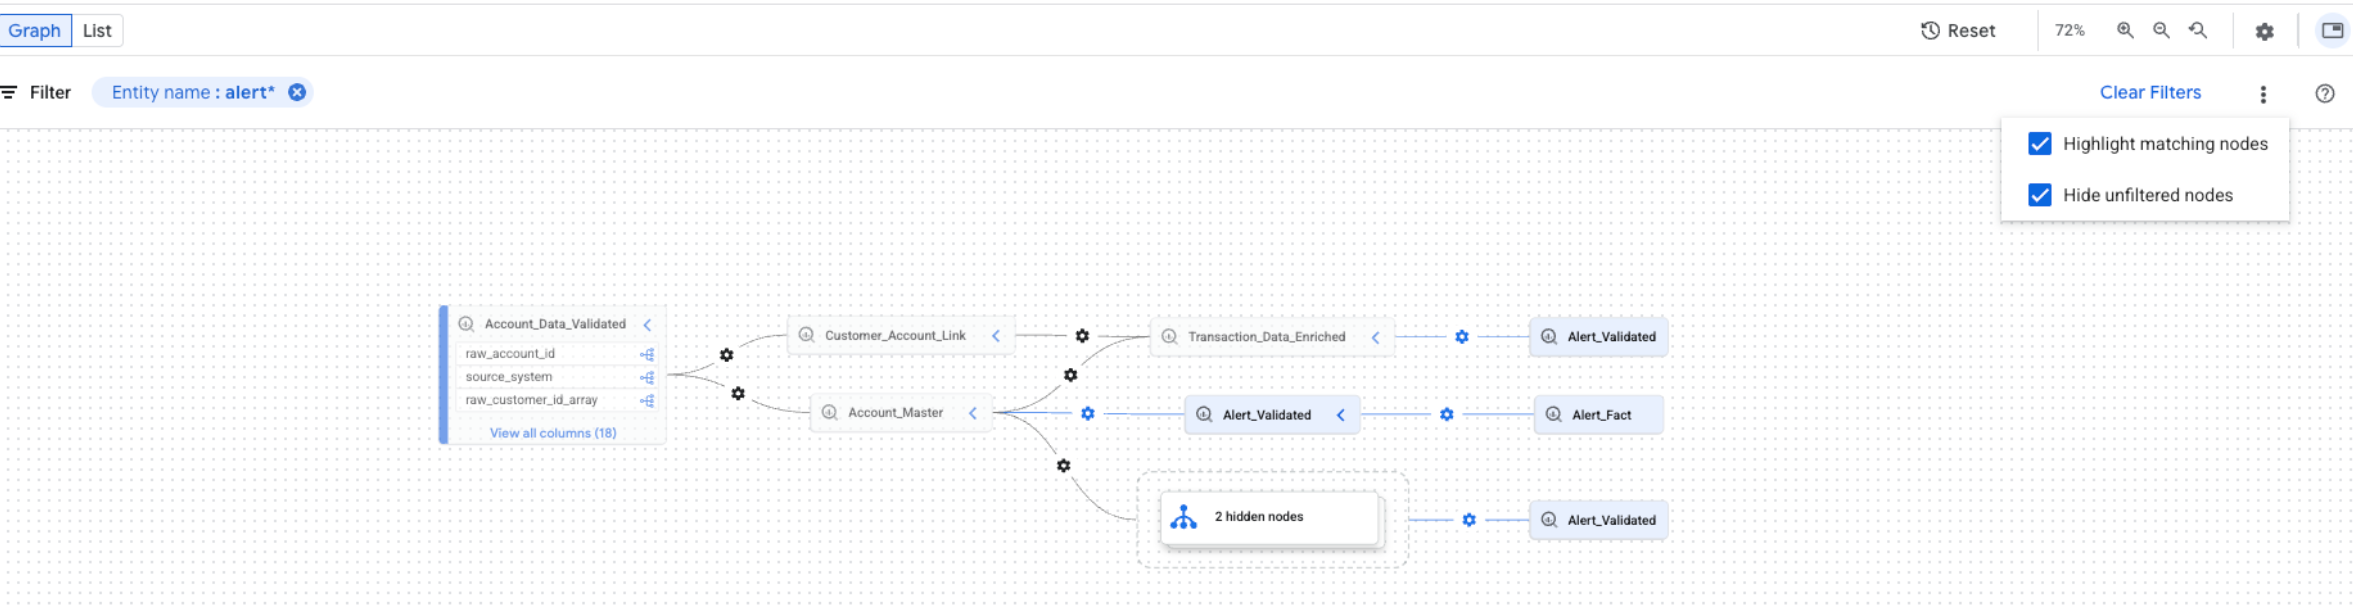
Sie können beide Optionen gleichzeitig auswählen. Wenn beide Optionen ausgewählt sind, werden ungefilterte Knoten ausgeblendet und übereinstimmende Knoten in der gefilterten Diagrammansicht hervorgehoben.
Datenherkunft deaktivieren
Wenn Sie die Herkunft nicht mehr verfolgen und Gebühren für die Datenherkunft vermeiden möchten, deaktivieren Sie die Data Lineage API (datalineage.googleapis.com) in jedem Projekt, in dem sie aktiviert ist.
Wenn Sie die Dataplex API deaktivieren, wird die Datenherkunft nicht deaktiviert und die Gebühren werden nicht gestoppt. Sie müssen die Data Lineage API deaktivieren.
Wenn Sie die Datenherkunft deaktivieren möchten, wählen Sie einen der folgenden Tabs aus und führen Sie die Schritte für jedes Projekt aus, für das das Herkunftstracking aktiviert wurde:
Console
Rufen Sie in der Google Cloud Console die Seite Aktivierte APIs und Dienste auf.
Klicken Sie in der Liste der APIs auf Data Lineage API.
Klicken Sie auf API deaktivieren.
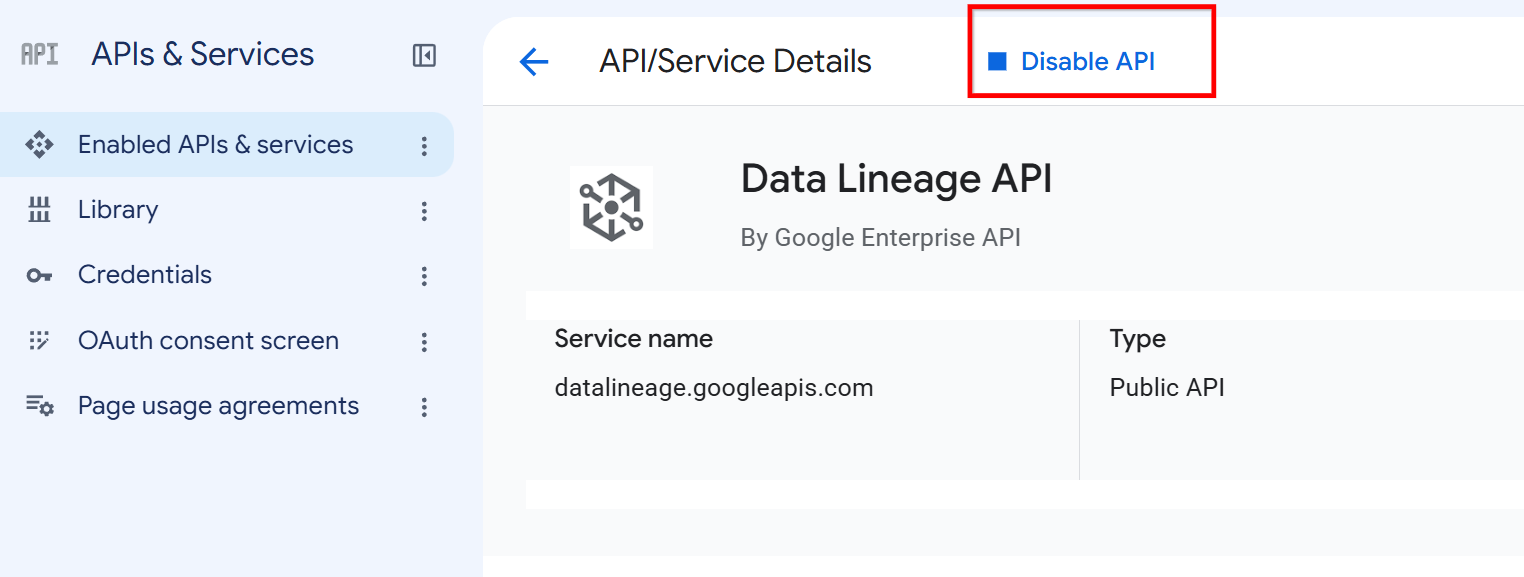
Schaltfläche „API deaktivieren“ auf der Detailseite der Data Lineage API. Klicken Sie bei Aufforderung auf Deaktivieren.
gcloud
Verwenden Sie den Befehl gcloud services
disable, um die Data Lineage API zu deaktivieren:
gcloud services disable datalineage.googleapis.com --project=PROJECT_ID
Ersetzen Sie Folgendes:
PROJECT_ID: die ID Ihres Projekts in Google Cloud
Wenn Sie das Datenherkunfts-Tracking für bestimmte Dienste beenden möchten, ohne die API vollständig zu deaktivieren, finden Sie weitere Informationen unter Datenherkunftsaufnahme für einen Dienst konfigurieren.
Nächste Schritte
- Datenherkunft für eine BigQuery-Tabelle nachverfolgen
- Informationen zum Datenherkunfts-Informationsmodell
- Überlegungen und Einschränkungen zur Datenherkunft
- Informationen zum Audit-Logging der Data Lineage API
- Probleme mit der Datenherkunft beheben.
- In OpenLineage einbinden.
- Datenherkunft mit Managed Service for Apache Spark verwenden