


סוכן החיפוש של Knowledge Catalog הוא עוזר דיגיטלי מבוסס-AI שמשפר את הרלוונטיות של תוצאות החיפוש לשאילתות מורכבות בשפה טבעית, על סמך יכולות החיפוש של Knowledge Catalog. הוא מבין את השאילתות ומנסח אותן בצורה אופטימלית, וכך מספק תוצאות מדויקות יותר מ-Knowledge Catalog Search API הרגיל. היכולת הזו חשובה במיוחד בשאילתות מורכבות או ארוכות.
תרחישים לדוגמה
סוכן החיפוש מספק ממשק צ'אט עם AI עשיר בתרחישים כמו:
- כוונות ואילוצים מורכבים או משולבים: טיפול בבקשות חיפוש עם כמה קריטריונים, כמו חיפוש מערכי נתונים ב-
us-central1אבל לא כולל משאבים ב-BigQuery. - חיפוש שמתמקד בעסק: חיפוש נכסי נתונים על סמך כוונה והקשר עסקי, במקום התאמה למונחים טכניים מדויקים.
- חיפוש בכמה שלבים: אתם יכולים לנהל שיחה עם Gemini כדי לצמצם את תוצאות החיפוש.
סוכן החיפוש מבוסס על החיפוש הסמנטי של Knowledge Catalog, שמספק חיפוש היברידי מוכן לשימוש. אתם יכולים להמשיך להשתמש בחיפוש הסמנטי של Knowledge Catalog ישירות כשאתם צריכים לעבד חיפושים עם כוונת רכישה גבוהה (כשאתם יודעים מהו המשאב או העמודה הספציפיים), דרישות של זמן אחזור נמוך או חיפוש היברידי ללא הגדרה.
איך זה עובד
כדי להגיב לשאילתת חיפוש, סוכן הגילוי מבצע את השלבים הבאים:
- מנתח את הקלט כדי להבין את הכוונה של השאילתה, יוצר כמה וריאציות של חיפוש וממפה מונחים למסנני מטא-נתונים.
- חיפוש משאבים באמצעות החיפוש הסמנטי של Knowledge Catalog.
- מדרג את התוצאות הממוזגות לפי רלוונטיות.
בתרשים הבא מוצגים פרטי התהליך:
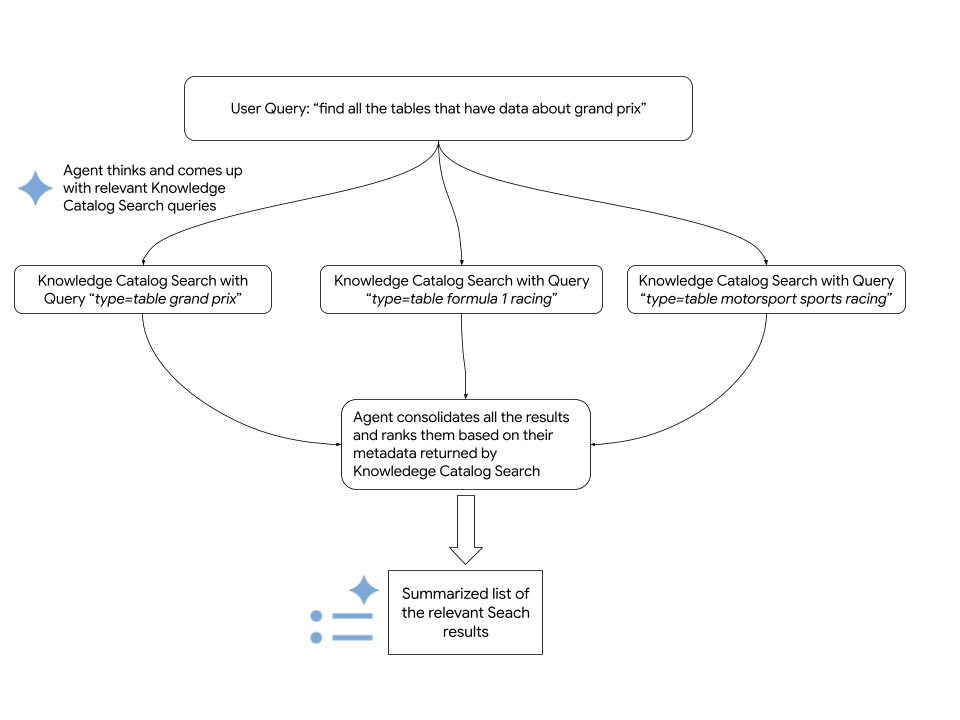
הנציג מסתמך על Knowledge Catalog Search API כדי לאחזר משאביGoogle Cloud רלוונטיים. בקטע הקוד הבא אפשר לראות איך הנציג קורא לחיפוש הסמנטי של Knowledge Catalog:
      # Configure the request parameters for the
      # call to Knowledge Catalog Semantic Search API.
      endpoint = "dataplex.googleapis.com"

      client = dataplex_v1.CatalogServiceClient(
          client_options={"api_endpoint": endpoint}
      )

      location = "global"
      consumer_project_id = "my-gcp-project"
      parent_name = f"projects/{consumer_project_id}/locations/{location}"

      # Call Knowledge Catalog Semantic Search API.
      response = client.search_entries(
          request={
              "name": parent_name,
              "query": query,
              "page_size": 50,
              "semantic_search": True,
          }
      )

      # Call Knowledge Catalog LookupContext for each search result
      # to retrieve rich, LLM-ready metadata.
      entries = []
      for result in response.results:
          entry_name = result.dataplex_entry.name

          # Prepare the LookupContext request for the specific resource
          lookup_request = {
              "name": parent_name,
              "resources": [entry_name]
          }

          # Call the LookupContext API
          lookup_response = client.lookup_context(request=lookup_request)

          # Extract the rich context YAML to share with the agent
          entries.append({
              "entry_name": entry_name,
              "context": lookup_response.context
          })

      return {"results": entries}
לפני שמתחילים
כדי להריץ את סוכן הגילוי של Knowledge Catalog, צריך לוודא שעומדים בדרישות הבאות:
התפקידים הנדרשים
כדי לקבל את ההרשאות שדרושות לשימוש בסוכן החיפוש, בקשו מהאדמין לתת לכם את התפקידים הבאים ב-IAM ב Google Cloud פרויקט iam.gserviceaccount.com:
- צפייה ב-Dataplex (
roles/dataplex.viewer) - Vertex AI User (
roles/aiplatform.user) - Service Usage Consumer (
roles/serviceusage.serviceUsageConsumer)
להסבר על מתן תפקידים, ראו איך מנהלים את הגישה ברמת הפרויקט, התיקייה והארגון.
התפקידים המוגדרים מראש האלה כוללים את ההרשאות שנדרשות כדי להשתמש בסוכן הגילוי. כדי לראות בדיוק אילו הרשאות נדרשות, אפשר להרחיב את הקטע ההרשאות הנדרשות:
ההרשאות הנדרשות
כדי להשתמש בסוכן הגילוי, נדרשות ההרשאות הבאות:
-
dataplex.projects.search -
aiplatform.endpoints.predict -
serviceusage.services.use
יכול להיות שתקבלו את ההרשאות האלה באמצעות תפקידים בהתאמה אישית או תפקידים מוגדרים מראש אחרים.
הפעלת ממשקי ה-API
כדי להשתמש בסוכן החיפוש של Knowledge Catalog, צריך להפעיל את ממשקי ה-API הבאים בפרויקט: Dataplex API, Vertex AI API ו-Service Usage API.
התפקידים שנדרשים כדי להפעיל ממשקי API
כדי להפעיל ממשקי API, צריך את ההרשאה serviceusage.services.enable. אם יצרתם את הפרויקט, סביר להניח שכבר יש לכם את ההרשאה הזו דרך התפקיד "בעלים" (roles/owner). אחרת, תוכלו לקבל את ההרשאה הזו דרך התפקיד "אדמין בממשק 'שימוש בשירות'" (roles/serviceusage.serviceUsageAdmin). איך מקצים תפקידים
הגדרת הסביבה
כדי להגדיר את סביבת הפיתוח של סוכן הגילוי:
משכפלים את המאגר
dataplex-labs.git clone https://github.com/GoogleCloudPlatform/dataplex-labs.gitעוברים לספריית הסוכן:
cd dataplex-labs/knowledge_catalog_discovery_agentיוצרים ומפעילים סביבה וירטואלית של Python, ואז מתקינים את יחסי התלות שמפורטים בקובץ
requirements.txt:-
google-adk(ערכת פיתוח לסוכנים) -
google-cloud-dataplex(לקוח Python של Knowledge Catalog) google-api-core
python3 -m venv /tmp/kcsearch source /tmp/kcsearch/bin/activate pip3 install -r requirements.txt-
מגדירים את משתני הסביבה באמצעות הפקודה הבאה:
export GOOGLE_CLOUD_PROJECT=PROJECT_ID
export GOOGLE_GENAI_USE_VERTEXAI=True
מחליפים את מה שכתוב בשדות הבאים:
-
PROJECT_IDבמזהה הפרויקט
-
הפעלת סוכן הגילוי כסוכן הבסיס (root)
כדי להריץ את סוכן הגילוי ישירות כסוכן הבסיס:
- בקובץ
agent.pyשנמצא בתיקייהknowledge_catalog_discovery_agent, משנים את השם של המשתנהdiscovery_agentל-root_agent. מריצים את הסוכן באמצעות הפקודה
adk run:adk run path/to/agent/parent/folderמחליפים את מה שכתוב בשדות הבאים:
-
path/to/agent/parent/folderבספריית האם שמכילה את התיקייה עם הנציג. לדוגמה, אם הנציג נמצא ב-knowledge_catalog_discovery_agent/, מריצים אתadk runמהספרייהagents/.
-
הפעלת סוכן הגילוי ככלי של הסוכן
כדי לשלב את נציג החיפוש בנציג גדול יותר בהתאמה אישית, כמו my_custom_agent, מבצעים את הפעולות הבאות:
מגדירים את מבנה הפרויקט כך שיכיל את מודול סוכן הגילוי:
my_custom_agent/
├── agent.py
└── knowledge_catalog_discovery_agent/
    ├── SKILL.md
    ├── agent.py
    ├── tools.py
    └── utils.py
בקובץ
agent.pyשל הסוכן בהתאמה אישית, מייבאים את סוכן החיפוש ומשתמשים בו ככלי של הסוכן. לדוגמה:root_agent = llm_agent.Agent( model=google_llm.Gemini(model=GEMINI_MODEL), name="my_custom_agent", instruction=( "You are a Custom Agent. Your goal is to help users understand" " their data landscape, evaluate data assets, and derive insights" " from available resources. **IMPORTANT**: You should use the" " `knowledge_catalog_discovery_agent` to search for and discover" " data assets. For best results, pass in the Natural Language user'" " query as is to the `knowledge_catalog_discovery_agent`. Once assets" " are found, you should analyze their metadata, compare them, and" " provide recommendations or summaries to the user to help them make" " decisions. Focus on general metadata summary and comparison." ), tools=[ agent_tool.AgentTool(discovery_agent), ], )מריצים את ה-agent באמצעות הפקודה
adk run:adk run path/to/agent/parent/folderמחליפים את מה שכתוב בשדות הבאים:
-
path/to/agent/parent/folderבספריית האם שמכילה את התיקייהmy_custom_agent/. לדוגמה, אם הנציג נמצא ב-agents/my_custom_agent/, מריצים אתadk runמהספרייהagents/.
-
המאמרים הבאים
- הסבר על תחביר החיפוש ב-Knowledge Catalog
- למידע נוסף על ערכת פיתוח סוכנים.
- תרחישים לדוגמה נוספים של Knowledge Catalog