


El linaje de datos en Knowledge Catalog (anteriormente, Dataplex Universal Catalog) te permite hacer un seguimiento del movimiento de los datos, comprender sus orígenes y depurar las canalizaciones de datos. Si los gráficos de linaje, los metadatos de proceso, los detalles de la tabla o los vínculos a nivel de columna no aparecen como se espera, o si ves cargos inesperados por el procesamiento de Knowledge Catalog Premium, puedes verificar los permisos de tu proyecto, la configuración de la API y los tipos de trabajos admitidos.
Si necesitas ayuda para resolver un problema que no se aborda en este documento, consulta Atención al cliente de Cloud.
Tipos de proyecto
Los recursos de datos pueden residir en diferentes proyectos. A continuación, se incluye un resumen de los proyectos posibles y sus nombres de recursos.
Proyecto de almacenamiento de BigQuery
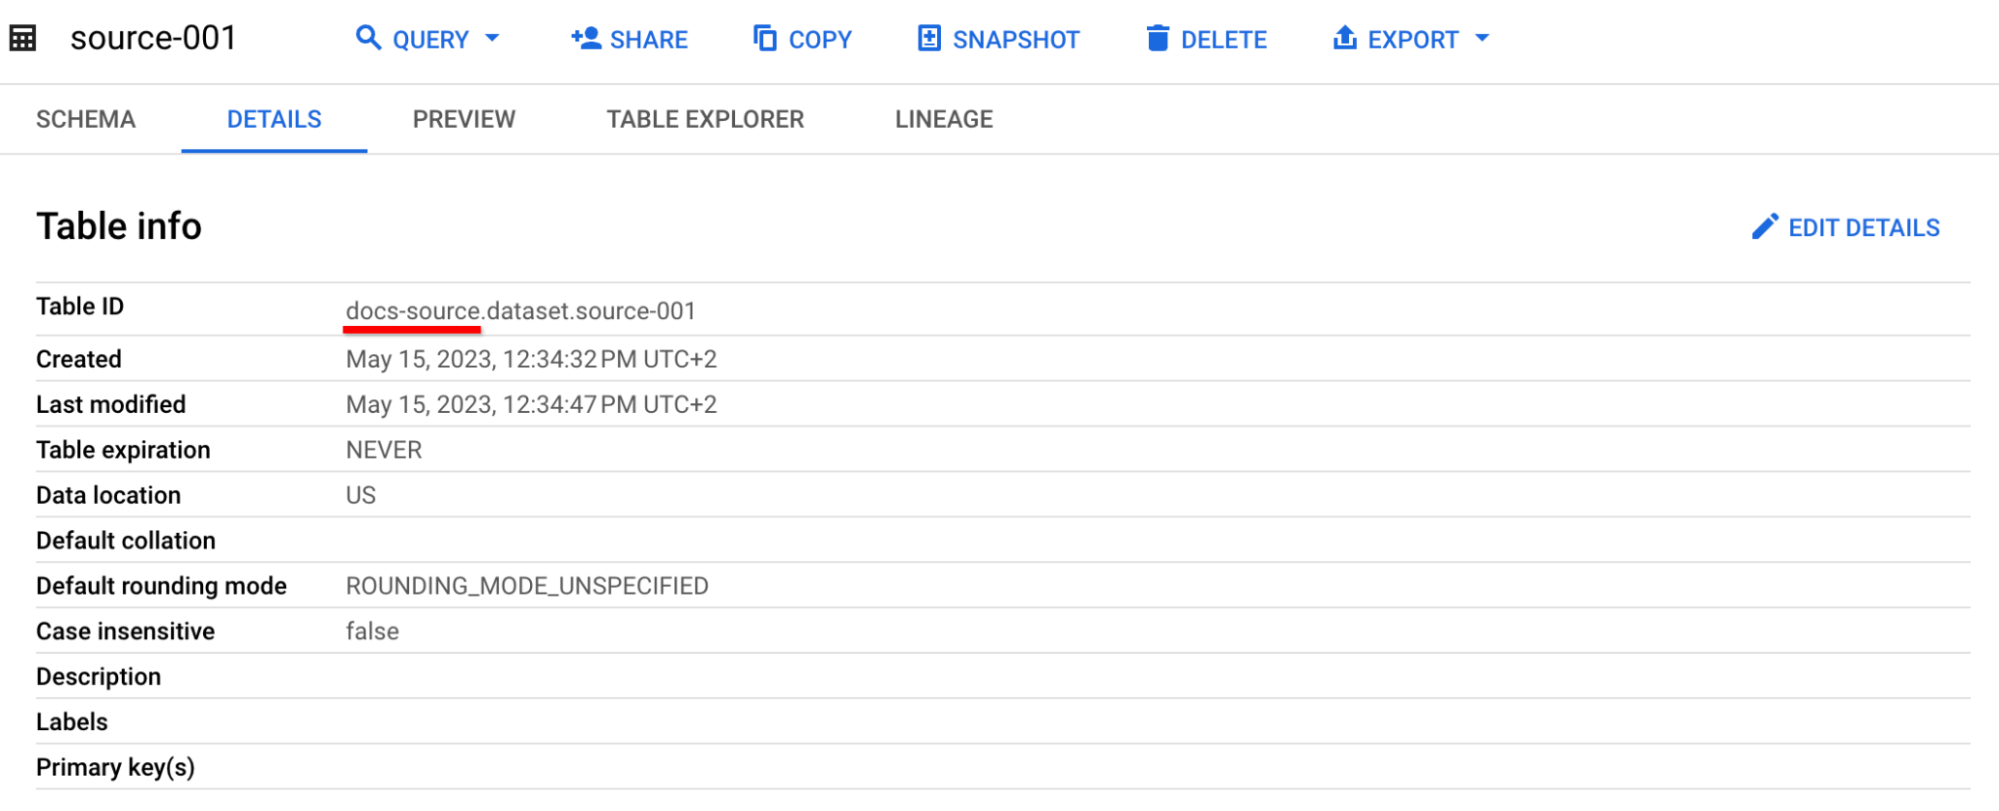
En este proyecto, se almacenan tus recursos de datos de BigQuery. Puedes encontrarlo en los detalles del recurso como parte de Table ID, antes del primer punto.
Proyecto de Compute
Este proyecto almacena los metadatos del linaje de datos. En BigQuery, aquí es donde ejecutas un trabajo. Si ejecutas un trabajo con la consola deGoogle Cloud , puedes encontrar el nombre del proyecto de procesamiento en el selector de proyectos:
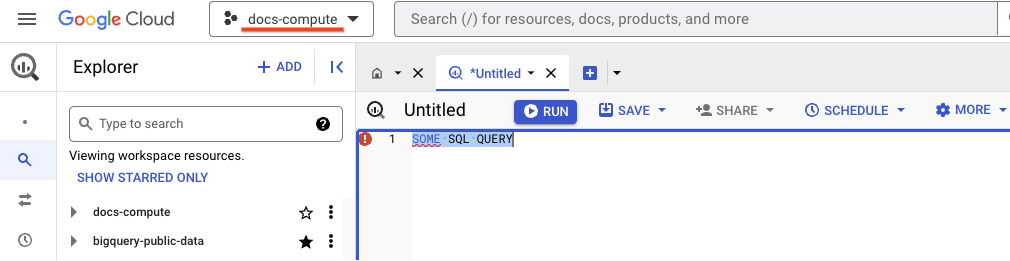
Cuando envíes solicitudes a la API de BigQuery, especifica el proyecto de procesamiento en la URL, por ejemplo:
POST /bigquery/v2/projects/docs-compute/jobs HTTP/1.1
Host: bigquery.googleapis.com
User-Agent: Go-http-client/1.1
Authorization: <REDACTED 1031 BYTES>
Accept-Encoding: gzip
{
  "configuration": {
    "query": {
      "useLegacySql": false,
      "query": "CREATE OR REPLACE TABLE `docs-target.dataset.target-002` AS SELECT * FROM `docs-source.dataset.source-002`;"
    }
  },
  "jobReference": {
    "projectId": "docs-compute",
    "jobId": "docs-compute-job-id",
    "location": "us",
  }
}
Proyecto activo
Este es el proyecto desde el que estás viendo el linaje de datos. En la consola deGoogle Cloud , se muestra el proyecto activo en el selector de proyectos. Si usas la API, el proyecto activo es el proyecto desde el que realizas las llamadas a la API.
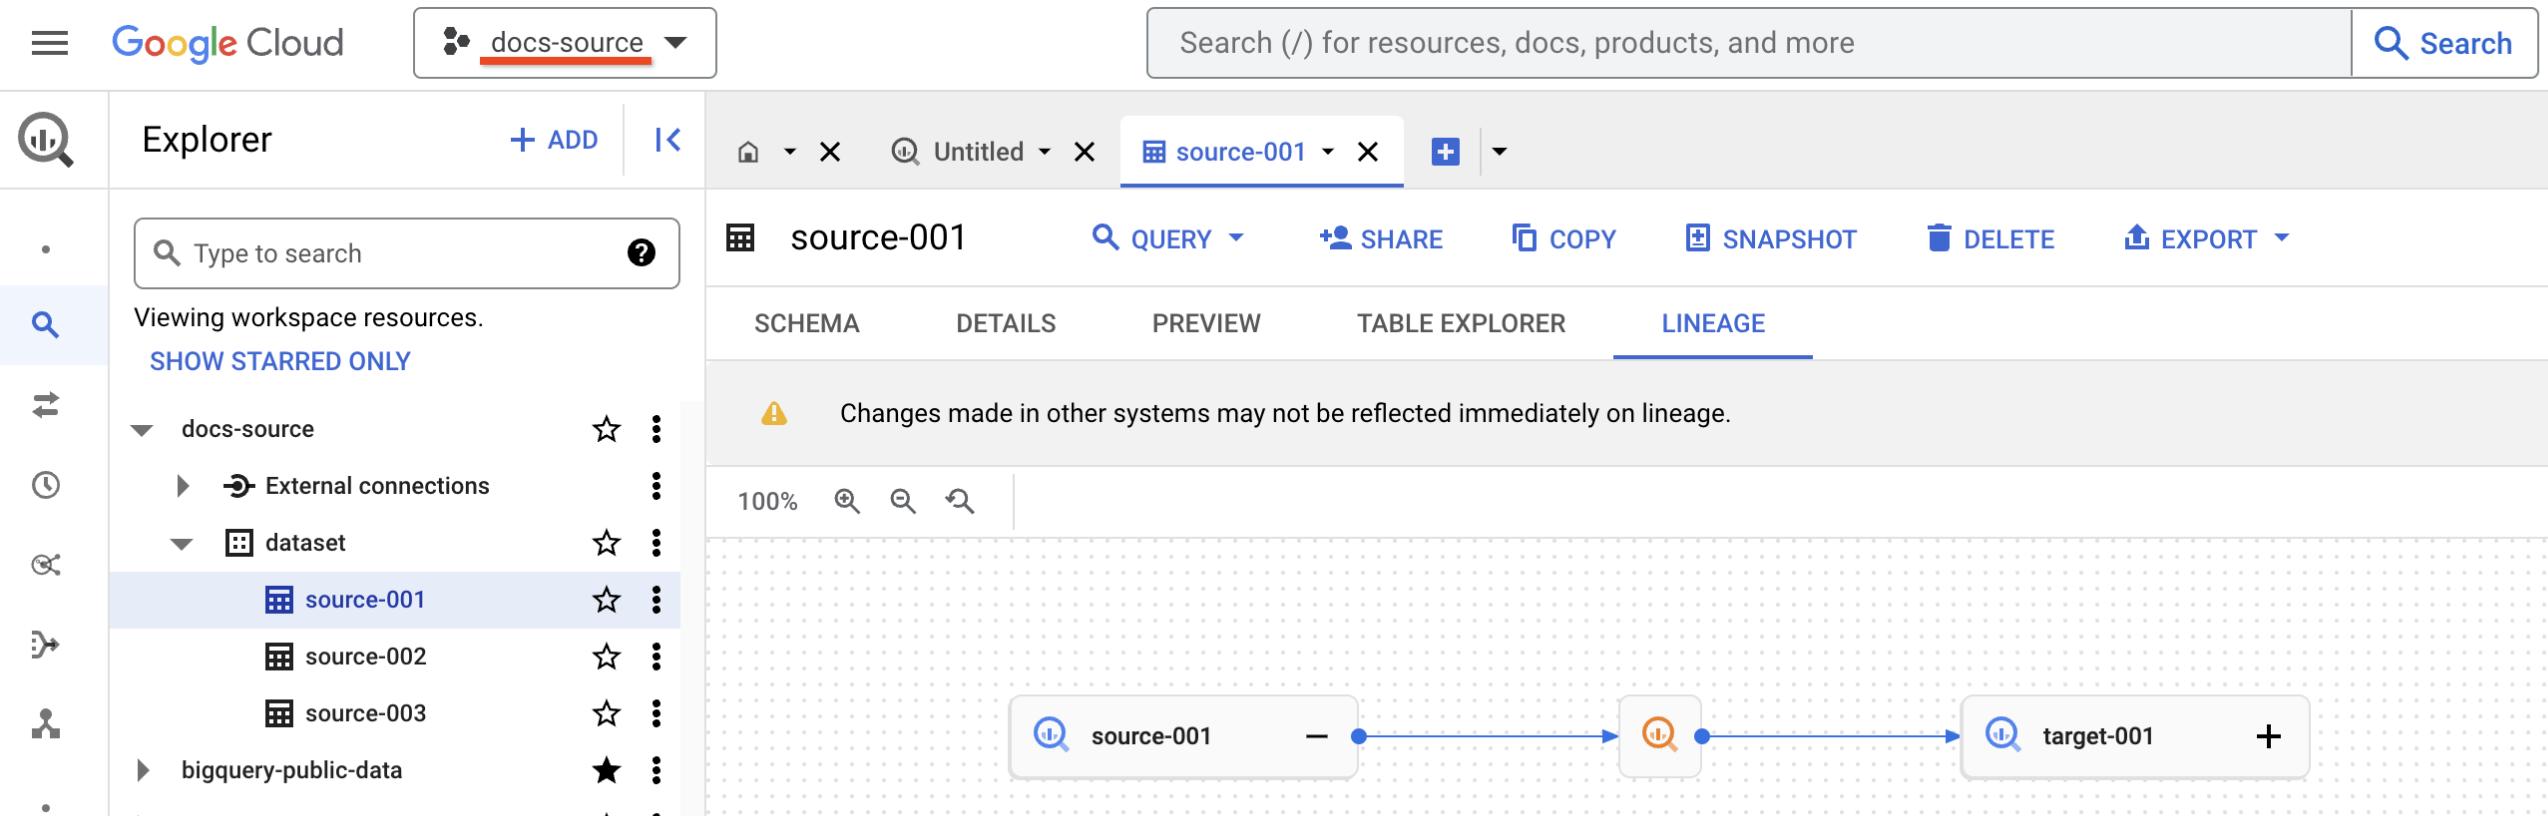
No se muestra el linaje de datos de BigQuery
El siguiente problema se produce después de ejecutar un trabajo de BigQuery. En este caso, el problema puede deberse a tres situaciones:
- La API de Data Lineage está inhabilitada en el proyecto activo o en el proyecto de procesamiento.
- No tienes el rol de visualizador de linaje de datos
(
roles/datalineage.viewer) en el proyecto activo ni en el de procesamiento. - El linaje de datos aún no llegó. Según el volumen y la complejidad de los datos que se procesan, el linaje de datos puede tardar entre 30 minutos y 24 horas en mostrarse.
Si ves el mensaje "No se pudo recuperar el linaje porque faltan permisos", significa que te faltan permisos en el proyecto activo. De lo contrario, te faltan permisos en el proyecto de procesamiento.
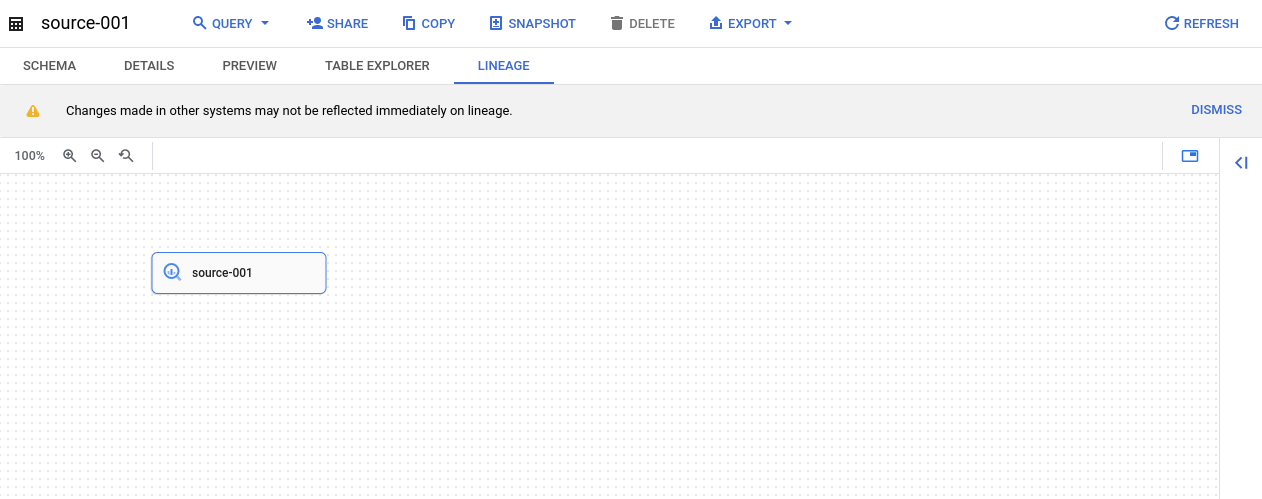
Para resolver este problema, verifica si la API de Data Lineage está habilitada para el proyecto de procesamiento. Después de habilitar la API, debes ejecutar un trabajo para ver el linaje de datos. Según el volumen y la complejidad de los datos que se procesan, el linaje de datos puede tardar entre 30 minutos y 24 horas en mostrarse.
A continuación, verifica si la API de Data Lineage está habilitada para el proyecto activo.
Cuando la API de Data Lineage esté habilitada, otorga el rol de visualizador de linaje de datos
(roles/datalineage.viewer) en los proyectos activo y de
procesamiento.
No se muestran los metadatos del proceso de BigQuery
El siguiente problema se produce cuando abres el panel de detalles de la tabla, que no
muestra todos los detalles, como la instrucción de SQL o la propiedad Process type.
Esto sucede incluso aunque el linaje de datos se muestre correctamente.
Esto puede suceder cuando no tienes permisos para ver los metadatos en el proyecto de procesamiento.
Ejemplo:
- Tabla de origen de BigQuery:
docs-source.dataset.source-001 - Tabla de destino de BigQuery:
docs-target.dataset.target-001 - Linaje de datos entre
docs-source.dataset.source-001ydocs-target.dataset.target-001en el proyecto de procesamientodocs-compute - Tienes el rol de visualizador de linaje de datos para los proyectos activos y de procesamiento de
docs-compute.
Si haces clic en los detalles del proceso de BigQuery, se mostrará el siguiente mensaje en la consola de Google Cloud :
You don't have permission to view BigQuery process metadata in project X.

Para resolver este problema, otorga al usuario el permiso bigquery.jobs.get (por ejemplo, incluido en el rol Visualizador de recursos de BigQuery) en el proyecto de procesamiento.
No se muestran los detalles de la tabla de BigQuery
El siguiente problema ocurre cuando abres el panel de detalles de la tabla, que muestra
solo la propiedad Fully qualified name. Esto sucede incluso si el linaje de datos se muestra correctamente. Esto puede suceder cuando no tienes
todos los permisos necesarios en los proyectos de almacenamiento
de la tabla.
Ejemplo:
- Tabla de BigQuery
docs-source.dataset.source-001 - Tabla de BigQuery
docs-target.dataset.target-001 - Linaje de datos entre
docs-source.dataset.source-001ydocs-target.dataset.target-001con el proyecto de procesamientodocs-compute - Tienes el rol de visualizador de linaje de datos para los proyectos activos y de procesamiento de
docs-compute.
En este caso, cuando haces clic en los detalles del nodo de BigQuery, ves el mensaje
Entry with this fully qualified name is not available in Knowledge Catalog or
you do not have permissions to view it
.

Para resolver este problema, otorga el permiso bigquery.tables.get (por ejemplo,
incluido en el rol de visualizador de datos de BigQuery) en el
proyecto de almacenamiento.
El linaje a nivel de columna muestra el mensaje "No hay columnas para seleccionar"
El siguiente problema ocurre cuando ves un recurso en la consola de Google Cloud y el gráfico de linaje a nivel de tabla se muestra de forma correcta, pero, cuando seleccionas el linaje a nivel de columna, se muestra el mensaje "No hay columnas para seleccionar" o no aparecen vínculos de columna a columna.
Este problema puede ocurrir en las siguientes situaciones:
- Eventos personalizados de OpenLineage: Los eventos transferidos a través del
extremo
ProcessOpenLineageRunEventde la API de Data Lineage solo admiten el linaje a nivel de la tabla. Las facetas personalizadas a nivel de columna no se renderizan en la consola deGoogle Cloud . - Fuentes de datos o sistemas no compatibles: Los gráficos de linaje a nivel de columna solo se generan para las transformaciones de SQL de BigQuery y los trabajos de Managed Service para Apache Spark. Otros sistemas integrados (como Cloud Data Fusion y Vertex AI) solo admiten el linaje a nivel de tabla.
- Tipos de trabajos de BigQuery no compatibles: No se recopila el linaje a nivel de columna para los trabajos de carga, los trabajos de copia ni las rutinas de BigQuery.
- Tablas externas: No se recopila el linaje ascendente a nivel de columna para las tablas externas.
- Recursos no estructurados o a nivel de almacenamiento: Si bien los recursos basados en archivos (como los archivos o buckets de Cloud Storage sin procesar) no suelen estar estructurados, el linaje de datos puede mostrar columnas para ellos si se informa al sistema el linaje a nivel de columna. Si no se informa el linaje a nivel de columna para el recurso de archivo, no puedes seleccionar ninguna columna.
- Tipos anidados complejos: El linaje a nivel de columna solo hace un seguimiento de las columnas de nivel superior. No puedes seleccionar de forma individual campos anidados dentro de tipos de datos complejos
(como
STRUCToJSON). - Pseudocolumnas de partición: Las columnas de partición del sistema (como
_PARTITIONDATEy_PARTITIONTIME) no se reconocen en los gráficos de linaje a nivel de columna. - Se excedieron los límites de vínculos: Si un trabajo de transformación genera más de 1,500 vínculos a nivel de columna, Knowledge Catalog omite la recopilación de linaje a nivel de columna y conserva solo el linaje a nivel de tabla.
- Recursos de varias organizaciones: Si una ruta de linaje atraviesa un recurso ubicado en otra organización, no puedes acceder a los detalles del esquema y de la columna si no perteneces a la misma organización que el recurso.
Cargos inesperados por el procesamiento premium de Knowledge Catalog
Inhabilitaste la API de Dataplex (dataplex.googleapis.com) para detener los cargos,
pero sigues viendo cargos diarios por el SKU "Procesamiento premium de Knowledge Catalog".
Este problema puede ocurrir si la API de Data Lineage (datalineage.googleapis.com)
permanece habilitada. La API de Data Lineage se factura con el
SKU "Procesamiento premium de Knowledge Catalog", pero se administra como una API independiente
en la consola de Google Cloud . Inhabilitar la API de Dataplex no
inhabilita la API de Data Lineage ni detiene sus cargos.
Para identificar si el linaje de datos es la fuente de los cargos, consulta tu
informe de Facturación de Cloud para ver la etiqueta
goog-dataplex-workload-type con el valor LINEAGE.
Para detener los cargos, desactiva el linaje de datos inhabilitando la API de Data Lineage en tus proyectos.