


データ品質のプロファイリングと検証
Knowledge Catalog(旧称 Dataplex Universal Catalog)を使用すると、BigQuery テーブルをプロファイリングして、NULL の割合、一意の値の数、値の分布などの列レベルの統計情報を計算できます。これらの分析情報を使用して、データ品質ルールを定義し、レコードの異常を検証できます。
このクイックスタートでは、意図的な異常を含むサンプルの BigQuery テーブルにデータを入力し、データ プロファイル スキャンを実行して、データ品質スキャンで結果を評価します。詳細については、データのプロファイリングについてと自動データ品質についてをご覧ください。
始める前に
プロジェクトを設定します。
- Google Cloud アカウントにログインします。 Google Cloudを初めて使用する場合は、 アカウントを作成して、実際のシナリオで Google プロダクトのパフォーマンスを評価してください。新規のお客様には、ワークロードの実行、テスト、デプロイができる無料クレジット $300 分を差し上げます。
-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
If you're using an existing project for this guide, verify that you have the permissions required to complete this guide. If you created a new project, then you already have the required permissions.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Knowledge Catalog and BigQuery APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.-
In the Google Cloud console, on the project selector page, select or create a Google Cloud project.
Roles required to select or create a project
- Select a project: Selecting a project doesn't require a specific IAM role—you can select any project that you've been granted a role on.
-
Create a project: To create a project, you need the Project Creator role
(
roles/resourcemanager.projectCreator), which contains theresourcemanager.projects.createpermission. Learn how to grant roles.
-
If you're using an existing project for this guide, verify that you have the permissions required to complete this guide. If you created a new project, then you already have the required permissions.
-
Verify that billing is enabled for your Google Cloud project.
Enable the Knowledge Catalog and BigQuery APIs, if any are not already enabled.
Roles required to enable APIs
To enable APIs, you need the
serviceusage.services.enablepermission. If you created the project, then you likely already have this permission through the Owner role (roles/owner). Otherwise, you can get this permission through the Service Usage Admin role (roles/serviceusage.serviceUsageAdmin). Learn how to grant roles.
必要なロール
データ プロファイル スキャンとデータ品質スキャンの作成と実行、BigQuery リソースの管理に必要な権限を取得するには、プロジェクトに対する次の IAM ロールを付与するよう管理者に依頼してください。
-
データスキャンの作成、実行、削除: Dataplex DataScan 編集者 (
roles/dataplex.dataScanEditor) -
サンプル テーブルの作成、入力、削除: BigQuery データオーナー (
roles/bigquery.dataOwner) -
BigQuery で SQL クエリを実行する: BigQuery ジョブユーザー (
roles/bigquery.jobUser)
ロールの付与については、プロジェクト、フォルダ、組織へのアクセス権の管理をご覧ください。
必要な権限は、カスタムロールや他の事前定義ロールから取得することもできます。
プロジェクトで IAM アクセスを管理するために必要な権限がある場合は、次の gcloud コマンドを実行して、これらのロールを独自のユーザー アカウントに付与できます。
gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/dataplex.dataScanEditor"

gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/bigquery.dataOwner"

gcloud projects add-iam-policy-binding PROJECT_ID \
    --member="user:USER_EMAIL" \
    --role="roles/bigquery.jobUser"
次のように置き換えます。
PROJECT_ID: 実際の Google Cloud プロジェクト ID。USER_EMAIL: ユーザー アカウントのメールアドレス(例:name@example.com)。
Knowledge Catalog サービス エージェントに権限を付与する
サービス エージェントは、Knowledge Catalog がユーザーの代わりに BigQuery でスキャンクエリを実行するために使用する Google マネージド サービス アカウントです。
Google Cloud コンソールで、ツールバーの [Cloud Shell をアクティブにする] をクリックします。環境がプロビジョニングされ、接続されるまでしばらく待ちます。
Knowledge Catalog サービス エージェントを作成します。
gcloud beta services identity create --service=dataplex.googleapis.comこのコマンドは、サービス エージェントがまだプロビジョニングされていない場合はサービス エージェントを作成し、そのメールアドレスを出力します。プロジェクトにすでに Knowledge Catalog サービス エージェントがある場合、コマンドは変更を加えずに既存の ID を返します。
出力は次のようになります。
serviceAccount:service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com次のステップのために、出力の
PROJECT_NUMBERをメモします。Knowledge Catalog がプロジェクトでクエリジョブを実行できるように、BigQuery ジョブユーザー(
roles/bigquery.jobUser)ロールを付与します。gcloud projects add-iam-policy-binding PROJECT_ID \ --member="serviceAccount:service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com" \ --role="roles/bigquery.jobUser"
次のように置き換えます。
PROJECT_ID: 実際の Google Cloud プロジェクト ID。PROJECT_NUMBER: Google Cloud プロジェクトの番号。
サービス エージェントがテーブルデータとスキーマを読み取れるように、BigQuery データ閲覧者(
roles/bigquery.dataViewer)ロールを付与します。gcloud projects add-iam-policy-binding PROJECT_ID \ --member="serviceAccount:service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com" \ --role="roles/bigquery.dataViewer"
次のように置き換えます。
PROJECT_ID: 実際の Google Cloud プロジェクト ID。PROJECT_NUMBER: Google Cloud プロジェクトの番号。
サンプル データセットとテーブルを作成する
本番環境のデータに触れることなく、プロファイリングとデータ品質スキャンを安全に試すには、専用の BigQuery データセットを設定し、重複や null 値などの意図的な異常を含むサンプル バイクシェア データを含むテーブルを作成します。
コンソール
Google Cloud コンソールで、[BigQuery] ページに移動します。
[エクスプローラ] ペインで、プロジェクト ID の横にある [アクションを表示] をクリックし、[データセットを作成] をクリックします。
[データセット ID] フィールドに「
quickstart_data_profile」と入力します。[データのロケーション] リストで、[us-central1(アイオワ)] を選択します。
[データセットを作成] をクリックします。
クエリエディタで、次の SQL クエリを入力して、
bikeshare_tripsテーブルにサンプルの自転車シェアリング データを生成します。CREATE OR REPLACE TABLE `PROJECT_ID.quickstart_data_profile.bikeshare_trips` AS SELECT -- Duplicate and null IDs IF(MOD(x, 100) = 0, NULL, IF(x > 9900, 1000 + (x - 9900), 1000 + x)) AS trip_id, -- Nulls and unrecognized category values CASE WHEN MOD(x, 50) = 0 THEN 'INVALID_TIER' WHEN MOD(x, 25) = 0 THEN NULL WHEN MOD(x, 4) = 0 THEN 'Local Rider' WHEN MOD(x, 4) = 1 THEN 'Walk Up' WHEN MOD(x, 4) = 2 THEN 'Student Membership' ELSE 'Weekender' END AS subscriber_type, -- Nulls and malformed bike IDs CASE WHEN MOD(x, 60) = 0 THEN 'UNKNOWN' WHEN MOD(x, 30) = 0 THEN NULL ELSE CAST(2000 + x AS STRING) END AS bike_id, -- Null dates and future timestamps CASE WHEN MOD(x, 70) = 0 THEN NULL WHEN MOD(x, 40) = 0 THEN TIMESTAMP_ADD(CURRENT_TIMESTAMP(), INTERVAL x MINUTE) ELSE TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL x MINUTE) END AS start_time, -- Nulls and placeholder station values CASE WHEN MOD(x, 20) = 0 THEN 'STATION_UNKNOWN' WHEN MOD(x, 10) = 0 THEN NULL ELSE CAST(100 + MOD(x, 50) AS STRING) END AS start_station_id, -- Negative durations, zeros, and extreme outliers CASE WHEN MOD(x, 15) = 0 THEN -10.0 WHEN MOD(x, 35) = 0 THEN 0.0 WHEN MOD(x, 200) = 0 THEN 99999.0 ELSE CAST(MOD(x, 120) + 1.5 AS FLOAT64) END AS duration_minutes FROM UNNEST(GENERATE_ARRAY(1, 10000)) AS x;
PROJECT_IDは、実際の Google Cloud プロジェクト ID に置き換えます。[ 実行] をクリックします。
gcloud
Cloud Shell で、
us-central1リージョンにquickstart_data_profileデータセットを作成します。bq --location=us-central1 mk --dataset PROJECT_ID:quickstart_data_profile
PROJECT_IDは、実際のGoogle Cloud プロジェクト ID に置き換えます。bikeshare_tripsサンプル テーブルを作成してデータを入力します。bq query \ --use_legacy_sql=false \ "CREATE OR REPLACE TABLE \`PROJECT_ID.quickstart_data_profile.bikeshare_trips\` AS SELECT IF(MOD(x, 100) = 0, NULL, IF(x > 9900, 1000 + (x - 9900), 1000 + x)) AS trip_id, CASE WHEN MOD(x, 50) = 0 THEN 'INVALID_TIER' WHEN MOD(x, 25) = 0 THEN NULL WHEN MOD(x, 4) = 0 THEN 'Local Rider' WHEN MOD(x, 4) = 1 THEN 'Walk Up' WHEN MOD(x, 4) = 2 THEN 'Student Membership' ELSE 'Weekender' END AS subscriber_type, CASE WHEN MOD(x, 60) = 0 THEN 'UNKNOWN' WHEN MOD(x, 30) = 0 THEN NULL ELSE CAST(2000 + x AS STRING) END AS bike_id, CASE WHEN MOD(x, 70) = 0 THEN NULL WHEN MOD(x, 40) = 0 THEN TIMESTAMP_ADD(CURRENT_TIMESTAMP(), INTERVAL x MINUTE) ELSE TIMESTAMP_SUB(CURRENT_TIMESTAMP(), INTERVAL x MINUTE) END AS start_time, CASE WHEN MOD(x, 20) = 0 THEN 'STATION_UNKNOWN' WHEN MOD(x, 10) = 0 THEN NULL ELSE CAST(100 + MOD(x, 50) AS STRING) END AS start_station_id, CASE WHEN MOD(x, 15) = 0 THEN -10.0 WHEN MOD(x, 35) = 0 THEN 0.0 WHEN MOD(x, 200) = 0 THEN 99999.0 ELSE CAST(MOD(x, 120) + 1.5 AS FLOAT64) END AS duration_minutes FROM UNNEST(GENERATE_ARRAY(1, 10000)) AS x;"
データ プロファイル スキャンを作成して実行する
データ プロファイル スキャンでは、テーブル行を調べて、一意の値の数、null の割合、データ分布範囲などの統計情報を計算します。
コンソール
Google Cloud コンソールで、[データのプロファイリングと品質] ページに移動します。
[データ プロファイル スキャンの作成] をクリックします。
[タイプを選択] で、[データ プロファイル スキャン] を選択したままにします。
[全般] の [表示名] フィールドに「
bikeshare-trips-profile」と入力します。[スキャンするテーブル] の [テーブル] フィールドで、[参照] をクリックし、プロジェクトの
quickstart_data_profile.bikeshare_tripsテーブルを選択して、[選択] をクリックします。[モード] で [標準] を選択します。
[スコープ] で [データ全体] を選択します。
[スケジュール] で [オンデマンド] を選択します。
その他の設定はデフォルトのままにします。
[スキャンを実行] をクリックします。
スキャンジョブが開始されます。通常、Knowledge Catalog がスキャンを実行してテーブルの統計情報を計算するまでに 3 ~ 5 分かかります。
gcloud
Cloud Shell で、データ プロファイル スキャンを作成します。
gcloud dataplex datascans create data-profile bikeshare-trips-profile \
 --location=us-central1 \
 --data-source-resource="//bigquery.googleapis.com/projects/PROJECT_ID/datasets/quickstart_data_profile/tables/bikeshare_trips" \
 --description="Data profile scan for sample bikeshare dataset"
PROJECT_IDは、実際のGoogle Cloud プロジェクト ID に置き換えます。データ プロファイル スキャンを実行します。
gcloud dataplex datascans run bikeshare-trips-profile \
 --location=us-central1
スキャンジョブがバックグラウンドで開始されます。スキャンが完了するまでに通常 3 ~ 5 分かかります。
データ プロファイル スキャンの結果を確認する
スキャンが完了したら、列の統計情報を確認して、データの特性を把握します。
Google Cloud コンソールで、[データのプロファイリングと品質] ページに移動します。
スキャンのリストで、[bikeshare-trips-profile] をクリックします。
スキャンがまだ実行されていない場合は、[今すぐ実行] をクリックします。
[概要] セクションで、最新のスキャンジョブに [成功] が表示されるまで待ちます。
次の図は、[概要] セクションに [成功] ステータスが表示されたスキャンジョブを示しています。
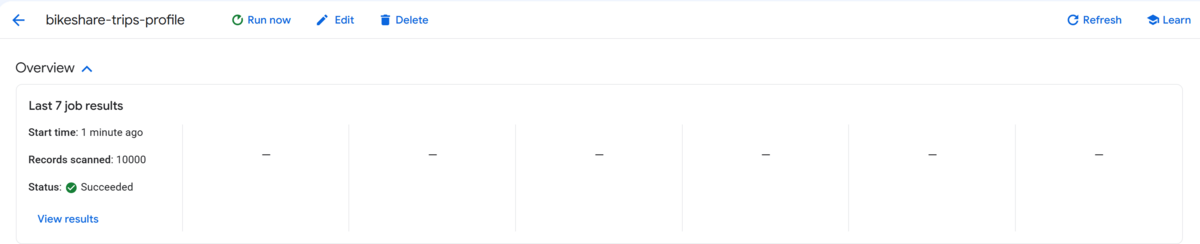
スキャン結果を調べて、テーブルのデータ分布を把握し、データ品質検証の対象となる可能性のあるものを特定します。[最新のジョブ結果] タブに、Knowledge Catalog は [Null の割合]、[一意の数と割合]、[上位の値]、[要約統計量] などの列レベルの指標を表示します。
次の表に、各テーブル列で確認するプロファイル指標、結果の解釈方法、ターゲットとするデータ品質ルールを示します。
テーブル列 プロファイル結果の指標 確認すべき点と解釈方法 データ品質検証のターゲット duration_minutes統計情報の概要 負の値が検出されました: 最小値は -10.0分です。ルートの経過時間は負の値にできません。負の値は、センサーまたは乗車記録が無効であることを示します。有効性(範囲)ルール( duration_minutes ≥ 1.0など)を使用して、乗車時間が正の値になるようにします。start_station_idNull % 約 5% の null 値: null の割合が 0% を超えているため、一部のレコードにステーション チェックアウト識別子がないことがわかります(ドックレスやキオスクレスの移動など)。 完全性(非 null)ルールを使用して、ステーション ID が欠落しているレコードをキャッチしてフラグを立てます。 subscriber_type上位の値 予期しないカテゴリ: 頻出値リストに、有効なメンバーシップ ティアとともに、標準以外のカテゴリ( INVALID_TIERなど)が表示されます。これは、検証されていないユーザー入力または取り込みの問題を示しています。Validity (Set) ルールをターゲットにして、すべての受信値が許可されたメンバータイプのリストに属するようにします。 trip_idユニーク数と割合(%) 重複する ID が検出されました: 一意性が 100% 未満(約 98%)であり、識別子レコードが重複していることを示しています。主キーと旅行 ID は 100% 一意である必要があります。 一意性ルールを使用して、重複するルートレコードにフラグを付け、防止します。
これらのプロファイル結果は、ターゲットを絞ったデータ品質ルールを作成するためのエビデンスに基づくベースラインとなります。
データ品質スキャンを作成して実行する
データの状態を把握したら、異常を検出する自動データ品質ルールを設定します。このステップでは、プロファイルの結果に基づいて 4 つの一般的なルールタイプを構成します。
コンソール
Google Cloud コンソールで、[データのプロファイリングと品質] ページに移動します。
[データ品質スキャンの作成] をクリックします。
[全般] の [表示名] フィールドに「
bikeshare-trips-quality」と入力します。[スキャンするテーブル] の [テーブル] フィールドで、[参照] をクリックし、
quickstart_data_profile.bikeshare_tripsテーブルを選択して、[選択] をクリックします。[スコープ] で [データ全体] を選択します。
[スケジュール] で [オンデマンド] を選択します。
その他の設定はデフォルトのままにして、[続行] をクリックします。
[データ品質ルール] セクションで、[ルールを追加] をクリックし、[組み込みルールタイプ] を選択します。
[ルールを追加] パネルで、列とルールの種類を選択します。
- [列を選択] フィールドで、[参照] をクリックし、
duration_minutes、start_station_id、subscriber_type、trip_idを選択します。 - [選択] をクリックします。
- [ルールの種類を選択] リストで、[範囲チェック]、[NULL チェック]、[値セットのチェック]、[一意性チェック] を選択し、[OK] をクリックします。
生成されたルールリストで、次の各ルールのチェックボックスをオンにします。
duration_minutes: 範囲チェックstart_station_id: NULL チェックsubscriber_type: 値セットのチェックtrip_id: 一意性チェック
[選択] をクリックします。
- [列を選択] フィールドで、[参照] をクリックし、
[データ品質ルール] テーブルで、値を必要とするルールのパラメータを構成します。
duration_minutes(範囲チェック)で、 [編集] をクリックし、[最小値] フィールドに「1.0」と入力して、[保存] をクリックします。subscriber_type(値セットのチェック)で、 [編集] をクリックし、[値を追加] をクリックして、許可される各値(Local Rider、Walk Up、Student Membership、Weekender)を追加し、[保存] をクリックします。
[続行] をクリックして [スキャンを実行] をクリックします。
gcloud
Cloud Shell で、プロファイルで見つかった異常をターゲットとするルール仕様を含む
dq_bikeshare.yamlという名前のファイルを作成します。cat << 'EOF' > dq_bikeshare.yaml rules: - column: trip_id dimension: UNIQUENESS uniquenessExpectation: {} - column: start_station_id dimension: COMPLETENESS nonNullExpectation: {} - column: duration_minutes dimension: VALIDITY rangeExpectation: minValue: "1.0" - column: subscriber_type dimension: VALIDITY setExpectation: values: - "Local Rider" - "Walk Up" - "Student Membership" - "Weekender" EOFデータ品質スキャンを作成します。
gcloud dataplex datascans create data-quality bikeshare-trips-quality \
 --location=us-central1 \
 --data-source-resource="//bigquery.googleapis.com/projects/PROJECT_ID/datasets/quickstart_data_profile/tables/bikeshare_trips" \
 --data-quality-spec-file="dq_bikeshare.yaml" \
 --description="Data quality scan for sample bikeshare dataset"
PROJECT_IDは、実際のGoogle Cloud プロジェクト ID に置き換えます。データ品質スキャンを実行します。
gcloud dataplex datascans run bikeshare-trips-quality \
 --location=us-central1
データ品質ルールの評価を確認する
データ品質の結果を確認して、ルールがサンプルデータを評価し、異常を特定した方法を確認します。
Google Cloud コンソールで、[データのプロファイリングと品質] ページに移動します。
[スキャン] テーブルで、[bikeshare-trips-quality] スキャンをクリックします。
[概要] セクションで、[結果を表示] をクリックしてジョブの詳細を開きます。
[ジョブの詳細] パネルで、評価結果を確認します。
データ品質ステータス: 予想どおり、評価された 3 つのディメンションすべてに失敗のステータスが表示されます。
- 有効性: 失敗。
duration_minutes列に負の値が含まれており、subscriber_typeに無効なメンバーシップ値(INVALID_TIER)が含まれています。 - 完全性: 失敗。
start_station_id列に null 値が含まれています。 - 一意性: 失敗。
trip_id列に重複するレコードが含まれています。
- 有効性: 失敗。
ルール: [ルール] テーブルに、評価された 4 つのルールがすべて [失敗] のステータスで表示されます。
duration_minutes: 範囲チェック(失敗)start_station_id: NULL チェック(失敗)subscriber_type: 値セットのチェック(失敗)trip_id: 一意性チェック(失敗)
失敗したルールについては、[失敗したレコードを取得するクエリ] 列の SQL クエリをコピーして BigQuery で実行し、無効な行を分離して検査できます。
BigQuery テーブルをプロファイリングして列の統計情報を検出し、それらの分析情報を使用して自動データ品質ルールを定義して検証しました。
クリーンアップ
このページで使用したリソースについて、 Google Cloud アカウントに課金されないようにするには、次の手順を実施します。
コンソール
Google Cloud コンソールで、[データのプロファイリングと品質] ページに移動します。
[スキャン] テーブルで、[bikeshare-trips-quality] と [bikeshare-trips-profile] を選択します。
[削除] をクリックして、確定します。
[BigQuery] ページに移動します。
[エクスプローラ] ペインで [データセット] をクリックします。
quickstart_data_profileデータセットを選択し、[削除] をクリックします。
gcloud
Cloud Shell で、データ品質スキャン、データ プロファイル スキャン、サンプル データセットを削除します。
gcloud dataplex datascans delete bikeshare-trips-quality --location=us-central1 --quiet
gcloud dataplex datascans delete bikeshare-trips-profile --location=us-central1 --quiet
bq rm -r -f -d PROJECT_ID:quickstart_data_profile
PROJECT_ID は、実際のGoogle Cloud プロジェクト ID に置き換えます。