


Mit Knowledge Catalog (ehemals Dataplex Universal Catalog) können Sie technische Strukturen, Geschäftskontext, Messwerte zur Datenqualität und operative Beziehungen in Ihrem verteilten Datenbestand automatisch erkennen und indexieren. Knowledge Catalog organisiert diese Metadaten in einem flexiblen, erweiterbaren Metamodell und einem aktiven Kontextgraphen, mit dem Sie Daten-Assets verwalten und generative KI-Agenten fundieren können.
Knowledge Catalog-Metamodell
Das Knowledge Catalog-Metamodell bietet eine einheitliche, strukturierte Metadatenverwaltung und bildet die strukturelle Grundlage des Active Context Graph in der Agentische Daten-Cloud von Google. Dieser Kontextgraph hilft Ihnen und Ihren Datenteams, Assets zu erkennen und zu verwalten, und ermöglicht es generativen KI-Agenten, fundierten, vertrauenswürdigen Geschäftskontext abzurufen.
Knowledge Catalog organisiert Metadaten über eine modulare Hierarchie von Containern, Assets, Schemas und Beziehungen:
- Container und Assets: Mit Eintraggruppen werden Einträge organisiert, die einzelne Daten-Assets und ihre Schemaspalten darstellen.
- Strukturierte Anreicherung: Aspekttypen definieren Schemas für Aspekte, die Einträgen, Spalten oder Beziehungen strukturierte Metadaten hinzufügen.
- Standards und Governance: Eintragstypen definieren Vorlagen, die erforderliche Aspekte für Einträge erzwingen.
- Beziehungen: Eintrag-Linktypen definieren Beziehungen (Eintragslinks), die verwandte Einträge und Geschäftsbegriffe verbinden.
In der folgenden Tabelle werden die Unterschiede zwischen systemverwalteten Ressourcen (automatisch von Google Cloudbereitgestellt) und benutzerdefinierten Ressourcen zusammengefasst:
| Metamodell-Element | Vom System verwaltet (integriert) | Benutzerdefiniert |
|---|---|---|
| Eintragsgruppen | Vordefiniert pro Projekt für Google Cloud -Dienste (z. B. @bigquery, @spanner, @pubsub). |
Wird von Nutzern erstellt, um benutzerdefinierte Daten-Assets und Berechtigungen zu gruppieren und zu verwalten. |
| Einträge | Wird automatisch aus Google Cloud -Quellen (z. B. BigQuery-Tabellen, -Ansichten, -Datasets und -Modellen) ausgefüllt. | Werden von Nutzern erstellt, um benutzerdefinierte Datenquellen, Dateien oder Datenbanken von Drittanbietern darzustellen. |
| Aspekttypen | Vordefinierte Systemvorlagen (z. B. Schema, Overview, Contacts, DataQuality, Lineage). |
Wird von Nutzern erstellt, um domainspezifische Metadatenschemas zu definieren (z. B. Klassifizierung personenidentifizierbarer Informationen oder SLA-Stufen). |
| Aspekte | Wird automatisch aus Quellsystemen, Abfragelogs oder automatisierten Scans ausgefüllt. | Werden von Nutzern, Pipelines oder KI-Agenten erstellt und an Einträge, Spalten oder Eintragslinks angehängt. |
| Eintragstypen | Vordefinierte Vorlagen für Google Cloud Ressourcentypen. | Wird von Nutzern definiert, um obligatorische und optionale Aspekte für benutzerdefinierte Daten-Assets anzugeben. |
| Einstiegslinks | Integrierte Beziehungstypen (z. B. synonym, definition, schema-join, related). |
Instanzen, die zwischen bestimmten Einträgen oder Spalten erstellt werden, um systemübergreifende Verbindungen zu modellieren. |
In den folgenden Abschnitten werden die Hauptkomponenten des Knowledge Catalog-Metamodells beschrieben.
Eintragsgruppen
Eine Eintragsgruppe (EntryGroup) ist ein regionaler Container für Einträge und Eintragslinks, der als Verwaltungs- und Sicherheitsgrenze für die Verwaltung dieser Ressourcen dient.
Mit Eintraggruppen können Sie Folgendes konfigurieren:
- Zugriffssteuerung mit Identity and Access Management: Gewähren Sie bestimmten Teams Lese- oder Bearbeitungsberechtigungen für eine Eintragsgruppe, ohne die Berechtigungen für einzelne Einträge zu ändern.
- Standort- und Projektzuordnung: Gruppieren Sie Assets nach geografischer Region und Projektinhaberschaft.
Für Google Cloud -Quellen erstellt Knowledge Catalog automatisch Systemeintragsgruppen pro Projekt (z. B. @bigquery oder @spanner). Für benutzerdefinierte Datenquellen erstellen Sie benutzerdefinierte Eintragsgruppen.
Ein Finanzteam kann beispielsweise eine benutzerdefinierte Eintraggruppe mit dem Namen production_finance_data erstellen, um Zugriffsberechtigungen für alle finanzbezogenen benutzerdefinierten Einträge an einem einzigen Ort zu verwalten.
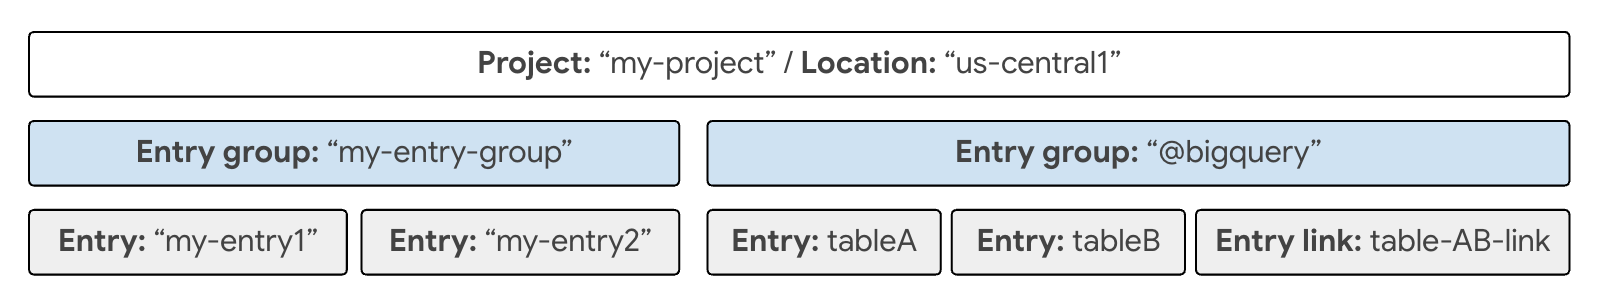
Weitere Informationen finden Sie unter Eintragsgruppen.
Einträge und Schemapfade
Ein Eintrag (Entry) stellt ein einzelnes Daten-Asset dar. Ein Eintrag kann eine strukturierte Datenbanktabelle, ein analytisches Modell, eine unstrukturierte Objekttabelle oder ein benutzerdefiniertes externes Dataset darstellen.
Zu den wichtigsten Komponenten eines Eintrags gehören:
- Eintrags-ID: Ein eindeutiger Ressourcenname innerhalb der übergeordneten Eintragsgruppe.
- Eintragstyp: Die Vorlage, die die Struktur und die erforderlichen Aspekte des Eintrags definiert.
- Aspekte: Strukturierte Metadatenattribute, die an den Eintrag angehängt sind.
- Schemapfade (Spalten): Bestimmte Unterabschnitte oder Felder innerhalb des Daten-Assets, z. B. eine Spalte in einer BigQuery-Tabelle oder ein Feld in einem JSON-Schema.
Mit Spalten können Sie Metadaten an einzelne Felder in einem Asset anhängen. Sie definieren Spalten nicht manuell. Sie werden ausgefüllt, wenn Sie einen Aspekt vom Typ schema an einen Eintrag anhängen. Sie können auf verschachtelte Felder mit Punktnotationspfaden verweisen (z. B. customer.address.postal_code).
Eine BigQuery-Tabelle mit dem Namen orders_project.sales.customer_orders wird beispielsweise als Eintrag dargestellt. Wenn Sie das Feld email_address in dieser Tabelle als vertrauliche Informationen beschreiben möchten, hängen Sie einen Klassifizierungsaspekt direkt an den Spaltenpfad email_address an.
Weitere Informationen finden Sie unter Einträge.
Aspekttypen
Ein Aspekttyp (AspectType) ist eine wiederverwendbare Schemavorlage, die die Felder, Datentypen und Validierungsregeln für einen Aspekt definiert. Jeder Aspekt ist eine Instanz eines Aspekttyps.
Aspekttypen können systemdefiniert (von Google Cloudbereitgestellt) oder benutzerdefiniert (von Ihrer Organisation erstellt) sein.
Wenn Sie den metadata_template für einen benutzerdefinierten Aspekttyp definieren, können Sie die folgenden unterstützten Datentypen verwenden:
| Datentyp des Felds | Beschreibung | Anwendungsbeispiel |
|---|---|---|
string |
Textwert (UTF-8). | E‑Mail-Adresse des Inhabers, Datenklassifizierungslabel, Abteilungsname. |
integer/number |
Numerische Werte (Ganzzahlen oder Gleitkommazahlen). | Tage der Datenaufbewahrung, SLA-Zielprozentsatz, Prioritätsrang. |
boolean |
Flag „True“ oder „False“. | contains_pii: true, is_certified: false. |
enum |
Eine vordefinierte Liste zulässiger Stringwerte. | Umgebung: ["DEV", "STAGING", "PROD"]. |
datetime/timestamp |
Datum und Uhrzeit im ISO 8601-Format. | Datum der letzten Zertifizierung, Frist für die Compliance-Überprüfung. |
record |
Ein verschachteltes strukturiertes Objekt, das untergeordnete Felder enthält. | ContactInfo { name: string, email: string, phone: string }. |
array |
Eine Liste wiederholter Werte eines beliebigen primitiven Typs oder Datensatztyps. | Liste der sekundären Dateninhaber: ["user1@example.com", "user2@example.com"]. |
map |
Schlüssel/Wert-Stringpaare für erweiterbare Attribute. | Benutzerdefinierte Bereitstellungs-Tags: {"cost_center": "1042", "tier": "gold"}. |
Wenn Sie beispielsweise eine wiederverwendbare Vorlage für Kontaktdaten definieren möchten, können Sie einen Aspekttyp mit dem Namen ContactInfo mit Feldern für owner_name (string), email (string) und support_channel (string) erstellen.

Weitere Informationen finden Sie unter Aspekttypen.
Aspekte
Ein Aspekt (Aspect) ist eine Gruppe von zugehörigen Metadatenfeldern, die einem Aspekttyp entsprechen. Aspekte werden an einen Eintrag, einen Eintragspfad (Spalte) oder einen Eintragslink angehängt, um diese Ressource zu beschreiben.
Im Gegensatz zu herkömmlichen Tagging-Systemen sind Aspekte in Knowledge Catalog direkt in ihren übergeordneten Einträgen oder Eintragslinks gekapselt. So können Sie atomare Lese- und Schreibvorgänge ausführen.
Aspekte werden in mehreren Funktionen verwendet:
- Technische Struktur: Der Aspekt
Schemabeschreibt Tabellenspalten, Datentypen und Beschreibungen. - Geschäftskontext: Benutzerdefinierte Aspekte beschreiben Inhaberschaft, Compliance und Lebenszyklusstatus.
- Betriebliches Vertrauen: Datenqualitätsaspekte erfassen Ergebnisse automatisierter Regelscans und Validierungswerte.
- Unstrukturierte Entitätsgraphen: Der Aspekt
GraphProfileerfasst KI-extrahierte Entitäten und Beziehungskanten aus Rohdateien.
Sie können beispielsweise eine Instanz des Aspekttyps ContactInfo mit den Werten {"owner_name": "Alex", "email": "alex@example.com"} erstellen und an den Eintrag customer_orders anhängen.
Weitere Informationen finden Sie unter Aspekte.
Eintragstypen
Ein Eintragstyp (EntryType) ist eine Governance-Vorlage zum Erstellen benutzerdefinierter Einträge. Er erzwingt Metadaten-Qualitätsstandards, indem er die erforderlichen Aspekttypen festlegt, die an einen Eintrag dieses Typs angehängt werden müssen.
Wenn Sie einen Eintrag eines bestimmten Eintragstyps erstellen, prüft Knowledge Catalog, ob alle im Eintragstyp als required markierten Aspekttypen vorhanden und gültig sind.
Sie können beispielsweise einen Eintragstyp mit dem Namen CertifiedDataProduct erstellen, der die Aspekttypen OwnerInfo und DataRetentionPolicy als erforderlich angibt. Jeder neue Eintrag, der mit diesem Eintragstyp erstellt wird, muss diese Aspekte enthalten, bevor Sie ihn speichern können.
Weitere Informationen finden Sie unter Eintragstypen.
Eintragslinks und Eintragslinktypen
Ein Eintragslink (EntryLink) stellt eine semantische Beziehung zwischen zwei Dateneinträgen oder zwischen bestimmten Spalten innerhalb von Einträgen her. Jeder Eintragslink ist eine Instanz eines Eintragslinktyps (EntryLinkType).
Eintragslinks können gerichtet oder ungerichtet sein:
- Symmetrisch (nicht gerichtet): Beziehungen, bei denen beide Seiten gleichrangig sind (z. B.
synonym,relatedoderschema-join). - Asymmetrisch (gerichtet): Beziehungen mit einer expliziten Quelle und einem expliziten Ziel (z. B.
definition, wobei ein Begriff aus dem Unternehmensglossar mit einer Tabellenspalte verknüpft wird).
Sie können Aspekte auch direkt an Eintragslinks anhängen (außer an schema-join-Links). So können Sie die Beziehung selbst beschreiben, z. B. durch Aufzeichnen von Konfidenzwerten für die Verknüpfung, Transformationsregeln oder Zuordnungshinweisen.
Knowledge Catalog unterstützt die folgenden integrierten Eintragstypen:
synonym: Verbindet äquivalente Geschäftskonzepte oder alternative Begriffe.related: Verbindet lose gekoppelte Assets über Systeme hinweg.definition: Verbindet Definitionen des Unternehmensglossars mit physischen Spalten oder Einträgen.schema-join: Verbindet Tabellen, die über übereinstimmende Fremdschlüssel- oder Schemapfade verknüpft werden können.

Weitere Informationen finden Sie in der REST-Referenz zu EntryLinks.
Unternehmensglossare und ‑begriffe
Mit einem Unternehmensglossar können Sie eine formale Geschäftstaxonomie erstellen, indem Sie Glossare, Kategorien und Geschäftsbegriffe definieren.
Mit Eintragslinks vom Typ definition oder synonym können Sie Geschäftsbegriffe direkt physischen Einträgen und Spaltenpfaden zuordnen. Wenn Nutzer oder KI-Agenten den Katalog in natürlicher Sprache durchsuchen, löst die Suchmaschine diese Geschäftsbegriffe auf, um die richtigen physischen Daten-Assets zu finden.
Weitere Informationen finden Sie unter Unternehmensglossare verwalten.
Unterstützte Google Cloud -Quellen
Knowledge Catalog nimmt automatisch Metadaten aus den folgendenGoogle Cloud -Quellen auf. Bei einigen Diensten wie AlloyDB for PostgreSQL und Cloud SQL müssen Sie zuerst die Knowledge Catalog-Integration aktivieren, bevor Metadaten aufgenommen werden können:
Analyse und Lakehouse
- BigQuery-Datasets, -Tabellen, -Ansichten, -Modelle, -Routinen, -Verbindungen, verknüpfte Datasets und Diagramme (Vorschau)
- BigQuery Sharing-Austausche und -Einträge (früher Analytics Hub)
- Dataform-Repositories und Code-Assets
- Dataproc Metastore-Dienste, -Datenbanken und -Tabellen
Iceberg REST Catalog-Tabellen (einschließlich Google Cloud Lakehouse-Laufzeitkatalog-IRC, Databricks Unity-IRC, AWS Glue Data Catalog-IRC und Snowflake Horizon-IRC)
Apache Hive-Tabellen
Delta Lake-Tabellen in SAP Business Data Cloud (BDC)
Apache Iceberg-Tabellen, die vom Lakehouse-Laufzeitkatalog verwaltet werden
KI und maschinelles Lernen
- Vertex AI-Modelle, -Datasets, -Featuregruppen, -Featureansichten und -Onlinespeicherinstanzen
Business Intelligence
- Looker (Google Cloud Core)-Instanzen, Dashboards, Dashboard-Elemente, Looks, LookML-Dashboards, LookML-Dashboard-Elemente, LookML-Projekte, Modelle, Explores, Ansichten und KI-Agenten
Datenbanken
- Bigtable-Instanzen, -Cluster und -Tabellen (einschließlich Details zur Spaltenfamilie)
- Spanner-Instanzen, ‑Datenbanken, ‑Tabellen und ‑Ansichten
Streaming und Messaging
- Pub/Sub-Themen
Unstrukturierte Daten
Operative Datenbanken
- AlloyDB for PostgreSQL-Cluster, -Instanzen, -Datenbanken, -Schemas, -Tabellen und -Ansichten (Vorabversion). Knowledge Catalog ruft Metadaten nur aus primären AlloyDB-Instanzen, nicht aus Lesereplikaten ab. Weitere Informationen finden Sie unter AlloyDB for PostgreSQL-Ressourcen mit Knowledge Catalog verwalten.
- Cloud SQL-Instanzen, -Datenbanken, -Schemas, -Tabellen, -Ansichten. Knowledge Catalog ruft Metadaten nur aus primären Cloud SQL-Instanzen, nicht aus Lesereplikaten ab. Weitere Informationen finden Sie unter Cloud SQL-Ressourcen mit Knowledge Catalog verwalten.
Wenn Sie Metadaten aus einer Drittanbieterquelle in Knowledge Catalog importieren möchten, können Sie Knowledge Catalog-Connectors oder eine Pipeline für verwaltete Verbindungen verwenden. Weitere Informationen finden Sie unter Knowledge Catalog-Connectors und Übersicht über verwaltete Verbindungen.
Projekt- und Standorteinschränkungen
Katalogressourcen im Knowledge Catalog werden in bestimmten Google Cloud -Projekten und an bestimmten geografischen Standorten gespeichert. Es gelten die folgenden Bereichseinschränkungen:
| Ressource | Standortregel | Projektregel |
|---|---|---|
| Einträge | Der Standort des Eintrags muss mit dem Standort des EntryType übereinstimmen oder der EntryType muss global sein. |
Kann auf globale Eintragstypen oder Eintragstypen im selben Projekt verweisen. |
| Aspekte für Einträge | Der AspectType des Aspekts muss am selben Standort wie der Eintrag gespeichert werden oder der AspectType muss global sein. |
Kann auf globale oder projektinterne Aspekttypen verweisen. |
| Einstiegslinks | Der Speicherort des Eintragslinks muss mit seinem EntryLinkType übereinstimmen oder der EntryLinkType muss global sein. |
Kann Einträge verknüpfen, die sich in verschiedenen Projekten innerhalb derselben Organisation befinden. |
| Eintragstypen | Besteht aus Aspekttypen, die am selben Ort wie der Eintragstyp gespeichert sind, oder aus Aspekttypen, die global sind. |
Wenn ein Eintragstyp auf benutzerdefinierte Aspekttypen verweist, müssen sich die Aspekttypen im selben Projekt und am selben Standort befinden. |
Feeds für Metadatenänderungen
Knowledge Catalog kann Metadatenänderungsereignisse mithilfe von Metadatenänderungsfeeds nahezu in Echtzeit streamen.
Ein Änderungsfeed für Metadaten veröffentlicht Benachrichtigungen über das Erstellen, Aktualisieren oder Löschen von Einträgen in einem von Ihnen konfigurierten Pub/Sub-Thema. Abonnentenclients können diese Ereignisse nutzen, um operative Workflows zu automatisieren, z. B. um Datenqualitätsbewertungen auszulösen, wenn sich ein Schema ändert, oder um nachgelagerte Governance-Dashboards zu aktualisieren.
Weitere Informationen finden Sie unter Metadaten-Änderungsfeeds.
Preise
Knowledge Catalog verwendet die SKU für Metadatenspeicher, um das gespeicherte Metadatenvolumen abzurechnen. Weitere Informationen finden Sie unter Knowledge Catalog – Preise.
Für Folgendes fallen keine Gebühren an:
- Katalogmetamodell-Ressourcen (Eintragstypen, Aspekttypen, Eintragsgruppen, Einträge und Eintragslinks) erstellen und verwalten.
- Such-API-Aufrufe und Suchanfragen, die in der Google Cloud Console ausgeführt werden.
Nächste Schritte
Metadaten zu einer Tabelle hinzufügen
Assets erkennen und benutzerdefinierte Aspektmetadaten an eine BigQuery-Tabelle anhängen.
Benutzerdefinierte Datenquellen aufnehmen
Eintragstypen definieren und benutzerdefinierte Metadaten aus externen Datenbanken und Pipelines aufnehmen.
Unternehmensglossare verwalten
Erstellen Sie eine Geschäftstaxonomie und ordnen Sie Begriffe direkt physischen Tabellen und Spalten zu.
Assets suchen und entdecken
Ressourcen in Google Cloud und benutzerdefinierten Quellen mithilfe von Suchprädikaten finden.
Kontext für KI-Agenten abrufen
LLM-fähige Metadaten und aktiven Kontext abrufen, um generative KI-Agenten zu fundieren.