


Mit der Datenherkunft in Knowledge Catalog (ehemals Dataplex Universal Catalog) können Sie nachvollziehen, wie sich Datentransformationen auf nachgelagerte Ressourcen und die davon abhängigen Workflows auswirken. Wenn Sie Abhängigkeiten auf Spaltenebene verfolgen, bevor Sie Tabellen ändern, können Sie die Datenintegrität prüfen und feststellen, ob vorhandene Pipelines angepasst werden müssen.
In dieser Anleitung verwalten Sie eine Datenbank, in der Datensätze zur Nutzung verschiedener Dienste eines Gesundheitsdienstleisters gespeichert werden. Damit die Daten einfacher zu verwenden sind, durchsuchen Sie die Tabellen, um potenzielle Änderungen zu identifizieren. Bevor Sie die Änderungen implementieren, verwenden Sie den BigQuery-Lineage Explorer, um Spalten zu untersuchen, Änderungen an Datentypen zu prüfen und festzustellen, ob sich Verbesserungen auf vorhandene Workflows auswirken oder zusätzliche Anpassungen erfordern.
Jetzt starten
Um den Anwendungsfall abzuschließen, richten Sie zuerst die Umgebung ein und führen Sie die Datentransformationen aus. Auf der Seite Voraussetzungen und Einrichtung können Sie ein Remote-Repository mit Dataform verbinden. Dieses Repository enthält den Code, der zum Einrichten des Datasets und zum Transformieren der Daten erforderlich ist.
Nachdem Sie die Umgebung eingerichtet haben, können Sie mit BigQuery und dem Lineage Explorer Datentransformationen und deren Auswirkungen auf die Workflows verfolgen.
Datentransformationen mit Lineage Explorer analysieren
Nachdem Sie das Dataset vorbereitet haben, analysieren Sie die Auswirkungen der Datentransformation auf dem BigQuery-Tab Herkunft.
Datenintegrität von Spalten mit Herkunftsdiagrammen prüfen
Sehen Sie sich in diesem Beispiel die Spalte medicare_participation_indicator an, die angibt, ob ein Arzt oder Anbieter bereit ist, Dienstleistungen für Medicare zu erbringen. Das Herkunftsdiagramm zeigt, wie Datentransformationen zwischen den abgeleiteten Tabellen zu Änderungen des Spaltendatentyps führen:
- Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
- Suchen Sie über das Suchfeld nach der Tabelle
physicians_and_other_supplier_2012_original. - Klicken Sie auf den Tab Lineage.
- Führen Sie im Bereich Lineage Explorer die folgenden Schritte aus:
- Wählen Sie im Abschnitt Spaltenspezifische Herkunft den Spaltennamen
medicare_participation_indicatoraus der Liste aus. - Wählen Sie im Bereich Richtung die Option Downstream aus.
- Klicken Sie auf Übernehmen.
- Wählen Sie im Abschnitt Spaltenspezifische Herkunft den Spaltennamen
- Maximieren Sie den Herkunftspfad, bis Sie
vertex_ai_model_final_featureserreichen. Analysieren Sie die Pfadänderungen zwischen der Tabelle
supplier_stg3und der Tabellesupplier_transform1: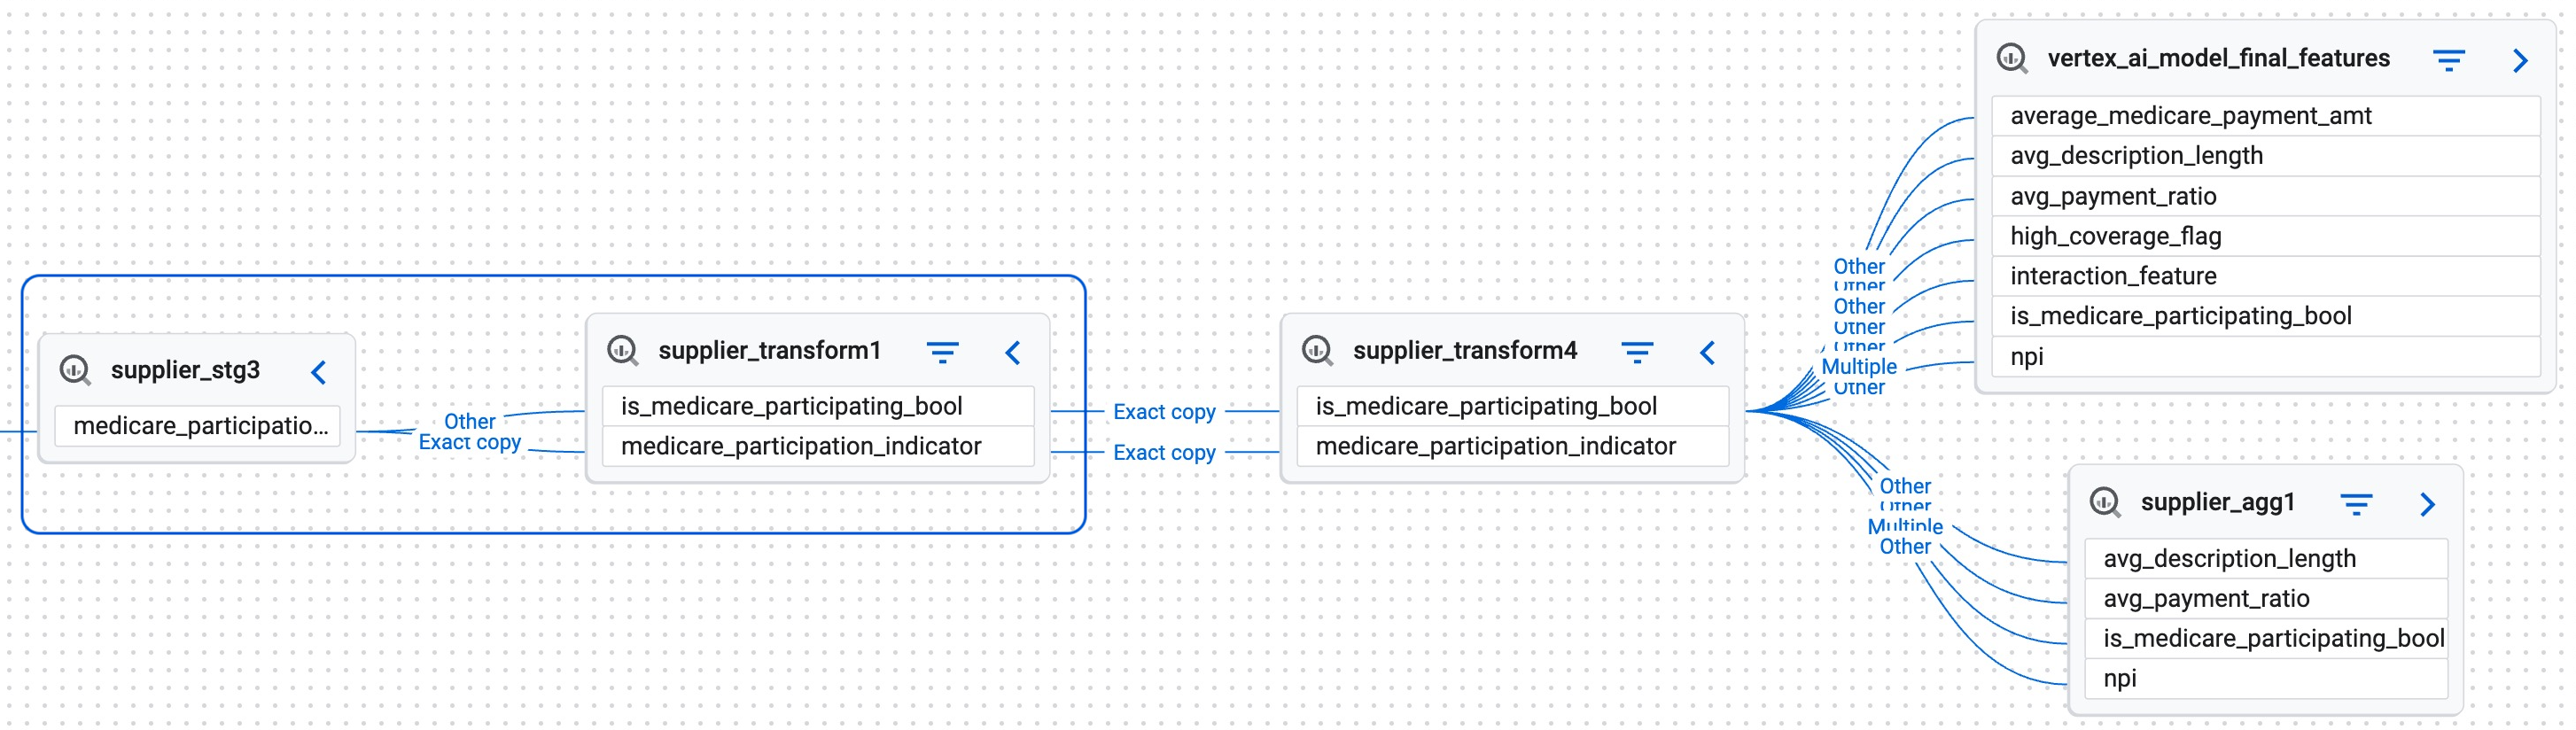
Visualisierung des Lineage-Trackings für die Spalte medicare_participation_indicator- Die Pfadmarkierung Exakte Kopie gibt an, dass die Spalte unverändert weitergegeben wird.
- Die Pfadmarkierung Sonstiges weist auf eine Transformation hin. In diesem Pfad wird der Datentyp
StringwieBooleanbehandelt.
Der Pfad zeigt, dass sich die Datentypen der Spalten ändern, was möglicherweise Anpassungen in den Workflows erfordert, die diese Tabellen verwenden.
Redundante nachgelagerte Spalten identifizieren
In diesem Beispiel wird die Spalte nppes_credentials untersucht, in der die National Provider Identifier (NPIs) der Ärzte im National Plan and Provider Enumeration System (NPPES) aufgeführt sind:
- Rufen Sie in der Google Cloud Console die Seite BigQuery auf.
- Suchen Sie über das Suchfeld nach der Tabelle
physicians_and_other_supplier_2012_original. - Klicken Sie auf den Tab Lineage.
- Führen Sie im Bereich Lineage Explorer die folgenden Schritte aus:
- Wählen Sie im Abschnitt Spaltenspezifische Herkunft den Spaltennamen
nppes_credentialsaus der Liste aus. - Wählen Sie im Bereich Richtung die Option Downstream aus.
- Klicken Sie auf Übernehmen.
- Wählen Sie im Abschnitt Spaltenspezifische Herkunft den Spaltennamen
- Erweitern Sie den Pfad, um zu prüfen, ob eine nachgelagerte Herkunft zu
vertex_ai_model_final_featuresführt.
Wenn keine Herkunft vorhanden ist, ist diese Spalte in diesem Workflow möglicherweise nicht relevant und kann sogar gelöscht werden.
Weitere Informationen zur Visualisierung von Daten mit einem Datenherkunftsdiagramm finden Sie unter Herkunftsdiagrammansicht.