


Knowledge Studio(预览版)可将元数据转换为活跃的上下文引擎,帮助您提高生成式 AI 应用的可靠性。您可以使用 Knowledge Studio,通过将 AI 智能体(例如 BigQuery 和 Gemini 中的对话式分析)与您的业务背景相结合,防止其产生幻觉。
Knowledge Studio 通过整合来自架构、Wiki 和过往 SQL 查询的零散知识,实现元数据精选自动化。您可以使用自然语言探索数据,浏览将数据资产与业务语义连接起来的可视化上下文图,并运行自动工作流来起草目录更新以供人工审核。然后,您可以使用 Model Context Protocol (MCP) 或 Knowledge Catalog API 将这些精选上下文块动态提供给智能体。
本文档面向希望了解 Knowledge Studio 工作原理的数据架构师、治理主管和 AI 工程师。
从被动目录到主动内容相关引擎
典型的元数据目录会存储静态架构、说明和数据字典。虽然静态元数据足以满足人类数据分析师搜索表的需求,但对于需要以下内容的生成式 AI 智能体来说,静态元数据是不够的:
深层语义关系:了解表如何跨架构联接、哪些列代表关键业务指标,以及业务术语库如何映射到底层存储。
运营接地:将实际 SQL 使用模式、查询频率以及实际智能体提示和回答纳入上下文。
持续自我学习:根据用户反馈和代理执行成功率,自动优化表说明、切面和列定义。
Knowledge Studio 通过一个常年运行的上下文引擎提供这些功能,该引擎会持续挖掘运营信号、生成高保真元数据建议,并通过 Model Context Protocol (MCP) 或 Knowledge Catalog API 向智能体提供预先格式化的上下文块。
Knowledge Studio 界面
Knowledge Studio 将您的工作流分为三个主要区域:
新对话:对话式聊天界面和交互式上下文图,用于使用自然语言进行数据发现、调查和语义查询验证。如需了解详情,请参阅探索数据资产。
上下文集:一个用于创建和管理逻辑容器(条目组)的界面,这些容器可封装丰富元数据,以便安全地为下游 AI 智能体提供依据。如需了解详情,请参阅管理上下文集。
丰富:一个控制中心,用于自动生成元数据、配置评估基准,并通过人机协同整理工作流审核 AI 提出的目录更新(变更请求)。如需了解详情,请参阅关于丰富任务。
真实的多产品场景
Knowledge Studio 可连接您的数据仓库、企业知识库和生成式 AI 应用。以下场景说明了 Knowledge Studio 如何在企业架构中的多个产品之间运行。
在 BigQuery 中建立自然语言查询
挑战:业务分析师在对话式分析中使用自然语言提出问题,例如“上个季度我们按区域划分的净留存率是多少?”如果没有精选的业务语义,模型可能会产生幻觉,误判联接键或将总预订量误认为净收入。
Knowledge Studio 解决方案:分析师使用新对话界面验证销售暂存表与经过认证的
SZBank Business Glossary之间的关系。Knowledge Studio 使用活跃上下文图表来建立对话分析,确保生成的 SQL 包含经过验证的联接条件和标准 KPI 公式。
根据企业 SOP 丰富元数据
挑战:数据工程团队在 BigQuery 中维护着数十个数据集,而关键业务规则和流水线沿袭信息则分散在外部 Confluence Wiki 或 Jira 工单中。随着架构的演变,目录文档会过时。
Knowledge Studio 解决方案:治理主管配置一个针对分析数据集的周期性丰富任务。Knowledge Studio 会从 Confluence 提取非结构化 SOP,并从 Cloud Logging 提取历史查询日志,从而自动提出更新后的列定义和表关系。管理员在运行详情页面中检查提议的差异,并批准对目录的已验证更新。
为智能体提供精选背景信息
- 挑战:AI 开发者在使用 LangChain 或 ADK 构建面向客户的支持或咨询智能体时,需要获取最新的架构语义,而无需硬编码数据库凭据或在提示中塞入大量表定义。
- Knowledge Studio 解决方案:Knowledge Studio 会将精选元数据和经过验证的联接图捕获到上下文集(例如
entryGroups/customer-360)中。如需访问上下文,智能体可以通过 Model Context Protocol (MCP) 连接到 Knowledge Studio,也可以使用 Knowledge Catalog API。在推理时,智能体会查询 MCP 端点或目录 API,以动态检索与用户意图相关的经过认证的业务上下文和示例查询。
架构概览
下图展示了 Knowledge Studio 组件如何与数据资产、基础模型和使用 AI 的应用进行交互:
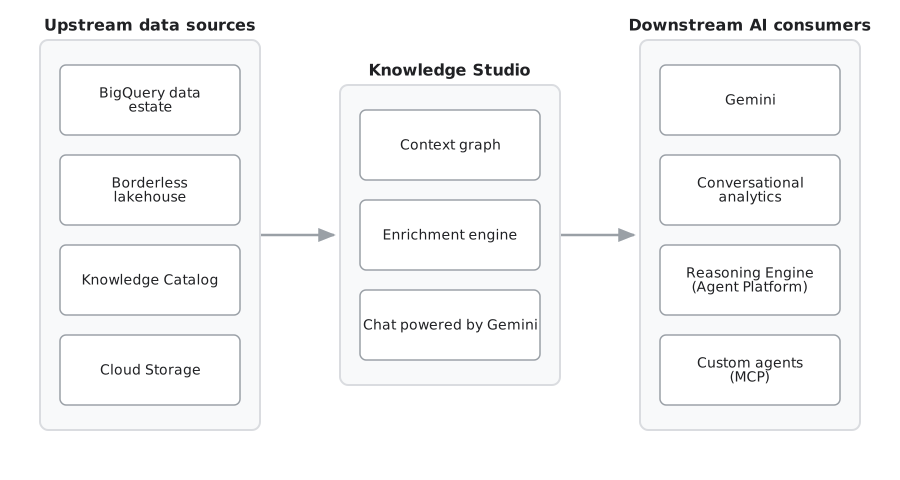
核心概念
如需有效使用 Knowledge Studio,请了解企业元数据是如何建模、打包和整理的。
上下文图表
上下文图是 Knowledge Studio 中的核心交互式可视化拓扑。它将数据资产(例如 BigQuery 表、视图和湖仓一体)与业务语义(例如业务术语库术语、指标公式和数据产品)统一起来。在典型的目录中,数据表及其关联的业务术语库定义存在于不同的孤岛中。在上下文图表中,它们作为节点存在于
同一画布上。数据分析师和工程师可以通过推断的使用情况、表上的联接条件等直观地查看数据之间的关系,而 Gemini 则使用该图来支持自然语言探索。如需了解详情,请参阅在 Knowledge Studio 中探索数据资产。
上下文图谱支持的资源和连接类型
上下文图支持将以下 Knowledge Catalog 资源呈现为节点或容器:
- 表和视图:技术 BigQuery 和 Lakehouse 表、视图、数据集和目录。
- 数据库和存储:运营数据库(例如 Spanner 和 AlloyDB)以及 Cloud Storage 资源。
- 分析和建模:Looker 项目和 dbt 模型、测试和曝光。
- 术语表术语:业务术语表中的各个业务定义。
- 数据产品:精选的数据资产包,供跨团队使用。
- 上下文:自定义上下文集和附加文档。
- 自定义资产:自定义条目组和不受支持的条目类型。
该图通过直观呈现以下语义关系边缘,定义了这些资源的连接方式:
架构联接:表之间的结构和操作联接关系。系统会自动扫描 BigQuery 作业,查找表明不同表中的列具有相同含义且可以联接在一起的查询。
定义:将技术数据资产或列映射到其对应的业务术语库定义的链接。
上下文:将专用上下文集或自定义网域文档归因于目标数据资产的链接。
软件包:聚合链接,显示哪些数据资产捆绑到特定数据产品中。
条目链接
条目链接表示上下文图中的有向或无向语义边。这些链接会在画布上直观地连接您的数据资产和其他统一资源。您可以选择性地过滤这些链接,以隔离整个数据资产中的特定关系。
条目链接可连接企业中的不同实体:
定义链接:将底层表列直接连接到经过认证的业务术语库术语和 KPI 公式。
关系链接:映射经过验证的主键、外键和多表联接路径。
智能体跟踪链接:将现实世界中的 AI 用户提示与用于回答这些提示的特定表相关联。
软件包链接:将多组数据资产联接到精选数据产品。
条目链接用作遍历以组合上下文集的各个连接。在自动扩充运行期间,只要代理识别出候选联接或未关联的字词,就会提出新的条目链接供管护者审批。
上下文集
上下文集是语义信息和数据资产引用的有界容器。每个上下文集都作为专用条目组 (type="context-set") 实现。
上下文集建立了封闭的执行边界,可防止智能体在整个企业目录中执行开放式搜索。此方法可减少幻觉和 token 消耗。
如需了解上下文集与相关结构(例如数据产品和语义上下文图)有何不同,或了解详细的架构功能、类别、命名空间和代理咨询模式,请参阅上下文集概览。
丰富化任务和运行作业
Knowledge Studio 中的自动化元数据增强功能分为增强任务、增强作业和增强运行。
丰富任务:一种持久配置,用于定义丰富代理如何分析一组目标数据资产。扩充任务会指定目标上下文集、上下文输入来源和评估基准。
丰富化作业:Knowledge Studio 中执行丰富化任务的后端编排过程。
丰富运行:任务的单次时间点执行实例。每次运行都会检查目标资产、提取语义信号,并生成数据监管者可以审核的更改请求(提案)。
如需详细了解丰富工作流,请参阅丰富任务简介。
上下文图表与数据沿袭的比较
了解 Knowledge Studio 上下文图和 Knowledge Catalog 数据沿袭之间的区别对于选择合适的工具至关重要。
数据沿袭会跟踪数据的操作移动和底层转换。沿袭可回答以下问题:这些数据来自哪里?哪个 ETL 流水线填充了此表?如果此上游架构发生更改,哪些下游信息中心会损坏?节点表示底层资产和转换作业(例如 Dataflow 流水线或 BigQuery 作业),有向边表示底层数据流。
上下文图可对业务语义、关系和领域知识进行建模。上下文图谱可回答以下问题:此列在业务方面意味着什么?这两个表在概念上有什么关系?AI 智能体应如何联接这些资产来回答问题?节点表示底层资产以及概念实体(例如术语表术语、KPI 公式和数据产品),而边表示语义连接(例如列到术语表定义的链接和经过验证的联接条件)。
如需详细了解流水线可追溯性,请参阅 Knowledge Catalog 数据沿袭。
企业安全与治理
Knowledge Studio 基于企业级安全架构构建,专为严格受监管的环境而设计。
用户管理的执行身份:扩充任务使用用户代管式服务账号运行,该账号是您在项目中创建和管理的身份,可允许服务代表您执行操作。Dataplex 服务代理 (P4SA) 使用 Service Account Token Creator 角色 (
roles/iam.serviceAccountTokenCreator) 模拟此服务账号,以生成短期有效的 OAuth 2.0 凭据。生成这些短期有效凭据会限制访问令牌的生命周期,与使用长期有效的服务账号密钥相比,可最大限度地降低凭据泄露的风险。第三方身份验证:连接远程 SaaS 知识源(例如 Microsoft SharePoint、Atlassian Confluence、Jira 和 GitHub)时,会使用Google Cloud的 Agent Identity 身份验证管理器,确保人工操作员绝不会处理原始客户端密钥。
如需了解如何配置这些安全功能,请参阅配置丰富功能的前提条件。
限制
Assured Workloads 合规性制度(包括 FedRAMP、CJIS、IL4/IL5 和 HIPAA)。
数据驻留 (DRZ) 承诺。此功能处理的数据可能会在您严格配置的地理边界之外存储或处理。
客户管理的加密密钥 (CMEK)。此功能存储或处理的数据使用 Google 拥有和Google-owned and Google-managed encryption keys(而不是您的 Cloud Key Management Service 或 Cloud EKM 密钥)进行加密。
VPC Service Controls。 不支持 VPC Service Controls。
Access Transparency (AXT) 通知和访问权限审批控制。Google 员工为支持或维护此预览版而执行的操作不会记录在 Access Transparency Cloud Access Ledger (CAL) 中。
在预览版期间,Knowledge Studio 还在以下限制范围内运行:
上下文集区域范围:不支持关联到区域数据资产的全局上下文集。上下文集必须与所打包素材资源的区域边界保持一致。
以控制台为主的管理:通过 Google Cloud 控制台管理丰富化任务和探索会话。预览版中不提供用于任务管理的直接 REST API 和
gcloudCLI 命令。不过,下游智能体可以使用 Knowledge Catalog Catalog API(ListEntries、LookupEntry)和 Model Context Protocol (MCP) 以编程方式发现和查询精选上下文集。集中式整理:所有元数据审核和批准都在丰富化运行详情页面中进行。
无独立结算 SKU:Knowledge Studio 不会引入单独的产品 SKU。使用费反映了底层资源(Gemini 推理引擎、BigQuery 和 Cloud Storage)的标准消耗。