


Knowledge Catalog è un livello di contesto basato su Gemini che fornisce un contesto aziendale universale e funzionalità di grounding attive in tutto il tuo patrimonio di dati. Creando un grafico contestuale dinamico a partire da dati strutturati e non strutturati, aiuta i team di dati e gli sviluppatori a scoprire asset, verificare la qualità dei dati e basare in modo sicuro le applicazioni di AI generativa per ridurre le allucinazioni.
Per una procedura dettagliata di Knowledge Catalog, guarda il seguente video:
Pubblico e prerequisiti
Questa panoramica è pensata per data engineer, context engineer, data scientist, data steward e sviluppatori di AI. Prima di utilizzare Knowledge Catalog, devi disporre di:
Familiarità con i sistemi di database e di archiviazione, come BigQuery o Cloud Storage.
Una conoscenza di base dei concetti di AI generativa, come la Retrieval-Augmented Generation (RAG) o il Model Context Protocol (MCP).
Risolvi la complessità dei dati specifici del settore
Nelle aziende moderne, i dati sono complessi, altamente distribuiti ed esistono in formati strutturati e non strutturati. Le richieste aziendali raramente corrispondono a un singolo schema di database o archivio di documenti. Allineare questi silos in modo sicuro e fornire risposte immediate e affidabili a domande cross-domain è una sfida operativa importante.
Knowledge Catalog funge da base semantica che colma questa lacuna, consentendo agli agenti AI e agli strumenti di analisi di recuperare un contesto fondato e pertinente.
Ruoli utente chiave
Context Engineers (Data Engineers). Automatizza l'aggregazione dei metadati in database e Cloud Storage, traccia le trasformazioni con la tracciabilità e crea workflow di arricchimento e valutazione.
Gestori dati (team di governance). Supervisiona la qualità dei metadati fornendo revisioni human-in-the-loop delle descrizioni generate con l'AI, standardizzando i vocabolari aziendali con i glossari e definendo aspetti personalizzati per allegare un contesto specifico del dominio alle voci del catalogo.
AI Developers. Basare gli LLM e le applicazioni di AI su schemi di dati aziendali attendibili utilizzando i server MCP o le API di recupero del contesto.
Casi d'uso per settore
La seguente tabella illustra le domande complesse che sorgono nella pratica, come superano i confini tecnici e come Knowledge Catalog aiuta le organizzazioni ad affrontarle:
| Settore | Sfide operative e relative ai dati | Problema aziendale da risolvere | Come risolve il problema Knowledge Catalog |
|---|---|---|---|
| E-commerce |
|
"Trova prodotti elettronici con tassi di reso elevati e foto dei clienti che mostrano segni di danni all'arrivo." | Fondamento semantico in tutti i formati di dati:rileva automaticamente i metadati dai database transazionali e li collega a immagini non strutturate nei bucket di archiviazione Cloud Storage, consentendo agli strumenti di AI di risolvere la query in sistemi di archiviazione diversi. |
| Produzione |
|
"Genera riepiloghi per tutti i report di ispezione relativi alle macchine nella regione occidentale che non hanno superato i controlli di sicurezza nell'ultimo trimestre." | Scansione regionale e non strutturata:esegue la scansione e cataloga i report di ispezione PDF non strutturati insieme ai metadati degli asset, consentendo agli agenti di AI generativa di individuare, compilare e riepilogare i report per regione. |
| Sanità |
|
"Quali pazienti sono a maggior rischio di riammissione a 30 giorni se si considerano i parametri vitali di laboratorio recenti e la frequenza degli appuntamenti?" | Qualità e tracciabilità dei dati:calcola la profilazione della qualità dei dati a livello di riga e le mappe di tracciabilità nei feed dei riepiloghi salute elettronici, il che contribuisce a garantire che i modelli predittivi clinici si basino solo su parametri vitali del paziente verificati e di alta qualità. |
| Servizi finanziari |
|
"Quali clienti con le entrate più alte si sono lamentati di "problemi di rendimento" e in che modo ciò influisce sulle proiezioni del terzo trimestre?" | Grafico contestuale unificato: unifica i record dei clienti, il feedback dell'assistenza e le tabelle finanziarie, consentendo alle query in linguaggio naturale di unire le statistiche sulle entrate dei clienti con i file di feedback non strutturati per prevedere l'impatto finanziario. |
Per affrontare queste sfide operative, Knowledge Catalog offre funzionalità chiave che aiutano data engineer, data scientist e sviluppatori di AI a creare sistemi di dati controllati:
Fornisci ai tuoi agenti AI informazioni di base con Model Context Protocol (MCP). Esporre metadati, schemi, derivazione e regole aziendali direttamente agli agenti AI utilizzando server MCP locali o remoti. Questi server consentono ai modelli di verificare le aspettative operative prima di proporre azioni.
Accelerare la scoperta per l'AI e l'analisi. Trova asset di dati pertinenti utilizzando la ricerca semantica in linguaggio naturale. I riepiloghi e i consigli generativi aiutano gli utenti a individuare i dati senza attendere le revisioni manuali della documentazione.
Estrai il contesto dai dati non strutturati. Analizza automaticamente i file non strutturati, come i PDF in Cloud Storage, per estrarre entità e relazioni, convertendole in asset interrogabili in BigQuery per supportare gli agenti conversazionali.
Governare i prodotti di dati su larga scala. Raggruppa le raccolte di asset con accordi sul livello del servizio (SLA), contratti, dettagli di proprietà e note sull'utilizzo in unità singole e controllate per la ricerca e l'abbonamento.
Come funziona Knowledge Catalog
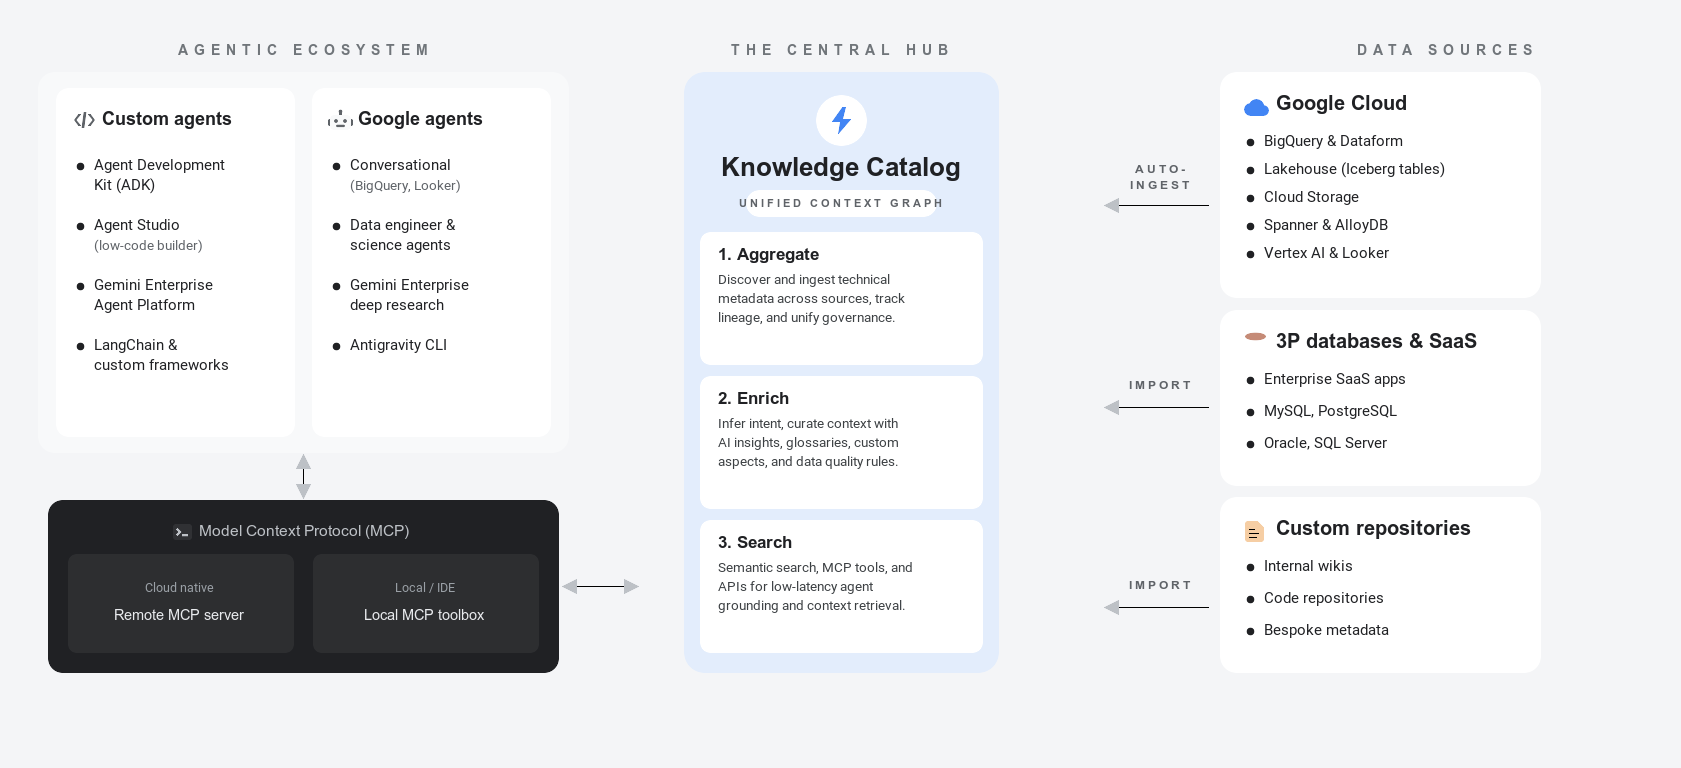
Knowledge Catalog unifica la gestione dei dati e il contesto attraverso un ciclo di vita a tre pilastri. Il seguente diagramma illustra in che modo il servizio mappa gli asset di dati fisici alla semantica aziendale per il grounding dell'agente AI:
Per saperne di più su questi concetti relativi ai metadati, consulta Informazioni sui metadati.
Le sezioni seguenti descrivono i tre pilastri del ciclo di vita dei metadati e illustrano come un'azienda di vendita al dettaglio li applica a tabelle di database, file e voci di catalogo esterni:
Aggregazione (scoperta e importazione). Knowledge Catalog esegue automaticamente la scansione e l'indicizzazione dei metadati tecnici in tutto il tuo patrimonio di dati senza spostare i dati sottostanti:
- Database integrati. La catalogazione automatica acquisisce schemi e attributi su piattaforme come BigQuery, AlloyDB per PostgreSQL e Spanner.
- Connettività gestita. Importa definizioni da sistemi esterni, come Oracle o PostgreSQL, o da registri partner, come Collibra, senza scrivere pipeline personalizzate.
- Tracciabilità dei dati. Trace le trasformazioni a livello di colonna nelle pipeline per monitorare la provenienza dei dati e il modo in cui sono cambiati.
- Esempio: una società di vendita al dettaglio inserisce automaticamente i metadati del database transazionale, come le tabelle
orderseorder_items, e indicizza i file di prodotto non strutturati archiviati nei bucket Cloud Storage. Collegano database esterni per stabilire un indice di metadati unificato in una directory rilevabile.
Per saperne di più sull'aggregazione dei metadati e sull'importazione dati (fai clic per espandere)
- Origini dati supportate: elenca tutte le origini Google Cloud e quelle esterne supportate per l'importazione automatica.
- Panoramica della connettività gestita: spiega come importare schemi tecnici da sistemi esterni.
- Monitorare la derivazione dei dati: descrive come visualizzare le trasformazioni della pipeline a livello di colonna e il flusso di dati.
Arricchimento (cura del contesto e verifica dell'affidabilità). Knowledge Catalog attribuisce un significato aziendale alle strutture tecniche e stabilisce indicatori di affidabilità:
- Insight creati con l'AI. Gemini analizza i log delle query per generare descrizioni delle colonne, riepiloghi delle tabelle e join consigliati.
- Indicizzazione non strutturata. Eseguire la scansione delle directory dei file per estrarre entità e connessioni da asset non strutturati come PDF o immagini.
- Glossari e aspetti. Mappa i nomi delle metriche interne a un vocabolario condiviso utilizzando termini aziendali e modelli logici.
- Qualità dei dati e rilevamento di anomalie. Applica linee guida per la pulizia ed esegui scansioni di machine learning per rilevare outlier statistici o problemi di aggiornamento dei dati, generando indicatori di affidabilità chiave.
- Revisioni della governance. Gestisci il rischio utilizzando le procedure di revisione del flusso di lavoro per verificare gli aggiornamenti dei metadati prima della pubblicazione.
- Esempio: il team Retail arricchisce gli asset attivando approfondimenti sui dati per consigliare descrizioni delle colonne ed eseguire regole di qualità dei dati. Mappano le definizioni aziendali sugli ordini attivi creando glossari e aspetti.
Per scoprire di più sull'arricchimento dei metadati e sulla verifica dell'affidabilità (fai clic per espandere)
- Configurare gli approfondimenti sui dati: spiega come generare descrizioni e riepiloghi automatici dei set di dati.
- Gestisci glossari aziendali: descrive come personalizzare i termini standard e i vocabolari aziendali.
- Arricchire i metadati con gli aspetti: mostra come collegare le proprietà dei metadati strutturati agli asset logici.
- Riutilizzare le regole di qualità dei dati: mostra come stabilire e riutilizzare le regole di convalida del database.
- Panoramica della profilazione dei dati: descrive come configurare le scansioni per anomalie dello schema e deriva statistica.
Ricerca e recupero (accesso e terra). Le applicazioni AI e gli utenti aziendali eseguono query sul grafico di contesto unificato per accedere ai dati in modo sicuro:
- Agenti di messa a terra. Connetti le tue app e i tuoi agenti basati su LLM al catalogo.
- API Context. Esegui richieste di payload di grounding a bassa latenza.
- Ricerca semantica. Trova gli asset giusti utilizzando query in linguaggio naturale.
- Pacchetto di dati. Raggruppa raccolte di tabelle, dettagli delle licenze e SLA in pacchetti di dati self-service sicuri.
- Esempio: gli analisti eseguono ricerche semantiche in linguaggio naturale per individuare gli asset. Le applicazioni AI utilizzano questo indice in modo sicuro tramite i server MCP o l'API di recupero del contesto e gli asset di alta qualità vengono raggruppati in una visualizzazione sicura.
Per scoprire di più sul recupero del contesto e sul grounding dell'agente (fai clic per espandere)
- Panoramica del Model Context Protocol (MCP): spiega come collegare gli agenti di AI generativa e i livelli dell'applicazione al contesto di Knowledge Catalog.
- Recuperare il contesto utilizzando LookupContext: mostra come estrarre i payload operativi chiave per il prompt dell'agente.
- Cerca asset: descrive le funzionalità di ricerca degli asset utilizzando la sintassi di query semantica in linguaggio naturale.
Knowledge Catalog nell'ecosistema Google Cloud e dell'AI
Comprendere in che modo Knowledge Catalog si integra con i servizi correlati è essenziale per creare una base di dati.
Google Cloud database e modelli
- BigQuery. Knowledge Catalog esegue automaticamente la scansione e l'indicizzazione di set di dati, tabelle e viste BigQuery. Attiva gli approfondimenti sui dati basati su Gemini per analizzare le cronologie delle query, pubblicare descrizioni e suggerire query di esempio verificate.
- Looker (Google Cloud core). Knowledge Catalog acquisisce dashboard, Look e strutture LookML di Looker, come viste, esplorazioni, dimensioni e misure. Questa importazione crea mappature della derivazione per tracciare la mappatura dei valori operativi alla semantica aziendale.
- Catalogo runtime Lighthouse. Knowledge Catalog si integra con Lighthouse, il metastore di runtime per i workload Iceberg open source. Esegue automaticamente l'indicizzazione dei metadati tecnici in aggiunta ai carichi di lavoro Lighthouse per fornire un contesto attivo unificato.
Piattaforme di agenti AI e assistenti
- Analisi conversazionale. Le interfacce di analisi utilizzano termini del catalogo e strumenti di ricerca per consentire agli utenti di eseguire query sulle metriche aziendali in linguaggio naturale con grounding verificato.
- Gemini per gli agenti AI. Gli agenti assistenti ad alta precisione utilizzano i metadati del catalogo per eseguire ricerche nel database, riducendo le allucinazioni.
- Gemini Enterprise Agent Platform. Knowledge Catalog funge da standard centrale di governance dei dati all'interno degli ambienti della piattaforma di destinazione. Si collega in modo incrociato con Gemini Enterprise Agent Platform per fornire strumenti e contesto all'Agent Registry della piattaforma.
Google Cloud Integrazione di servizi di database e AI
Knowledge Catalog funziona insieme ad altri prodottiGoogle Cloud per formare la base dei tuoi dati. La seguente tabella mostra come Knowledge Catalog si integra con i servizi correlati e li completa:
| Servizio | Ruolo principale | In che modo si integra con Knowledge Catalog |
|---|---|---|
| Knowledge Catalog | Governance e contesto agentico | Funge da grafico del contesto semantico unificato, esegue scansioni di controllo della qualità dei dati ed espone schemi basati su dati reali a modelli e applicazioni di AI. |
| BigQuery | Data warehousing aziendale | Archivia, esegue query ed elabora i set di dati; esegue automaticamente la scansione, l'indicizzazione e l'arricchimento di queste tabelle con aspetti di classificazione aziendale. |
| Vertex AI | Sviluppo di modelli di AI | Crea, esegue il deployment e ospita modelli di base. Gli agenti personalizzati recuperano il contesto dei metadati per basare il ragionamento logico. |
| Cloud Storage | Archiviazione di file non strutturati | Archivia file non strutturati non elaborati; esegue automaticamente scansioni di rilevamento non strutturate per analizzare PDF e immagini per creare mappe delle relazioni. |
Semantica e formati dei dati
Per istruire e basare in modo efficace i sistemi agentici, devi distinguere tra struttura fisica dei dati e significato semantico:
- Semantica. Il significato, l'intento e le relazioni aziendali associati
ai tuoi dati. Sebbene gli schemi tecnici definiscano le specifiche di archiviazione strutturale, come un tipo di database, la lunghezza dei caratteri o un vincolo di numeri interi, la semantica descrive ciò che il set di dati rappresenta effettivamente. Ad esempio, puoi mappare una colonna denominata
txn_qtyalla definizione aziendale di "quantità acquistata". - Dati strutturati. Informazioni archiviate in schemi definiti e formati relazionali. Alcuni esempi includono tabelle BigQuery, database Spanner e tabelle Postgres operative. Knowledge Catalog esegue automaticamente il crawling di questi metadati e registra colonne e vincoli.
- Dati non strutturati. Informazioni non formattate contenenti testo o file multimediali grezzi privi di uno schema strutturale. Gli esempi includono schede tecniche in PDF, email di assistenza clienti e immagini archiviate in Cloud Storage. Knowledge Catalog esegue scansioni di rilevamento utilizzando gli approfondimenti sui dati non strutturati per estrarre le relazioni tra le entità sottostanti e registrarle in un profilo del grafico, un aspetto specializzato che contiene nodi e archi di relazioni tra entità estratti con l'AI.
Orchestrazione del contesto di Agentic Data Cloud
All'interno del framework Agentic Data Cloud di Google, Knowledge Catalog funge da piano di orchestrazione semantica. Anziché richiedere agli sviluppatori di codificare manualmente gli schemi di database e le regole nei prompt, il motore di contesto fornisce dinamicamente il contesto semantico preciso di cui un agente ha bisogno per prendere decisioni intelligenti.
La seguente figura mostra come Knowledge Catalog orchestra e fornisce il contesto dei dati:
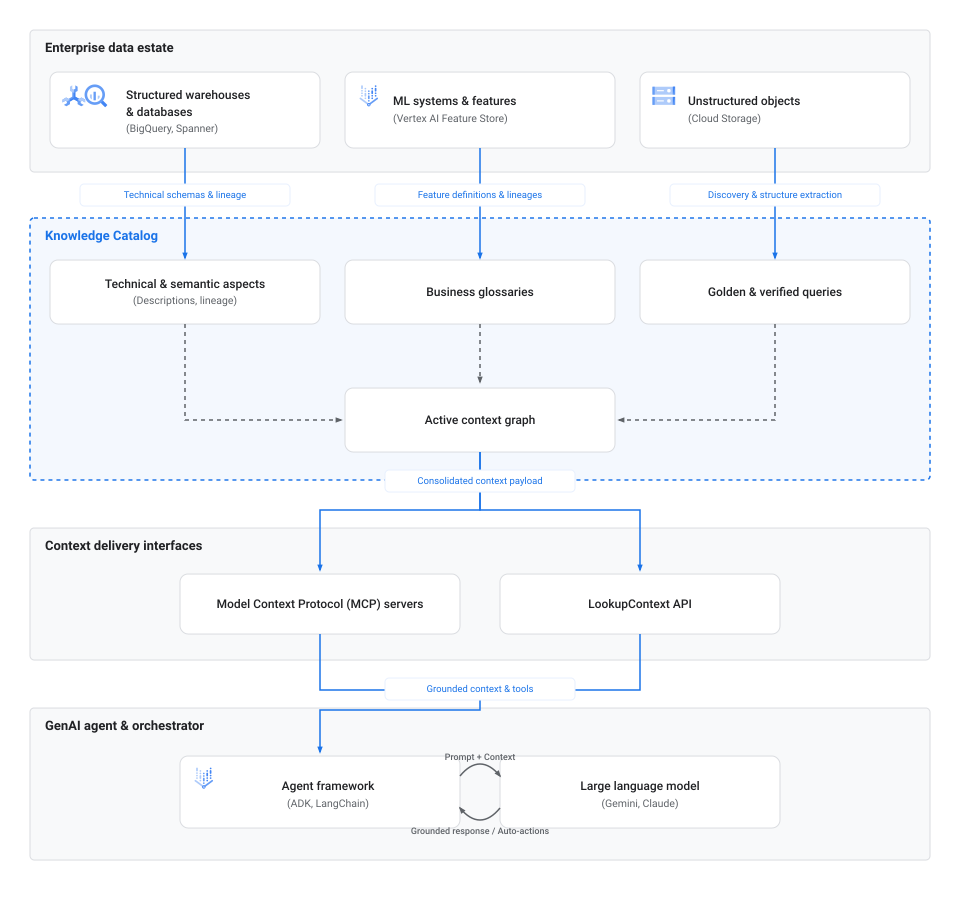
Il flusso di lavoro di orchestrazione del contesto è costituito dalle seguenti fasi:
- Importazione e scoperta. Database operativi, warehouse come Spanner e BigQuery, archivi di oggetti non strutturati come Cloud Storage e metastore di runtime come Lighthouse forniscono schemi tecnici, mappe di derivazione e definizioni di metadati direttamente in Knowledge Catalog.
- Mappatura del contesto. All'interno di Knowledge Catalog, queste proprietà dei metadati sono collegate a elementi semantici, tra cui aspetti tecnici, glossari aziendali e query verificate, per assemblare il grafico del contesto attivo.
- Interfacce di pubblicazione. Le applicazioni e gli orchestratori AI recuperano questo
grafico del contesto consolidato in modo programmatico utilizzando connettori standard,
come MCP o endpoint API
LookupContextdiretti. - Fondamenti dell'agente. Framework di orchestrazione, come Agent Development Kit (ADK) o LangChain, inseriscono questo contesto di metadati direttamente nei prompt LLM. Questa iniezione basa il ragionamento dell'agente su regole organizzative verificate, che gli consentono di eseguire query sui database o eseguire azioni automatizzate senza allucinazioni.
Profili degli agenti AI
A seconda dei workflow che vuoi automatizzare, puoi creare diverse classi di agenti basati su Knowledge Catalog:
- Agenti di individuazione dei dati. Questi assistenti aiutano gli utenti a cercare e navigare nel patrimonio di dati. Anziché utilizzare la corrispondenza delle parole chiave, analizzano l'intenzione e i vincoli in linguaggio naturale per recuperare gli asset fisici più pertinenti.
- Agenti di arricchimento dei metadati. Questi agenti in background acquisiscono testo non strutturato da wiki, file README o log di chat, analizzano il testo in metadati formali e scrivono i metadati come aspetti in Knowledge Catalog per mantenerli aggiornati.
- Qualità dei dati e agenti della pipeline. Questi agenti autonomi valutano le regole di qualità, rilevano la deriva dello schema e creano o riparano le pipeline di trasformazione dei dati eseguendo query sulla tracciabilità dei dati e sulle statistiche del profilo.
Strumenti di orchestrazione
Per creare e integrare questi agenti, puoi utilizzare i seguenti strumenti:
- Model Context Protocol (MCP). Un protocollo aperto e standardizzato per collegare gli agenti a risorse esterne. Puoi configurare gli agenti in modo che si connettano al catalogo utilizzando il server MCP remoto o MCP Toolbox locale. Per ulteriori informazioni, consulta Informazioni sul Model Context Protocol (MCP) in Knowledge Catalog.
- Agent Development Kit (ADK). Un framework di Google che semplifica la creazione, l'esecuzione e il test di agenti di AI generativa, offrendo binding integrati all'API Catalog Service. Per ulteriori informazioni, consulta la home page dell'ADK.
- API LookupContext. Un endpoint API REST e gRPC che estrae un payload di contesto YAML o JSON unificato per gli asset di dati, pronto per essere inserito direttamente nei prompt LLM. Per saperne di più, consulta Recuperare il contesto utilizzando l'API LookupContext.
Contesto di accesso con MCP
Model Context Protocol (MCP) è un bridge standardizzato che consente agli agenti e agli strumenti AI di connettersi facilmente a origini dati come Knowledge Catalog. Utilizza la seguente tabella di confronto per determinare l'opzione migliore per la tua integrazione:
| Implementazione | Ideale per | Dettagli chiave | Endpoint o configurazione |
|---|---|---|---|
| Server MCP remoto | Deployment cloud-first, ambienti serverless come Cloud Run e servizi esterni gestiti. | Endpoint ospitato da Google che non richiede la gestione del server locale. | Endpoint: https://dataplex.googleapis.com/mcp. Per la configurazione, consulta Utilizzare un server MCP remoto. |
| Strumenti MCP locali | Sviluppo di agenti locali, prototipazione rapida e integrazioni IDE desktop come VS Code o Cursor. | Strumento a riga di comando che funge da proxy locale tra il tuo ambiente di lavoro e Knowledge Catalog. | Richiede l'installazione binaria e le impostazioni .mcp.json.Per la configurazione, vedi Utilizzare un server MCP locale. |
Best practice per il contesto dei dati agentici
Per creare esperienze di agenti affidabili, tieni presente le seguenti best practice quando organizzi ed esegui query sui metadati in Knowledge Catalog:
- Aggiungi aspetti. Gli agenti AI non possono distinguere tra tabelle di produzione ufficiali e mockup temporanei della sandbox solo in base al nome. Definisci e applica un aspetto dell'indicatore di fiducia personalizzato per certificare i prodotti di dati autorevoli, il che consente agli agenti di dare la priorità alle query o di limitarle a queste risorse.
- Ottimizza le ricerche utilizzando i budget contestuali. Quando chiami l'API
LookupContext, specifica il parametrocontext_budget. L'API ottimizza e inserisce prima i metadati più importanti, come la tracciabilità e le descrizioni principali, all'interno dei vincoli di token specificati. - Fornisci risorse correlate per mostrare i percorsi di unione. Nelle tue richieste contestuali, elenca fino a 10 tabelle o asset correlati. Fornire un gruppo di asset consente al motore di contesto di compilare automaticamente i percorsi e le relazioni di unione, il che aiuta l'agente a comprendere l'interfaccia delle tabelle.
- Strutturare i glossari semantici. Standardizza i termini e le abbreviazioni nei glossari aziendali. Questa standardizzazione aiuta gli strumenti conversazionali a risolvere in modo accurato i sinonimi e le metriche specifici dell'attività.
- Pubblica query di riferimento. Allega query in linguaggio naturale verificate e i relativi equivalenti SQL corretti direttamente alle voci di Knowledge Catalog. Basando il ragionamento su questi modelli verificati, eviti errori di conversione SQL negli agenti di conversione del testo in SQL.
Transizione da Dataplex Universal Catalog a Knowledge Catalog
Dataplex Universal Catalog si è evoluto in Knowledge Catalog. Per saperne di più su questa transizione, consulta Transizione da Dataplex Universal Catalog a Knowledge Catalog.
Limitazioni
Quando pianifichi l'implementazione, tieni presenti le seguenti limitazioni:
Integrazioni supportate. Sebbene Knowledge Catalog supporti i principali sistemi di terze parti, alcune estrazioni semantiche automatizzate potrebbero essere limitate ai servizi Google Cloud integrati.
Limiti di quota. Si applicano le quote API standard Google Cloud alle operazioni di recupero del contesto e di estrazione dei metadati.
Passaggi successivi
Informazioni sul contesto dei dati
Scopri come il contesto attivo trasforma i metadati passivi per fondare gli agenti AI ed evitare le allucinazioni.
Stabilisci il contesto dei dati di base
Crea un glossario aziendale, definisci tipi di aspetti personalizzati e arricchisci gli asset in BigQuery.
Agenti di terra con MCP
Collega gli agenti AI e gli strumenti per sviluppatori a Knowledge Catalog utilizzando Model Context Protocol.
Cerca risorse
Trova ed esplora le risorse del catalogo nei sistemi Google Cloud e di terze parti utilizzando il linguaggio naturale.
Automatizza le analisi della qualità dei dati
Definisci regole di convalida e monitora la pulizia dei dati nelle tabelle con scansioni automatiche della qualità.
Esplora i casi d'uso interattivi
Esamina soluzioni reali per l'arricchimento del contesto, la lineage dei dati e i flussi di lavoro agentici.