


Knowledge Catalog (in precedenza Dataplex Universal Catalog) ti consente di applicare policy di sicurezza coerenti tra i motori di query, come BigQuery SQL e Apache Spark, per le tabelle Apache Iceberg su archiviazioneGoogle Cloud . In questo tutorial, utilizzerai gli script con Knowledge Catalog e Lakehouse senza confini per creare un data lakehouse regolamentato che ti aiuti a proteggere le informazioni sensibili, come i documenti finanziari.
Panoramica dell'architettura
Quando archivi i dati in sistemi di archiviazione diversi, la gestione della sicurezza frammentata può diventare una sfida. Per configurare il controllo granulare dell'accesso su un formato di tabella aperto come Apache Iceberg, devi creare un'architettura di sicurezza rigorosa e unificata.
Con questo design, Knowledge Catalog funge da control plane centrale e da motore di contesto universale. Contiene i metadati necessari per applicare dinamicamente il contesto di sicurezza a tutti i motori supportati, indipendentemente dal motore che esegue la query sui dati.
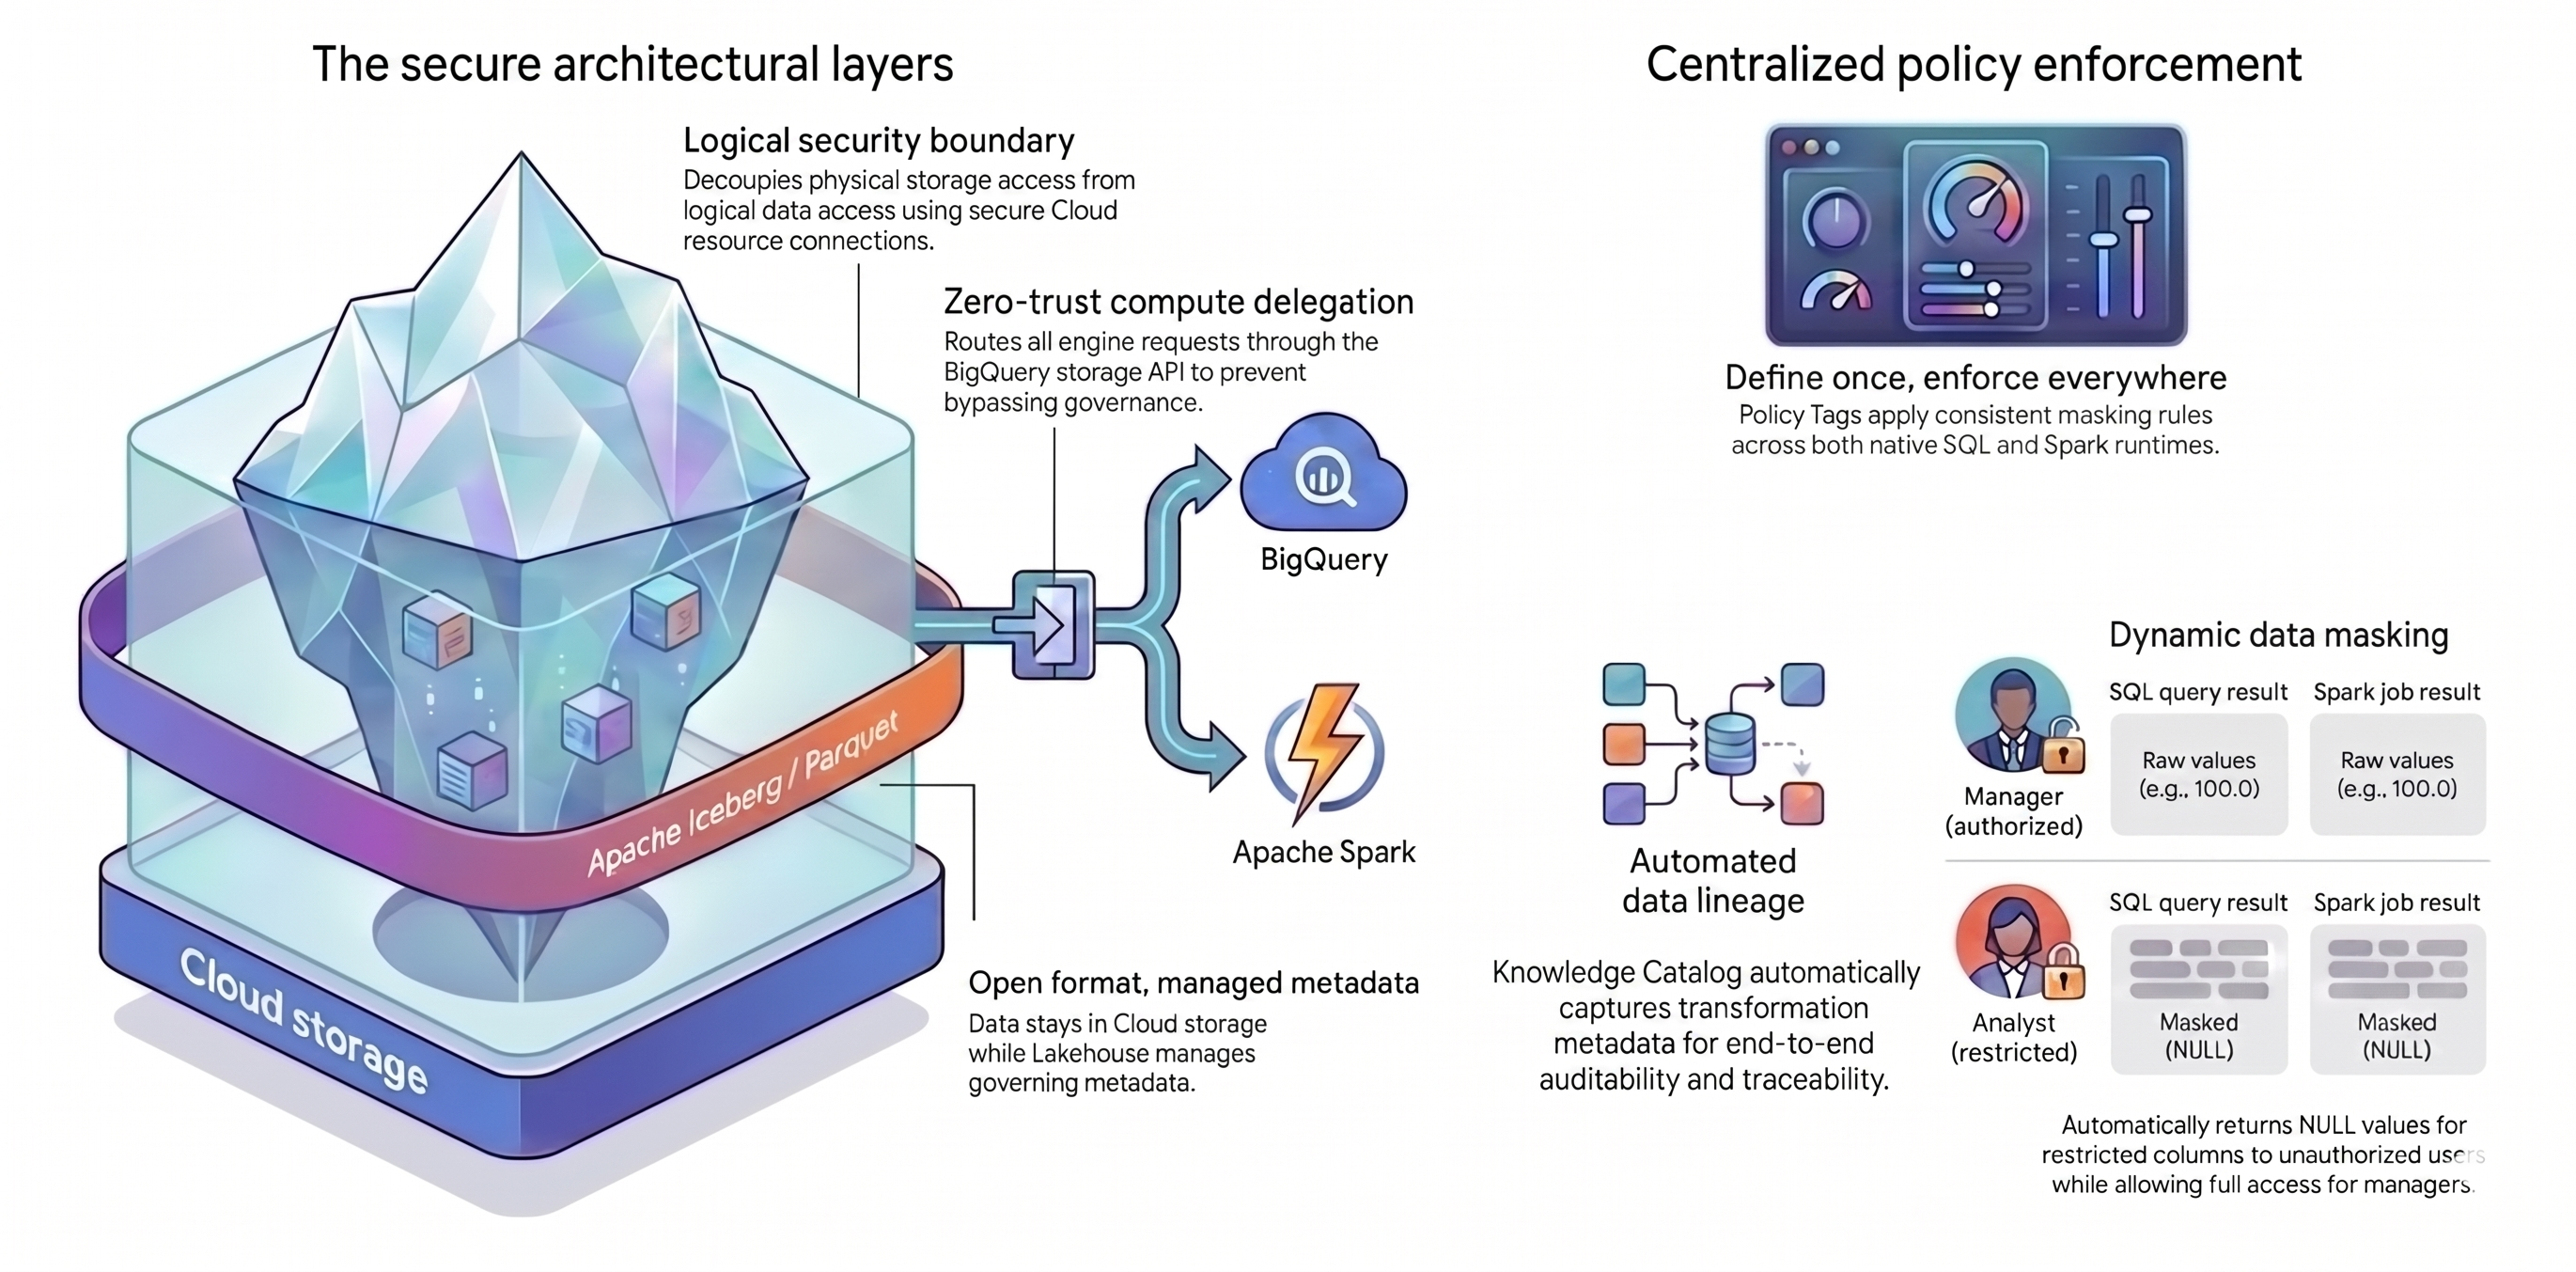
Questo tutorial si basa su due concetti principali per creare questa architettura unificata:
- Livelli di architettura sicuri: anziché consentire agli utenti o ai motori di query di accedere direttamente ai bucket Cloud Storage, crei una base sicura e a più livelli basata sui seguenti attributi:
- Formato aperto con metadati gestiti: i tuoi dati rimangono nel formato aperto Apache Iceberg (Parquet) all'interno di Cloud Storage, mentre Lakehouse gestisce i metadati della tabella.
- Confine di sicurezza logico: disaccoppia le autorizzazioni di archiviazione dalle query sui dati utilizzando una connessione alle risorse Cloud sicura. Non concedi mai agli utenti finali l'accesso diretto ai file.
- Delega del computing: per impedire ai motori di query di bypassare le tue regole, instrada tutte le richieste di dati tramite l'API BigQuery Storage. Il routing delle richieste tramite l'API BigQuery Storage garantisce che Knowledge Catalog possa intercettare e applicare le policy anche per i motori di elaborazione esterni.
- Applicazione centralizzata delle policy: con una base sicura, utilizzi Knowledge Catalog per applicare universalmente le tue regole:
- Definisci una volta, applica ovunque: definisci i tag di policy in Knowledge Catalog una sola volta e la piattaforma applica regole di mascheramento coerenti a tutti i motori di query supportati.
- Mascheramento dinamico dei dati: il sistema valuta l'identità dell'utente durante le query. Gli utenti autorizzati vedono i valori non elaborati, mentre gli utenti con limitazioni ricevono output
NULLin tutti i motori di query. - Tracciabilità dei dati automatizzata: Knowledge Catalog monitora automaticamente le trasformazioni dei dati, creando una traccia di audit senza codice di logging personalizzato.
Obiettivi
- Crea tabelle Apache Iceberg gestite da BigQuery. Lakehouse gestisce i metadati Iceberg.
- Configura regole di sicurezza centrali utilizzando i tag di policy per mascherare e proteggere le colonne sensibili.
- Separa le autorizzazioni di archiviazione fisica dalle query sui dati logici utilizzando una connessione alle risorse Cloud.
- Instrada le query in modo sicuro tramite Managed Service for Apache Spark in modo che i motori esterni non possano bypassare le tue regole di sicurezza. Per saperne di più, consulta la documentazione di Managed Service for Apache Spark.
- Esplora una mappa interattiva dei tuoi dati utilizzando la derivazione dei dati.
Prima di iniziare
Prima di iniziare, segui questi passaggi:
- Seleziona un progetto Google Cloud per questo tutorial.
- Verifica che la fatturazione sia abilitata per il tuo progetto.
prepara l'ambiente
Questo tutorial utilizza Cloud Shell, un ambiente a riga di comando in esecuzione nel cloud.
Nella consoleGoogle Cloud , fai clic sull'icona di Cloud Shell nella barra degli strumenti in alto a destra.
Imposta le variabili del progetto:
export PROJECT_ID=$(gcloud config get-value project) export REGION="us-central1" export ICEBERG_BUCKET="iceberg-retail-demo-${PROJECT_ID}" export DATASET_ID="lakehouse_retail_demo" export CONN_NAME="iceberg-bq-conn-demo"Definisci le variabili per due user persona, un analista di vendita al dettaglio e un responsabile di vendita al dettaglio:
export USER_ANALYST="retail-analyst-demo"
export EMAIL_ANALYST="${USER_ANALYST}@${PROJECT_ID}.iam.gserviceaccount.com"

export USER_MANAGER="retail-manager-demo"
export EMAIL_MANAGER="${USER_MANAGER}@${PROJECT_ID}.iam.gserviceaccount.com"
export CURRENT_USER=$(gcloud config get-value account)
Abilita le API Google Cloud richieste.
gcloud services enable \
  bigquery.googleapis.com \
  bigqueryconnection.googleapis.com \
  datacatalog.googleapis.com \
  bigquerydatapolicy.googleapis.com \
  datalineage.googleapis.com \
  dataplex.googleapis.com \
  dataproc.googleapis.com \
  storage-component.googleapis.com
Scarica il codice sorgente del tutorial
Scarica gli script Python per questo tutorial dal repository DevRel di Google Cloud :
# Shallow clone without full history
git clone --depth 1 --filter=blob:none --sparse https://github.com/GoogleCloudPlatform/devrel-demos.git
cd devrel-demos

# Download only the specific folder
git sparse-checkout set data-analytics/governed-lakehouse
cd data-analytics/governed-lakehouse
Crea un bucket di archiviazione
Crea un nuovo bucket per contenere i file della tabella Iceberg:
gcloud storage buckets create gs://${ICEBERG_BUCKET} --location=${REGION}
Prepara identità e sicurezza
In questo passaggio, configurerai la delega di calcolo creando una connessione alle risorse Cloud. Questa connessione funge da identità delegata e sicura che BigQuery utilizza per gestire e leggere i file Iceberg. In questo modo, i singoli utenti non avranno mai accesso diretto al tuo bucket Cloud Storage.
Esegui questi comandi per creare la connessione, recuperare il account di servizio generato automaticamente e concedere a questo account le autorizzazioni necessarie per gestire i dati Iceberg:
# Create the Cloud resource connection
bq mk --connection \
    --connection_type=CLOUD_RESOURCE \
    --location=${REGION} \
    ${CONN_NAME}

# Retrieve the connection's automatically generated Service Account
export BQ_CONN_SVC_ACCT=$(bq show --format=json --connection ${REGION}.${CONN_NAME} \
    | jq -r '.cloudResource.serviceAccountId')

# Grant Storage Object Admin to the connection for the Iceberg bucket
gcloud storage buckets add-iam-policy-binding gs://${ICEBERG_BUCKET} \
    --member="serviceAccount:${BQ_CONN_SVC_ACCT}" \
    --role="roles/storage.objectAdmin" \
    --quiet
Crea service account per due utenti tipo: Analyst e Manager. I seguenti comandi configurano questi service account, consentono all'utente corrente di impersonarli per i test e concedono loro ruoli specifici per eseguire query e visualizzare i dati.
echo "Creating Service Accounts..."
for USER in "${USER_ANALYST}" "${USER_MANAGER}"; do
    gcloud iam service-accounts create ${USER} --display-name="Lakehouse ${USER}"
done

echo "⏳ Waiting 15 seconds for rules to apply..."
sleep 15

echo "Granting roles to service accounts..."
for USER in "${USER_ANALYST}" "${USER_MANAGER}"; do
    EMAIL="${USER}@${PROJECT_ID}.iam.gserviceaccount.com"

    # Allow Cloud Shell to impersonate them for testing
    gcloud iam service-accounts add-iam-policy-binding ${EMAIL} \
        --member="user:${CURRENT_USER}" \
        --role="roles/iam.serviceAccountTokenCreator" \
        --quiet

    # Allow logical viewing of the catalog, querying, and running Dataproc jobs
    for ROLE in "roles/datacatalog.viewer" "roles/bigquery.dataViewer" "roles/bigquery.user" "roles/bigquery.connectionUser" "roles/serviceusage.serviceUsageConsumer" "roles/dataproc.worker"; do
        gcloud projects add-iam-policy-binding ${PROJECT_ID} \
            --member="serviceAccount:${EMAIL}" \
            --role="${ROLE}" \
            --quiet
    done
done

# Grant the Manager data creation rights
gcloud projects add-iam-policy-binding ${PROJECT_ID} \
    --member="serviceAccount:${EMAIL_MANAGER}" \
    --role="roles/bigquery.dataEditor" \
    --quiet

echo "✅ Identity and Security setup completed!"
Crea tabelle Apache Iceberg
Utilizza il motore SQL di BigQuery per creare tabelle Apache Iceberg. Anche se esegui i comandi di creazione con BigQuery, Lakehouse funge da livello di gestione che archivia i metadati della tabella e protegge i file Parquet sottostanti in Cloud Storage.
Dopo aver creato le tabelle, esegui una rapida trasformazione per vedere come Knowledge Catalog gestisce la sicurezza e monitora automaticamente il percorso dei dati.
Crea un set di dati BigQuery
Innanzitutto, crea un set di dati BigQuery per raggruppare le tabelle:
echo "Creating BigQuery Dataset..."
bq mk --location=${REGION} --dataset ${PROJECT_ID}:${DATASET_ID}
Crea le tabelle Iceberg
Esegui questi comandi per creare le tabelle di inventario e transazioni:
echo "Creating Iceberg tables..."

# Inventory table
bq query --use_legacy_sql=false \
"CREATE OR REPLACE TABLE \`${PROJECT_ID}.${DATASET_ID}.inventory\` (
    product_id INT64,
    product_name STRING,
    stock_count INT64
)
WITH CONNECTION \`${REGION}.${CONN_NAME}\`
OPTIONS (
    file_format = 'PARQUET',
    table_format = 'ICEBERG',
    storage_uri = 'gs://${ICEBERG_BUCKET}/inventory/'
);"

# Transactions table
bq query --use_legacy_sql=false \
"CREATE OR REPLACE TABLE \`${PROJECT_ID}.${DATASET_ID}.transactions\` (
    id INT64,
    item STRING,
    amount FLOAT64,
    transaction_date DATE
)
WITH CONNECTION \`${REGION}.${CONN_NAME}\`
OPTIONS (
    file_format = 'PARQUET',
    table_format = 'ICEBERG',
    storage_uri = 'gs://${ICEBERG_BUCKET}/transactions/'
);"
Inserisci dati campionati
Inserisci dati di esempio nelle tabelle:
echo "Inserting data into Iceberg tables..."

# Insert into Inventory table
bq query --use_legacy_sql=false \
"INSERT INTO \`${PROJECT_ID}.${DATASET_ID}.inventory\` (product_id, product_name, stock_count)
VALUES (101, 'Widget A', 500), (102, 'Widget B', 250), (103, 'Widget C', 800);"

# Insert into Transactions table
bq query --use_legacy_sql=false \
"INSERT INTO \`${PROJECT_ID}.${DATASET_ID}.transactions\` (id, item, amount, transaction_date)
VALUES
    (1, 'Widget A', 100.0, DATE '2024-01-01'),
    (2, 'Widget B', 150.0, DATE '2024-01-02'),
    (3, 'Widget C', 50.0, DATE '2024-01-03');"
Ora hai due tabelle Iceberg con dati di esempio non elaborati. Lakehouse gestisce i metadati, ma i file Parquet effettivi si trovano nel tuo bucket Cloud Storage.
Trasforma i dati per la derivazione automatica
Aggrega le transazioni non elaborate in un riepilogo delle vendite giornaliere. Questa trasformazione crea una nuova tabella e genera i metadati utilizzati da Knowledge Catalog per mappare automaticamente il percorso dei dati.
echo "Creating transactions summary table..."
bq query --use_legacy_sql=false \
"CREATE TABLE \`${PROJECT_ID}.${DATASET_ID}.transactions_summary\` AS
 SELECT transaction_date, SUM(amount) as total_sales, COUNT(id) as transaction_count
 FROM \`${PROJECT_ID}.${DATASET_ID}.transactions\`
 GROUP BY transaction_date;"
Definisci le policy di governance degli accessi
In un ambiente di produzione, la scrittura delle regole di sicurezza sotto forma di codice (infrastructure as code) rende le policy ripetibili, sottoposte a controllo della versione e più facili da gestire. In questa sezione utilizzerai l'SDK Python Google Cloud per definire e applicare automaticamente le regole.
Prepara l'ambiente virtuale Python
Configura un ambiente virtuale Python isolato per gestire le dipendenze e garantire l'esecuzione affidabile degli script:
# Create and activate a virtual environment
python3 -m venv lakehouse_env
source lakehouse_env/bin/activate

# Install required Knowledge Catalog and BigQuery governance libraries
pip install google-cloud-datacatalog google-cloud-bigquery-datapolicies google-cloud-bigquery --quiet

echo "✅ Python environment is ready!"
Definisci tassonomie e tag di sicurezza
Inizia creando le basi per le tue regole di sicurezza. In questo passaggio, creerai una tassonomia che fungerà da contenitore e un tag di policy che fungerà da etichetta di sicurezza specifica per i dati sensibili.
Esegui lo script per creare le risorse:
python 1_create_taxonomy.py
Esamina 1_create_taxonomy.py per vedere la logica di base:
# Create Taxonomy with Fine-Grained Access Control enabled
taxonomy = datacatalog_v1.Taxonomy(
    display_name="BusinessCritical",
    activated_policy_types=[datacatalog_v1.Taxonomy.PolicyType.FINE_GRAINED_ACCESS_CONTROL]
)
created_taxonomy = client.create_taxonomy(parent=parent, taxonomy=taxonomy)

# Create Policy Tag inside the Taxonomy
policy_tag = datacatalog_v1.PolicyTag(display_name="RestrictedFinancial")
created_policy_tag = client.create_policy_tag(parent=created_taxonomy.name, policy_tag=policy_tag)
Impostando esplicitamente il tipo di policy FINE_GRAINED_ACCESS_CONTROL, trasformi un tag di metadati standard in un confine di sicurezza rigoroso con negazione predefinita. Qualsiasi colonna con questo tag nega l'accesso a tutti gli utenti per impostazione predefinita.
Crea una policy di mascheramento dinamico dei dati
Ora definisci cosa succede quando un utente senza privilegi esegue una query su una colonna con tag. Crea una policy di mascheramento dei dati che sostituisca automaticamente i valori sensibili con NULL per la persona Analyst.
Esegui lo script per configurare la regola di mascheramento:
python 2_create_masking.py
All'interno di 2_create_masking.py, lo script cerca l'ID del tag di criteri che hai creato e applica la policy dati all'account di servizio Analyst:
# Define a Masking Policy that always returns NULL
data_policy = bigquery_datapolicies_v1.DataPolicy(
    data_policy_id="mask_financial_null",
    policy_tag=policy_tag_id,
    data_policy_type=bigquery_datapolicies_v1.DataPolicy.DataPolicyType.DATA_MASKING_POLICY,
    data_masking_policy=bigquery_datapolicies_v1.DataMaskingPolicy(
        predefined_expression=bigquery_datapolicies_v1.DataMaskingPolicy.PredefinedExpression.ALWAYS_NULL
    )
)

# ... (Policy creation code) ...

# Bind the Masked Reader role to the Analyst
iam_policy.bindings.add(
    role="roles/bigquerydatapolicy.maskedReader",
    members=[f"serviceAccount:{analyst_email}"]
)
Concedi l'accesso con privilegi ai tuoi dati
A causa della configurazione di negazione per impostazione predefinita, nessuno può leggere la colonna con tag. Devi concedere esplicitamente l'accesso agli utenti autorizzati. Assegna alla persona Manager e al tuo account il ruolo Fine-Grained Reader (roles/datacatalog.categoryFineGrainedReader). In questo modo, questi utenti specifici possono bypassare le regole di mascheramento e leggere i dati non mascherati.
Esegui lo script per concedere l'accesso:
python 3_grant_access.py
All'interno di 3_grant_access.py, lo script modifica la policy IAM del tag di criteri:
# Grant original data read access
iam_policy.bindings.add(
    role="roles/datacatalog.categoryFineGrainedReader",
    members=[f"serviceAccount:{manager_email}", f"user:{current_user}"]
)
client.set_iam_policy(request=iam_policy_pb2.SetIamPolicyRequest(resource=policy_tag_id, policy=iam_policy))
Associa i tag di sicurezza allo schema della tabella
Infine, puoi collegare le regole logiche ai dati effettivi. Aggiorna lo schema della tabella Iceberg per collegare il tag di criteri direttamente alla colonna amount. In questo modo, Lakehouse applica immediatamente le protezioni ai file delle tabelle Iceberg nel bucket.
Esegui lo script per collegare il tag di criteri:
python 4_attach_tag.py
Consulta le 4_attach_tag.py. Lo script recupera lo schema della tabella BigQuery, esegue l'iterazione dei campi e associa il tag in modo specifico alla colonna amount:
new_schema =[]
for field in table.schema:
    if field.name == 'amount':
        # Wrap the Policy Tag ID and attach it to the column
        policy_tags_list = bigquery.PolicyTagList(names=[policy_tag_id])
        new_field = bigquery.SchemaField(
            name=field.name, field_type=field.field_type, mode=field.mode,
            description=field.description, policy_tags=policy_tags_list
        )
        new_schema.append(new_field)
    else:
        new_schema.append(field)

# Update the table schema in BigQuery
table.schema = new_schema
client.update_table(table, ["schema"])
Verifica le policy di sicurezza
Esegui alcune query di test per assicurarti che le autorizzazioni funzionino come previsto. Per dimostrare che Knowledge Catalog funge da motore di contesto universale applicando le stesse policy di sicurezza quando cambi i motori di query, esegui questi test utilizzando sia BigQuery che Apache Spark.
Esegui test con BigQuery SQL
Inizia controllando le policy direttamente in BigQuery. Questo è il modo più rapido per verificare che le regole di mascheramento e le autorizzazioni siano attive.
Controlla come gestore
La persona Manager ha un accesso con privilegi di lettura granulare. Dovrebbero vedere ogni dettaglio della tabella, inclusi i valori nella colonna amount.
# Impersonate the Manager
gcloud config set auth/impersonate_service_account ${EMAIL_MANAGER}

# Query the transactions table
bq query --use_legacy_sql=false "SELECT * FROM \`${PROJECT_ID}.${DATASET_ID}.transactions\`"
Poiché il gestore ha il ruolo Fine-Grained Reader (roles/datacatalog.categoryFineGrainedReader), la query mostra i valori degli importi non elaborati:
+----+----------+--------+------------------+
| id |   item   | amount | transaction_date |
+----+----------+--------+------------------+
|  1 | Widget A |  100.0 |       2024-01-01 |
|  3 | Widget C |   50.0 |       2024-01-03 |
|  2 | Widget B |  150.0 |       2024-01-02 |
+----+----------+--------+------------------+
Controlla come analista
Passa all'utente tipo Analyst ed esegui la stessa query.
gcloud config set auth/impersonate_service_account ${EMAIL_ANALYST}

bq query --use_legacy_sql=false "SELECT * FROM \`${PROJECT_ID}.${DATASET_ID}.transactions\`"
Anche se esegui la stessa query, Knowledge Catalog maschera i valori sensibili nella colonna amount:
+----+----------+--------+------------------+
| id |   item   | amount | transaction_date |
+----+----------+--------+------------------+
|  1 | Widget A |   NULL |       2024-01-01 |
|  3 | Widget C |   NULL |       2024-01-03 |
|  2 | Widget B |   NULL |       2024-01-02 |
+----+----------+--------+------------------+
Torna al tuo account
Esegui la pulizia dello stato di autenticazione di Cloud Shell per tornare all'utente amministratore.
gcloud config unset auth/impersonate_service_account
Esegui test con Apache Spark
La sicurezza spesso viene meno quando gli utenti accedono direttamente ai file di dati in Cloud Storage. Se un data scientist utilizza Apache Spark per leggere direttamente i file della tabella Iceberg, normalmente bypassa le tue regole perché Cloud Storage comprende solo le autorizzazioni a livello di bucket.
Per evitare che ciò accada, utilizza la delega di calcolo. Utilizzando il connettore Spark-BigQuery, crei un bridge sicuro che instrada tutte le richieste Spark tramite l'API BigQuery Storage. In questo modo, Knowledge Catalog controlla le autorizzazioni e applica le regole di mascheramento prima che i dati raggiungano il cluster Spark.
Carica lo script read_transactions.py nel tuo bucket Cloud Storage in modo che Managed Service for Apache Spark possa accedervi:
# Upload script to Cloud Storage
gsutil cp read_transactions.py gs://${ICEBERG_BUCKET}/scripts/read_transactions.py
Esamina la logica di base nello script che hai caricato:
# Reading data via Compute Delegation (Knowledge Catalog policies are applied dynamically here)
df = spark.read \
    .format("bigquery") \
    .option("table", f"{project_id}.{dataset_id}.{table_name}") \
    .load()

print("\n=== 📊 Data Preview ===")
df.show(truncate=False)
Lo script non indirizza Spark al percorso gs:// dei file Iceberg. Specificando .format("bigquery"), l'API BigQuery Storage intercetta la richiesta di lettura, controlla l'identità dell'utente che esegue il job Spark, applica le regole di mascheramento di Knowledge Catalog e restituisce solo i dati autorizzati al DataFrame Spark.
Esegui Spark come gestore
Invia un job Spark come Manager. Utilizza Managed Service for Apache Spark, un servizio gestito che ti consente di eseguire workload Spark senza dover gestire i tuoi cluster:
echo "🚀 Submitting Dataproc Serverless Job as [MANAGER]..."
gcloud dataproc batches submit pyspark gs://${ICEBERG_BUCKET}/scripts/read_transactions.py \
    --project=${PROJECT_ID} \
    --region=${REGION} \
    --service-account=${EMAIL_MANAGER} \
    --version=2.3 \
    -- ${PROJECT_ID} ${DATASET_ID} \
    --format="value(name)"
Esamina i log di output del job nel terminale. Poiché il gestore ha il ruolo Fine-Grained Reader (roles/datacatalog.categoryFineGrainedReader), Spark recupera correttamente gli importi in chiaro:
=== 📊 Data Preview ===
+---+--------+------+-------------------+
|id |item    |amount|transaction_date   |
+---+--------+------+-------------------+
|1  |Widget A|100.0 |2024-01-01         |
|2  |Widget B|150.0 |2024-01-02         |
|3  |Widget C|50.0  |2024-01-03         |
+---+--------+------+-------------------+
Esegui Spark come analista
Infine, esegui lo stesso codice Spark del ruolo Analyst:
echo "🚀 Submitting Dataproc Serverless Job as [ANALYST]..."
gcloud dataproc batches submit pyspark gs://${ICEBERG_BUCKET}/scripts/read_transactions.py \
    --project=${PROJECT_ID} \
    --region=${REGION} \
    --service-account=${EMAIL_ANALYST} \
    --version=2.3 \
    -- ${PROJECT_ID} ${DATASET_ID} \
    --format="value(name)"
Esamina di nuovo i log. Anche se l'analista ha eseguito lo stesso codice Spark, l'API BigQuery Storage ha intercettato la richiesta e ha applicato la policy di Knowledge Catalog. Il DataFrame Spark dell'analista mostra null per gli importi.
=== 📊 Data Preview ===
+---+--------+------+-------------------+
|id |item    |amount|transaction_date   |
+---+--------+------+-------------------+
|1  |Widget A|null  |2024-01-01         |
|2  |Widget B|null  |2024-01-02         |
|3  |Widget C|null  |2024-01-03         |
+---+--------+------+-------------------+
Hai appena dimostrato che, in qualità di control plane centrale, Knowledge Catalog applica le policy di sicurezza in modo coerente, indipendentemente dal motore di query utilizzato.
Visualizza il percorso dei tuoi dati con la derivazione automatica
Un lakehouse conforme alle policy richiede non solo controlli degli accessi, ma anche una traccia di audit chiara. La derivazione dei dati ti aiuta a capire da dove provengono i dati e come vengono trasformati. Rispondere a domande essenziali come "Quali tabelle non elaborate sono state utilizzate per produrre questo report sulle vendite?" ti aiuta a mantenere la conformità, eseguire rapidamente il debug delle pipeline di dati e creare una base di dati affidabile.
Anziché scrivere manualmente un codice di logging complesso, Knowledge Catalog monitora automaticamente questo ciclo di vita nell'intera architettura. Ad esempio, quando hai creato una tabella di riepilogo in precedenza in questo tutorial, BigQuery ha acquisito istantaneamente i dettagli della trasformazione e li ha inviati a Knowledge Catalog. In questo modo, il contesto e la cronologia dei dati vengono aggiornati dinamicamente.
Esplora il grafico di derivazione interattivo
Dai un'occhiata alla mappa interattiva generata da Knowledge Catalog. Mostra il flusso di dati non elaborati dalla tabella transactions alla tabella transactions_summary. Poiché Knowledge Catalog raccoglie i metadati come motore di contesto dinamico, questo grafico mostra la tracciabilità affidabile e in tempo reale necessaria per un audit dei dati.
- Nella console Google Cloud , vai a Knowledge Catalog > Ricerca.
- Digita
lakehouse_retail_demo.transactions_summarynella barra di ricerca e fai clic sulla tabella. - Fai clic sulla scheda Lineage.
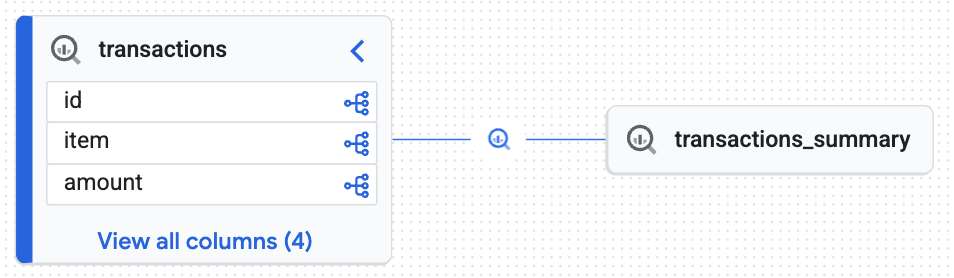
Il grafico interattivo conferma che la tabella di destinazione (transactions_summary) deriva dalla tabella Iceberg non elaborata e regolamentata (transactions). Questa visualizzazione dimostra la tracciabilità end-to-end dei tuoi dati.
Esegui la pulizia
Per evitare addebiti continui, rimuovi le risorse che hai creato per questo tutorial.
Rimuovi gli asset di norme e metadati
Prima di poter eliminare il set di dati BigQuery o il bucket Cloud Storage, devi eliminare le policy di governance dei dati e gli asset di metadati.
Esegui lo script di pulizia Python:
python cleanup_governance.py
Esamina lo script cleanup_governance.py dal repository per trovare la seguente logica di eliminazione. L'ordine di eliminazione è fondamentale. Innanzitutto, elimina la policy di mascheramento dei dati. Quindi, elimina la tassonomia principale, il che rimuove automaticamente tutti i tag di policy sottostanti ed evita errori di dipendenza delle risorse.
# 1. Delete Data Policy
data_policy_name = f"{parent_loc}/dataPolicies/mask_financial_null"
dp_client.delete_data_policy(name=data_policy_name)

# 2. Find and Delete Taxonomy (This auto-deletes child Policy Tags)
taxonomies = catalog_client.list_taxonomies(parent=parent_loc)
taxonomy_id = next((t.name for t in taxonomies if t.display_name == "BusinessCritical"), None)
catalog_client.delete_taxonomy(name=taxonomy_id)
Rimuovi le identità e gli asset di archiviazione e computing
Elimina le tabelle BigQuery, i bucket Cloud Storage, i service account e l'ambiente virtuale Python locale.
Copia ed esegui questo script di pulizia in Cloud Shell:
echo "Deleting Service Accounts and Impersonation Bindings..."
export CURRENT_USER=$(gcloud config get-value account)

for USER in "${USER_ANALYST}" "${USER_MANAGER}"; do
    EMAIL="${USER}@${PROJECT_ID}.iam.gserviceaccount.com"

    # Remove impersonation binding
    gcloud iam service-accounts remove-iam-policy-binding ${EMAIL} \
        --member="user:${CURRENT_USER}" \
        --role="roles/iam.serviceAccountTokenCreator" \
        --quiet > /dev/null 2>&1

    # Delete the Service Account
    gcloud iam service-accounts delete ${EMAIL} --quiet
done

echo "Removing BigQuery Dataset and Tables..."
bq rm -f ${DATASET_ID}.transactions_summary
bq rm -f ${DATASET_ID}.transactions
bq rm -f ${DATASET_ID}.inventory
bq rm -f -d ${DATASET_ID}

echo "Removing BigQuery Cloud Resource Connection..."
bq rm --connection --location=${REGION} ${CONN_NAME}

echo "Removing Iceberg Cloud Storage Bucket..."
gcloud storage rm --recursive gs://${ICEBERG_BUCKET} --quiet

echo "Removing Auto-generated Dataproc Staging & Temp Buckets..."
for BUCKET in $(gcloud storage ls | grep -E "gs://dataproc-(staging|temp)-${REGION}"); do
    gcloud storage rm --recursive $BUCKET --quiet
done

echo "✅ Clean up completed successfully!"
Ripulisci i file di progetto:
echo "Deactivating and removing the local Python environment..."
deactivate
cd ../..
rm -rf devrel-demos
Conclusione
Hai creato un data lakehouse sicuro. Utilizzando Lakehouse per gestire le tabelle Iceberg, hai mantenuto i file delle tabelle sottostanti al sicuro in Cloud Storage. Impostando Knowledge Catalog come motore di contesto universale, hai definito i tag di policy in una posizione centrale e li hai applicati in modo coerente a diversi motori di query come BigQuery SQL e Apache Spark. Infine, hai monitorato automaticamente l'intero percorso dei dati con la derivazione dei dati in tempo reale.
Passaggi successivi
- Recupera il contesto dei dati per gli agenti AI: Recupera il contesto dei dati con l'API Context.
- Approfondimento sulla derivazione dei dati: Visualizza le informazioni sulla derivazione dei dati.
- Esplora controllo dell'accesso avanzato: per implementare scenari di sicurezza più complessi, consulta la documentazione ufficiale sulla personalizzazione di Lakehouse con funzionalità aggiuntive.
- Managed Service for Apache Spark: scopri come scalare le pipeline di dati senza eseguire il provisioning dei cluster nella documentazione di Managed Service for Apache Spark.
- Prova altri casi d'uso: prova altri casi d'uso di Knowledge Catalog.