


Knowledge Catalog (sebelumnya Dataplex Universal Catalog) memudahkan pemahaman dan analisis data Anda dengan otomatis membuat profil tabel BigQuery, Google Cloud Lakehouse Iceberg REST Catalog, SAP Business Data Cloud (BDC) Delta Lake, dan Hive.
Pembuatan profil mirip dengan mendapatkan laporan kesehatan mendetail untuk data Anda. Fitur ini memberi Anda statistik utama, seperti nilai umum, cara data tersebar (distribusi), dan jumlah entri yang hilang (jumlah null). Informasi ini mempercepat analisis Anda.
Pembuatan profil data merekomendasikan aturan pemeriksaan kualitas data untuk memastikan data Anda tetap andal.
Model konseptual
Knowledge Catalog memungkinkan Anda lebih memahami profil data dengan membuat pemindaian profil data. Pemindaian profil data adalah jenis pemindaian data Knowledge Catalog yang menganalisis BigQuery, Google Cloud Lakehouse Iceberg REST Catalog, SAP BDC Delta Lake, atau tabel Hive untuk menghasilkan insight statistik.
Diagram berikut menunjukkan cara Knowledge Catalog memindai data untuk melaporkan karakteristik statistik.
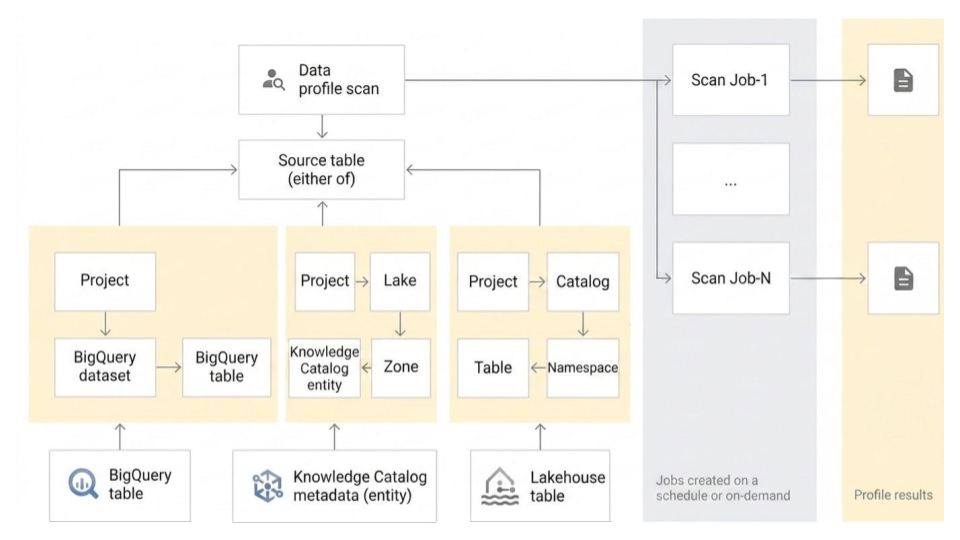
Pemindaian profil data dikaitkan dengan satu tabel BigQuery, Google Cloud Lakehouse Iceberg REST Catalog, SAP BDC Delta Lake, atau Hive, dan memindai tabel untuk menghasilkan hasil pembuatan profil data. Pemindaian profil data mendukung beberapa opsi konfigurasi.
Opsi konfigurasi
Bagian ini menjelaskan opsi konfigurasi yang tersedia untuk menjalankan pemindaian profil data.
Mode pembuatan profil
Anda dapat memilih di antara mode pembuatan profil berikut:
Standard: Ini adalah mode default. Fitur ini memberikan profil yang komprehensif dan dapat disesuaikan dengan memindai data Anda berdasarkan pengambilan sampel dan filter yang Anda tentukan. Mode standar cocok untuk analisis mendetail dan pemantauan karakteristik data jangka panjang.
Ringan (Pratinjau): Mode ini menyediakan pemindaian profil latensi rendah yang menampilkan hasil dalam hitungan detik. Model ini dioptimalkan untuk kecepatan dan efisiensi biaya guna mendukung kasus penggunaan seperti berikut:
- Mendasarkan respons agen AI pada karakteristik data langsung
- Membuat profil secara hemat biaya dalam skala besar untuk penemuan data global
- Memberikan laporan kondisi yang cepat selama eksplorasi data interaktif
Mode ringan memiliki batasan berikut:
- Tidak seperti mode pembuatan profil standar, Anda tidak dapat mengubah cakupan, filter, atau ukuran pengambilan sampel pada pemindaian ringan.
- Template ini tidak mendukung tampilan dan tabel eksternal BigQuery.
Opsi penjadwalan
Anda dapat menjadwalkan pemindaian profil data dengan frekuensi yang ditentukan, atau menjalankan pemindaian sesuai permintaan. Jika tugas pemindaian berjalan lebih lama dari yang diperkirakan, Anda dapat membatalkan tugas.
Identitas eksekusi
Secara default, Knowledge Catalog menggunakan agen layanan terpusat (service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com) untuk menjalankan pemindaian profil data.
Anda juga dapat mengganti identitas eksekusi default ini dengan menentukan akun layanan kustom atau menggunakan Kredensial Pengguna Akhir (EUC) Anda sendiri. Hal ini memberikan beberapa manfaat:
- Prinsip hak istimewa terendah: Hanya berikan izin Identity and Access Management (IAM) yang tepat yang diperlukan untuk tugas pembuatan profil data tertentu ke akun layanan khusus, sehingga meminimalkan akses yang disediakan secara berlebihan.
- Kontrol akses terperinci: Cakupan izin untuk resource tertentu, yang memungkinkan integrasi dengan kebijakan akses tingkat baris dan tingkat kolom di BigQuery.
- Kemampuan audit yang lebih baik: Menetapkan akun layanan kustom atau kredensial pengguna ke pemindaian tertentu, sehingga pelacakan dan pencatatan aktivitas menjadi jauh lebih jelas di log audit.
- Penyatuan penagihan: Saat Anda menggunakan identitas eksekusi kustom, biaya pemrosesan dan penyimpanan dipusatkan langsung di BigQuery (melewati SKU Knowledge Catalog Premium). Dengan demikian, Anda dapat memanfaatkan diskon perusahaan dan komitmen slot BigQuery.
Untuk petunjuk tentang cara mengonfigurasi identitas eksekusi kustom, lihat Mengonfigurasi identitas eksekusi.
Persyaratan jaringan
Untuk menjalankan pemindaian, Anda harus mengaktifkan Akses Google Pribadi di subnet VPC yang Anda gunakan untuk pemindaian. Jika Anda tidak menentukan subnet, pastikan subnet default Anda telah mengaktifkan Akses Google Pribadi.
Cakupan
Untuk pemindaian pembuatan profil Standard, Anda dapat menentukan cakupan data yang akan dipindai:
Tabel lengkap: Seluruh tabel dipindai dalam pemindaian profil data. Pengambilan sampel, filter baris, dan filter kolom diterapkan di seluruh tabel sebelum menghitung statistik pembuatan profil.
Inkremental: Data inkremental yang Anda tentukan akan dipindai dalam pemindaian profil data. Tentukan kolom
DateatauTimestampdalam tabel yang akan digunakan sebagai penambahan. Biasanya, ini adalah kolom tempat tabel dipartisi. Sampling, filter baris, dan filter kolom diterapkan pada data inkremental sebelum menghitung statistik pembuatan profil.
Memfilter data
Untuk pemindaian pembuatan profil Standard, Anda dapat memfilter data yang akan dipindai untuk pembuatan profil menggunakan filter baris dan filter kolom. Penggunaan filter membantu Anda mengurangi waktu dan biaya operasi, serta mengecualikan data sensitif dan tidak diperlukan. Pemindaian pembuatan profil ringan tidak mendukung filter kolom dan filter baris.
Filter baris: filter baris memungkinkan Anda berfokus pada data dalam jangka waktu tertentu atau dari segmen tertentu, seperti wilayah. Misalnya, Anda dapat memfilter data dengan stempel waktu sebelum tanggal tertentu.
Filter kolom: filter kolom memungkinkan Anda menyertakan dan mengecualikan kolom tertentu dari tabel untuk menjalankan pemindaian profil data.
Data sampel
Untuk pemindaian pembuatan profil Standard, Anda dapat menentukan persentase data dari data Anda yang akan dijadikan sampel untuk menjalankan pemindaian profil data. Membuat pemindaian profil data pada sampel data yang lebih kecil dapat mengurangi waktu proses dan biaya kueri seluruh set data.
Beberapa pemindaian profil data
Anda dapat membuat beberapa pemindaian profil data sekaligus menggunakan konsol Google Cloud . Anda dapat memilih hingga 100 tabel dari satu set data dan membuat pemindaian profil data untuk setiap set data. Untuk mengetahui informasi selengkapnya, lihat Membuat beberapa pemindaian profil data.
Mengekspor hasil pemindaian ke tabel BigQuery
Anda dapat mengekspor hasil pemindaian profil data ke tabel BigQuery untuk analisis lebih lanjut. Untuk menyesuaikan pelaporan, Anda dapat menghubungkan data tabel BigQuery ke dasbor Looker. Anda dapat membuat laporan gabungan menggunakan tabel hasil yang sama di beberapa pemindaian.
Hasil pembuatan profil data
Hasil pembuatan profil data mencakup nilai berikut:
| Jenis kolom | Hasil pembuatan profil data |
|---|---|
| Kolom numerik |
|
| Kolom string |
|
| Kolom lain yang tidak bertingkat (tanggal, waktu, stempel waktu, biner, dll.) |
|
| Semua kolom berformat khusus bertingkat atau kompleks lainnya (seperti Record, Array, JSON) atau kolom apa pun dengan mode repeated. |
|
Hasilnya mencakup jumlah data yang dipindai di setiap tugas.
Pelaporan dan pemantauan
Anda dapat memantau dan menganalisis hasil pembuatan profil data menggunakan laporan dan metode berikut:
Laporan yang dipublikasikan dengan tabel sumber di halaman BigQuery dan Knowledge Catalog
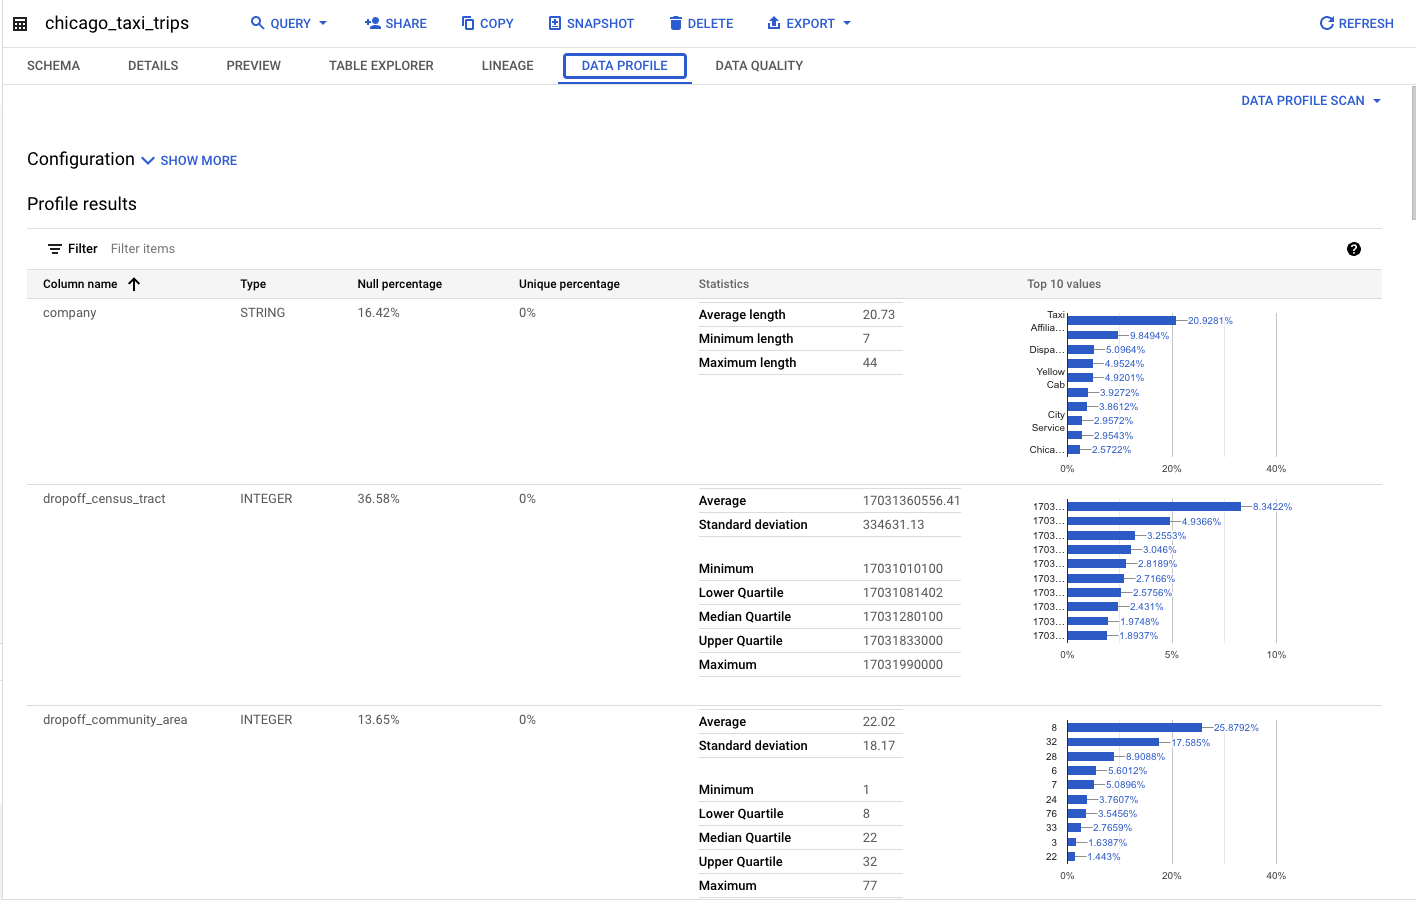
Jika Anda mengonfigurasi pemindaian profil data untuk memublikasikan hasilnya ke BigQuery dan Knowledge Catalog, Anda dapat melihat hasil pemindaian profil data terbaru di tab Data profile tabel sumber di BigQuery dan Knowledge Catalog. Hasil ini dapat diakses dari project mana pun.
Laporan historis per tugas
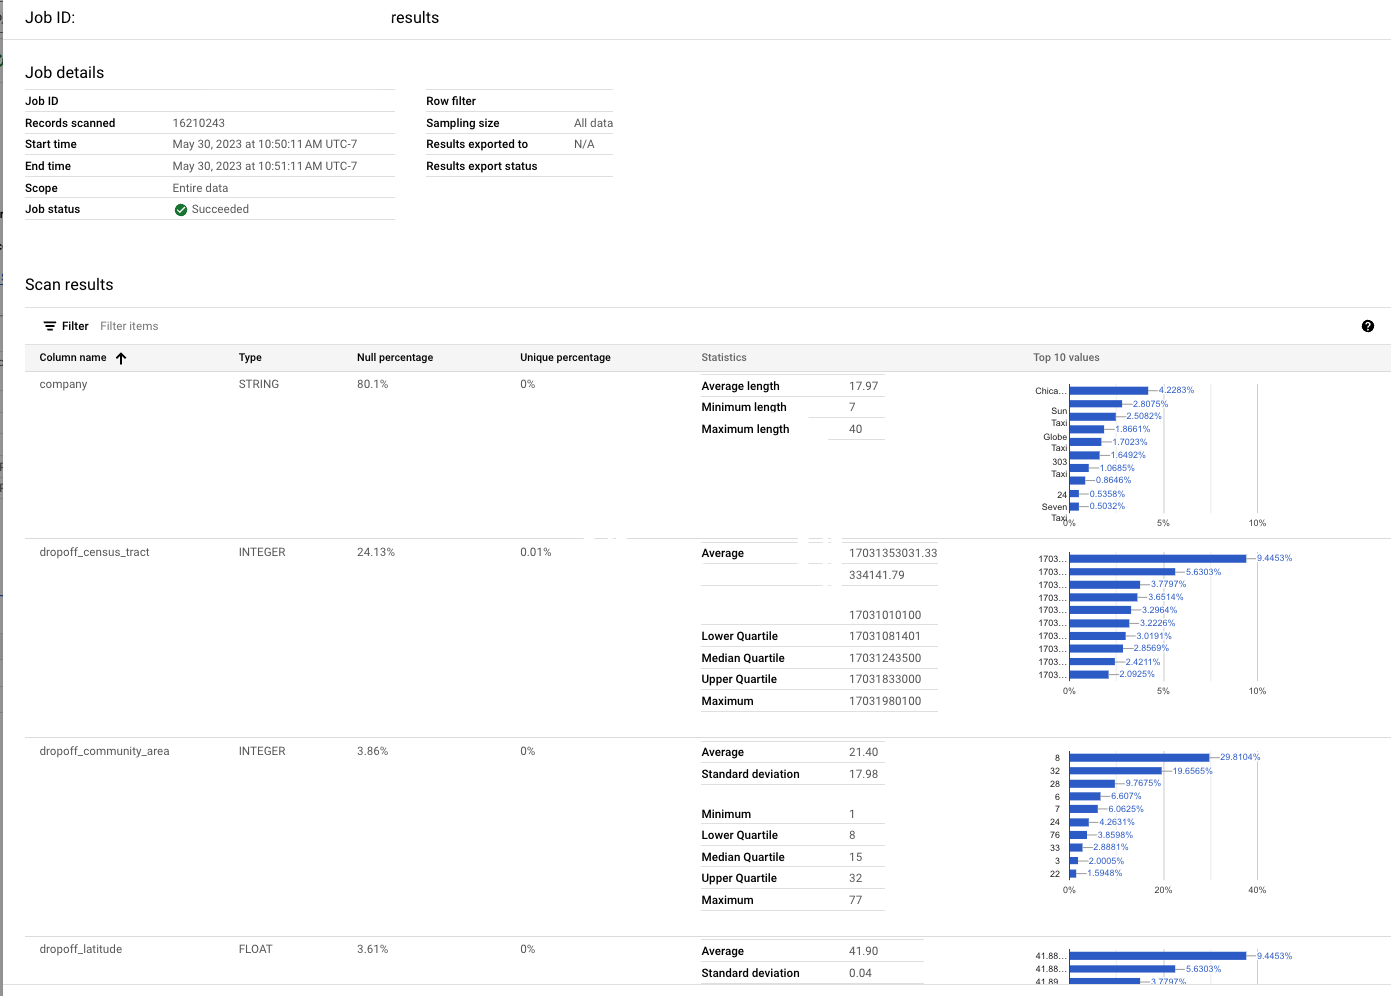
Di halaman Data profiling & quality > Pemindaian profil data di Knowledge Catalog dan BigQuery, Anda dapat melihat laporan mendetail untuk tugas terbaru dan historis. Hal ini mencakup informasi profil tingkat kolom dan konfigurasi yang digunakan.
Tab Analisis
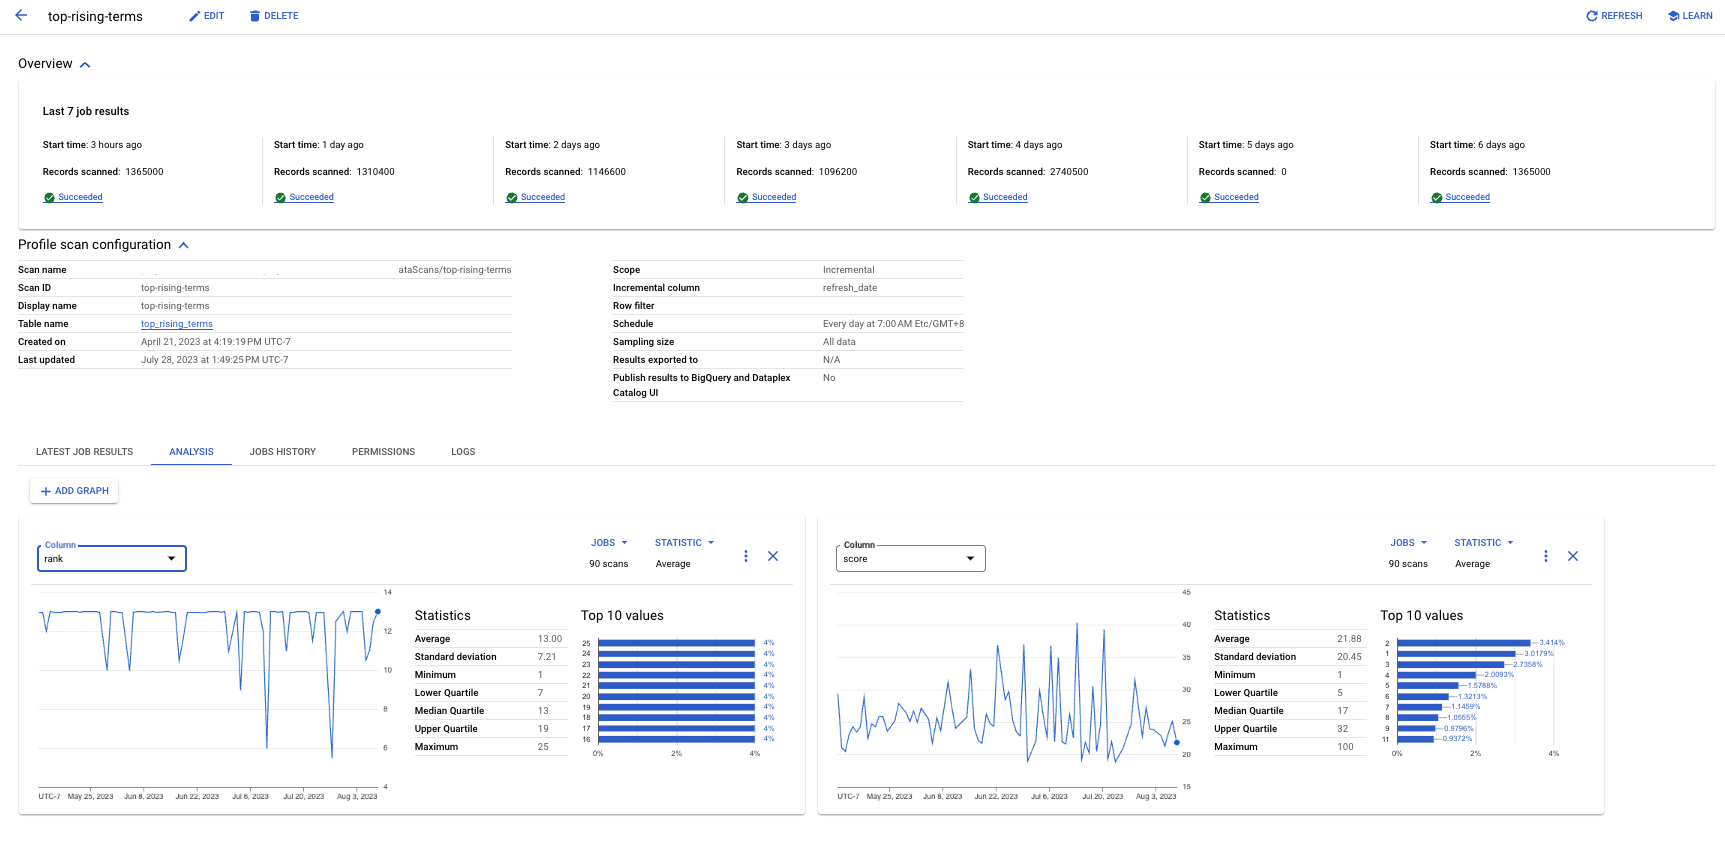
Di halaman Data profiling & quality > Pemindaian profil data di Knowledge Catalog dan BigQuery, Anda dapat menggunakan tab Analysis untuk melihat tren statistik tertentu dari sebuah kolom di beberapa tugas profil. Misalnya, jika memiliki pemindaian inkremental, Anda dapat melihat tren rata-rata nilai dari waktu ke waktu.
Membuat dasbor atau analisis Anda sendiri
Jika telah mengonfigurasi pemindaian profil data untuk mengekspor hasil ke tabel BigQuery, Anda dapat membuat dasbor sendiri menggunakan alat, seperti Data Studio.
Memantau biaya komputasi DCU di Penagihan Cloud
Komputasi pemindaian profil data berjalan di infrastruktur serverless dan tidak memancarkan metrik deret waktu ke Cloud Monitoring. Untuk melacak dan mengatribusikan biaya DCU Profiling Data berdasarkan project, ID pemindaian, atau tabel, buat kueri ekspor Penagihan Cloud di BigQuery menggunakan label sistem
goog-dataplex-datascan-*. Untuk mengetahui informasi selengkapnya, lihat Memantau dan mengatribusikan biaya DCU Dataplex dengan ekspor Penagihan Cloud.
Batasan
- Anda hanya dapat menjalankan pemindaian profil data di tabel BigQuery, Google Cloud Lakehouse Iceberg REST Catalog, SAP BDC Delta Lake, dan Hive.
- Pembuatan profil data didukung untuk tabel BigQuery dengan semua jenis kolom kecuali
BIGNUMERIC. Pemindaian yang dibuat untuk tabel dengan kolomBIGNUMERICakan menghasilkan error validasi dan tidak berhasil dibuat. - Beberapa pemindaian profil data tidak didukung untuk tabel Lakehouse.
Harga
- Untuk mengetahui informasi selengkapnya tentang harga, lihat Harga Knowledge Catalog.
- Untuk melacak dan mengatribusikan penggunaan dan biaya DCU pemindaian Profil Data menggunakan ekspor Penagihan Cloud ke BigQuery, lihat Memantau dan mengatribusikan biaya DCU Dataplex dengan ekspor Penagihan Cloud.
Langkah berikutnya
- Pelajari cara menggunakan pembuatan profil data.
- Untuk mengetahui informasi selengkapnya tentang resource Terraform yang tersedia untuk membuat pemindaian profil data, lihat referensi berikut:
- Resource pemindaian data Knowledge Catalog di registry Terraform.
- Dokumentasi resource pemindaian data Knowledge Catalog di GitHub, yang mendukung konfigurasi aturan berbasis YAML.
- Pelajari kualitas data otomatis.
- Pelajari cara menggunakan kualitas data otomatis.
- Pelajari cara mengeksplorasi data dengan membuat insight data.