


O Knowledge Catalog (antigo Dataplex Universal Catalog) facilita a compreensão e a análise dos seus dados ao criar automaticamente perfis das tabelas do BigQuery, Google Cloud do catálogo REST do Lakehouse Iceberg, do Delta Lake do SAP Business Data Cloud (BDC) e do Hive.
A criação de perfil é como receber um relatório de integridade detalhado dos seus dados. Ele fornece estatísticas importantes, como valores comuns, como os dados estão distribuídos (distribuição) e quantas entradas estão ausentes (contagens nulas). Essas informações aceleram sua análise.
A criação de perfis de dados recomenda regras de verificação de qualidade de dados para garantir que seus dados permaneçam confiáveis.
Modelo conceitual
O Knowledge Catalog permite que você entenda melhor o perfil dos seus dados criando uma verificação do perfil de dados. Uma verificação de perfil de dados é um tipo de verificação de dados do Knowledge Catalog que analisa uma tabela do BigQuery, Google Cloud do Lakehouse Iceberg REST Catalog, do SAP BDC Delta Lake ou do Hive para gerar insights estatísticos.
O diagrama a seguir mostra como o Knowledge Catalog verifica dados para informar sobre características estatísticas.
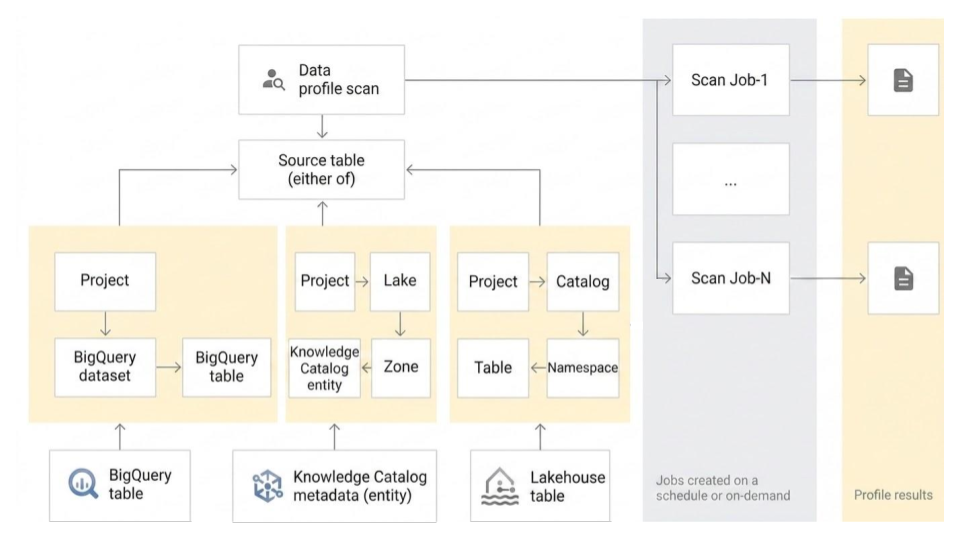
Uma verificação do perfil de dados é associada a uma tabela do BigQuery, Google Cloud do catálogo REST do Lakehouse Iceberg, do Delta Lake do SAP BDC ou do Hive e verifica a tabela para gerar os resultados da criação de perfil de dados. Uma verificação de perfil de dados é compatível com várias opções de configuração.
Opções de configuração
Nesta seção, descrevemos as opções de configuração disponíveis para executar verificações de perfil de dados.
Modos de criação de perfil
É possível escolher entre os seguintes modos de criação de perfil:
Padrão: esse é o modo padrão. Ele fornece um perfil abrangente e personalizável ao verificar seus dados com base na amostragem e nos filtros especificados. O modo padrão é adequado para análises detalhadas e monitoramento de longo prazo das características dos dados.
Leve (pré-lançamento): esse modo oferece verificações de perfil de baixa latência que retornam resultados em segundos. Ele é otimizado para velocidade e custo-benefício para oferecer suporte a casos de uso como os seguintes:
- Embasamento de respostas de agentes de IA com características de dados imediatas
- Pré-geração econômica de perfis em escala para descoberta de dados globais
- Fornecer relatórios de integridade rápidos durante a análise de dados interativa
O modo leve tem as seguintes limitações:
- Ao contrário do modo de criação de perfil padrão, não é possível modificar o escopo, os filtros ou o tamanho da amostragem em verificações leves.
- Ele não é compatível com visualizações e tabelas externas do BigQuery.
Opções de programação
É possível programar uma verificação do perfil de dados com uma frequência definida ou executá-la sob demanda. Se um job de verificação estiver demorando mais do que o esperado, cancele o job.
Identidade de execução
Por padrão, o Knowledge Catalog usa um agente de serviço centralizado (service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com) para executar verificações do perfil de dados.
Também é possível modificar essa identidade de execução padrão especificando uma conta de serviço personalizada ou usando suas próprias credenciais de usuário final (EUC, na sigla em inglês). Isso oferece vários benefícios:
- Princípio de privilégio mínimo:conceda apenas as permissões exatas do Identity and Access Management (IAM) necessárias para tarefas específicas de criação de perfil de dados a uma conta de serviço dedicada, minimizando o acesso excessivo.
- Controle de acesso refinado:defina o escopo das permissões para recursos específicos, permitindo a integração com políticas de acesso no nível da linha e da coluna no BigQuery.
- Auditoria aprimorada:atribua contas de serviço personalizadas ou credenciais de usuário a verificações específicas, tornando o rastreamento e o registro de atividades muito mais claros nos registros de auditoria.
- Unificação de faturamento:quando você usa uma identidade de execução personalizada, as cobranças de processamento e armazenamento são centralizadas diretamente no BigQuery (ignorando as SKUs do Knowledge Catalog Premium). Assim, você pode aproveitar os descontos corporativos e os compromissos de slot do BigQuery.
Para instruções sobre como configurar uma identidade de execução personalizada, consulte Configurar identidade de execução.
Requisitos de rede
Para executar uma verificação, ative o Acesso privado do Google na sub-rede VPC que você usa para a verificação. Se você não especificar uma sub-rede, verifique se a sub-rede padrão tem o Acesso privado do Google ativado.
Escopo
Para verificações de criação de perfil padrão, é possível especificar o escopo dos dados a serem verificados:
Tabela completa: a tabela inteira é verificada na verificação do perfil de dados. A amostragem, os filtros de linha e os filtros de coluna são aplicados a toda a tabela antes de calcular as estatísticas de criação de perfil.
Incremental: os dados incrementais que você especificar serão verificados na verificação do perfil de dados. Especifique uma coluna
DateouTimestampna tabela para ser usada como incremento. Normalmente, essa é a coluna em que a tabela é particionada. A amostragem, os filtros de linha e os filtros de coluna são aplicados aos dados incrementais antes de calcular as estatísticas de criação de perfil.
Filtrar dados
Para verificações de criação de perfil padrão, é possível filtrar os dados a serem verificados para criação de perfil usando filtros de linha e de coluna. O uso de filtros ajuda a reduzir o tempo de execução e o custo, além de excluir dados sensíveis e desnecessários. As verificações de criação de perfil leves não são compatíveis com filtros de coluna e de linha.
Filtros de linha: permitem que você se concentre nos dados de um período específico ou de um segmento específico, como região. Por exemplo, é possível filtrar dados com um carimbo de data/hora anterior a uma determinada data.
Filtros de coluna: permitem incluir e excluir colunas específicas da tabela para executar a verificação do perfil de dados.
Dados de amostra
Para verificações de criação de perfil padrão, é possível especificar uma porcentagem de registros dos seus dados para amostragem ao executar uma verificação do perfil de dados. Criar verificações de perfil de dados em uma amostra menor de dados pode reduzir o tempo de execução e o custo de consulta do conjunto de dados inteiro.
Várias verificações do perfil de dados
É possível criar várias verificações de perfil de dados ao mesmo tempo usando o console do Google Cloud . É possível selecionar até 100 tabelas de um conjunto de dados e criar uma verificação do perfil de dados para cada conjunto. Para mais informações, consulte Criar várias verificações de perfil de dados.
Exportar os resultados da verificação para uma tabela do BigQuery
É possível exportar os resultados da verificação do perfil de dados para uma tabela do BigQuery para análise posterior. Para personalizar os relatórios, conecte os dados da tabela do BigQuery a um painel do Looker. É possível criar um relatório agregado usando a mesma tabela de resultados em várias verificações.
Resultados da criação de perfil de dados
Os resultados da criação de perfil de dados incluem os seguintes valores:
| Tipo de coluna | Resultados da criação de perfil de dados |
|---|---|
| Coluna numérica |
|
| Coluna de string |
|
| Outras colunas não aninhadas (data, hora, carimbo de data/hora, binário etc.) |
|
| Todas as outras colunas com tipo de dados aninhadas ou complexas (como Record, Array, JSON) ou qualquer coluna com o modo repeated. |
|
Os resultados incluem o número de registros verificados em cada job.
Relatórios e monitoramento
É possível monitorar e analisar os resultados da criação de perfil de dados usando os seguintes relatórios e métodos:
Relatórios publicados com a tabela de origem nas páginas do BigQuery e do Knowledge Catalog
Se você configurar uma verificação do perfil de dados para publicar os resultados no BigQuery e no Knowledge Catalog, poderá conferir os resultados mais recentes da verificação do perfil de dados na guia Perfil de dados da tabela de origem no BigQuery e no Knowledge Catalog. Esses resultados podem ser acessados em qualquer projeto.
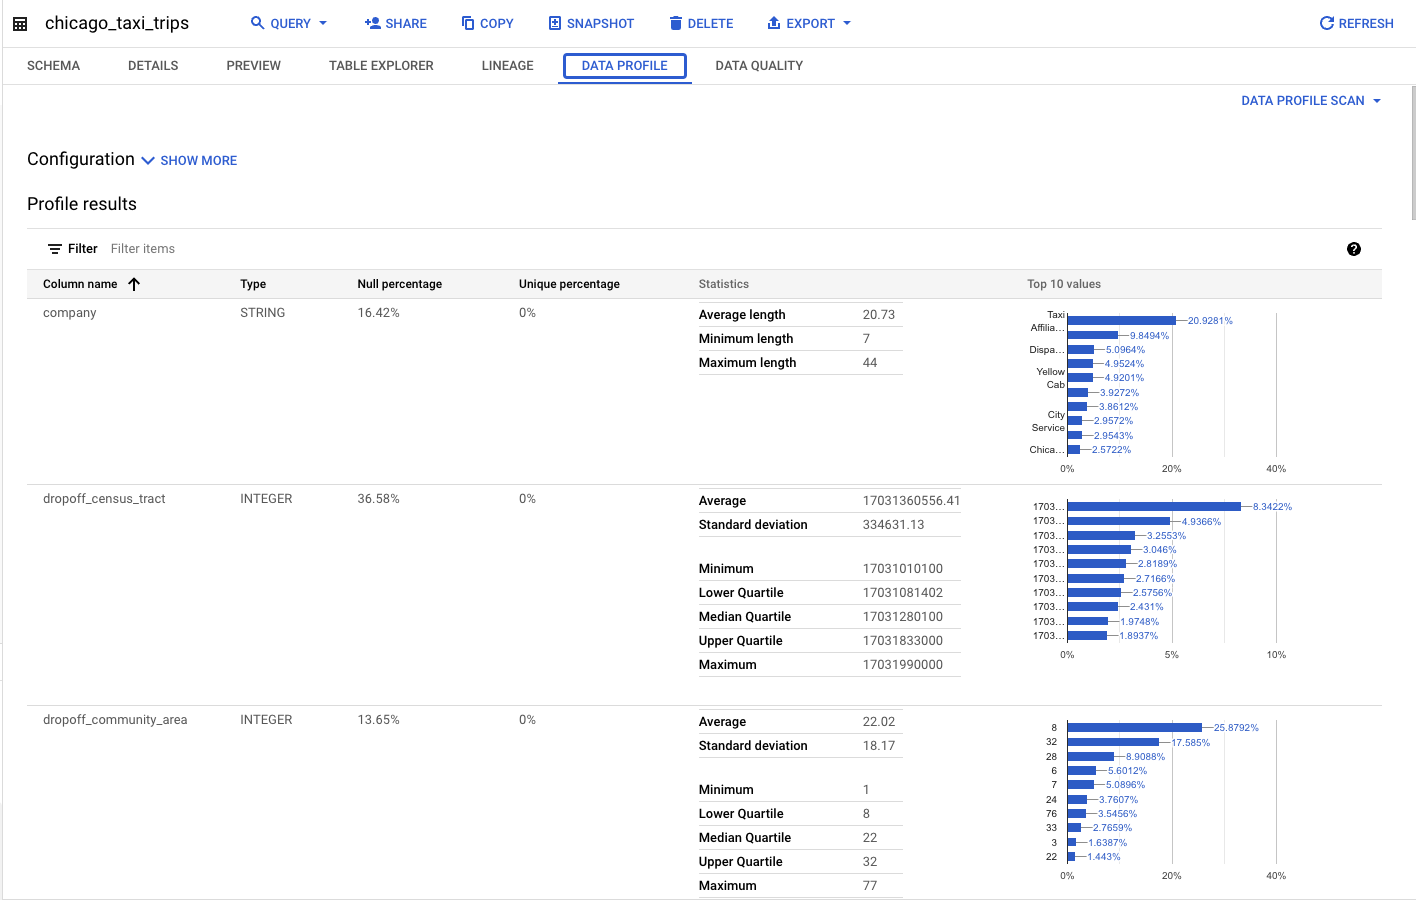
Relatório histórico por job
Na página Qualidade e perfilamento de dados > Verificação do perfil de dados no Knowledge Catalog e no BigQuery, é possível conferir os relatórios detalhados dos jobs mais recentes e históricos. Isso inclui informações de perfil no nível da coluna e a configuração usada.
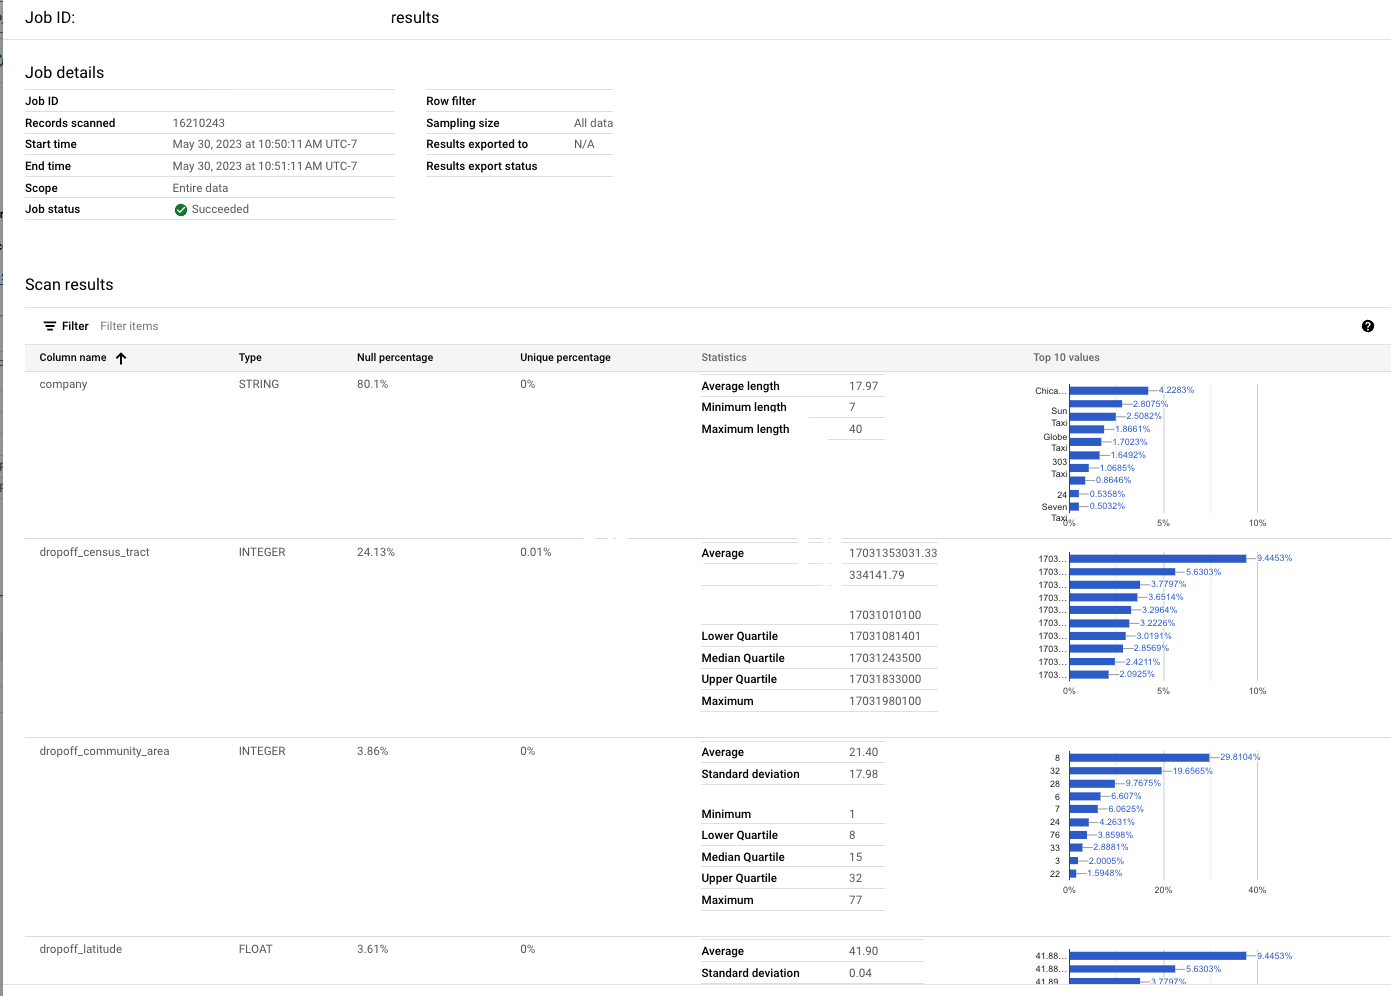
Guia "Análise"
Na página Criação de perfil e qualidade de dados > Verificação do perfil de dados no Knowledge Catalog e no BigQuery, use a guia Análise para conferir as tendências de uma determinada estatística de uma coluna em vários jobs de perfil. Por exemplo, se você tiver uma verificação incremental, poderá ver como a média de um valor tem variado ao longo do tempo.

Criar seu próprio painel ou análise
Se você configurou uma verificação do perfil de dados para exportar resultados para uma tabela do BigQuery, é possível criar seus próprios painéis usando ferramentas como o Data Studio.
Monitorar os custos de computação da DCU no Cloud Billing
A computação da verificação do perfil de dados é executada em uma infraestrutura sem servidor e não emite métricas de série temporal para o Cloud Monitoring. Para rastrear e atribuir custos de DCU de criação de perfil de dados por projeto, ID de verificação ou tabela, consulte a exportação do Cloud Billing no BigQuery usando os rótulos do sistema
goog-dataplex-datascan-*. Para mais informações, consulte Monitorar e atribuir custos de DCU do Dataplex com a exportação do Cloud Billing.
Limitações
- Só é possível executar verificações de perfil de dados em tabelas do BigQuery, Google Cloud do catálogo REST do Lakehouse Iceberg, do SAP BDC Delta Lake e do Hive.
- A criação de perfis de dados é compatível com tabelas do BigQuery com todos os tipos de coluna, exceto
BIGNUMERIC. Uma verificação criada para uma tabela com uma colunaBIGNUMERICresulta em um erro de validação e não é criada. - Não é possível fazer várias verificações do perfil de dados em tabelas do Lakehouse.
Preços
- Para mais informações sobre preços, consulte Preços do Knowledge Catalog.
- Para rastrear e atribuir o uso e os custos de DCU da verificação de criação de perfil de dados usando a exportação do Cloud Billing para o BigQuery, consulte Monitorar e atribuir custos de DCU do Dataplex com a exportação do Cloud Billing.
A seguir
- Saiba como usar a criação de perfil de dados.
- Para mais informações sobre os recursos do Terraform disponíveis para criar verificações de perfil de dados, consulte:
- Recurso de verificação de dados do Knowledge Catalog no registro do Terraform.
- A documentação do recurso de verificação de dados do Knowledge Catalog no GitHub, que oferece suporte à configuração de regras baseada em YAML.
- Saiba mais sobre a qualidade de dados automática.
- Saiba como usar a qualidade de dados automática.
- Saiba como explorar seus dados ao gerar insights de dados.