


Mit Knowledge Catalog (früher Dataplex Universal Catalog) können Sie die Qualität der Daten in Ihren BigQuery- und Iceberg REST Catalog-Tabellen definieren und messen. Sie können das Scannen von Daten automatisieren, Daten anhand definierter Regeln validieren und Warnmeldungen protokollieren, wenn Ihre Daten die Qualitätsanforderungen nicht erfüllen. Mit der automatischen Datenqualität können Sie Datenqualitätsregeln und Bereitstellungen als Code verwalten und so die Integrität von Pipelines für die Datenproduktion verbessern.
Informationen zum Scannen von Daten auf Anomalien finden Sie unter Knowledge Catalog-Datenprofilscan. Mit dem Scan können Datenqualitätsregeln generiert werden. Sie können auch integrierte Qualitätsregeln verwenden oder benutzerdefinierte Regeln erstellen.
Knowledge Catalog bietet Monitoring, Fehlerbehebung und Cloud Logging-Benachrichtigungen, die in die automatische Datenqualität eingebunden sind.
Konzeptionelles Modell
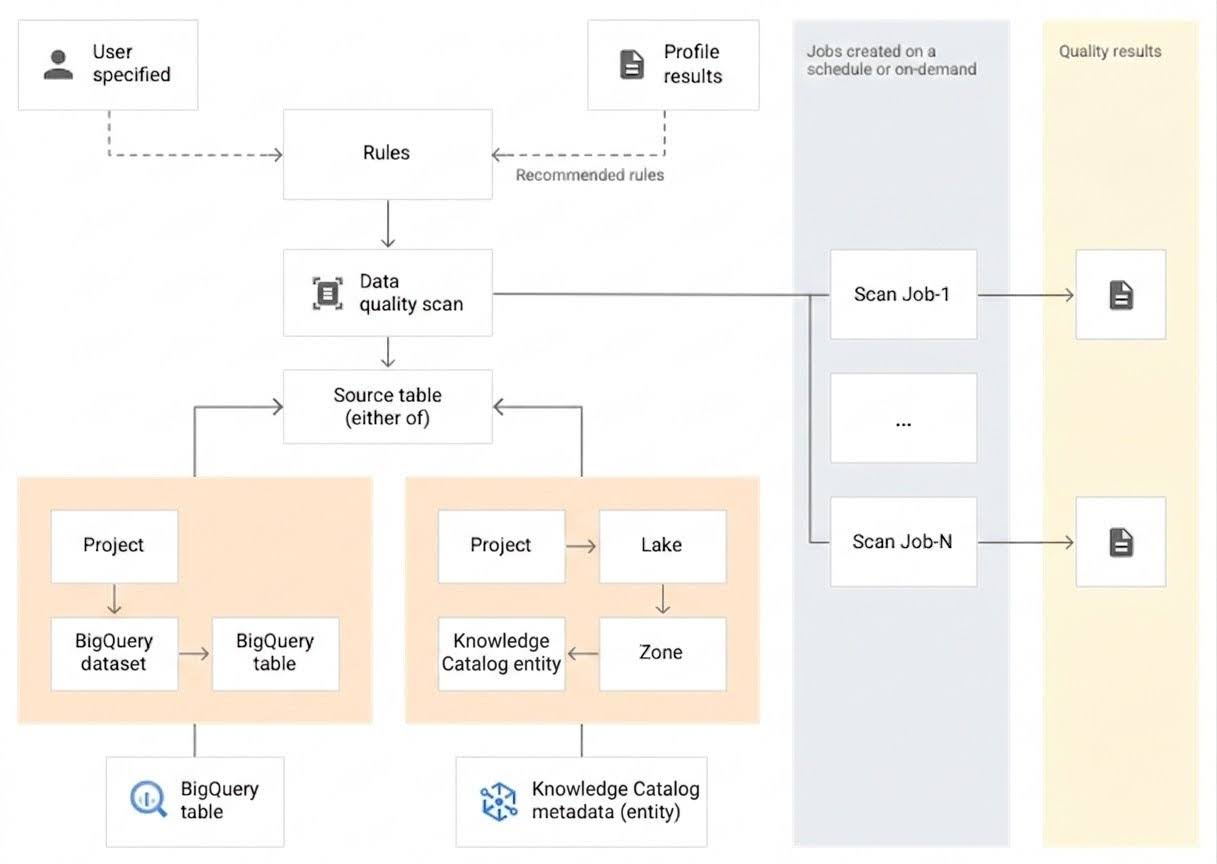
Ein Datenqualitätsscan ist ein Knowledge Catalog-Datenscan, bei dem Ihre Daten anhand einer Reihe integrierter Regeln validiert werden. Ein Datenscan ist ein Knowledge Catalog-Job, bei dem Daten aus BigQuery und Cloud Storage (über externe BigQuery-Tabellen) erfasst und verschiedene Arten von Metadaten abgeleitet werden. Wenn Sie die Qualität einer Tabelle mit der automatischen Datenqualität messen möchten, erstellen Sie ein DataScan-Objekt vom Typ data quality. Der Scan wird nur für eine BigQuery-Tabelle ausgeführt.
Für den Scan werden Ressourcen in einem Mandantenprojekt von Google verwendet. Sie müssen also keine eigene Infrastruktur einrichten.
Das Erstellen und Verwenden eines Datenqualitätsscans umfasst die folgenden Schritte:
- Datenqualitätsregeln definieren
- Regelausführung konfigurieren
- Ergebnisse des Datenqualitätsscans analysieren
- Monitoring und Benachrichtigungen einrichten
- Fehler bei der Datenqualität beheben
Regeldefinition
Datenqualitätsregeln, die mit einem Datenqualitätsscan verknüpft sind, definieren die Erwartungen an die Daten. Sie haben folgende Möglichkeiten, Datenqualitätsregeln zu erstellen:
- Empfehlungen aus dem Data Profiling in Knowledge Catalog verwenden
- Integrierte Regeln oder Systemregelvorlagen verwenden
- Benutzerdefinierte SQL-Regeln erstellen
- Datenqualitätsregeln wiederverwenden
Integrierte Regeln
Knowledge Catalog unterstützt die folgenden Kategorien von integrierten Regeln:
- Auf Zeilenebene
Bei Kategorie-Regeln auf Zeilenebene wird die Erwartung auf jede Datenzeile angewendet. Jede Zeile erfüllt die Bedingung unabhängig oder nicht. Beispiel:
column_A_value < 1.Für Prüfungen auf Zeilenebene müssen Sie einen Grenzwert für das Bestehen angeben. Wenn der Prozentsatz der Zeilen, die die Regel bestehen, unter den Grenzwert fällt, schlägt die Regel fehl.
- Aggregieren
Bei aggregierten Regeln wird die Erwartung auf einen einzelnen Wert angewendet, der über alle Daten hinweg aggregiert wird. Beispiel:
Avg(someCol) >= 10Damit die Prüfung bestanden wird, muss sie als boolescher Werttrueausgewertet werden. Bei aggregierten Regeln gibt es keine unabhängige Anzahl von bestandenen oder nicht bestandenen Tests für jede Zeile.
Für beide Regelkategorien können Sie die folgenden Parameter festlegen:
- Die Spalte, auf die die Regel angewendet wird
- Eine Dimension
In der folgenden Tabelle sind die unterstützten Regeltypen für Zeilenebene und Aggregat aufgeführt:
| Regeltyp (Name in der Google Cloud -Konsole) |
Regel auf Zeilenebene oder aggregierte Regel | Beschreibung | Unterstützte Spaltentypen | Regelspezifische Parameter |
|---|---|---|---|---|
RangeExpectation(Bereichsprüfung) |
Auf Zeilenebene | Prüft, ob der Wert zwischen dem Mindest- und dem Höchstwert liegt. | Alle Spalten mit numerischen, Datums- und Zeitstempeltypen. | Erforderlich:
|
NonNullExpectation(Null-Prüfung) |
Auf Zeilenebene | Prüfen Sie, ob die Spaltenwerte nicht NULL sind. | Alle unterstützten Spaltentypen. | Erforderlich:
|
SetExpectation(Scheck festlegen) |
Auf Zeilenebene | Prüft, ob die Werte in einer Spalte einem der angegebenen Werte in einem Set entsprechen. | Alle unterstützten Spaltentypen außer Record und Struct. |
Erforderlich:
|
RegexExpectation(Prüfung mit regulären Ausdrücken) |
Auf Zeilenebene | Überprüft die Werte anhand eines angegebenen regulären Ausdrucks. | String | Erforderlich:
|
Uniqueness(Eindeutigkeitsprüfung) |
Aggregieren | Prüfen, ob alle Werte in einer Spalte eindeutig sind. | Alle unterstützten Spaltentypen außer Record und Struct. |
Erforderlich:
|
StatisticRangeExpectation(Statistikprüfung) |
Aggregieren | Prüft, ob die angegebene statistische Maßzahl dem erwarteten Bereich entspricht. | Alle unterstützten numerischen Spaltentypen. | Erforderlich:
|
Unterstützte benutzerdefinierte SQL-Regeltypen
SQL-Regeln bieten die Flexibilität, die Validierung mit benutzerdefinierter Logik zu erweitern. Diese Regeln gibt es in den folgenden Typen.
| Regeltyp | Regel auf Zeilenebene oder aggregierte Regel | Beschreibung | Unterstützte Spaltentypen | Regelspezifische Parameter | Beispiel |
|---|---|---|---|---|---|
| Zeilenbedingung | Auf Zeilenebene | Geben Sie für jede Zeile eine Erwartung an, indem Sie einen SQL-Ausdruck in einer WHERE-Klausel definieren. Der SQL-Ausdruck sollte pro Zeile als true (bestanden) oder false (nicht bestanden) ausgewertet werden.Im Knowledge Catalog wird der Prozentsatz der Zeilen berechnet, die diese Erwartung erfüllen. Dieser Wert wird dann mit dem Prozentsatz des Grenzwerts für das Bestehen verglichen, um zu ermitteln, ob die Regel erfolgreich war oder nicht. Der Ausdruck kann einen Verweis auf eine andere Tabelle enthalten, z. B. um Prüfungen der referenziellen Integrität zu erstellen. |
Alle Spalten | Erforderlich:
|
grossWeight <= netWeight |
| Tabellenbedingung (aggregierter SQL-Ausdruck) |
Aggregieren | Diese Regeln werden einmal pro Tabelle ausgeführt. Geben Sie einen SQL-Ausdruck an, der als boolescher Wert true (bestanden) oder false (nicht bestanden) ausgewertet wird.Der SQL-Ausdruck kann mithilfe von Ausdruck-Unterabfragen auf eine andere Tabelle verweisen. |
Alle Spalten | Erforderlich:
|
Einfaches Aggregatbeispiel:avg(price) > 100Verwenden einer Ausdrucksunterabfrage zum Vergleichen von Werten in einer anderen Tabelle: (SELECT COUNT(*) FROM `example_project.example_dataset.different-table`) < COUNT(*) |
| SQL-Assertion | Aggregieren | Eine Assertionsregel verwendet eine Datenqualitätsabfrage, um Zeilen zu finden, die eine oder mehrere in der Abfrage angegebene Bedingungen nicht erfüllen. Geben Sie eine SQL-Anweisung an, die ausgewertet wird, um Zeilen zurückzugeben, die dem ungültigen Status entsprechen. Wenn bei der Abfrage Zeilen zurückgegeben werden, schlägt die Regel fehl. Lassen Sie das abschließende Semikolon in der SQL-Anweisung weg. Die SQL-Anweisung kann mithilfe von Ausdruck-Unterabfragen auf eine andere Tabelle verweisen. |
Alle Spalten | Erforderlich:
|
Einfaches Aggregatbeispiel, um sicherzustellen, dass discount_pct
nicht größer als 100 ist:SELECT * FROM example_project.example_dataset.table WHERE discount_pct > 100Verwenden einer Ausdrucksunterabfrage zum Vergleichen von Werten in einer anderen Tabelle: SELECT * FROM `example_project.example_dataset.different-table` WHERE gross_weight > (SELECT avg(gross_weight) FROM `example_project.example_dataset.different-table`)
|
Beispielregeln für die automatische Datenqualität
Informationen zu den unterstützten SQL-Funktionen finden Sie in der GoogleSQL-Referenz.
Datenqualitätsregeln wiederverwenden
Sie können Knowledge Catalog-Regeln für die Datenqualität wiederverwenden, um komplexe oder standardisierte Geschäftsregeldefinitionen für mehrere Regeln für die Datenqualität freizugeben. Dazu verwenden Sie Regelvorlagen. Sie können beispielsweise eine Regelvorlage für die E‑Mail-Validierung oder für die Fremdschlüsselvalidierung zwischen zwei Tabellen erstellen und diese Vorlagen dann für Ihre Datenprüfungen wiederverwenden.
Die Wiederverwendbarkeit von Regeln bietet die folgenden wichtigen Funktionen:
- Vorlagen für Datenqualitätsregeln: Erstellen Sie benutzerdefinierte Regelvorlagen, um komplexe oder standardisierte Geschäftsregeldefinitionen zu speichern, die für mehrere Datenqualitätsregeln verwendet werden können. Erstellen Sie einen
data-quality-rule-template-Eintrag und fügen Sie ihm einendata-quality-rule-template-Aspekt hinzu, um die Vorlagenlogik zu definieren. - Datenregeln als Metadaten: Deklarieren Sie Datenqualitätsregeln als Aspekte im Knowledge Catalog für Einträge wie BigQuery-Tabellen oder Begriffe aus dem Unternehmensglossar. Verwenden Sie den Aspekttyp
data-rules, um diese Regeln an Einträge anzuhängen. - Systemregelvorlagen: Verwenden Sie Systemregelvorlagen für häufig verwendete Regeln.
Weitere Informationen finden Sie unter Datenqualitätsregeln wiederverwenden.
Dimensionen
Mit Dimensionen können Sie die Ergebnisse mehrerer Datenqualitätsregeln für die Überwachung und Benachrichtigung aggregieren. Sie müssen jede Datenqualitätsregel mit einer Dimension verknüpfen. Knowledge Catalog bietet die folgenden Dimensionen:
- Aktualität
- Mit der Aktualität wird gemessen, wann die Daten zuletzt aktualisiert wurden. Anhand dieser Informationen können Sie feststellen, ob die Daten aktuell genug sind, um nützlich zu sein.
- Volumen
- Mit dem Volumen wird gemessen, ob alle erwarteten Daten vorhanden sind.
- Vollständigkeit
- Die Vollständigkeit gibt an, ob die Daten alle Informationen enthalten, die für den beabsichtigten Zweck erforderlich sind.
- Gültigkeit
- Mit der Prüfung auf Gültigkeit wird ermittelt, ob die Daten den integrierten Standards für Format, akzeptable Bereiche oder andere Kriterien entsprechen. Wenn ein gültiges Datum beispielsweise das Format
YYYY/mm/ddhaben muss, ist 08-12-2019 ungültig. Ein weiteres Beispiel: Wenn ein gültiger Verkaufspreis für einen Artikel zwischen 10 € und 20 € liegt, ist ein Verkaufspreis von 100 € ungültig. - Konsistenz
- Konsistenz bedeutet, dass Daten in mehreren Instanzen, z. B. Tabellen und Spalten, dieselben Werte haben. Dateninkonsistenzen treten auf, wenn sich beispielsweise der Umsatz eines Produkts unterscheidet, je nachdem, ob er aus einer Verkaufs- oder einer Nutzungsdatenbank gelesen wird.
- Genauigkeit
- Die Genauigkeit bezieht sich auf die Korrektheit der Daten. Beachten Sie, dass gültige Daten nicht unbedingt korrekt sind. Eine gültige Haarfarbe ist beispielsweise „braun“. Wenn eine Person aber keine braunen Haare hat, sind die Daten ungenau.
- Eindeutigkeit
- Die Eindeutigkeit gibt an, ob die Daten eindeutig sind und keine Duplikate enthalten.
Tastatureingabe in Regeln
Alle Wertparameter werden als Stringwerte an die API übergeben. Für Knowledge Catalog müssen Eingaben dem von BigQuery angegebenen Format entsprechen.
Parameter vom Typ „Binary“ können als base64-codierter String übergeben werden.
| Typ | Unterstützte Formate | Beispiele |
|---|---|---|
| Binär | Base64-codierter Wert | YXBwbGU= |
| Zeitstempel | YYYY-[M]M-[D]D[( |T)[H]H:[M]M:[S]S[.F]] [time_zone] ODER YYYY-[M]M-[D]D[( |T)[H]H:[M]M:[S]S[.F]][time_zone_offset] |
2014-09-27 12:30:00.45-08 |
| Datum | JJJJ-M[M]-T[T] | 2014-09-27 |
| Zeit | [H]H:[M]M:[S]S[.DDDDDD] | 12:30:00.45 |
| DateTime | YYYY-[M]M-[D]D [[H]H:[M]M:[S]S[.DDDDDD]] | 2014-09-27 12:30:00.45 |
Parameter für Datenreferenz
Wenn Sie eine benutzerdefinierte SQL-Regel erstellen, können Sie auf eine Datenquellentabelle und alle ihre Vorbedingungsfilter verweisen, indem Sie den Datenreferenzparameter ${data()} in der Regel verwenden, anstatt die Quelltabelle und ihre Filter explizit zu erwähnen.
Knowledge Catalog interpretiert den Parameter als Verweis auf die Quelltabelle und ihre Filter. Beispiele für Precondition-Filter sind Zeilenfilter, Sampling-Prozentsätze und inkrementelle Filter.
Angenommen, Sie haben eine Datenquellentabelle mit dem Namen my_project_id.dim_dataset.dim_currency. Sie möchten einen inkrementellen Datenqualitätsscan ausführen, der nur neue tägliche Daten scannt. Auf die Tabelle wird ein Zeilenfilter angewendet, der nach den heutigen Einträgen (transaction_timestamp >= current_date()) filtert.
Eine benutzerdefinierte SQL-Regel zum Suchen von Zeilen mit discount_pct für heute sieht so aus:
discount_pct IN (SELECT discount_pct FROM my_project_id.dim_dataset.dim_currency WHERE transaction_timestamp >= current_date())
Wenn Sie den Parameter für den Datenverweis verwenden, können Sie die Regel vereinfachen. Ersetzen Sie die Erwähnung der Tabelle und ihrer Vorbedingungsfilter durch den Parameter ${data()}:
discount_pct IN (SELECT discount_pct FROM ${data()})
Im Knowledge Catalog wird der Parameter ${data()} als Verweis auf die Datenquellentabelle mit den heutigen Einträgen, my_project_id.dim_dataset.dim_currency WHERE transaction_timestamp >= current_date(), interpretiert.
In diesem Beispiel bezieht sich der Datenreferenzparameter nur auf die inkrementellen Daten.
Beim Parameter ${data()} wird zwischen Groß- und Kleinschreibung unterschieden.
Wenn Sie einen Alias in einer Unterabfrage verwenden, um auf Spalten in der Quelltabelle zu verweisen, verwenden Sie entweder den Datenreferenzparameter, um auf die Quelltabelle zu verweisen, oder lassen Sie den Tabellenverweis weg. Verweisen Sie nicht mit einem direkten Tabellenverweis in der WHERE-Klausel auf die Spalten in der Quelltabelle.
Empfohlen:
Verwenden Sie den Parameter „data_reference“, um auf die Quelltabelle zu verweisen:
discount_pct IN (
SELECT discount_pct FROM
`my_project_id.dim_dataset.dim_currency` AS temp-table
WHERE
temp-table.transaction_timestamp = ${data()}.timestamp
)
Lassen Sie die Tabellenreferenz weg:
discount_pct IN (
SELECT discount_pct FROM
`another_project.another_dataset.another_table` AS temp-table
WHERE
temp-table.transaction_timestamp = timestamp
Nicht empfohlen:
Verwenden Sie keinen direkten Tabellenbezug, um auf Spalten in der Quelltabelle zu verweisen:
discount_pct IN (
SELECT discount_pct FROM
`my_project_id.dim_dataset.dim_currency` AS temp-table
WHERE
temp-table.transaction_timestamp = `my_project_id.dim_dataset.dim_currency`.timestamp
)
Gültige Verwendung verschiedener Tabellen:
Sie können einen direkten Tabellenbezug verwenden, wenn Sie Spalten aus einer anderen Tabelle vergleichen:
discount_pct IN (
SELECT discount_pct FROM
`my_project_id.dim_dataset.dim_currency` AS temp-table
WHERE
temp-table.transaction_timestamp = `another_project.another_dataset.another_table`.timestamp
)
Abfragen debuggen
Wenn Sie eine Regel erstellen, können Sie optional eine Debugging-Abfrage einfügen, die zusammen mit der Regel ausgeführt wird. Eine Debugging-Abfrage ist eine SQL-Anweisung, die bis zu 10 Skalarwerte zurückgibt. Anhand dieser Werte können Sie die Ursache ermitteln, wenn die Regel fehlschlägt. Sie können maximal eine Debug-Abfrage pro Regel hinzufügen. Sie darf nicht länger als 1.024 Zeichen sein.
Betrachten Sie die folgende SQL-Assertionsregel für die Tabelle example_project.example_dataset.table, mit der geprüft wird, ob der durchschnittliche Umsatz pro Artikel 100 übersteigt:
SELECT
  *
FROM
  `example_project.example_dataset.table`
WHERE
  SUM(revenue) / COUNT(DISTINCT item_id) > 100
Wenn die vorherige Regel fehlschlägt, können Sie Messwerte wie den Gesamtumsatz, die Anzahl der einzelnen Artikel und den durchschnittlichen Umsatz pro Artikel ansehen, um das Problem zu beheben. Die folgende Debugging-Abfrage gibt diese Messwerte zurück:
SELECT
  SUM(revenue),
  COUNT(DISTINCT item_id),
  SUM(revenue) / COUNT(DISTINCT item_id)
FROM `example_project.example_dataset.table`
Regelausführung
Sie können festlegen, dass Datenqualitätsscans in einem bestimmten Intervall ausgeführt werden, oder einen Scan bei Bedarf ausführen.
Ausführungsidentität
Standardmäßig verwendet Knowledge Catalog einen zentralen Dienst-Agenten (service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com), um Datenqualitätsprüfungen auszuführen.
Sie können diese Standardausführungsidentität überschreiben, indem Sie ein benutzerdefiniertes Dienstkonto angeben oder Ihre eigenen Endnutzeranmeldedaten verwenden. Das hat mehrere Vorteile:
- Prinzip der geringsten Berechtigung:Weisen Sie einem dedizierten Dienstkonto nur die IAM-Berechtigungen zu, die für bestimmte Aufgaben zur Datenqualität erforderlich sind. So wird ein übermäßiger Zugriff minimiert.
- Detaillierte Zugriffssteuerung:Berechtigungen auf bestimmte Ressourcen beschränken, um die Integration mit Zugriffsrichtlinien auf Zeilen- und Spaltenebene in BigQuery zu ermöglichen.
- Verbesserte Prüfbarkeit: Sie können bestimmten Scans benutzerdefinierte Dienstkonten oder Nutzeranmeldedaten zuweisen, um das Tracking und Logging von Aktivitäten in Audit-Logs zu vereinfachen.
- Vereinheitlichung der Abrechnung: Wenn Sie eine benutzerdefinierte Ausführungsidentität verwenden, werden die Verarbeitungs- und Speicherkosten direkt unter BigQuery zentralisiert (ohne Knowledge Catalog Premium-SKUs). So können Sie die BigQuery-Unternehmensrabatte und Slot-Zusicherungen nutzen.
Eine Anleitung zum Konfigurieren einer benutzerdefinierten Ausführungsidentität finden Sie unter Ausführungsidentität konfigurieren.
Netzwerkanforderungen
Wenn Sie einen Scan ausführen möchten, müssen Sie den privaten Google-Zugriff für das VPC-Subnetz aktivieren, das Sie für den Scan verwenden. Wenn Sie kein Subnetz angeben, muss für Ihr Standardsubnetz der privater Google-Zugriff aktiviert sein.
Wenn Sie einen Datenqualitätsscan ausführen, erstellt Knowledge Catalog einen Job. Wenn ein Job falsch konfiguriert ist oder länger als erwartet ausgeführt wird, können Sie ihn abbrechen.
Im Rahmen der Spezifikation eines Datenqualitätsscans können Sie den Umfang eines Jobs auf eine der folgenden Optionen festlegen:
- Vollständige Tabelle
- Bei jedem Job wird die gesamte Tabelle validiert.
- Inkrementell
- Bei jedem Job werden inkrementelle Daten validiert. Wenn Sie Inkremente bestimmen möchten, geben Sie in der Tabelle eine
Date- oderTimestamp-Spalte an, die als Markierung verwendet werden kann. In der Regel ist dies die Spalte, nach der die Tabelle partitioniert ist.
Daten filtern
Sie können Daten, die auf Datenqualität geprüft werden sollen, mithilfe eines Zeilenfilters filtern. Mit einem Zeilenfilter können Sie sich auf Daten innerhalb eines bestimmten Zeitraums oder eines bestimmten Segments, z. B. einer bestimmten Region, konzentrieren. Durch die Verwendung von Filtern können die Laufzeit und die Kosten reduziert werden. Sie können beispielsweise Daten mit einem Zeitstempel vor einem bestimmten Datum herausfiltern.
Beispieldaten
Sie können einen Prozentsatz der Datensätze aus Ihren Daten angeben, die für die Ausführung eines Datenqualitätsscans herangezogen werden sollen. Wenn Sie Datenqualitätsscans für eine kleinere Stichprobe von Daten erstellen, können Sie die Laufzeit und die Kosten im Vergleich zur Abfrage des gesamten Datasets reduzieren.
Filterregeln
Wenn Sie einen Datenqualitätsscan ausführen, können Sie die Filtersyntax AIP-160 verwenden, um bestimmte Regeln selektiv auszuführen. Knowledge Catalog führt Filterung für die Metadaten der im Scan definierten Regeln oder der Regeln durch, die dem Katalogeintrag über den Aspekt data-rules angehängt sind.
Filtersyntax
Die Filtersyntax entspricht den AIP-160-Richtlinien. Sie können Standardoperatoren aus AIP-160 (z. B. =, !=, >, <, =~) verwenden und mehrere Bedingungen mit AND oder OR kombinieren.
Wenn Sie einen AIP-160-Filterstring verwenden, gehen Sie so vor:
- In der Google Cloud Console: Geben Sie den Filter direkt mit der AIP-160-Syntax ein, z. B.
name = "critical_check". - In einem API-Aufruf: Der Filterstring ist oft ein Wert in einem anderen JSON-Stringliteral. Dazu müssen doppelte Anführungszeichen im AIP-160-String maskiert werden. Beispiel:
"filter": "name = \"critical_check\"".
Filterbare Felder
Sie können nach den meisten Feldern filtern, die in der Regeldefinition verfügbar sind:
name: Der Anzeigename der Regel.dimension: Die Dimension für die Datenqualität (z. B.VALIDITY).column: Der Name der Spalte, auf die sich die Regel bezieht.threshold: Der Schwellenwert für die Regel.ignore_null: Ein boolescher Wert. Wenntrue, werdenNULLZeilen als bestanden betrachtet.attributes: Benutzerdefinierte Schlüssel/Wert-Paare, die der Regel zugewiesen sind.
Die folgenden Beispiele zeigen gängige Filtermuster. Numerische und boolesche Werte werden nicht in Anführungszeichen gesetzt.
Nach Name filtern
- Genaue Übereinstimmung:
name = "critical_check" - Muster abgleichen:
name =~ "temp_.*"
Nach Dimension filtern
- Mit einer bestimmten Dimension übereinstimmen:
dimension = "COMPLETENESS" - Mehrere Dimensionen abgleichen:
dimension = "VALIDITY" OR dimension = "ACCURACY"
Nach Spalte und Grenzwert filtern
- Bestimmte Spalte abgleichen:
column = "user_id" - Grenzwert erreichen:
threshold > 0.95 - Übereinstimmung mit einem Bereich:
threshold >= 0.8 AND threshold < 0.9
Nach „ignore_null“ filtern
- Boolescher Wert für Übereinstimmung:
ignore_null = true
Nach benutzerdefinierten Attributen filtern
- Prüfen, ob Schlüssel vorhanden ist:
attributes:environment - Abgleichsschlüssel und ‑wert:
attributes.environment = "prod" - Abgleich mit regulären Ausdrücken:
attributes.tag =~ "prio-.*" - Kombinationen für den Abgleich:
attributes.environment = "prod" AND attributes.criticality = "high"
Ergebnisse des Datenqualitätsscans
Die Ergebnisse Ihrer Datenqualitätsprüfungen sind im Knowledge Catalog und in BigQuery verfügbar. Sie können die Scanergebnisse auch mit den folgenden Methoden überprüfen und analysieren:
Ergebnisse nach BigQuery exportieren
Sie können die Scanergebnisse zur weiteren Analyse in eine BigQuery-Tabelle exportieren. Wenn Sie Berichte anpassen möchten, können Sie die Daten aus der BigQuery-Tabelle mit einem Looker-Dashboard verbinden. Sie können einen aggregierten Bericht erstellen, indem Sie dieselbe Ergebnistabelle für mehrere Scans verwenden.
Ergebnisse als Knowledge Catalog-Metadaten veröffentlichen
Sie können die Ergebnisse des Datenqualitätsscans als Knowledge Catalog-Metadaten veröffentlichen. Die neuesten Ergebnisse werden im Knowledge Catalog-Eintrag für die Quelltabelle unter dem Systemaspekttyp
data-quality-scorecardgespeichert. Sie können die Ergebnisse auf den BigQuery- und Knowledge Catalog-Seiten der Quelltabelle in der Google Cloud Console auf dem Tab Datenqualität ansehen. Sie können die Ergebnisse auch über die API abrufen.Weitere Informationen zu Knowledge Catalog-Metadaten finden Sie unter Metadatenverwaltung in Knowledge Catalog.
Datenqualitätsfaktoren ansehen
Jedes Scanergebnis enthält Datenqualitätswerte, die den Prozentsatz der bestandenen Regeln angeben. Die Punktzahlen werden auf der Ebene des gesamten Jobs, der Spalte (wenn die Regel für eine Spalte ausgewertet wird) und der Dimension angegeben. Mit den Datenqualitätswerten können Sie die Datenqualität in Tabellen oder Spalten normalisieren, Trends verfolgen und Daten identifizieren, die die Qualitätsanforderungen nicht erfüllen.
Weitere Informationen finden Sie unter Ergebnisse des Datenqualitätsscans anzeigen.
Monitoring und Benachrichtigungen
Sie können Datenqualitätsscans mit den folgenden Methoden überwachen und Benachrichtigungen dazu erhalten:
Benachrichtigungen in Cloud Logging einrichten
Sie können die Datenqualitätsjobs mit den
data_scan- unddata_quality_scan_rule_result-Logs im Log-Explorer überwachen.Für jeden Datenqualitätsjob enthält das
data_scan-Log mit dem Felddata_scan_type, das aufDATA_QUALITYfestgelegt ist, die folgenden Informationen:- Datenquelle, die für den Datenscan verwendet wird.
- Details zur Jobausführung, z. B. Erstellungszeit, Beginn, Ende und Jobstatus.
- Ergebnis des Datenqualitätsjobs: bestanden oder nicht bestanden.
- Dimensionsebene: bestanden oder nicht bestanden.
Jeder erfolgreiche Job enthält ein
data_quality_scan_rule_result-Log mit den folgenden detaillierten Informationen zu jeder Regel in diesem Job:- Konfigurationsinformationen wie Regelname, Regeltyp, Auswertungstyp und Dimension.
- Ergebnisinformationen wie „Bestanden“ oder „Nicht bestanden“, Gesamtzahl der Zeilen, Anzahl der Zeilen, die die Prüfung bestanden haben, Anzahl der Nullzeilen und Anzahl der ausgewerteten Zeilen.
Die Informationen in den Logs sind über die API und dieGoogle Cloud -Konsole verfügbar. Anhand dieser Informationen können Sie Benachrichtigungen einrichten. Weitere Informationen finden Sie unter Benachrichtigungen in Logging einrichten.
Berichte als E-Mail-Benachrichtigung senden
Sie können Berichte mit E‑Mail-Benachrichtigungen senden, um Personen über den Status und die Ergebnisse eines Jobs zur Datenqualität zu informieren. Benachrichtigungsberichte sind für die folgenden Szenarien verfügbar:
- Der Datenqualitätsfaktor ist niedriger als ein angegebenes Ziel.
- Der Job ist fehlgeschlagen.
- Der Job ist abgeschlossen.
Sie konfigurieren Benachrichtigungsberichte, wenn Sie einen Datenqualitätsscan erstellen.
DCU-Compute-Kosten in Cloud Billing im Blick behalten
Serverloses Computing für Datenqualitätsscans gibt keine Zeitreihenmesswerte an Cloud Monitoring aus. Wenn Sie die DCU-Kosten für die Datenqualität nach Projekt, Scan-ID oder Tabelle verfolgen und zuordnen möchten, fragen Sie den Cloud Billing-Export in BigQuery mit den Systemlabels
goog-dataplex-datascan-*ab. Weitere Informationen finden Sie unter Dataplex-DCU-Kosten mit Cloud Billing-Export überwachen und zuordnen.
Fehler bei der Datenqualität beheben
Wenn die Ausführung einer Regel fehlschlägt, stellt Knowledge Catalog eine Abfrage zum Abrufen der fehlgeschlagenen Datensätze bereit. Führen Sie diese Abfrage aus, um die Datensätze zu sehen, die nicht mit Ihrer Regel übereinstimmen. Weitere Informationen finden Sie unter Fehler bei der Datenqualität beheben.
Beschränkungen
- Regel-Empfehlungen werden in der gcloud CLI nicht unterstützt.
- Die Auswahl der Dimensionen ist auf eine der sieben vordefinierten Dimensionen festgelegt.
- Die Anzahl der Regeln pro Datenqualitätsscan ist auf 1.000 begrenzt.
- Datenqualitätswerte, die auf Spaltenebene gemeldet werden, werden nur in der API unterstützt.
- Sie können Datenqualitätsregeln nur für BigQuery-, Iceberg REST Catalog-, SAP Business Data Cloud Delta Lake- und Apache Hive-Tabellen ausführen.
Preise
- Weitere Informationen zu Preisen finden Sie unter Preise für den Knowledge Catalog.
- Informationen zum Erfassen und Zuordnen der DCU-Nutzung und -Kosten für Datenqualitäts-Scans mit dem Cloud Billing-Export nach BigQuery finden Sie unter Dataplex-DCU-Kosten mit dem Cloud Billing-Export erfassen und zuordnen.
Nächste Schritte
- Informationen zur Verwendung der automatischen Datenqualität
- Informationen zum Wiederverwenden von Regeln zur Datenqualität
- Datenqualitätsregeln als Code verwalten
- Folgen Sie einem Tutorial, um einen Datenqualitätsworkflow mit Richtlinien als Code zu erstellen.
- Informationen zu den verfügbaren Terraform-Ressourcen für die Datenprofilerstellung. Weitere Informationen finden Sie hier:
- Dataplex-Ressource für Datenscans in der Terraform-Registry.
- Die Dokumentation zur Dataplex-Ressource für Datenscans auf GitHub, die die YAML-basierte Regelkonfiguration unterstützt.
- Weitere Informationen zur Datenprofilerstellung
- Informationen zur Verwendung der Datenprofilerstellung