


Las tareas de enriquecimiento de Knowledge Catalog te permiten automatizar la selección de metadatos y compilar conjuntos de contexto específicos del dominio analizando los esquemas de tus conjuntos de datos, los registros de consultas y la documentación empresarial. Puedes usar estas propuestas generadas para reducir el esfuerzo de documentación manual y fundamentar los agentes de IA posteriores en un contexto empresarial verificado.
Este documento está dirigido a administradores de datos, ingenieros de datos y administradores de plataformas que están familiarizados con los conceptos básicos de Knowledge Catalog y quieren comprender cómo funcionan las tareas de enriquecimiento. Para configurar y ejecutar una tarea de enriquecimiento de inmediato, consulta Crea tareas de enriquecimiento.
Por qué usar tareas de enriquecimiento
Las tareas de enriquecimiento abordan el desafío de mantener los Data Catalog a gran escala precisos y actualizados.
| Aspecto | Enfoque convencional | Enfoque de Knowledge Studio |
|---|---|---|
| Proceso | Descripciones escritas a mano. Los administradores revisan manualmente miles de tablas y entrevistan a expertos en el dominio. | Impulsado por agentes. Un agente autónomo analiza datos y lee procedimientos operativos estándar. |
| Velocidad y escalamiento | Es lento y difícil de mantener a medida que los esquemas cambian con el tiempo. | Altamente escalable Las propuestas de metadatos de alta calidad se generan de forma continua. |
| Esfuerzo humano | Alta. Ingreso manual de datos y mantenimiento continuo extensivos | Bajo. Los administradores de datos solo necesitan revisar y aprobar las sugerencias generadas. |
Casos de uso de la tarea de enriquecimiento
Las tareas de enriquecimiento ayudan a las organizaciones a resolver los siguientes desafíos comunes de metadatos:
Integración de adquisiciones: Una empresa adquiere una nueva unidad de negocio con miles de recursos de datos no documentados. Los ingenieros de datos apuntan una tarea de enriquecimiento al nuevo conjunto de datos y proporcionan los diccionarios de datos de la empresa adquirida como un indicador de conocimiento, que es material de referencia que fundamenta al agente en el contexto específico de la empresa. El agente propone descripciones alineadas con el negocio para todo el conjunto de datos en horas en lugar de meses.
Documentación continua: Un equipo de ingeniería de plataformas crea un lakehouse dinámico en el que los esquemas cambian a diario. El equipo configura una tarea de enriquecimiento para que se ejecute diariamente con la publicación automática habilitada, de modo que las actualizaciones de metadatos verificadas se apliquen automáticamente sin revisión manual. La publicación automática garantiza que el catálogo siempre refleje los cambios más recientes en el esquema.
Administración semántica: Una oficina de datos central quiere estandarizar la terminología en todos los departamentos. El equipo configura una tarea de enriquecimiento para usar un glosario empresarial aprobado como material de referencia. Luego, el agente alinea las descripciones de las tablas y las columnas con esas definiciones oficiales, lo que garantiza una terminología coherente en todo el catálogo sin alterar las fuentes de datos originales.
Conceptos básicos
Cuando configuras una tarea de enriquecimiento, trabajas con los siguientes componentes principales y recursos opcionales:
- Conjunto de contexto (obligatorio)
-
Es un contenedor limitado de recursos de datos y metadatos de destino. Cada tarea de enriquecimiento se orienta a un conjunto de contextos, y cada conjunto de contextos se puede enriquecer con solo una tarea de enriquecimiento. Las tareas de enriquecimiento no reemplazan las descripciones de tus recursos de BigQuery subyacentes ni crean términos del glosario empresarial. En cambio, almacenan las descripciones, los conceptos y los vínculos de columna a glosario generados como entradas de superposición dentro del conjunto de contexto y vinculan las entradas generadas a las tablas subyacentes con vínculos de entrada
reference(projects/dataplex-types/locations/global/entryLinkTypes/reference). El conjunto de contexto puede contener recursos de destino prepropagados (como un conjunto de datos de BigQuery o Lakehouse), o puedes crear un conjunto de contexto vacío y, de forma opcional, agregar recursos de destino cuando configures la tarea de enriquecimiento.Por ejemplo, un conjunto de contexto de marketing que vincula lógicamente tus tablas de campañas, métricas de ROAS y glosarios de terminología en un solo límite de contexto de IA.
- Tarea de enriquecimiento
-
Es la configuración que define lo que debe hacer el agente. Una tarea contiene el conjunto de contexto y el programa requeridos, junto con cualquier recurso de datos de destino, indicador de conocimiento, conjunto de evaluación o fuente de autoaprendizaje opcional que configures cuando crees o edites la tarea.
Por ejemplo, una tarea configurada para indicarle al agente que lea tus repositorios de GitHub y enriquezca tu conjunto de datos de
financetodos los domingos a la medianoche. - Trabajo de enriquecimiento
- Es el proceso de organización de backend en Knowledge Studio que ejecuta una tarea de enriquecimiento.
- Ejecución de enriquecimiento
-
Es una instancia de ejecución única y puntual de una tarea. La consola de Knowledge Studio incluye una pestaña Trabajos en la que se enumeran las ejecuciones históricas de una tarea, y puedes abrir una ejecución específica para revisar las propuestas de metadatos que generó.
Por ejemplo, la instancia de ejecución específica que ocurrió el 24 de octubre y generó 15 cambios de columna propuestos.
- Indicadores de conocimiento (opcional)
- Son materiales de referencia externos que fundamentan al agente en la realidad de tu empresa. Cuando proporcionas buckets, carpetas o archivos de Cloud Storage que contienen diccionarios de datos, glosarios de Knowledge Catalog o URLs de documentación interna durante la creación de la tarea o cuando editas el alcance de una tarea, te aseguras de que el agente use tu lógica empresarial específica en lugar de hacer suposiciones genéricas.
- Conjuntos de evaluación (opcional)
-
Preguntas de prueba y SQL correspondiente (proporcionado en formato
.jsonlcuando creas o editas una tarea de enriquecimiento) que se usan para calificar la precisión del agente. Cuando el agente propone metadatos nuevos, ejecuta estas preguntas de prueba en las propuestas para garantizar que la exactitud no disminuya antes de la publicación.Por ejemplo, proporcionar una pregunta de prueba como "¿Cuál es nuestro MRR?" junto con la consulta en SQL exacta necesaria para calcular los ingresos recurrentes mensuales. Si el agente propone metadatos confusos que hacen que esta consulta de prueba falle, se marca la propuesta.
- Fuentes de autoaprendizaje (opcional)
-
Registros de conversaciones en vivo de tus apps de Gemini Enterprise o análisis de agentes de BigQuery que puedes adjuntar cuando creas o editas una tarea de enriquecimiento. El agente lee estos registros de chat para identificar lo que preguntan los usuarios, descubre vacíos de conocimiento y propone automáticamente metadatos nuevos para llenar esos vacíos.
Por ejemplo, si los registros de chat revelan que los usuarios preguntan con frecuencia "¿Qué significa el código de estado 42?" y el agente no responde, el autoaprendizaje activa una propuesta de metadatos para documentar ese código de estado faltante.
Fuentes de datos e integraciones compatibles para las tareas de enriquecimiento
Las tareas de enriquecimiento se integran en sistemas de Google Cloud y de terceros.
Fuentes de datos para el enriquecimiento
El agente de enriquecimiento puede enriquecer y agregar directamente recursos de datos de destino de las siguientes fuentes de datos de Google Cloud a tus conjuntos de contexto:
Tablas y conjuntos de datos de BigQuery
Catálogos, espacios de nombres y tablas de Lakehouse
A través de la integración de Lakehouse, Knowledge Studio admite de forma indirecta el enriquecimiento de metadatos de fuentes de terceros adjuntas a través de integraciones de Iceberg REST Catalog (como Databricks Unity, Snowflake Horizon, AWS Glue Data Catalog y SAP Business Data Cloud).
Indicadores de conocimiento (opcional)
Durante una ejecución de enriquecimiento, el agente puede extraer reglas semánticas, contexto empresarial y conocimiento del dominio de las siguientes fuentes opcionales de solo lectura que adjuntes a la tarea:
Google Cloud:
- Buckets, carpetas o archivos individuales de Cloud Storage que contengan formatos de archivo compatibles (como PDF, CSV, Markdown, configuración, conjuntos de datos y archivos de texto no estructurados)
- Glosarios empresariales de Knowledge Catalog ubicados en el mismo permiso regional
- Aplicaciones de Google Workspace, incluidos los archivos de Google Drive (como Documentos, Hojas de cálculo, Presentaciones, PDFs, archivos y documentos de texto genéricos)
Sistemas de terceros (que no son de Google Cloud):
- Archivos de Microsoft SharePoint de menos de 5 MB (como archivos PDF, archivos de Office y documentos de texto genéricos, sin incluir formatos o imágenes heredados)
- Repositorios de GitHub (cualquier archivo que contenga texto legible)
- Espacios de Atlassian Confluence y proyectos de Jira
Fuentes de autoaprendizaje (opcional)
Para identificar las brechas de conocimiento a partir de los registros de interacción reales, el agente de enriquecimiento puede extraer trayectorias de las siguientes fuentes opcionales:
- Aplicaciones de Gemini Enterprise
- Tablas de análisis de agentes de BigQuery. Para obtener más información, consulta Análisis de agentes de BigQuery.
Cómo funciona el agente de enriquecimiento
Cuando activas una tarea de enriquecimiento, ya sea a pedido o de forma recurrente, se inicia una ejecución de enriquecimiento. El agente de enriquecimiento se ejecuta de forma asíncrona en segundo plano, analiza tus recursos de datos, seguimientos de consultas y documentación para producir propuestas de metadatos verificadas.
En el siguiente diagrama, se ilustra la arquitectura de alto nivel del flujo de trabajo de un agente de enriquecimiento:
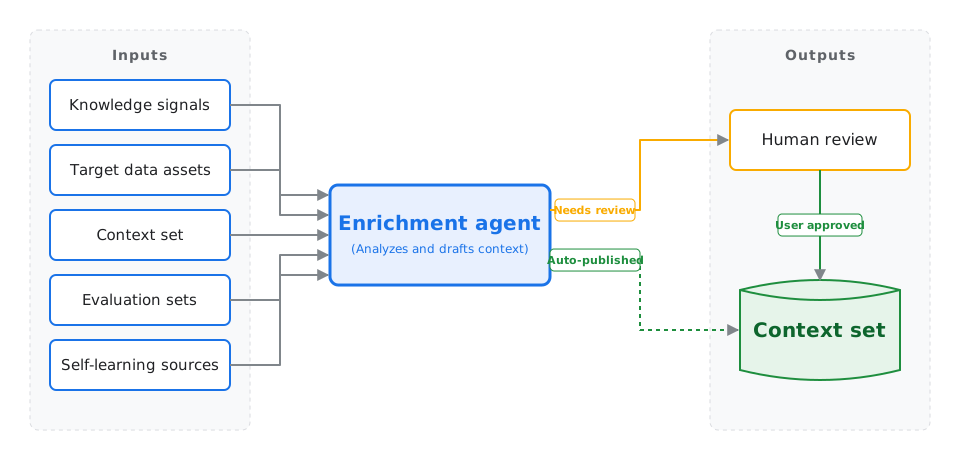
El agente selecciona tu conjunto de contexto a través de cuatro fases clave:
- Analiza indicadores y documentación: El agente extrae registros de interacción para encontrar dónde los agentes de IA downstream tuvieron dificultades o requirieron desambiguación. El agente analiza los documentos empresariales en Cloud Storage o las apps de terceros vinculadas, y examina el historial de consultas para descubrir uniones de tablas de alta frecuencia y dependencias ascendentes.
- Redacción de propuestas de contexto: Guiado por tu objetivo de selección, el agente redacta un contexto estructurado para tus recursos de destino. Estas propuestas de borrador incluyen descripciones generales de tablas orientadas a la empresa, fórmulas de métricas formales, condiciones de unión verificadas y plantillas de consulta en SQL basadas en parámetros de oro.
- Comparativas y optimización: Se verifica la validez determinística de cada propuesta (por ejemplo, la sintaxis de SQL válida) y se le asigna una puntuación de confianza, que se acumula en una puntuación de confianza general para la ejecución. Si configuraste un conjunto de evaluación, el agente también prueba de forma iterativa sus metadatos de borrador con tus preguntas de prueba para maximizar la exactitud de las consultas posteriores y mide si la exactitud disminuye en comparación con el modelo de referencia.
Aplicar políticas de revisión: El agente almacena en etapa intermedia todos los cambios propuestos como solicitudes de cambio. Cuando una ejecución genera más de 250 cambios de metadatos, el agente divide las propuestas en solicitudes de cambio por lotes encadenadas (Lote 1 de N, Lote 2 de N, etcétera) que se deben aprobar en secuencia. Si habilitaste la publicación automática, el agente evalúa toda la ejecución en su conjunto y aprueba automáticamente las solicitudes de cambio en etapa de pruebas, lo que deja un registro de auditoría, solo cuando se cumplen todas las condiciones siguientes:
- La puntuación de confianza general de la ejecución es de al menos 0.85 (85%) o cumple con el umbral configurado.
- Ninguna propuesta falla una verificación de validez (por ejemplo, SQL con formato incorrecto).
- Cuando se configura un conjunto de evaluación, la exactitud disminuye en no más de 5 puntos porcentuales (o la disminución máxima de calidad que hayas configurado).
Si no se cumple alguna de estas condiciones, todas las propuestas de la ejecución permanecerán en etapa de pruebas como solicitudes de cambio para su revisión manual. Las propuestas de eliminación siempre se almacenan en etapa intermedia en una solicitud de cambio de Eliminaciones independiente y se retienen para su revisión manual, incluso cuando la publicación automática está habilitada.
Seguridad y administración empresarial
Debido a que las tareas de enriquecimiento de Knowledge Studio usan inteligencia artificial para analizar tus esquemas de datos y documentación interna, la plataforma implementa límites estrictos de seguridad y administración para proteger tu información de propiedad exclusiva:
Identidad de ejecución administrada por el usuario: Las tareas de enriquecimiento se ejecutan con una cuenta de servicio de ejecución administrada por el usuario que configuras en tu proyecto. El agente de servicio de Dataplex actúa en nombre de esta cuenta de servicio de ejecución con credenciales de corta duración, lo que garantiza que las tareas solo puedan leer las fuentes de datos y los conjuntos de contexto a los que otorgas acceso explícito.
Gobernanza con intervención humana: Las propuestas de metadatos generadas se almacenan en etapa intermedia como solicitudes de cambio para mantener un registro de auditoría. A menos que habilites la publicación automática y la ejecución cumpla con todos los umbrales de calidad, validez y evaluación, los administradores de datos deben inspeccionar las comparaciones de diferencias y las puntuaciones de confianza antes de aprobar las actualizaciones de un conjunto de contexto. Las propuestas de eliminación siempre requieren una revisión manual.
Entrenamiento de modelos de base: Tus datos siguen siendo tuyos. Los seguimientos de ejecución, los esquemas de bases de datos y los indicadores de conocimiento proporcionados por el cliente (como documentos o glosarios internos) nunca se usan para entrenar los modelos de base de Google.
Limpieza de datos: Antes de que se escriban los metadatos propuestos en un conjunto de contexto, el agente oculta automáticamente la información de identificación personal (IIP) de los registros del sistema y los seguimientos de generación.
Límites de ejecución: El agente de enriquecimiento opera dentro de un usuario seguro administrado por Google. El agente llega a tus fuentes de datos privadas con una interfaz de Private Service Connect y un proxy de salida controlado por el cliente.
Para configurar los roles de Identity and Access Management (IAM), las cuentas de servicio y los proveedores de autenticación externos para las tareas de enriquecimiento, consulta Configura los requisitos previos para las tareas de enriquecimiento.
Parámetros de configuración recomendados
Knowledge Catalog proporciona varios parámetros de configuración opcionales para las tareas de enriquecimiento. Te recomendamos que comiences con una configuración básica y habilites de forma progresiva las funciones avanzadas a medida que escalas tus operaciones de metadatos.
| Configuración | Componentes incluidos | Publicación automática | Casos en los que se recomienda |
|---|---|---|---|
| Básica | Conjunto de información contextual | Inhabilitado | Prueba la herramienta. Te permite ver cómo el agente infiere metadatos estrictamente a partir del esquema de tu conjunto de datos. Debes revisar todas las propuestas de forma manual. |
| Con fundamento |
|
Inhabilitado | Entornos de producción Fundamenta al agente en tu lógica empresarial específica, usando tus procedimientos operativos estándar y glosarios para mejorar la precisión. |
| Automatizado |
|
Habilitado | Escala las operaciones de metadatos. El conjunto de evaluación actúa como una baranda de seguridad. Si una propuesta generada de forma automática provoca una regresión en la exactitud de los datos posteriores, la publicación se detiene para que se realice una revisión manual. |
| Autoaprendizaje |
|
Habilitado | Catálogos avanzados y autónomos El agente se adapta continuamente analizando las interacciones de los usuarios en vivo y los registros de chat de los agentes para identificar y corregir las brechas de conocimiento. |
Elige entre una sola tarea y varias tareas
Cada tarea de enriquecimiento tiene una relación uno a uno con su conjunto de contexto de destino y admite hasta 500 recursos de datos en total en los recursos predeterminados del conjunto de contexto y cualquier recurso adicional que agregues a la tarea.
- Usa una sola tarea de enriquecimiento y un conjunto de contexto cuando hasta 500 tablas compartan un dominio empresarial, un equipo de administración de datos y un programa de actualización comunes. Agrupar las tablas relacionadas en una sola tarea permite que el agente de enriquecimiento descubra claves de unión entre tablas, conceptos empresariales compartidos y plantillas de consulta en SQL de varias tablas en una sola ejecución. Si una ejecución grande genera más de 250 propuestas de metadatos, Knowledge Studio divide automáticamente el resultado en lotes secuenciales (Lote 1 de N, Lote 2 de N) para que los revisores puedan aprobarlos en etapas manejables.
- Divide en varios conjuntos de contexto y tareas de enriquecimiento cuando tus dominios de datos tengan propietarios de dominio o aprobadores de flujo de trabajo distintos, requieran diferentes programas de ejecución o indicadores de conocimiento, o abarquen más de 500 tablas de destino.
Ciclo de vida de la Deployment
El proceso de compilación e implementación de una tarea de enriquecimiento sigue un ciclo de vida lineal:
- Configura los requisitos previos: Otorga los roles necesarios, configura las cuentas de servicio y habilita la generación de perfiles de datos y las estadísticas de datos de IA en las tablas de uso frecuente. Para obtener más información, consulta Configura los requisitos previos para las tareas de enriquecimiento.
- Vincular conocimiento externo: Autoriza la tarea para leer archivos de tu unidad de Google Drive o repositorios de Git externos para fundamentar. Para obtener más información, consulta Configura conectores externos para tareas de enriquecimiento.
- Crea la tarea: Define el conjunto de contexto, los recursos objetivo, los indicadores de conocimiento y la estrategia de evaluación. Para obtener más información, consulta Crea tareas de enriquecimiento.
- Revisa las propuestas de la IA: Verifica los diagnósticos de la ejecución, revisa las descripciones propuestas y aprueba los cambios en los metadatos. Para obtener más información, consulta Evalúa y aprueba propuestas de enriquecimiento.
Limitaciones
Durante la versión preliminar, las tareas de enriquecimiento operan dentro de los siguientes límites:
Límites de cumplimiento: Las tareas de enriquecimiento no admiten los Controles del servicio de VPC (Controles del servicio de VPC), las claves de encriptación administradas por el cliente (CMEK), los compromisos de residencia de datos (DRZ), la Transparencia de acceso (AXT) ni Assured Workloads.
Administración centrada en la consola: Configuras y administras tareas exclusivamente a través de la consola de Google Cloud . Las APIs de REST públicas directas y los comandos de la CLI de
gcloudno están disponibles en la versión preliminar.Alcance de la tarea y asignación de conjuntos de contexto uno a uno: Cada conjunto de contexto se puede enriquecer con solo una tarea de enriquecimiento, y cada tarea de enriquecimiento admite hasta 500 recursos de destino en total.
Cuotas y límites: Las tareas de enriquecimiento y las ejecuciones de tareas están sujetas a cuotas de frecuencia y recursos regionales por proyecto. Para obtener más información, consulta la sección Tareas de enriquecimiento de Knowledge Studio en Cuotas y límites.
Precios
Durante la versión preliminar, la ejecución de tareas de enriquecimiento de Knowledge Studio y la etapa de pruebas de las solicitudes de cambio por lotes no aprobadas se ofrecen sin cargo.
Un grupo de entradas de conjunto de contexto vacío o una solicitud de cambio por lotes no aprobada no genera cargos por almacenamiento de metadatos. Los cargos por almacenamiento de metadatos comienzan solo cuando apruebas una solicitud de cambio en tu grupo de entradas del conjunto de contexto (o cuando la publicación automática aplica los cambios), momento en el que se aplican los cargos estándar por almacenamiento de metadatos de Knowledge Catalog al proyecto que aloja el grupo de entradas. Los cargos de uso estándar, incluidos el procesamiento de consultas de BigQuery y las lecturas y escrituras de etapa de pruebas de Cloud Storage, se aplican en tu proyecto cuando una tarea de enriquecimiento usa recursos opcionales administrados por el cliente, como buckets de Cloud Storage para indicadores de conocimiento o conjuntos de evaluación y tablas de seguimiento de análisis de agentes de BigQuery para el autoaprendizaje.
¿Qué sigue?
Descripción general de Knowledge Studio
Conocer los conceptos básicos y la arquitectura de Knowledge Studio
Descripción general de los conjuntos de contexto
Aprende cómo los metadatos generados por las tareas de enriquecimiento se almacenan en conjuntos de contexto para fundamentar los agentes de IA.
Configura los requisitos previos para las tareas de enriquecimiento
Aprende a configurar roles y cuentas de servicio de para ejecutar tareas de enriquecimiento.
Crear tareas de enriquecimiento
Aprende a generar metadatos ejecutando tareas de enriquecimiento automatizadas.
Evaluar y aprobar propuestas de enriquecimiento
Aprende a supervisar los trabajos y a revisar o aprobar manualmente las propuestas de metadatos.
Administrar tareas de enriquecimiento
Obtén información para editar, pausar y borrar trabajos de enriquecimiento programados.