


「擴充工作」是 Knowledge Catalog 中的自主代理,可協助資料監管員和平台工程師擴充中繼資料作業。擴充工作會持續分析資料集結構定義、讀取公司文件,並為資料資產生成建議說明。為充分發揮擴充工作的效益,您必須熟悉 Knowledge Catalog 的核心概念和貴組織的資料架構。
擴充工作會自動生成中繼資料,減輕手動管理負擔,同時確保目錄反映準確、符合業務需求的背景資訊。
使用資料充實任務的好處
擴充工作可解決大規模 Data Catalog 準確性和即時性的問題。
| 切面 | 傳統方法 | Knowledge Studio 做法 |
|---|---|---|
| 流程 | 手寫說明。管理員會手動審查數千個資料表,並訪談領域專家。 | 代理程式驅動。自主代理分析資料並讀取標準作業程序。 |
| 速度和規模 | 隨著結構定義不斷變化,維護作業會變得緩慢且困難。 | 具備高擴充性。系統會持續產生高品質的中繼資料提案。 |
| 人力 | 高。需要大量手動輸入資料和持續維護。 | 低。資料管理員只需審查及核准生成的建議。 |
擴充工作用途
擴充工作可協助組織解決下列常見的中繼資料問題:
收購整合:某公司收購了新的業務單位,其中包含數千項未記錄的資料資產。資料工程師將擴充工作指向新資料集,並使用收購公司的資料字典做為知識信號。代理在幾小時內就為整個資料集提出符合業務需求的說明,而非耗時數月。
持續記錄:平台工程團隊建構動態湖倉,結構定義每天都會變更。他們設定擴充工作,每天自動發布,確保目錄一律反映最新的結構定義變更。
語意管理:中央資料辦公室希望標準化所有部門的術語。他們部署了充實工作,參照精選的 Knowledge Catalog 詞彙。如果資料表說明違反核准的企業詞彙表字詞,代理會自動標記並建議覆寫。
核心概念
設定擴充工作時,您需要定義下列核心元件:
- 資料充實工作
-
定義代理必須執行的操作。工作包含您選取的背景資訊集、目標資源、排程,以及您提供的任何知識信號。
舉例來說,您可以設定工作,指示代理在每週日午夜讀取 GitHub 存放區,並充實
finance資料集。 - 資料充實工作
- Knowledge Studio 中的後端自動調度管理程序,可執行擴充工作。
- 資料充實執行作業
-
工作在特定時間點的單一執行個體。Knowledge Studio 控制台包含「Jobs」(工作) 分頁,其中列出工作的歷來執行作業,您可以開啟特定執行作業,查看產生的中繼資料提案。
例如,10 月 24 日發生的特定執行個體,導致 15 項資料欄變更提案。
- 脈絡資料集
-
目標資料資產和中繼資料的有界容器。每項擴充工作都必須設為指定一個情境集。情境集可包含目標資源,例如 BigQuery 資料集或 Lakehouse,但如果沒有,也可以建立空白情境集。
例如,行銷情境集可將廣告活動資料表、廣告投資報酬率指標和術語詞彙表,邏輯上繫結至單一 AI 情境邊界。
- 知識信號
- 外部資料,可讓代理依據貴公司的實際情況運作。提供含有資料字典、Knowledge Catalog 詞彙或內部文件網址的 Cloud Storage bucket,可確保代理使用您的特定商業邏輯,而非一般猜測。
- 評估集
-
測試問題和對應的 SQL (以
.jsonl格式提供),用於評估代理的準確度。代理提出新的中繼資料時,會根據提案執行這些測試問題,確保發布前準確度不會下降。舉例來說,您可以提供「我們的 MRR 是多少?」等測試問題,並搭配計算每月經常性收益所需的確切 SQL 查詢。如果代理提出的中繼資料令人困惑,導致測試查詢失敗,系統就會標記該提案。
- 自主學習來源
-
Gemini Enterprise 應用程式或 BigQuery 代理數據分析的即時對話記錄。代理會讀取這些對話記錄,找出使用者詢問的問題、發現缺少的知識,並自動提出新的中繼資料來填補這些缺口。
舉例來說,如果對話記錄顯示使用者經常詢問「狀態碼 42 是什麼意思?」,而代理無法回答,自我學習功能就會觸發中繼資料提案,記錄缺少的狀態碼。
支援擴充工作的資料來源和整合
充實工作可與 Google Cloud 和第三方系統整合。
目標資料資產
擴充代理可以直接擴充下列Google Cloud 目標資料資產,並新增至情境集:
BigQuery 資料集、資料表和檢視
Lakehouse 湖泊、可用區和資產
透過 Lakehouse 整合,Knowledge Studio 間接支援從透過 Iceberg REST Catalog 整合 (例如 Databricks Unity、Snowflake Horizon、AWS Glue Data Catalog 和 SAP Business Data Cloud) 附加的第三方來源擴充中繼資料。
知識信號
在擴充執行期間,代理會從下列唯讀來源擷取語意規則、業務脈絡和領域知識:
Google Cloud:
- 包含支援檔案格式的 Cloud Storage bucket (例如 PDF、CSV、Markdown、設定、資料集和非結構化文字檔案)
- 位於相同區域範圍內的 Knowledge Catalog 組織詞彙
- Google Workspace 應用程式,包括 Google 雲端硬碟檔案 (例如文件、試算表、簡報、PDF、檔案和一般文字文件)
第三方系統 (非 Google Cloud):
- 5 MB 以下的 Microsoft SharePoint 檔案 (例如 PDF、Office 檔案和一般文字文件,不含舊版格式或圖片)
- GitHub 存放區 (任何包含可讀文字的檔案)
- Atlassian Confluence 頁面內文
自主學習來源
為從實際互動記錄中找出知識落差,擴充代理會從下列來源挖掘軌跡:
- Gemini Enterprise 應用程式
- BigQuery 代理分析資料表
- 使用限定範圍記錄檢視畫面的 Cloud Logging
擴充代理的運作方式
觸發擴充工作 (隨選或定期排程) 時,系統會啟動擴充執行作業。擴充代理會在背景以非同步方式執行,分析資料資產、查詢追蹤記錄和說明文件,產生經過驗證的中繼資料提案。
下圖說明擴充代理的高階工作流程架構:
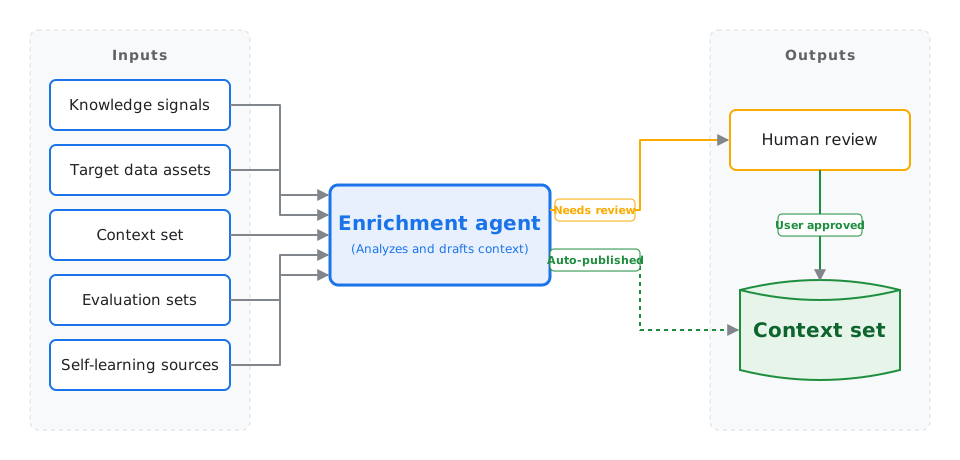
代理會透過四個主要階段,建立脈絡集:
- 分析信號和說明文件:代理會挖掘互動記錄,找出下游 AI 代理遇到困難或需要釐清之處。這項工具會掃描 Cloud Storage 或連結的第三方應用程式中的企業文件,並檢查查詢記錄,找出高頻率的資料表彙整和上游依附元件。
- 草擬脈絡提案:代理會根據您的收錄目標,為目標資產草擬結構化脈絡。包括業務導向的資料表總覽、正式指標公式、經過驗證的彙整條件,以及黃金參數式 SQL 查詢範本。
- 基準測試和最佳化:代理會使用評估集中的測試問題,反覆測試自己草擬的中繼資料,並修正說明,直到下游查詢準確度達到最高。接著,系統會執行保留的測試查詢,計算迴歸錯誤率。每項建議的說明或指標規則都會獲得可信度分數。
- 套用審查政策:符合信賴度門檻的提案會觸發政策規則。如果您已啟用自動發布功能,且迴歸錯誤率在允許範圍內,系統會自動合併變更。如果迴歸錯誤超過允許的門檻,系統會立即停止自動發布,並將所有提案打包成單一變更要求,送交專人審查。
資料安全性與治理
Knowledge Studio 擴充工作會使用人工智慧分析資料架構和內部文件,因此平台會實施嚴格的界限,保護您的專屬資訊。
基礎模型訓練:您的資料仍歸您所有。客戶的執行追蹤記錄、資料庫結構定義和提供的知識信號 (例如文件或內部詞彙),絕不會用於訓練 Google 的基礎模型。
資料清理:在將任何建議的中繼資料寫入情境集之前,代理會自動從系統記錄和生成追蹤記錄中,遮蓋個人識別資訊 (PII)。
執行界線:擴充代理會在 Google 代管的安全租戶中運作。這項服務會使用 Private Service Connect 介面和客戶控管的輸出 Proxy,安全地連至私人資料來源。
法規遵循狀態:在目前的預先發布版階段,擴充工作不支援 VPC Service Controls (VPC-SC)、客戶自行管理的加密金鑰 (CMEK) 或 Assured Workloads。
建議設定
Knowledge Catalog 提供多項擴充工作的選用設定。建議您先從基本設定開始,並在擴充中繼資料作業時,逐步啟用進階功能。
| 設定 | 包含的元件 | 自動發布 | 適合 |
|---|---|---|---|
| 基本版 | 脈絡資料集 | 已停用 | 測試工具。您可以查看代理如何嚴格依據資料集的結構定義推論中繼資料。您必須手動審查所有提案。 |
| 有依據 |
|
已停用 | 正式環境。以您的特定商業邏輯為基準,使用標準作業程序和詞彙表,提高代理的準確度。 |
| 自動化處理 |
|
已啟用 | 調整中繼資料作業。評估集可做為安全防護機制。如果自動生成的提案導致下游準確度下降,系統會暫停發布,並送交人工審查。 |
| 自我學習 |
|
已啟用 | 進階和自主目錄。代理會分析即時使用者互動和代理對話記錄,找出並填補知識落差,持續調整。 |
限制和預覽範圍
在預先發布版期間,擴充工作會在下列限制內運作:
控制台優先管理:您只能透過 Google Cloud 控制台設定及管理工作。預先發布版不提供直接公開 REST API 和
gcloudCLI 指令。配額和限制:擴充工作和工作執行作業受限於各專案的區域資源和頻率配額。詳情請參閱「配額與限制」中的「Knowledge Studio 擴充工作」一節。
部署作業生命週期
建構及部署充實工作的程序遵循線性生命週期:
- 設定必要條件:授予必要角色、設定服務帳戶,並為常用資料表啟用資料剖析和 AI 資料洞察功能。詳情請參閱「設定擴充工作的必要條件」。
- 連結外部知識:授權工作讀取 Google 雲端硬碟或外部 Git 存放區中的檔案,以便建立基準。
- 建立工作:定義脈絡資料集、目標資源、知識信號和評估策略。
- 查看 AI 提案:檢查執行診斷、查看建議說明,並核准中繼資料變更。