


Un harnais d'évaluation AlphaEvolve doit traiter les mises à jour de code candidates de manière systématique via un pipeline d'exécution déterministe. Au lieu d'exécuter et de noter une solution en une seule fois, le harnais divise le pipeline en trois portes de test progressives :
Portes d'évaluation
Le diagramme suivant montre comment les programmes candidats passent par les trois niveaux de test distincts avant de renvoyer des métadonnées structurées à AlphaEvolve.
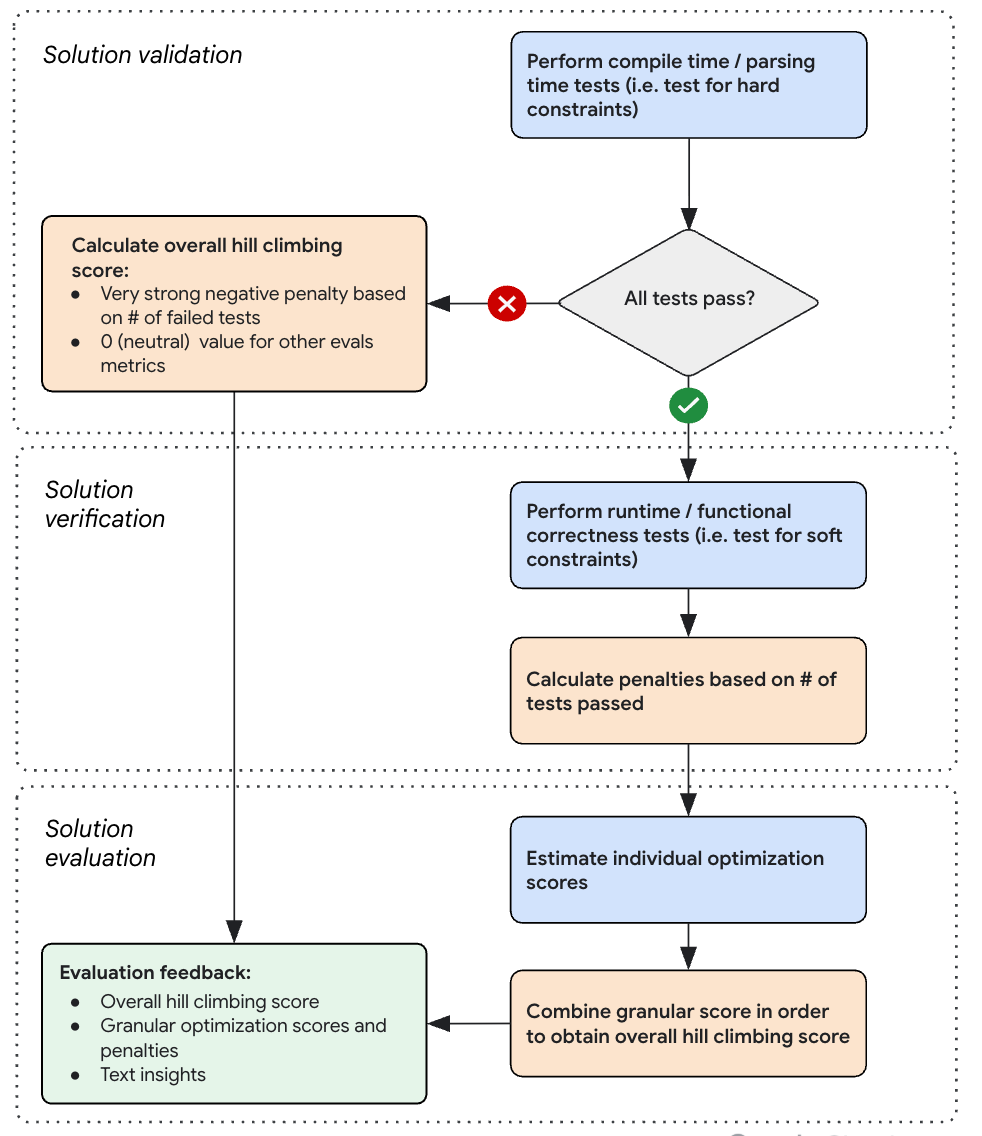
Validation de la solution
La boucle d'évaluation commence par appliquer des contraintes structurelles strictes sans exécuter la logique de base du code. Le harnais vérifie que la solution candidate présente une syntaxe de compilation de base correcte, des bugs d'analyse et des violations de sécurité structurelles.
Chemin de réussite : si le programme réussit toutes les vérifications de validation, le code passe en toute sécurité à la boucle d'exécution de vérification de la solution.
Chemin d'échec (court-circuit) : si un test de validation échoue, le harnais interrompt immédiatement l'exécution. Il contourne complètement les niveaux de vérification et de test de performances gourmands en ressources pour protéger l'infrastructure système. La boucle passe directement à la production de commentaires, en appliquant une pénalité de recherche plate massive (par exemple,
-1e12) ainsi que des scores de performances nuls.
Vérification de la solution
Une fois qu'un programme candidat est validé comme étant syntaxiquement correct et sûr à exécuter, le harnais le lance dans un environnement isolé pour appliquer des contraintes fonctionnelles souples. Cette phase exécute vos vérifications standard d'unité et de correction fonctionnelle.
Au lieu de générer un signal binaire de réussite ou d'échec, le harnais évalue le programme en fonction du nombre exact ou du pourcentage de tests fonctionnels réussis. Cela compte pour un score de pénalité global, ce qui fournit à AlphaEvolve un gradient de recherche numérique dense pour corriger progressivement les structures logiques défectueuses au fil des générations successives.
Évaluation de la solution
Lorsqu'un programme candidat s'avère à la fois syntaxiquement sûr et algorithmiquement correct, il atteint la couche d'analyse comparative des performances.
Le harnais exécute des tests empiriques, des calculs de logique de produit directe ou des simulations analytiques pour quantifier vos métriques d'optimisation métier cibles (telles que la vitesse d'exécution algorithmique, l'espace mémoire utilisé de l'infrastructure cloud ou les limites de calibration de sortie).
Commentaires d'évaluation complets
À la fin du pipeline d'exécution, le harnais agrège les données de toutes les phases terminées dans une charge utile de commentaires structurée. Cette charge utile est renvoyée directement à AlphaEvolve pour guider la sélection du parent pour les mutations ultérieures.
La sortie de commentaires standardisée comprend les trois composants principaux suivants :
Score global d'escalade : valeur scalaire unique et combinée calculée de manière déterministe par le harnais qu'AlphaEvolve maximise directement lors de l'optimisation.
Scores et pénalités d'optimisation granulaires : sous-métriques individuelles, temps d'exécution et répartition des pénalités de contraintes souples. Cette distribution explicite des données permet au moteur de raisonner clairement sur les compromis d'ingénierie sous-jacents.
Insights textuels : journaux structurels bruts et détails du mode d'échec renvoyés dans les futurs contextes de prompt, ce qui permet au LLM d'apprendre explicitement de ses erreurs de génération.