


In diesem Leitfaden wird die Bereitstellung einer hochverfügbaren Oracle Data Guard-Konfiguration in einem Google Distributed Cloud (GDC)-Standardcluster mit Air Gap beschrieben. Bei dieser Konfiguration wird die Oracle Database Enterprise Edition verwendet und die vorhandenen Funktionen von GDC für Speicher und Netzwerk werden genutzt.
In dieser Bereitstellung wird der offizielle Oracle Database Operator for Kubernetes verwendet, der die Lebenszyklusverwaltung der Datenbank automatisiert.
Architektur
Die Architektur beschreibt eine hochverfügbare Oracle Database-Bereitstellung, die vom Oracle Database Operator in einem GDC-Standardcluster verwaltet wird. Eine Hochverfügbarkeitsbereitstellung besteht aus einer primären Datenbank und einer Standby-Datenbank, die mit Data Guard für Replikation und Failover konfiguriert sind.
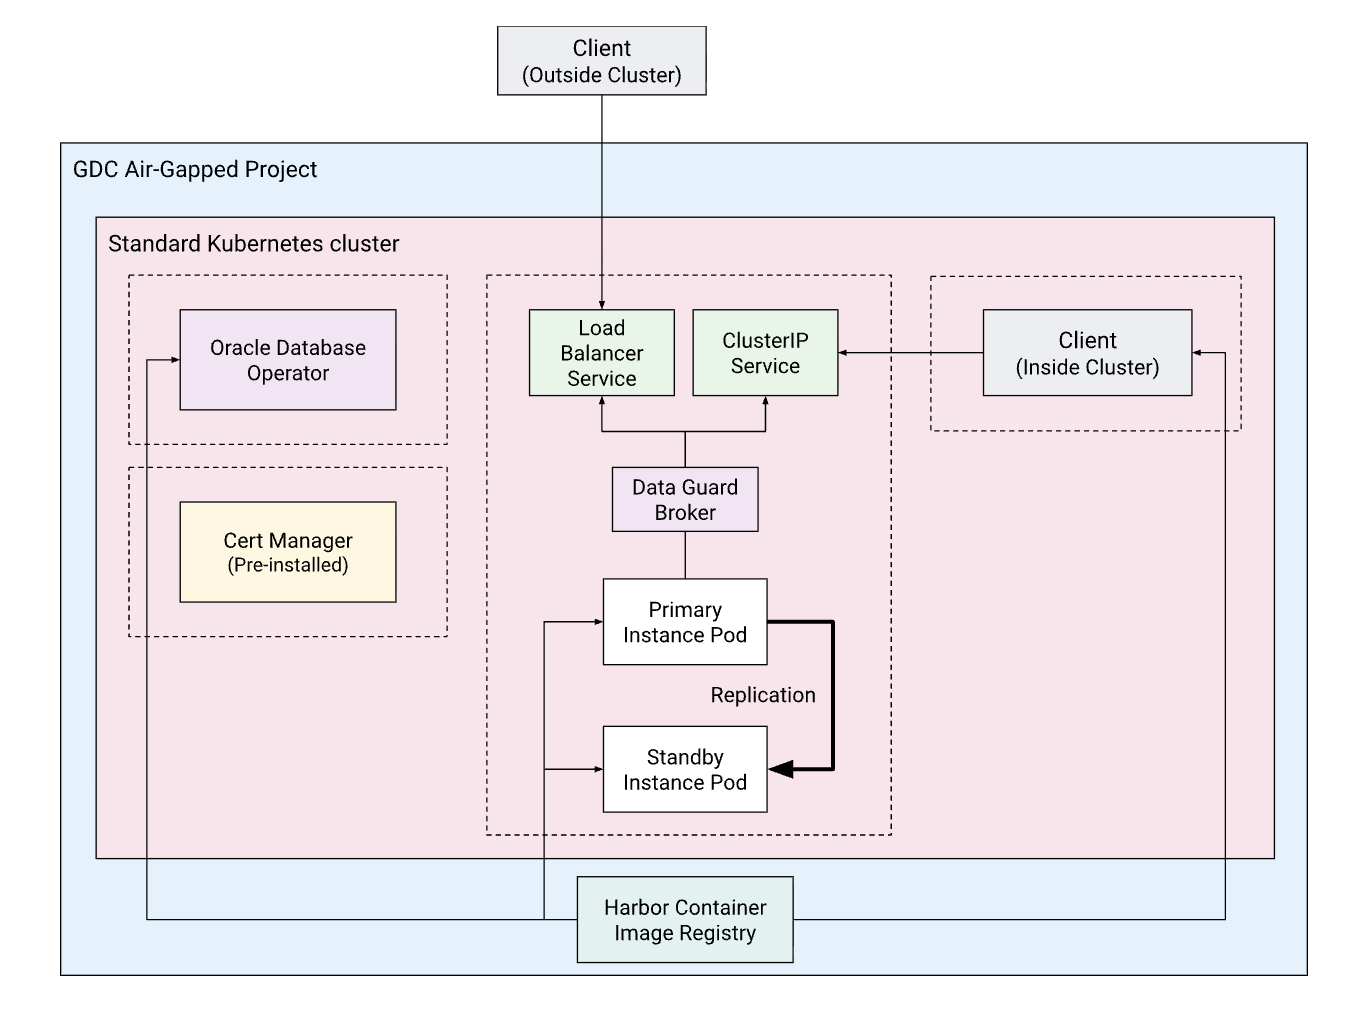
Die wichtigsten Komponenten sind:
- GDC-Projekt: Der Projektcontainer für Ihre Ressourcen.
- Standard-Kubernetes-Cluster: Ein Standardcluster, der die Rechenressourcen bereitstellt.
- Oracle Database Operator: Ein Kubernetes-Operator, der die Bereitstellung, die Verwaltung des Lebenszyklus und die Beobachtbarkeit von Oracle-Datenbanken automatisiert. Sie vereinfacht komplexe Aufgaben wie Patching, Sicherung und Wiederherstellung, sodass zustandsorientierte Oracle-Arbeitslasten in einer containerisierten Umgebung einfacher ausgeführt werden können.
- Primäre Datenbank: die aktive containerisierte Lese-/Schreibdatenbankinstanz.
- Standby-Datenbank: Die schreibgeschützte Replikat-Datenbankinstanz (oder Lese-/Schreibzugriff während des Failovers).
- Data Guard Broker: Orchestriert die Konfiguration und Rollenübergänge (Switchover/Failover) zwischen den Datenbanken.
- Harbor: Die private Container-Registry, die zum Hosten der Datenbank-, Operator- und Client-Images in der Air-Gap-Umgebung verwendet wird.
- Cert-manager: Der Operator verwendet
cert-managerzum Verwalten von Webhook-Zertifikaten.cert-managerist auf GDC-Standardclustern vorinstalliert.
In dieser Anleitung stellen Sie den Operator in einem eigenen Namespace (oracle-database-operator-system) und die Datenbankinstanz in einem separaten Namespace (oracle-dbs) bereit. Diese Namespaces sind im Architekturdiagramm mit gestrichelten Rahmen dargestellt.
Diese Trennung wird aus Gründen der Übersichtlichkeit und Verwaltbarkeit empfohlen. Es liegt jedoch bei Ihnen, wie Sie Ihre Datenbanken organisieren. Sie können beispielsweise bestimmte Datenbanken in verschiedenen Namespaces gruppieren, um eine detaillierte Zugriffssteuerung (RBAC) basierend auf den Anforderungen der Arbeitslast, der Teameigentümerschaft oder den Sicherheitsspezifikationen zu verwalten.
Hinweis
Bevor Sie mit der Bereitstellung beginnen, müssen Sie sicherstellen, dass Ihre Umgebung die folgenden Anforderungen erfüllt:
- Erstellen Sie ein Projekt, das als Container für alle Ressourcen dient, die in diesem Leitfaden generiert werden.
Weisen Sie Ihrem Nutzer die Rollen „Cluster-Administrator“ und „Standard-Cluster-Administrator“ für Ihr Projekt zu. So können Sie einen Kubernetes-Standardcluster erstellen und seine Ressourcen verwalten:
export PROJECT_ID=PROJECT_ID
export USER_NAME=USER_NAME

gdcloud projects add-iam-policy-binding ${PROJECT_ID} \
  --member="user:${USER_NAME}" \
  --role=cluster-admin

gdcloud projects add-iam-policy-binding ${PROJECT_ID} \
  --member="user:${USER_NAME}" \
  --role=standard-cluster-admin
Erstellen Sie eine Harbor-Instanz und ein Harbor-Projekt, um die für diese Anleitung erforderlichen Container-Images zu hosten.
Weisen Sie Ihrem Nutzer die Rolle „Harbor Instance Admin“ zu, damit Sie Images in Ihre Harbor-Instanz hochladen können:
gdcloud projects add-iam-policy-binding ${PROJECT_ID} \
  --member="user:${USER_NAME}" \
  --role=harbor-instance-admin
Erstellen Sie in Ihrem Harbor-Projekt ein Harbor-Roboterkonto. Später in diesem Leitfaden werden die Anmeldedaten des Roboterkontos in Kubernetes-Secrets gespeichert, damit der Cluster beim Instanziieren von Containern Images aus Harbor abrufen kann.
Erstellen Sie einen Kubernetes-Standardcluster mit mindestens zwei Worker-Knoten, die jeweils mindestens 16 GB Arbeitsspeicher haben. Beispiel:
kubectl --kubeconfig MGMT_API_KUBECONFIG create -f - <<EOF
apiVersion: cluster.gdc.goog/v1
kind: Cluster
metadata:
  name: ${CLUSTER_NAME}
  namespace: ${PROJECT_ID}
spec:
  nodePools:
  - machineTypeName: n3-standard-8-gdc
    nodeCount: 2
    name: ${CLUSTER_NAME}-node-pool
EOF
Richten Sie die Umgebungsvariablen ein. Diese werden im gesamten Leitfaden zum Erstellen und Verweisen auf Ressourcen verwendet:
Hinweise:
- Die beiden Datenbankinstanzen werden in diesem Leitfaden willkürlich als
blueundgreenbezeichnet. Anfänglich ist die Instanzbluedie primäre Instanz undgreendie Standby-Instanz.
# General info export PROJECT_ID="PROJECT_ID" export ZONE="ZONE" export ORG_NAME="ORG_NAME" export CLUSTER_NAME="CLUSTER_NAME" # Software versions export ORACLE_OPERATOR_VERSION="2.1.0" export ORACLE_DB_VERSION="21.3.0.0" # Namespaces export ORACLE_OPERATOR_NAMESPACE="ORACLE_OPERATOR_NAMESPACE" export DB_NAMESPACE="DATABASE_NAMESPACE" # Harbor config export HARBOR_INSTANCE_PROJECT_ID="HARBOR_PROJECT_ID" export HARBOR_INSTANCE_NAME="HARBOR_INSTANCE_NAME" export HARBOR_INSTANCE_URL="HARBOR_INSTANCE_URL" export HARBOR_PROJECT="HARBOR_PROJECT" export HARBOR_PULL_SECRET_NAME="HARBOR_PULL_SECRET_NAME" export HARBOR_ROBOT_ACCOUNT="robot\$HARBOR_PROJECT+ROBOT_NAME" export HARBOR_ROBOT_SECRET="HARBOR_ROBOT_SECRET" # Oracle database config export ADMIN_PASSWORD="ADMIN_PASSWORD" export ADMIN_PASSWORD_SECRET_NAME="ADMIN_PASSWORD_SECRET_NAME" # Database names export DB_NAME_BLUE="database-blue" export DB_NAME_GREEN="database-green"- Die beiden Datenbankinstanzen werden in diesem Leitfaden willkürlich als
Netzwerkhinweis: In diesem Leitfaden wird davon ausgegangen, dass er von einem Bastion-Knoten ausgeführt wird, der Zugriff auf die GDC APIs und das Internet hat, um die Manifeste und Container-Images des Oracle-Operators herunterzuladen. Wenn Sie dies auf einem Computer ohne Internetzugriff ausführen, müssen Sie diese Assets separat abrufen (z. B. mit
docker save, um Images von einem verbundenen Computer zu exportieren, und mitdocker load, um sie zu importieren) und sie sicher in Ihre Umgebung hochladen, bevor Sie fortfahren.Bevor Sie fortfahren, müssen Sie unter container-registry.oracle.com ein Konto erstellen und ein API-Token abrufen. Akzeptieren Sie dann die Lizenzvereinbarung für die Images Oracle Database Enterprise Edition und Oracle Instant Client.
Images in Harbor laden
Da Cluster in Google Distributed Cloud mit Air Gap nicht auf externe Registries zugreifen können, müssen Sie die erforderlichen Images in Ihre private Harbor-Instanz spiegeln.
In Oracle Container Registry anmelden
Sie müssen sich zuerst bei der offiziellen Oracle-Registry authentifizieren, um die Basis-Images abzurufen:
docker --config=./docker-oracle login container-registry.oracle.com
Nach erfolgreicher Anmeldung werden die Anmeldedaten in ./docker-oracle/config.json gespeichert.
In Harbor anmelden
Authentifizieren Sie sich mit Ihrer privaten Harbor-Instanz:
docker --config=./docker-harbor login ${HARBOR_INSTANCE_URL} \
  -u ${HARBOR_ROBOT_ACCOUNT} \
  -p ${HARBOR_ROBOT_SECRET}
Nach einer erfolgreichen Anmeldung werden die Anmeldedaten des Roboterkontos in ./docker-harbor/config.json gespeichert.
Images abrufen, taggen und übertragen
Laden Sie die Images aus der offiziellen Oracle-Container-Registry herunter und übertragen Sie sie per Push in Ihr internes Harbor-Projekt. Sie spiegeln den Operator, die Enterprise-Datenbank und den Instant Client zu Testzwecken.
Spiegeln Sie das Image des Oracle-Datenbankoperators:
docker --config=./docker-oracle pull \
  container-registry.oracle.com/database/operator:${ORACLE_OPERATOR_VERSION} \
  --platform linux/amd64

docker tag container-registry.oracle.com/database/operator:${ORACLE_OPERATOR_VERSION} \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-operator:${ORACLE_OPERATOR_VERSION}

docker --config=./docker-harbor push \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-operator:${ORACLE_OPERATOR_VERSION}
Spiegeln Sie das Oracle Database Enterprise-Image:
docker --config=./docker-oracle pull \
  container-registry.oracle.com/database/enterprise:${ORACLE_DB_VERSION} \
  --platform linux/amd64

docker tag container-registry.oracle.com/database/enterprise:${ORACLE_DB_VERSION} \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-enterprise:${ORACLE_DB_VERSION}

docker --config=./docker-harbor push \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-enterprise:${ORACLE_DB_VERSION}
Spiegeln Sie das Oracle Instant Client-Image:
docker --config=./docker-oracle pull \
  container-registry.oracle.com/database/instantclient:latest \
  --platform linux/amd64

docker tag container-registry.oracle.com/database/instantclient:latest \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-instantclient:latest

docker --config=./docker-harbor push \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-instantclient:latest
Clusterzugriff konfigurieren
Bevor Sie Ressourcen bereitstellen, rufen Sie die Anmeldedaten für Ihren Standardcluster ab und erstellen Sie einen Alias:
Rufen Sie die kubeconfig-Datei für Ihren Standardcluster ab:
KUBECONFIG=kubeconfig-${CLUSTER_NAME}.yaml gdcloud clusters \
  get-credentials ${CLUSTER_NAME} \
  --standard \
  --project ${PROJECT_ID} \
  --zone ${ZONE}
Erstellen Sie den Alias
kk, um nachfolgende Befehle zu vereinfachen:alias kk="kubectl --kubeconfig kubeconfig-${CLUSTER_NAME}.yaml"
Secrets erstellen
Erstellen Sie ein Kubernetes-Secret, damit der Cluster Images aus Harbor mit den in Ihrer lokalen ./docker-harbor/config.json gespeicherten Anmeldedaten abrufen kann. Sie benötigen dieses Secret sowohl im Namespace des Operators (zum Abrufen des Operator-Images) als auch im Namespace der Datenbank (zum Abrufen des Datenbank-Images).
Erstellen Sie den Namespace für den Operator:
kk create ns ${ORACLE_OPERATOR_NAMESPACE}Erstellen Sie das Pull-Secret für den Operator:
kk create secret docker-registry ${HARBOR_PULL_SECRET_NAME} \
  --from-file=.dockerconfigjson=./docker-harbor/config.json \
  -n ${ORACLE_OPERATOR_NAMESPACE}
Erstellen Sie den Namespace für die Datenbanken:
kk create ns ${DB_NAMESPACE}Erstellen Sie das Image-Pull-Secret für die Datenbankcontainer:
kk create secret docker-registry ${HARBOR_PULL_SECRET_NAME} \
  --from-file=.dockerconfigjson=./docker-harbor/config.json \
  -n ${DB_NAMESPACE}
Erstellen Sie das Secret für das Administratorpasswort der Datenbanken:
kk create secret generic ${ADMIN_PASSWORD_SECRET_NAME} \
  --from-literal=password=${ADMIN_PASSWORD} \
  -n ${DB_NAMESPACE}
Oracle Database Operator installieren
Installieren Sie jetzt den Oracle Database Operator in Ihrem Cluster, indem Sie drei Manifeste anwenden:
ClusterRoleBinding: Richtet die erforderlichen Berechtigungen für den Operator ein, damit er clusterweit funktioniert.
kk apply -f https://raw.githubusercontent.com/oracle/oracle-database-operator/refs/tags/v${ORACLE_OPERATOR_VERSION}/rbac/cluster-role-binding.yamlKnoten-RBAC: Gewährt Berechtigungen zum Lesen der Knotentopologie, was für die korrekte Pod-Planung entscheidend ist.
kk apply -f https://raw.githubusercontent.com/oracle/oracle-database-operator/refs/tags/v${ORACLE_OPERATOR_VERSION}/rbac/node-rbac.yamlOperator-Bereitstellung: Stellt die Operator-Pods und benutzerdefinierten Ressourcendefinitionen bereit. Mit diesem Befehl wird das offizielle Manifest heruntergeladen, der Image-Pfad durch Ihre Harbor-URL ersetzt, die
imagePullSecrets-Konfiguration eingefügt, damit sich Kubernetes bei Harbor authentifizieren kann, und das Ergebnis angewendet:curl -L https://raw.githubusercontent.com/oracle/oracle-database-operator/refs/tags/v${ORACLE_OPERATOR_VERSION}/oracle-database-operator.yaml \ | sed "s|container-registry.oracle.com/database/operator:latest|${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-operator:${ORACLE_OPERATOR_VERSION}|g" \ | awk "/terminationGracePeriodSeconds: 10/{print; print \" imagePullSecrets:\n - name: ${HARBOR_PULL_SECRET_NAME}\"; next}1" \ | kk apply -f -Warten Sie, bis die Operator-Pods ausgeführt werden:
kk get pods -n ${ORACLE_OPERATOR_NAMESPACE} --watchDie Ausgabe sollte so aussehen:
NAME                                                           READY   STATUS    RESTARTS   AGE
oracle-database-operator-controller-manager-5f7b56874d-k9v4z   1/1     Running   0          45s
oracle-database-operator-controller-manager-5f7b56874d-n2x8m   1/1     Running   0          45s
oracle-database-operator-controller-manager-5f7b56874d-r6z7q   1/1     Running   0          45s
Primäre und Standby-Datenbanken bereitstellen
Sie stellen jetzt nacheinander zwei Datenbankinstanzen im selben Namespace bereit.
Primäre Instanz bereitstellen
Führen Sie den folgenden Befehl aus, um die primäre Datenbankinstanz zu erstellen:
apiVersion: database.oracle.com/v4
kind: SingleInstanceDatabase
metadata:
  name: ${DB_NAME_BLUE}
  namespace: ${DB_NAMESPACE}
spec:
  replicas: 1
  edition: enterprise
  image:
    pullFrom: "${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-enterprise:${ORACLE_DB_VERSION}"
    pullSecrets: ${HARBOR_PULL_SECRET_NAME}
    prebuiltDB: true
  sid: ORCLBLUE
  pdbName: ORCLPDB1
  archiveLog: true
  flashBack: true
  forceLog: true
  adminPassword:
    secretName: "${ADMIN_PASSWORD_SECRET_NAME}"
    secretKey: "password"
  persistence:
    size: "50Gi"
    storageClass: "standard-rwo"
    accessMode: "ReadWriteOnce"
  resources:
    requests:
      memory: "4Gi"
Wichtige Konfigurationsparameter:
sid/pdbName: Definiert die Systemkennung (SID) und den Namen der steckbaren Datenbank (PDB).edition: Gibt die Datenbankversion an (in diesem Fallenterprise).image: Verweist auf das Image Ihrer privaten Harbor-Registry.persistence: Fordert ein nichtflüchtiges Volume mit 50 GiB mithilfe der StorageClassstandard-rwoan, die einen zonalen nichtflüchtigen Speicher in GDC erstellt.replicas: Legt die Anzahl der Pods für die Instanz auf 1 fest.archiveLog: Aktiviert den Archivprotokollmodus, der für Data Guard erforderlich ist.flashBack: Aktiviert die Flashback-Datenbank, sodass Sie die Datenbank auf einen früheren Zeitpunkt zurücksetzen können.forceLog: Aktiviert das erzwungene Logging, sodass alle Änderungen protokolliert werden, auch bei Vorgängen, die normalerweise das Logging umgehen.
Eine vollständige Liste der Konfigurationsoptionen, einschließlich benutzerdefinierter Initialisierungsparameter und Ressourcenlimits, finden Sie in der offiziellen Dokumentation.
Die Datenbankerstellung ist ressourcenintensiv und kann 10 bis 20 Minuten dauern.
Warten Sie, bis die Datenbank vollständig bereit ist, bevor Sie fortfahren. Dies ist wichtig, da die Standby-Datenbank Zugriff auf die primäre Datenbank benötigt, um die Replikation einzurichten.
Warten Sie, bis der Datenbank-Pod
Runningist:kk get po -n ${DB_NAMESPACE} -l app=${DB_NAME_BLUE} -wDie Ausgabe sollte so aussehen:
NAME                   READY   STATUS    RESTARTS   AGE
database-blue-i5xdj   0/1     Pending   0          0s
database-blue-i5xdj   0/1     Pending   0          0s
database-blue-i5xdj   0/1     Pending   0          1s
database-blue-i5xdj   0/1     Init:0/1   0          1s
database-blue-i5xdj   0/1     PodInitializing   0          98s
database-blue-i5xdj   0/1     Running           0          99s
database-blue-i5xdj   1/1     Running           0          99s
Beobachten Sie dann die Logs und warten Sie auf die Meldung
DATABASE IS READY TO USE!:kk logs -n ${DB_NAMESPACE} -l app=${DB_NAME_BLUE} -fDie Ausgabe sollte Folgendes enthalten:
#########################
DATABASE IS READY TO USE!
#########################
Prüfen Sie, ob der Status
Healthyund die RollePRIMARYist:kk get sidb -n ${DB_NAMESPACE} ${DB_NAME_BLUE}Die Ausgabe sollte so aussehen:
NAME            EDITION      STATUS    ROLE
database-blue   Enterprise   Healthy   PRIMARY
Stand-by-Instanz bereitstellen
Nachdem die primäre Instanz fehlerfrei ist, stellen Sie die Stand-by-Instanz bereit. Die Data Guard-Parameter (archiveLog, flashBack, forceLog) werden von der primären Datenbank übernommen und dürfen nicht im Standby-Manifest angegeben werden:
Stellen Sie die Stand-by-Instanz bereit:
apiVersion: database.oracle.com/v4
kind: SingleInstanceDatabase
metadata:
  name: ${DB_NAME_GREEN}
  namespace: ${DB_NAMESPACE}
spec:
  replicas: 1
  edition: enterprise
  image:
    pullFrom: "${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-enterprise:${ORACLE_DB_VERSION}"
    pullSecrets: ${HARBOR_PULL_SECRET_NAME}
    prebuiltDB: true
  sid: ORCLGREEN
  pdbName: ORCLPDB1
  adminPassword:
    secretName: "${ADMIN_PASSWORD_SECRET_NAME}"
    secretKey: "password"
  createAs: standby
  primaryDatabaseRef: ${DB_NAME_BLUE}
  persistence:
    size: "50Gi"
    storageClass: "standard-rwo"
    accessMode: "ReadWriteOnce"
  resources:
    requests:
      memory: "4Gi"
Warten Sie, bis der Datenbank-Pod
Runningist:kk get po -n ${DB_NAMESPACE} -l app=${DB_NAME_GREEN} -wDie Ausgabe sollte so aussehen:
NAME                   READY   STATUS    RESTARTS   AGE
database-green-q1gur   0/1     Pending   0          0s
database-green-q1gur   0/1     Pending   0          0s
database-green-q1gur   0/1     Pending   0          1s
database-green-q1gur   0/1     Init:0/1   0          1s
database-green-q1gur   0/1     PodInitializing   0          98s
database-green-q1gur   0/1     Running           0          99s
database-green-q1gur   1/1     Running           0          99s
Beobachten Sie dann die Logs und warten Sie auf die Meldung
DATABASE IS READY TO USE!:kk logs -n ${DB_NAMESPACE} -l app=${DB_NAME_GREEN} -fDie Ausgabe sollte Folgendes enthalten:
#########################
DATABASE IS READY TO USE!
#########################
Prüfen Sie, ob der Status
Healthyund die RollePHYSICAL_STANDBYist:kk get sidb -n ${DB_NAMESPACE}Die Ausgabe sollte so aussehen:
NAME             EDITION      STATUS    ROLE
database-blue    Enterprise   Healthy   PRIMARY
database-green                Healthy   PHYSICAL_STANDBY
Data Guard-Broker konfigurieren
Stellen Sie den
DataguardBrokerbereit, um die Data Guard-Konfiguration zu verwalten:apiVersion: database.oracle.com/v4 kind: DataguardBroker metadata: name: broker-blue-green namespace: ${DB_NAMESPACE} spec: primaryDatabaseRef: ${DB_NAME_BLUE} standbyDatabaseRefs: - ${DB_NAME_GREEN} protectionMode: MaxAvailability fastStartFailover: false loadBalancer: trueWichtige Konfigurationsparameter:
protectionMode: AufMaxAvailabilitygesetzt, um sicherzustellen, dass keine Daten verloren gehen, wenn mindestens ein Standby-System verfügbar ist. Wenn mindestens ein Standby-System erreichbar ist, wird in den asynchronen Modus gewechselt.fastStartFailover: Legen Siefalsefest, um das automatische Failover zu deaktivieren. Wenn diese Option aktiviert ist, kann ein Observer-Prozess automatisch ein Failover auslösen, wenn die primäre Datenbank nicht mehr verfügbar ist.loadBalancer: Wird auftruegesetzt, um einen Kubernetes-LoadBalancer-Dienst für den Broker zu erstellen, der eine stabile externe IP-Adresse bereitstellt, die immer zur aktuellen primären Datenbank weiterleitet.
Beobachten Sie den Broker-Status, bis
Healthygemeldet wird:kk get dataguardbroker -n ${DB_NAMESPACE} -wDie Ausgabe sollte so aussehen:
NAME PRIMARY STANDBYS PROTECTION MODE CONNECT STR STATUS FSFO broker-blue-green MaxAvailability Creating broker-blue-green MaxAvailability Creating broker-blue-green ORCLBLUE ORCLGREEN MaxAvailability 10.0.0.25:32345/DATAGUARD Creating false broker-blue-green ORCLBLUE ORCLGREEN MaxAvailability 10.0.0.25:32345/DATAGUARD Healthy falseDataguardBrokererstellt einen Kubernetes-Dienst (broker-blue-green), der Traffic automatisch an die aktuelle primäre Datenbank weiterleitet. Dies bietet einen stabilen Verbindungspunkt für Anwendungen. Diesen Dienst nutzen:kk get svc -n ${DB_NAMESPACE} broker-blue-greenDie Ausgabe sollte so aussehen: Beachten Sie die Bereitstellung eines
CLUSTER-IPfür clusterinterne Clients und einesEXTERNAL-IPfür externe Clients, die einen Load Balancer verwenden:NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE broker-blue-green LoadBalancer 10.0.19.198 100.66.38.138 1521:31116/TCP,5500:31842/TCP 8mPrüfen Sie die Endpunkte des Broker-Dienstes. Er muss anfänglich auf die IP-Adresse des blauen Pods verweisen:
kk get endpoints -n ${DB_NAMESPACE} broker-blue-greenDie Ausgabe sollte so aussehen, wobei die IP-Adresse des blauen Pods anstelle von
BLUE_POD_IPangezeigt werden sollte:NAME ENDPOINTS broker-blue-green [BLUE_POD_IP]:5500,[BLUE_POD_IP]:1521Prüfen Sie die Datenbank-Pods, um die IP-Adresse zu korrelieren:
kk get pod -n ${DB_NAMESPACE} -o wide
Datensynchronisierung und Rollen testen
Sie prüfen nun die Replikation, indem Sie Daten in die primäre Datenbank schreiben und sie mit einem clusterinternen Client-Pod aus der Standby-Datenbank lesen.
Mit Broker-Dienst in die primäre Datenbank schreiben
Stellen Sie einen temporären Pod bereit, um über den stabilen Broker-Dienst eine Verbindung zur primären Datenbank herzustellen:
kk run sqlplus -n ${DB_NAMESPACE} --rm -it --restart=Never \
  --image=${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-instantclient:latest \
  --image-pull-policy=Always \
  --overrides='{"spec": {"imagePullSecrets": [{"name": "'${HARBOR_PULL_SECRET_NAME}'"}]}}' \
  -- sqlplus sys/${ADMIN_PASSWORD}@broker-blue-green:1521/ORCLPDB1 as sysdba
Erstellen Sie eine Testtabelle:
CREATE TABLE employees (id NUMBER, name VARCHAR2(50));
INSERT INTO employees VALUES (1, 'John Doe');
COMMIT;
SELECT * FROM employees;
exit;
Die Ausgabe sollte so aussehen:
        ID NAME
---------- --------------------------------------------------
        1 John Doe
Aus Stand-by-Modus lesen (direkter Zugriff)
Stellen Sie einen temporären Pod bereit, um eine direkte Verbindung zum Standby-Dienst herzustellen:
kk run sqlplus -n ${DB_NAMESPACE} --rm -it --restart=Never \
  --image=${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-instantclient:latest \
  --image-pull-policy=Always \
  --overrides='{"spec": {"imagePullSecrets": [{"name": "'${HARBOR_PULL_SECRET_NAME}'"}]}}' \
  -- sqlplus sys/${ADMIN_PASSWORD}@${DB_NAME_GREEN}:1521/ORCLPDB1 as sysdba
Prüfen Sie die Datenreplikation:
SELECT * FROM employees;
exit;
Die Ausgabe sollte so aussehen:
        ID NAME
---------- --------------------------------------------------
        1 John Doe
Manuelles Switchover durchführen
Lösen Sie einen manuellen Switchover aus, um die Rollen umzukehren und die grüne Datenbank zur neuen primären Datenbank zu machen. Der Operator benötigt die SID (z. B. ORCLGREEN) für das Switchover-Ziel.
Führen Sie dazu diesen Befehl aus:
kk patch dataguardbroker broker-blue-green -n ${DB_NAMESPACE} --type='merge' \
  -p "{\"spec\":{\"setAsPrimaryDatabase\":\"ORCLGREEN\"}}"
Beobachten Sie den Fortschritt des Switchovers:
kk get sidb -n ${DB_NAMESPACE} -wDie Ausgabe sollte nach Abschluss der Umstellung so aussehen:
NAME             EDITION      STATUS    ROLE
database-blue    Enterprise   Healthy   PHYSICAL_STANDBY
database-green                Healthy   PRIMARY
Prüfen Sie, ob die Datenbankinstanzen die Rollen gewechselt haben und die grüne Datenbank jetzt die primäre ist:
kk get dataguardbroker -n ${DB_NAMESPACE}Die Ausgabe sollte so aussehen:
NAME                PRIMARY     STANDBYS   PROTECTION MODE
broker-blue-green   ORCLGREEN   ORCLBLUE   MaxAvailability
Prüfen Sie, ob die
broker-blue-green-Dienstendpunkte aktualisiert wurden und auf die IP-Adresse des grünen Pods verweisen:kk get endpoints -n ${DB_NAMESPACE} broker-blue-greenDie Ausgabe sollte so aussehen, wobei die IP-Adresse des grünen Pods anstelle von
GREEN_POD_IPangezeigt werden sollte:NAME ENDPOINTS broker-blue-green [GREEN_POD_IP]:5500,[GREEN_POD_IP]:1521
Nächste Schritte
- Referenzarchitektur für selbstverwaltete Oracle-Datenbanken
- Selbstverwaltete Oracle-Datenbanken bereitstellen