


Esta arquitetura de referência fornece uma estrutura conceitual para implantar e operar bancos de dados PostgreSQL gerenciados pelo cliente no Google Distributed Cloud (GDC) com isolamento físico. Essa solução permite que as organizações mantenham cargas de trabalho de banco de dados críticas aproveitando um cluster multizona de alta disponibilidade (HA) implantado em máquinas virtuais.
A arquitetura se concentra em uma configuração resiliente de três nós que garante a disponibilidade do banco de dados mesmo no caso de uma falha em uma única zona ou infraestrutura. Ele abrange todo o ciclo de vida, desde o provisionamento e a rede automatizados até operações de nível de produção, como alta disponibilidade, backup, restauração e observabilidade.
Recursos e funcionalidades
A solução oferece vários componentes funcionais principais para o gerenciamento de bancos de dados:
- Alta disponibilidade automatizada: use o Patroni e o etcd para fornecer eleição automática de líder e failover, garantindo que o banco de dados permaneça operacional sem intervenção manual.
- Resiliência em várias zonas: distribua nós de banco de dados em três zonas de disponibilidade distintas para se proteger contra interrupções localizadas de hardware ou infraestrutura.
- Automação padronizada: provisione toda a pilha usando playbooks baseados em Ansible com o Autobase para garantir implantações repetíveis e consistentes.
- Pool de conexões: serviço PgBouncer integrado para gerenciar altas contagens de conexão e estabilizar o consumo de recursos nos nós do banco de dados.
- Balanceamento de carga global: use o balanceador de carga global de camada 4 gerenciado pela plataforma para fornecer um IP virtual (VIP) único e estável que pode ser acessado em todas as zonas.
- Prontidão para isolamento físico: fluxos de trabalho especializados para empacotar todas as dependências e binários do sistema operacional necessários para implantação em ambientes desconectados.
- Proteção de dados: use ferramentas padrão, como
pg_dumpepg_basebackup, com snapshots de armazenamento do GDC para manter uma estratégia robusta de backup e recuperação.
Arquitetura
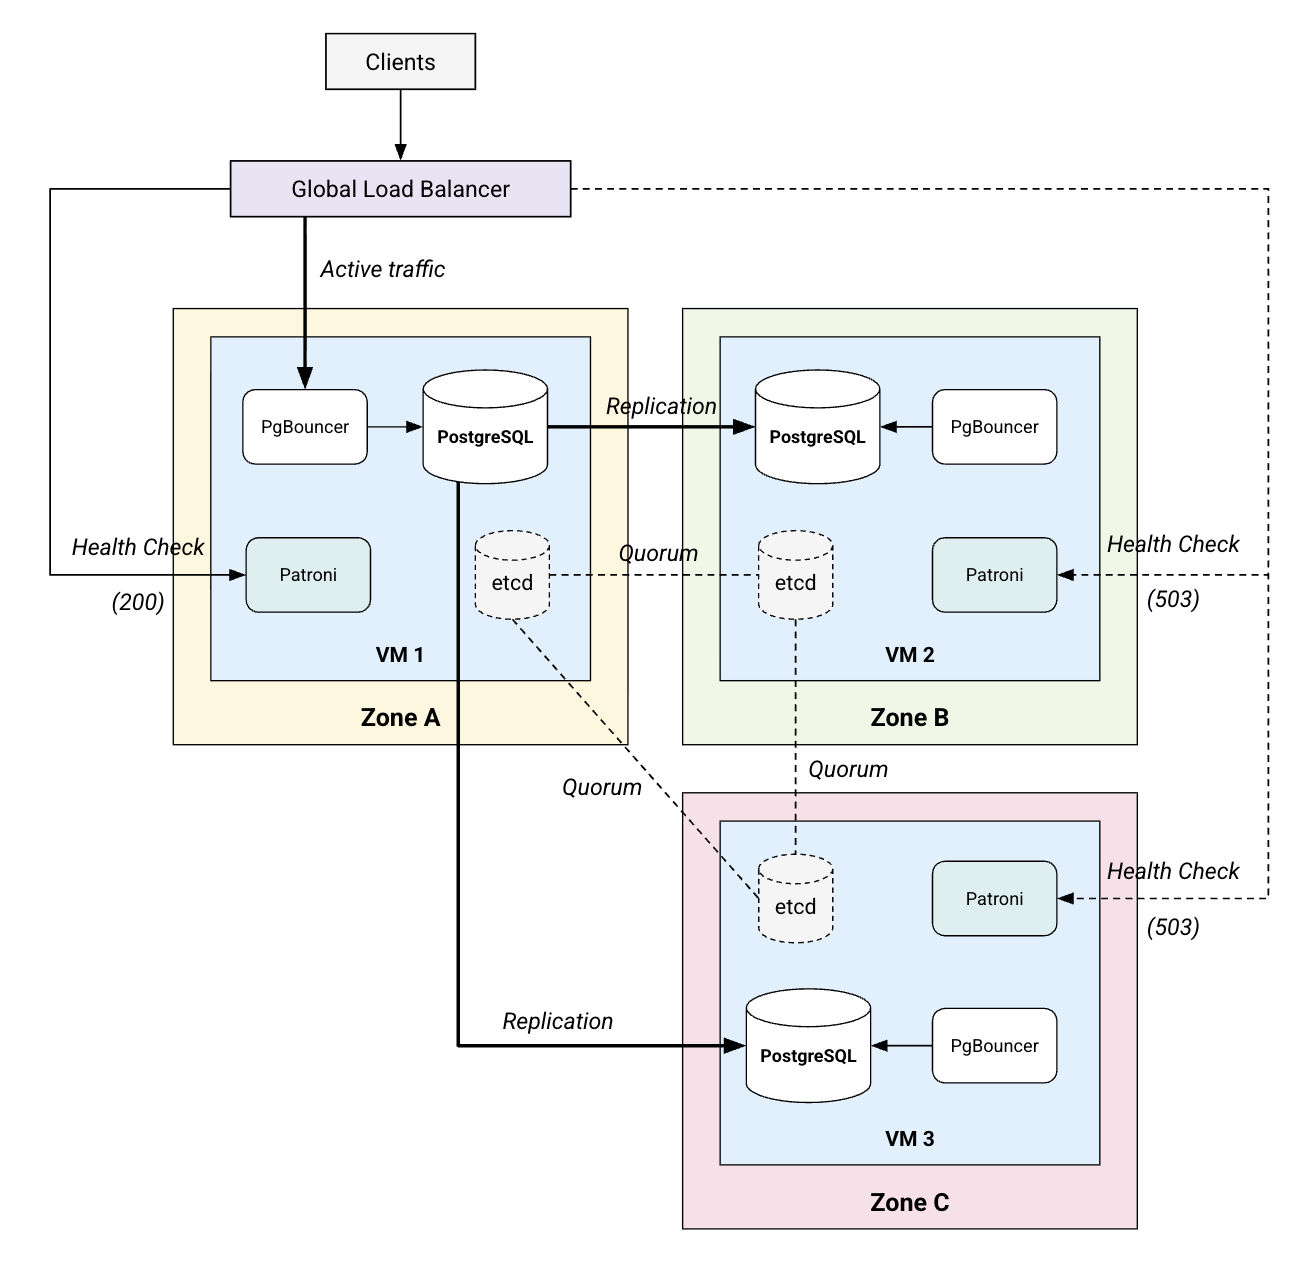
A arquitetura consiste em um ambiente de três VMs distribuído em três zonas de disponibilidade que executam uma pilha de serviços colocalizada.
Princípios de arquitetura
- Consenso baseado em maioria: usa um modelo baseado em quórum em que a maioria dos nós (2 de 3) precisa concordar com o estado do cluster, evitando cenários de "split-brain" e garantindo a integridade de dados.
- Separação de responsabilidades: cada VM executa uma pilha de serviços colocalizada, mas distinta (banco de dados, gerenciador de alta disponibilidade, consenso e pooler) para fornecer um nó independente e resiliente.
- Failover com reconhecimento de banco de dados: prioriza as métricas de integridade do banco de dados com a API REST do Patroni para coordenar o redirecionamento de tráfego pelo balanceador de carga da plataforma.
- Infraestrutura como código: depende de playbooks automatizados para todas as tarefas de configuração, reduzindo o risco de erro humano durante a implantação e o escalonamento.
Conceitos e tecnologias
Nesta seção, detalhamos os componentes funcionais, as responsabilidades deles e como eles se comunicam no sistema.
Infraestrutura e plataforma
- Máquinas virtuais (VMs): instâncias de computação dedicadas distribuídas entre zonas para hospedar a pilha do banco de dados.
- Balanceador de carga global de camada 4: um serviço gerenciado pela plataforma que fornece um IP virtual (VIP) estável que roteia o tráfego para o líder atual do cluster.
- Armazenamento permanente: é necessário um armazenamento de alto desempenho com SSD para atender aos requisitos rigorosos de latência dos registros prévios de escrita da camada de consenso.
Serviços e lógica
- PostgreSQL 17: o mecanismo de banco de dados relacional principal responsável pela persistência de dados e pela execução de consultas.
- Patroni: o gerenciador de alta disponibilidade que monitora o processo local do PostgreSQL e coordena as eleições de líder usando o etcd.
- etcd: o armazenamento de configuração distribuído que fornece a camada de consenso e mantém o estado autoritativo do cluster.
- PgBouncer: um pooler de conexões leve que fica na frente do PostgreSQL para processar conexões de aplicativos recebidas de maneira eficiente.
Fluxo de dados e interfaces
- PgBouncer (porta 6432): o ponto de entrada principal para o tráfego do banco de dados do aplicativo.
- API Patroni (porta 8008): uma interface REST HTTPS usada pelo balanceador de carga para
realizar verificações de integridade e identificar o líder atual usando o endpoint
/primary. - etcd (porta 2379): o canal de comunicação para o cluster de consenso manter o estado e realizar eleições.
Considerações
- Escalabilidade e desempenho:
- Os nós do banco de dados precisam ser dimensionados com base na carga de trabalho, com um mínimo de 2 vCPUs e 8 GiB de RAM. As cargas de trabalho Production normalmente começam em 8 vCPUs e 32 GiB.
- O desempenho depende do armazenamento de baixa latência. Os SSDs são necessários para garantir que o etcd possa processar sincronizações de dados em menos de 10 ms.
- Replicação síncrona: a sobrecarga da replicação síncrona depende diretamente da latência de rede entre zonas. Para garantir o desempenho ideal em configurações sem perda de dados, é necessária uma baixa latência entre zonas.
- Gerenciamento de recursos e licenciamento:
- Essa solução depende de componentes de banco de dados sem custo financeiro e de código aberto.
- O Autobase é usado como a ferramenta de automação de referência para simplificar a instalação e a configuração da pilha de alta disponibilidade. No entanto, a arquitetura não está exclusivamente vinculada ao Autobase, e os componentes de código aberto podem ser gerenciados usando pipelines personalizados.
- Para organizações que precisam de suporte formal para o pacote de automação, o suporte pago de terceiros está disponível.
- O pool de conexões com o PgBouncer é essencial para evitar o esgotamento de CPU e memória causado por um alto número de conexões de usuários.
- Disponibilidade e confiabilidade:
- A alta disponibilidade é alcançada por um quórum de três nós. A falha de qualquer nó ou zona não interrompe o serviço.
- Estabilidade do cluster: para manter um quórum confiável, é necessária uma baixa latência de rede entre os nós. O ideal é que os tempos de retorno (RTT) médios sejam inferiores a 10 ms para evitar tempos limite de eleição e instabilidade do cluster.
- Gerenciamento operacional:
- Tarefas de rotina, como aplicação de patches de versões secundárias e upgrades de versões principais, continuam sendo responsabilidade da equipe de operações do cliente.
- As saídas do
stdoutdas VMs são ingeridas automaticamente na plataforma de monitoramento do GDC com isolamento físico. Um guia será publicado no futuro sobre como integrar um monitoramento mais detalhado para os componentes individuais. - Uma estratégia de backup robusta precisa ser implementada usando ferramentas nativas do banco de dados e snapshots da plataforma. Guias detalhados para esses procedimentos serão publicados separadamente.
Decisão de design
As escolhas arquitetônicas dessa solução fornecem um caminho resiliente para implantações multizona.
Máquinas virtuais no Kubernetes
Uma abordagem baseada em VM foi selecionada para fornecer alta disponibilidade em várias zonas. O GDC não é compatível com clusters do Kubernetes que abrangem várias zonas físicas. Portanto, é necessário implantar VMs dedicadas em zonas separadas para alcançar uma arquitetura robusta entre zonas. Essa configuração pode sobreviver à falha total de uma única zona de infraestrutura.
Balanceamento de carga global nativo da plataforma
A arquitetura usa o balanceador de carga global L4 do GDC, em vez de proxies baseados em software nas VMs. Essa abordagem oferece várias vantagens:
- Alcance global: fornece um IP virtual estável que pode ser acessado em todas as zonas.
- Gerenciado pela plataforma: o VIP é gerenciado de forma independente pelo plano de controle da plataforma.
- Failover simplificado: o failover é gerenciado por meio de sondagens de verificação de integridade padrão, em vez de configurações de software locais complexas.
- Alta disponibilidade: remover a dependência de proxies locais garante que o ponto de entrada do tráfego do banco de dados permaneça resiliente.
Suposições e limitações
Suposições
- O ambiente tem um registro ou mecanismo local para importar dependências e binários de SO empacotados.
- O acesso SSH por chave está disponível para todas as VMs de destino para automação baseada em Ansible.
- O projeto tem cota suficiente para o provisionamento de VMs e balanceadores de carga multizonais.
Limitações
- Manutenção manual: a aplicação de patches no sistema operacional e os upgrades de versão do PostgreSQL são tarefas manuais e não são automatizadas pela solução.
- Sensibilidade do armazenamento: a camada de consenso (etcd) é altamente sensível à latência do disco. A alta contenção de armazenamento sustentada pode afetar a estabilidade da camada de consenso.
- Estabilidade da rede: o gerenciador de alta disponibilidade depende de uma conectividade de rede consistente e de baixa latência entre as zonas. Atrasos ou instabilidade na rede podem influenciar o tempo de coordenação do cluster e as transições de papéis.
Outros recursos
- Repositório de código de automação de referência: Código-fonte do Autobase no GitHub
- Implementação de referência do banco de dados PostgreSQL