


Questa architettura di riferimento fornisce un framework concettuale per il deployment e il funzionamento dei database PostgreSQL gestiti dal cliente su Google Distributed Cloud (GDC) con air gap. Questa soluzione consente alle organizzazioni di mantenere i workload di database critici sfruttando un cluster ad alta affidabilità (HA) multizona di cui è stato eseguito il deployment su macchine virtuali.
L'architettura si concentra su una configurazione resiliente a 3 nodi che garantisce la disponibilità del database anche in caso di errore di una singola zona o infrastruttura. Copre l'intero ciclo di vita, dal provisioning e dal networking automatizzati alle operazioni di livello di produzione come alta affidabilità, backup, ripristino e osservabilità.
Caratteristiche e funzionalità
La soluzione fornisce diversi componenti funzionali di base per la gestione dei database:
- Alta affidabilità automatizzata: utilizza Patroni ed etcd per fornire l'elezione automatica del leader e il failover, garantendo che il database rimanga operativo senza intervento manuale.
- Resilienza multizona: distribuisci i nodi del database in tre zone di disponibilità distinte per proteggerti da interruzioni localizzate dell'hardware o dell'infrastruttura.
- Automazione standardizzata: esegui il provisioning dell'intero stack utilizzando playbook basati su Ansible con Autobase per garantire deployment ripetibili e coerenti.
- Pool di connessioni: servizio PgBouncer integrato per gestire un numero elevato di connessioni e stabilizzare il consumo di risorse sui nodi del database.
- Bilanciamento del carico globale: utilizza il bilanciatore del carico L4 globale gestito dalla piattaforma per fornire un unico IP virtuale (VIP) stabile accessibile in tutte le zone.
- Idoneità con air gap: flussi di lavoro specializzati per il packaging di tutte le dipendenze e i file binari del sistema operativo richiesti per il deployment in ambienti disconnessi.
- Protezione dei dati: utilizza strumenti standard come
pg_dumpepg_basebackupinsieme agli snapshot di archiviazione di GDC per mantenere una solida strategia di backup e ripristino.
Architettura
L'architettura è costituita da un ambiente con tre VM distribuite in tre zone di disponibilità che eseguono uno stack di servizi in co-locazione.
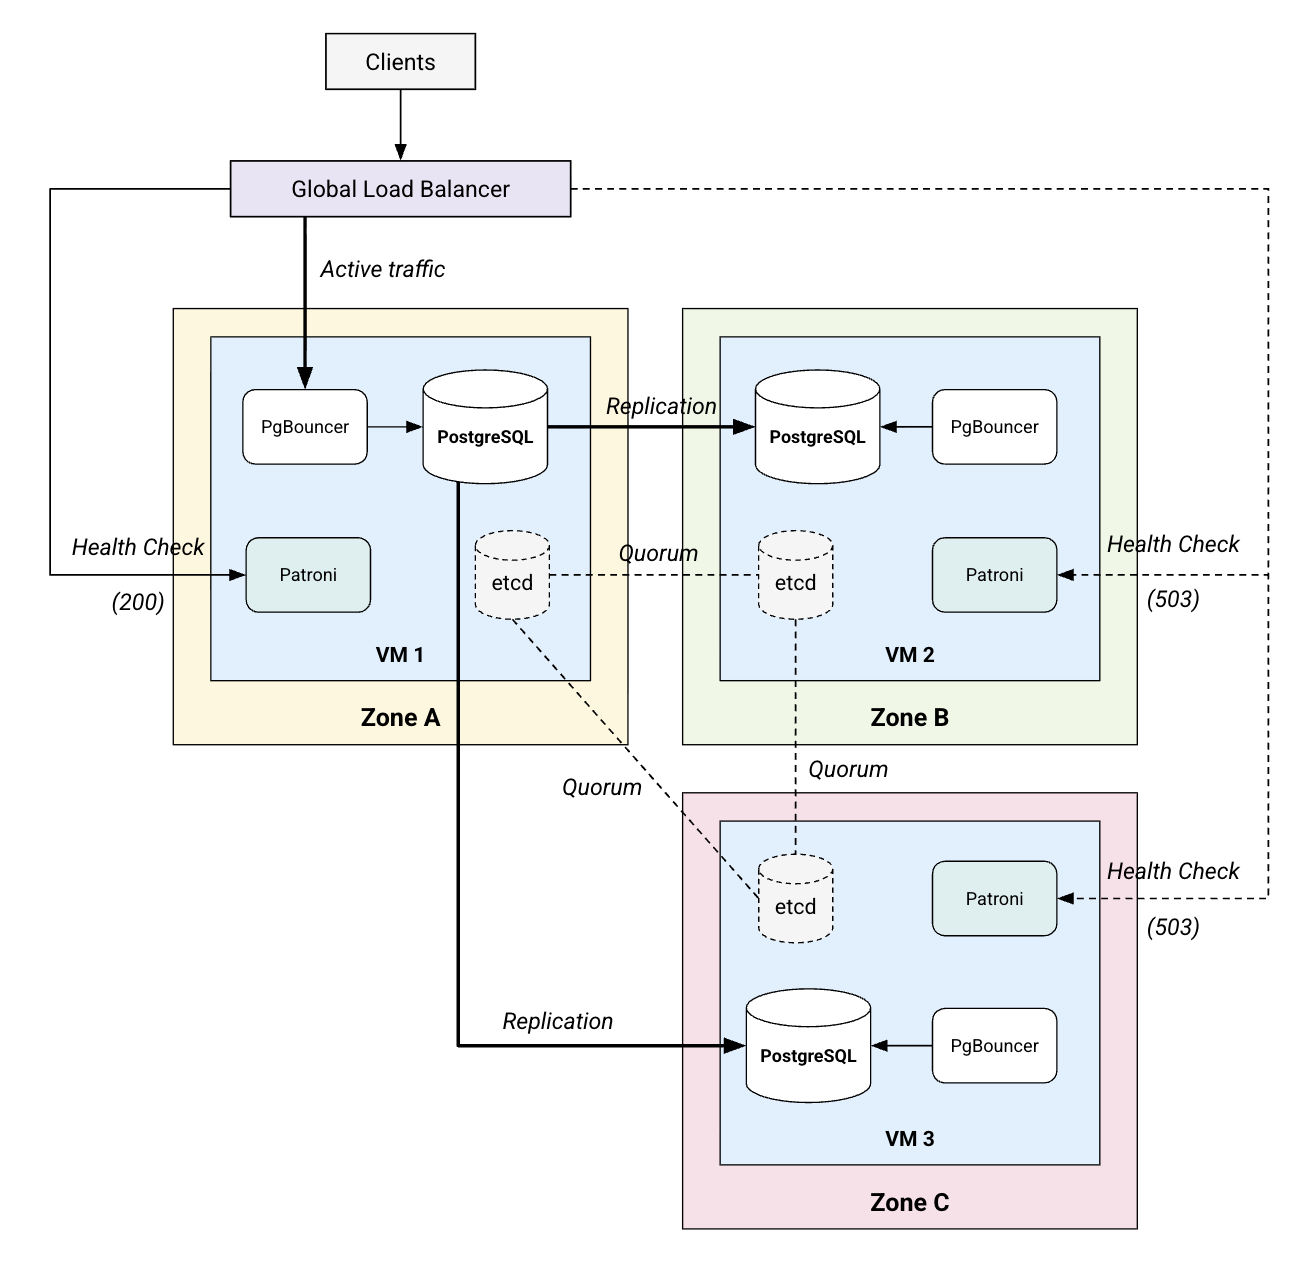
Principi di architettura
- Consenso basato sulla maggioranza: utilizza un modello basato su quorum in cui la maggior parte dei nodi (2 su 3) deve concordare sullo stato del cluster, evitando scenari di "split-brain" e garantendo l'integrità dei dati.
- Separazione delle responsabilità: ogni VM esegue uno stack di servizi collocati, ma distinti (database, gestore HA, consenso e pooler) per fornire un nodo autonomo e resiliente.
- Failover sensibile al database: assegna la priorità alle metriche di integrità del database con l'API REST di Patroni per coordinare il reindirizzamento del traffico tramite il bilanciatore del carico della piattaforma.
- Infrastructure as code: si basa su playbook automatizzati per tutte le attività di configurazione, riducendo il rischio di errori umani durante il deployment e lo scale up.
Concetti e tecnologie
Questa sezione descrive in dettaglio i componenti funzionali, le loro responsabilità e il modo in cui comunicano all'interno del sistema.
Infrastruttura e piattaforma
- Macchine virtuali (VM): istanze di computing dedicate distribuite tra le zone per ospitare lo stack del database.
- Bilanciatore del carico L4 globale: un servizio gestito dalla piattaforma che fornisce un IP virtuale (VIP) stabile che instrada il traffico al leader del cluster attuale.
- Archiviazione permanente: è necessario uno spazio di archiviazione supportato da SSD ad alte prestazioni per soddisfare i requisiti di latenza rigorosi per i log write-ahead del livello di consenso.
Servizi e logica
- PostgreSQL 17: il motore del database relazionale principale responsabile della persistenza dei dati e dell'esecuzione delle query.
- Patroni: il gestore dell'alta affidabilità che monitora il processo PostgreSQL locale e coordina le elezioni del leader utilizzando etcd.
- etcd: l'archivio di configurazione distribuito che fornisce il livello di consenso e contiene lo stato autorevole del cluster.
- PgBouncer: un pooler di connessioni leggero che si trova davanti a PostgreSQL per gestire in modo efficiente le connessioni delle applicazioni in entrata.
Flusso di dati e interfacce
- PgBouncer (porta 6432): il punto di accesso principale per il traffico del database dell'applicazione.
- API Patroni (porta 8008): un'interfaccia REST HTTPS utilizzata dal bilanciatore del carico per eseguire controlli di integrità e identificare il leader attuale utilizzando l'endpoint
/primary. - etcd (porta 2379): il canale di comunicazione per il cluster di consenso per mantenere lo stato ed eseguire le elezioni.
Considerazioni
- Scalabilità e prestazioni:
- I nodi del database devono essere dimensionati in base al workload, con un minimo di 2 vCPU e 8 GiB di RAM. I workload di produzione in genere partono da 8 vCPU e 32 GiB.
- Le prestazioni si basano su uno spazio di archiviazione a bassa latenza; le unità SSD sono necessarie per garantire che etcd possa elaborare le sincronizzazioni dei dati in meno di 10 ms.
- Replica sincrona: l'overhead della replica sincrona dipende direttamente dalla latenza di rete tra zone. Per garantire prestazioni ottimali per le configurazioni senza perdita di dati, è necessaria una bassa latenza tra le zone.
- Gestione delle risorse e licenze:
- Questa soluzione si basa su componenti di database open source senza costi.
- Autobase viene utilizzato come strumento di automazione di riferimento per semplificare l'installazione e la configurazione dello stack HA. Tuttavia, l'architettura non è legata esclusivamente ad Autobase e i componenti open source sottostanti possono essere gestiti utilizzando pipeline personalizzate.
- Per le organizzazioni che richiedono assistenza formale per il pacchetto di automazione, è disponibile l'assistenza a pagamento di terze parti.
- Il pooling delle connessioni con PgBouncer è essenziale per evitare l'esaurimento della CPU e della memoria causato da un numero elevato di connessioni utente.
- Disponibilità e affidabilità:
- L'alta affidabilità viene ottenuta tramite un quorum di 3 nodi. L'errore di un singolo nodo o di una singola zona non interrompe il servizio.
- Stabilità del cluster: il mantenimento di un quorum affidabile richiede una bassa latenza di rete tra i nodi. Idealmente, i tempi di round trip (RTT) medi dovrebbero essere inferiori a 10 ms per evitare timeout delle elezioni e instabilità del cluster.
- Gestione operativa:
- Le attività di routine, come l'applicazione di patch alle versioni secondarie e gli upgrade delle versioni principali, rimangono di responsabilità del team operativo del cliente.
- Gli output di
stdoutdelle VM vengono importati automaticamente nella piattaforma di monitoraggio GDC con air gap. In futuro verrà pubblicata una guida su come integrare un monitoraggio più dettagliato per i singoli componenti. - È necessario implementare una solida strategia di backup utilizzando strumenti nativi del database e snapshot della piattaforma. Le guide dettagliate per queste procedure verranno pubblicate separatamente.
Decisione di progettazione
Le scelte architettoniche per questa soluzione forniscono un percorso resiliente per i deployment multizona.
Macchine virtuali su Kubernetes
È stato scelto un approccio basato su VM per fornire alta affidabilità multizona. GDC non supporta i cluster Kubernetes che si estendono su più zone fisiche. Pertanto, per ottenere un'architettura tra zone solida, è necessario eseguire il deployment di VM dedicate in zone separate. Questa configurazione può sopravvivere al guasto totale di una singola zona dell'infrastruttura.
Bilanciamento del carico globale nativo della piattaforma
L'architettura sfrutta il bilanciatore del carico L4 globale di GDC anziché i proxy basati su software sulle VM. Questo approccio offre diversi vantaggi:
- Copertura globale: fornisce un IP virtuale stabile accessibile in tutte le zone.
- Gestito dalla piattaforma: il VIP è gestito in modo indipendente dal control plane della piattaforma.
- Failover semplificato: il failover viene gestito tramite probe di controllo di integrità standard anziché configurazioni software locali complesse.
- Alta affidabilità: l'eliminazione della dipendenza dai proxy locali garantisce che il punto di ingresso per il traffico del database rimanga resiliente.
Ipotesi e limitazioni
Ipotesi
- L'ambiente dispone di un registry o di un meccanismo locale per importare dipendenze e file binari del sistema operativo pacchettizzati.
- L'accesso SSH basato su chiavi è disponibile per tutte le VM di destinazione per l'automazione basata su Ansible.
- Il progetto dispone di una quota sufficiente per il provisioning di VM e bilanciatori del carico multizona.
Limitazioni
- Manutenzione manuale: l'applicazione di patch al sistema operativo e gli upgrade della versione di PostgreSQL sono attività manuali e non vengono automatizzati dalla soluzione.
- Sensibilità dello spazio di archiviazione: il livello di consenso (etcd) è molto sensibile alla latenza del disco. Una contesa di archiviazione elevata e prolungata può influire sulla stabilità del livello di consenso.
- Stabilità della rete: il gestore dell'alta affidabilità si basa su una connettività di rete coerente e a bassa latenza tra le zone. Ritardi o jitter di rete possono influire sulla tempistica del coordinamento del cluster e delle transizioni dei ruoli.
Materiali aggiuntivi
- Repository di codice di automazione di riferimento: Codice sorgente di Autobase su GitHub
- Implementazione di riferimento del database PostgreSQL