


Arsitektur referensi ini menyediakan framework konseptual untuk men-deploy dan mengoperasikan database PostgreSQL yang dikelola pelanggan di Google Distributed Cloud (GDC) dengan air gap. Solusi ini memungkinkan organisasi mempertahankan workload database penting dengan memanfaatkan cluster multi-zona yang sangat tersedia (HA) yang di-deploy di virtual machine.
Arsitektur ini berfokus pada konfigurasi 3 node yang tangguh yang memastikan ketersediaan database bahkan jika terjadi kegagalan satu zona atau infrastruktur. Solusi ini mencakup siklus proses lengkap, mulai dari penyediaan dan jaringan otomatis hingga operasi tingkat produksi seperti ketersediaan tinggi, pencadangan, pemulihan, dan kemampuan observasi.
Fitur dan kemampuan
Solusi ini menyediakan beberapa komponen fungsional inti untuk pengelolaan database:
- Ketersediaan tinggi otomatis: Gunakan Patroni dan etcd untuk menyediakan pemilihan pemimpin dan failover otomatis, sehingga memastikan database tetap beroperasi tanpa intervensi manual.
- Ketahanan multi-zona: Distribusikan node database di tiga zona ketersediaan yang berbeda untuk melindungi dari pemadaman hardware atau infrastruktur yang terlokalisasi.
- Otomatisasi standar: Sediakan seluruh stack menggunakan playbook berbasis Ansible dengan Autobase untuk memastikan deployment yang dapat diulang dan konsisten.
- Penggabungan koneksi: Layanan PgBouncer terintegrasi untuk mengelola jumlah koneksi yang tinggi dan menstabilkan konsumsi resource pada node database.
- Load balancing global: Gunakan Load Balancer L4 Global yang dikelola platform untuk menyediakan IP virtual (VIP) tunggal dan stabil yang dapat diakses di semua zona.
- Kesiapan air-gap: Alur kerja khusus untuk memaketkan semua dependensi dan biner sistem operasi yang diperlukan untuk deployment di lingkungan yang terputus.
- Perlindungan data: Manfaatkan alat standar seperti
pg_dumpdanpg_basebackupbersama snapshot penyimpanan GDC untuk mempertahankan strategi pencadangan dan pemulihan yang andal.
Arsitektur
Arsitektur ini terdiri dari lingkungan tiga VM yang didistribusikan di tiga zona ketersediaan yang menjalankan stack layanan yang ditempatkan bersama.
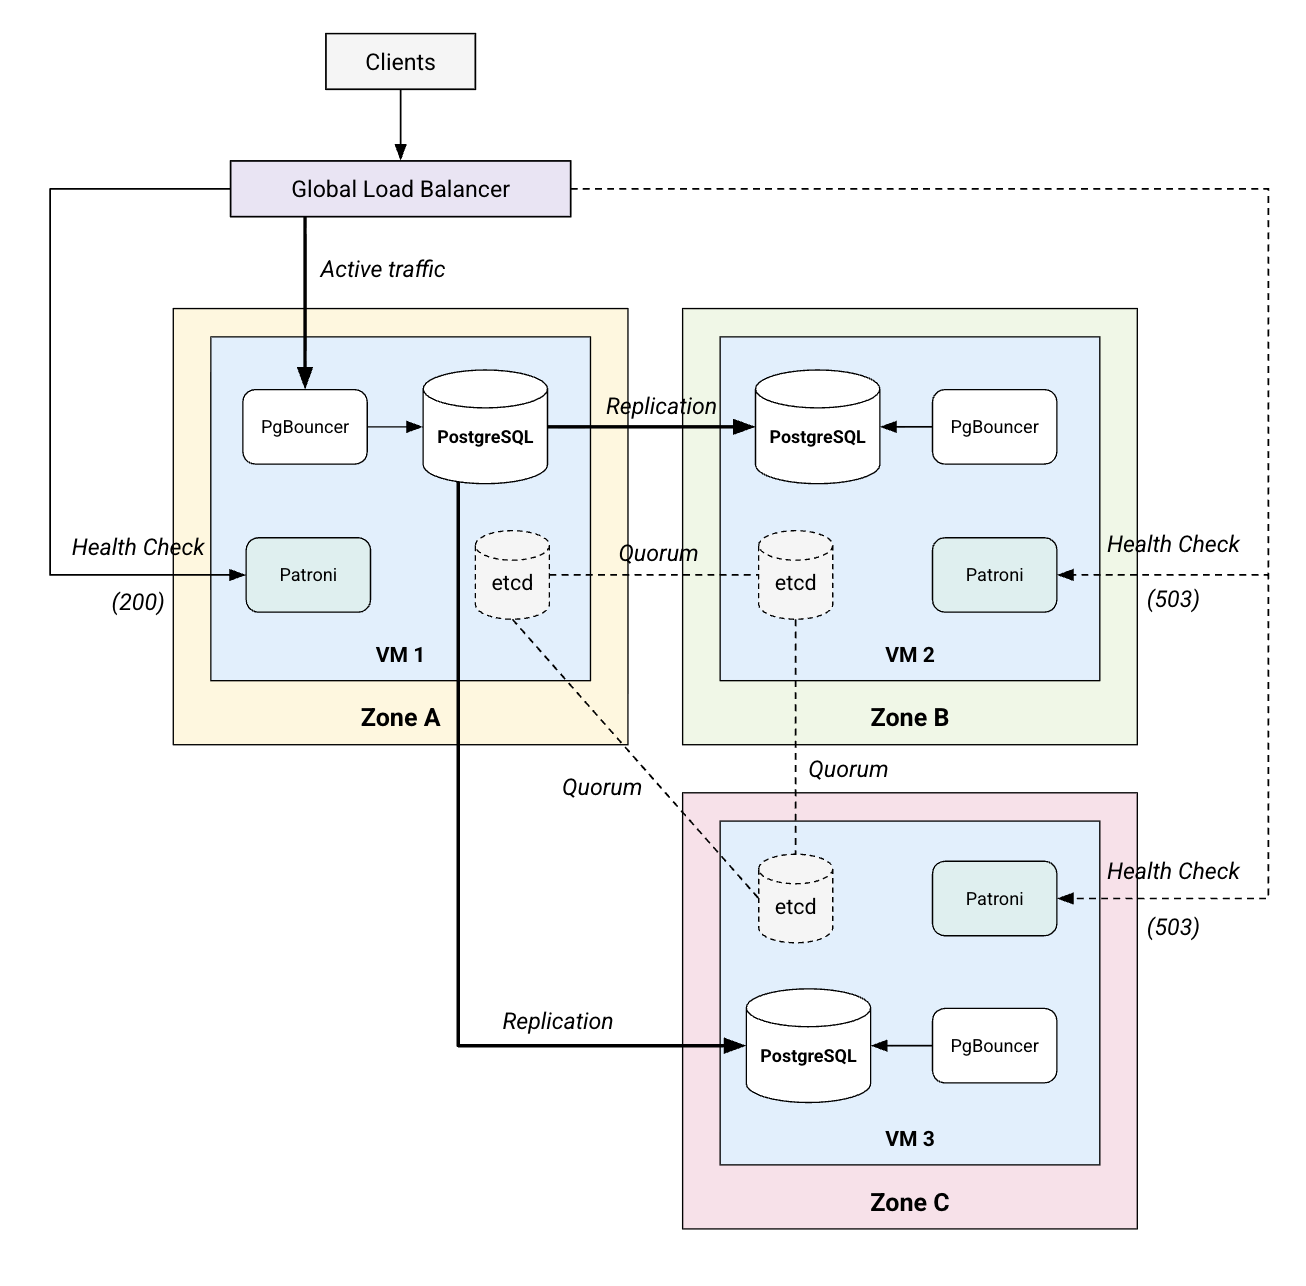
Prinsip arsitektur
- Konsensus berbasis mayoritas: Menggunakan model berbasis kuorum, yang mengharuskan mayoritas node (2 dari 3) menyetujui status cluster, sehingga mencegah skenario "split-brain" dan memastikan integritas data.
- Pemisahan fokus: Setiap VM menjalankan stack layanan yang ditempatkan bersama, tetapi berbeda (database, pengelola HA, konsensus, dan pooler) untuk menyediakan node yang mandiri dan tangguh.
- Failover berbasis database: Memprioritaskan metrik kondisi database dengan REST API Patroni untuk mengoordinasikan pengalihan traffic melalui load balancer platform.
- Infrastructure as code: Mengandalkan playbook otomatis untuk semua tugas konfigurasi, sehingga mengurangi risiko kesalahan manusia selama deployment dan penskalaan.
Konsep dan teknologi
Bagian ini menjelaskan komponen fungsional, tanggung jawabnya, dan cara komponen tersebut berkomunikasi dalam sistem.
Infrastruktur dan platform
- Virtual Machine (VM): Instance komputasi khusus yang didistribusikan di seluruh zona untuk menghosting stack database.
- Load Balancer L4 Global: Layanan yang dikelola platform yang menyediakan IP virtual (VIP) stabil yang merutekan traffic ke pemimpin cluster saat ini.
- Penyimpanan persisten: Penyimpanan yang didukung SSD berperforma tinggi diperlukan untuk memenuhi persyaratan latensi yang ketat untuk write-ahead log lapisan konsensus.
Layanan dan logika
- PostgreSQL 17: Mesin database relasional inti yang bertanggung jawab atas persistensi data dan eksekusi kueri.
- Patroni: Pengelola ketersediaan tinggi yang memantau proses PostgreSQL lokal dan mengoordinasikan pemilihan pemimpin menggunakan etcd.
- etcd: Penyimpanan konfigurasi terdistribusi yang menyediakan lapisan konsensus dan menyimpan status otoritatif cluster.
- PgBouncer: Pooler koneksi ringan yang berada di depan PostgreSQL untuk menangani koneksi aplikasi yang masuk secara efisien.
Aliran data dan antarmuka
- PgBouncer (Port 6432): Titik entri utama untuk traffic database aplikasi.
- Patroni API (Port 8008): Antarmuka REST HTTPS yang digunakan oleh load balancer untuk
melakukan health check dan mengidentifikasi leader saat ini menggunakan endpoint
/primary. - etcd (Port 2379): Saluran komunikasi untuk cluster konsensus guna mempertahankan status dan melakukan pemilihan.
Pertimbangan
- Skalabilitas dan performa:
- Node database harus diukur berdasarkan workload, dengan minimum 2 vCPU dan RAM 8 GiB. Workload produksi biasanya dimulai dari 8 vCPU dan 32 GiB.
- Performa bergantung pada penyimpanan latensi rendah; SSD diperlukan untuk memastikan etcd dapat memproses sinkronisasi data dalam waktu kurang dari 10 milidetik.
- Replikasi sinkron: Overhead replikasi sinkron bergantung langsung pada latensi jaringan antar-zona. Untuk memastikan performa yang optimal bagi konfigurasi tanpa kehilangan data, diperlukan latensi antar-zona yang rendah.
- Pengelolaan resource dan pemberian lisensi:
- Solusi ini mengandalkan komponen database open source gratis.
- Autobase digunakan sebagai alat otomatisasi referensi untuk menyederhanakan penginstalan dan konfigurasi stack HA. Namun, arsitektur ini tidak hanya terkait dengan Autobase, dan komponen open source yang mendasarinya dapat dikelola menggunakan pipeline kustom.
- Untuk organisasi yang memerlukan dukungan formal untuk paket otomatisasi, dukungan berbayar pihak ketiga tersedia.
- Penggabungan koneksi dengan PgBouncer sangat penting untuk mencegah kehabisan CPU dan memori yang disebabkan oleh jumlah koneksi pengguna yang tinggi.
- Ketersediaan dan keandalan:
- Ketersediaan tinggi dicapai melalui kuorum 3 node. Kegagalan satu node atau zona tidak akan mengganggu layanan.
- Stabilitas cluster: Mempertahankan kuorum yang andal memerlukan latensi jaringan yang rendah antar-node. Waktu round-trip (RTT) rata-rata idealnya harus di bawah 10 md untuk mencegah waktu tunggu pemilihan dan ketidakstabilan cluster.
- Pengelolaan operasional:
- Tugas rutin seperti patching versi minor dan upgrade utama tetap menjadi tanggung jawab tim operasi pelanggan.
- Output dari
stdoutVM akan otomatis diserap ke dalam platform pemantauan GDC dengan air gap. Panduan akan dipublikasikan di masa mendatang tentang cara mengintegrasikan pemantauan yang lebih mendetail untuk setiap komponen. - Strategi pencadangan yang kuat harus diterapkan menggunakan alat native database dan snapshot platform. Panduan mendetail untuk prosedur ini akan dipublikasikan secara terpisah.
Keputusan desain
Pilihan arsitektur untuk solusi ini memberikan jalur yang tangguh untuk deployment multi-zona.
Virtual machine melalui Kubernetes
Pendekatan berbasis VM dipilih untuk memberikan ketersediaan tinggi multi-zona. GDC tidak mendukung cluster Kubernetes yang mencakup beberapa zona fisik. Oleh karena itu, men-deploy VM khusus ke zona terpisah diperlukan untuk mencapai arsitektur lintas zona yang tangguh. Konfigurasi ini dapat bertahan dari kegagalan total satu zona infrastruktur.
Load balancing global berbasis platform
Arsitektur ini memanfaatkan Load Balancer L4 Global GDC, bukan proxy berbasis software di VM. Pendekatan ini memberikan beberapa keuntungan:
- Jangkauan global: Menyediakan IP virtual stabil yang dapat diakses di semua zona.
- Dikelola platform: VIP dikelola secara independen oleh bidang kontrol platform.
- Failover yang disederhanakan: Failover dikelola melalui pemeriksaan health check standar, bukan konfigurasi software lokal yang kompleks.
- Ketersediaan tinggi: Menghapus ketergantungan pada proxy lokal memastikan bahwa titik entri untuk traffic database tetap tangguh.
Asumsi dan batasan
Asumsi
- Lingkungan ini memiliki registry atau mekanisme lokal untuk mengimpor dependensi dan biner OS yang dipaketkan.
- Akses SSH berbasis kunci tersedia untuk semua VM target untuk otomatisasi berbasis Ansible.
- Project ini memiliki kuota yang cukup untuk penyediaan VM dan Load Balancer multi-zona.
Batasan
- Pemeliharaan manual: Patching sistem operasi dan upgrade versi PostgreSQL adalah tugas manual dan tidak diotomatiskan oleh solusi.
- Sensitivitas penyimpanan: Lapisan konsensus (etcd) sangat sensitif terhadap latensi disk. Pertentangan penyimpanan yang tinggi dan berkelanjutan dapat memengaruhi stabilitas lapisan konsensus.
- Stabilitas jaringan: Pengelola ketersediaan tinggi mengandalkan konektivitas jaringan yang konsisten dan berlatensi rendah antar-zona. Penundaan atau jitter jaringan dapat memengaruhi pengaturan waktu koordinasi cluster dan transisi peran.
Materi tambahan
- Repositori kode otomatisasi referensi: Kode Sumber Autobase di GitHub
- Implementasi referensi database PostgreSQL