


Cette architecture de référence fournit un framework conceptuel pour déployer et exploiter des bases de données MariaDB 12 gérées par le client et à disponibilité élevée sur Google Distributed Cloud (GDC) air-gapped. Il permet aux entreprises et aux clients en accès anticipé de gérer de manière fiable les charges de travail de base de données critiques à l'aide d'une configuration de machine virtuelle (VM) multizone robuste.
Comme GDC sous air gap n'est actuellement pas compatible avec les clusters Kubernetes étendus entre plusieurs zones, cette architecture repose strictement sur des VM dédiées déployées sur trois domaines de disponibilité pour assurer la continuité des opérations et résister à une défaillance complète de zone sans perte de données.
Fonctionnalités et capacités
- Résilience multizone : configuration à trois nœuds hautement résiliente déployée sur trois zones de disponibilité distinctes pour protéger contre les défaillances d'une seule zone d'infrastructure.
- Haute disponibilité et consensus automatisés : utilise Galera pour le clustering multimaster synchrone, ce qui permet la détection automatique des défaillances, le consensus des nœuds et la synchronisation globale des données sans scénarios de split-brain.
- Routage intelligent du trafic : les instances HAProxy colocalisées gèrent le regroupement des connexions et acheminent strictement le trafic, en dirigeant les opérations d'écriture (par exemple, le port 3306) vers un nœud principal actif et en équilibrant la charge des opérations de lecture (par exemple, le port 3307) sur les instances répliquées synchronisées.
- Équilibrage de charge global : s'intègre à l'équilibreur de charge L4 global GDC natif de la plate-forme pour fournir une adresse IP virtuelle (VIP) unique et stable aux applications clientes, en faisant abstraction de la topologie de nœud sous-jacente.
- Validation du basculement tenant compte de la base de données : utilise un script Python personnalisé léger ou une solution OSS telle que clustercheck (par exemple, exposé sur le port 9200) pour diffuser les vérifications d'état vers l'équilibreur de charge et HAProxy, ce qui garantit que le trafic n'est acheminé que vers des nœuds opérationnels et entièrement synchronisés.
Principes architecturaux
- Consensus synchrone basé sur la majorité : privilégie la cohérence stricte des données par rapport à la cohérence à terme. Galera applique un modèle basé sur un quorum qui nécessite un accord majoritaire, ce qui élimine le risque de perte de données ou de split-brain lors des partitions réseau.
- Séparation des préoccupations : dissocie la couche de réplication de base de données (Galera) de la couche de routage de connexion et de détection de basculement (HAProxy et service de vérification de l'état d'état Python).
- Optimisation de l'infrastructure : spécialement conçu pour les environnements air gap, en utilisant des VM robustes pour contourner les limites actuelles de la mise en réseau Kubernetes.
Architecture
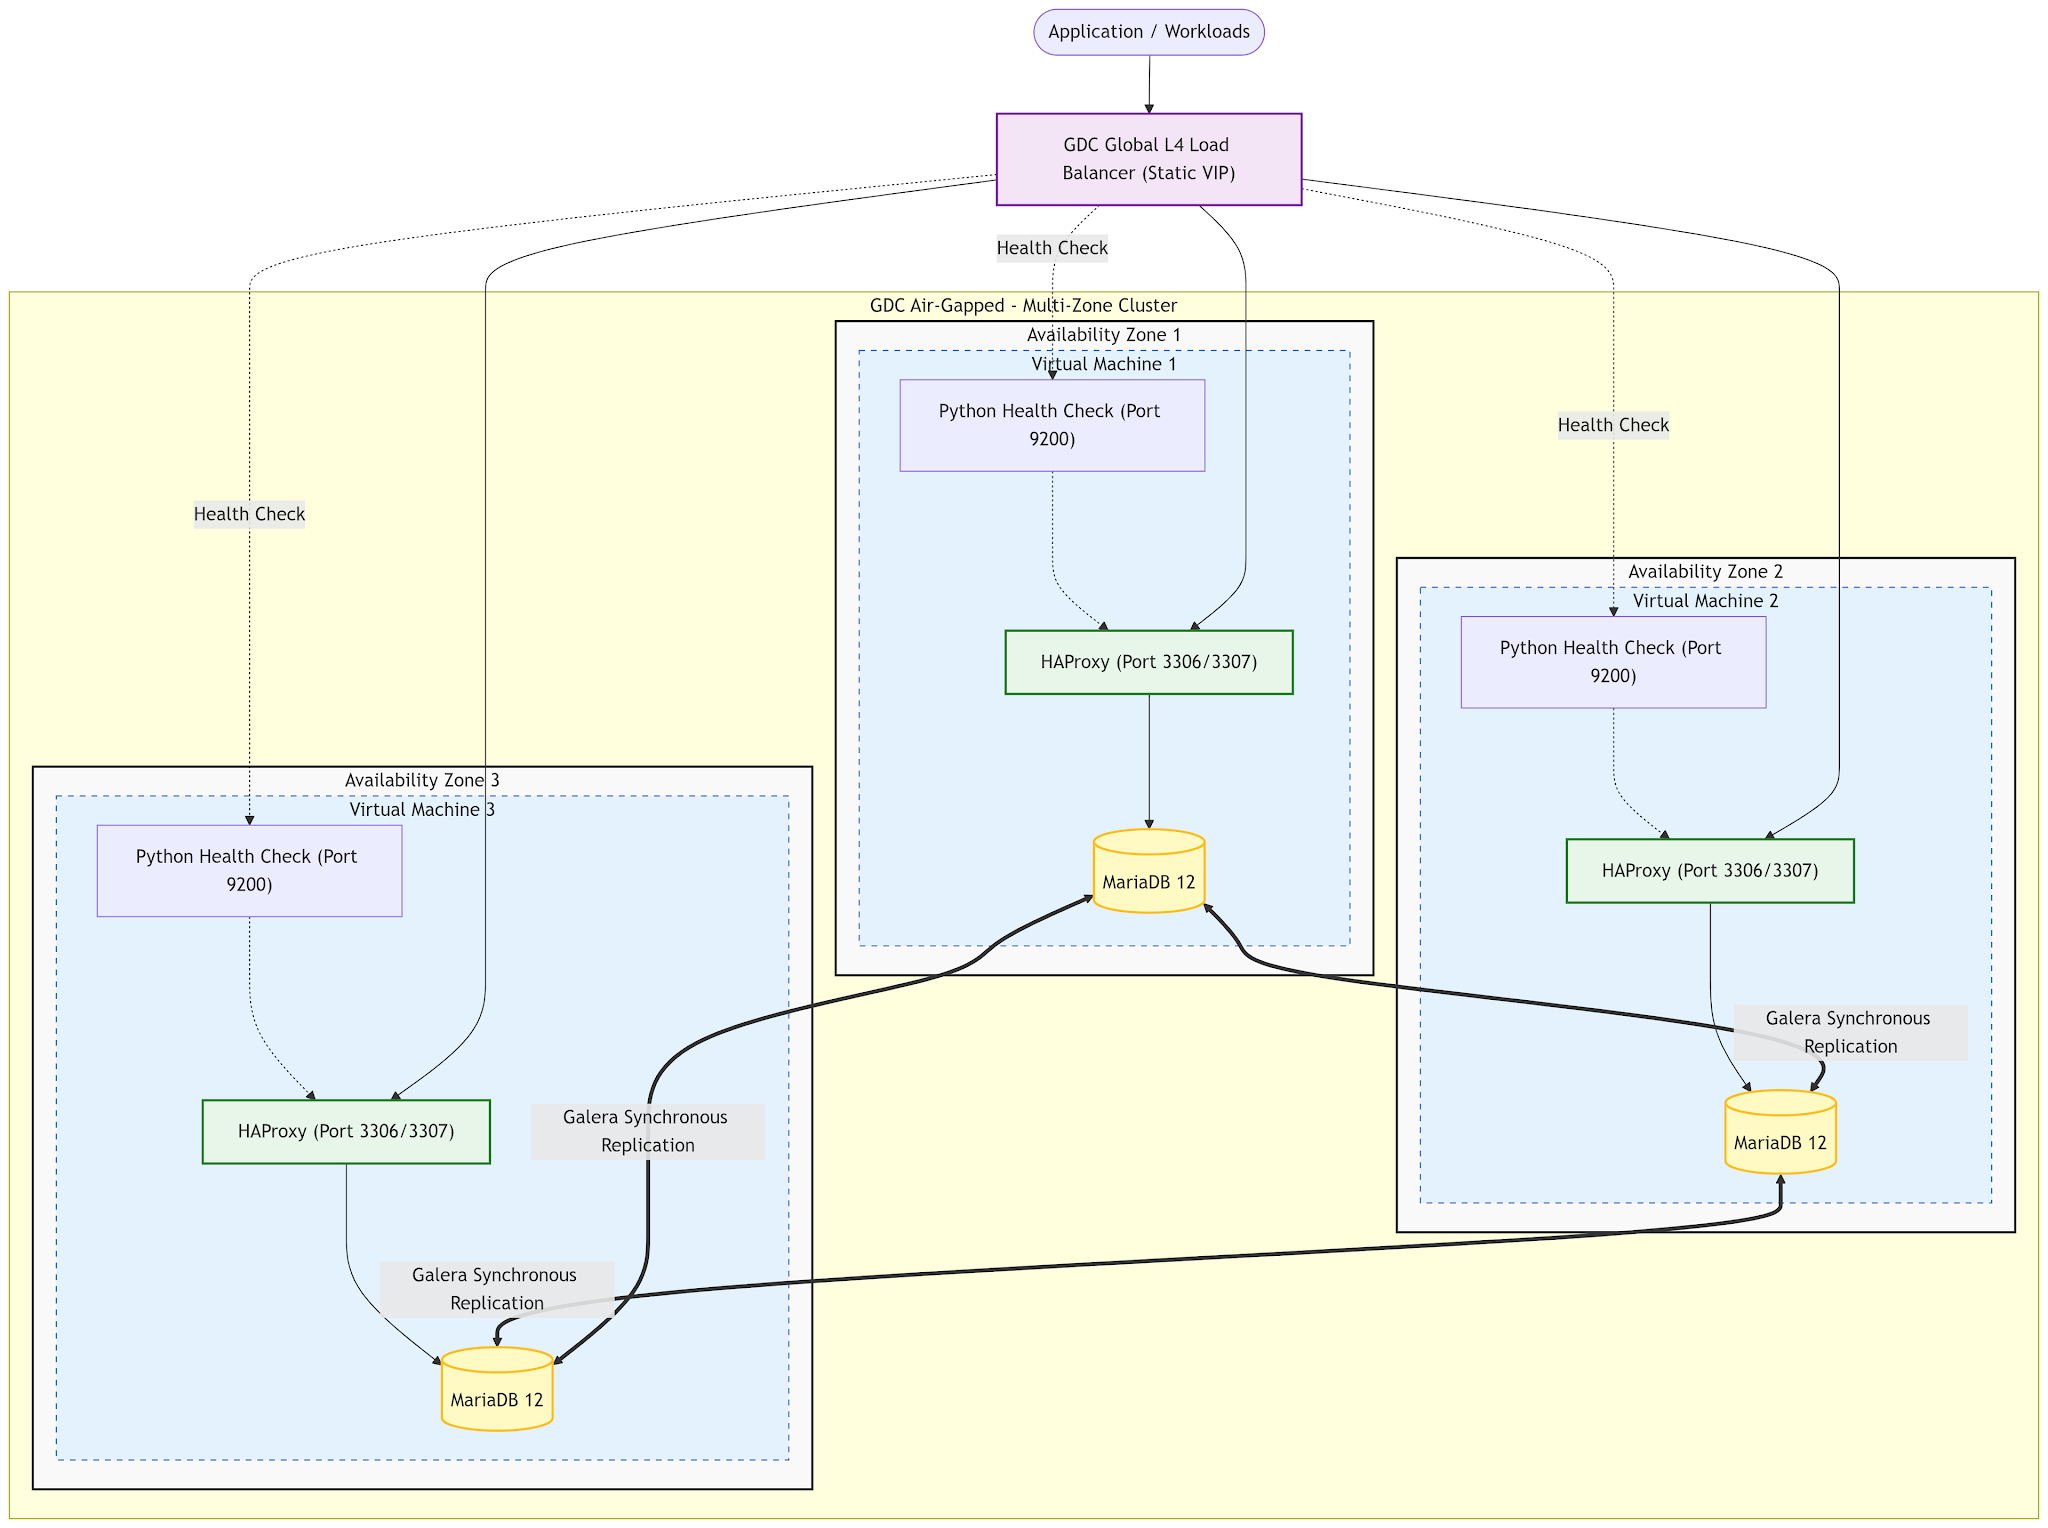
Concepts et technologies
Cette section détaille les composants fonctionnels et leurs responsabilités spécifiques au sein de l'architecture multizone.
Infrastructure et plate-forme
- Machines virtuelles (VM) : trois instances de calcul dédiées, chacune déployée dans une zone de disponibilité distincte pour former les limites du domaine de défaillance.
- Équilibreur de charge L4 mondial GDC : construction réseau gérée par la plate-forme qui expose une adresse IP virtuelle interne stable, évaluant automatiquement les vérifications d'état HTTP basées sur Python pour rediriger le trafic entrant.
Services et logique
- MariaDB 12 : moteur de base de données relationnelle de base.
- Plug-in Galera : framework de clustering responsable de la réplication synchrone multimaster et de la vérification du quorum des nœuds.
- HAProxy : agit en tant que routeur de trafic sur chaque VM. Configuré dans une topologie active/de sauvegarde pour les écritures afin d'éviter les interblocages, et en mode round-robin pour les lectures distribuées.
- Service de vérification d'état Python : service HTTP léger (encapsulé dans systemd) qui interroge en continu l'état de la base de données locale et signale son état de fonctionnement à HAProxy et à l'équilibreur de charge L4 via le port 9200.
Flux de données et interfaces
- Les applications envoient des requêtes de base de données à l'adresse IP virtuelle de l'équilibreur de charge L4 global.
- L'équilibreur de charge transmet la connexion à une instance HAProxy opérationnelle sur l'une des VM.
- En fonction du port demandé, HAProxy transfère le trafic de manière dynamique : le port 3306 cible strictement le nœud actif pour les écritures, tandis que le port 3307 effectue des cycles de lecture sur le cluster.
Considérations de conception
Éléments généraux à prendre en compte
- Compromis entre performances et cohérence : comme Galera est synchrone de manière native, chaque transaction doit être confirmée par les pairs du cluster. Les performances sont directement liées à la latence du réseau interzone dans l'environnement GDC.
- Gestion des ressources : le déploiement de HAProxy directement sur les VM de base de données optimise l'utilisation du matériel, mais nécessite un réglage minutieux des ressources pour éviter que la surcharge du pooling de connexions ne prive les processus MariaDB principaux de ressources.
Remarques concernant les vérifications d'état
Bien que cette solution utilise un script Python personnalisé pour sa simplicité et l'absence de dépendances externes, les clients peuvent choisir d'implémenter une vérification d'état OSS standard à l'aide de xinetd et clustercheck.
- Script Python personnalisé : exploite Python 3 et le module
http.serverpréinstallés, ce qui est idéal pour les environnements sous air gap, car aucun transfert de package supplémentaire n'est requis. Toutefois, le client doit gérer le code du script personnalisé. - Outils OSS (
xinetd/clustercheck) : transfère la charge de maintenance à la communauté Open Source, mais augmente la complexité de l'architecture et la gestion des dépendances lors de la préparation initiale du logiciel sous air gap.
Considérations sur les performances
Lorsque vous planifiez votre déploiement, tenez compte des facteurs concrets suivants pour optimiser les performances et la fiabilité :
- Dimensionnement du matériel : bien que les exigences varient selon la charge de travail, utilisez ces profils standards comme point de départ pour chaque VM :
- Développement/Démonstration de faisabilité : 2 vCPU, 8 Go de RAM (minimum pour un fonctionnement stable).
- Petite production : 4 vCPU, 16 Go de RAM. Adapté aux outils internes avec une simultanéité modérée.
- Production standard : 8 vCPU, 32 Go de RAM. La référence recommandée pour les applications critiques.
- Haut débit : plus de 16 vCPU, plus de 64 Go de RAM. Requis pour les charges de travail avec des ensembles de travail volumineux qui bénéficient d'une mise en cache étendue des données dans le pool de mémoire tampon InnoDB.
- Performances de stockage : un stockage hautes performances est essentiel pour la durabilité de la base de données et la stabilité du cluster. Les disques SSD sont vivement recommandés pour minimiser la latence d'écriture pendant la phase de commit de la réplication synchrone.
Pour des performances optimales, visez une latence d'écriture sur disque p99 inférieure à 10 ms afin de vous assurer que les journaux binaires Galera
gcacheou MySQL ne deviennent pas un goulot d'étranglement. - Latence du réseau et contrôle de flux : la latence entre les VM a un impact direct sur la vitesse de validation des transactions.
- Réplication synchrone : dans un cluster Galera ou Group Replication, chaque transaction d'écriture doit être confirmée par une majorité de nœuds. La latence interzone dans GDC sous air gap est généralement inférieure à 1 ms, ce qui est idéal pour limiter les frais d'écriture (généralement de 10 à 30 %).
- Contrôle de flux : une instabilité élevée du réseau ou un seul nœud "lent" peut déclencher le contrôle de flux Galera, ce qui suspend les écritures sur l'ensemble du cluster pour permettre au nœud lent de rattraper son retard.
- Rôle de HAProxy (ou du routeur MySQL) : un équilibreur de charge reste essentiel :
- Répartition du trafic : HAProxy s'assure que le trafic d'écriture est strictement dirigé vers un seul nœud actif (port 3306) pour éviter les blocages, tout en équilibrant les requêtes en lecture seule sur toutes les instances répliquées synchronisées (port 3307).
- Stabilité de la connexion : il fournit une couche d'abstraction qui évite aux applications d'avoir à gérer manuellement une logique de basculement complexe.
- Composants side-car : le service de vérification d'état Python personnalisé et l'équilibreur de charge sont légers, mais essentiels. Assurez-vous que les VM disposent d'une disponibilité constante du processeur. Dans les scénarios à charge élevée, le "vol" de processeur au niveau de l'hyperviseur peut retarder les réponses de vérification de l'état d'état, ce qui entraîne l'éviction prématurée d'un nœud opérationnel de la rotation par l'équilibreur de charge global.
Décision de conception
Les choix architecturaux effectués dans cette SRA répondent explicitement aux limites de GDC sous air gap et optimisent le débit.
- Machines virtuelles sur Kubernetes : GDC sous air gap n'est actuellement pas compatible avec les clusters Kubernetes qui s'étendent sur plusieurs zones physiques. Une approche basée sur les VM a été choisie, car le déploiement de VM dédiées dans des zones distinctes est la seule méthode viable pour obtenir une véritable haute disponibilité multizone et survivre à une défaillance totale de la zone.
- Galera par rapport à la configuration manuelle principale/secondaire (avec ProxySQL) : une architecture principale/secondaire traditionnelle associée à ProxySQL a été évaluée comme une alternative possible. Toutefois, la gestion de la logique de basculement manuel avec ProxySQL implique une complexité opérationnelle et de script importante. Galera a été sélectionné à la place, car sa nature synchrone native réduit considérablement la complexité du basculement et offre des performances nettement meilleures.
- Rejet d'Orchestrator : Orchestrator est considéré comme un gestionnaire de topologie standard pour le basculement automatique. Cependant, elle a été évaluée et finalement rejetée, car elle n'est compatible qu'avec MariaDB 10 et non avec les versions de MariaDB strictement supérieures à 11. Il était donc incompatible avec notre exigence de MariaDB 12.
- Équilibrage de charge global natif de la plate-forme : l'utilisation de l'équilibreur de charge L4 global GDC natif garantit que l'adresse IP virtuelle est contrôlée par le plan de contrôle GDC, ce qui permet de maintenir la résilience du point d'entrée et de simplifier la distribution du trafic entre les zones.
Hypothèses et limites
Hypothèses
- Disponibilité de l'infrastructure : les clients disposent d'un quota de projet suffisant pour provisionner des VM dédiées et correctement dimensionnées, ainsi que des équilibreurs de charge mondiaux répartis uniformément sur trois zones de disponibilité.
- Mise en réseau sécurisée : l'accès basé sur des clés et les règles de réseau de projet (PNP) appropriées sont établis pour permettre la synchronisation Galera au sein du cluster et l'interrogation des vérification de l'état.
Limites
- Kubernetes non compatible : les clients qui recherchent strictement des solutions conteneurisées/basées sur Kubernetes ne peuvent pas obtenir de haute disponibilité multizone tant que les clusters étendus ne sont pas entièrement compatibles avec la plate-forme.
- Mises à niveau manuelles requises : contrairement aux services gérés, cette solution place l'entière responsabilité des correctifs de routine au niveau de l'OS, des mises à niveau des versions mineures de la base de données et de la gestion des versions de Galera sur le client.
- Sensibilité à la latence du réseau : la réplication synchrone nécessite un réseau stable et de haute qualité. La gigue du réseau ou les pics de latence entre les zones sous air gap retarderont proportionnellement les opérations d'écriture sur le cluster MariaDB.
Autres ressources
- Implémentation de référence de la solution : Base de données MariaDB 12 multizone à haute disponibilité dans GDC sous air gap