


Esta arquitectura de referencia proporciona un marco conceptual para implementar y operar bases de datos de MariaDB 12 administradas por el cliente y con alta disponibilidad en Google Distributed Cloud (GDC) aislado. Permite que los clientes empresariales y de acceso anticipado mantengan de forma confiable las cargas de trabajo de bases de datos esenciales con una configuración de máquina virtual (VM) multizona sólida.
Debido a que GDC aislado actualmente no admite clústeres extendidos de Kubernetes entre zonas, esta arquitectura se basa estrictamente en VMs dedicadas implementadas en tres dominios de disponibilidad para garantizar operaciones continuas y resistir una falla de zona completa sin pérdida de datos.
Características y funciones
- Resiliencia multizona: Es una configuración de 3 nodos altamente resiliente que se implementa en tres zonas de disponibilidad distintas para proteger contra fallas de una sola zona de infraestructura.
- Alta disponibilidad y consenso automatizados: Usa Galera para la agrupación en clústeres síncrona de varios maestros, lo que proporciona detección automática de fallas, consenso de nodos y sincronización de datos global sin situaciones de cerebro dividido.
- Enrutamiento de tráfico inteligente: Las instancias de HAProxy ubicadas en el mismo lugar administran la agrupación de conexiones y enrutan el tráfico de forma estricta, lo que dirige las operaciones de escritura (p.ej., el puerto 3306) a un nodo principal activo y balancea las cargas de las operaciones de lectura (p.ej., el puerto 3307) en las réplicas sincronizadas.
- Balanceo de cargas global: Se integra en el balanceador de cargas L4 global de GDC nativo de la plataforma para proporcionar una IP virtual (VIP) única y estable para las aplicaciones cliente, lo que abstrae la topología de nodos subyacente.
- Validación de conmutación por error con reconocimiento de la base de datos: Utiliza una secuencia de comandos de Python personalizada y ligera o una solución de OSS como clustercheck (p.ej., expuesta en el puerto 9200) para entregar verificaciones de estado al balanceador de cargas y a HAProxy, lo que garantiza que el tráfico solo se enrute a nodos en buen estado y completamente sincronizados.
Principios de arquitectura
- Consenso síncrono basado en la mayoría: Prioriza la coherencia estricta de los datos por sobre la coherencia eventual. Galera aplica un modelo basado en quórum que requiere un acuerdo mayoritario, lo que elimina el riesgo de pérdida de datos o de cerebro dividido durante las particiones de red.
- Separación de problemas: Desvincula la capa de replicación de la base de datos (Galera) de la capa de enrutamiento de conexiones y detección de conmutación por error (HAProxy y el servicio de verificación de estado de Python).
- Optimización de la infraestructura: Se diseñó específicamente para entornos aislados, con VMs sólidas para omitir las limitaciones actuales de las herramientas de redes de Kubernetes.
Arquitectura
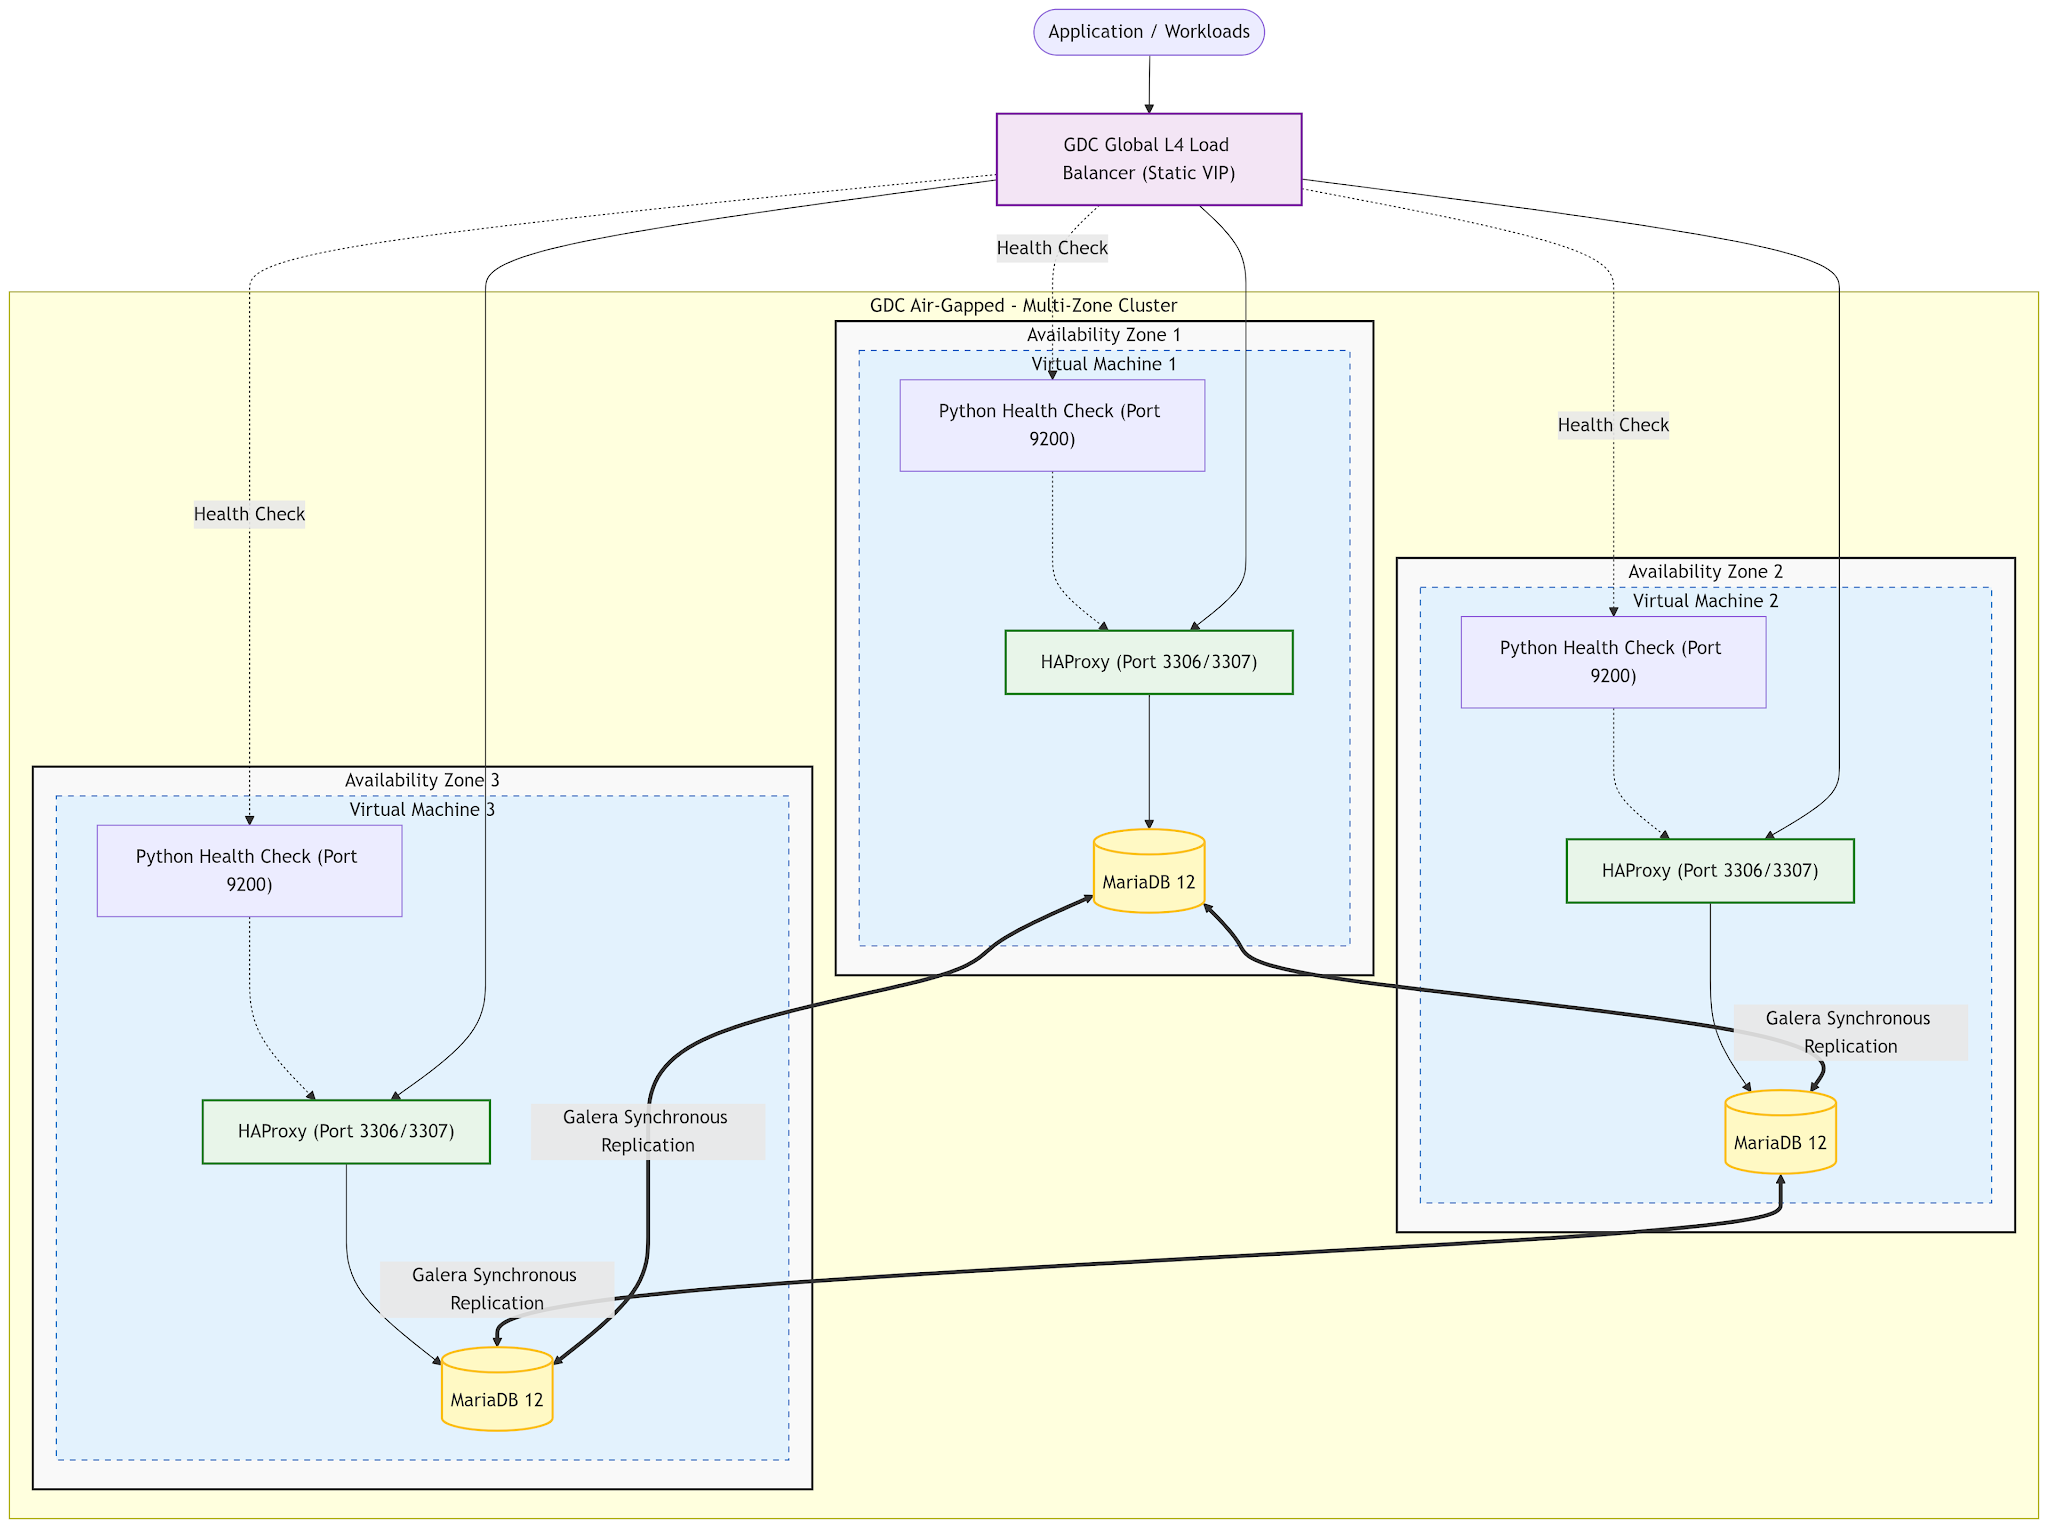
Conceptos y tecnologías
En esta sección, se detallan los componentes funcionales y sus responsabilidades específicas dentro de la arquitectura multizona.
Infraestructura y plataforma
- Máquinas virtuales (VM): Tres instancias de procesamiento dedicadas, cada una implementada en una zona de disponibilidad independiente para formar los límites del dominio con fallas.
- Balanceador de cargas de L4 global de GDC: Es una construcción de redes administrada por la plataforma que expone una VIP interna estable y evalúa automáticamente las verificaciones de estado de HTTP controladas por Python para redireccionar el tráfico entrante.
Servicios y lógica
- MariaDB 12: Es el motor de base de datos relacional principal.
- Complemento de Galera: Es el framework de agrupamiento en clústeres responsable de la replicación síncrona de varios maestros y de la verificación del quórum de nodos.
- HAProxy: Actúa como el router de tráfico en cada VM. Se configura en una topología activa/de copia de seguridad para las operaciones de escritura, con el objetivo de evitar interbloqueos, y en un sistema round-robin para las operaciones de lectura distribuidas.
- Servicio de verificación de estado de Python: Es un servicio HTTP ligero (unido en systemd) que sondea de forma continua el estado de la base de datos local y envía su estado de salud a HAProxy y al balanceador de cargas de L4 a través del puerto 9200.
Flujo de datos e interfaces
- Las aplicaciones envían solicitudes de base de datos a la VIP del balanceador de cargas de capa 4 global.
- El balanceador de cargas envía mediante proxy la conexión a una instancia de HAProxy en buen estado en una de las VMs.
- Según el puerto solicitado, HAProxy reenvía el tráfico de forma dinámica: el puerto 3306 se orienta estrictamente al nodo activo para las operaciones de escritura, mientras que el puerto 3307 alterna las operaciones de lectura en todo el clúster.
Consideraciones del diseño
Consideraciones generales
- Compensaciones entre rendimiento y coherencia: Debido a que Galera es síncrono de forma nativa, los pares del clúster deben confirmar cada transacción. El rendimiento se correlaciona directamente con la latencia de red entre zonas dentro del entorno de GDC.
- Administración de recursos: Implementar HAProxy directamente en las VMs de la base de datos optimiza el uso del hardware, pero requiere un ajuste cuidadoso de los recursos para evitar que la sobrecarga de la agrupación de conexiones agote los procesos principales de MariaDB.
Consideraciones sobre las verificaciones de estado
Si bien esta solución usa una secuencia de comandos de Python personalizada por su simplicidad y falta de
dependencias externas, los clientes pueden optar por implementar una verificación de estado de OSS estándar
con xinetd y clustercheck.
- Secuencia de comandos personalizada de Python: Aprovecha Python 3 y el módulo
http.serverpreinstalados, lo que es ideal para entornos aislados, ya que no requiere transferencias de paquetes adicionales. Sin embargo, el cliente debe mantener el código de la secuencia de comandos personalizada. - Herramientas de OSS (
xinetd/clustercheck): Transfiere la carga de mantenimiento a la comunidad de código abierto, pero aumenta la complejidad de la arquitectura y la administración de dependencias durante la preparación inicial del software aislado.
Consideraciones de rendimiento
Cuando planifiques tu implementación, ten en cuenta los siguientes factores concretos para optimizar el rendimiento y la confiabilidad:
- Dimensionamiento del hardware: Si bien los requisitos varían según la carga de trabajo, usa estos perfiles
estándar como punto de partida para cada VM:
- Desarrollo/prueba de concepto: 2 CPU virtuales, 8 GB de RAM (mínimo para un funcionamiento estable).
- Producción pequeña: 4 CPU virtuales, 16 GB de RAM. Adecuado para herramientas internas con simultaneidad moderada.
- Producción estándar: 8 CPU virtuales, 32 GB de RAM. Es el modelo de referencia recomendado para las aplicaciones esenciales.
- Alta capacidad de procesamiento: Más de 16 CPU virtuales, más de 64 GB de RAM. Es necesario para las cargas de trabajo con conjuntos de trabajo grandes que se benefician del almacenamiento en caché de datos extenso en el grupo de búferes de InnoDB.
- Rendimiento del almacenamiento: El almacenamiento de alto rendimiento es vital para la durabilidad de la base de datos y la estabilidad del clúster. Se recomienda usar discos SSD para
minimizar la latencia de escritura durante la fase de "confirmación" de la replicación síncrona.
Para obtener un rendimiento óptimo, intenta lograr una latencia de escritura en el disco p99 de menos de 10 ms
para asegurarte de que los registros binarios de Galera
gcacheo MySQL no se conviertan en un cuello de botella. - Latencia de red y control de flujo: La latencia entre las VMs afecta directamente
la velocidad de confirmación de las transacciones.
- Replicación síncrona: En un clúster de Galera o Group Replication, la mayoría de los nodos debe confirmar cada transacción de escritura. La latencia entre zonas en GDC aislado suele ser inferior a 1 ms, lo que es excelente para mantener la sobrecarga de escritura al mínimo (por lo general, entre un 10% y un 30%).
- Control de flujo: Una alta inestabilidad de la red o un solo nodo "lento" pueden activar el control de flujo de Galera, lo que pausa las escrituras en todo el clúster para permitir que el nodo rezagado se ponga al día.
- La función de HAProxy (o MySQL Router): Un balanceador de cargas sigue siendo
esencial:
- División del tráfico: HAProxy garantiza que el tráfico de escritura se dirija estrictamente a un solo nodo activo (puerto 3306) para evitar interbloqueos, mientras que balancea las consultas de solo lectura en todas las réplicas sincronizadas (puerto 3307).
- Estabilidad de la conexión: Proporciona una capa de abstracción que evita que las aplicaciones tengan que controlar la lógica de conmutación por error compleja de forma manual.
- Componentes de sidecar: El servicio de verificación de estado de Python personalizado y el balanceador de cargas son ligeros, pero fundamentales. Asegúrate de que las VMs tengan una disponibilidad de CPU coherente. En situaciones de carga alta, el "robo" de CPU en el nivel del hipervisor puede retrasar las respuestas de la verificación de estado, lo que hace que el balanceador de cargas global desaloje de forma prematura un nodo en buen estado de la rotación.
Decisión de diseño
Las opciones de arquitectura que se toman en esta SRA abordan de forma explícita las limitaciones de GDC aislado y optimizan la alta capacidad de procesamiento.
- Máquinas virtuales en Kubernetes: En la actualidad, GDC aislado no admite clústeres de Kubernetes que abarquen varias zonas físicas. Se eligió estrictamente un enfoque basado en VM porque implementar VMs dedicadas en zonas separadas es el único método viable para lograr una verdadera alta disponibilidad multizona y sobrevivir a una falla total de la zona.
- Galera frente a la configuración manual principal/secundaria (con ProxySQL): Se evaluó como una alternativa viable una arquitectura principal/secundaria tradicional vinculada con ProxySQL. Sin embargo, controlar la lógica de conmutación por error manual junto con ProxySQL implica una complejidad operativa y de secuencias de comandos significativa. En su lugar, se seleccionó Galera porque su naturaleza síncrona nativa reduce drásticamente la complejidad de la conmutación por error y proporciona un rendimiento significativamente mejor.
- Rechazo de Orchestrator: Orchestrator se considera un administrador de topología estándar de la industria para la conmutación por error automatizada. Sin embargo, se evaluó y, finalmente, se rechazó porque solo admite MariaDB 10 y no es compatible con las versiones de MariaDB estrictamente superiores a la 11. Esto lo hizo incompatible con nuestro requisito de MariaDB 12 de destino.
- Balanceo de cargas global nativo de la plataforma: Aprovechar el balanceador de cargas de L4 global nativo de GDC garantiza que la VIP esté controlada por el plano de control de GDC, lo que mantiene la resiliencia del punto de entrada y simplifica la entrega de tráfico entre zonas.
Suposiciones y limitaciones
Suposiciones
- Disponibilidad de la infraestructura: Los clientes tienen suficiente cuota de proyecto para aprovisionar VMs dedicadas y con el tamaño adecuado, y balanceadores de cargas globales distribuidos de manera uniforme en 3 zonas de disponibilidad.
- Herramientas de redes seguras: Se establecen el acceso basado en claves y las ProjectNetworkPolicies (PNP) adecuadas para permitir la sincronización de Galera dentro del clúster y el sondeo de verificación de estado.
Limitaciones
- Kubernetes no compatible: Los clientes que buscan estrictamente soluciones basadas en contenedores o Kubernetes no pueden lograr la alta disponibilidad multizona hasta que la plataforma admita por completo los clústeres extendidos.
- Se requieren actualizaciones manuales: A diferencia de los servicios administrados, esta solución coloca la responsabilidad de la aplicación de parches de rutina a nivel del SO, las actualizaciones de versiones secundarias de la base de datos y la administración de versiones de Galera por completo en el cliente.
- Sensibilidad a la latencia de red: La replicación síncrona exige una red estable y de alta calidad. La inestabilidad de la red o los picos de latencia entre las zonas aisladas retrasarán de forma proporcional las operaciones de escritura en el clúster de MariaDB.
Materiales adicionales
- Implementación de referencia de la solución: Base de datos de MariaDB 12 multizona y con alta disponibilidad en GDC aislado