


Visão geral
Esta arquitetura de referência define o design conceitual para implantar o Elastic Stack (Elasticsearch e Kibana) no Google Distributed Cloud (GDC) com isolamento físico e integrá-lo a um serviço de modelo de linguagem grande (LLM) para ativar os recursos de IA generativa da Elastic.
O Elastic Stack é uma plataforma de análise de pesquisa, observabilidade e segurança amplamente adotada. As versões recentes do Elastic adicionam recursos de IA generativa ao Kibana, incluindo o Agente de IA do Elastic, agentes personalizados criados com o Agent Builder e o Attack Discovery. Esses recursos usam um LLM para traduzir solicitações em linguagem natural em consultas do Elasticsearch, organizar chamadas de ferramentas em várias etapas e correlacionar alertas de segurança.
Essa arquitetura implanta o Elastic Stack usando o operador oficial do Elastic Cloud no Kubernetes (ECK) disponível no Marketplace do GDC com isolamento físico e conecta o Kibana a um endpoint de inferência de LLM hospedado dentro do limite do GDC, seja o serviço gerenciado do Gemini no GDC ou um servidor de inferência autogerenciado compatível com a OpenAI, como o Ollama ou o vLLM.
Recursos e funcionalidades
A solução oferece vários componentes funcionais principais para pesquisa, observabilidade e análise de segurança assistidas por IA:
- Gerenciamento do ciclo de vida baseado no Marketplace: instale o operador do ECK do
Marketplace do GDC com isolamento físico em um namespace de projeto
em um cluster compartilhado e deixe que ele automatize o provisionamento,
a configuração e a reconciliação dos recursos personalizados
ElasticsearcheKibana. - Investigação de dados em linguagem natural: use o agente de IA do Elastic para analisar dados do Elasticsearch em linguagem natural. O agente descobre índices e mapeamentos, gera e executa consultas ES|QL e sintetiza as descobertas sem exigir conhecimento prévio do esquema subjacente.
- Agentes personalizados e fluxos de trabalho automatizados: use o Agent Builder para criar agentes personalizados que combinam instruções personalizadas com ferramentas integradas, ferramentas ES|QL personalizadas e fluxos de trabalho do Kibana (por exemplo, abrindo automaticamente casos de segurança do Kibana com descobertas de investigação).
- Correlação de alertas de segurança orientada por IA: use a descoberta de ataques para analisar alertas abertos do Elastic Security, mapeá-los para o framework MITRE ATT&CK e correlacionar alertas, endereços IP e contas de usuário relacionados em cadeias de ataque.
- Compatibilidade com isolamento físico: as imagens de contêiner do operador do ECK, do Elasticsearch e do Kibana são extraídas do registro local do Harbor do GDC, e todo o tráfego de inferência de LLM permanece na rede interna do GDC.
- Back-ends de LLM conectáveis: conecte o Kibana ao Gemini gerenciado no
GDC ou a qualquer servidor de inferência autogerenciado que exponha
uma API
/v1/chat/completionscompatível com a OpenAI usando o conector da OpenAI do Kibana.
Princípios de arquitetura
- Modelo de responsabilidade compartilhada: o GDC fornece o cluster compartilhado, o pacote do Marketplace, o registro do Harbor e a rede. O cliente opera a implantação do Elastic Stack, gerencia o licenciamento do Elastic e é responsável pela seleção e operação do serviço de LLM autogerenciado (se usado).
- Soberania de dados: todos os dados operacionais e de segurança, comandos e respostas do modelo permanecem dentro do limite do GDC com isolamento físico. Nenhum tráfego é enviado para serviços de LLM públicos ou hospedados pela Elastic.
- Operações nativas da nuvem: usa o padrão de operador do Kubernetes para gerenciar cargas de trabalho com estado do Elastic de forma declarativa, garantindo implantações consistentes e repetíveis.
- Padronização de protocolo: depende da API de preenchimento de chat compatível com a OpenAI, que é amplamente aceita, com chamada de função nativa, desvinculando o Kibana de qualquer mecanismo de inferência ou fornecedor de modelo específico.
Arquitetura
A arquitetura consiste em uma implantação do Elastic Stack gerenciada pelo operador do ECK em um namespace de projeto em um cluster de usuário compartilhado do GDC. O Kibana se comunica pela rede interna do GDC com um endpoint de inferência de LLM.
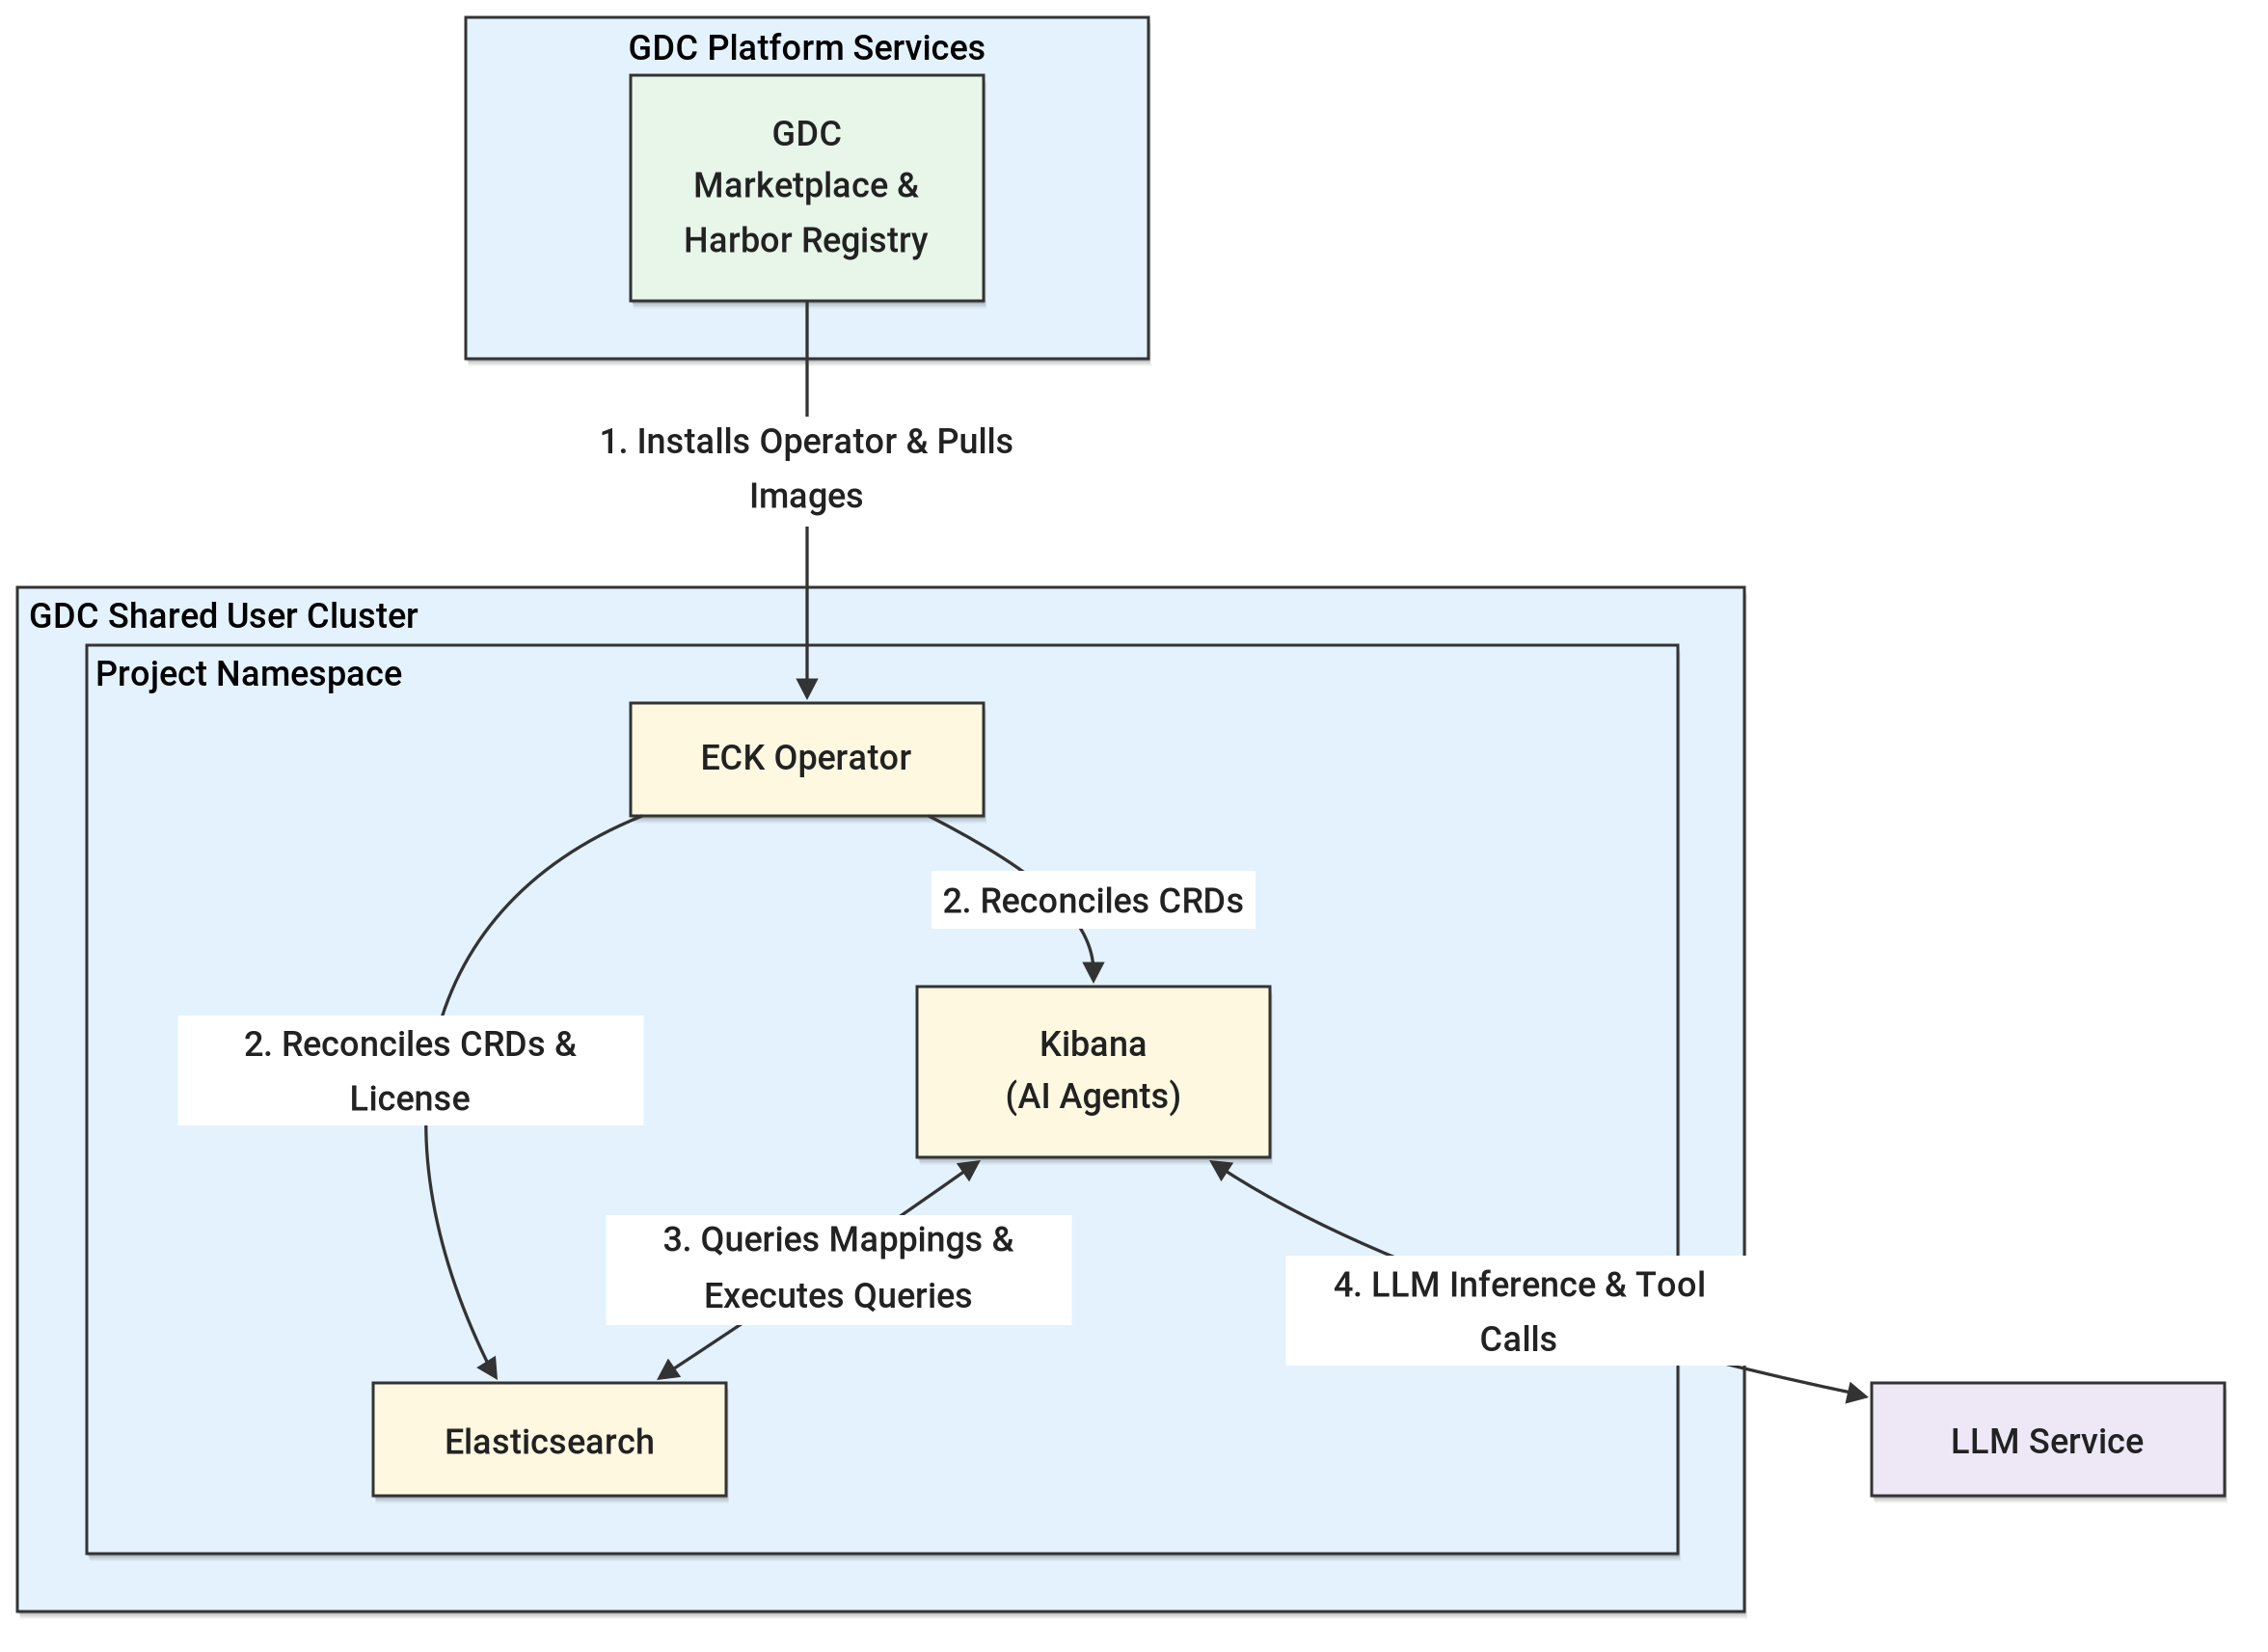
Os principais componentes dessa arquitetura incluem:
- Cluster compartilhado do GDC: um cluster compartilhado do Kubernetes com escopo de organização anexado a vários projetos, que hospeda pacotes de software e cargas de trabalho de aplicativos do GDC Marketplace.
- Projeto do GDC: o namespace do projeto no cluster compartilhado que isola o operador do ECK, o cluster do Elasticsearch, a instância do Kibana e os Secrets e as NetworkPolicies do Kubernetes associados.
- Operador do Elastic Cloud no Kubernetes (ECK): instalado do
GDC Marketplace no namespace do projeto, o
operador gerencia os recursos personalizados
ElasticsearcheKibanae reconcilia a licença do Elastic necessária para recursos de IA generativa e conectores de LLM externos. - Elasticsearch: armazena e indexa dados operacionais e de segurança, além de executar consultas de pesquisa e ES|QL geradas pelos recursos de IA e agentes do Kibana.
- Kibana: hospeda os recursos de IA generativa da Elastic (Elastic AI Agent, Agent Builder e Attack Discovery) e gerencia os conectores de ação de LLM que orquestram a chamada de ferramenta em várias etapas entre o usuário, o Elasticsearch e o serviço de LLM.
- Serviço de LLM: um serviço de LLM gerenciado (como o Gemini no GDC) ou um servidor de inferência autogerenciado (como Ollama ou vLLM) que fornece recursos de preenchimento de chat e chamada de ferramentas para o Kibana pela rede interna do GDC.
Conceitos e tecnologias
Nesta seção, detalhamos os componentes funcionais, as responsabilidades deles e como eles se comunicam no sistema.
Infraestrutura e plataforma
- Cluster compartilhado do GDC: o ambiente de computação principal em que o operador do ECK, o Elasticsearch e os pods do Kibana residem em um namespace de projeto.
- GDC Marketplace: o catálogo usado para instalar e fazer upgrade do pacote do Marketplace do Elastic, que registra as CustomResourceDefinitions do Elastic e implanta o StatefulSet
elastic-operator. - Registro do Harbor: a fonte de verdade local e segura para o operador do ECK, o Elasticsearch e as imagens de contêiner do Kibana no ambiente com isolamento físico.
- Armazenamento permanente: os PersistentVolumeClaims provisionados pelo
volumeClaimTemplatesdo Elasticsearch fornecem armazenamento em blocos durável para dados do Elasticsearch. - Rede do GDC: os serviços LoadBalancer expõem o Elasticsearch (porta
9200) e o Kibana (porta5601), enquanto os recursosNetworkPolicydo Kubernetes eProjectNetworkPolicyglobais controlam o tráfego de entrada e entre projetos, incluindo a conectividade com o serviço de LLM.
Serviços e lógica
- Operador do ECK: o controlador que observa os recursos personalizados
ElasticsearcheKibanae os reconcilia em StatefulSets, implantações, serviços e secrets. Olicense-controllerdele reconcilia continuamente a licença do cluster com os Secrets de licença no namespace do operador. - Agente de IA do Elastic: o agente de conversação padrão no Kibana. Ele usa
ferramentas integradas do Agent Builder (
platform.core.list_indices,platform.core.get_index_mapping,platform.core.searcheplatform.core.execute_esql) para descobrir dados, gerar ES|QL e resumir resultados. - Agent Builder: o framework para criar agentes personalizados que combinam
instruções de sistema personalizadas com ferramentas integradas e definidas pelo usuário
(
esql,index_search,workflowemcp). - Fluxos de trabalho do Kibana: automações declarativas definidas por YAML (por exemplo,
cases.createCase) que podem ser registradas como ferramentas do Agent Builder para permitir que os agentes realizem ações, como abrir casos de segurança do Kibana. - Descoberta de ataques: um recurso de segurança do Elastic Security que envia um contexto de alerta anonimizado ao LLM para correlacionar alertas do índice
.alerts-security.alerts-defaultem cadeias de ataque mapeadas para táticas do MITRE ATT&CK. - Serviço de LLM: fornece conclusões de chat ajustadas por instruções com suporte nativo a chamadas de ferramentas. O modelo precisa gerar de forma confiável invocações de ferramentas válidas, JSON estruturado e consultas ES|QL.
Fluxo de dados e interfaces
- API de preenchimento de chat compatível com a OpenAI (
/v1/chat/completions): a interface entre o conector da OpenAI do Kibana (.gen-ai) e o serviço de LLM, configurada com o provedor Outro (serviço compatível com a OpenAI), chamada de função nativa ativada e streaming de eventos enviados pelo servidor. - APIs REST e ES|QL do Elasticsearch: usadas pelo Kibana e pelos agentes dele para inspecionar mapeamentos, executar pesquisas e executar agregações ES|QL.
- APIs REST do Kibana: usadas para o gerenciamento programático de conectores
(
/api/actions), agentes e ferramentas (/api/agent_builder), fluxos de trabalho (/api/workflows), regras de detecção (/api/detection_engine) e descoberta de ataques (/api/attack_discovery). - HTTPS com autenticação integrada: os endpoints do Elasticsearch e do Kibana são disponibilizados por TLS usando certificados gerados pelo ECK, com credenciais armazenadas em Secrets do Kubernetes gerenciados pelo ECK.
Considerações
- Escalabilidade e desempenho:
- As solicitações de recursos, os limites, as contagens de nós e os tamanhos de armazenamento do Elasticsearch e do Kibana precisam ser ajustados de acordo com os padrões de avaliação para corresponder aos volumes de dados de produção e à simultaneidade de consultas.
- O conector da OpenAI do Kibana aplica um tempo limite padrão de 60 segundos por turno de streaming. O serviço de LLM precisa ser executado na aceleração de GPU com otimizações como o Flash Attention para manter cada turno dentro desse limite.
- Uma única vez do agente pode acionar subchamadas de LLM aninhadas. O servidor de inferência
precisa manter vários slots de cache de KV paralelos (por exemplo,
OLLAMA_NUM_PARALLEL=2) para evitar que as subchamadas removam o contexto armazenado em cache da conversa principal.
- Requisitos do modelo de LLM:
- O modelo precisa ser ajustado por instruções com suporte nativo a chamadas de função. A chamada de função nativa precisa estar ativada no conector do Kibana, já que a chamada de função simulada baseada em comandos é menos confiável para chamadas de ferramentas aninhadas.
- É altamente recomendável uma janela de contexto de pelo menos 128.000 tokens, já que investigações em várias etapas que combinam definições de ferramentas, esquemas de índice, documentação do ES|QL e resultados da pesquisa podem exceder 70.000 tokens.
- Um limite de pelo menos 8.192 tokens de saída e uma penalidade de repetição
suave são recomendados para modelos com capacidade de raciocínio, porque o Kibana
trata um motivo de conclusão
lengthcomo um erro fatal e usa decodificação gananciosa. - A Descoberta de Ataques requer um modelo de classe 30B ou maior (como
gemma4:31b) para sintetizar de forma confiável saídas estruturadas com vários alertas.
- Segurança e conformidade:
- Todos os comandos, dados recuperados e respostas do modelo permanecem na rede interna do GDC.
- As políticas de rede precisam ser reforçadas, saindo de configurações de avaliação permissivas para restringir o acesso de entrada ao Elasticsearch e ao Kibana a clientes autorizados e limitar a saída ao endpoint de serviço do LLM.
- O acesso ao Kibana e ao Elasticsearch precisa ser controlado por controles de acesso baseados em papéis do Elastic, em vez do superusuário
elastic.
- Gerenciamento de recursos e licenciamento:
- Os recursos de IA generativa e os conectores de LLM externos do Elastic exigem uma licença Enterprise (ou um teste Enterprise ativo de 30 dias), que precisa ser provisionada por um Secret de licença do ECK para persistir nos ciclos de reconciliação do operador.
- Disponibilidade e confiabilidade:
- As implantações Production precisam usar vários nós do Elasticsearch com fragmentos de réplica e várias instâncias do Kibana para evitar pontos únicos de falha.
- A disponibilidade dos recursos de IA depende da disponibilidade e da latência do serviço de LLM.
- Gerenciamento operacional:
- O cliente é responsável por fazer upgrade do pacote do Elastic Marketplace e das versões do Elastic Stack, gerenciar licenças e fazer backup dos dados do Elasticsearch.
- Quando um serviço de LLM autogerenciado é usado, o cliente é responsável pela implantação, pelo planejamento de capacidade da GPU, pelas atualizações do modelo e pelo ajuste.
Decisão de design
As principais escolhas de arquitetura para essa solução se concentram em ativar os recursos de IA generativa da Elastic dentro das restrições do ambiente com isolamento físico.
Operador de ECK do Marketplace do GDC
O operador do ECK é instalado pelo Marketplace do GDC com isolamento físico, em vez de ser implantado manualmente. O pacote do Marketplace vem pré-configurado para extrair imagens de contêiner do registro local do Harbor, registra as CustomResourceDefinitions necessárias e se integra aos papéis do IAM no nível do projeto do GDC. Isso reduz o esforço de espelhamento de imagens e mantém a implantação alinhada ao ciclo de vida do software do GDC.
Implantação de cluster compartilhado
A solução implanta o Elastic Stack em um namespace de projeto em um cluster compartilhado do GDC. Isso permite que os clientes consumam o software do Marketplace com outras cargas de trabalho do projeto sem provisionar e operar um cluster dedicado, enquanto o namespace do projeto fornece isolamento de recursos, Secrets e políticas de rede.
Opções de serviço de LLM
O Gemini gerenciado no GDC é a opção preferida,
quando disponível, porque remove o fardo operacional de hospedar a infraestrutura de
inferência. Onde ele não estiver disponível ou onde os clientes precisarem de um modelo aberto específico, o Kibana poderá se conectar a qualquer servidor de inferência autogerenciado que exponha um endpoint /v1/chat/completions compatível com a OpenAI. A padronização nessa API
mantém a configuração do Elastic independente do mecanismo de inferência (como
Ollama ou vLLM).
Chamada de função nativa
A chamada de função nativa está ativada no conector do Kibana para que a formatação da chamada de ferramenta
seja delegada ao protocolo OpenAI tools do servidor de inferência.
A chamada de função simulada padrão baseada em comandos do Kibana é menos confiável durante
chamadas de ferramentas aninhadas e pode falhar com erros de análise.
Reconciliação de licenças gerenciadas pelo ECK
A licença Enterprise (ou de teste) é declarada como um Secret de licença do ECK, em vez
de ser ativada diretamente pela API de licença do Elasticsearch. Como o ECK
reconcilia continuamente a licença do cluster, as licenças aplicadas fora do ECK são
revertidas para basic no próximo ciclo de reconciliação.
Suposições e limitações
Suposições
- Um cluster compartilhado do GDC e um projeto anexado estão disponíveis, com capacidade de computação e armazenamento permanente suficiente para o operador ECK, o Elasticsearch e o Kibana.
- O pacote do Elastic Marketplace e as imagens de contêiner correspondentes do Elasticsearch e do Kibana estão disponíveis no Marketplace do GDC com isolamento físico e no registro local do Harbor.
- Os usuários têm os papéis de projeto necessários (
namespace-admin,project-viewer,marketplace-editoreproject-networkpolicy-admin). - Um serviço de LLM (Gemini gerenciado no GDC ou um servidor de inferência autogerenciado compatível com a OpenAI) é implantado e pode ser acessado pelo pod do Kibana na rede interna do GDC.
- Uma licença do Elastic Enterprise está disponível ou o teste de 30 dias do Enterprise é usado para avaliação.
Limitações
- Serviço de LLM fora do escopo: a implantação e a operação de um serviço de LLM autogerenciado, incluindo a infraestrutura de GPU, não são abordadas por essa arquitetura.
- Sem serviços de IA hospedados pela Elastic: os LLMs gerenciados pela Elastic e outros serviços de IA da Elastic hospedados na nuvem não estão disponíveis no ambiente com isolamento físico.
- Qualidade dependente do modelo: a acurácia e a confiabilidade dos resultados do Agente de IA, do Agent Builder e do Attack Discovery dependem dos recursos do modelo selecionado e da configuração de ambiente de execução dele.
- Padrões de nível de avaliação: a implementação de referência usa um cluster do Elasticsearch de nó único, certificados autoassinados e políticas de rede permissivas, que precisam ser reforçadas para uso em produção.
- Especificidade da versão: a solução foi validada com o Elastic v9.4.0, o Elastic Kubernetes Operator v3.4.0 e o GDC v1.16.2. Outras versões podem exigir ajustes.
Outros recursos
Implementação de referência de solução (SRI): Como implantar os recursos de IA generativa do Elastic Stack no GDC com isolamento físico