


Panoramica
Questa architettura di riferimento definisce il design concettuale per il deployment di Elastic Stack (Elasticsearch e Kibana) su Google Distributed Cloud (GDC) con air gap e la sua integrazione con un servizio di modello linguistico di grandi dimensioni (LLM) per abilitare le funzionalità di AI generativa di Elastic.
Elastic Stack è una piattaforma di ricerca, osservabilità e analisi della sicurezza ampiamente adottata. Le recenti release di Elastic aggiungono funzionalità di AI generativa a Kibana, tra cui Elastic AI Agent, agenti personalizzati creati con Agent Builder e Attack Discovery. Queste funzionalità si basano su un LLM per tradurre le richieste in linguaggio naturale in query Elasticsearch, orchestrare le chiamate agli strumenti in più passaggi e correlare gli avvisi di sicurezza.
Questa architettura esegue il deployment di Elastic Stack utilizzando l'operatore Elastic Cloud on Kubernetes (ECK) ufficiale disponibile nel Marketplace GDC con air gap e connette Kibana a un endpoint di inferenza LLM ospitato all'interno del confine GDC, ovvero il servizio Gemini gestito su GDC o un server di inferenza compatibile con OpenAI autogestito come Ollama o vLLM.
Caratteristiche e funzionalità
La soluzione fornisce diversi componenti funzionali di base per la ricerca, l'osservabilità e l'analisi della sicurezza assistite dall'AI:
- Gestione del ciclo di vita basata su Marketplace: installa l'operatore ECK dal Marketplace GDC con air gap in uno spazio dei nomi del progetto su un cluster condiviso e lascia che automatizzi il provisioning, la configurazione e la riconciliazione delle risorse personalizzate
ElasticsearcheKibana. - Indagine sui dati in linguaggio naturale: utilizza l'agente AI di Elastic per esplorare i dati di Elasticsearch in linguaggio naturale. L'agente rileva indici e mappature, genera ed esegue query ES|QL e sintetizza i risultati senza richiedere una conoscenza preliminare dello schema sottostante.
- Agenti personalizzati e workflow automatizzati: utilizza Agent Builder per creare agenti personalizzati che combinano istruzioni personalizzate con strumenti integrati, strumenti ES|QL personalizzati e workflow di Kibana (ad esempio, l'apertura automatica di casi di Kibana Security con i risultati delle indagini).
- Correlazione degli avvisi di sicurezza basata sull'AI: utilizza Attack Discovery per analizzare gli avvisi di Elastic Security aperti, mapparli al framework MITRE ATT&CK e correlare gli avvisi, gli indirizzi IP e gli account utente correlati in catene di attacco.
- Compatibilità con ambienti air-gapped: le immagini container dell'operatore ECK, di Elasticsearch e di Kibana vengono estratte dal registry Harbor GDC locale e tutto il traffico di inferenza LLM rimane sulla rete GDC interna.
- Backend LLM collegabili: connetti Kibana a Gemini gestito su GDC o a qualsiasi server di inferenza autogestito che espone un'API
/v1/chat/completionscompatibile con OpenAI tramite il connettore OpenAI di Kibana.
Principi di architettura
- Modello di responsabilità condivisa: GDC fornisce il cluster condiviso, il pacchetto Marketplace, il registry Harbor e il networking. Il cliente gestisce il deployment di Elastic Stack, le licenze Elastic e la selezione e il funzionamento del servizio LLM autogestito (se utilizzato).
- Sovranità dei dati: tutti i dati operativi e di sicurezza, i prompt e le risposte del modello rimangono all'interno del confine di GDC con air gap. Nessun traffico viene inviato ai servizi LLM pubblici o ospitati su Elastic.
- Operazioni cloud-native: utilizza il pattern dell'operatore Kubernetes per gestire i workload Elastic stateful in modo dichiarativo, garantendo deployment coerenti e ripetibili.
- Standardizzazione del protocollo: si basa sull'API di completamento della chat compatibile con OpenAI ampiamente supportata con chiamata di funzione nativa, disaccoppiando Kibana da qualsiasi motore di inferenza o fornitore di modelli specifico.
Architettura
L'architettura è costituita da un deployment di Elastic Stack gestito dall'operatore ECK all'interno di uno spazio dei nomi del progetto su un cluster utente condiviso di GDC. Kibana comunica sulla rete GDC interna con un endpoint di inferenza LLM.
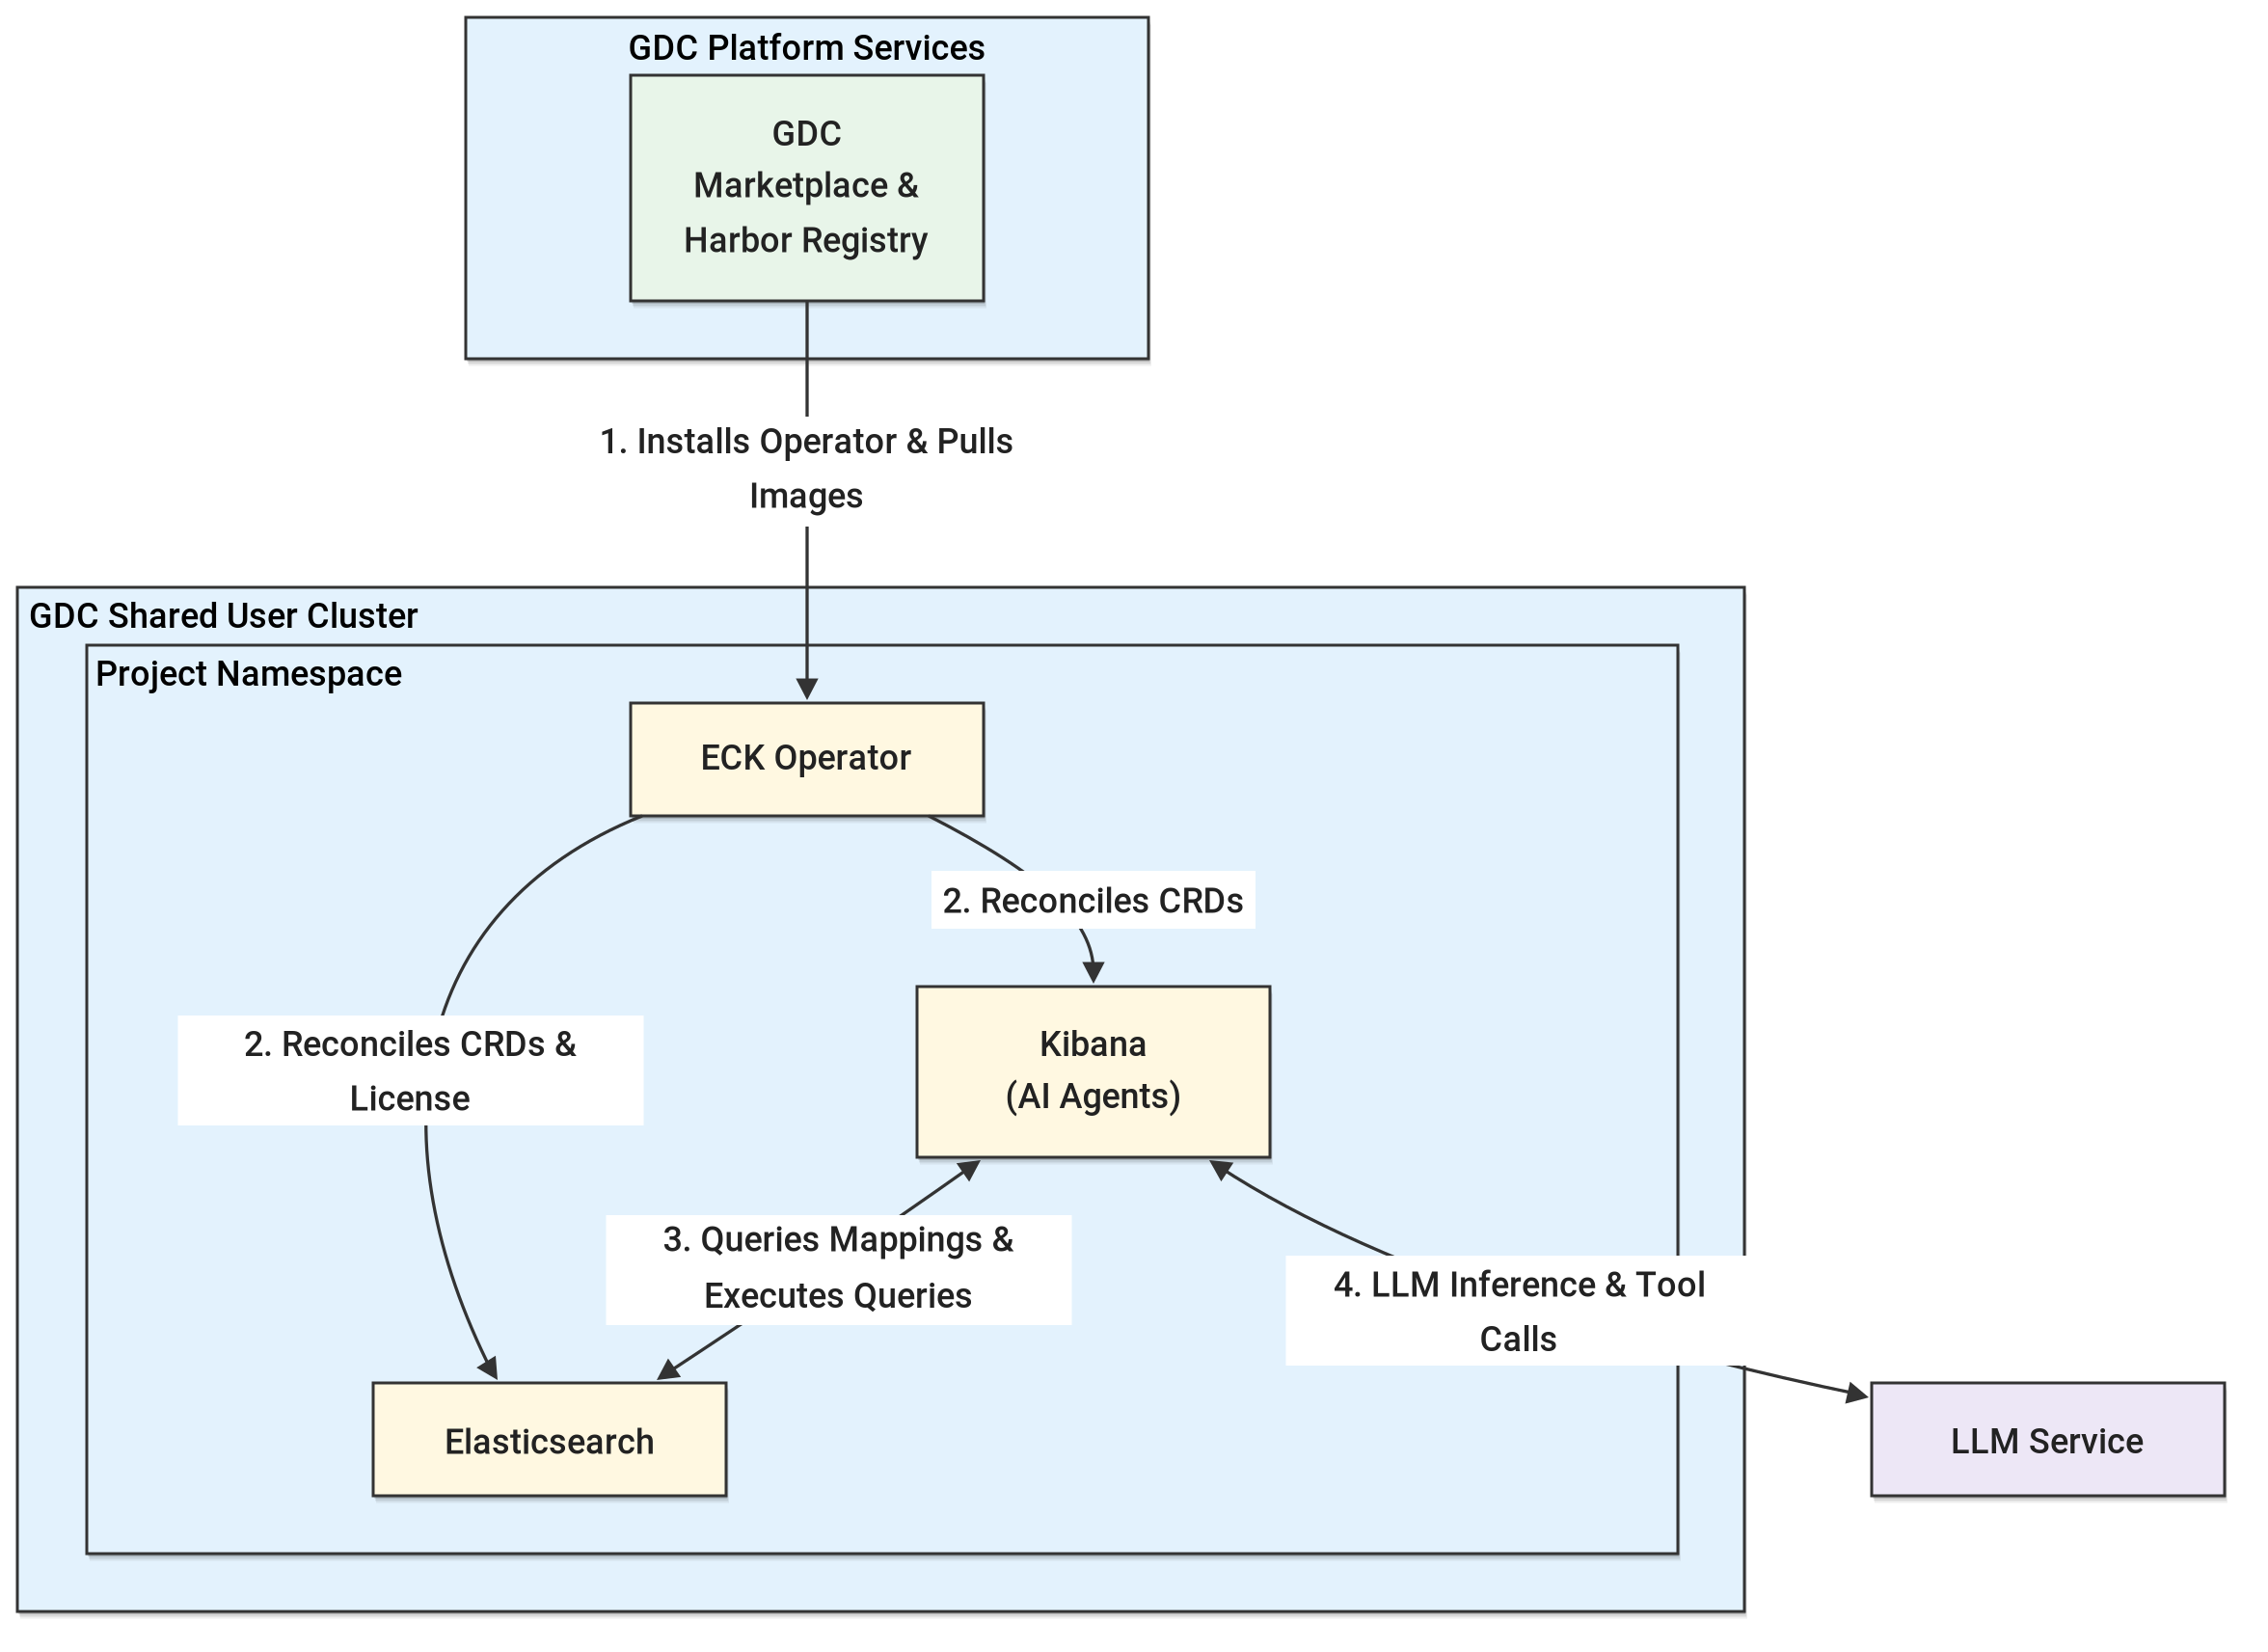
I componenti chiave di questa architettura includono:
- Cluster GDC condiviso: un cluster Kubernetes condiviso con ambito a livello di organizzazione collegato a più progetti, che ospita pacchetti software e workload delle applicazioni di Marketplace GDC.
- Progetto GDC: lo spazio dei nomi del progetto sul cluster condiviso che isola l'operatore ECK, il cluster Elasticsearch, l'istanza Kibana e i Secret e le NetworkPolicy di Kubernetes associati.
- Operatore Elastic Cloud on Kubernetes (ECK): installato dal Marketplace GDC nello spazio dei nomi del progetto, l'operatore gestisce le risorse personalizzate
ElasticsearcheKibanae riconcilia la licenza Elastic richiesta per le funzionalità di AI generativa e i connettori LLM esterni. - Elasticsearch: archivia e indicizza i dati operativi e di sicurezza ed esegue query di ricerca ed ES|QL generate dagli agenti e dalle funzionalità di AI di Kibana.
- Kibana: ospita le funzionalità di AI generativa di Elastic (Elastic AI Agent, Agent Builder e Attack Discovery) e gestisce i connettori di azioni LLM che orchestrano la chiamata allo strumento in più passaggi tra l'utente, Elasticsearch e il servizio LLM.
- Servizio LLM: un servizio LLM gestito (come Gemini su GDC) o un server di inferenza autogestito (come Ollama o vLLM) che fornisce funzionalità di completamento della chat e chiamata degli strumenti a Kibana sulla rete GDC interna.
Concetti e tecnologie
Questa sezione descrive in dettaglio i componenti funzionali, le loro responsabilità e il modo in cui comunicano all'interno del sistema.
Infrastruttura e piattaforma
- Cluster condiviso GDC: l'ambiente di computing principale in cui risiedono l'operatore ECK, Elasticsearch e i pod Kibana all'interno di uno spazio dei nomi del progetto.
- GDC Marketplace: il catalogo utilizzato per installare ed eseguire l'upgrade del pacchetto Marketplace di Elastic, che registra le CustomResourceDefinition di Elastic ed esegue il deployment dello StatefulSet
elastic-operator. - Harbor Registry: la fonte di verità locale e sicura per l'operatore ECK, Elasticsearch e le immagini container di Kibana nell'ambiente air-gapped.
- Archiviazione permanente: gli oggetti PersistentVolumeClaim di cui è stato eseguito il provisioning tramite l'oggetto Elasticsearch
volumeClaimTemplatesforniscono un'archiviazione a blocchi durevole per i dati Elasticsearch. - Networking GDC: i servizi LoadBalancer espongono Elasticsearch (porta
9200) e Kibana (porta5601), mentre le risorse KubernetesNetworkPolicyeProjectNetworkPolicyglobali regolano il traffico in entrata e tra progetti, inclusa la connettività al servizio LLM.
Servizi e logica
- Operatore ECK: il controller che monitora le risorse personalizzate
ElasticsearcheKibanae le riconcilia in StatefulSet, deployment, servizi e secret. Il suolicense-controllerriconcilia continuamente la licenza del cluster con i secret della licenza nello spazio dei nomi dell'operatore. - Elastic AI Agent: l'agente AI conversazionale predefinito in Kibana. Utilizza gli strumenti integrati di Agent Builder (
platform.core.list_indices,platform.core.get_index_mapping,platform.core.searcheplatform.core.execute_esql) per scoprire i dati, generare ES|QL e riepilogare i risultati. - Agent Builder: il framework per la creazione di agenti personalizzati che combinano istruzioni di sistema personalizzate con strumenti integrati e strumenti definiti dall'utente (
esql,index_search,workflowemcp). - Workflow di Kibana: automazioni dichiarative definite in YAML (ad esempio,
cases.createCase) che possono essere registrate come strumenti di Agent Builder per consentire agli agenti di intraprendere azioni come l'apertura di casi di sicurezza di Kibana. - Attack Discovery: una funzionalità di sicurezza di Elastic Security che invia il contesto degli avvisi anonimizzato all'LLM per correlare gli avvisi dall'indice
.alerts-security.alerts-defaultin catene di attacchi mappate alle tattiche MITRE ATT&CK. - Servizio LLM: fornisce completamenti di chat ottimizzati per le istruzioni con supporto nativo per le chiamate agli strumenti. Il modello deve generare in modo affidabile chiamate di strumenti valide, JSON strutturato e query ES|QL.
Flusso di dati e interfacce
- API di completamento della chat compatibile con OpenAI (
/v1/chat/completions): l'interfaccia tra il connettore OpenAI (.gen-ai) di Kibana e il servizio LLM, configurata con il provider Altro (servizio compatibile con OpenAI), la chiamata di funzione nativa abilitata e lo streaming di Server-Sent Events. - API REST Elasticsearch ed ES|QL: utilizzate da Kibana e dai suoi agenti per ispezionare le mappature, eseguire ricerche ed eseguire aggregazioni ES|QL.
- API REST Kibana: utilizzate per la gestione programmatica dei connettori (
/api/actions), degli agenti e degli strumenti (/api/agent_builder), dei workflow (/api/workflows), delle regole di rilevamento (/api/detection_engine) e di Attack Discovery (/api/attack_discovery). - HTTPS con autenticazione integrata: gli endpoint Elasticsearch e Kibana vengono forniti tramite TLS utilizzando certificati generati da ECK, con credenziali archiviate in Secret Kubernetes gestiti da ECK.
Considerazioni
- Scalabilità e prestazioni:
- Le richieste di risorse, i limiti, i conteggi dei nodi e le dimensioni dello spazio di archiviazione di Elasticsearch e Kibana devono essere modificati rispetto ai valori predefiniti di valutazione per corrispondere ai volumi di dati di produzione e alla concorrenza delle query.
- Il connettore OpenAI di Kibana applica un timeout predefinito di 60 secondi per ogni turno di streaming. Il servizio LLM deve essere eseguito sull'accelerazione GPU con ottimizzazioni come Flash Attention per mantenere ogni turno entro questo limite.
- Un singolo turno dell'agente può attivare chiamate secondarie LLM nidificate. Il server di inferenza deve mantenere più slot di cache KV paralleli (ad esempio,
OLLAMA_NUM_PARALLEL=2) per evitare che le chiamate secondarie eliminino il contesto memorizzato nella cache della conversazione principale.
- Requisiti del modello LLM:
- Il modello deve essere ottimizzato per le istruzioni con supporto nativo delle chiamate di funzione. La chiamata di funzione nativa deve essere abilitata sul connettore Kibana, poiché la chiamata di funzione simulata basata su prompt è meno affidabile per le chiamate allo strumento nidificate.
- Si consiglia vivamente una finestra contestuale di almeno 128.000 token, poiché le indagini in più fasi che combinano definizioni di strumenti, schemi di indice, documentazione ES|QL e risultati di ricerca possono superare i 70.000 token.
- Per i modelli con capacità di ragionamento,è consigliato un limite di token di output di almeno 8192 token e una penalità di ripetizione moderata, perché Kibana tratta un motivo di completamento
lengthcome un errore irreversibile e utilizza la decodifica greedy. - Attack Discovery richiede un modello di classe 30B o superiore (come
gemma4:31b) per sintetizzare in modo affidabile output strutturati con più avvisi.
- Sicurezza e conformità:
- Tutti i prompt, i dati recuperati e le risposte del modello rimangono nella rete GDC interna.
- Le policy di rete devono essere rafforzate rispetto alle impostazioni di valutazione permissive per limitare l'accesso in entrata a Elasticsearch e Kibana ai client autorizzati e per limitare il traffico in uscita verso l'endpoint di servizio LLM.
- L'accesso a Kibana ed Elasticsearch deve essere regolato tramite i controlli degli accessi basati su ruoli di Elastic anziché tramite il super utente
elastic.
- Gestione delle risorse e licenze:
- Le funzionalità di AI generativa e i connettori LLM esterni di Elastic richiedono una licenza Enterprise (o una prova Enterprise di 30 giorni attiva), di cui è necessario eseguire il provisioning tramite un secret della licenza ECK per persistere nei cicli di riconciliazione dell'operatore.
- Disponibilità e affidabilità:
- I deployment di produzione devono utilizzare più nodi Elasticsearch con shard di replica e più istanze Kibana per evitare single point of failure.
- La disponibilità delle funzionalità di AI dipende dalla disponibilità e dalla latenza del servizio LLM.
- Gestione operativa:
- Il cliente è responsabile dell'upgrade del pacchetto Marketplace di Elastic e delle versioni di Elastic Stack, della gestione delle licenze e del backup dei dati di Elasticsearch.
- Quando viene utilizzato un servizio LLM autogestito, il cliente è responsabile del deployment, della pianificazione della capacità della GPU, degli aggiornamenti del modello e dell'ottimizzazione.
Decisione di progettazione
Le principali scelte architettoniche per questa soluzione si concentrano sull'abilitazione delle funzionalità di AI generativa di Elastic entro i vincoli dell'ambiente air-gapped.
Operatore ECK dal Marketplace GDC
L'operatore ECK viene installato dal Marketplace GDC con air gap anziché essere distribuito manualmente. Il pacchetto Marketplace è preconfigurato per estrarre le immagini container dal registry Harbor locale, registra le CustomResourceDefinition richieste e si integra con i ruoli IAM a livello di progetto GDC. In questo modo si riduce l'impegno per il mirroring delle immagini e il deployment rimane allineato al ciclo di vita del software GDC.
Deployment di cluster condivisi
La soluzione esegue il deployment di Elastic Stack in uno spazio dei nomi del progetto su un cluster condiviso GDC. In questo modo, i clienti possono utilizzare il software del Marketplace insieme ad altri workload del progetto senza eseguire il provisioning e la gestione di un cluster dedicato, mentre lo spazio dei nomi del progetto fornisce l'isolamento di risorse, secret e policy di rete.
Opzioni del servizio LLM
Gemini gestito su GDC è l'opzione preferita, se disponibile, in quanto elimina l'onere operativo di ospitare l'infrastruttura di inferenza. Se non è disponibile o se i clienti richiedono un modello aperto specifico, Kibana può connettersi a qualsiasi server di inferenza autogestito che espone un endpoint /v1/chat/completions compatibile con OpenAI. La standardizzazione su questa API mantiene la configurazione di Elastic indipendente dal motore di inferenza (come Ollama o vLLM).
Chiamata di funzione nativa
La chiamata di funzione nativa è abilitata sul connettore Kibana in modo che la formattazione della chiamata allo strumento venga delegata al protocollo OpenAI tools del server di inferenza.
La chiamata di funzione simulata basata su prompt predefinita di Kibana è meno affidabile durante le chiamate allo strumento nidificate e può non riuscire con errori di analisi.
Riconciliazione delle licenze gestite da ECK
La licenza Enterprise (o di prova) viene dichiarata come secret della licenza ECK anziché essere attivata direttamente tramite l'API per le licenze Elasticsearch. Poiché ECK riconcilia continuamente la licenza del cluster, le licenze applicate al di fuori di ECK vengono ripristinate a basic nel ciclo di riconciliazione successivo.
Ipotesi e limitazioni
Ipotesi
- Sono disponibili un cluster condiviso GDC e un progetto collegato, con capacità di calcolo e archiviazione permanente sufficiente per l'operatore ECK, Elasticsearch e Kibana.
- Il pacchetto Marketplace di Elastic e le immagini container Elasticsearch e Kibana corrispondenti sono disponibili nel Marketplace GDC con air gap e nel registry Harbor locale.
- Gli utenti dispongono dei ruoli di progetto richiesti (
namespace-admin,project-viewer,marketplace-editoreproject-networkpolicy-admin). - È stato eseguito il deployment di un servizio LLM (Gemini gestito su GDC o un server di inferenza compatibile con OpenAI autogestito) raggiungibile dal pod Kibana tramite la rete GDC interna.
- È disponibile una licenza Elastic Enterprise o viene utilizzata la prova di 30 giorni di Enterprise per la valutazione.
Limitazioni
- Servizio LLM fuori ambito: il deployment e il funzionamento di un servizio LLM autogestito, inclusa l'infrastruttura GPU, non sono coperti da questa architettura.
- Nessun servizio AI ospitato da Elastic: gli LLM gestiti da Elastic e altri servizi AI di Elastic ospitati nel cloud non sono disponibili nell'ambiente air-gapped.
- Qualità dipendente dal modello: l'accuratezza e l'affidabilità dei risultati di agente AI, Agent Builder e Attack Discovery dipendono dalle funzionalità del modello selezionato e dalla sua configurazione di runtime.
- Impostazioni predefinite di livello di valutazione: l'implementazione di riferimento utilizza un cluster Elasticsearch a nodo singolo, certificati autofirmati e policy di rete permissive, che devono essere rafforzate per l'utilizzo in produzione.
- Specificità della versione: la soluzione è stata convalidata con Elastic v9.4.0, Elastic Kubernetes Operator v3.4.0 e GDC v1.16.2. Altre versioni potrebbero richiedere modifiche.
Materiali aggiuntivi
Implementazione di riferimento della soluzione (SRI): Deployment delle funzionalità di AI generativa di Elastic Stack su GDC con air gap