


Présentation
Cette architecture de référence définit la conception conceptuelle pour déployer la suite Elastic (Elasticsearch et Kibana) sur Google Distributed Cloud (GDC) avec isolation physique et l'intégrer à un service de grand modèle de langage (LLM) pour activer les fonctionnalités d'IA générative d'Elastic.
Elastic Stack est une plate-forme d'analyse de recherche, d'observabilité et de sécurité largement adoptée. Les versions récentes d'Elastic ajoutent des fonctionnalités d'IA générative à Kibana, y compris l'agent IA Elastic, des agents personnalisés créés avec Agent Builder et Attack Discovery. Ces fonctionnalités s'appuient sur un LLM pour traduire les requêtes en langage naturel en requêtes Elasticsearch, orchestrer les appels d'outils en plusieurs étapes et corréler les alertes de sécurité.
Cette architecture déploie Elastic Stack à l'aide de l'opérateur Elastic Cloud sur Kubernetes (ECK) officiel disponible sur la place de marché GDC sous air gap, et connecte Kibana à un point de terminaison d'inférence LLM hébergé dans la limite GDC, soit le service Gemini géré sur GDC, soit un serveur d'inférence autogéré compatible avec OpenAI, tel qu'Ollama ou vLLM.
Fonctionnalités et capacités
La solution fournit plusieurs composants fonctionnels de base pour la recherche, l'observabilité et l'analyse de sécurité assistées par l'IA :
- Gestion du cycle de vie basée sur Marketplace : installez l'opérateur ECK depuis la place de marché GDC sous air gap dans un espace de noms de projet sur un cluster partagé, et laissez-le automatiser le provisionnement, la configuration et le rapprochement des ressources personnalisées
ElasticsearchetKibana. - Investigation des données en langage naturel : utilisez l'agent IA Elastic pour explorer les données Elasticsearch en langage naturel. L'agent découvre les index et les mappages, génère et exécute des requêtes ES|QL, et synthétise les résultats sans nécessiter de connaissances préalables du schéma sous-jacent.
- Agents personnalisés et workflows automatisés : utilisez Agent Builder pour créer des agents spécialisés qui combinent des instructions personnalisées avec des outils intégrés, des outils ES|QL personnalisés et des workflows Kibana (par exemple, pour ouvrir automatiquement des cas de sécurité Kibana avec les résultats d'investigation).
- Corrélation des alertes de sécurité basée sur l'IA : utilisez Attack Discovery pour analyser les alertes Elastic Security ouvertes, les mapper au framework MITRE ATT&CK et corréler les alertes, les adresses IP et les comptes utilisateur associés dans des chaînes d'attaque.
- Compatibilité avec les environnements air gap : les images de conteneur de l'opérateur ECK, d'Elasticsearch et de Kibana sont extraites du registre Harbor GDC local, et tout le trafic d'inférence LLM reste sur le réseau GDC interne.
- Backends LLM pluggables : connectez Kibana à Gemini géré sur GDC ou à n'importe quel serveur d'inférence autogéré exposant une API
/v1/chat/completionscompatible avec OpenAI via le connecteur OpenAI de Kibana.
Principes architecturaux
- Modèle de responsabilité partagée : GDC fournit le cluster partagé, le package de place de marché, le registre Harbor et la mise en réseau. Le client exploite le déploiement Elastic Stack, gère les licences Elastic et est responsable de la sélection et de l'exploitation du service LLM autogéré (le cas échéant).
- Souveraineté des données : toutes les données opérationnelles et de sécurité, les requêtes et les réponses du modèle restent dans la limite de l'environnement GDC sous air gap. Aucun trafic n'est envoyé aux services LLM publics ou hébergés par Elastic.
- Opérations cloud natives : utilise le modèle d'opérateur Kubernetes pour gérer les charges de travail Elastic avec état de manière déclarative, ce qui garantit des déploiements cohérents et reproductibles.
- Standardisation des protocoles : s'appuie sur l'API de complétion de chat compatible avec OpenAI, largement compatible, avec appel de fonction natif, ce qui dissocie Kibana de tout moteur d'inférence ou fournisseur de modèle spécifique.
Architecture
L'architecture se compose d'un déploiement Elastic Stack géré par l'opérateur ECK dans un espace de noms de projet sur un cluster d'utilisateur partagé GDC. Kibana communique sur le réseau GDC interne avec un point de terminaison d'inférence LLM.
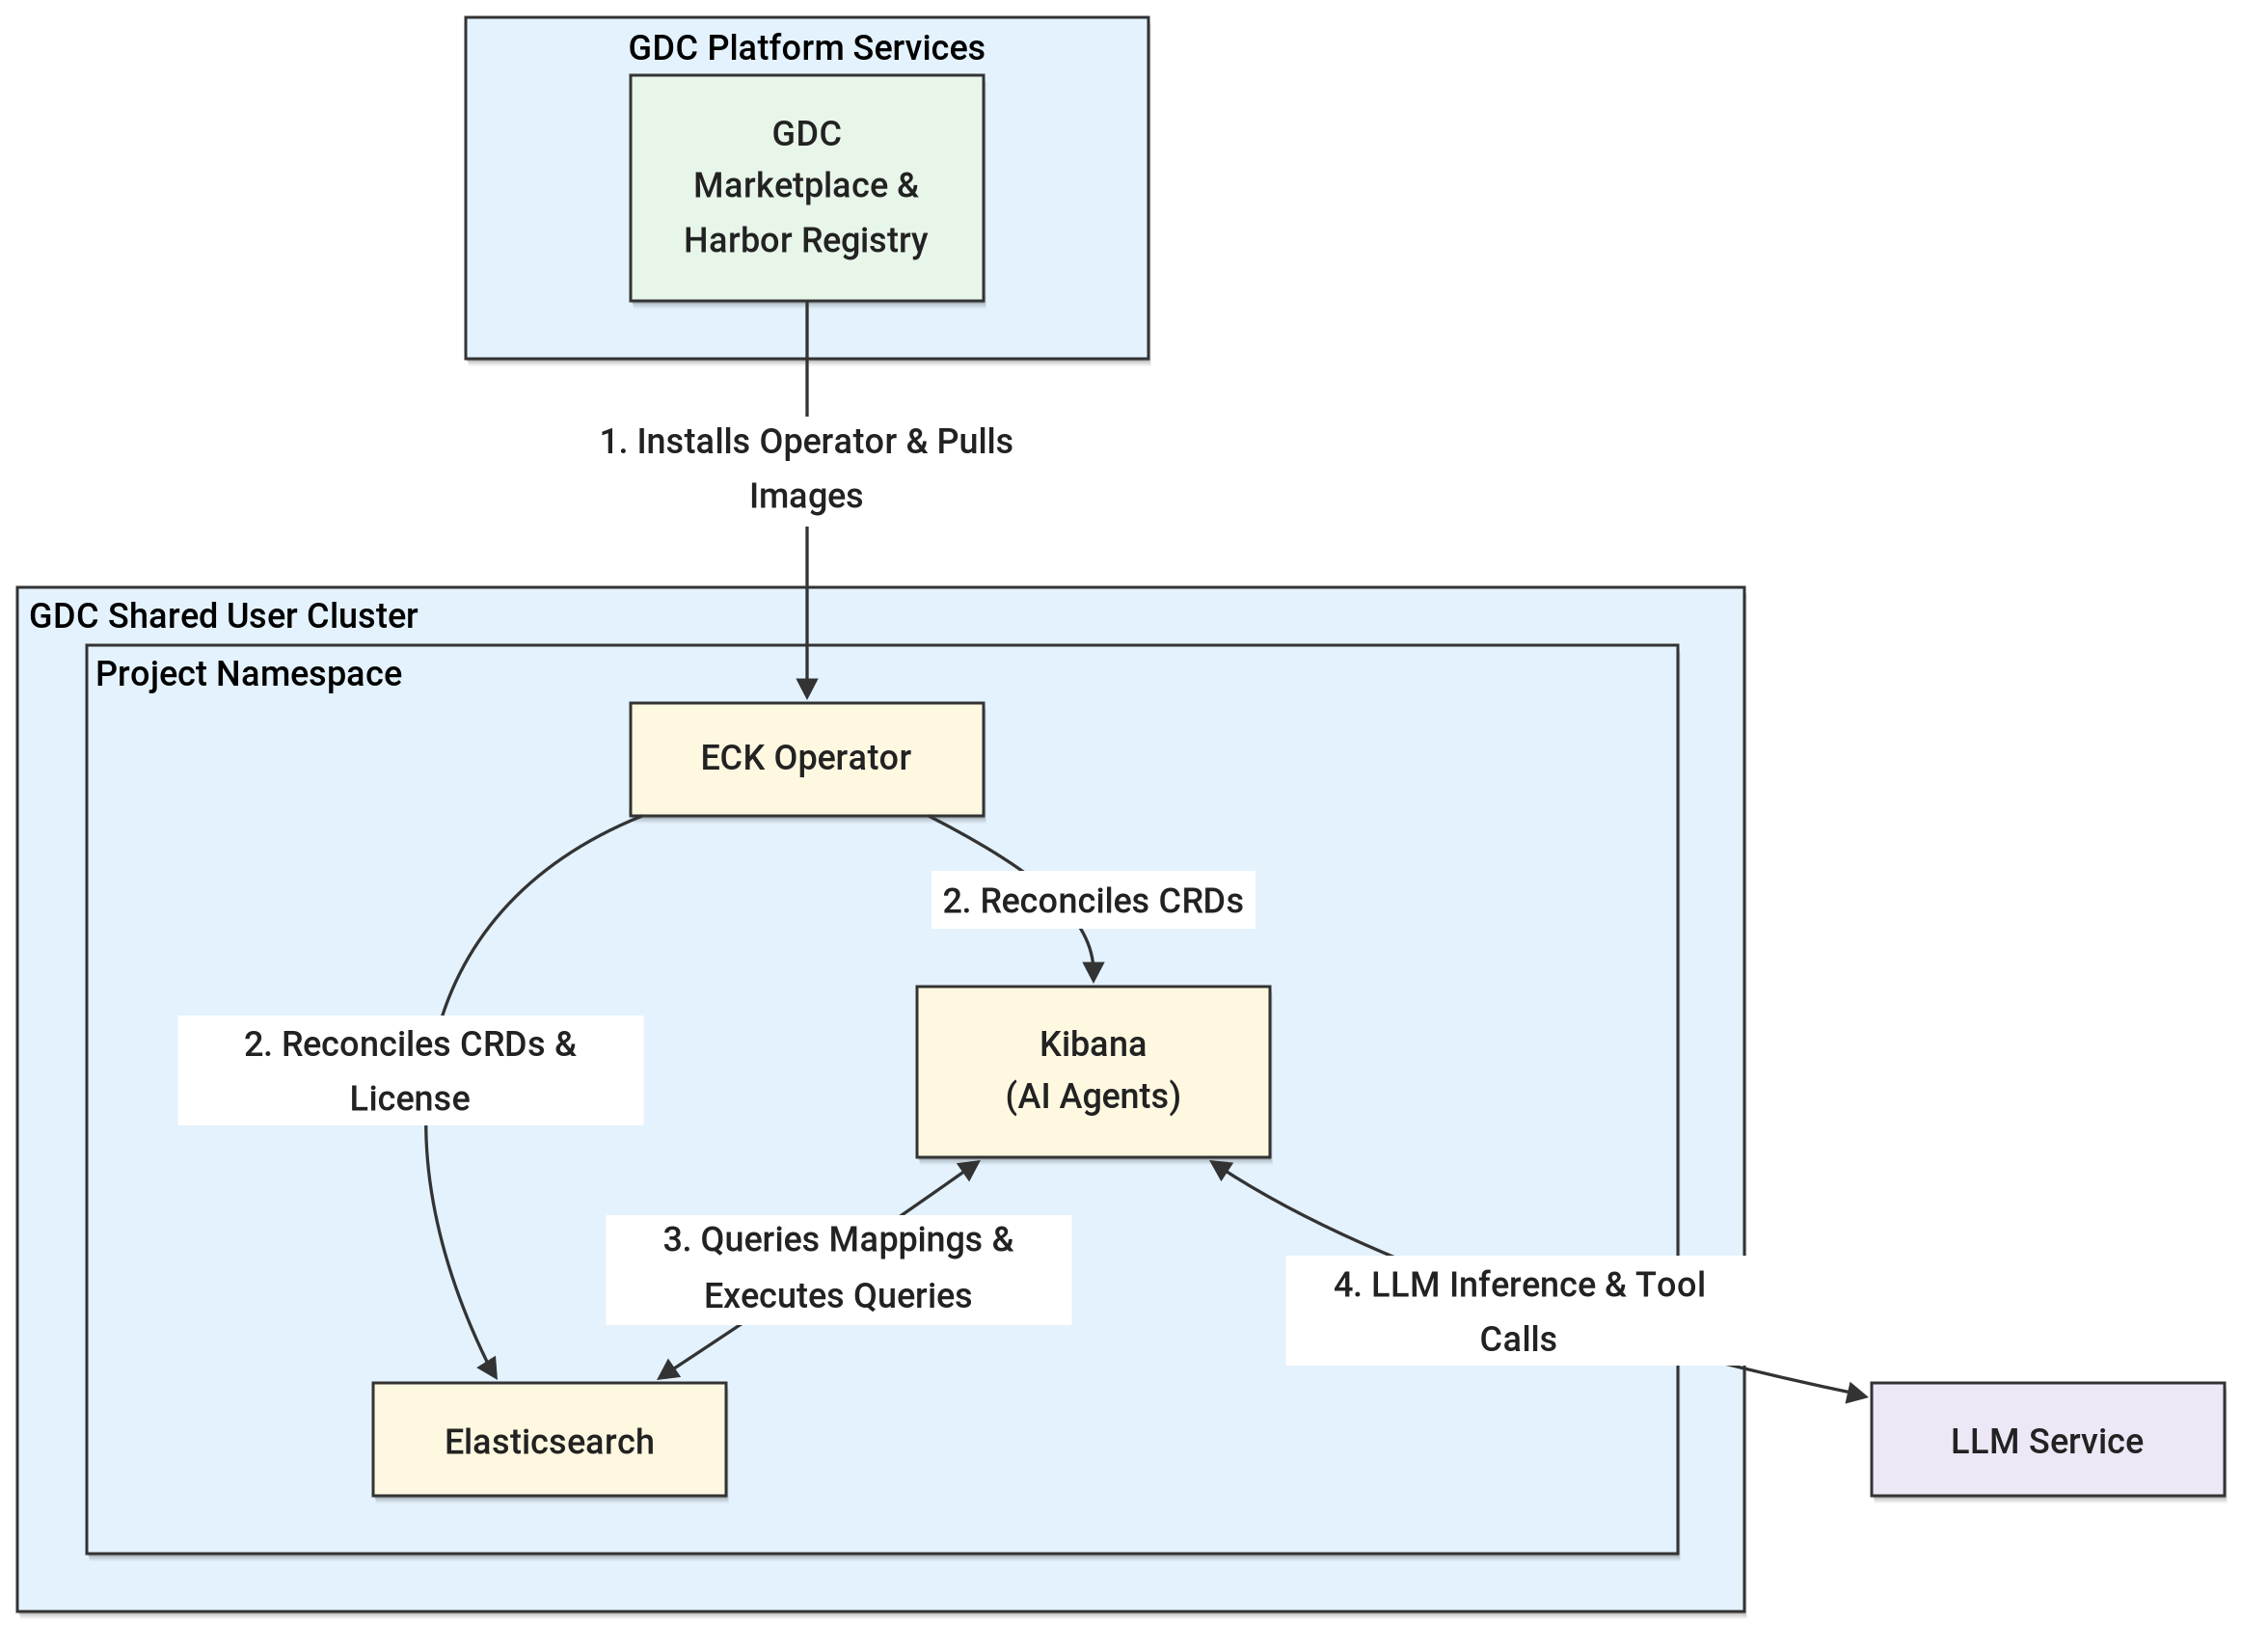
Voici les principaux composants de cette architecture :
- Cluster partagé GDC : cluster Kubernetes partagé au niveau de l'organisation, associé à plusieurs projets, hébergeant des packages logiciels et des charges de travail d'application GDC Marketplace.
- Projet GDC : espace de noms du projet sur le cluster partagé qui isole l'opérateur ECK, le cluster Elasticsearch, l'instance Kibana, ainsi que les secrets et les NetworkPolicies Kubernetes associés.
- Opérateur Elastic Cloud sur Kubernetes (ECK) : installé depuis GDC Marketplace dans l'espace de noms du projet, l'opérateur gère les ressources personnalisées
ElasticsearchetKibana, et rapproche la licence Elastic requise pour les fonctionnalités d'IA générative et les connecteurs LLM externes. - Elasticsearch : stocke et indexe les données opérationnelles et de sécurité, et exécute les requêtes de recherche et ES|QL générées par les fonctionnalités d'IA et les agents de Kibana.
- Kibana : héberge les fonctionnalités d'IA générative d'Elastic (Elastic AI Agent, Agent Builder et Attack Discovery) et gère les connecteurs d'action LLM qui orchestrent l'appel d'outils en plusieurs étapes entre l'utilisateur, Elasticsearch et le service LLM.
- Service LLM : service LLM géré (comme Gemini sur GDC) ou serveur d'inférence autogéré (comme Ollama ou vLLM) qui fournit des fonctionnalités de complétion de chat et d'appel d'outils à Kibana sur le réseau GDC interne.
Concepts et technologies
Cette section détaille les composants fonctionnels, leurs responsabilités et la manière dont ils communiquent au sein du système.
Infrastructure et plate-forme
- Cluster partagé GDC : environnement de calcul principal dans lequel résident l'opérateur ECK, Elasticsearch et les pods Kibana dans un espace de noms de projet.
- GDC Marketplace : catalogue utilisé pour installer et mettre à niveau le package Elastic Marketplace, qui enregistre les CustomResourceDefinitions Elastic et déploie le StatefulSet
elastic-operator. - Registre Harbor : source de vérité locale et sécurisée pour l'opérateur ECK, Elasticsearch et les images de conteneurs Kibana dans l'environnement air gap.
- Stockage persistant : les PersistentVolumeClaims provisionnés via l'
volumeClaimTemplatesElasticsearch fournissent un stockage de blocs durable pour les données Elasticsearch. - Mise en réseau GDC : les services LoadBalancer exposent Elasticsearch (port
9200) et Kibana (port5601), tandis que les ressources KubernetesNetworkPolicyet globalesProjectNetworkPolicyrégissent le trafic entrant et inter-projets, y compris la connectivité au service LLM.
Services et logique
- Opérateur ECK : contrôleur qui surveille les ressources personnalisées
ElasticsearchetKibanaet les rapproche dans les StatefulSets, les déploiements, les services et les secrets. Sonlicense-controllerrapproche en permanence la licence du cluster des secrets de licence dans l'espace de noms de l'opérateur. - Agent IA Elastic : agent conversationnel par défaut dans Kibana. Il utilise les outils Agent Builder intégrés (
platform.core.list_indices,platform.core.get_index_mapping,platform.core.searchetplatform.core.execute_esql) pour découvrir des données, générer du code ES|QL et résumer les résultats. - Agent Builder : framework permettant de créer des agents personnalisés qui combinent des instructions système personnalisées avec des outils intégrés et des outils définis par l'utilisateur (
esql,index_search,workflowetmcp). - Workflows Kibana : automatisations déclaratives définies en YAML (par exemple,
cases.createCase) qui peuvent être enregistrées en tant qu'outils Agent Builder pour permettre aux agents d'effectuer des actions telles que l'ouverture de cas de sécurité Kibana. - Attack Discovery : fonctionnalité de sécurité d'Elastic Security qui envoie un contexte d'alerte anonymisé au LLM pour corréler les alertes de l'index
.alerts-security.alerts-defaultdans des chaînes d'attaque mappées aux tactiques MITRE ATT&CK. - Service LLM : fournit des complétions de chat ajustées aux instructions avec une compatibilité native avec les appels d'outils. Le modèle doit générer de manière fiable des appels d'outils, des JSON structurés et des requêtes ES|QL valides.
Flux de données et interfaces
- API de complétion de chat compatible avec OpenAI (
/v1/chat/completions) : interface entre le connecteur OpenAI de Kibana (.gen-ai) et le service LLM, configurée avec le fournisseur Autre (service compatible avec OpenAI), l'appel de fonction natif activé et le streaming d'événements envoyés par le serveur. - API REST Elasticsearch et ES|QL : utilisées par Kibana et ses agents pour inspecter les mappages, exécuter des recherches et exécuter des agrégations ES|QL.
- API REST Kibana : utilisées pour la gestion automatisée des connecteurs (
/api/actions), des agents et des outils (/api/agent_builder), des workflows (/api/workflows), des règles de détection (/api/detection_engine) et d'Attack Discovery (/api/attack_discovery). - HTTPS avec authentification intégrée : les points de terminaison Elasticsearch et Kibana sont diffusés via TLS à l'aide de certificats générés par ECK, avec des identifiants stockés dans des secrets Kubernetes gérés par ECK.
Remarques
- Évolutivité et performances :
- Les requêtes de ressources, les limites, le nombre de nœuds et les tailles de stockage d'Elasticsearch et de Kibana doivent être ajustés par rapport aux valeurs par défaut de l'évaluation pour correspondre aux volumes de données de production et à la simultanéité des requêtes.
- Le connecteur OpenAI de Kibana applique un délai avant expiration par défaut de 60 secondes par tour de streaming. Le service LLM doit s'exécuter sur l'accélération GPU avec des optimisations telles que Flash Attention pour que chaque tour reste dans cette limite.
- Un seul tour d'agent peut déclencher des sous-appels LLM imbriqués. Le serveur d'inférence doit gérer plusieurs emplacements de cache KV parallèles (par exemple,
OLLAMA_NUM_PARALLEL=2) pour éviter que les sous-appels n'effacent le contexte mis en cache de la conversation principale.
- Exigences concernant les modèles LLM :
- Le modèle doit être réglé par instructions avec une compatibilité native avec les appels de fonction. L'appel de fonction natif doit être activé sur le connecteur Kibana, car l'appel de fonction simulé basé sur des requêtes est moins fiable pour les appels d'outils imbriqués.
- Une fenêtre de contexte d'au moins 128 000 jetons est vivement recommandée, car les investigations en plusieurs étapes combinant des définitions d'outils, des schémas d'index, de la documentation ES|QL et des résultats de recherche peuvent dépasser 70 000 jetons.
- Une limite de jetons de sortie d'au moins 8 192 jetons et une pénalité de répétition légère sont recommandées pour les modèles capables de raisonner, car Kibana traite un motif d'arrêt
lengthcomme une erreur fatale et utilise le décodage glouton. - Attack Discovery nécessite un modèle de classe 30B ou supérieure (tel que
gemma4:31b) pour synthétiser de manière fiable des sorties structurées multi-alertes.
- Sécurité et conformité :
- Tous les prompts, les données récupérées et les réponses du modèle restent sur le réseau GDC interne.
- Les règles de réseau doivent être renforcées par rapport aux paramètres d'évaluation permissifs afin de limiter l'accès entrant à Elasticsearch et Kibana aux clients autorisés, et de limiter la sortie vers le point de terminaison du service LLM.
- L'accès à Kibana et Elasticsearch doit être régi par les contrôles d'accès basés sur les rôles Elastic plutôt que par le super-utilisateur
elastic.
- Gestion des ressources et licences :
- Les fonctionnalités d'IA générative et les connecteurs LLM externes d'Elastic nécessitent une licence Enterprise (ou un essai Enterprise de 30 jours actif), qui doit être provisionnée via un secret de licence ECK pour persister entre les cycles de rapprochement de l'opérateur.
- Disponibilité et fiabilité :
- Les déploiements en production doivent utiliser plusieurs nœuds Elasticsearch avec des segments dupliqués et plusieurs instances Kibana pour éviter les points de défaillance uniques.
- La disponibilité des fonctionnalités d'IA dépend de la disponibilité et de la latence du service LLM.
- Gestion opérationnelle :
- Le client est responsable de la mise à niveau du package Elastic Marketplace et des versions d'Elastic Stack, de la gestion des licences et de la sauvegarde des données Elasticsearch.
- Lorsqu'un service LLM autogéré est utilisé, le client est responsable de son déploiement, de la planification de la capacité des GPU, des mises à jour du modèle et de son réglage.
Décision de conception
Les principaux choix architecturaux de cette solution se concentrent sur l'activation des fonctionnalités d'IA générative d'Elastic dans les limites de l'environnement sous air gap.
Opérateur ECK de GDC Marketplace
L'opérateur ECK est installé à partir de la place de marché GDC sous air gap plutôt que déployé manuellement. Le package de place de marché est préconfiguré pour récupérer les images de conteneurs du registre Harbor local, enregistre les CustomResourceDefinitions requises et s'intègre aux rôles IAM au niveau du projet GDC. Cela réduit l'effort de mise en miroir des images et maintient le déploiement aligné sur le cycle de vie du logiciel GDC.
Déploiement de clusters partagés
La solution déploie la suite Elastic dans un espace de noms de projet sur un cluster partagé GDC. Cela permet aux clients d'utiliser les logiciels Marketplace avec d'autres charges de travail de projet sans provisionner ni exploiter de cluster dédié, tandis que l'espace de noms du projet isole les ressources, les secrets et les règles de réseau.
Options de service LLM
Gemini géré sur GDC est l'option privilégiée lorsqu'elle est disponible, car elle élimine la charge opérationnelle liée à l'hébergement de l'infrastructure d'inférence. Lorsqu'il n'est pas disponible ou que les clients ont besoin d'un modèle ouvert spécifique, Kibana peut se connecter à n'importe quel serveur d'inférence autogéré qui expose un point de terminaison /v1/chat/completions compatible avec OpenAI. La standardisation sur cette API permet de maintenir la configuration Elastic indépendante du moteur d'inférence (comme Ollama ou vLLM).
Appel de fonction natif
L'appel de fonction natif est activé sur le connecteur Kibana afin que la mise en forme de l'appel d'outil soit déléguée au protocole OpenAI tools du serveur d'inférence.
L'appel de fonction simulé par défaut de Kibana basé sur des requêtes est moins fiable lors des appels d'outils imbriqués et peut échouer avec des erreurs d'analyse.
Rapprochement des licences gérées par ECK
La licence Enterprise (ou d'essai) est déclarée en tant que secret de licence ECK au lieu d'être activée directement via l'API de licence Elasticsearch. Étant donné qu'ECK rapproche en permanence la licence du cluster, les licences appliquées en dehors d'ECK sont rétablies sur basic lors du cycle de rapprochement suivant.
Hypothèses et limites
Hypothèses
- Un cluster partagé GDC et un projet associé sont disponibles, avec une capacité de calcul et de stockage persistant suffisante pour l'opérateur ECK, Elasticsearch et Kibana.
- Le package Elastic Marketplace et les images de conteneurs Elasticsearch et Kibana correspondantes sont disponibles dans GDC Marketplace avec air gap et dans le registre Harbor local.
- Les utilisateurs disposent des rôles de projet requis (
namespace-admin,project-viewer,marketplace-editoretproject-networkpolicy-admin). - Un service LLM (Gemini géré sur GDC ou un serveur d'inférence autogéré compatible avec OpenAI) est déployé et accessible depuis le pod Kibana sur le réseau GDC interne.
- Une licence Elastic Enterprise est disponible, ou l'essai Enterprise de 30 jours est utilisé pour l'évaluation.
Limites
- Service LLM hors du champ d'application : le déploiement et l'exploitation d'un service LLM autogéré, y compris l'infrastructure GPU, ne sont pas couverts par cette architecture.
- Aucun service d'IA hébergé par Elastic : les LLM gérés par Elastic et les autres services d'IA Elastic hébergés dans le cloud ne sont pas disponibles dans l'environnement sous air gap.
- Qualité dépendante du modèle : la précision et la fiabilité des résultats d'agent IA, d'Agent Builder et d'Attack Discovery dépendent des capacités du modèle sélectionné et de sa configuration d'exécution.
- Paramètres par défaut de niveau évaluation : l'implémentation de référence utilise un cluster Elasticsearch à nœud unique, des certificats autosignés et des règles de réseau permissives, qui doivent être renforcées pour une utilisation en production.
- Spécificité de la version : la solution a été validée avec Elastic v9.4.0, Elastic Kubernetes Operator v3.4.0 et GDC v1.16.2. D'autres versions peuvent nécessiter des ajustements.
Autres ressources
Implémentation de référence de la solution (SRI) : Déployer les fonctionnalités d'IA générative d'Elastic Stack sur GDC sous air gap