


Neste guia, descrevemos a implantação de uma instância autogerenciada do Oracle Database Enterprise em um cluster padrão com isolamento físico do Google Distributed Cloud (GDC). Essa implantação permite executar cargas de trabalho da Oracle no ambiente com isolamento físico, aproveitando os recursos de armazenamento e rede do GDC.
Ele usa o Oracle Database Operator para Kubernetes oficial, que automatiza o gerenciamento do ciclo de vida do banco de dados.
Arquitetura
A arquitetura descreve uma implantação de banco de dados Oracle de instância única gerenciada pelo Oracle Database Operator em um cluster padrão do GDC. Embora este guia demonstre a implantação de uma única instância de banco de dados, é possível implantar quantas instâncias a capacidade do cluster (RAM, CPU, espaço em disco) permitir.
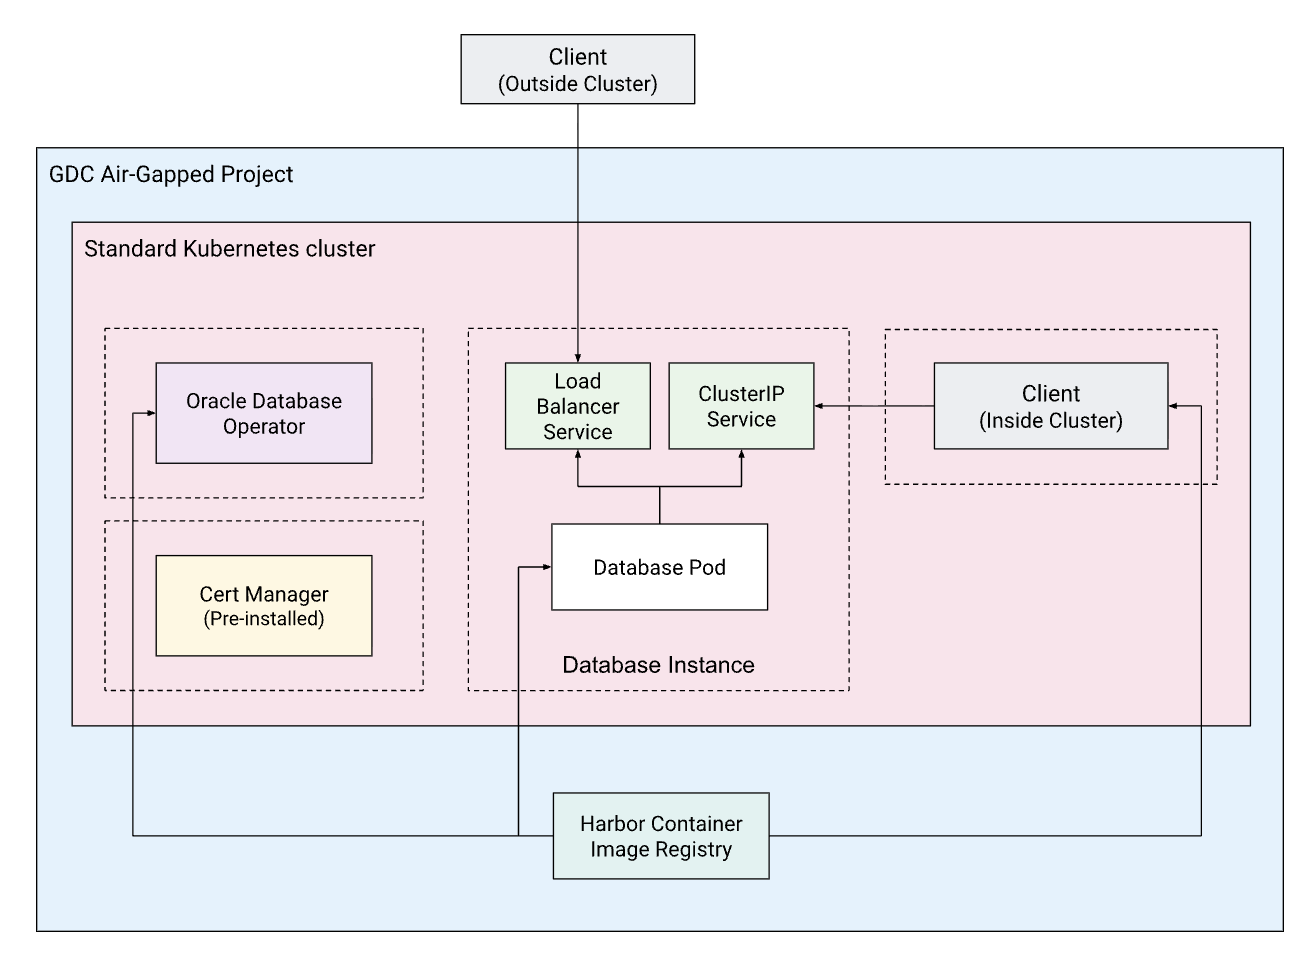
A arquitetura é composta pelos seguintes componentes principais:
- Projeto do GDC: o contêiner do projeto para seus recursos.
- Cluster padrão do Kubernetes: um cluster padrão que fornece os recursos de computação.
- Oracle Database Operator: um operador do Kubernetes que automatiza o provisionamento, o gerenciamento do ciclo de vida e a observabilidade de bancos de dados Oracle. Ele simplifica tarefas complexas, como aplicação de patches, backup e recuperação, facilitando a execução de cargas de trabalho com estado do Oracle em um ambiente conteinerizado.
- Instância de banco de dados: o banco de dados de instância única (SIDB, na sigla em inglês) do Oracle em contêiner com armazenamento permanente.
- Harbor: o Container Registry particular usado para hospedar o banco de dados, o operador e as imagens do cliente no ambiente com isolamento físico.
- Cert-manager: o operador depende do
cert-managerpara gerenciar certificados de webhooks. Ocert-managervem pré-instalado nos clusters padrão do GDC.
Neste guia, você implanta o operador no próprio namespace
(oracle-database-operator-system) e a instância do banco de dados em um namespace
separado (oracle-db). Esses namespaces são ilustrados com caixas de borda tracejada
no diagrama de arquitetura.
Essa separação é recomendada para fins de esclarecimento e gerenciamento. No entanto, cabe a você decidir como organizar seus bancos de dados. Por exemplo, é possível agrupar determinados bancos de dados em namespaces diferentes para gerenciar o controle de acesso granular (RBAC) com base nas necessidades da carga de trabalho, na propriedade da equipe ou nas especificações de segurança.
Antes de começar
Antes de iniciar a implantação, verifique se o ambiente atende aos seguintes requisitos:
- Crie um projeto que vai servir como o detentor de todos os recursos gerados ao longo deste guia.
Atribua ao usuário os papéis de administrador de cluster e administrador de cluster padrão no projeto. Isso permite criar um cluster padrão do Kubernetes e gerenciar os recursos dele:
export PROJECT_ID=PROJECT_ID
export USER_NAME=USER_NAME

gdcloud projects add-iam-policy-binding ${PROJECT_ID} \
  --member="user:${USER_NAME}" \
  --role=cluster-admin

gdcloud projects add-iam-policy-binding ${PROJECT_ID} \
  --member="user:${USER_NAME}" \
  --role=standard-cluster-admin
Crie uma instância do Harbor e um projeto do Harbor para hospedar as imagens de contêiner necessárias para este guia.
Atribua ao usuário o papel de administrador da instância do Harbor para que ele possa fazer upload de imagens para sua instância do Harbor:
gdcloud projects add-iam-policy-binding ${PROJECT_ID} \
  --member="user:${USER_NAME}" \
  --role=harbor-instance-admin
Crie uma conta de robô do Harbor no seu projeto do Harbor. Mais adiante neste guia, as credenciais da conta do robô serão armazenadas em secrets do Kubernetes, permitindo que o cluster extraia imagens do Harbor ao instanciar contêineres.
Crie um cluster padrão do Kubernetes com dois nós de trabalho, cada um com no mínimo 16 GB de memória. Exemplo:
kubectl --kubeconfig MGMT_API_KUBECONFIG create -f - <<EOF
apiVersion: cluster.gdc.goog/v1
kind: Cluster
metadata:
  name: ${CLUSTER_NAME}
  namespace: ${PROJECT_ID}
spec:
  nodePools:
  - machineTypeName: n3-standard-8-gdc
    nodeCount: 2
    name: ${CLUSTER_NAME}-node-pool
EOF
Configure as variáveis de ambiente. Elas serão usadas ao longo do guia para criar e referenciar recursos:
# General info
export PROJECT_ID="PROJECT_ID"
export ZONE="ZONE"
export ORG_NAME="ORG_NAME"
export CLUSTER_NAME="CLUSTER_NAME"

# Oracle operator settings
export ORACLE_OPERATOR_VERSION="2.1.0"
export ORACLE_DB_VERSION="23.26.1.0"
export ORACLE_OPERATOR_NAMESPACE="ORACLE_DBS_OPERATOR-SYSTEM"

# Harbor config
export HARBOR_INSTANCE_PROJECT_ID="HARBOR_PROJECT_ID"
export HARBOR_INSTANCE_NAME="HARBOR_INSTANCE_NAME"
export HARBOR_INSTANCE_URL="HARBOR_INSTANCE_URL"
export HARBOR_PROJECT="HARBOR_PROJECT"
export HARBOR_PULL_SECRET_NAME="HARBOR_PULL_SECRET_NAME"
export HARBOR_ROBOT_ACCOUNT="robot\$HARBOR_PROJECT+ROBOT_NAME"
export HARBOR_ROBOT_SECRET="HARBOR_ROBOT_SECRET"

# Oracle database config
export ADMIN_PASSWORD="ADMIN_PASSWORD"
export DB_NAMESPACE="DB_NAMESPACE"
export DB_NAME="DB_NAME"
Observação sobre a rede: este guia pressupõe que ele está sendo executado em um nó de bastião que tem acesso às APIs do GDC e à Internet para fazer o download dos manifestos e das imagens de contêiner do operador da Oracle. Se você estiver executando isso em uma máquina sem acesso à Internet, precisará conseguir esses recursos separadamente (por exemplo, usando
docker savepara exportar imagens de uma máquina conectada edocker loadpara importá-las) e fazer upload deles com segurança para seu ambiente antes de continuar.Crie uma conta e receba um token de API em container-registry.oracle.com e aceite o contrato de licença das imagens do Oracle Database Enterprise Edition e do Oracle Instant Client antes de prosseguir.
Carregar imagens no Harbor
Como os clusters no Google Distributed Cloud com isolamento físico não podem acessar registros externos, é necessário espelhar as imagens necessárias na instância particular do Harbor.
Faça login no Oracle Container Registry.
Primeiro, autentique-se no registro oficial da Oracle para extrair as imagens de base:
docker --config=./docker-oracle login container-registry.oracle.com
Após o login, as credenciais serão salvas em
./docker-oracle/config.json.
Carregar imagens no Harbor
Faça a autenticação com sua instância privada do Harbor:
docker --config=./docker-harbor login ${HARBOR_INSTANCE_URL} \
  -u ${HARBOR_ROBOT_ACCOUNT} \
  -p ${HARBOR_ROBOT_SECRET}
Após o login, as credenciais da conta do robô serão salvas em
./docker-harbor/config.json.
Extrair, marcar e enviar imagens
Faça o download das imagens do Oracle Container Registry oficial e envie-as para seu projeto interno do Harbor. Você vai espelhar o operador, o banco de dados corporativo e o cliente instantâneo para testes.
Espelhe a imagem do Oracle Database Operator:
docker --config=./docker-oracle pull \
  container-registry.oracle.com/database/operator:${ORACLE_OPERATOR_VERSION} \
  --platform linux/amd64
docker tag container-registry.oracle.com/database/operator:${ORACLE_OPERATOR_VERSION} \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-operator:${ORACLE_OPERATOR_VERSION}
docker --config=./docker-harbor push \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-operator:${ORACLE_OPERATOR_VERSION}
Espelhe a imagem do Oracle Database Enterprise:
docker --config=./docker-oracle pull \
  container-registry.oracle.com/database/enterprise:${ORACLE_DB_VERSION} \
  --platform linux/amd64
docker tag container-registry.oracle.com/database/enterprise:${ORACLE_DB_VERSION} \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-enterprise:${ORACLE_DB_VERSION}
docker --config=./docker-harbor push \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-enterprise:${ORACLE_DB_VERSION}
Espelhe a imagem do Oracle Instant Client:
docker --config=./docker-oracle pull container-registry.oracle.com/database/instantclient:latest \
  --platform linux/amd64
docker tag container-registry.oracle.com/database/instantclient:latest \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-instantclient:latest
docker --config=./docker-harbor push ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-instantclient:latest
Configurar o acesso ao cluster
Antes de implantar recursos, recupere as credenciais do cluster padrão e crie um alias conveniente:
Recupere o kubeconfig do cluster padrão:
KUBECONFIG=kubeconfig-${CLUSTER_NAME}.yaml gdcloud clusters \
  get-credentials ${CLUSTER_NAME} \
  --standard \
  --project ${PROJECT_ID} \
  --zone ${ZONE}
Crie o alias
kkpara simplificar os comandos seguintes:alias kk="kubectl --kubeconfig kubeconfig-${CLUSTER_NAME}.yaml"
Criar Secrets
Crie um secret do Kubernetes para permitir que o cluster extraia imagens do Harbor
usando as credenciais salvas no ./docker-harbor/config.json local. Você
precisa desse secret no namespace do operador (para extrair a imagem do operador)
e no namespace do banco de dados (para extrair a imagem do banco de dados).
Crie o namespace para o operador:
kk create ns ${ORACLE_OPERATOR_NAMESPACE}Crie o secret de pull para o operador:
kk create secret docker-registry ${HARBOR_PULL_SECRET_NAME} \
  --from-file=.dockerconfigjson=./docker-harbor/config.json \
  -n ${ORACLE_OPERATOR_NAMESPACE}
Crie o namespace para o banco de dados:
kk create ns ${DB_NAMESPACE}Crie o secret de pull para o banco de dados:
kk create secret docker-registry ${HARBOR_PULL_SECRET_NAME} \
  --from-file=.dockerconfigjson=./docker-harbor/config.json \
  -n ${DB_NAMESPACE}
Instalar o operador do banco de dados Oracle
Agora, instale o operador do banco de dados Oracle no cluster aplicando três manifestos:
Vinculação de papel do cluster: configura as permissões necessárias para o operador funcionar em todo o cluster.
kk apply -f https://raw.githubusercontent.com/oracle/oracle-database-operator/refs/tags/v${ORACLE_OPERATOR_VERSION}/rbac/cluster-role-binding.yamlRBAC do nó: concede permissões para ler a topologia do nó, o que é fundamental para a programação correta de pods.
kk apply -f https://raw.githubusercontent.com/oracle/oracle-database-operator/refs/tags/v${ORACLE_OPERATOR_VERSION}/rbac/node-rbac.yamlImplantação do operador: implanta os pods do operador e as definições de recursos personalizados (CRDs). Esse comando faz o download do manifesto oficial, substitui o caminho da imagem pelo URL do Harbor, injeta a configuração
imagePullSecretspara que o Kubernetes possa se autenticar no Harbor e aplica o resultado:curl -L https://raw.githubusercontent.com/oracle/oracle-database-operator/refs/tags/v${ORACLE_OPERATOR_VERSION}/oracle-database-operator.yaml \ | sed "s|container-registry.oracle.com/database/operator:latest|${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-operator:${ORACLE_OPERATOR_VERSION}|g" \ | awk "/terminationGracePeriodSeconds: 10/{print; print \" imagePullSecrets:\n - name: ${HARBOR_PULL_SECRET_NAME}\"; next}1" \ | kk apply -f -Aguarde até que os pods do operador estejam em execução:
kk get pods -n ${ORACLE_OPERATOR_NAMESPACE} --watchA saída será semelhante a esta:
NAME                                                           READY   STATUS    RESTARTS   AGE
oracle-database-operator-controller-manager-5f7b56874d-k9v4z   1/1     Running   0          45s
oracle-database-operator-controller-manager-5f7b56874d-n2x8m   1/1     Running   0          45s
oracle-database-operator-controller-manager-5f7b56874d-r6z7q   1/1     Running   0          45s
Implantar uma nova instância de banco de dados
Com o operador em execução, agora é possível implantar um banco de dados Oracle de instância única. Este guia cria uma instância básica da edição Enterprise adequada para desenvolvimento ou teste.
Crie um secret do Kubernetes para armazenar a senha administrativa do banco de dados:
kk create secret generic oracle-db-password \
  --from-literal=password=${ADMIN_PASSWORD} \
  -n ${DB_NAMESPACE}
Aplique o manifesto
SingleInstanceDatabasepara criar o banco de dados:apiVersion: database.oracle.com/v4 kind: SingleInstanceDatabase metadata: name: ${DB_NAME} namespace: ${DB_NAMESPACE} spec: sid: ORCLCDB pdbName: ORCLPDB1 edition: enterprise replicas: 1 image: pullFrom: ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-enterprise:${ORACLE_DB_VERSION} pullSecrets: ${HARBOR_PULL_SECRET_NAME} prebuiltDB: true persistence: size: 50Gi storageClass: standard-rwo accessMode: ReadWriteOnce adminPassword: secretName: oracle-db-password secretKey: passwordPrincipais parâmetros de configuração:
sid/pdbName: define o identificador do sistema (SID) e o nome do banco de dados conectável (PDB).edition: especifica a edição do banco de dados (enterpriseneste caso).image: aponta para a imagem do registro particular do Harbor.persistence: solicita um volume permanente de 50 Gi usando o StorageClassstandard-rwo, que cria um disco permanente zonal no GDC.replicas: define o número de pods como1. Embora1seja comum para uma única instância, é possível aumentar esse valor para casos de uso específicos, como atualizações graduais (em que um novo pod é criado antes que o antigo seja encerrado) ou se você estiver usando um back-end de armazenamento compartilhado que ofereça suporte ao acesso simultâneo. Para implantações básicas de instância única,1é o padrão.
Para uma lista completa de opções de configuração, incluindo parâmetros de inicialização personalizados e limites de recursos, consulte a documentação oficial.
A criação do banco de dados consome muitos recursos e pode levar de 10 a 20 minutos.
Aguarde até que o pod do banco de dados esteja
Running:kk get po -n ${DB_NAMESPACE} -l app=${DB_NAME} -wA saída será semelhante a esta:
NAME                   READY   STATUS    RESTARTS   AGE
my-db-i5xdj   0/1     Pending   0          0s
my-db-i5xdj   0/1     Pending   0          0s
my-db-i5xdj   0/1     Pending   0          1s
my-db-i5xdj   0/1     Init:0/1   0          1s
my-db-i5xdj   0/1     PodInitializing   0          98s
my-db-i5xdj   0/1     Running           0          99s
my-db-i5xdj   1/1     Running           0          99s
Em seguida, observe os registros e aguarde a mensagem
DATABASE IS READY TO USE!:kk logs -n ${DB_NAMESPACE} -l app=${DB_NAME} -fA saída precisa conter o seguinte:
#########################
DATABASE IS READY TO USE!
#########################
Verifique se o status é
Healthy:kk get singleinstancedatabase -n ${DB_NAMESPACE}A saída será semelhante a esta:
NAME    EDITION      STATUS    ROLE
my-db   Enterprise   Healthy   PRIMARY
Acessar e expor o banco de dados
Por padrão, o operador cria dois serviços para o banco de dados:
${DB_NAME}(ClusterIP): para tráfego interno no cluster. Use esse nome de DNS estável para aplicativos em execução no mesmo cluster.${DB_NAME}-ext(NodePort): para acesso externo. Por padrão, isso expõe o banco de dados em uma porta alta em cada nó. É possível fazer upgrade para um serviço de balanceador de carga definindoloadBalancer: truena especificaçãoSingleInstanceDatabase.
Para mais informações sobre como personalizar esses serviços, como definir NodePorts específicos, consulte a documentação do GitHub.
Escolha um dos métodos a seguir para acessar o banco de dados, dependendo das suas necessidades. Para mais detalhes sobre os tipos de serviço do GDC, consulte Expor serviços.
Acesso dentro do cluster (ClusterIP)
Para acessar o banco de dados de outros pods em execução no mesmo cluster do Kubernetes, use o serviço ClusterIP.
- Para verificar isso com segurança, conecte-se diretamente de um pod de cliente temporário.
- Verifique os serviços disponíveis no namespace. Anote o serviço
ClusterIPchamado${DB_NAME}(por exemplo,my-db). Esse nome serve como o nome do host para conexões internas. Implante um pod temporário que contenha o cliente SQL*Plus. Use a imagem
instantclientespelhada no registro do Harbor:kk run sqlplus-client -n ${DB_NAMESPACE} --rm -it --restart=Never \ --image=${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-instantclient:latest \ --image-pull-policy=Always \ --overrides='{"spec": {"imagePullSecrets": [{"name": "'${HARBOR_PULL_SECRET_NAME}'"}]}}' \ -- sqlplus sys/${ADMIN_PASSWORD}@${DB_NAME}:1521/ORCLPDB1 as sysdbaO prompt do SQL vai aparecer, indicando que a conexão foi bem-sucedida.
Crie uma tabela de amostra para verificar o acesso de gravação:
CREATE TABLE employees (id NUMBER, name VARCHAR2(50));
INSERT INTO employees VALUES (1, 'John Doe');
COMMIT;
SELECT * FROM employees;
A saída será semelhante a esta:
        ID NAME
---------- --------------------------------------------------
        1 John Doe
Saia da sessão:
exit
Acesso dentro da VPC (balanceador de carga interno)
Para expor o banco de dados a outros recursos (como VMs) localizados no mesmo projeto ou VPC do GDC, mas fora do cluster do Kubernetes, use um balanceador de carga interno. Isso mantém o tráfego privado no ambiente de rede isolado. Consulte a documentação do balanceador de carga interno do GDC para mais detalhes.
Como o operador não é compatível automaticamente com a adição de anotações ao
serviço gerado, é necessário criar um recurso de serviço separado. Observe a
anotação networking.gke.io/load-balancer-type: internal, que é necessária
para provisionar um balanceador de carga interno.
Crie o serviço de balanceador de carga interno:
apiVersion: v1
kind: Service
metadata:
  name: ${DB_NAME}-internal
  namespace: ${DB_NAMESPACE}
  annotations:
    networking.gke.io/load-balancer-type: internal
spec:
  type: LoadBalancer
  selector:
    app: ${DB_NAME}
  ports:
  - name: sqlnet
    port: 1521
    targetPort: 1521
Recupere o endereço IP interno:
export DB_INT_IP=$(kk get svc ${DB_NAME}-internal -n ${DB_NAMESPACE} \
  -o jsonpath='{.status.loadBalancer.ingress[0].ip}')
echo "Database Internal IP: ${DB_INT_IP}"
Acesso de fora da VPC (balanceador de carga externo)
Para expor o banco de dados a clientes completamente fora do ambiente do GDC ou da VPC (por exemplo, de uma rede corporativa ou de um cliente externo), use um balanceador de carga externo. Isso atribui um endereço IP que pode ser acessado de fora do limite da VPC isolada. Consulte a documentação do balanceador de carga externo do GDC para mais detalhes.
Para criar um balanceador de carga externo, atualize a especificação SingleInstanceDatabase
para definir loadBalancer: true. Isso muda o tipo de serviço ${DB_NAME}-ext
atual de NodePort para LoadBalancer.
Atualize a especificação:
kk patch sidb ${DB_NAME} -n ${DB_NAMESPACE} --type='merge' \
  -p '{"spec":{"loadBalancer":true}}'
Recupere o endereço IP externo:
export DB_EXT_IP=$(kk get svc ${DB_NAME}-ext -n ${DB_NAMESPACE} \
  -o jsonpath='{.status.loadBalancer.ingress[0].ip}')
echo "Database External IP: ${DB_EXT_IP}"
A seguir
- Arquitetura de referência do banco de dados Oracle autogerenciado
- Implantar bancos de dados Oracle autogerenciados altamente disponíveis