


Questa guida descrive il deployment di un'istanza Oracle Database Enterprise autogestita su un cluster standard Google Distributed Cloud con air gap. Questo deployment ti consente di eseguire i workload Oracle all'interno dell'ambiente con air gap, sfruttando le funzionalità di archiviazione e networking esistenti di GDC.
Utilizza l'operatore di database Oracle ufficiale per Kubernetes, che automatizza la gestione del ciclo di vita del database.
Architettura
L'architettura descrive un deployment di Oracle Database a istanza singola gestito dall'operatore Oracle Database all'interno di un cluster GDC standard. Sebbene questa guida mostri il deployment di una singola istanza di database, puoi eseguire il deployment di tutte le istanze consentite dalla capacità del cluster (RAM, CPU, spazio su disco).
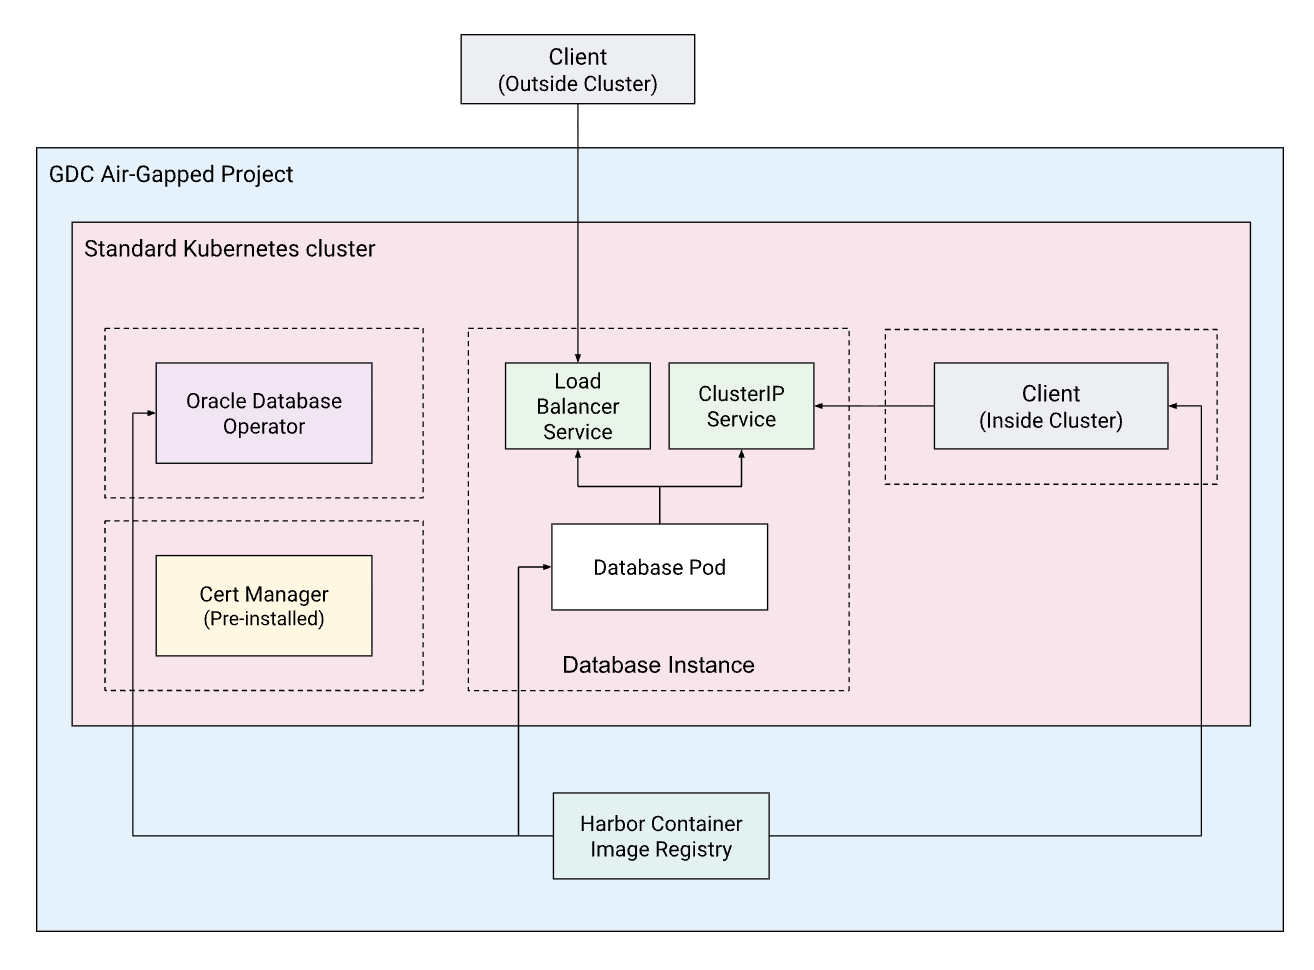
L'architettura comprende i seguenti componenti chiave:
- Progetto GDC: il container del progetto per le tue risorse.
- Cluster Kubernetes standard: un cluster standard che fornisce le risorse di computing.
- Oracle Database Operator: un operatore Kubernetes che automatizza il provisioning, la gestione del ciclo di vita e l'osservabilità dei database Oracle. Semplifica attività complesse come l'applicazione di patch, il backup e il ripristino, semplificando l'esecuzione di workload Oracle stateful in un ambiente containerizzato.
- Istanza di database: il database Oracle Single Instance (SIDB) containerizzato con archiviazione permanente.
- Harbor: il Container Registry privato utilizzato per ospitare le immagini del database, dell'operator e del client all'interno dell'ambiente con air gap.
- Cert-manager: l'operatore si affida a
cert-managerper la gestione dei certificati dei webhook.cert-managerè preinstallato sui cluster standard GDC.
In questa guida, esegui il deployment dell'operatore nel proprio spazio dei nomi (oracle-database-operator-system) e dell'istanza del database in uno spazio dei nomi separato (oracle-db). Questi spazi dei nomi sono illustrati con caselle con bordo tratteggiato nel diagramma dell'architettura.
Questa separazione è consigliata per chiarezza e gestibilità. Tuttavia, spetta a te decidere come organizzare i tuoi database. Ad esempio, potresti raggruppare determinati database in spazi dei nomi diversi per gestire il controllo degli accessi granulare (RBAC) in base alle esigenze del workload, alla proprietà del team o alle specifiche di sicurezza.
Prima di iniziare
Prima di iniziare il deployment, devi assicurarti che il tuo ambiente soddisfi i seguenti requisiti:
- Crea un progetto che fungerà da contenitore per tutte le risorse generate in questa guida.
Assegna al tuo utente i ruoli Amministratore cluster e Amministratore cluster standard per il tuo progetto. In questo modo potrai creare un cluster Kubernetes standard e gestirne le risorse:
export PROJECT_ID=PROJECT_ID
export USER_NAME=USER_NAME

gdcloud projects add-iam-policy-binding ${PROJECT_ID} \
  --member="user:${USER_NAME}" \
  --role=cluster-admin

gdcloud projects add-iam-policy-binding ${PROJECT_ID} \
  --member="user:${USER_NAME}" \
  --role=standard-cluster-admin
Crea un'istanza Harbor e un progetto Harbor per ospitare le immagini container necessarie per questa guida.
Assegna al tuo utente il ruolo Harbor Instance Admin in modo da poter caricare immagini nella tua istanza Harbor:
gdcloud projects add-iam-policy-binding ${PROJECT_ID} \
  --member="user:${USER_NAME}" \
  --role=harbor-instance-admin
Crea un account robot Harbor nel tuo progetto Harbor. Più avanti in questa guida, le credenziali dell'account robot verranno archiviate nei secret di Kubernetes, consentendo al cluster di eseguire il pull delle immagini da Harbor durante la creazione di istanze dei container.
Crea un cluster Kubernetes standard con due nodi worker, ciascuno con almeno 16 GB di memoria. Ad esempio:
kubectl --kubeconfig MGMT_API_KUBECONFIG create -f - <<EOF
apiVersion: cluster.gdc.goog/v1
kind: Cluster
metadata:
  name: ${CLUSTER_NAME}
  namespace: ${PROJECT_ID}
spec:
  nodePools:
  - machineTypeName: n3-standard-8-gdc
    nodeCount: 2
    name: ${CLUSTER_NAME}-node-pool
EOF
Configura le variabili di ambiente. Queste variabili verranno utilizzate in tutta la guida per creare e fare riferimento alle risorse:
# General info
export PROJECT_ID="PROJECT_ID"
export ZONE="ZONE"
export ORG_NAME="ORG_NAME"
export CLUSTER_NAME="CLUSTER_NAME"

# Oracle operator settings
export ORACLE_OPERATOR_VERSION="2.1.0"
export ORACLE_DB_VERSION="23.26.1.0"
export ORACLE_OPERATOR_NAMESPACE="ORACLE_DBS_OPERATOR-SYSTEM"

# Harbor config
export HARBOR_INSTANCE_PROJECT_ID="HARBOR_PROJECT_ID"
export HARBOR_INSTANCE_NAME="HARBOR_INSTANCE_NAME"
export HARBOR_INSTANCE_URL="HARBOR_INSTANCE_URL"
export HARBOR_PROJECT="HARBOR_PROJECT"
export HARBOR_PULL_SECRET_NAME="HARBOR_PULL_SECRET_NAME"
export HARBOR_ROBOT_ACCOUNT="robot\$HARBOR_PROJECT+ROBOT_NAME"
export HARBOR_ROBOT_SECRET="HARBOR_ROBOT_SECRET"

# Oracle database config
export ADMIN_PASSWORD="ADMIN_PASSWORD"
export DB_NAMESPACE="DB_NAMESPACE"
export DB_NAME="DB_NAME"
Nota sulla rete: questa guida presuppone che venga eseguita da un nodo bastion che ha accesso alle API GDC e a internet per scaricare i manifest e le immagini container dell'operatore Oracle. Se esegui questa operazione da una macchina senza accesso a internet, devi ottenere questi asset separatamente (ad esempio, utilizzando
docker saveper esportare le immagini da una macchina connessa edocker loadper importarle) e caricarli in modo sicuro nel tuo ambiente prima di procedere.Crea un account e ottieni un token API su container-registry.oracle.com, quindi accetta il contratto di licenza per le immagini Oracle Database Enterprise Edition e Oracle Instant Client prima di procedere.
Carica le immagini in Harbor
Poiché i cluster all'interno di Google Distributed Cloud con air gap non possono accedere ai registry esterni, devi eseguire il mirroring delle immagini richieste nella tua istanza Harbor privata.
Accedi a Oracle Container Registry
Devi prima autenticarti con il registry Oracle ufficiale per eseguire il pull delle immagini di base:
docker --config=./docker-oracle login container-registry.oracle.com
Dopo l'accesso, le credenziali verranno salvate in
./docker-oracle/config.json.
Carica le immagini in Harbor
Esegui l'autenticazione con la tua istanza Harbor privata:
docker --config=./docker-harbor login ${HARBOR_INSTANCE_URL} \
  -u ${HARBOR_ROBOT_ACCOUNT} \
  -p ${HARBOR_ROBOT_SECRET}
Dopo aver eseguito l'accesso, le credenziali dell'account robot verranno salvate in ./docker-harbor/config.json.
Esegui il pull, il tagging e il push delle immagini
Scarica le immagini da Oracle Container Registry ufficiale ed eseguine il push al tuo progetto Harbor interno. Eseguirai il mirroring dell'operatore, del database aziendale e del client istantaneo per i test.
Esegui il mirroring dell'immagine di Oracle Database Operator:
docker --config=./docker-oracle pull \
  container-registry.oracle.com/database/operator:${ORACLE_OPERATOR_VERSION} \
  --platform linux/amd64
docker tag container-registry.oracle.com/database/operator:${ORACLE_OPERATOR_VERSION} \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-operator:${ORACLE_OPERATOR_VERSION}
docker --config=./docker-harbor push \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-operator:${ORACLE_OPERATOR_VERSION}
Esegui il mirroring dell'immagine Oracle Database Enterprise:
docker --config=./docker-oracle pull \
  container-registry.oracle.com/database/enterprise:${ORACLE_DB_VERSION} \
  --platform linux/amd64
docker tag container-registry.oracle.com/database/enterprise:${ORACLE_DB_VERSION} \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-enterprise:${ORACLE_DB_VERSION}
docker --config=./docker-harbor push \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-enterprise:${ORACLE_DB_VERSION}
Esegui il mirroring dell'immagine Oracle Instant Client:
docker --config=./docker-oracle pull container-registry.oracle.com/database/instantclient:latest \
  --platform linux/amd64
docker tag container-registry.oracle.com/database/instantclient:latest \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-instantclient:latest
docker --config=./docker-harbor push ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-instantclient:latest
Configura l'accesso al cluster
Prima di eseguire il deployment delle risorse, recupera le credenziali per il tuo cluster standard e crea un alias pratico:
Recupera il file kubeconfig per il tuo cluster standard:
KUBECONFIG=kubeconfig-${CLUSTER_NAME}.yaml gdcloud clusters \
  get-credentials ${CLUSTER_NAME} \
  --standard \
  --project ${PROJECT_ID} \
  --zone ${ZONE}
Crea l'alias
kkper semplificare i comandi successivi:alias kk="kubectl --kubeconfig kubeconfig-${CLUSTER_NAME}.yaml"
Crea secret
Crea un secret Kubernetes per consentire al cluster di eseguire il pull delle immagini da Harbor utilizzando le credenziali salvate nel file ./docker-harbor/config.json locale. Questo secret è necessario sia nello spazio dei nomi dell'operatore (per eseguire il pull dell'immagine dell'operatore) sia nello spazio dei nomi del database (per eseguire il pull dell'immagine del database).
Crea lo spazio dei nomi per l'operatore:
kk create ns ${ORACLE_OPERATOR_NAMESPACE}Crea il secret pull per l'operatore:
kk create secret docker-registry ${HARBOR_PULL_SECRET_NAME} \
  --from-file=.dockerconfigjson=./docker-harbor/config.json \
  -n ${ORACLE_OPERATOR_NAMESPACE}
Crea lo spazio dei nomi per il database:
kk create ns ${DB_NAMESPACE}Crea il secret di pull per il database:
kk create secret docker-registry ${HARBOR_PULL_SECRET_NAME} \
  --from-file=.dockerconfigjson=./docker-harbor/config.json \
  -n ${DB_NAMESPACE}
Installa l'operatore Oracle Database
Ora installa l'operatore del database Oracle nel tuo cluster applicando tre manifest:
ClusterRoleBinding: configura le autorizzazioni necessarie per il funzionamento dell'operatore a livello di cluster.
kk apply -f https://raw.githubusercontent.com/oracle/oracle-database-operator/refs/tags/v${ORACLE_OPERATOR_VERSION}/rbac/cluster-role-binding.yamlRBAC del nodo: concede le autorizzazioni per leggere la topologia del nodo, fondamentale per la corretta pianificazione dei pod.
kk apply -f https://raw.githubusercontent.com/oracle/oracle-database-operator/refs/tags/v${ORACLE_OPERATOR_VERSION}/rbac/node-rbac.yamlDeployment dell'operatore: esegue il deployment dei pod dell'operatore e delle definizioni di risorse personalizzate (CRD). Questo comando scarica il manifest ufficiale, sostituisce il percorso dell'immagine con l'URL di Harbor, inserisce la configurazione
imagePullSecretsin modo che Kubernetes possa autenticarsi con Harbor e applica il risultato:curl -L https://raw.githubusercontent.com/oracle/oracle-database-operator/refs/tags/v${ORACLE_OPERATOR_VERSION}/oracle-database-operator.yaml \ | sed "s|container-registry.oracle.com/database/operator:latest|${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-operator:${ORACLE_OPERATOR_VERSION}|g" \ | awk "/terminationGracePeriodSeconds: 10/{print; print \" imagePullSecrets:\n - name: ${HARBOR_PULL_SECRET_NAME}\"; next}1" \ | kk apply -f -Attendi che i pod dell'operatore siano in esecuzione:
kk get pods -n ${ORACLE_OPERATOR_NAMESPACE} --watchL'output dovrebbe essere simile all'esempio seguente:
NAME                                                           READY   STATUS    RESTARTS   AGE
oracle-database-operator-controller-manager-5f7b56874d-k9v4z   1/1     Running   0          45s
oracle-database-operator-controller-manager-5f7b56874d-n2x8m   1/1     Running   0          45s
oracle-database-operator-controller-manager-5f7b56874d-r6z7q   1/1     Running   0          45s
Esegui il deployment di una nuova istanza di database
Con l'operatore in esecuzione, ora puoi eseguire il deployment di un database Oracle a istanza singola. Questa guida crea un'istanza Enterprise Edition di base adatta per lo sviluppo o i test.
Crea un secret di Kubernetes per archiviare la password amministrativa del database:
kk create secret generic oracle-db-password \
  --from-literal=password=${ADMIN_PASSWORD} \
  -n ${DB_NAMESPACE}
Applica il manifest
SingleInstanceDatabaseper creare il database:apiVersion: database.oracle.com/v4 kind: SingleInstanceDatabase metadata: name: ${DB_NAME} namespace: ${DB_NAMESPACE} spec: sid: ORCLCDB pdbName: ORCLPDB1 edition: enterprise replicas: 1 image: pullFrom: ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-enterprise:${ORACLE_DB_VERSION} pullSecrets: ${HARBOR_PULL_SECRET_NAME} prebuiltDB: true persistence: size: 50Gi storageClass: standard-rwo accessMode: ReadWriteOnce adminPassword: secretName: oracle-db-password secretKey: passwordParametri di configurazione principali:
sid/pdbName: definisce l'identificatore di sistema (SID) e il nome del database pluggable (PDB).edition: specifica la versione del database (enterprisein questo caso).image: rimanda all'immagine del registro Harbor privato.persistence: richiede un volume permanente da 50 Gi utilizzando StorageClassstandard-rwo, che crea un disco permanente a livello di zona in GDC.replicas: imposta il numero di pod su1. Sebbene1sia tipico per una singola istanza, puoi aumentarlo per casi d'uso specifici come gli aggiornamenti in sequenza (in cui viene creato un nuovo pod prima della terminazione di quello precedente) o se utilizzi un backend di archiviazione condiviso che supporta l'accesso simultaneo. Per i deployment di base con una singola istanza,1è lo standard.
Per un elenco completo delle opzioni di configurazione, inclusi i parametri di inizializzazione personalizzati e i limiti delle risorse, consulta la documentazione ufficiale.
La creazione del database richiede un uso intensivo delle risorse e potrebbe richiedere da 10 a 20 minuti.
Attendi finché il pod del database non è
Running:kk get po -n ${DB_NAMESPACE} -l app=${DB_NAME} -wL'output dovrebbe essere simile all'esempio seguente:
NAME                   READY   STATUS    RESTARTS   AGE
my-db-i5xdj   0/1     Pending   0          0s
my-db-i5xdj   0/1     Pending   0          0s
my-db-i5xdj   0/1     Pending   0          1s
my-db-i5xdj   0/1     Init:0/1   0          1s
my-db-i5xdj   0/1     PodInitializing   0          98s
my-db-i5xdj   0/1     Running           0          99s
my-db-i5xdj   1/1     Running           0          99s
Quindi, controlla i log e attendi il messaggio
DATABASE IS READY TO USE!:kk logs -n ${DB_NAMESPACE} -l app=${DB_NAME} -fL'output dovrebbe contenere quanto segue.
#########################
DATABASE IS READY TO USE!
#########################
Verifica che lo stato sia
Healthy:kk get singleinstancedatabase -n ${DB_NAMESPACE}L'output dovrebbe essere simile all'esempio seguente:
NAME    EDITION      STATUS    ROLE
my-db   Enterprise   Healthy   PRIMARY
Accedi al database ed esponilo
Per impostazione predefinita, l'operatore crea due servizi per il database:
${DB_NAME}(ClusterIP): per il traffico interno al cluster. Utilizza questo nome DNS stabile per le applicazioni in esecuzione nello stesso cluster.${DB_NAME}-ext(NodePort): per l'accesso esterno. Per impostazione predefinita, questo espone il database su una porta alta di ogni nodo. Puoi eseguirne l'upgrade a un servizio di bilanciamento del carico impostandoloadBalancer: truenella specificaSingleInstanceDatabase.
Per saperne di più su come personalizzare questi servizi, ad esempio definendo NodePort specifiche, consulta la documentazione di GitHub.
Scegli uno dei seguenti metodi per accedere al database in base alle tue esigenze. Per maggiori dettagli sui tipi di servizi GDC, consulta Esponi i servizi.
Accesso all'interno del cluster (ClusterIP)
Per accedere al database da altri pod in esecuzione nello stesso cluster Kubernetes, utilizza il servizio ClusterIP.
- Per verificarlo in modo sicuro, connettiti direttamente da un pod client temporaneo.
- Controlla i servizi disponibili nel tuo spazio dei nomi. Prendi nota del servizio
ClusterIPdenominato${DB_NAME}(ad esempio,my-db). Questo nome funge da nome host per le connessioni interne. Esegui il deployment di un pod temporaneo contenente il client SQL*Plus. Utilizza l'immagine
instantclientdi cui è stato eseguito il mirroring nel registry Harbor:kk run sqlplus-client -n ${DB_NAMESPACE} --rm -it --restart=Never \ --image=${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-instantclient:latest \ --image-pull-policy=Always \ --overrides='{"spec": {"imagePullSecrets": [{"name": "'${HARBOR_PULL_SECRET_NAME}'"}]}}' \ -- sqlplus sys/${ADMIN_PASSWORD}@${DB_NAME}:1521/ORCLPDB1 as sysdbaDovresti visualizzare il prompt SQL che indica che la connessione è riuscita.
Crea una tabella di esempio per verificare l'accesso in scrittura:
CREATE TABLE employees (id NUMBER, name VARCHAR2(50));
INSERT INTO employees VALUES (1, 'John Doe');
COMMIT;
SELECT * FROM employees;
L'output dovrebbe essere simile all'esempio seguente:
        ID NAME
---------- --------------------------------------------------
        1 John Doe
Esci dalla sessione:
exit
Accesso all'interno del VPC (bilanciatore del carico interno)
Per esporre il database ad altre risorse (come le VM) situate all'interno dello stesso progetto GDC o VPC, ma all'esterno del cluster Kubernetes, utilizza un bilanciatore del carico interno. In questo modo, il traffico rimane privato all'interno del tuo ambiente di rete isolato. Per ulteriori dettagli, consulta la documentazione sul bilanciatore del carico interno di GDC.
Poiché l'operatore non supporta automaticamente l'aggiunta di annotazioni al servizio generato, devi creare una risorsa di servizio separata. Prendi nota dell'annotazione networking.gke.io/load-balancer-type: internal, necessaria per eseguire il provisioning di un bilanciatore del carico interno.
Crea il servizio di bilanciatore del carico interno:
apiVersion: v1
kind: Service
metadata:
  name: ${DB_NAME}-internal
  namespace: ${DB_NAMESPACE}
  annotations:
    networking.gke.io/load-balancer-type: internal
spec:
  type: LoadBalancer
  selector:
    app: ${DB_NAME}
  ports:
  - name: sqlnet
    port: 1521
    targetPort: 1521
Recupera l'indirizzo IP interno:
export DB_INT_IP=$(kk get svc ${DB_NAME}-internal -n ${DB_NAMESPACE} \
  -o jsonpath='{.status.loadBalancer.ingress[0].ip}')
echo "Database Internal IP: ${DB_INT_IP}"
Accesso dall'esterno del VPC (bilanciatore del carico esterno)
Per esporre il database a client completamente esterni all'ambiente GDC o al VPC (ad esempio, da una rete aziendale o da un client esterno), puoi utilizzare un bilanciatore del carico esterno. In questo modo viene assegnato un indirizzo IP raggiungibile dall'esterno del perimetro VPC isolato. Per ulteriori dettagli, consulta la documentazione sul bilanciatore del carico esterno GDC.
Per creare un bilanciatore del carico esterno, aggiorna la specifica SingleInstanceDatabase per impostare loadBalancer: true. In questo modo, il tipo di servizio ${DB_NAME}-ext esistente viene modificato da NodePort a LoadBalancer.
Aggiorna la specifica:
kk patch sidb ${DB_NAME} -n ${DB_NAMESPACE} --type='merge' \
  -p '{"spec":{"loadBalancer":true}}'
Recupera l'indirizzo IP esterno:
export DB_EXT_IP=$(kk get svc ${DB_NAME}-ext -n ${DB_NAMESPACE} \
  -o jsonpath='{.status.loadBalancer.ingress[0].ip}')
echo "Database External IP: ${DB_EXT_IP}"
Passaggi successivi
- Architettura di riferimento del database Oracle autogestito
- Esegui il deployment di database Oracle autogestiti ad alta affidabilità