


In diesem Leitfaden wird die Bereitstellung einer selbstverwalteten Oracle Database Enterprise-Instanz in einem GDC-Standardcluster (Google Distributed Cloud) mit Air Gap beschrieben. Mit dieser Bereitstellung können Sie Oracle-Arbeitslasten in der Air-Gap-Umgebung ausführen und die vorhandenen Speicher- und Netzwerkfunktionen von GDC nutzen.
Dabei wird der offizielle Oracle Database Operator for Kubernetes verwendet, der die Verwaltung des Lebenszyklus der Datenbank automatisiert.
Architektur
Die Architektur beschreibt eine Oracle-Datenbankbereitstellung mit einer einzelnen Instanz, die vom Oracle Database Operator in einem GDC-Standardcluster verwaltet wird. In dieser Anleitung wird die Bereitstellung einer einzelnen Datenbankinstanz beschrieben. Sie können jedoch so viele Instanzen bereitstellen, wie die Kapazität Ihres Clusters (RAM, CPU, Speicherplatz) zulässt.
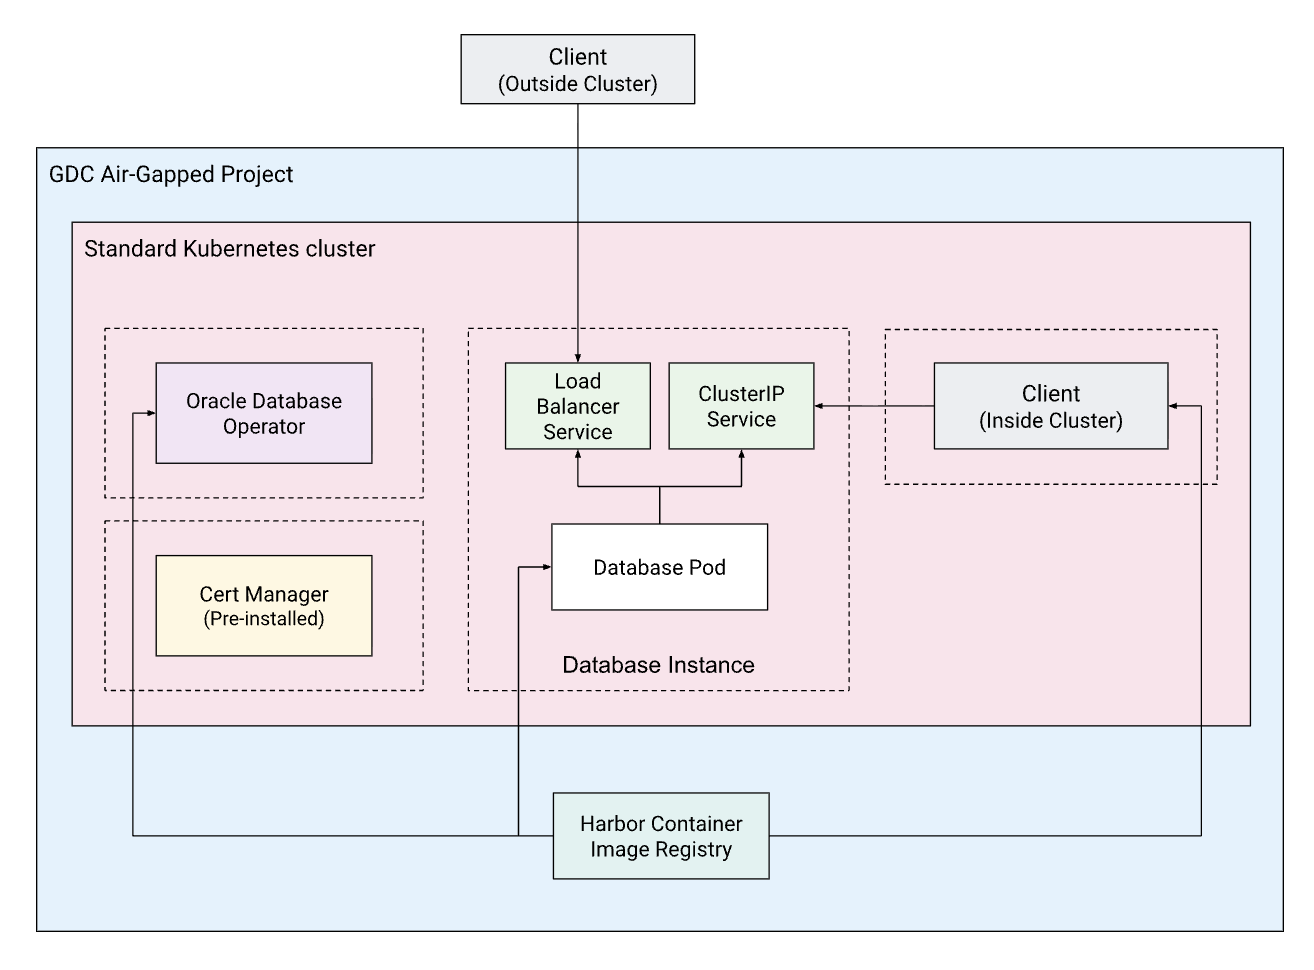
Die Architektur umfasst die folgenden Hauptkomponenten:
- GDC-Projekt: Der Projektcontainer für Ihre Ressourcen.
- Standard-Kubernetes-Cluster: Ein Standardcluster, der die Rechenressourcen bereitstellt.
- Oracle Database Operator: Ein Kubernetes-Operator, der die Bereitstellung, die Verwaltung des Lebenszyklus und die Beobachtbarkeit von Oracle-Datenbanken automatisiert. Sie vereinfacht komplexe Aufgaben wie Patching, Sicherung und Wiederherstellung, sodass zustandsorientierte Oracle-Arbeitslasten in einer containerisierten Umgebung einfacher ausgeführt werden können.
- Datenbankinstanz: Die containerisierte Oracle Single Instance Database (SIDB) mit nichtflüchtigem Speicher.
- Harbor: Die private Container-Registry, die zum Hosten der Datenbank-, Operator- und Client-Images in der Air-Gap-Umgebung verwendet wird.
- Cert-manager: Der Operator verwendet
cert-managerzum Verwalten von Webhook-Zertifikaten.cert-managerist auf GDC-Standardclustern vorinstalliert.
In dieser Anleitung stellen Sie den Operator in einem eigenen Namespace (oracle-database-operator-system) und die Datenbankinstanz in einem separaten Namespace (oracle-db) bereit. Diese Namespaces sind im Architekturdiagramm mit gestrichelten Rahmen dargestellt.
Diese Trennung wird aus Gründen der Übersichtlichkeit und Verwaltbarkeit empfohlen. Es liegt jedoch bei Ihnen, wie Sie Ihre Datenbanken organisieren. Sie können beispielsweise bestimmte Datenbanken in verschiedenen Namespaces gruppieren, um eine detaillierte Zugriffssteuerung (RBAC) basierend auf den Anforderungen der Arbeitslast, der Teamzugehörigkeit oder den Sicherheitsspezifikationen zu verwalten.
Hinweis
Bevor Sie mit der Bereitstellung beginnen, müssen Sie dafür sorgen, dass Ihre Umgebung die folgenden Anforderungen erfüllt:
- Erstellen Sie ein Projekt, das als Container für alle Ressourcen dient, die in diesem Leitfaden generiert werden.
Weisen Sie Ihrem Nutzer die Rollen „Cluster-Administrator“ und „Standard-Cluster-Administrator“ für Ihr Projekt zu. So können Sie einen Standard-Kubernetes-Cluster erstellen und seine Ressourcen verwalten:
export PROJECT_ID=PROJECT_ID
export USER_NAME=USER_NAME

gdcloud projects add-iam-policy-binding ${PROJECT_ID} \
  --member="user:${USER_NAME}" \
  --role=cluster-admin

gdcloud projects add-iam-policy-binding ${PROJECT_ID} \
  --member="user:${USER_NAME}" \
  --role=standard-cluster-admin
Erstellen Sie eine Harbor-Instanz und ein Harbor-Projekt, um die für diesen Leitfaden erforderlichen Container-Images zu hosten.
Weisen Sie Ihrem Nutzer die Rolle „Harbor Instance Admin“ zu, damit Sie Images in Ihre Harbor-Instanz hochladen können:
gdcloud projects add-iam-policy-binding ${PROJECT_ID} \
  --member="user:${USER_NAME}" \
  --role=harbor-instance-admin
Erstellen Sie in Ihrem Harbor-Projekt ein Harbor-Roboterkonto. Später in diesem Leitfaden werden die Anmeldedaten des Roboterkontos in Kubernetes-Secrets gespeichert, damit der Cluster beim Instanziieren von Containern Images aus Harbor abrufen kann.
Erstellen Sie einen Standard-Kubernetes-Cluster mit zwei Worker-Knoten, die jeweils mindestens 16 GB Arbeitsspeicher haben. Beispiel:
kubectl --kubeconfig MGMT_API_KUBECONFIG create -f - <<EOF
apiVersion: cluster.gdc.goog/v1
kind: Cluster
metadata:
  name: ${CLUSTER_NAME}
  namespace: ${PROJECT_ID}
spec:
  nodePools:
  - machineTypeName: n3-standard-8-gdc
    nodeCount: 2
    name: ${CLUSTER_NAME}-node-pool
EOF
Richten Sie die Umgebungsvariablen ein. Diese werden im gesamten Leitfaden zum Erstellen und Verweisen auf Ressourcen verwendet:
# General info
export PROJECT_ID="PROJECT_ID"
export ZONE="ZONE"
export ORG_NAME="ORG_NAME"
export CLUSTER_NAME="CLUSTER_NAME"

# Oracle operator settings
export ORACLE_OPERATOR_VERSION="2.1.0"
export ORACLE_DB_VERSION="23.26.1.0"
export ORACLE_OPERATOR_NAMESPACE="ORACLE_DBS_OPERATOR-SYSTEM"

# Harbor config
export HARBOR_INSTANCE_PROJECT_ID="HARBOR_PROJECT_ID"
export HARBOR_INSTANCE_NAME="HARBOR_INSTANCE_NAME"
export HARBOR_INSTANCE_URL="HARBOR_INSTANCE_URL"
export HARBOR_PROJECT="HARBOR_PROJECT"
export HARBOR_PULL_SECRET_NAME="HARBOR_PULL_SECRET_NAME"
export HARBOR_ROBOT_ACCOUNT="robot\$HARBOR_PROJECT+ROBOT_NAME"
export HARBOR_ROBOT_SECRET="HARBOR_ROBOT_SECRET"

# Oracle database config
export ADMIN_PASSWORD="ADMIN_PASSWORD"
export DB_NAMESPACE="DB_NAMESPACE"
export DB_NAME="DB_NAME"
Netzwerkhinweis: In diesem Leitfaden wird davon ausgegangen, dass er von einem Bastion-Knoten ausgeführt wird, der Zugriff auf die GDC APIs und das Internet hat, um die Manifeste und Container-Images des Oracle-Operators herunterzuladen. Wenn Sie dies auf einem Computer ohne Internetzugriff ausführen, müssen Sie diese Assets separat abrufen (z. B. mit
docker save, um Images von einem verbundenen Computer zu exportieren, und mitdocker load, um sie zu importieren) und sie sicher in Ihre Umgebung hochladen, bevor Sie fortfahren.Erstellen Sie ein Konto und rufen Sie ein API-Token unter container-registry.oracle.com ab. Akzeptieren Sie dann die Lizenzvereinbarung für die Images Oracle Database Enterprise Edition und Oracle Instant Client, bevor Sie fortfahren.
Images in Harbor laden
Da Cluster in Google Distributed Cloud mit Air Gap nicht auf externe Registries zugreifen können, müssen Sie die erforderlichen Images in Ihre private Harbor-Instanz spiegeln.
In Oracle Container Registry anmelden
Sie müssen sich zuerst bei der offiziellen Oracle-Registry authentifizieren, um die Basis-Images abzurufen:
docker --config=./docker-oracle login container-registry.oracle.com
Nach erfolgreicher Anmeldung werden die Anmeldedaten in ./docker-oracle/config.json gespeichert.
Images in Harbor laden
Authentifizieren Sie sich mit Ihrer privaten Harbor-Instanz:
docker --config=./docker-harbor login ${HARBOR_INSTANCE_URL} \
  -u ${HARBOR_ROBOT_ACCOUNT} \
  -p ${HARBOR_ROBOT_SECRET}
Nach einer erfolgreichen Anmeldung werden die Anmeldedaten des Roboterkontos in ./docker-harbor/config.json gespeichert.
Images abrufen, taggen und per Push übertragen
Laden Sie die Images aus der offiziellen Oracle Container Registry herunter und übertragen Sie sie per Push in Ihr internes Harbor-Projekt. Sie spiegeln den Operator, die Enterprise-Datenbank und den Instant Client zu Testzwecken.
Spiegeln Sie das Oracle Database Operator-Image:
docker --config=./docker-oracle pull \
  container-registry.oracle.com/database/operator:${ORACLE_OPERATOR_VERSION} \
  --platform linux/amd64
docker tag container-registry.oracle.com/database/operator:${ORACLE_OPERATOR_VERSION} \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-operator:${ORACLE_OPERATOR_VERSION}
docker --config=./docker-harbor push \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-operator:${ORACLE_OPERATOR_VERSION}
Spiegeln Sie das Image Oracle Database Enterprise:
docker --config=./docker-oracle pull \
  container-registry.oracle.com/database/enterprise:${ORACLE_DB_VERSION} \
  --platform linux/amd64
docker tag container-registry.oracle.com/database/enterprise:${ORACLE_DB_VERSION} \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-enterprise:${ORACLE_DB_VERSION}
docker --config=./docker-harbor push \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-enterprise:${ORACLE_DB_VERSION}
Spiegeln Sie das Oracle Instant Client-Image:
docker --config=./docker-oracle pull container-registry.oracle.com/database/instantclient:latest \
  --platform linux/amd64
docker tag container-registry.oracle.com/database/instantclient:latest \
  ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-instantclient:latest
docker --config=./docker-harbor push ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-instantclient:latest
Clusterzugriff konfigurieren
Bevor Sie Ressourcen bereitstellen, rufen Sie die Anmeldedaten für Ihren Standardcluster ab und erstellen Sie einen Alias:
Rufen Sie die kubeconfig-Datei für Ihren Standardcluster ab:
KUBECONFIG=kubeconfig-${CLUSTER_NAME}.yaml gdcloud clusters \
  get-credentials ${CLUSTER_NAME} \
  --standard \
  --project ${PROJECT_ID} \
  --zone ${ZONE}
Erstellen Sie den Alias
kk, um nachfolgende Befehle zu vereinfachen:alias kk="kubectl --kubeconfig kubeconfig-${CLUSTER_NAME}.yaml"
Secrets erstellen
Erstellen Sie ein Kubernetes-Secret, damit der Cluster Images aus Harbor mit den in Ihrer lokalen ./docker-harbor/config.json gespeicherten Anmeldedaten abrufen kann. Sie benötigen dieses Secret sowohl im Namespace des Operators (zum Abrufen des Operator-Images) als auch im Namespace der Datenbank (zum Abrufen des Datenbank-Images).
Erstellen Sie den Namespace für den Operator:
kk create ns ${ORACLE_OPERATOR_NAMESPACE}Erstellen Sie das Pull-Secret für den Operator:
kk create secret docker-registry ${HARBOR_PULL_SECRET_NAME} \
  --from-file=.dockerconfigjson=./docker-harbor/config.json \
  -n ${ORACLE_OPERATOR_NAMESPACE}
Erstellen Sie den Namespace für die Datenbank:
kk create ns ${DB_NAMESPACE}Erstellen Sie das Pull-Secret für die Datenbank:
kk create secret docker-registry ${HARBOR_PULL_SECRET_NAME} \
  --from-file=.dockerconfigjson=./docker-harbor/config.json \
  -n ${DB_NAMESPACE}
Oracle Database Operator installieren
Installieren Sie jetzt den Oracle Database Operator in Ihrem Cluster, indem Sie drei Manifeste anwenden:
ClusterRoleBinding: Richtet die erforderlichen Berechtigungen für den Operator ein, damit er clusterweit funktioniert.
kk apply -f https://raw.githubusercontent.com/oracle/oracle-database-operator/refs/tags/v${ORACLE_OPERATOR_VERSION}/rbac/cluster-role-binding.yamlKnoten-RBAC: Gewährt Berechtigungen zum Lesen der Knotentopologie, was für die korrekte Pod-Planung entscheidend ist.
kk apply -f https://raw.githubusercontent.com/oracle/oracle-database-operator/refs/tags/v${ORACLE_OPERATOR_VERSION}/rbac/node-rbac.yamlOperator-Bereitstellung: Stellt die Operator-Pods und benutzerdefinierten Ressourcendefinitionen (CRDs) bereit. Mit diesem Befehl wird das offizielle Manifest heruntergeladen, der Image-Pfad durch Ihre Harbor-URL ersetzt, die
imagePullSecrets-Konfiguration eingefügt, damit sich Kubernetes bei Harbor authentifizieren kann, und das Ergebnis angewendet:curl -L https://raw.githubusercontent.com/oracle/oracle-database-operator/refs/tags/v${ORACLE_OPERATOR_VERSION}/oracle-database-operator.yaml \ | sed "s|container-registry.oracle.com/database/operator:latest|${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-operator:${ORACLE_OPERATOR_VERSION}|g" \ | awk "/terminationGracePeriodSeconds: 10/{print; print \" imagePullSecrets:\n - name: ${HARBOR_PULL_SECRET_NAME}\"; next}1" \ | kk apply -f -Warten Sie, bis die Operator-Pods ausgeführt werden:
kk get pods -n ${ORACLE_OPERATOR_NAMESPACE} --watchDie Ausgabe sollte so aussehen:
NAME                                                           READY   STATUS    RESTARTS   AGE
oracle-database-operator-controller-manager-5f7b56874d-k9v4z   1/1     Running   0          45s
oracle-database-operator-controller-manager-5f7b56874d-n2x8m   1/1     Running   0          45s
oracle-database-operator-controller-manager-5f7b56874d-r6z7q   1/1     Running   0          45s
Neue Datenbankinstanz bereitstellen
Wenn der Operator ausgeführt wird, können Sie eine Oracle-Datenbank mit einer einzelnen Instanz bereitstellen. In diesem Leitfaden wird eine einfache Enterprise-Version-Instanz erstellt, die für die Entwicklung oder für Tests geeignet ist.
Erstellen Sie ein Kubernetes-Secret, um das Administratorpasswort der Datenbank zu speichern:
kk create secret generic oracle-db-password \
  --from-literal=password=${ADMIN_PASSWORD} \
  -n ${DB_NAMESPACE}
Wenden Sie das Manifest
SingleInstanceDatabasean, um die Datenbank zu erstellen:apiVersion: database.oracle.com/v4 kind: SingleInstanceDatabase metadata: name: ${DB_NAME} namespace: ${DB_NAMESPACE} spec: sid: ORCLCDB pdbName: ORCLPDB1 edition: enterprise replicas: 1 image: pullFrom: ${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-enterprise:${ORACLE_DB_VERSION} pullSecrets: ${HARBOR_PULL_SECRET_NAME} prebuiltDB: true persistence: size: 50Gi storageClass: standard-rwo accessMode: ReadWriteOnce adminPassword: secretName: oracle-db-password secretKey: passwordWichtige Konfigurationsparameter:
sid/pdbName: Definiert die Systemkennung (SID) und den Namen der steckbaren Datenbank (PDB).edition: Gibt die Datenbankversion an (in diesem Fallenterprise).image: Verweist auf das Image Ihrer privaten Harbor-Registry.persistence: Fordert ein nichtflüchtiges Volume mit 50 GiB mithilfe der StorageClassstandard-rwoan, die einen zonalen nichtflüchtigen Speicher in GDC erstellt.replicas: Legt die Anzahl der Pods auf1fest.1ist zwar typisch für eine einzelne Instanz, Sie können diesen Wert jedoch für bestimmte Anwendungsfälle erhöhen, z. B. für rollierende Updates (bei denen ein neuer Pod erstellt wird, bevor der alte beendet wird) oder wenn Sie ein freigegebenes Speicher-Backend verwenden, das gleichzeitigen Zugriff unterstützt. Für einfache Bereitstellungen mit einer einzelnen Instanz ist1der Standard.
Eine vollständige Liste der Konfigurationsoptionen, einschließlich benutzerdefinierter Initialisierungsparameter und Ressourcenlimits, finden Sie in der offiziellen Dokumentation.
Die Datenbankerstellung ist ressourcenintensiv und kann 10 bis 20 Minuten dauern.
Warten Sie, bis der Datenbank-Pod
Runningist:kk get po -n ${DB_NAMESPACE} -l app=${DB_NAME} -wDie Ausgabe sollte so aussehen:
NAME                   READY   STATUS    RESTARTS   AGE
my-db-i5xdj   0/1     Pending   0          0s
my-db-i5xdj   0/1     Pending   0          0s
my-db-i5xdj   0/1     Pending   0          1s
my-db-i5xdj   0/1     Init:0/1   0          1s
my-db-i5xdj   0/1     PodInitializing   0          98s
my-db-i5xdj   0/1     Running           0          99s
my-db-i5xdj   1/1     Running           0          99s
Beobachten Sie dann die Logs und warten Sie auf die Meldung
DATABASE IS READY TO USE!:kk logs -n ${DB_NAMESPACE} -l app=${DB_NAME} -fDie Ausgabe sollte Folgendes enthalten:
#########################
DATABASE IS READY TO USE!
#########################
Prüfen Sie, ob der Status
Healthylautet:kk get singleinstancedatabase -n ${DB_NAMESPACE}Die Ausgabe sollte so aussehen:
NAME    EDITION      STATUS    ROLE
my-db   Enterprise   Healthy   PRIMARY
Auf die Datenbank zugreifen und sie freigeben
Standardmäßig erstellt der Operator zwei Dienste für die Datenbank:
${DB_NAME}(ClusterIP): für internen Traffic innerhalb des Clusters. Verwenden Sie diesen stabilen DNS-Namen für Anwendungen, die im selben Cluster ausgeführt werden.${DB_NAME}-ext(NodePort): für den externen Zugriff. Standardmäßig wird die Datenbank dadurch auf einem hohen Port auf jedem Knoten bereitgestellt. Sie können ein Upgrade auf einen Load-Balancer-Dienst durchführen, indem SieloadBalancer: truein derSingleInstanceDatabase-Spezifikation festlegen.
Weitere Informationen zum Anpassen dieser Dienste, z. B. zum Definieren bestimmter NodePorts, finden Sie in der GitHub-Dokumentation.
Wählen Sie je nach Bedarf eine der folgenden Methoden für den Zugriff auf Ihre Datenbank aus. Weitere Informationen zu GDC-Diensttypen finden Sie unter Dienste verfügbar machen.
Zugriff innerhalb des Clusters (ClusterIP)
Wenn Sie von anderen Pods, die im selben Kubernetes-Cluster ausgeführt werden, auf die Datenbank zugreifen möchten, verwenden Sie den Dienst ClusterIP.
- Um dies sicher zu überprüfen, stellen Sie eine direkte Verbindung von einem temporären Client-Pod her.
- Prüfen Sie die verfügbaren Dienste in Ihrem Namespace. Notieren Sie sich den
ClusterIP-Dienst mit dem Namen${DB_NAME}(z. B.my-db). Dieser Name dient als Hostname für interne Verbindungen. Stellen Sie einen temporären Pod mit dem SQL*Plus-Client bereit. Sie verwenden das Image
instantclient, das in Ihrer Harbor-Registry gespiegelt ist:kk run sqlplus-client -n ${DB_NAMESPACE} --rm -it --restart=Never \ --image=${HARBOR_INSTANCE_URL}/${HARBOR_PROJECT}/oracle-instantclient:latest \ --image-pull-policy=Always \ --overrides='{"spec": {"imagePullSecrets": [{"name": "'${HARBOR_PULL_SECRET_NAME}'"}]}}' \ -- sqlplus sys/${ADMIN_PASSWORD}@${DB_NAME}:1521/ORCLPDB1 as sysdbaDie SQL-Eingabeaufforderung sollte angezeigt werden, was auf eine erfolgreiche Verbindung hinweist.
Erstellen Sie eine Beispieltabelle, um den Schreibzugriff zu prüfen:
CREATE TABLE employees (id NUMBER, name VARCHAR2(50));
INSERT INTO employees VALUES (1, 'John Doe');
COMMIT;
SELECT * FROM employees;
Die Ausgabe sollte so aussehen:
        ID NAME
---------- --------------------------------------------------
        1 John Doe
Beenden Sie die Sitzung:
exit
Zugriff innerhalb der VPC (interner Load Balancer)
Wenn Sie die Datenbank für andere Ressourcen (z. B. VMs) im selben GDC-Projekt oder in derselben VPC, aber außerhalb des Kubernetes-Clusters verfügbar machen möchten, verwenden Sie einen internen Load Balancer. Dadurch bleibt der Traffic in Ihrer isolierten Netzwerkumgebung privat. Weitere Informationen finden Sie in der Dokumentation zum internen Load Balancer von GDC.
Da der Operator das Hinzufügen von Annotationen zum generierten Dienst nicht automatisch unterstützt, müssen Sie eine separate Dienstressource erstellen. Beachten Sie die Annotation networking.gke.io/load-balancer-type: internal, die für die Bereitstellung eines internen Load Balancers erforderlich ist.
Erstellen Sie den internen Load Balancer-Dienst:
apiVersion: v1
kind: Service
metadata:
  name: ${DB_NAME}-internal
  namespace: ${DB_NAMESPACE}
  annotations:
    networking.gke.io/load-balancer-type: internal
spec:
  type: LoadBalancer
  selector:
    app: ${DB_NAME}
  ports:
  - name: sqlnet
    port: 1521
    targetPort: 1521
Rufen Sie die interne IP-Adresse ab:
export DB_INT_IP=$(kk get svc ${DB_NAME}-internal -n ${DB_NAMESPACE} \
  -o jsonpath='{.status.loadBalancer.ingress[0].ip}')
echo "Database Internal IP: ${DB_INT_IP}"
Zugriff von außerhalb der VPC (externer Load Balancer)
Wenn Sie die Datenbank für Clients außerhalb der GDC-Umgebung oder VPC (z. B. aus einem Unternehmensnetzwerk oder von einem externen Client) verfügbar machen möchten, können Sie einen externen Load Balancer verwenden. Dadurch wird eine IP-Adresse zugewiesen, die von außerhalb der isolierten VPC-Grenze erreichbar ist. Weitere Informationen finden Sie in der Dokumentation zum externen Load Balancer von GDC.
Wenn Sie einen externen Load Balancer erstellen möchten, aktualisieren Sie die Spezifikation SingleInstanceDatabase, um loadBalancer: true festzulegen. Dadurch wird der vorhandene Diensttyp ${DB_NAME}-ext von NodePort in LoadBalancer geändert.
Aktualisieren Sie die Spezifikation:
kk patch sidb ${DB_NAME} -n ${DB_NAMESPACE} --type='merge' \
  -p '{"spec":{"loadBalancer":true}}'
Rufen Sie die externe IP-Adresse ab:
export DB_EXT_IP=$(kk get svc ${DB_NAME}-ext -n ${DB_NAMESPACE} \
  -o jsonpath='{.status.loadBalancer.ingress[0].ip}')
echo "Database External IP: ${DB_EXT_IP}"
Nächste Schritte
- Referenzarchitektur für selbstverwaltete Oracle-Datenbanken
- Hochverfügbare, selbstverwaltete Oracle-Datenbanken bereitstellen