


Definição do problema
As organizações que executam modelos de linguagem grandes (LLMs) em ambientes com isolamento físico
acumulam rapidamente endpoints de modelo: cada modelo de peso aberto disponibilizado no
Google Distributed Cloud (GDC) com isolamento físico (consulte o guia complementar "Modelos de peso aberto
no GDC com isolamento físico") expõe o próprio Service do Kubernetes,
o próprio endereço, as próprias credenciais e o próprio ciclo de vida operacional.
Os desenvolvedores de aplicativos e agentes acabam em silos arquitetônicos, codificando um endpoint por modelo e reescrevendo integrações a cada iteração de modelo. Essa
fragmentação cria dívida técnica e atrasa a implantação de
cargas de trabalho de agentes de várias etapas essenciais para a missão.
As camadas de rede padrão também são "cegas para IA": um balanceador de carga convencional
trata o tráfego de inferência como HTTP genérico e não consegue ler o campo model de uma
solicitação, priorizar cargas de trabalho sensíveis à latência, considerar tokens em vez de
solicitações ou direcionar uma solicitação para a réplica do servidor de modelos que já contém o
cache de KV relevante. Em clusters de GPU com isolamento físico de alto custo, isso leva à subutilização do hardware
e a um retorno do investimento ruim. Embora o Gemini no
GDC
ofereça modelos de fronteira gerenciados, os clientes que os combinam com modelos de pesos abertos
auto-hospedados precisam de uma camada de inferência que ofereça agilidade semelhante à da nuvem
sem comprometer a soberania dos dados: nenhuma solicitação, comando ou peso de modelo pode
sair do limite do GDC.
Solução proposta
Este documento descreve a arquitetura de referência para um gateway de IA autogerenciado
no GDC com isolamento físico: uma camada de inferência segura e centralizada
que fornece aos aplicativos um endpoint compatível com a OpenAI para todos os modelos e roteia
cada solicitação para o back-end correto. A implementação de referência se baseia na API Gateway do Kubernetes: o Envoy Gateway é a implementação da API Gateway (plano de controle e plano de dados do proxy do Envoy), e o Envoy Agent Router (antigo Envoy AI Gateway) a estende com o processamento de solicitações específico de IA: extração de modelo do corpo da solicitação, tradução de solicitação e resposta, autenticação upstream, contabilização de tokens e, opcionalmente, limitação de taxa baseada em tokens. A extensão de inferência da API Gateway adiciona a seleção de endpoints com reconhecimento de servidor de modelos (InferencePool e seletor de endpoints) para que a capacidade da GPU seja usada de maneira eficiente. Todos os artefatos são
armazenados em stage no registro do Harbor da organização do GDC,
e toda a pilha é executada em um cluster padrão sem nenhuma conectividade
externa.
O que está incluído: essa arquitetura abrange a implantação do Envoy Gateway
e do Envoy Agent Router em um cluster padrão, os recursos da API Gateway
(GatewayClass, Gateway) e os recursos do Envoy Agent Router (AIGatewayRoute,
AIServiceBackend, BackendSecurityPolicy, GatewayConfig) que expõem um
endpoint unificado compatível com a OpenAI, roteamento baseado em corpo no campo model, a
extensão de inferência da API Gateway (InferencePool, InferenceObjective, seletor de
endpoints) para balanceamento de carga com reconhecimento de modelo, limitação de taxa opcional baseada em token com
o Redis, encerramento de TLS no gateway, políticas de rede (NetworkPolicy /
ProjectNetworkPolicy) e o gerenciamento de artefatos com isolamento físico no Harbor. Os
back-ends de disponibilização do modelo por trás do gateway (Ollama, vLLM) são implantados com o
conjunto de guias complementares Modelos de pesos abertos no GDC
com isolamento físico.
O que não está incluído: essa arquitetura não abrange um produto de gateway de IA gerenciado, a implantação e o ajuste dos modelos em si (conjunto de guias complementares), o ajuste fino de modelos, modalidades de IA generativa que não sejam LLM, tráfego de agente para ferramenta (MCPRoute) ou distribuições de gateway com suporte comercial. O Gemini no
GDC é uma experiência no produto gerenciada. O provisionamento dele está
fora do escopo, e esta versão do conjunto de guias valida o gateway com
modelos de peso aberto auto-hospedados.
Público-alvo: o público-alvo principal deste documento inclui administradores de plataforma responsáveis por implantar e operar o gateway em um cluster padrão e arquitetos técnicos que projetam plataformas de IA no ambiente com isolamento físico. Os desenvolvedores de aplicativos que consomem o endpoint unificado são um público-alvo secundário que se beneficia de entender como as solicitações são roteadas.
Arquitetura
A solução é executada inteiramente em um cluster padrão da
organização do GDC com isolamento físico. Na camada de serviços, a
API Kubernetes Gateway padroniza o modelo de configuração. O plano de controle
do gateway de IA (o controlador do Envoy Gateway e o controlador do Envoy Agent Router)
lê os recursos da API Gateway e do Envoy Agent Router e
configura o plano de dados: um proxy Envoy Deployment que é o ponto de entrada
da solicitação (exposto por um Service do tipo LoadBalancer) e o processador externo
do Envoy Agent Router que é executado como um arquivo secundário no proxy Pod e executa
a lógica específica de IA. Na camada do aplicativo, as cargas de trabalho do cliente
(aplicativos e agentes) enviam uma solicitação de IA ao proxy (1), que entrega
a solicitação ao processador externo, que extrai o nome do modelo, traduz
a solicitação e registra o uso de tokens (2). O proxy encaminha o tráfego balanceado
para os Pods de inferência do modelo selecionado (3), e o modelo é executado nos nós de GPU
da camada de infraestrutura (4). Os back-ends de disponibilização de modelos são anexados ao
gateway como um AIServiceBackend (qualquer Service compatível com a OpenAI) ou
como um InferencePool cujo seletor de endpoint escolhe a melhor réplica por
solicitação. As imagens de contêiner e os gráficos do Helm são extraídos do Harbor.
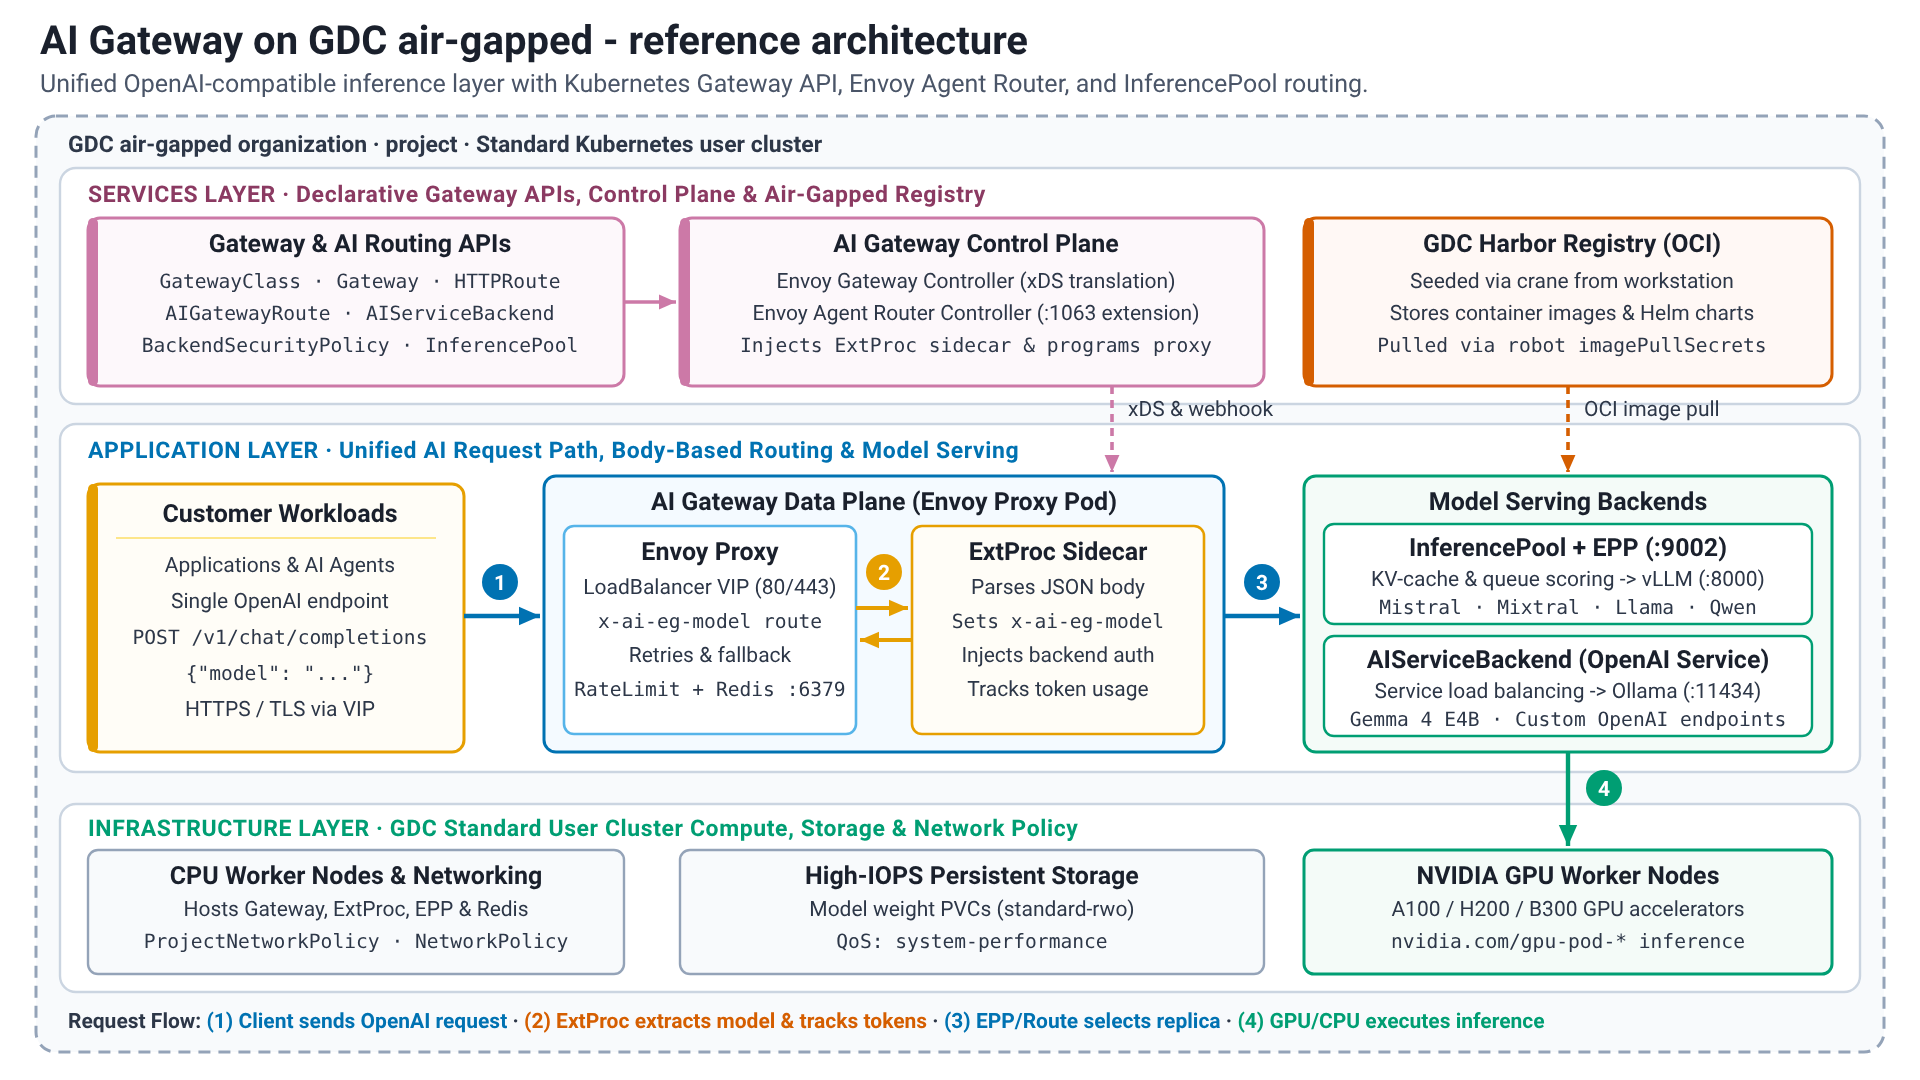
Componentes da solução
A solução usa os seguintes componentes:
| Componente da solução | Responsabilidades | Fluxo de dados | Interfaces |
|---|---|---|---|
| API Kubernetes Gateway | Modelo de recurso padrão orientado a papéis para entrada e roteamento: GatewayClass (propriedade da plataforma), Gateway (listeners, TLS) e recursos de rota (propriedade das equipes de aplicativos). Sucessora da API Ingress sem anotações específicas do fornecedor. |
Somente configuração declarativa. Os recursos são monitorados pelos controladores e não transportam tráfego de solicitação. | API do Kubernetes (gateway.networking.k8s.io/v1). Os CRDs são instalados do gráfico de CRD do Envoy Gateway. |
| Controlador do Envoy Gateway (plano de controle) | Implementa a API Gateway: provisiona um proxy Envoy Deployment e LoadBalancer Service por Gateway, traduz rotas e políticas (BackendTrafficPolicy, SecurityPolicy, EnvoyExtensionPolicy, Backend, EnvoyProxy) para a configuração xDS, executa o serviço de limitação de taxa global quando configurado e chama o servidor de extensão do roteador do agente Envoy pelo gerenciador de extensões para que os back-ends InferencePool sejam adicionados à tradução. |
Observa a API Kubernetes e envia a configuração xDS para os proxies. Sem tráfego de solicitação. | API do Kubernetes (watch), xDS gRPC para os proxies, gRPC para o servidor de extensão (porta 1063). |
| Controlador do roteador do agente Envoy (plano de controle) | Reconcilia os recursos aigateway.envoyproxy.io/v1beta1, AIGatewayRoute (regras de rota no nome do modelo extraído), AIServiceBackend (um back-end com o esquema de API), BackendSecurityPolicy (credenciais upstream) e GatewayConfig (configurações do processador externo por Gateway) em recursos do Envoy Gateway, injeta o arquivo secundário do processador externo nos Pods do proxy do Envoy e disponibiliza o servidor de extensão usado pelo Envoy Gateway. |
Somente configuração. | API Kubernetes, servidor de extensão gRPC (porta 1063), webhook de admissão de mutação para a injeção de sidecar. |
| Proxy do Envoy (plano de dados) | Ponto de entrada de solicitação: encerra o TLS, corresponde a listeners e rotas, equilibra a carga entre endpoints de back-end, aplica limites de taxa e tempos limite, tenta novamente e volta para back-ends alternativos e emite registros de acesso e métricas. | Recebe solicitações de clientes no VIP LoadBalancer (80/443), consulta o processador externo para cada solicitação de IA, encaminha a solicitação para o endpoint de back-end selecionado (um Service ou o Pod escolhido pelo seletor de endpoint) e transmite a resposta de volta para o cliente. |
HTTP/HTTPS para clientes (API compatível com OpenAI), ext_proc gRPC para o sidecar e o seletor de endpoints, HTTP para os back-ends, gRPC para o serviço de limitação de taxa. |
| Processador externo do roteador do agente Envoy (ExtProc) | Analisa o corpo da solicitação compatível com a OpenAI, extrai o campo model para o cabeçalho de roteamento x-ai-eg-model, aplica substituições de nome de modelo, traduz payloads de solicitação e resposta entre o esquema de API do cliente e o esquema de API de back-end, injeta as credenciais upstream definidas por BackendSecurityPolicy e extrai o uso de tokens (entrada, saída, total) da resposta para metadados dinâmicos usados para limitação de taxa e métricas baseadas em tokens. |
Contêiner secundário no proxy Envoy Pod; processa corpos de solicitação e resposta, incluindo respostas transmitidas. |
gRPC ext_proc do Envoy; endpoint de métricas do Prometheus. |
| Extensão de inferência da API Gateway (InferencePool + seletor de endpoint) | InferencePool (inference.networking.k8s.io/v1) agrupa os Pods de uma implantação de servidor de modelos (seletor de rótulos, porta de destino, por exemplo, 8000) e faz referência ao seletor de endpoints (EPP, na sigla em inglês). InferenceObjective (v1alpha2) atribui uma prioridade por modelo ou objetivo. O EPP coleta as métricas do servidor de modelos (profundidade da fila de solicitações, uso do cache KV, adaptadores LoRA carregados) e seleciona o endpoint para cada solicitação. |
O proxy chama o EPP (ext_proc, porta 9002) com os cabeçalhos da solicitação. O EPP responde com o endpoint a ser usado. O proxy encaminha a solicitação para esse Pod. |
API Kubernetes (CRDs), gRPC ext_proc (9002), coleta do Prometheus dos servidores de modelos. |
| Redis (opcional) | Armazenamento de apoio do serviço de limitação de taxa do Envoy: contadores compartilhados para limites baseados em solicitações e tokens em todas as réplicas de proxy. Necessário apenas quando a limitação de taxa global está configurada. | O serviço de limitação de taxa lê e incrementa contadores na porta 6379 para cada solicitação limitada. | Protocolo Redis (6379). Redis 8.10 implantado no cluster ou uma instância do Redis. |
| Back-ends de disponibilização de modelos (Ollama / vLLM) | Disponibilize os modelos de peso aberto por trás do gateway, implantados com o guia complementar "Definir modelos de peso aberto no GDC com isolamento físico". Anexado como um AIServiceBackend (qualquer Service compatível com a OpenAI, por exemplo, Ollama) ou como um InferencePool (servidores de modelos, como o vLLM, que expõem as métricas que o seletor de endpoints pontua). |
Recebe as solicitações roteadas do proxy, executa a inferência nos nós de GPU (ou na CPU para avaliação funcional com modelos pequenos) e retorna a resposta compatível com a OpenAI. | API REST compatível com OpenAI: vLLM na porta 8000, Ollama na porta 11434; métricas do Prometheus (vLLM) para o seletor de endpoints. |
| Harbor | Armazena as imagens de contêiner (proxy do Envoy, gateway do Envoy, controlador e processador externo do roteador do agente do Envoy, serviço de limitação de taxa, seletor de endpoints, Redis) e os gráficos do Helm (artefatos OCI) da solução. | Os artefatos são copiados dos registros públicos para o Harbor com seed_registry.sh (crane) de uma estação de trabalho com acesso à Internet. O cluster extrai imagens com uma conta de robô usando secrets de extração de imagem, e os gráficos são renderizados do Harbor com helm template. |
API de distribuição OCI; interface do Harbor e contas de robô. |
| Cluster padrão e nós de GPU | Hospeda todos os componentes do gateway (nós de CPU são suficientes) e os Pods de inferência (nós de GPU com os recursos de acelerador descobertos nos nós). Oferece VIPs de LoadBalancer, armazenamento permanente para os pesos do modelo e aplicação da política de rede. |
Plataforma básica: as solicitações entram pelo VIP LoadBalancer do Gateway e permanecem dentro da rede do cluster. |
API Kubernetes, APIs de rede do GDC (networking.gdc.goog/v1 ProjectNetworkPolicy), console do GDC e gdcloud para o administrador da plataforma. |
Recursos e funcionalidades
Essa arquitetura de referência oferece os seguintes recursos principais:
- Endpoint unificado compatível com a OpenAI: os aplicativos chamam um endereço
(
/v1/chat/completions,/v1/models, …) para cada modelo disponibilizado por trás do gateway.- Componentes:
Gateway,AIGatewayRoute, proxy Envoy, processador externo. - Responsabilidades: expor um IP virtual estável, encerrar o TLS, aceitar o formato de solicitação compatível com a OpenAI e traduzi-lo para o esquema de back-end quando necessário.
- Interfaces: HTTPS REST (JSON, incluindo eventos enviados pelo servidor para streaming).
- Componentes:
- Roteamento baseado no corpo (com reconhecimento de modelo): o gateway lê o campo
modeldo corpo da solicitação e a encaminha para o back-end correspondente sem nenhuma lógica de endpoint do lado do cliente.- Componentes: processador externo, regras de
AIGatewayRoutecorrespondentes ax-ai-eg-model,AIServiceBackend,InferencePool. - Responsabilidades: extrair o nome do modelo, corresponder às regras de rota,
renomear modelos (
modelNameOverride), dividir o tráfego por peso e recorrer a back-ends alternativos por prioridade. - Interfaces: API Kubernetes (
aigateway.envoyproxy.io/v1beta1).
- Componentes: processador externo, regras de
- Balanceamento de carga com reconhecimento de servidor de modelos: as solicitações para um
InferencePoolsão enviadas para a réplica com a fila mais curta e o cache KV mais útil, em vez de round robin.- Componentes: extensão de inferência da API Gateway (
InferencePool,InferenceObjective, seletor de endpoint). - Responsabilidades: extrair métricas do servidor de modelos, pontuar endpoints (profundidade da fila, uso do cache de chave-valor, afinidade do cache de prefixo, adaptadores LoRA) e priorizar objetivos sob carga.
- Interfaces: API Kubernetes (
inference.networking.k8s.io/v1,inference.networking.x-k8s.io/v1alpha2), ext_proc gRPC (9002).
- Componentes: extensão de inferência da API Gateway (
- Políticas de segurança e autenticação upstream: as credenciais para back-ends
que as exigem são injetadas pelo gateway e nunca distribuídas para os
aplicativos.
- Componentes:
BackendSecurityPolicy, Envoy GatewaySecurityPolicy, listeners de TLS. - Responsabilidades: injetar chaves de API nos back-ends, encerrar o TLS do cliente no
Gateway, aplicar políticas de autenticação e autorização do cliente quando necessário. - Interfaces:
Secrets do Kubernetes referenciados pelas políticas.
- Componentes:
- Limitação de taxa baseada em tokens (opcional): o uso é medido em tokens, não
apenas em solicitações.
- Componentes: processador externo (
llmRequestCosts), gateway do EnvoyBackendTrafficPolicy(limitação de taxa global), serviço de limitação de taxa, Redis. - Responsabilidades: extrair tokens de entrada, saída e totais de cada resposta, anexá-los como custos de solicitação, aplicar orçamentos por consumidor ou por modelo em todas as réplicas de proxy.
- Interfaces: API Kubernetes, Redis (6379).
- Componentes: processador externo (
- Gerenciamento de tráfego: os recursos padrão da API Gateway se aplicam ao tráfego de IA.
- Componentes:
Gateway,HTTPRoute,AIGatewayRoute,BackendTrafficPolicy. - Responsabilidades: correspondência baseada em host, caminho e cabeçalho, tempos limite adequados para gerações longas, novas tentativas, divisão de tráfego ponderada e substituição baseada em prioridade entre back-ends.
- Interfaces: API Kubernetes.
- Componentes:
- Observabilidade: as métricas de solicitação, latência e token estão disponíveis para
todos os modelos.
- Componentes: registros de acesso e estatísticas do proxy Envoy, métricas do processador externo (uso de tokens, duração da solicitação, tempo até o primeiro token), métricas do seletor de endpoints.
- Responsabilidades: expor métricas no formato do Prometheus e registros de acesso estruturados que a pilha de observabilidade do GDC ou um Prometheus gerenciado pelo cliente podem extrair.
- Interfaces: endpoints de métricas do Prometheus, registros de saída padrão.
- Gerenciamento de artefatos com isolamento físico: todas as imagens e gráficos são preparados no
Harbor antes da instalação.
- Componentes: Harbor,
seed_registry.sh, contas de robô, secrets de extração de imagem, recursoEnvoyProxy(imagem de proxy e secret de extração). - Responsabilidades: propagar imagens e gráficos Helm da OCI de uma estação de trabalho conectada, fixar versões, renderizar gráficos off-line com
helm template. - Interfaces: API OCI Distribution, API Kubernetes.
- Componentes: Harbor,
Princípios de arquitetura
- Padrões em primeiro lugar: o gateway é configurado pela API Gateway do Kubernetes e pela extensão de inferência dele e se comunica com a API compatível com a OpenAI para aplicativos. Assim, os aplicativos, as rotas e os back-ends permanecem portáteis em todas as implementações de gateway.
- Segurança em primeiro lugar: todos os componentes e a residência de dados residem no limite do GDC com isolamento físico. O término de TLS ocorre no
Gateway, as credenciais de back-end são injetadas pelo gateway e o acesso à rede é restrito com objetosNetworkPolicyeProjectNetworkPolicy. - Soberania de dados: comandos, respostas, pesos de modelos e dados de uso nunca saem da organização do GDC do cliente. Não é necessária conectividade externa para a operação.
- Separação de responsabilidades: a API Gateway orientada a papéis permite que o administrador da plataforma seja proprietário das políticas de
GatewayClass,Gateway, TLS e de rede, enquanto as equipes de aplicativos são proprietárias dos recursosAIGatewayRoute,AIServiceBackendeInferencePoolnos próprios namespaces. - Plano de controle e dados desacoplado: os controladores apenas traduzem a configuração. O caminho da solicitação consiste no proxy do Envoy, no sidecar do processador externo e no seletor de endpoints, que continuam exibindo tráfego se um controlador for reiniciado.
- Aberta e flexível: a arquitetura usa software de código aberto em todo o processo (Envoy Gateway, Envoy Agent Router, extensão de inferência da API Gateway, Ollama, vLLM), e os mesmos recursos da API Gateway podem ser disponibilizados por implementações alternativas.
- Escalonabilidade e desempenho: o plano de dados é escalonado horizontalmente com a adição de réplicas de proxy e verticalmente com o ajuste de CPU e memória. O balanceamento de carga que reconhece o servidor de modelos mantém as GPUs saturadas sem sobrecarregar réplicas individuais.
- Experiência simplificada para o usuário final: um endpoint, um formato de API e uma credencial para cada modelo encurtam o caminho da implantação do modelo até o consumo.
- Resiliência: as verificações de integridade e a replicação do Kubernetes, as novas tentativas do Envoy e o fallback baseado em prioridade entre back-ends mantêm o endpoint disponível quando réplicas de modelos individuais falham.
Considerações
- Escalonabilidade e desempenho:
- Os componentes do gateway são cargas de trabalho somente de CPU. O proxy Envoy
Deploymentde umGatewayé escalonado horizontalmente aumentando a contagem de réplicas (recursoEnvoyProxy) e verticalmente aumentando as solicitações de CPU e memória. A inspeção do corpo pelo processador externo custa CPU proporcional ao tamanho da solicitação e da resposta. As respostas transmitidas são processadas de forma incremental. - O balanceamento de carga que reconhece o servidor de modelos só se aplica a back-ends anexados como
um
InferencePool. Os back-ends anexados como umAIServiceBackendsão balanceados pelo proxy nos endpoints doService. - O gateway não adiciona capacidade de GPU: a capacidade de processamento e a latência são limitadas pelos servidores de modelos. Dimensione as implantações de modelo com o conjunto de guias complementares (vLLM para alta capacidade de processamento, Ollama para facilidade de uso e avaliação somente de CPU).
- As gerações longas precisam de tempos limite de solicitação e inatividade mais longos do que as APIs HTTP típicas. Configure-os nas rotas e políticas, e não nos clientes.
- Os componentes do gateway são cargas de trabalho somente de CPU. O proxy Envoy
- Gerenciamento de recursos:
- Todos os componentes do gateway são executados em nós de CPU e não precisam de acelerador. A tabela a seguir mostra o dimensionamento indicativo para uma implantação funcional. A implementação de referência define as solicitações e os limites exatos. Os valores de produção dependem da taxa de solicitação e dos tamanhos de payload.
- A tabela de portas a seguir lista todas as portas que as políticas de rede precisam admitir.
- O planejamento de GPU pertence às implantações de modelo: os nomes dos recursos do acelerador são descobertos nos nós, conforme descrito no conjunto de guias complementares.
Dimensionamento indicativo dos componentes do gateway (somente CPU)
| Componente | Réplicas | CPU (solicitação) | Memória (solicitação) | Observações |
|---|---|---|---|---|
| Controlador do Envoy Gateway | 1 | 100 milhões a 500 milhões | 256Mi–1Gi | Plano de controle; não está no caminho da solicitação |
| Controlador do roteador do agente do Envoy | 1 | 100 milhões a 500 milhões | 256Mi–512Mi | Plano de controle e servidor de extensão |
Proxy Envoy Pod (proxy + arquivo secundário do processador externo) |
1 a 2 por Gateway |
500m–2 | 512Mi–2Gi | Escalonar com taxa de solicitação e tamanho do payload |
| Selecionador de endpoints | 1 por InferencePool |
100 milhões a 500 milhões | 256Mi–512Mi | Coleta as métricas do servidor de modelos |
| Serviço de limitação de taxa (opcional) | 1 | 100 milhões a 500 milhões | 256Mi–512Mi | Somente com limitação de taxa global |
| Redis (opcional) | 1 | 100 milhões a 500 milhões | 256Mi–1Gi | Somente com limitação de taxa global |
Portas de rede
| Porta | Componente | Finalidade |
|---|---|---|
| 80 / 443 | Proxy Envoy (Gateway listeners) |
Ponto de entrada HTTP/HTTPS no VIP LoadBalancer |
| 1063 | Controlador do roteador do agente do Envoy (servidor de extensão) | Chamadas gRPC do gerenciador de extensões do Envoy Gateway |
| 9002 | Selecionador de endpoints | Chamadas gRPC ext_proc do proxy do Envoy |
| 6379 | Redis | Contadores de limitação de taxa |
| 8000 | vLLM | API e métricas compatíveis com a OpenAI do servidor de modelos |
| 11434 | Ollama | API compatível com Ollama e OpenAI do servidor de modelos |
- Disponibilidade e confiabilidade:
- O proxy e o processador externo são executados no mesmo
Pod. Várias réplicas por trás doLoadBalancerServicemascaram falhas individuais dePod, e os controladores podem ser reiniciados sem interromper o tráfego. - As regras
AIGatewayRoutepodem listar vários back-ends com prioridades para que o gateway use outro conjunto de réplicas ou servidor de modelos quando um back-end estiver com problemas. - O seletor de endpoints é um
Deploymentpor pool. Se ele não estiver disponível, as solicitações para esseInferencePoolvão falhar até que ele volte. Execute-o com solicitações de recursos e sondagens de prontidão e monitore-o como um componente do plano de dados. - O Redis contém apenas contadores de limitação de taxa. Uma interrupção do Redis afeta a limitação de taxa, não o roteamento.
- O proxy e o processador externo são executados no mesmo
- Complexidade operacional:
- Alinhamento de versão entre o Envoy Gateway, o Envoy Agent Router e a extensão de inferência da API Gateway: faça upgrade dos três juntos com a combinação testada (Envoy Gateway 1.8.4, Envoy Agent Router 1.1.0, extensão de inferência da API Gateway 1.5.0).
- Ciclo de vida com isolamento físico: cada imagem e gráfico é propagado novamente no Harbor para
cada upgrade. O recurso
EnvoyProxye os valores do gráfico fixam o registro e o secret de pull. - Duas camadas de configuração:
GatewayClass/Gateway/EnvoyProxyde propriedade da plataforma eAIGatewayRoute/AIServiceBackend/InferencePoolde propriedade da equipe. Integrar um novo modelo significa adicionar uma regra de rota e um back-end, não um novo gateway. - Monitoramento: taxa de solicitação, latência (incluindo o tempo até o primeiro token), uso de tokens por modelo e por consumidor, pontuação do seletor de endpoints e uso de GPU dos servidores de modelos.
InferenceObjectiveainda é uma API Alfa (v1alpha2). Espere mudanças de esquema entre as versões da extensão de inferência.
- Segurança e compliance:
- Toda a solução opera dentro do perímetro de segurança com isolamento físico do GDC.
- As políticas de rede são obrigatórias: um namespace
NetworkPolicyaceita tráfego do proxy para as portas do servidor de modelos (8000, 11434) e para o seletor de endpoints (9002), e umProjectNetworkPolicyaceita o tráfego do cliente para o VIPLoadBalancerquando os consumidores residem fora do projeto. - O término de TLS ocorre no
Gatewaycom um certificado armazenado em umSecretdo Kubernetes. Os clientes só veem o endpoint do gateway. - As credenciais upstream (por exemplo, uma chave de API exigida por um servidor de modelos)
são armazenadas em
Secrets referenciados por umBackendSecurityPolicye injetadas pelo gateway, para que os aplicativos nunca tenham credenciais de back-end. - A limitação de taxa baseada em token limita o consumo de capacidade de GPU cara por consumidor ou por modelo.
- As contas de robô do Harbor e os secrets de extração de imagens do Kubernetes garantem o acesso seguro às imagens de contêiner. O RBAC da API Gateway orientado a papéis separa as responsabilidades da plataforma e do aplicativo.
Decisões de design
As seguintes decisões de design importantes foram tomadas para esta arquitetura de referência:
Decisão 1: implementação do gateway de IA: roteador de agente do Envoy de código aberto no Envoy Gateway versus distribuições alternativas
| Contexto | Decisão importante | Justificativa |
|---|---|---|
| O gateway de IA é a principal escolha arquitetônica com alternativas viáveis, desde opções de código aberto autogerenciadas até ofertas com suporte comercial: (a) Envoy Agent Router no Envoy Gateway (código aberto), (b) kgateway e agentgateway (implementações de API de gateway de código aberto que também lidam com o tráfego do provedor de LLM, ferramentas MCP e comunicação entre agentes em um plano de dados, opcionalmente com suporte do fornecedor da solo.io), (c) Solo Enterprise para agentgateway como a opção premium com suporte comercial. | A implementação de referência usa o roteador de agente do Envoy de código aberto no gateway do Envoy. As alternativas continuam sendo opções válidas por trás dos mesmos recursos da API Gateway. Uma distribuição com suporte comercial é recomendada para ambientes de produção que exigem suporte dedicado do fornecedor. | Vantagens do código aberto: roteamento L7 leve, de alto desempenho e em conformidade com os padrões, sem taxas de licença, ideal para avaliar a solução antes de se comprometer com uma oferta paga. O roteador de agente do Envoy é a opção validada neste conjunto de guias. Desvantagens do código aberto: o suporte é feito com base no melhor esforço pela equipe de soluções e é orientado pela comunidade, o que pode não atender aos ambientes de produção principais. Vantagens premium: contratos de suporte empresarial para o ciclo de vida do gateway e, muitas vezes, recursos agênticos avançados. Desvantagens do Premium: licenciamento pago ou contrato de suporte e um relacionamento adicional com o fornecedor. |
Decisão 2: API Kubernetes Gateway com a extensão de inferência versus Entrada ou uma API de gateway reservada
| Contexto | Decisão importante | Justificativa |
|---|---|---|
| Os endpoints de inferência podem ser expostos com a API Ingress legada, um formato de configuração específico do gateway ou a API Kubernetes Gateway. O balanceamento de carga com reconhecimento de modelo também precisa de uma maneira de descrever os pools de servidores de modelos e as prioridades deles. | A solução padroniza a API Kubernetes Gateway (GatewayClass, Gateway, rotas) implementada pelo Envoy Gateway e a extensão de inferência da API Gateway (InferencePool, InferenceObjective, seletor de endpoints) para roteamento com reconhecimento de modelo. |
A API Gateway é o padrão do Kubernetes que sucede Entrada, é orientada a funções (equipes de plataforma versus equipes de aplicativos) e portátil entre implementações. A extensão de inferência é o padrão da comunidade para roteamento que reconhece o servidor de modelos (profundidade da fila, cache de KV, prioridades) e é compatível com o roteador do agente do Envoy. As distribuições alternativas de gateway implementam as mesmas APIs, o que mantém a Decisão 1 reversível. |
Decisão 3: roteamento baseado no corpo no campo model de solicitações compatíveis com a OpenAI como o endpoint unificado
| Contexto | Decisão importante | Justificativa |
|---|---|---|
Os aplicativos podem abordar modelos por um endpoint por modelo (com base em host ou caminho), por um cabeçalho personalizado definido pelo cliente ou pelo campo model que cada solicitação compatível com a OpenAI já carrega. |
O gateway expõe um endpoint compatível com a OpenAI e rotas no campo model: o processador externo o extrai para o cabeçalho x-ai-eg-model, e as regras AIGatewayRoute correspondem a esse cabeçalho. |
Os clientes e SDKs compatíveis com a OpenAI funcionam sem mudanças e trocam de modelo ao alterar uma string. Os endpoints, as credenciais e o posicionamento do modelo podem mudar sem afetar os aplicativos. As mesmas regras podem mapear um nome de modelo para vários back-ends para divisão de tráfego, fallback ou substituições de nome de modelo. |
Decisão 4: propagação de artefatos com isolamento físico no Harbor versus extrações sob demanda
| Contexto | Decisão importante | Justificativa |
|---|---|---|
| A instalação upstream extrai imagens de contêiner de registros públicos e gráficos do Helm como artefatos OCI sob demanda, o que é impossível em um ambiente com isolamento físico. | Todas as imagens de contêiner (proxy do Envoy, Envoy Gateway, controlador e processador externo do Envoy Agent Router, serviço de limite de taxa, seletor de endpoints, Redis) e os gráficos do Helm do Envoy Gateway e do Envoy Agent Router são propagados em um projeto do Harbor com seed_registry.sh (crane), os gráficos são renderizados off-line com helm template do Harbor, e o recurso EnvoyProxy e os valores do gráfico fixam o registro do Harbor e o secret de pull. |
Uma etapa de propagação repetível e auditável por versão. O cluster nunca precisa de conectividade externa. A fixação de versão torna os upgrades explícitos e reversíveis. |
Decisão 5: limitação de taxa opcional baseada em token com o Redis em comparação com limites baseados apenas em solicitações
| Contexto | Decisão importante | Justificativa |
|---|---|---|
| A capacidade da GPU é consumida por token, não por solicitação. Um limite de contagem de solicitações não pode proteger um modelo compartilhado de alguns comandos muito grandes ou gerações longas. A limitação de taxa global no Envoy Gateway precisa de um armazenamento de contador compartilhado. | A limitação de taxa baseada em tokens é um recurso opcional da arquitetura: o processador externo registra os tokens de entrada, saída e totais por solicitação (llmRequestCosts), um BackendTrafficPolicy aplica o orçamento e uma instância do Redis (Redis 8.10, implantada no cluster ou uma instância atual) armazena os contadores. As implantações sem limitação de taxa não precisam do Redis. |
O uso é medido na unidade que reflete o custo, os orçamentos são aplicados de forma consistente em todas as réplicas de proxy, e a dependência é paga apenas pelos clientes que precisam de cotas. |
Decisão 6: topologia: controle de gateway e plano de dados em um namespace dedicado de um cluster padrão, modelos em namespaces de aplicativos
| Contexto | Decisão importante | Justificativa |
|---|---|---|
| O gateway pode ser executado em um cluster dedicado, em cada namespace de aplicativo ou uma vez por cluster padrão ao lado dos modelos que ele representa. Os modelos de peso aberto no GDC com isolamento físico são implantados em clusters padrão (conjunto de guias complementares). | O plano de controle do Envoy Gateway e do Envoy Agent Router e o plano de dados do proxy do Envoy são executados em um namespace dedicado do cluster padrão que hospeda os modelos. AIGatewayRoute, AIServiceBackend, InferencePool e as implantações de modelo residem nos namespaces do aplicativo e são referenciados entre namespaces. |
As solicitações permanecem dentro da rede do cluster entre o proxy e os Pods do modelo (latência mais baixa, sem balanceadores de carga adicionais), o administrador da plataforma é o proprietário do namespace do gateway, enquanto as equipes de aplicativos são proprietárias das rotas e dos modelos, e o seletor de endpoints pode extrair os servidores de modelos diretamente. Um gateway de cliente por projeto que encaminha para um gateway de servidor central continua sendo uma extensão dessa topologia para consumo em vários projetos. |
Suposições e limitações
- O ambiente do GDC com isolamento físico 1.16.2-hf1 ou mais recente está disponível com um cluster padrão que executa o Kubernetes v1.32.13-gke.400 ou mais recente.
- Há recursos de hardware suficientes (especialmente GPUs) para os back-ends de disponibilização de modelos. Os próprios componentes do gateway são executados em nós de CPU. Modelos reais precisam de GPUs. Modelos pequenos no Ollama podem ser executados na CPU apenas para avaliação funcional.
- A instância do Harbor está configurada e acessível, e uma estação de trabalho com acesso à Internet e conectividade com o ambiente do GDC (API Harbor e Kubernetes) está disponível para propagar imagens e gráficos.
- Os usuários têm as permissões necessárias: papéis de projeto de Leitor de Instância do Harbor
e Administrador de Cluster Standard, além de um
StandardClusterRoleBindingpara o papelcluster-adminno cluster Standard para a instalação com escopo de cluster (CRDs,GatewayClass, namespaces). Consulte a implementação de referência. - Os back-ends de disponibilização de modelos expõem uma API compatível com a OpenAI. Os back-ends
anexados como um
InferencePooltambém expõem as métricas compatíveis com vLLM de que o seletor de endpoints depende. - Limitação: o suporte para os componentes de código aberto (Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension) é feito da melhor maneira possível pela equipe de soluções. O suporte dedicado do fornecedor requer uma distribuição com suporte comercial (Decisão 1).
- Limitação:
InferenceObjectiveé uma API Alfa (inference.networking.x-k8s.io/v1alpha2) e pode mudar entre as versões da extensão de inferência. - Limitação: um VIP
LoadBalancerpara oGatewaye umProjectNetworkPolicysão necessários para consumidores fora do projeto. Dentro do projeto, os clientes no cluster oukubectl port-forwardpodem acessar o gatewayServicediretamente. - Limitação: o Gemini no GDC, o ajuste de modelos, os modelos de IA generativa que não são LLM e a disponibilização de modelos em vários nós estão fora do escopo desta versão da solução.
Fluxo do usuário
Veja a seguir um fluxo de usuário abrangente para o gateway de IA no GDC com isolamento físico: primeiro, o caminho de solicitação em que um desenvolvedor de aplicativos confia e, em seguida, o caminho de configuração que o administrador da plataforma segue.
1. Caminho da solicitação do desenvolvedor
Um aplicativo ou agente precisa apenas do endpoint do gateway, de uma credencial de cliente, se o gateway exigir uma, e do nome do modelo.
- Envie a solicitação: o aplicativo chama
POST /v1/chat/completionsno endpoint do gateway com um corpo JSON compatível com a OpenAI que nomeia o modelo (por exemplo,"model": "gemma"), exatamente como chamaria qualquer serviço compatível com a OpenAI. - Entrar no gateway: a solicitação chega ao VIP
LoadBalancerdoGateway. O proxy do Envoy encerra o TLS e faz a correspondência entre o listener e a rota. - Processar o corpo: o proxy entrega a solicitação ao processador externo do roteador do agente do Envoy, que analisa o corpo, extrai o nome do modelo para o cabeçalho
x-ai-eg-modele traduz o payload para o esquema de back-end, se for diferente. - Selecionar o back-end: a regra
AIGatewayRouteque corresponde ao nome do modelo seleciona umAIServiceBackend(por exemplo, o OllamaService) ou umInferencePool(por exemplo, um conjunto de réplicas vLLM). Para umInferencePool, o seletor de endpoint escolhe a réplica com a fila mais curta e a melhor correspondência de cache de chave-valor. - Encaminhar e responder: o proxy injeta credenciais upstream quando um
BackendSecurityPolicyse aplica, encaminha a solicitação para oPodescolhido, transmite a resposta de volta e permite que o processador externo registre o uso do token, que alimenta as métricas e, quando configurado, o limite de taxa baseado em token. - Trocar de modelo: para usar outro modelo, o desenvolvedor muda a string
model. Não é necessário um novo endpoint, credencial ou biblioteca de cliente.
2. Caminho de configuração do administrador da plataforma
- Inserir artefatos no Harbor: crie as contas de robô do Harbor e copie
as imagens de contêiner e os gráficos do Helm do Envoy Gateway e do Envoy Agent Router
para o Harbor com
seed_registry.shde uma estação de trabalho com acesso à Internet. - Instalar o gateway do Envoy: renderize os gráficos de CRD e do controlador do Harbor
com
helm templatee aplique-os no namespace do gateway. Crie o recursoEnvoyProxyque fixa a imagem do proxy e o secret de pull e verifique o controlador com umGatewayClass,GatewayeHTTPRoutebásicos. - Instalar o roteador do agente do Envoy: instale os CRDs do roteador do agente do Envoy e os
CRDs da extensão de inferência da API Gateway, implante o controlador do roteador do agente do Envoy
e reconfigure o gateway do Envoy para chamar o servidor de extensão (porta
1063) e aceitar back-ends
InferencePool. Opcionalmente, implante o Redis e ative o serviço de limite de taxa global. - Expor o gateway: crie o
GatewayClasse oGatewaycom ouvintes HTTP e HTTPS (certificado TLSSecret), aguarde o VIPLoadBalancere aplique oProjectNetworkPolicypara consumidores fora do projeto. - Anexar modelos: implante os back-ends de disponibilização de modelos com o conjunto de guias complementares e crie recursos
AIServiceBackendparaServices compatíveis com a OpenAI eInferencePool, além de recursos do seletor de endpoints para conjuntos de réplicas compatíveis com vLLM, junto com os objetos de namespaceNetworkPolicy. - Publique a rota: crie o
AIGatewayRoutecom uma regra por nome de modelo (roteamento baseado em corpo) e, quando necessário, objetosBackendSecurityPolicyeBackendTrafficPolicypara credenciais upstream e orçamentos de token. - Validar e operar: chame
/v1/modelse/v1/chat/completionspelo VIP (ou um substitutokubectl port-forward), verifique as métricas do proxy, do processador externo e do seletor de endpoints e entregue os nomes do endpoint e do modelo às equipes de aplicativos. Escalone réplicas de proxy e implantações de modelo de forma independente. Faça upgrade do Envoy Gateway, do Envoy Agent Router e da extensão de inferência juntos.
As etapas detalhadas são fornecidas na implementação de referência do roteador de agente do Envoy e no guia do usuário de roteamento baseado no corpo com o roteador de agente do Envoy.
Outros recursos
- Implementação de referência do roteador de agente do Envoy
- Guia do usuário de roteamento baseado no corpo com o roteador de agente do Envoy
- Arquitetura de referência de LLMs de pesos abertos
- Documentação do roteador de agentes do Envoy
- Gateway do Envoy
- API Kubernetes Gateway
- Extensão de inferência da API Gateway
- Documentação do Google Distributed Cloud com isolamento físico