


문제 기술문
에어 갭 환경에서 대규모 언어 모델 (LLM)을 실행하는 조직은 모델 엔드포인트를 빠르게 누적합니다. Google Distributed Cloud (GDC) 에어 갭에서 제공되는 모든 개방형 가중치 모델 (GDC 에어 갭의 개방형 가중치 모델 설정 도우미 가이드 참조)은 자체 Kubernetes Service, 자체 주소, 자체 사용자 인증 정보, 자체 운영 수명 주기를 노출합니다.
애플리케이션 및 에이전트 개발자는 아키텍처 사일로에 갇혀 모델당 하나의 엔드포인트를 하드 코딩하고 모델 반복마다 통합을 다시 작성하게 됩니다. 이러한 단편화는 기술 부채를 유발하고 미션 크리티컬한 다단계 에이전트 워크로드의 배포를 지연시킵니다.
표준 네트워킹 계층은 'AI를 인식하지 못합니다'. 기존 부하 분산기는 추론 트래픽을 일반 HTTP처럼 취급하며 요청의 model 필드를 읽거나, 지연 시간에 민감한 워크로드의 우선순위를 지정하거나, 요청 대신 토큰을 고려하거나, 관련 KV 캐시를 이미 보유한 모델 서버 복제본으로 요청을 전달할 수 없습니다. 비용이 많이 드는 에어 갭 적용 GPU 클러스터에서는 이로 인해 하드웨어 활용도가 낮아지고 투자수익이 저하됩니다. GDC의 Gemini는 관리형 프런티어 모델을 제공하지만, 이를 자체 호스팅 개방형 가중치 모델과 결합하는 고객은 데이터 주권을 침해하지 않으면서 클라우드와 같은 민첩성을 제공하는 추론 레이어가 필요합니다. 즉, 요청, 프롬프트 또는 모델 가중치가 GDC 경계를 벗어나서는 안 됩니다.
제안된 솔루션
이 문서에서는 GDC 에어 갭의 자체 관리형 AI 게이트웨이에 대한 참조 아키텍처를 간략하게 설명합니다. 이 게이트웨이는 애플리케이션에 모든 모델에 대해 하나의 OpenAI 호환 엔드포인트를 제공하고 각 요청을 올바른 백엔드로 라우팅하는 안전한 중앙 집중식 추론 레이어입니다. 참조 구현은 Kubernetes Gateway API를 기반으로 합니다. Envoy Gateway는 Gateway API 구현 (컨트롤 플레인 및 Envoy 프록시 데이터 영역)이며 Envoy Agent Router (이전의 Envoy AI Gateway)는 요청 본문에서 모델 추출, 요청 및 응답 변환, 업스트림 인증, 토큰 계산, 선택적으로 토큰 기반 비율 제한과 같은 AI 관련 요청 처리로 이를 확장합니다. Gateway API 추론 확장 프로그램은 GPU 용량을 효율적으로 사용할 수 있도록 모델 서버 인식 엔드포인트 선택(InferencePool 및 엔드포인트 선택기)을 추가합니다. 모든 아티팩트는 GDC 조직의 Harbor 레지스트리에 스테이징되며 전체 스택은 외부 연결 없이 표준 클러스터에서 실행됩니다.
포함된 항목: 이 아키텍처는 표준 클러스터의 Envoy Gateway 및 Envoy Agent Router 배포, 통합 OpenAI 호환 엔드포인트를 노출하는 Gateway API 리소스(GatewayClass, Gateway) 및 Envoy Agent Router 리소스(AIGatewayRoute, AIServiceBackend, BackendSecurityPolicy, GatewayConfig), model 필드의 본문 기반 라우팅, 모델 인식 부하 분산을 위한 Gateway API Inference Extension(InferencePool, InferenceObjective, 엔드포인트 선택기), Redis를 사용한 선택적 토큰 기반 비율 제한, 게이트웨이의 TLS 종료, 네트워크 정책(NetworkPolicy/ProjectNetworkPolicy), Harbor의 에어 갭 아티팩트 관리를 다룹니다. 게이트웨이 뒤에 있는 모델 서빙 백엔드 (Ollama, vLLM)는 GDC 에어 갭에서 개방형 가중치 모델 설정 도우미 가이드와 함께 배포됩니다.
포함되지 않는 항목: 이 아키텍처에는 관리형 AI 게이트웨이 제품, 모델 자체의 배포 및 조정 (컴패니언 가이드 세트), 모델 미세 조정, LLM이 아닌 생성형 AI 모달리티, 에이전트-도구 트래픽(MCPRoute) 또는 상업적으로 지원되는 게이트웨이 배포가 포함되지 않습니다. GDC의 Gemini는 관리형 제품 기능입니다. 프로비저닝은 범위에 포함되지 않으며 이 버전의 가이드 세트는 자체 호스팅 개방형 가중치 모델로 게이트웨이를 검증합니다.
대상: 이 문서의 주요 대상에는 표준 클러스터에서 게이트웨이를 배포하고 운영하는 플랫폼 관리자와 에어 갭 환경 내에서 AI 플랫폼을 설계하는 기술 설계자가 포함됩니다. 통합 엔드포인트를 사용하는 애플리케이션 개발자는 요청이 라우팅되는 방식을 이해함으로써 이점을 얻는 보조 대상입니다.
아키텍처
이 솔루션은 GDC 에어 갭 적용형 조직의 표준 클러스터에서 전적으로 실행됩니다. 서비스 레이어에서 Kubernetes Gateway API는 구성 모델을 표준화합니다. AI 게이트웨이 컨트롤 플레인(Envoy Gateway 컨트롤러 및 Envoy Agent Router 컨트롤러)은 Gateway API 및 Envoy Agent Router 리소스를 읽고 데이터 플레인을 구성합니다. 데이터 플레인은 요청 진입점인 Envoy 프록시 Deployment(LoadBalancer 유형의 Service를 통해 노출됨)와 프록시 Pod에서 사이드카로 실행되고 AI 관련 로직을 실행하는 Envoy Agent Router 외부 프로세서입니다. 애플리케이션 계층에서 고객 워크로드(애플리케이션 및 에이전트)는 AI 요청을 프록시로 전송하고(1), 프록시는 요청을 외부 프로세서에 전달하여 모델 이름을 추출하고 요청을 변환하며 토큰 사용량을 기록합니다(2). 프록시는 분산된 트래픽을 선택한 모델의 추론 Pod로 전달하고(3), 모델은 인프라 레이어의 GPU 노드에서 실행됩니다(4). 모델 서빙 백엔드는 AIServiceBackend (모든 OpenAI 호환 Service) 또는 엔드포인트 선택기가 요청당 최적의 복제본을 선택하는 InferencePool로 게이트웨이에 연결됩니다. 컨테이너 이미지와 Helm 차트는 Harbor에서 가져옵니다.
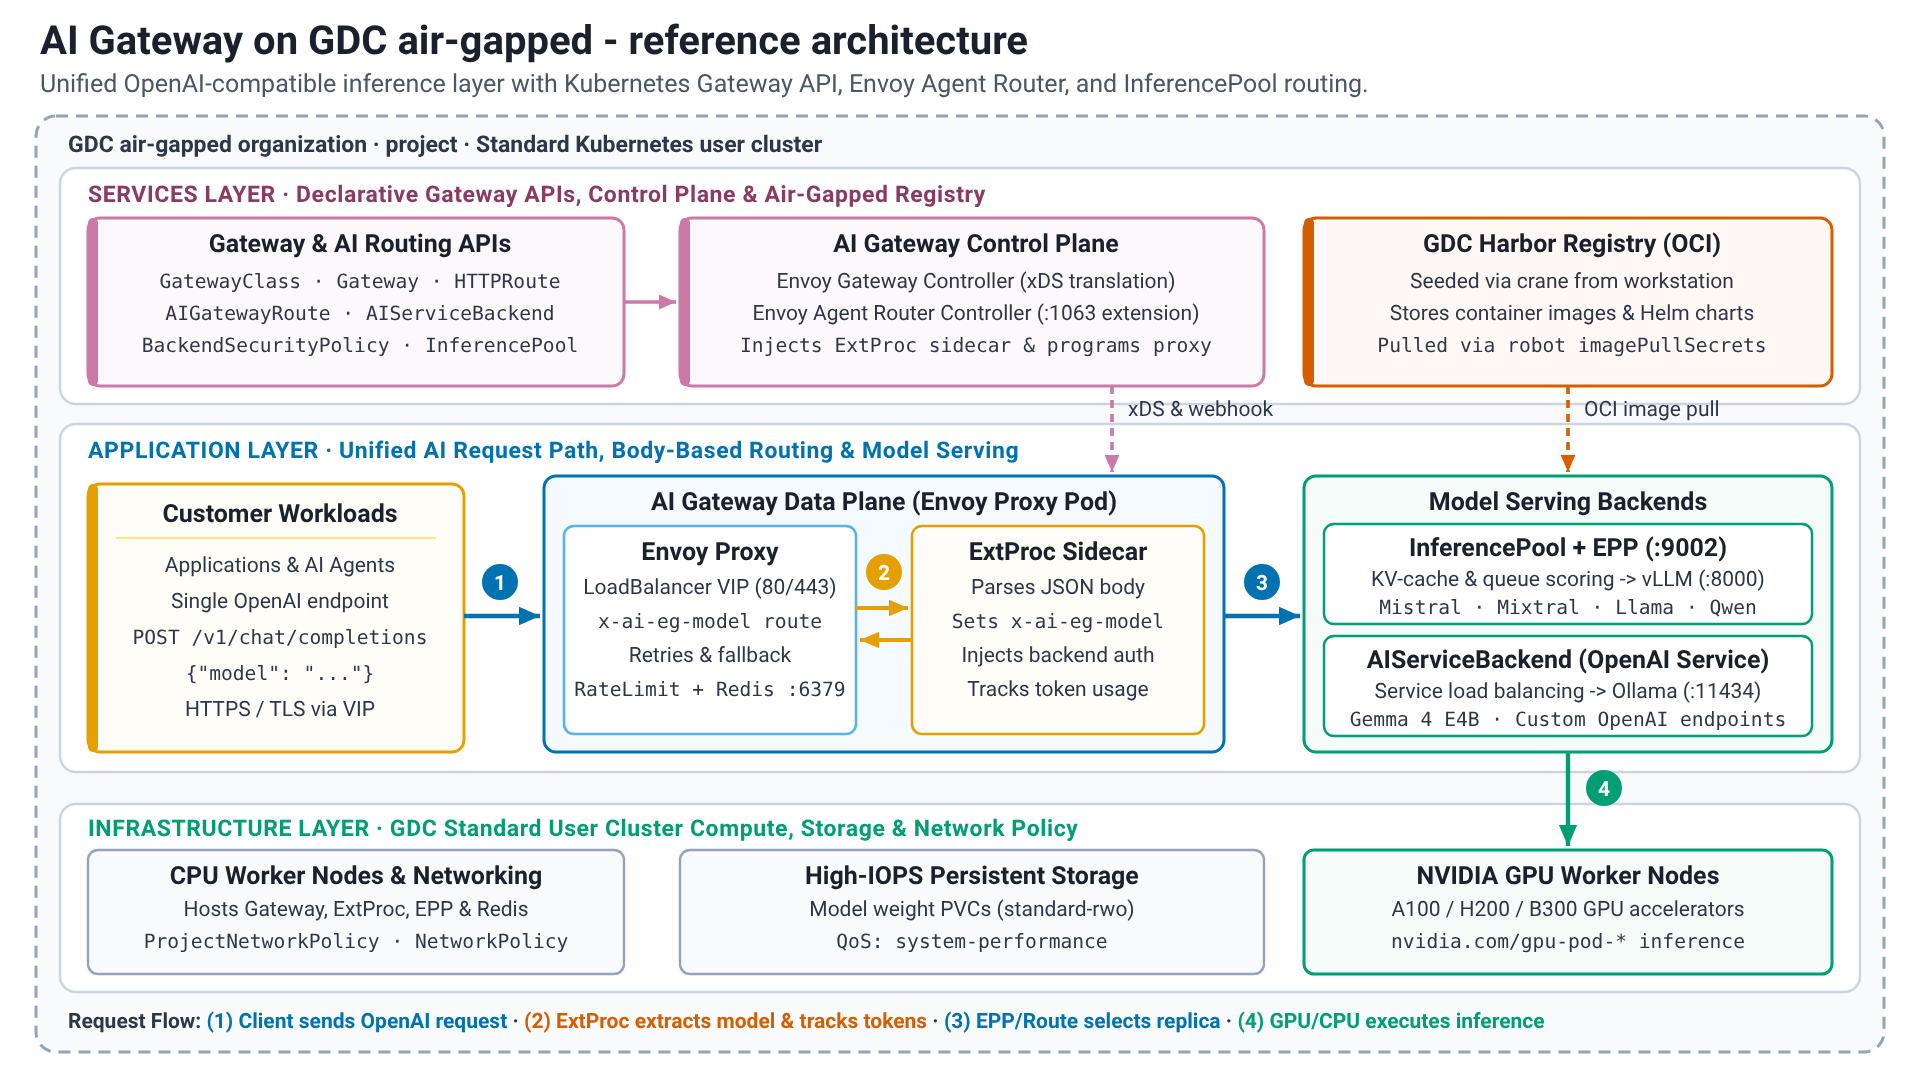
솔루션 구성요소
이 솔루션은 다음 구성요소를 사용합니다.
| 솔루션 구성요소 | 책임 | 데이터 흐름 | 인터페이스 |
|---|---|---|---|
| Kubernetes Gateway API | 인그레스 및 라우팅을 위한 표준 역할 지향 리소스 모델: GatewayClass (플랫폼 소유), Gateway (리스너, TLS), 경로 리소스 (애플리케이션팀 소유) 공급업체별 주석이 없는 Ingress API의 후속 버전입니다. |
선언적 구성만 해당합니다. 리소스는 컨트롤러에서 감시하며 요청 트래픽을 전달하지 않습니다. | Kubernetes API(gateway.networking.k8s.io/v1). CRD는 Envoy Gateway CRD 차트에서 설치됩니다. |
| Envoy 게이트웨이 컨트롤러 (컨트롤 플레인) | Gateway API를 구현합니다. Gateway당 Envoy 프록시 Deployment 및 LoadBalancer Service를 하나씩 프로비저닝하고, 경로 및 정책(BackendTrafficPolicy, SecurityPolicy, EnvoyExtensionPolicy, Backend, EnvoyProxy)을 xDS 구성으로 변환하고, 구성된 경우 전역 비율 제한 서비스를 실행하고, 확장 프로그램 관리자를 통해 Envoy 에이전트 라우터 확장 프로그램 서버를 호출하여 InferencePool 백엔드가 변환에 추가되도록 합니다. |
Kubernetes API를 감시하고 xDS 구성을 프록시로 푸시합니다. 요청 트래픽은 없습니다. | Kubernetes API(watch), 프록시를 향한 xDS gRPC, 확장 프로그램 서버를 향한 gRPC(포트 1063) |
| Envoy 에이전트 라우터 컨트롤러 (컨트롤 플레인) | aigateway.envoyproxy.io/v1beta1 리소스, AIGatewayRoute (추출된 모델 이름의 라우팅 규칙), AIServiceBackend (API 스키마가 있는 백엔드), BackendSecurityPolicy (업스트림 사용자 인증 정보), GatewayConfig(Gateway당 외부 프로세서 설정)를 Envoy Gateway 리소스로 조정하고, 외부 프로세서 사이드카를 Envoy 프록시 Pod에 삽입하고, Envoy Gateway에서 사용하는 확장 프로그램 서버를 제공합니다. |
구성만 해당합니다. | Kubernetes API, gRPC 확장 서버 (포트 1063), 사이드카 삽입을 위한 변경 허용 웹훅 |
| Envoy 프록시 (데이터 영역) | 요청 진입점: TLS를 종료하고, 리스너와 경로를 일치시키고, 백엔드 엔드포인트 간에 부하를 분산하고, 비율 제한과 제한 시간을 적용하고, 대체 백엔드로 재시도 및 대체하고, 액세스 로그와 측정항목을 내보냅니다. | LoadBalancer VIP (80/443)에서 클라이언트 요청을 수신하고, 모든 AI 요청에 대해 외부 프로세서에 컨설팅하고, 선택한 백엔드 엔드포인트 (엔드포인트 선택기에서 선택한 Service 또는 Pod)로 요청을 전달하고, 응답을 클라이언트로 다시 스트리밍합니다. |
클라이언트에 대한 HTTP/HTTPS(OpenAI 호환 API), 사이드카 및 엔드포인트 선택기에 대한 ext_proc gRPC, 백엔드에 대한 HTTP, 비율 제한 서비스에 대한 gRPC입니다. |
| Envoy 에이전트 라우터 외부 프로세서(ExtProc) | OpenAI 호환 요청 본문을 파싱하고, model 필드를 라우팅 헤더 x-ai-eg-model로 추출하고, 모델 이름 재정의를 적용하고, 클라이언트 API 스키마와 백엔드 API 스키마 간에 요청 및 응답 페이로드를 변환하고, BackendSecurityPolicy로 정의된 업스트림 사용자 인증 정보를 삽입하고, 응답에서 토큰 사용량(입력, 출력, 총계)을 추출하여 토큰 기반 비율 제한 및 측정항목에 사용되는 동적 메타데이터로 변환합니다. |
Envoy 프록시 Pod의 사이드카 컨테이너. 스트리밍된 응답을 포함한 요청 및 응답 본문을 처리합니다. |
Envoy ext_proc gRPC, Prometheus 측정항목 엔드포인트 |
| Gateway API Inference Extension (InferencePool + 엔드포인트 선택 도구) | InferencePool(inference.networking.k8s.io/v1)는 하나의 모델 서버 배포의 Pod(라벨 선택기, 대상 포트, 예: 8000)를 그룹화하고 엔드포인트 선택기(EPP)를 참조합니다. InferenceObjective(v1alpha2)는 모델 또는 목표별로 우선순위를 할당합니다. EPP는 모델 서버 측정항목 (요청 큐 깊이, KV 캐시 사용률, 로드된 LoRA 어댑터)을 스크래핑하고 모든 요청의 엔드포인트를 선택합니다. |
프록시는 요청 헤더를 사용하여 EPP (ext_proc, 포트 9002)를 호출합니다. EPP는 사용할 엔드포인트로 응답합니다. 프록시는 요청을 해당 Pod에 전달합니다. |
Kubernetes API (CRD), gRPC ext_proc (9002), 모델 서버의 Prometheus 스크래핑 |
| Redis (선택사항) | Envoy 비율 제한 서비스의 백업 저장소: 모든 프록시 복제본에서 요청 기반 및 토큰 기반 한도의 공유 카운터입니다. 전역 비율 제한이 구성된 경우에만 필요합니다. | 비율 제한 서비스는 제한된 요청마다 포트 6379에서 카운터를 읽고 증가시킵니다. | Redis 프로토콜(6379) 클러스터에 배포된 Redis 8.10 또는 기존 Redis 인스턴스 |
| 모델 서빙 백엔드(Ollama/vLLM) | 게이트웨이 뒤에서 개방형 가중치 모델을 서빙합니다. GDC 에어 갭에서 개방형 가중치 모델 설정이라는 함께 제공되는 가이드를 사용하여 배포됩니다. AIServiceBackend(Ollama와 같은 OpenAI 호환 Service) 또는 InferencePool(엔드포인트 선택 도구가 점수를 매기는 측정항목을 노출하는 vLLM과 같은 모델 서버)로 연결됩니다. |
프록시에서 라우팅된 요청을 수신하고, GPU 노드(또는 소규모 모델을 사용한 기능 평가의 경우 CPU)에서 추론을 실행하고, OpenAI 호환 응답을 반환합니다. | OpenAI 호환 REST API: 포트 8000의 vLLM, 포트 11434의 Ollama, 엔드포인트 선택 도구의 Prometheus 측정항목(vLLM) |
| Harbor | 솔루션의 컨테이너 이미지(Envoy 프록시, Envoy 게이트웨이, Envoy 에이전트 라우터 컨트롤러 및 외부 프로세서, 비율 제한 서비스, 엔드포인트 선택기, Redis)와 Helm 차트(OCI 아티팩트)를 저장합니다. | 아티팩트는 인터넷 액세스가 가능한 워크스테이션에서 seed_registry.sh (crane)를 사용하여 공개 레지스트리에서 Harbor로 복사됩니다. 클러스터는 이미지 가져오기 보안 비밀을 통해 로봇 계정으로 이미지를 가져오고 차트는 helm template를 사용하여 Harbor에서 렌더링됩니다. |
OCI Distribution API, Harbor UI, 로봇 계정 |
| Standard 클러스터 및 GPU 노드 | 모든 게이트웨이 구성요소(CPU 노드로 충분함)와 추론 Pod(노드에서 검색된 가속기 리소스가 있는 GPU 노드)를 호스팅합니다. LoadBalancer VIP, 모델 가중치에 대한 영구 스토리지, 네트워크 정책 시행을 제공합니다. |
기본 플랫폼: 요청은 Gateway의 LoadBalancer VIP를 통해 들어오고 클러스터 네트워크 내에 유지됩니다. |
Kubernetes API, GDC 네트워킹 API(networking.gdc.goog/v1 ProjectNetworkPolicy), GDC 콘솔, 플랫폼 관리자용 gdcloud |
특징 및 기능
이 참조 아키텍처는 다음과 같은 핵심 기능을 제공합니다.
- 통합 OpenAI 호환 엔드포인트: 애플리케이션은 게이트웨이 뒤에서 모델 서빙되는 모든 모델에 대해 하나의 주소(
/v1/chat/completions,/v1/models, …)를 호출합니다.- 구성요소:
Gateway,AIGatewayRoute, Envoy 프록시, 외부 프로세서 - 책임: 안정적인 가상 IP 노출, TLS 종료, OpenAI 호환 요청 형식 수락, 필요한 경우 백엔드 스키마로 변환
- 인터페이스: HTTPS REST (스트리밍을 위한 서버 전송 이벤트를 포함한 JSON).
- 구성요소:
- 본문 기반(모델 인식) 라우팅: 게이트웨이는 요청 본문의
model필드를 읽고 클라이언트 측 엔드포인트 로직 없이 일치하는 백엔드로 요청을 라우팅합니다.- 구성요소: 외부 프로세서,
x-ai-eg-model,AIServiceBackend,InferencePool에서 일치하는AIGatewayRoute규칙 - 책임: 모델 이름 추출, 라우팅 규칙 일치, 모델 이름 바꾸기 (
modelNameOverride), 가중치별 트래픽 분할, 우선순위별 대체 백엔드로 대체 - 인터페이스: Kubernetes API (
aigateway.envoyproxy.io/v1beta1)
- 구성요소: 외부 프로세서,
- 모델 서버 인식 부하 분산:
InferencePool에 대한 요청은 라운드 로빈 대신 큐가 가장 짧고 KV 캐시가 가장 유용한 복제본으로 전송됩니다.- 구성요소: Gateway API Inference Extension(
InferencePool,InferenceObjective, 엔드포인트 선택 도구) - 책임: 모델 서버 측정항목 스크래핑, 엔드포인트 점수 산정(큐 깊이, KV 캐시 사용률, 프리픽스 캐시 어피니티, LoRA 어댑터), 부하 상태에서 목표별 우선순위 준수
- 인터페이스: Kubernetes API(
inference.networking.k8s.io/v1,inference.networking.x-k8s.io/v1alpha2), ext_proc gRPC(9002)
- 구성요소: Gateway API Inference Extension(
- 업스트림 인증 및 보안 정책: 백엔드에 필요한 사용자 인증 정보는 게이트웨이에 의해 삽입되며 애플리케이션에 배포되지 않습니다.
- 구성요소:
BackendSecurityPolicy, Envoy 게이트웨이SecurityPolicy, TLS 리스너 - 책임: 백엔드에 API 키 삽입,
Gateway에서 클라이언트 TLS 종료, 필요한 경우 클라이언트 인증 및 승인 정책 시행 - 인터페이스: 정책에서 참조하는 Kubernetes
Secret입니다.
- 구성요소:
- 토큰 기반 비율 제한(선택사항): 사용량은 요청뿐만 아니라 토큰으로도 측정됩니다.
- 구성요소: 외부 프로세서 (
llmRequestCosts), Envoy 게이트웨이BackendTrafficPolicy(전역 비율 제한), 비율 제한 서비스, Redis - 책임: 모든 응답에서 입력, 출력, 총 토큰을 추출하고, 이를 요청 비용으로 연결하고, 모든 프록시 복제본에서 소비자별 또는 모델별 예산을 적용합니다.
- 인터페이스: Kubernetes API, Redis(6379)
- 구성요소: 외부 프로세서 (
- 트래픽 관리: 표준 Gateway API 기능이 AI 트래픽에 적용됩니다.
- 구성요소:
Gateway,HTTPRoute,AIGatewayRoute,BackendTrafficPolicy - 책임: 호스트, 경로, 헤더 기반 일치, 긴 생성에 적합한 제한 시간, 재시도, 가중치 기반 트래픽 분할, 백엔드 간 우선순위 기반 대체입니다.
- 인터페이스: Kubernetes API
- 구성요소:
- 모니터링 가능성: 모든 모델에 요청, 지연 시간, 토큰 측정항목을 사용할 수 있습니다.
- 구성요소: Envoy 프록시 액세스 로그 및 통계, 외부 프로세서 측정항목(토큰 사용량, 요청 기간, 첫 번째 토큰까지의 시간), 엔드포인트 선택 도구 측정항목
- 책임: GDC 모니터링 가능성 스택 또는 고객 관리 Prometheus가 스크래핑할 수 있는 Prometheus 형식 측정항목 및 구조화된 액세스 로그를 노출합니다.
- 인터페이스: Prometheus 측정항목 엔드포인트, 표준 출력 로그
- 에어 갭 적용 아티팩트 관리: 모든 이미지와 차트는 설치 전에 Harbor에 스테이징됩니다.
- 구성요소: Harbor,
seed_registry.sh, 로봇 계정, 이미지 가져오기 보안 비밀,EnvoyProxy리소스(프록시 이미지 및 가져오기 보안 비밀) - 책임: 연결된 워크스테이션에서 이미지 및 OCI Helm 차트 시드, 버전 고정,
helm template를 사용하여 오프라인으로 차트 렌더링 - 인터페이스: OCI Distribution API, Kubernetes API
- 구성요소: Harbor,
아키텍처 원칙
- 표준 우선: 게이트웨이는 Kubernetes Gateway API 및 해당 추론 확장 프로그램을 통해 구성되며 애플리케이션에 OpenAI 호환 API를 사용하므로 애플리케이션, 경로, 백엔드가 게이트웨이 구현 전반에서 이식 가능하게 유지됩니다.
- 보안 우선: 모든 구성요소와 데이터 레지던시가 GDC 에어 갭 경계 내에 있습니다. TLS는
Gateway에서 종료되고 백엔드 사용자 인증 정보는 게이트웨이에 의해 삽입되며 네트워크 액세스는NetworkPolicy및ProjectNetworkPolicy객체로 제한됩니다. - 데이터 주권: 프롬프트, 응답, 모델 가중치, 사용 데이터는 고객의 GDC 조직을 벗어나지 않으며, 운영에 외부 연결이 필요하지 않습니다.
- 관심사 분리: 역할 지향 Gateway API를 사용하면 플랫폼 관리자가
GatewayClass,Gateway, TLS, 네트워크 정책을 소유하고 애플리케이션팀은 자체 네임스페이스에서AIGatewayRoute,AIServiceBackend,InferencePool리소스를 소유할 수 있습니다. - 분리된 제어 및 데이터 영역: 컨트롤러는 구성만 변환합니다. 요청 경로는 Envoy 프록시, 외부 프로세서 사이드카, 엔드포인트 선택기로 구성되며, 컨트롤러가 다시 시작되면 트래픽을 계속 제공합니다.
- 개방성 및 유연성: 이 아키텍처는 전반적으로 오픈소스 소프트웨어(Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension, Ollama, vLLM)를 사용하며, 동일한 Gateway API 리소스를 대체 구현으로 제공할 수 있습니다.
- 확장성 및 성능: 데이터 영역은 프록시 복제본을 추가하여 수평으로 확장하고 CPU 및 메모리를 조정하여 수직으로 확장합니다. 모델 서버 인식 부하 분산은 개별 복제본에 과부하를 주지 않으면서 GPU를 포화 상태로 유지합니다.
- 간소화된 최종 사용자 환경: 모든 모델에 하나의 엔드포인트, 하나의 API 형식, 하나의 사용자 인증 정보가 사용되므로 모델 배포에서 소비까지의 경로가 단축됩니다.
- 복원력: Kubernetes 상태 점검 및 복제, Envoy 재시도, 백엔드 간 우선순위 기반 대체는 개별 모델 복제본이 실패할 때 엔드포인트를 사용할 수 있도록 유지합니다.
고려사항
- 확장성 및 성능:
- 게이트웨이 구성요소는 CPU 전용 워크로드입니다.
Gateway의 Envoy 프록시Deployment는 복제본 수(EnvoyProxy리소스)를 늘려 수평으로 확장하고 CPU 및 메모리 요청을 늘려 수직으로 확장합니다. 외부 프로세서의 본문 검사에는 요청 및 응답 크기에 비례하는 CPU 비용이 발생합니다. 스트리밍된 응답은 점진적으로 처리됩니다. - 모델 서버 인식 부하 분산은
InferencePool로 연결된 백엔드에만 적용됩니다.AIServiceBackend로 연결된 백엔드는Service의 엔드포인트 전반에서 프록시에 의해 부하 분산됩니다. - 게이트웨이는 GPU 용량을 추가하지 않습니다. 처리량과 지연 시간은 모델 서버에 의해 제한됩니다. 컴패니언 가이드 세트(높은 처리량을 위한 vLLM, 사용 편의성 및 CPU 전용 평가를 위한 Ollama)를 사용하여 모델 배포의 크기를 조정합니다.
- 긴 생성에는 일반적인 HTTP API보다 더 긴 요청 및 유휴 제한 시간이 필요합니다. 클라이언트가 아닌 경로 및 정책에서 구성하세요.
- 게이트웨이 구성요소는 CPU 전용 워크로드입니다.
- 리소스 관리:
- 모든 게이트웨이 구성요소는 CPU 노드에서 실행되며 가속기가 필요하지 않습니다. 다음 표는 기능 배포의 크기 조정 지표를 보여줍니다. 참조 구현은 정확한 요청 및 한도를 설정합니다. 프로덕션 값은 요청 비율 및 페이로드 크기에 따라 달라집니다.
- 다음 포트 표에는 네트워크 정책에서 허용해야 하는 모든 포트가 나와 있습니다.
- GPU 계획은 모델 배포에 속합니다. 가속기 리소스 이름은 함께 제공되는 가이드 세트에 설명된 대로 노드에서 검색됩니다.
게이트웨이 구성요소의 대략적인 크기 (CPU만 해당)
| 구성요소 | 복제본 | CPU (요청) | 메모리 (요청) | 참고 |
|---|---|---|---|---|
| Envoy 게이트웨이 컨트롤러 | 1 | 1억~5억 | 256Mi~1Gi | 컨트롤 플레인, 요청 경로에 없음 |
| Envoy 에이전트 라우터 컨트롤러 | 1 | 1억~5억 | 256Mi~512Mi | 컨트롤 플레인 및 확장 프로그램 서버 |
Envoy 프록시 Pod(프록시 + 외부 프로세서 사이드카) |
Gateway당 1~2개 |
5억~20억 | 512Mi~2Gi | 요청 비율 및 페이로드 크기로 확장 |
| 엔드포인트 선택 도구 | InferencePool당 1개 |
1억~5억 | 256Mi~512Mi | 모델 서버 측정항목을 스크래핑합니다. |
| 비율 제한 서비스 (선택사항) | 1 | 1억~5억 | 256Mi~512Mi | 전역 비율 제한만 사용 |
| Redis (선택사항) | 1 | 1억~5억 | 256Mi~1Gi | 전역 비율 제한만 사용 |
네트워크 포트
| 포트 | 구성요소 | 목적 |
|---|---|---|
| 80 / 443 | Envoy 프록시 (Gateway 리스너) |
LoadBalancer VIP의 HTTP/HTTPS 진입점 |
| 1063 | Envoy 에이전트 라우터 컨트롤러(확장 프로그램 서버) | Envoy Gateway 확장 프로그램 관리자의 gRPC 호출 |
| 9002 | 엔드포인트 선택 도구 | Envoy 프록시의 ext_proc gRPC 호출 |
| 6379 | Redis | 비율 제한 카운터 |
| 8000 | vLLM | 모델 서버의 OpenAI 호환 API 및 측정항목 |
| 11434 | Ollama | 모델 서버의 Ollama 및 OpenAI 호환 API |
- 가용성 및 안정성:
- 프록시와 외부 프로세서는 동일한
Pod에서 실행됩니다.LoadBalancerService뒤에 있는 여러 복제본은 개별Pod오류를 마스킹하고 컨트롤러는 트래픽을 중단하지 않고 다시 시작할 수 있습니다. AIGatewayRoute규칙은 백엔드가 비정상일 때 게이트웨이가 다른 복제본 세트 또는 모델 서버로 대체되도록 우선순위가 있는 여러 백엔드를 나열할 수 있습니다.- 엔드포인트 선택기는 풀별
Deployment입니다. 사용할 수 없는 경우 다시 사용할 수 있을 때까지 해당InferencePool에 대한 요청이 실패합니다. 리소스 요청 및 준비 프로브로 실행하고 데이터 영역 구성요소처럼 모니터링합니다. - Redis는 비율 제한 카운터만 보유합니다. Redis 서비스 중단은 라우팅이 아닌 비율 제한에 영향을 미칩니다.
- 프록시와 외부 프로세서는 동일한
- 운영 복잡성:
- Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension 간의 버전 조정: 테스트된 조합 (Envoy Gateway 1.8.4, Envoy Agent Router 1.1.0, Gateway API Inference Extension 1.5.0)과 함께 세 가지를 업그레이드합니다.
- 에어 갭 적용 수명 주기: 업그레이드할 때마다 모든 이미지와 차트가 Harbor에 다시 시드됩니다.
EnvoyProxy리소스와 차트 값은 레지스트리와 가져오기 보안 비밀을 고정합니다. - 두 가지 구성 레이어: 플랫폼 소유
GatewayClass/Gateway/EnvoyProxy및 팀 소유AIGatewayRoute/AIServiceBackend/InferencePool. 새 모델을 온보딩한다는 것은 새 게이트웨이가 아닌 라우팅 규칙과 백엔드를 추가하는 것을 의미합니다. - 모니터링: 요청 비율, 지연 시간 (첫 번째 토큰까지 소요되는 시간 포함), 모델 및 소비자별 토큰 사용량, 엔드포인트 선택기 점수, 모델 서버의 GPU 사용률
InferenceObjective는 아직 알파 API (v1alpha2)입니다. 추론 확장 프로그램 출시 버전 간에 스키마가 변경될 수 있습니다.
- 보안 및 규정 준수:
- 전체 솔루션은 GDC 에어 갭 보안 경계 내에서 작동합니다.
- 네트워크 정책은 필수입니다. 네임스페이스
NetworkPolicy는 프록시에서 모델 서버 포트(8000, 11434) 및 엔드포인트 선택 도구(9002)로의 트래픽을 허용하고,ProjectNetworkPolicy는 소비자가 프로젝트 외부에 있을 때LoadBalancerVIP로의 클라이언트 트래픽을 허용합니다. - TLS는 Kubernetes
Secret에 저장된 인증서를 사용하여Gateway에서 종료됩니다. 클라이언트는 게이트웨이 엔드포인트만 볼 수 있습니다. - 업스트림 사용자 인증 정보(예: 모델 서버에 필요한 API 키)는
BackendSecurityPolicy에서 참조하는Secret에 저장되고 게이트웨이에서 삽입되므로 애플리케이션은 백엔드 사용자 인증 정보를 보유하지 않습니다. - 토큰 기반 비율 제한은 소비자 또는 모델당 고가의 GPU 용량 소비를 제한합니다.
- Harbor 로봇 계정과 Kubernetes 이미지 가져오기 보안 비밀은 컨테이너 이미지에 대한 안전한 액세스를 보장하며, 역할 지향 게이트웨이 API RBAC는 플랫폼과 애플리케이션 책임을 분리합니다.
설계 결정
이 참조 아키텍처에 대해 다음과 같은 주요 설계 결정이 내려졌습니다.
결정 1: AI 게이트웨이 구현: Envoy 게이트웨이의 오픈소스 Envoy 에이전트 라우터와 대체 배포 비교
| 컨텍스트 | 주요 결정사항 | 근거 |
|---|---|---|
| AI 게이트웨이는 자체 관리형 오픈소스 옵션부터 상업적으로 지원되는 제품에 이르기까지 실행 가능한 대안을 갖춘 기본 아키텍처 선택입니다. (a) Envoy Gateway의 Envoy 에이전트 라우터 (오픈소스), (b) kgateway 및 agentgateway (하나의 데이터 영역에서 LLM 제공업체 트래픽, MCP 도구, 에이전트 간 통신도 처리하는 오픈소스 게이트웨이 API 구현, 선택적으로 solo.io의 공급업체 지원 포함), (c) 상업적으로 지원되는 프리미엄 옵션인 agentgateway용 Solo Enterprise. | 참조 구현은 Envoy 게이트웨이에서 오픈소스 Envoy 에이전트 라우터를 사용합니다. 대안은 동일한 게이트웨이 API 리소스 뒤에서 유효한 선택으로 남아 있습니다. 전용 공급업체 지원이 필요한 프로덕션 환경에는 상업적으로 지원되는 배포가 권장됩니다. | 오픈소스의 장점: 가볍고 표준을 준수하며 고성능 L7 라우팅을 제공하고 라이선스 요금이 없으며 유료 제품을 사용하기 전에 솔루션을 평가하는 데 이상적입니다. Envoy 에이전트 라우터는 이 가이드 세트에서 검증된 옵션입니다. 오픈소스의 단점: 지원은 솔루션팀과 커뮤니티 주도로 최선을 다해 제공되므로 핵심 프로덕션 환경을 충족하지 못할 수 있습니다. 프리미엄 이점: 게이트웨이 수명 주기에 대한 엔터프라이즈 지원 계약과 고급 에이전트 기능이 제공되는 경우가 많습니다. 프리미엄 단점: 유료 라이선스 또는 지원 계약 및 추가 공급업체 관계 |
결정 2: 추론 확장 프로그램이 있는 Kubernetes Gateway API와 인그레스 또는 독점 게이트웨이 API 비교
| 컨텍스트 | 주요 결정사항 | 근거 |
|---|---|---|
| 추론 엔드포인트는 기존 인그레스 API, 게이트웨이별 구성 형식 또는 Kubernetes Gateway API를 사용하여 노출할 수 있습니다. 모델 인식 부하 분산에는 모델 서버 풀과 우선순위를 설명하는 방법이 추가로 필요합니다. | 이 솔루션은 Envoy Gateway에서 구현하는 Kubernetes Gateway API (GatewayClass, Gateway, 경로)와 모델 인식 라우팅을 위한 Gateway API Inference Extension (InferencePool, InferenceObjective, 엔드포인트 선택기)을 표준으로 사용합니다. |
Gateway API는 인그레스를 대체하는 Kubernetes 표준으로, 역할 중심 (플랫폼팀과 애플리케이션팀)이며 구현 간에 이식 가능합니다. 추론 확장 프로그램은 모델 서버 인식 라우팅 (큐 깊이, KV 캐시, 우선순위)의 커뮤니티 표준이며 Envoy 에이전트 라우터에서 기본적으로 지원됩니다. 대체 게이트웨이 배포는 동일한 API를 구현하므로 결정 1을 되돌릴 수 있습니다. |
결정 3: 통합 엔드포인트로서 OpenAI 호환 요청의 model 필드에 대한 본문 기반 라우팅
| 컨텍스트 | 주요 결정사항 | 근거 |
|---|---|---|
애플리케이션은 모델당 하나의 엔드포인트(호스트 또는 경로 기반), 클라이언트가 설정한 커스텀 헤더 또는 모든 OpenAI 호환 요청에 이미 포함된 model 필드를 통해 모델을 처리할 수 있습니다. |
게이트웨이는 OpenAI 호환 엔드포인트 하나를 노출하고 model 필드에서 라우팅합니다. 외부 프로세서는 이를 x-ai-eg-model 헤더로 추출하고 AIGatewayRoute 규칙은 해당 헤더와 일치합니다. |
기존 OpenAI 호환 클라이언트와 SDK는 변경 없이 작동하며 문자열 하나를 변경하여 모델을 전환합니다. 엔드포인트, 사용자 인증 정보, 모델 배치는 애플리케이션을 건드리지 않고도 변경할 수 있습니다. 동일한 규칙으로 트래픽 분할, 대체 또는 모델 이름 재정의를 위해 모델 이름을 여러 백엔드에 매핑할 수 있습니다. |
결정 4: Harbor에 에어 갭 적용 아티팩트 시딩과 주문형 가져오기 비교
| 컨텍스트 | 주요 결정사항 | 근거 |
|---|---|---|
| 업스트림 설치는 공개 레지스트리에서 컨테이너 이미지를 가져오고 Helm 차트를 OCI 아티팩트로 필요에 따라 가져오는데, 이는 에어 갭 환경에서는 불가능합니다. | 모든 컨테이너 이미지 (Envoy 프록시, Envoy 게이트웨이, Envoy 에이전트 라우터 컨트롤러 및 외부 프로세서, 비율 제한 서비스, 엔드포인트 선택기, Redis)와 Envoy 게이트웨이 및 Envoy 에이전트 라우터 Helm 차트는 seed_registry.sh (crane)를 사용하여 Harbor 프로젝트에 시드되고, 차트는 Harbor에서 helm template를 사용하여 오프라인으로 렌더링되며, EnvoyProxy 리소스와 차트 값은 Harbor 레지스트리와 가져오기 보안 비밀을 고정합니다. |
버전당 반복 가능하고 감사 가능한 시딩 단계가 하나 있습니다. 클러스터에는 외부 연결이 필요하지 않습니다. 버전 고정을 통해 업그레이드를 명시적이고 되돌릴 수 있습니다. |
결정 5: Redis를 사용한 선택적 토큰 기반 비율 제한과 요청 기반 제한만 비교
| 컨텍스트 | 주요 결정사항 | 근거 |
|---|---|---|
| GPU 용량은 요청당이 아닌 토큰당 소비됩니다. 요청 수 제한으로는 몇 가지 매우 큰 프롬프트나 긴 생성으로부터 공유 모델을 보호할 수 없습니다. Envoy Gateway의 전역 비율 제한에는 공유 카운터 저장소가 필요합니다. | 토큰 기반 비율 제한은 아키텍처의 선택적 기능입니다. 외부 프로세서는 요청당 입력, 출력, 총 토큰을 기록하고(llmRequestCosts), BackendTrafficPolicy는 예산을 적용하며, Redis 인스턴스(클러스터 또는 기존 인스턴스에 배포된 Redis 8.10)는 카운터를 저장합니다. 비율 제한이 없는 배포에는 Redis가 필요하지 않습니다. |
사용량은 비용을 반영하는 단위로 측정되고, 예산은 모든 프록시 복제본에 일관되게 적용되며, 종속 항목은 할당량이 필요한 고객만 비용을 지불합니다. |
결정 6: 토폴로지: 표준 클러스터의 전용 네임스페이스에 있는 게이트웨이 제어 및 데이터 영역, 애플리케이션 네임스페이스의 모델
| 컨텍스트 | 주요 결정사항 | 근거 |
|---|---|---|
| 게이트웨이는 전용 클러스터, 모든 애플리케이션 네임스페이스 또는 표준 클러스터당 한 번씩, 프런트하는 모델 옆에서 실행될 수 있습니다. GDC 에어 갭의 개방형 가중치 모델은 표준 클러스터 (컴패니언 가이드 세트)에 배포됩니다. | Envoy 게이트웨이 및 Envoy 에이전트 라우터 컨트롤 플레인과 Envoy 프록시 데이터 영역은 모델을 호스팅하는 표준 클러스터의 전용 네임스페이스에서 실행됩니다. AIGatewayRoute, AIServiceBackend, InferencePool 및 모델 배포는 애플리케이션 네임스페이스에 있으며 네임스페이스 간에 참조됩니다. |
요청은 프록시와 모델 Pod 간의 클러스터 네트워크 내에 유지되고(지연 시간이 가장 낮고 추가 부하 분산기가 없음), 플랫폼 관리자가 게이트웨이 네임스페이스를 소유하고 애플리케이션팀이 경로와 모델을 소유하며, 엔드포인트 선택기가 모델 서버를 직접 스크래핑할 수 있습니다. 중앙 서버 게이트웨이로 전달하는 프로젝트별 클라이언트 게이트웨이는 다중 프로젝트 소비를 위한 이 토폴로지의 확장으로 유지됩니다. |
가정 및 제한사항
- GDC 에어 갭 1.16.2-hf1 이상 환경은 Kubernetes v1.32.13-gke.400 이상을 실행하는 표준 클러스터에서 사용할 수 있습니다.
- 모델 서빙 백엔드에 충분한 하드웨어 리소스 (특히 GPU)가 있습니다. 게이트웨이 구성요소 자체는 CPU 노드에서 실행됩니다. 실제 모델에는 GPU가 필요합니다. Ollama의 소형 모델은 기능 평가를 위해서만 CPU에서 실행할 수 있습니다.
- Harbor 인스턴스가 설정되고 액세스 가능하며, 인터넷 액세스 및 GDC 환경(Harbor 및 Kubernetes API)에 대한 연결이 있는 워크스테이션을 이미지 및 차트 시딩에 사용할 수 있습니다.
- 사용자에게 필요한 권한이 있습니다. 프로젝트 역할 Harbor 인스턴스 뷰어 및 표준 클러스터 관리자와 클러스터 범위 설치(CRD,
GatewayClass, 네임스페이스)를 위한 표준 클러스터의cluster-admin역할에 대한StandardClusterRoleBinding가 있습니다. 참조 구현을 확인하세요. - 모델 서빙 백엔드는 OpenAI 호환 API를 노출합니다.
InferencePool로 연결된 백엔드는 엔드포인트 선택기가 사용하는 vLLM 호환 측정항목도 노출합니다. - 제한사항: 오픈소스 구성요소 (Envoy Gateway, Envoy 에이전트 라우터, Gateway API 추론 확장 프로그램)에 대한 지원은 솔루션팀에서 최선을 다해 제공합니다. 전담 공급업체 지원을 받으려면 상업적으로 지원되는 배포가 필요합니다 (결정 1).
- 제한사항:
InferenceObjective는 알파 API(inference.networking.x-k8s.io/v1alpha2)이며 추론 확장 프로그램 출시 버전 간에 변경될 수 있습니다. - 제한사항: 프로젝트 외부의 소비자는
Gateway의LoadBalancerVIP와ProjectNetworkPolicy가 필요합니다. 프로젝트 내부에서는 클러스터 내 클라이언트 또는kubectl port-forward가 게이트웨이Service에 직접 연결할 수 있습니다. - 제한사항: GDC의 Gemini, 모델 파인 튜닝, LLM이 아닌 생성형 AI 모델, 멀티 노드 모델 서빙은 이 버전의 솔루션 범위에 포함되지 않습니다.
사용자 플로우
다음은 GDC 에어 갭의 AI 게이트웨이에 대한 포괄적인 사용자 플로우입니다. 먼저 애플리케이션 개발자가 사용하는 요청 경로, 플랫폼 관리자가 따르는 설정 경로입니다.
1. 개발자 요청 경로
애플리케이션 또는 에이전트에는 게이트웨이 엔드포인트, 게이트웨이가 적용하는 경우 클라이언트 사용자 인증 정보, 모델 이름만 필요합니다.
- 요청 전송: 애플리케이션은 OpenAI 호환 서비스를 호출하는 것과 동일하게 모델(예:
"model": "gemma")의 이름을 지정하는 OpenAI 호환 JSON 본문을 사용하여 게이트웨이 엔드포인트에서POST /v1/chat/completions를 호출합니다. - 게이트웨이 입력: 요청이
Gateway의LoadBalancerVIP에 도달합니다. Envoy 프록시가 TLS를 종료하고 리스너와 경로를 일치시킵니다. - 본문 처리: 프록시가 요청을 Envoy 에이전트 라우터 외부 프로세서에 전달합니다. 이 프로세서는 본문을 파싱하고 모델 이름을
x-ai-eg-model헤더로 추출하며 페이로드를 백엔드 스키마로 변환합니다(다른 경우). - 백엔드 선택: 모델 이름과 일치하는
AIGatewayRoute규칙은AIServiceBackend(예: OllamaService) 또는InferencePool(예: vLLM 복제본 세트)를 선택합니다.InferencePool의 경우 엔드포인트 선택 도구는 큐가 가장 짧고 KV 캐시 일치가 가장 좋은 복제본을 선택합니다. - 전달 및 응답: 프록시는
BackendSecurityPolicy가 적용될 때 업스트림 사용자 인증 정보를 삽입하고, 선택한Pod에 요청을 전달하고, 응답을 다시 스트리밍하고, 외부 프로세서가 토큰 사용량을 기록하도록 허용합니다. 이 사용량은 측정항목과 구성된 경우 토큰 기반 비율 제한에 반영됩니다. - 모델 전환: 다른 모델을 사용하려면 개발자가
model문자열을 변경합니다. 새 엔드포인트, 사용자 인증 정보, 클라이언트 라이브러리가 필요하지 않습니다.
2. 플랫폼 관리자 설정 경로
- Harbor에 아티팩트 시드: Harbor 로봇 계정을 만든 후 인터넷 액세스가 가능한 워크스테이션에서
seed_registry.sh를 사용하여 컨테이너 이미지와 Envoy 게이트웨이 및 Envoy 에이전트 라우터 Helm 차트를 Harbor에 복사합니다. - Envoy Gateway 설치:
helm template를 사용하여 Harbor에서 CRD 및 컨트롤러 차트를 렌더링하고 게이트웨이 네임스페이스에 적용합니다. 프록시 이미지와 가져오기 보안 비밀을 고정하는EnvoyProxy리소스를 만들고 기본GatewayClass,Gateway,HTTPRoute를 사용하여 컨트롤러를 확인합니다. - Envoy 에이전트 라우터 설치: Envoy 에이전트 라우터 CRD 및 Gateway API 추론 확장 프로그램 CRD를 설치하고, Envoy 에이전트 라우터 컨트롤러를 배포하고, 확장 프로그램 서버(포트 1063)를 호출하고
InferencePool백엔드를 허용하도록 Envoy 게이트웨이를 재구성합니다. 원하는 경우 Redis를 배포하고 전역 비율 제한 서비스를 사용 설정합니다. - 게이트웨이 노출: HTTP 및 HTTPS 리스너 (TLS 인증서
Secret)를 사용하여GatewayClass및Gateway를 만들고LoadBalancerVIP를 기다린 후 프로젝트 외부의 소비자에 대해ProjectNetworkPolicy를 적용합니다. - 모델 연결: 함께 제공되는 가이드 세트를 사용하여 모델 서빙 백엔드를 배포한 다음 OpenAI 호환
Service및InferencePool에 대한AIServiceBackend리소스와 vLLM 호환 복제본 세트에 대한 엔드포인트 선택기 리소스를 네임스페이스NetworkPolicy객체와 함께 만듭니다. - 경로 게시: 모델 이름당 하나의 규칙(본문 기반 라우팅)과 필요한 경우 업스트림 사용자 인증 정보 및 토큰 예산에 대한
BackendSecurityPolicy및BackendTrafficPolicy객체를 사용하여AIGatewayRoute를 만듭니다. - 검증 및 운영: VIP(또는
kubectl port-forward대체)를 통해/v1/models및/v1/chat/completions를 호출하고, 프록시, 외부 프로세서, 엔드포인트 선택기 측정항목을 확인하고, 엔드포인트 및 모델 이름을 애플리케이션팀에 전달합니다. 프록시 복제본과 모델 배포를 독립적으로 확장하고 Envoy Gateway, Envoy Agent Router, 추론 확장 프로그램을 함께 업그레이드합니다.
자세한 단계는 Envoy 에이전트 라우터 참조 구현 및 Envoy 에이전트 라우터를 사용한 본문 기반 라우팅 사용자 가이드에 나와 있습니다.
추가 자료
- Envoy 에이전트 라우터 참조 구현
- Envoy 에이전트 라우터 사용자 가이드를 사용한 본문 기반 라우팅
- 가중치 공개 LLM 참조 아키텍처
- Envoy 에이전트 라우터 문서
- Envoy 게이트웨이
- Kubernetes Gateway API
- Gateway API Inference Extension
- 에어 갭이 적용된 Google Distributed Cloud 문서