


Dichiarazione del problema
Le organizzazioni che eseguono modelli linguistici di grandi dimensioni (LLM) in ambienti con air gap accumulano rapidamente endpoint di erogazione del modello: ogni modello con pesi aperti fornito su Google Distributed Cloud (GDC) con air gap (consulta la guida complementare Modelli con pesi aperti su GDC con air gap) espone la propria Service Kubernetes, il proprio indirizzo, le proprie credenziali e il proprio ciclo di vita operativo.
Gli sviluppatori di applicazioni e agenti finiscono in silos architettonici, con l'hardcoding di un endpoint per modello e la riscrittura delle integrazioni a ogni iterazione del modello. Questa frammentazione crea un debito tecnico e rallenta il deployment di workload agentici in più fasi e mission-critical.
Anche i livelli di rete standard sono "AI-blind": un bilanciatore del carico convenzionale tratta il traffico di inferenza come HTTP generico e non può leggere il campo model di una richiesta, dare priorità ai workload sensibili alla latenza, tenere conto dei token anziché delle richieste o indirizzare una richiesta alla replica del server di modelli che contiene già la cache KV pertinente. Nei cluster GPU air-gapped ad alto costo, ciò porta a un sottoutilizzo dell'hardware e a un ritorno sull'investimento scarso. Sebbene Gemini on GDC fornisca modelli pionieristici gestiti, i clienti che li combinano con modelli open weight in hosting autonomo hanno bisogno di un livello di inferenza che offra un'agilità simile a quella del cloud senza compromettere la sovranità dei dati: nessuna richiesta, nessun prompt o nessun peso del modello può lasciare il confine di GDC.
Soluzione proposta
Questo documento descrive l'architettura di riferimento per un gateway AI autogestito su GDC con air gap: un livello di inferenza sicuro e centralizzato che fornisce alle applicazioni un endpoint compatibile con OpenAI per tutti i modelli e indirizza ogni richiesta al backend corretto. L'implementazione di riferimento si basa sull'API Kubernetes Gateway: Envoy Gateway è l'implementazione dell'API Gateway (control plane e data plane del proxy Envoy) ed Envoy Agent Router (in precedenza Envoy AI Gateway) la estende con l'elaborazione delle richieste specifica per l'AI: estrazione del modello dal corpo della richiesta, traduzione della richiesta e della risposta, autenticazione upstream, contabilità dei token e, facoltativamente, limitazione di frequenza basata su token. L'estensione di inferenza dell'API Gateway aggiunge la selezione degli endpoint sensibili al server di modelli (InferencePool e selettore di endpoint) in modo che la capacità della GPU venga utilizzata in modo efficiente. Tutti gli artefatti vengono gestiti temporaneamente nel registry Harbor dell'organizzazione GDC e l'intero stack viene eseguito in un cluster standard senza connettività esterna.
Cosa è incluso: questa architettura copre il deployment di Envoy Gateway ed Envoy Agent Router in un cluster standard, le risorse dell'API Gateway (GatewayClass, Gateway) e le risorse di Envoy Agent Router (AIGatewayRoute, AIServiceBackend, BackendSecurityPolicy, GatewayConfig) che espongono un endpoint unificato compatibile con OpenAI, il routing basato sul corpo nel campo model, l'estensione di inferenza dell'API Gateway (InferencePool, InferenceObjective, selettore di endpoint) per il bilanciamento del carico model-aware, la limitazione di frequenza facoltativa basata su token con Redis, la terminazione TLS nel gateway, le policy di rete (NetworkPolicy/ProjectNetworkPolicy) e la gestione degli artefatti air-gapped in Harbor. I backend di erogazione del modello dietro il gateway (Ollama, vLLM) vengono sottoposti a deployment con il set di guide complementari Modelli con pesi aperti su GDC con air gap.
Cosa non è incluso: questa architettura non copre un prodotto gateway AI gestito, il deployment e l'ottimizzazione dei modelli stessi (set di guide complementari), l'ottimizzazione dei modelli, le modalità di AI generativa non LLM, il traffico da agente a strumento (MCPRoute) o le distribuzioni di gateway supportate commercialmente. Gemini su GDC è una funzionalità del prodotto gestita; il suo provisioning non rientra nell'ambito e questa versione del set di guide convalida il gateway con modelli open weight self-hosted.
Pubblico: il pubblico principale di questo documento include gli amministratori della piattaforma responsabili del deployment e del funzionamento del gateway in un cluster standard e gli architetti tecnici che progettano piattaforme AI all'interno dell'ambiente con air gap. Gli sviluppatori di applicazioni che utilizzano l'endpoint unificato sono un pubblico secondario che trae vantaggio dalla comprensione del modo in cui vengono instradate le richieste.
Architettura
La soluzione viene eseguita interamente in un cluster standard dell'organizzazione GDC con air gap. Nel livello Servizi, l'API Gateway Kubernetes standardizza il modello di configurazione; il control plane del gateway AI (il controller Envoy Gateway e il controller Envoy Agent Router) legge le risorse dell'API Gateway e di Envoy Agent Router e configura il data plane: un proxy Envoy Deployment che è il punto di ingresso della richiesta (esposto tramite un Service di tipo LoadBalancer) e il processore esterno Envoy Agent Router che viene eseguito come sidecar nel proxy Pod ed esegue la logica specifica dell'AI. Nel livello di applicazione, i workload dei clienti (applicazioni e agenti) inviano una richiesta AI al proxy (1), il proxy consegna la richiesta al processore esterno, che estrae il nome del modello, traduce la richiesta e registra l'utilizzo dei token (2), il proxy inoltra il traffico bilanciato ai Pod di inferenza del modello selezionato (3) e il modello viene eseguito sui nodi GPU del livello di infrastruttura (4). I backend di erogazione del modello sono collegati al gateway come AIServiceBackend (qualsiasi Service compatibile con OpenAI) o come InferencePool il cui selettore di endpoint seleziona la migliore replica per richiesta. Le immagini container e i grafici Helm vengono estratti da Harbor.
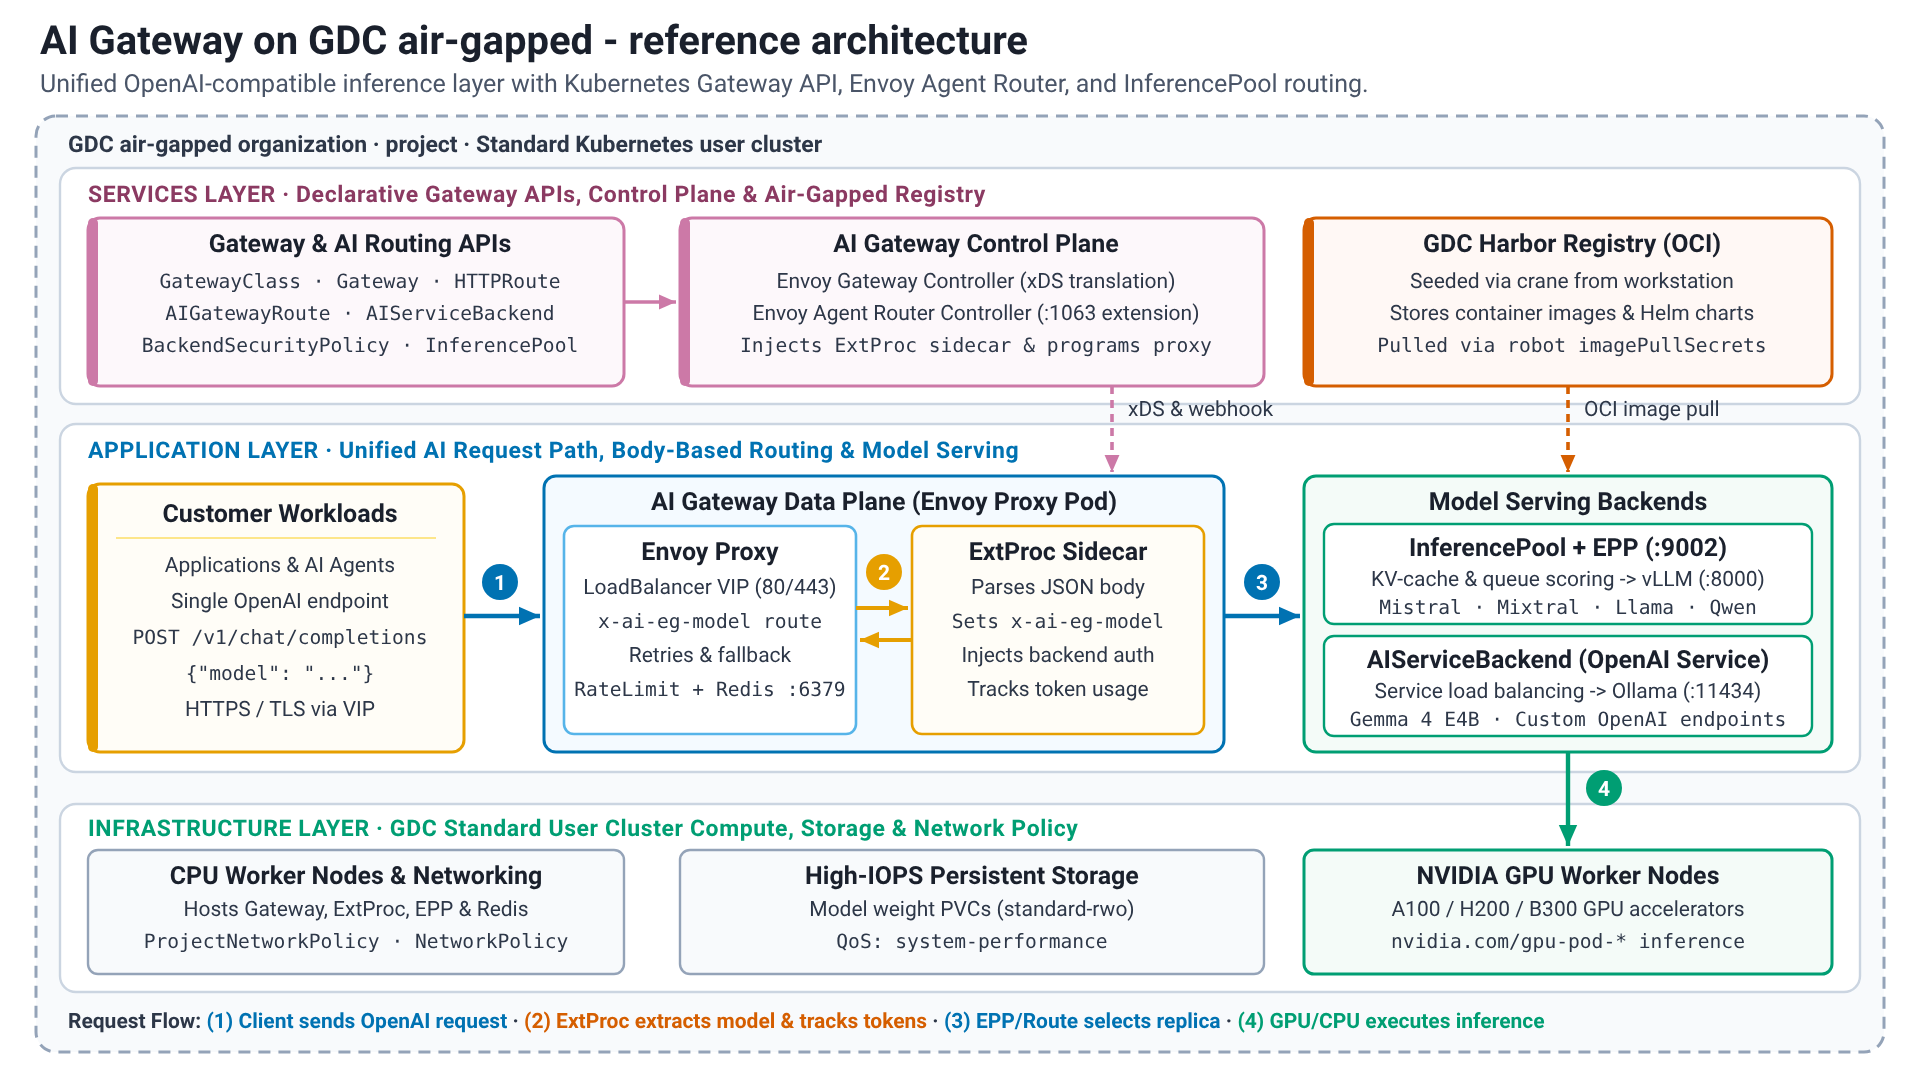
Componenti della soluzione
La soluzione utilizza i seguenti componenti:
| Componente della soluzione | Responsabilità | Flusso di dati | Interfacce |
|---|---|---|---|
| API Kubernetes Gateway | Modello di risorse standard orientato ai ruoli per l'ingress e il routing: GatewayClass (di proprietà della piattaforma), Gateway (listener, TLS) e risorse di route (di proprietà dei team delle applicazioni). Successore dell'API Ingress senza annotazioni specifiche del fornitore. |
Solo configurazione dichiarativa; le risorse sono monitorate dai controller e non trasportano traffico di richieste. | API Kubernetes (gateway.networking.k8s.io/v1); i CRD vengono installati dal grafico CRD di Envoy Gateway. |
| Controller Envoy Gateway (control plane) | Implementa l'API Gateway: esegue il provisioning di un proxy Envoy Deployment e LoadBalancer Service per Gateway, traduce route e policy (BackendTrafficPolicy, SecurityPolicy, EnvoyExtensionPolicy, Backend, EnvoyProxy) in configurazione xDS, esegue il servizio di limitazione di frequenza globale quando configurato e chiama il server di estensione Envoy Agent Router tramite il relativo gestore delle estensioni in modo che i backend InferencePool vengano aggiunti alla traduzione. |
Monitora l'API Kubernetes e invia la configurazione xDS ai proxy; nessun traffico di richieste. | API Kubernetes (watch), xDS gRPC verso i proxy, gRPC verso il server di estensione (porta 1063). |
| Controller Envoy Agent Router (control plane) | Riconcilia le risorse aigateway.envoyproxy.io/v1beta1, AIGatewayRoute (regole di instradamento sul nome del modello estratto), AIServiceBackend (un backend con il relativo schema dell'API), BackendSecurityPolicy (credenziali upstream) e GatewayConfig (impostazioni del processore esterno per Gateway) in risorse Envoy Gateway, inserisce il sidecar del processore esterno nei Pod del proxy Envoy ed eroga il server di estensione utilizzato da Envoy Gateway. |
Solo configurazione. | API Kubernetes, server di estensione gRPC (porta 1063), webhook di ammissione mutante per l'iniezione sidecar. |
| Proxy Envoy (piano dati) | Punto di ingresso della richiesta: termina TLS, associa listener e route, bilancia il carico tra gli endpoint di backend, applica limiti di frequenza e timeout, riprova e utilizza backend alternativi, genera log di accesso e metriche. | Riceve le richieste dei client sul VIP LoadBalancer (80/443), consulta il processore esterno per ogni richiesta AI, inoltra la richiesta all'endpoint di backend selezionato (un Service o il Pod scelto dal selettore di endpoint) e trasmette la risposta al client. |
HTTP/HTTPS verso i client (API compatibile con OpenAI), gRPC ext_proc verso il sidecar e il selettore di endpoint, HTTP verso i backend, gRPC verso il servizio di limitazione di frequenza. |
| Processore esterno (ExtProc) Envoy Agent Router | Analizza il corpo della richiesta compatibile con OpenAI, estrae il campo model nell'intestazione di routing x-ai-eg-model, applica gli override dei nomi dei modelli, traduce i payload di richiesta e risposta tra lo schema dell'API client e lo schema dell'API di backend, inserisce le credenziali upstream definite da BackendSecurityPolicy ed estrae l'utilizzo dei token (input, output, totale) dalla risposta nei metadati dinamici utilizzati per la limitazione di frequenza e le metriche basate sui token. |
Container sidecar nel proxy Envoy Pod; elabora i corpi delle richieste e delle risposte, incluse le risposte in streaming. |
gRPC ext_proc di Envoy; endpoint delle metriche di Prometheus. |
| Estensione di inferenza API Gateway (InferencePool + selettore di endpoint) | InferencePool (inference.networking.k8s.io/v1) raggruppa i Pod di un deployment del server di modelli (selettore di etichette, porta di destinazione, ad esempio 8000) e fa riferimento al relativo selettore di endpoint (EPP). InferenceObjective (v1alpha2) assegna una priorità per modello o obiettivo. L'EPP raccoglie le metriche del server di modelli (profondità della coda delle richieste, utilizzo della cache KV, adattatori LoRA caricati) e seleziona l'endpoint per ogni richiesta. |
Il proxy chiama l'EPP (ext_proc, porta 9002) con le intestazioni della richiesta; l'EPP risponde con l'endpoint da utilizzare; il proxy inoltra la richiesta a quell'Pod. |
API Kubernetes (CRD), gRPC ext_proc (9002), scraping di Prometheus dei server di modelli. |
| Redis (facoltativo) | Archivio di backup del servizio di limitazione di frequenza di Envoy: contatori condivisi per i limiti basati su richieste e token in tutte le repliche proxy. Necessario solo se è configurata la limitazione di frequenza globale. | Il servizio di limitazione di frequenza legge e incrementa i contatori sulla porta 6379 per ogni richiesta limitata. | Protocollo Redis (6379). Redis 8.10 di cui è stato eseguito il deployment nel cluster o un'istanza Redis esistente. |
| Backend di erogazione del modello (Ollama/vLLM) | Gestisci i modelli con pesi aperti dietro il gateway, di cui è stato eseguito il deployment con la guida complementare Configura i modelli con pesi aperti su GDC con air gap. Collegato come AIServiceBackend (qualsiasi Service compatibile con OpenAI, ad esempio Ollama) o come InferencePool (server di modelli come vLLM che espongono le metriche su cui si basa il punteggio del selettore di endpoint). |
Ricevono le richieste indirizzate dal proxy, eseguono l'inferenza sui nodi GPU (o sulla CPU per la valutazione funzionale con modelli di piccole dimensioni) e restituiscono la risposta compatibile con OpenAI. | API REST compatibile con OpenAI: vLLM sulla porta 8000, Ollama sulla porta 11434; metriche Prometheus (vLLM) per il selettore di endpoint. |
| Harbor | Archivia le immagini container (proxy Envoy, Envoy Gateway, controller Envoy Agent Router e processore esterno, servizio di limitazione di frequenza, Endpoint Picker, Redis) e i grafici Helm (artefatti OCI) della soluzione. | Gli artefatti vengono copiati dai registri pubblici in Harbor con seed_registry.sh (crane) da una workstation con accesso a internet; il cluster esegue il pull delle immagini con un account robot tramite secret di pull delle immagini e i grafici vengono visualizzati da Harbor con helm template. |
API OCI Distribution; UI di Harbor e account robot. |
| Cluster Standard e nodi GPU | Ospita tutti i componenti del gateway (sono sufficienti i nodi CPU) e i Pod di inferenza (nodi GPU con le risorse dell'acceleratore rilevate dai nodi). Fornisce VIP LoadBalancer, archiviazione permanente per i pesi del modello e l'applicazione delle policy di rete. |
Piattaforma di base; le richieste entrano tramite il VIP LoadBalancer di Gateway e rimangono all'interno della rete del cluster. |
API Kubernetes, API di networking GDC (networking.gdc.goog/v1 ProjectNetworkPolicy), console GDC e gdcloud per l'amministratore della piattaforma. |
Caratteristiche e funzionalità
Questa architettura di riferimento offre le seguenti funzionalità principali:
- Endpoint unificato compatibile con OpenAI: le applicazioni chiamano un indirizzo (
/v1/chat/completions,/v1/models, …) per ogni erogazione del modello dietro il gateway.- Componenti:
Gateway,AIGatewayRoute, proxy Envoy, processore esterno. - Responsabilità: esposizione di un IP virtuale stabile, terminazione di TLS, accettazione del formato di richiesta compatibile con OpenAI e traduzione nello schema di backend, se necessario.
- Interfacce: HTTPS REST (JSON, inclusi gli eventi inviati dal server per lo streaming).
- Componenti:
- Routing basato sul corpo (sensibile al modello): il gateway legge il campo
modeldel corpo della richiesta e indirizza la richiesta al backend corrispondente senza alcuna logica dell'endpoint lato client.- Componenti: processore esterno, regole
AIGatewayRoutecorrispondenti sux-ai-eg-model,AIServiceBackend,InferencePool. - Responsabilità: estrazione del nome del modello, corrispondenza delle regole di instradamento, ridenominazione dei modelli (
modelNameOverride), suddivisione del traffico in base al peso e fallback ai backend alternativi in base alla priorità. - Interfacce: API Kubernetes (
aigateway.envoyproxy.io/v1beta1).
- Componenti: processore esterno, regole
- Bilanciamento del carico basato sul server di modelli: le richieste a un
InferencePoolvengono inviate alla replica con la coda più breve e la cache KV più utile, anziché in modalità round robin.- Componenti: estensione di inferenza dell'API Gateway (
InferencePool,InferenceObjective, selettore di endpoint). - Responsabilità: scraping delle metriche del server di modelli, assegnazione di punteggi agli endpoint (profondità della coda, utilizzo della cache KV, affinità della cache dei prefissi, adattatori LoRA), rispetto delle priorità per obiettivo in condizioni di carico.
- Interfacce: API Kubernetes (
inference.networking.k8s.io/v1,inference.networking.x-k8s.io/v1alpha2), ext_proc gRPC (9002).
- Componenti: estensione di inferenza dell'API Gateway (
- Policy di autenticazione e sicurezza upstream: le credenziali per i backend che le richiedono vengono inserite dal gateway e non vengono mai distribuite alle applicazioni.
- Componenti:
BackendSecurityPolicy, Envoy GatewaySecurityPolicy, listener TLS. - Responsabilità: inserimento di chiavi API nei backend, terminazione del TLS client in
Gateway, applicazione delle policy di autenticazione e autorizzazione del client quando richiesto. - Interfacce:
SecretKubernetes a cui fanno riferimento le policy.
- Componenti:
- Limitazione di frequenza basata su token (facoltativa): l'utilizzo viene misurato in token, non solo in richieste.
- Componenti: processore esterno (
llmRequestCosts), Envoy GatewayBackendTrafficPolicy(limitazione di frequenza globale), servizio di limitazione di frequenza, Redis. - Responsabilità: estrazione dei token di input, output e totali da ogni risposta, associazione come costi delle richieste, applicazione dei budget per consumer o per modello in tutte le repliche del proxy.
- Interfacce: API Kubernetes, Redis (6379).
- Componenti: processore esterno (
- Gestione del traffico: le funzionalità standard dell'API Gateway si applicano al traffico AI.
- Componenti:
Gateway,HTTPRoute,AIGatewayRoute,BackendTrafficPolicy. - Responsabilità: corrispondenza basata su host, percorso e intestazione, timeout adatti a generazioni lunghe, nuovi tentativi, suddivisione del traffico ponderata e fallback basato sulla priorità tra i backend.
- Interfacce: API Kubernetes.
- Componenti:
- Osservabilità: le metriche relative a richieste, latenza e token sono disponibili per ogni modello.
- Componenti: log di accesso e statistiche del proxy Envoy, metriche del processore esterno (utilizzo dei token, durata della richiesta, tempo fino al primo token), metriche del selettore di endpoint.
- Responsabilità: esposizione delle metriche in formato Prometheus e dei log di accesso strutturati di cui lo stack di osservabilità di GDC o un Prometheus gestito dal cliente può eseguire lo scraping.
- Interfacce: endpoint delle metriche di Prometheus, log di output standard.
- Gestione degli artefatti air-gapped: ogni immagine e grafico viene preparato in Harbor prima dell'installazione.
- Componenti: Harbor,
seed_registry.sh, account robot, secret di pull delle immagini, risorsaEnvoyProxy(immagine proxy e secret di pull). - Responsabilità: seeding di immagini e grafici Helm OCI da una workstation connessa, blocco delle versioni, rendering dei grafici offline con
helm template. - Interfacce: API OCI Distribution, API Kubernetes.
- Componenti: Harbor,
Principi di architettura
- Standard First: il gateway viene configurato tramite l'API Gateway di Kubernetes e la relativa estensione di inferenza e comunica con l'API compatibile con OpenAI verso le applicazioni, in modo che applicazioni, route e backend rimangano portabili tra le implementazioni del gateway.
- La sicurezza prima di tutto: tutti i componenti e i dati risiedono all'interno del confine con air gap di GDC. La terminazione TLS avviene in
Gateway, le credenziali di backend vengono inserite dal gateway e l'accesso alla rete è limitato con gli oggettiNetworkPolicyeProjectNetworkPolicy. - Sovranità dei dati: prompt, risposte, pesi del modello e dati di utilizzo non lasciano mai l'organizzazione GDC del cliente; non è richiesta alcuna connettività esterna per il funzionamento.
- Separazione delle responsabilità: l'API Gateway orientata ai ruoli consente all'amministratore della piattaforma di gestire le policy di rete, TLS,
GatewayClasseGateway, mentre i team delle applicazioni gestiscono le risorseAIGatewayRoute,AIServiceBackendeInferencePoolnei propri spazi dei nomi. - Control plane e data plane disaccoppiati: i controller traducono solo la configurazione; il percorso della richiesta è costituito dal proxy Envoy, dal sidecar del processore esterno e dal selettore di endpoint, che continuano a gestire il traffico se un controller viene riavviato.
- Aperta e flessibile: l'architettura utilizza software open source in tutto (Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension, Ollama, vLLM) e le stesse risorse dell'API Gateway possono essere gestite da implementazioni alternative.
- Scalabilità e prestazioni: il piano dati scala orizzontalmente aggiungendo repliche proxy e verticalmente regolando la CPU e la memoria; il bilanciamento del carico basato sul server di modelli mantiene le GPU sature senza sovraccaricare le singole repliche.
- Esperienza utente finale semplificata: un endpoint, un formato API e una credenziale per ogni modello abbreviano il percorso dal deployment del modello al consumo.
- Resilienza: i controlli di integrità e la replica di Kubernetes, i nuovi tentativi di Envoy e il fallback basato sulla priorità tra i backend mantengono l'endpoint disponibile in caso di errore delle singole repliche del modello.
Considerazioni
- Scalabilità e prestazioni:
- I componenti del gateway sono workload solo CPU; il proxy Envoy
Deploymentdi unGatewayscala orizzontalmente aumentando il numero di repliche (risorsaEnvoyProxy) e verticalmente aumentando le richieste di CPU e memoria. L'ispezione del corpo da parte del processore esterno comporta un costo della CPU proporzionale alle dimensioni della richiesta e della risposta; le risposte in streaming vengono elaborate in modo incrementale. - Il bilanciamento del carico sensibile al server di modelli si applica solo ai backend collegati come
InferencePool; i backend collegati comeAIServiceBackendvengono bilanciati dal proxy tra gli endpoint del relativoService. - Il gateway non aggiunge capacità GPU: il throughput e la latenza sono limitati dai server di modelli. Dimensiona i deployment dei modelli con il set di guide complementari (vLLM per un throughput elevato, Ollama per la facilità d'uso e la valutazione solo della CPU).
- Le generazioni lunghe richiedono timeout di inattività e di richiesta più lunghi rispetto alle tipiche API HTTP; configurali sulle route e sulle policy anziché sui client.
- I componenti del gateway sono workload solo CPU; il proxy Envoy
- Gestione delle risorse:
- Tutti i componenti del gateway vengono eseguiti su nodi CPU e non richiedono acceleratori. La tabella seguente fornisce un dimensionamento indicativo per un deployment funzionale. L'implementazione di riferimento imposta le richieste e i limiti esatti; i valori di produzione dipendono dal tasso di richieste e dalle dimensioni del payload.
- La tabella delle porte che segue elenca tutte le porte che le policy di rete devono ammettere.
- La pianificazione della GPU appartiene ai deployment dei modelli: i nomi delle risorse dell'acceleratore vengono rilevati dai nodi come descritto nel set di guide complementari.
Dimensionamento indicativo dei componenti del gateway (solo CPU)
| Componente | Repliche | CPU (richiesta) | Memoria (richiesta) | Note |
|---|---|---|---|---|
| Controller Envoy Gateway | 1 | 100 mln - 500 mln | 256Mi–1Gi | Control plane; non nel percorso della richiesta |
| Controller Envoy Agent Router | 1 | 100 mln - 500 mln | 256Mi–512Mi | Control plane e server di estensione |
Proxy Envoy Pod (proxy + sidecar del processore esterno) |
1-2 per Gateway |
500 m-2 | 512Mi–2Gi | Scala in base al tasso di richieste e alle dimensioni del payload |
| Selettore endpoint | 1 per InferencePool |
100 mln - 500 mln | 256Mi–512Mi | Esegue lo scraping delle metriche del server di modelli |
| Servizio di limitazione di frequenza (facoltativo) | 1 | 100 mln - 500 mln | 256Mi–512Mi | Solo con limitazione di frequenza globale |
| Redis (facoltativo) | 1 | 100 mln - 500 mln | 256Mi–1Gi | Solo con limitazione di frequenza globale |
Porte di rete
| Porta | Componente | Finalità |
|---|---|---|
| 80 / 443 | Proxy Envoy (Gateway listener) |
Punto di ingresso HTTP/HTTPS sul VIP LoadBalancer |
| 1063 | Controller Envoy Agent Router (server di estensione) | Chiamate gRPC dal gestore delle estensioni di Envoy Gateway |
| 9002 | Selettore endpoint | Chiamate gRPC ext_proc dal proxy Envoy |
| 6379 | Redis | Contatori di limitazione di frequenza |
| 8000 | vLLM | API e metriche compatibili con OpenAI del server di modelli |
| 11434 | Ollama | API compatibile con Ollama e OpenAI del server di modelli |
- Disponibilità e affidabilità:
- Il proxy e il processore esterno vengono eseguiti nello stesso
Pod; più repliche dietroLoadBalancerServicemascherano i singoli errori diPode i controller possono riavviarsi senza interrompere il traffico. - Le regole
AIGatewayRoutepossono elencare diversi backend con priorità in modo che il gateway esegua il fallback a un altro set di repliche o server di modelli quando un backend non è integro. - Il selettore di endpoint è un
Deploymentper pool; se non è disponibile, le richieste a quelInferencePoolnon vanno a buon fine finché non torna disponibile. Eseguilo con richieste di risorse e probe di idoneità e monitoralo come un componente del piano dati. - Redis contiene solo i contatori di limitazione di frequenza; un'interruzione di Redis influisce sulla limitazione di frequenza, non sul routing.
- Il proxy e il processore esterno vengono eseguiti nello stesso
- Complessità operativa:
- Allineamento delle versioni tra Envoy Gateway, Envoy Agent Router e l'estensione di inferenza dell'API Gateway: esegui l'upgrade dei tre componenti insieme alla combinazione testata (Envoy Gateway 1.8.4, Envoy Agent Router 1.1.0, estensione di inferenza dell'API Gateway 1.5.0).
- Ciclo di vita con air gap: ogni immagine e grafico viene reinserito in Harbor per ogni upgrade; la risorsa
EnvoyProxye i valori del grafico bloccano il registry e il secret di pull. - Due livelli di configurazione:
GatewayClass/Gateway/EnvoyProxydi proprietà della piattaforma eAIGatewayRoute/AIServiceBackend/InferencePooldi proprietà del team; l'onboarding di un nuovo modello significa aggiungere una regola di instradamento e un backend, non un nuovo gateway. - Monitoraggio: tasso di richieste, latenza (incluso il tempo per il primo token), utilizzo dei token per modello e per consumer, punteggio del selettore di endpoint e utilizzo della GPU dei server di modelli.
InferenceObjectiveè ancora un'API alpha (v1alpha2); aspettati modifiche allo schema tra le release dell'estensione Inference.
- Sicurezza e conformità:
- L'intera soluzione opera all'interno del perimetro di sicurezza con air gap di GDC.
- Le policy di rete sono obbligatorie: uno spazio dei nomi
NetworkPolicyammette il traffico dal proxy alle porte del server di modelli (8000, 11434) e all'Endpoint Picker (9002) e unProjectNetworkPolicyammette il traffico dei client alLoadBalancerVIP quando i consumatori risiedono al di fuori del progetto. - La terminazione TLS avviene in
Gatewaycon un certificato archiviato in unSecretKubernetes; i client vedono solo l'endpoint del gateway. - Le credenziali upstream (ad esempio una chiave API richiesta da un server di modelli)
sono archiviate in
Secreta cui fa riferimento unBackendSecurityPolicye inserite dal gateway, in modo che le applicazioni non contengano mai credenziali di backend. - La limitazione di frequenza basata su token limita il consumo della costosa capacità della GPU per consumer o per modello.
- Gli account robot di Harbor e i secret di pull delle immagini di Kubernetes garantiscono un accesso sicuro alle immagini container; il RBAC dell'API Gateway orientato ai ruoli separa le responsabilità della piattaforma e dell'applicazione.
Decisioni di progettazione
Per questa architettura di riferimento sono state prese le seguenti decisioni chiave di progettazione:
Decisione 1: implementazione del gateway AI: Envoy Agent Router open source su Envoy Gateway rispetto a distribuzioni alternative
| Contesto | Decisione chiave | Rationale |
|---|---|---|
| Il gateway AI è la scelta architettonica principale con alternative valide, dalle opzioni open source autogestite alle offerte supportate commercialmente: (a) Envoy Agent Router su Envoy Gateway (open source), (b) kgateway e agentgateway (implementazioni dell'API Gateway open source che gestiscono anche il traffico dei provider LLM, gli strumenti MCP e la comunicazione tra agenti in un unico piano dati, facoltativamente con il supporto del fornitore da solo.io), (c) Solo Enterprise per agentgateway come opzione premium supportata commercialmente. | L'implementazione di riferimento utilizza l'agente router Envoy open source su Envoy Gateway. Le alternative rimangono scelte valide dietro le stesse risorse dell'API Gateway; per gli ambienti di produzione che richiedono un'assistenza dedicata del fornitore, è consigliata una distribuzione supportata commercialmente. | Vantaggi dell'open source: leggero e conforme agli standard, routing L7 ad alte prestazioni, nessuna tariffa per la licenza, ideale per valutare la soluzione prima di impegnarsi in un'offerta a pagamento; Envoy Agent Router è l'opzione convalidata in questo set di guide. Svantaggi dell'open source: l'assistenza è fornita secondo il criterio del "best effort" dal team Solutions ed è guidata dalla community, il che potrebbe non soddisfare gli ambienti di produzione principali. Vantaggi premium: contratti di assistenza per le aziende per il ciclo di vita del gateway e, spesso, funzionalità agentiche avanzate. Svantaggi della versione Premium: contratto di licenza o assistenza a pagamento e un rapporto aggiuntivo con il fornitore. |
Decisione 2: API Kubernetes Gateway con l'estensione di inferenza rispetto a Ingress o a un'API Gateway proprietaria
| Contesto | Decisione chiave | Rationale |
|---|---|---|
| Gli endpoint di inferenza possono essere esposti con l'API Ingress legacy, un formato di configurazione specifico del gateway o l'API Gateway di Kubernetes. Il bilanciamento del carico model-aware richiede inoltre un modo per descrivere i pool di server di modelli e le relative priorità. | La soluzione si basa sull'API Kubernetes Gateway (GatewayClass, Gateway, route) implementata da Envoy Gateway e sull'estensione di inferenza dell'API Gateway (InferencePool, InferenceObjective, selettore di endpoint) per il routing model-aware. |
L'API Gateway è lo standard Kubernetes che succede a Ingress, è orientato ai ruoli (team della piattaforma rispetto ai team delle applicazioni) e portabile tra le implementazioni. L'estensione Inference è lo standard della community per il routing basato sul server di modelli (profondità della coda, cache KV, priorità) ed è supportata da Envoy Agent Router out-of-the-box; le distribuzioni di gateway alternative implementano le stesse API, il che mantiene reversibile la Decisione 1. |
Decisione 3: routing basato sul corpo nel campo model delle richieste compatibili con OpenAI come endpoint unificato
| Contesto | Decisione chiave | Rationale |
|---|---|---|
Le applicazioni possono indirizzare i modelli tramite un endpoint per modello (basato su host o percorso), tramite un'intestazione personalizzata impostata dal client o tramite il campo model già presente in ogni richiesta compatibile con OpenAI. |
Il gateway espone un endpoint compatibile con OpenAI e instrada sul campo model: il processore esterno lo estrae nell'intestazione x-ai-eg-model e le regole AIGatewayRoute corrispondono a questa intestazione. |
I client e gli SDK compatibili con OpenAI esistenti funzionano senza modifiche e cambiano i modelli modificando una stringa; gli endpoint, le credenziali e il posizionamento dei modelli possono cambiare senza toccare le applicazioni; le stesse regole possono mappare un nome di modello a più backend per la suddivisione del traffico, il fallback o l'override del nome del modello. |
Decisione 4: seeding degli artefatti con air gap in Harbor rispetto ai pull on demand
| Contesto | Decisione chiave | Rationale |
|---|---|---|
| L'installazione upstream estrae le immagini container dai registri pubblici e i grafici Helm come artefatti OCI on demand, il che è impossibile in un ambiente con air gap. | Tutte le immagini container (proxy Envoy, Envoy Gateway, controller Envoy Agent Router e processore esterno, servizio di limitazione di frequenza, Endpoint Picker, Redis) e i grafici Helm di Envoy Gateway ed Envoy Agent Router vengono inseriti in un progetto Harbor con seed_registry.sh (crane), i grafici vengono visualizzati offline con helm template da Harbor e la risorsa EnvoyProxy e i valori dei grafici bloccano il registry Harbor e il secret di pull. |
Un passaggio di seeding ripetibile e controllabile per versione; il cluster non ha mai bisogno di connettività esterna; il blocco della versione rende gli upgrade espliciti e reversibili. |
Decisione 5: limitazione di frequenza facoltativa basata su token con Redis rispetto ai limiti basati solo sulle richieste
| Contesto | Decisione chiave | Rationale |
|---|---|---|
| La capacità della GPU viene consumata per token, non per richiesta; un limite al numero di richieste non può proteggere un modello condiviso da alcuni prompt molto grandi o da generazioni lunghe. La limitazione di frequenza globale in Envoy Gateway richiede un archivio di contatori condiviso. | La limitazione di frequenza basata su token è una funzionalità facoltativa dell'architettura: il processore esterno registra i token di input, output e totali per richiesta (llmRequestCosts), un BackendTrafficPolicy applica il budget e un'istanza Redis (Redis 8.10, di cui è stato eseguito il deployment nel cluster o un'istanza esistente) archivia i contatori. I deployment senza limitazione di frequenza non richiedono Redis. |
L'utilizzo viene misurato nell'unità che riflette il costo, i budget vengono applicati in modo coerente a tutte le repliche proxy e la dipendenza viene pagata solo dai clienti che hanno bisogno di quote. |
Decisione 6: Topologia: piano di controllo e dati del gateway in uno spazio dei nomi dedicato di un cluster standard, modelli negli spazi dei nomi delle applicazioni
| Contesto | Decisione chiave | Rationale |
|---|---|---|
| Il gateway potrebbe essere eseguito in un cluster dedicato, in ogni spazio dei nomi dell'applicazione o una volta per cluster standard accanto ai modelli che gestisce. Il deployment dei modelli open weight su GDC con air gap viene eseguito in cluster standard (set di guide complementari). | Il control plane di Envoy Gateway ed Envoy Agent Router e il piano dati del proxy Envoy vengono eseguiti in uno spazio dei nomi dedicato del cluster standard che ospita i modelli; AIGatewayRoute, AIServiceBackend, InferencePool e i deployment dei modelli si trovano negli spazi dei nomi dell'applicazione e vengono referenziati tra gli spazi dei nomi. |
Le richieste rimangono all'interno della rete del cluster tra il proxy e i Pod del modello (latenza minima, nessun bilanciatore del carico aggiuntivo), l'amministratore della piattaforma è proprietario dello spazio dei nomi del gateway, mentre i team delle applicazioni sono proprietari delle route e dei modelli e il selettore di endpoint può eseguire lo scraping direttamente dei server di modelli. Un gateway client per progetto che inoltra a un gateway server centrale rimane un'estensione di questa topologia per l'utilizzo multiprogetto. |
Ipotesi e limitazioni
- L'ambiente GDC con air gap 1.16.2-hf1 o versioni successive è disponibile con un cluster standard che esegue Kubernetes v1.32.13-gke.400 o versioni successive.
- Sono presenti risorse hardware sufficienti (soprattutto GPU) per i backend di erogazione del modello; i componenti del gateway vengono eseguiti sui nodi della CPU. I modelli reali richiedono GPU; i modelli di piccole dimensioni su Ollama possono essere eseguiti su CPU solo per la valutazione funzionale.
- L'istanza Harbor è configurata e accessibile ed è disponibile una workstation con accesso a internet e connettività all'ambiente GDC (API Harbor e Kubernetes) per il seeding di immagini e grafici.
- Gli utenti dispongono delle autorizzazioni necessarie: i ruoli di progetto Harbor Instance Viewer e Standard Cluster Admin, oltre a un
StandardClusterRoleBindingper il ruolocluster-adminsul cluster standard per l'installazione con ambito cluster (CRD,GatewayClass, spazi dei nomi). Consulta l'implementazione di riferimento. - I backend di erogazione del modello espongono un'API compatibile con OpenAI; i backend collegati come
InferencePoolespongono anche le metriche compatibili con vLLM su cui si basa il selettore di endpoint. - Limitazione: il supporto per i componenti open source (Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension) è fornito dal team Solutions; l'assistenza dedicata del fornitore richiede una distribuzione supportata commercialmente (Decisione 1).
- Limitazione:
InferenceObjectiveè un'API alpha (inference.networking.x-k8s.io/v1alpha2) e potrebbe cambiare tra le release dell'estensione di inferenza. - Limitazione: sono necessari un VIP
LoadBalancerperGatewaye unProjectNetworkPolicyper i consumer esterni al progetto; all'interno del progetto, i client nel cluster okubectl port-forwardpossono raggiungere direttamente il gatewayService. - Limitazione: Gemini su GDC, l'ottimizzazione del modello, i modelli di AI generativa non LLM e l'erogazione del modello multi-nodo non rientrano nell'ambito di questa versione della soluzione.
Flusso utente
Di seguito è riportato un flusso utente completo per il gateway AI su GDC con air gap: prima il percorso della richiesta su cui si basa uno sviluppatore di applicazioni, poi il percorso di configurazione seguito dall'amministratore della piattaforma.
1. Percorso di richiesta dello sviluppatore
Un'applicazione o un agente non ha bisogno di altro che dell'endpoint del gateway, di una credenziale client se il gateway ne applica una e del nome del modello.
- Invia la richiesta: l'applicazione chiama
POST /v1/chat/completionssull'endpoint del gateway con un corpo JSON compatibile con OpenAI che assegna un nome al modello (ad esempio"model": "gemma"), esattamente come chiamerebbe qualsiasi servizio compatibile con OpenAI. - Entra nel gateway: la richiesta raggiunge il VIP
LoadBalancerdiGateway; il proxy Envoy termina TLS e trova il listener e la route corrispondenti. - Elaborazione del corpo: il proxy passa la richiesta al processore esterno Envoy Agent Router, che analizza il corpo, estrae il nome del modello nell'intestazione
x-ai-eg-modele traduce il payload nello schema del backend se è diverso. - Seleziona il backend: la regola
AIGatewayRouteche corrisponde al nome del modello seleziona unAIServiceBackend(ad esempio OllamaService) o unInferencePool(ad esempio un set di repliche vLLM); per unInferencePool, il selettore di endpoint sceglie la replica con la coda più breve e la migliore corrispondenza della cache KV. - Inoltro e risposta: il proxy inserisce le credenziali upstream quando si applica un
BackendSecurityPolicy, inoltra la richiesta alPodscelto, trasmette la risposta in streaming e consente al processore esterno di registrare l'utilizzo dei token, che alimenta le metriche e, se configurato, il limite di frequenza basato sui token. - Cambia modello: per utilizzare un altro modello, lo sviluppatore modifica la stringa
model; non sono necessari nuovi endpoint, credenziali o librerie client.
2. Percorso di configurazione per l'amministratore della piattaforma
- Esegui il seeding degli artefatti in Harbor: crea gli account robot di Harbor, quindi copia le immagini container e i grafici Helm di Envoy Gateway ed Envoy Agent Router in Harbor con
seed_registry.shda una workstation con accesso a internet. - Installa Envoy Gateway: esegui il rendering dei grafici CRD e del controller da Harbor con
helm templatee applicali nello spazio dei nomi del gateway; crea la risorsaEnvoyProxyche blocca l'immagine proxy e il secret di pull e verifica il controller conGatewayClass,GatewayeHTTPRoutedi base. - Installa Envoy Agent Router: installa i CRD di Envoy Agent Router e i CRD dell'estensione di inferenza dell'API Gateway, esegui il deployment del controller di Envoy Agent Router e riconfigura Envoy Gateway per chiamare il suo server di estensione (porta 1063) e accettare i backend
InferencePool; facoltativamente, esegui il deployment di Redis e attiva il servizio di limitazione di frequenza globale. - Esponi il gateway: crea
GatewayClasseGatewaycon listener HTTP e HTTPS (certificato TLSSecret), attendi il VIPLoadBalancere applicaProjectNetworkPolicyper i consumer esterni al progetto. - Collega i modelli: esegui il deployment dei backend di erogazione del modello con il set di guide complementari, quindi crea risorse
AIServiceBackendperServicecompatibili con OpenAI eInferencePool, oltre alle risorse Endpoint Picker per i set di repliche compatibili con vLLM, insieme agli oggettiNetworkPolicydello spazio dei nomi. - Pubblica la route: crea
AIGatewayRoutecon una regola per nome del modello (routing basato sul corpo) e, se necessario, oggettiBackendSecurityPolicyeBackendTrafficPolicyper le credenziali upstream e i budget dei token. - Convalida e operatività: chiama
/v1/modelse/v1/chat/completionstramite il VIP (o un fallbackkubectl port-forward), controlla le metriche del proxy, del processore esterno e del selettore di endpoint e fornisci i nomi degli endpoint e dei modelli ai team delle applicazioni. Scala le repliche del proxy e i deployment dei modelli in modo indipendente; esegui l'upgrade di Envoy Gateway, Envoy Agent Router e Inference Extension insieme.
I passaggi dettagliati sono forniti nell'implementazione di riferimento di Envoy Agent Router e nella guida dell'utente per il routing basato sul corpo con Envoy Agent Router.
Materiali aggiuntivi
- Implementazione di riferimento di Envoy Agent Router
- Guida dell'utente per il routing basato sul corpo con Envoy Agent Router
- Architettura di riferimento per gli LLM con pesi aperti
- Documentazione di Envoy Agent Router
- Envoy Gateway
- API Kubernetes Gateway
- Estensione Gateway API Inference
- Documentazione di Google Distributed Cloud con air gap