


Pernyataan Masalah
Organisasi yang menjalankan Model Bahasa Besar (LLM) di lingkungan dengan air gap dengan cepat mengumpulkan endpoint penyajian model: setiap model bobot terbuka yang disajikan di Google Distributed Cloud (GDC) dengan air gap (lihat panduan pendamping set Model Bobot Terbuka di GDC dengan air gap) mengekspos Service Kubernetes-nya sendiri, alamatnya sendiri, kredensialnya sendiri, dan siklus proses operasionalnya sendiri.
Developer aplikasi dan agen terjebak dalam silo arsitektur, melakukan hard code pada satu endpoint per model dan menulis ulang integrasi dengan setiap iterasi model. Fragmentasi ini menciptakan utang teknis dan memperlambat deployment workload agentic multilangkah yang sangat penting.
Lapisan jaringan standar juga "tidak mendukung AI": load balancer konvensional
memperlakukan traffic inferensi seperti HTTP generik dan tidak dapat membaca kolom model dari
permintaan, memprioritaskan workload yang sensitif terhadap latensi, memperhitungkan token, bukan
permintaan, atau mengarahkan permintaan ke replika server model yang sudah menyimpan
cache KV yang relevan. Dalam cluster GPU air-gapped yang berbiaya tinggi, hal ini menyebabkan kurangnya pemanfaatan hardware dan laba atas investasi yang buruk. Meskipun Gemini di
GDC
menyediakan model termutakhir terkelola, pelanggan yang menggabungkannya dengan model open weight
yang dihosting sendiri memerlukan lapisan inferensi yang menawarkan fleksibilitas seperti cloud
tanpa mengorbankan kedaulatan data: tidak ada permintaan, perintah, atau bobot model yang boleh
keluar dari batas GDC.
Solusi yang diusulkan
Dokumen ini menguraikan arsitektur referensi untuk gateway AI yang dikelola sendiri
di GDC dengan air gap: lapisan inferensi yang aman dan terpusat
yang memberi aplikasi satu endpoint yang kompatibel dengan OpenAI untuk semua model dan merutekan
setiap permintaan ke backend yang tepat. Implementasi referensi ini dibangun di atas
Kubernetes Gateway API: Envoy Gateway adalah implementasi Gateway API (bidang
kontrol dan bidang data proxy Envoy) dan Envoy Agent Router (sebelumnya Envoy AI
Gateway) memperluasnya dengan pemrosesan permintaan khusus AI: ekstraksi model dari
isi permintaan, terjemahan permintaan dan respons, autentikasi upstream,
penghitungan token, dan, secara opsional, pembatasan kapasitas berbasis token. Gateway API
Inference Extension menambahkan pemilihan endpoint yang mendukung server model (InferencePool
dan Endpoint Picker) sehingga kapasitas GPU digunakan secara efisien. Semua artefak di-stage di registry Harbor organisasi GDC dan seluruh stack berjalan di cluster standar tanpa konektivitas eksternal.
Yang disertakan: Arsitektur ini mencakup deployment Envoy Gateway
dan Envoy Agent Router di cluster standar, resource Gateway API
(GatewayClass, Gateway) dan resource Envoy Agent Router (AIGatewayRoute,
AIServiceBackend, BackendSecurityPolicy, GatewayConfig) yang mengekspos
endpoint terpadu yang kompatibel dengan OpenAI, perutean berbasis isi pada kolom model,
Gateway API Inference Extension (InferencePool, InferenceObjective, Endpoint
Picker) untuk load balancing berbasis model, pembatasan kapasitas berbasis token opsional dengan
Redis, TLS termination di gateway, kebijakan jaringan (NetworkPolicy /
ProjectNetworkPolicy), dan pengelolaan artefak dengan air-gap di Harbor. Backend penyajian model di balik gateway (Ollama, vLLM) di-deploy dengan panduan pendamping yang ditetapkan Open Weight Models di GDC dengan air gap.
Yang tidak disertakan: Arsitektur ini tidak mencakup produk gateway AI terkelola, deployment dan penyesuaian model itu sendiri (set panduan pendamping), penyesuaian model, modalitas GenAI non-LLM, traffic agen ke alat (MCPRoute), atau distribusi gateway yang didukung secara komersial. Gemini di
GDC adalah kemampuan produk terkelola; penyediaannya
berada di luar cakupan dan versi panduan ini memvalidasi gateway dengan
model open weight yang dihosting sendiri.
Audiens: Audiens utama untuk dokumen ini mencakup Administrator Platform yang bertanggung jawab untuk men-deploy dan mengoperasikan gateway di cluster standar dan arsitek teknis yang mendesain platform AI dalam lingkungan air-gapped. Developer aplikasi yang menggunakan endpoint terpadu adalah audiens sekunder yang mendapatkan manfaat dari pemahaman tentang cara permintaan mereka dirutekan.
Arsitektur
Solusi ini berjalan sepenuhnya di cluster standar organisasi GDC dengan air gap. Di lapisan Layanan,
Kubernetes Gateway API menstandarkan model konfigurasi; bidang kontrol gateway AI (pengontrol Envoy Gateway dan pengontrol Envoy Agent Router)
membaca resource Gateway API dan Envoy Agent Router serta
mengonfigurasi bidang data: proxy Envoy Deployment yang merupakan titik entri
permintaan (diekspos melalui Service jenis LoadBalancer) dan pemroses eksternal Envoy Agent
Router yang berjalan sebagai file bantuan di proxy Pod dan menjalankan
logika khusus AI. Di lapisan Aplikasi, workload pelanggan (aplikasi dan agen) mengirimkan permintaan AI ke proxy (1), proxy menyerahkan permintaan ke pemroses eksternal, yang mengekstrak nama model, menerjemahkan permintaan, dan mencatat penggunaan token (2), proxy meneruskan traffic yang seimbang ke Pod inferensi model yang dipilih (3), dan model berjalan di node GPU lapisan Infrastruktur (4). Backend penyajian model dilampirkan ke gateway sebagai AIServiceBackend (Service yang kompatibel dengan OpenAI) atau sebagai InferencePool yang Pemilih Endpoint-nya memilih replika terbaik per permintaan. Image container dan diagram Helm ditarik dari Harbor.
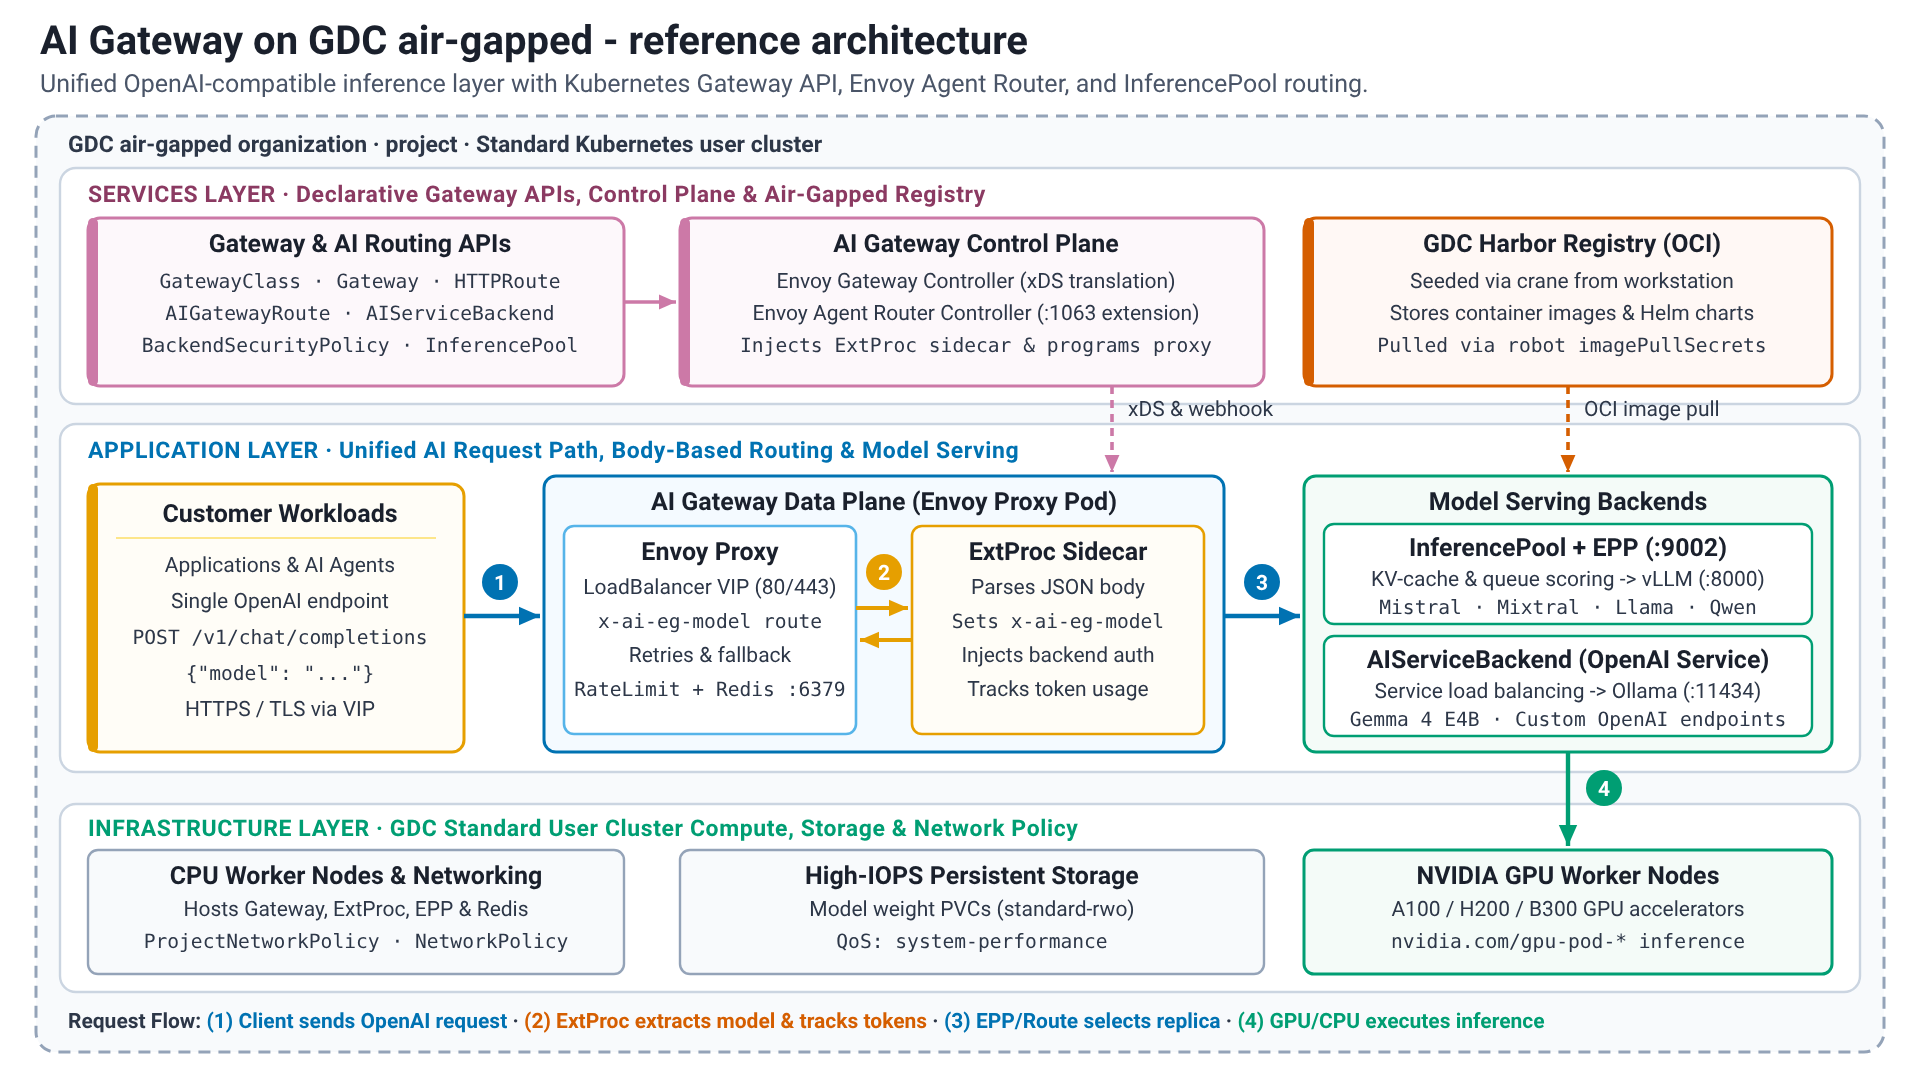
Komponen solusi
Solusi ini menggunakan komponen berikut:
| Komponen Solusi | Tanggung Jawab | Aliran Data | Antarmuka |
|---|---|---|---|
| Kubernetes Gateway API | Model resource standar yang berorientasi pada peran untuk ingress dan pemilihan rute: GatewayClass (dimiliki oleh platform), Gateway (pemroses, TLS), dan resource rute (dimiliki oleh tim aplikasi). Penerus Ingress API tanpa anotasi khusus vendor. |
Hanya konfigurasi deklaratif; resource dipantau oleh pengontrol dan tidak membawa traffic permintaan. | Kubernetes API (gateway.networking.k8s.io/v1); CRD diinstal dari diagram CRD Envoy Gateway. |
| Pengontrol Envoy Gateway (bidang kontrol) | Mengimplementasikan Gateway API: menyediakan satu proxy Envoy Deployment dan LoadBalancer Service per Gateway, menerjemahkan rute dan kebijakan (BackendTrafficPolicy, SecurityPolicy, EnvoyExtensionPolicy, Backend, EnvoyProxy) ke dalam konfigurasi xDS, menjalankan layanan pembatasan kapasitas global saat dikonfigurasi, dan memanggil server ekstensi Envoy Agent Router melalui pengelola ekstensinya sehingga backend InferencePool ditambahkan ke terjemahan. |
Memantau Kubernetes API dan mengirimkan konfigurasi xDS ke proxy; tidak ada traffic permintaan. | Kubernetes API (watch), xDS gRPC ke proxy, gRPC ke server ekstensi (port 1063). |
| Pengontrol Envoy Agent Router (bidang kontrol) | Merekonsiliasi resource aigateway.envoyproxy.io/v1beta1, AIGatewayRoute (aturan pemilihan rute pada nama model yang diekstrak), AIServiceBackend (backend dengan skema API-nya), BackendSecurityPolicy (kredensial upstream), dan GatewayConfig (setelan pemroses eksternal per Gateway), ke dalam resource Envoy Gateway, memasukkan sidecar pemroses eksternal ke dalam Pod proxy Envoy, dan menyajikan server ekstensi yang digunakan oleh Envoy Gateway. |
Hanya konfigurasi. | Kubernetes API, server ekstensi gRPC (port 1063), webhook penerimaan mutasi untuk injeksi sidecar. |
| Proxy Envoy (bidang data) | Titik entri permintaan: menghentikan TLS, mencocokkan pemroses dan rute, melakukan load balancing di seluruh endpoint backend, menerapkan batas kapasitas dan waktu tunggu, mencoba ulang dan beralih ke backend alternatif, serta memunculkan log akses dan metrik. | Menerima permintaan klien di VIP LoadBalancer (80/443), berkonsultasi dengan pemroses eksternal untuk setiap permintaan AI, meneruskan permintaan ke endpoint backend yang dipilih (Service atau Pod yang dipilih oleh Pemilih Endpoint), dan melakukan streaming respons kembali ke klien. |
HTTP/HTTPS ke klien (API yang kompatibel dengan OpenAI), gRPC ext_proc ke sidecar dan Pemilih Endpoint, HTTP ke backend, gRPC ke layanan pembatasan kapasitas. |
| Pemroses eksternal (ExtProc) Envoy Agent Router | Mengurai isi permintaan yang kompatibel dengan OpenAI, mengekstrak kolom model ke dalam header pemilihan rute x-ai-eg-model, menerapkan penggantian nama model, menerjemahkan payload permintaan dan respons antara skema API klien dan skema API backend, memasukkan kredensial upstream yang ditentukan oleh BackendSecurityPolicy, dan mengekstrak penggunaan token (input, output, total) dari respons ke dalam metadata dinamis yang digunakan untuk pembatasan kapasitas dan metrik berbasis token. |
Container sidecar di proxy Envoy Pod; memproses isi permintaan dan respons, termasuk respons yang di-streaming. |
gRPC ext_proc Envoy; endpoint metrik Prometheus. |
| Gateway API Inference Extension (InferencePool + Endpoint Picker) | InferencePool (inference.networking.k8s.io/v1) mengelompokkan Pod dari satu deployment server model (pemilih label, port target, misalnya 8000) dan mereferensikan Endpoint Picker (EPP)-nya. InferenceObjective (v1alpha2) menetapkan prioritas per model atau tujuan. EPP mengumpulkan metrik server model (kedalaman antrean permintaan, pemanfaatan KV-cache, adaptor LoRA yang dimuat) dan memilih endpoint untuk setiap permintaan. |
Proxy memanggil EPP (ext_proc, port 9002) dengan header permintaan; EPP menjawab dengan endpoint yang akan digunakan; proxy meneruskan permintaan ke Pod tersebut. |
Kubernetes API (CRD), gRPC ext_proc (9002), scraping Prometheus dari server model. |
| Redis (opsional) | Penyimpanan pendukung layanan pembatasan kapasitas Envoy: penghitung bersama untuk batas berbasis permintaan dan berbasis token di semua replika proxy. Hanya diperlukan jika pembatasan kapasitas global dikonfigurasi. | Layanan pembatasan kapasitas membaca dan menambah penghitung di port 6379 untuk setiap permintaan yang dibatasi. | Protokol Redis (6379). Redis 8.10 yang di-deploy di cluster, atau instance Redis yang ada. |
| Backend penyajian model (Ollama/vLLM) | Menyajikan model open weight di balik gateway; di-deploy dengan panduan pendamping yang ditetapkan Open Weight Models on GDC dengan air gap. Terlampir sebagai AIServiceBackend (Service yang kompatibel dengan OpenAI, misalnya Ollama) atau sebagai InferencePool (server model seperti vLLM yang mengekspos metrik yang dinilai oleh Endpoint Picker). |
Menerima permintaan yang dirutekan dari proxy, menjalankan inferensi pada node GPU (atau pada CPU untuk evaluasi fungsional dengan model kecil), dan menampilkan respons yang kompatibel dengan OpenAI. | REST API yang kompatibel dengan OpenAI: vLLM di port 8000, Ollama di port 11434; Metrik Prometheus (vLLM) untuk Endpoint Picker. |
| Harbor | Menyimpan image container (proxy Envoy, Envoy Gateway, pengontrol Envoy Agent Router dan pemroses eksternal, layanan pembatasan kapasitas, Endpoint Picker, Redis) dan diagram Helm (artefak OCI) solusi. | Artefak disalin dari registry publik ke Harbor dengan seed_registry.sh (crane) dari workstation dengan akses internet; cluster mengambil image dengan akun robot melalui secret pull image dan diagram dirender dari Harbor dengan helm template. |
OCI Distribution API; UI Harbor dan akun robot. |
| Cluster standar dan node GPU | Menghosting semua komponen gateway (node CPU sudah cukup) dan Pod inferensi (node GPU dengan resource akselerator yang ditemukan dari node). Menyediakan VIP LoadBalancer, penyimpanan persisten untuk bobot model, dan penegakan kebijakan jaringan. |
Platform dasar; permintaan masuk melalui VIP LoadBalancer dari Gateway dan tetap berada di dalam jaringan cluster. |
Kubernetes API, API jaringan GDC (networking.gdc.goog/v1 ProjectNetworkPolicy), konsol GDC, dan gdcloud untuk Administrator Platform. |
Fitur dan kemampuan
Arsitektur referensi ini menyediakan kemampuan inti berikut:
- Endpoint terpadu yang kompatibel dengan OpenAI: Aplikasi memanggil satu alamat
(
/v1/chat/completions,/v1/models, …) untuk setiap penyajian model di balik gateway.- Komponen:
Gateway,AIGatewayRoute, proxy Envoy, pemroses eksternal. - Tanggung jawab: Mengekspos IP virtual yang stabil, menghentikan TLS, menerima format permintaan yang kompatibel dengan OpenAI, dan menerjemahkannya ke skema backend jika diperlukan.
- Antarmuka: HTTPS REST (JSON, termasuk peristiwa yang dikirim server untuk streaming).
- Komponen:
- Perutean berbasis isi (berorientasi model): Gateway membaca kolom
modeldari isi permintaan dan merutekan permintaan ke backend yang cocok tanpa logika endpoint sisi klien.- Komponen: Pemroses eksternal, aturan
AIGatewayRouteyang cocok denganx-ai-eg-model,AIServiceBackend,InferencePool. - Tanggung jawab: Mengekstrak nama model, mencocokkan aturan rute,
mengganti nama model (
modelNameOverride), memisahkan traffic berdasarkan bobot, dan melakukan fallback ke backend alternatif berdasarkan prioritas. - Antarmuka: Kubernetes API (
aigateway.envoyproxy.io/v1beta1).
- Komponen: Pemroses eksternal, aturan
- Load balancing yang mendukung server model: Permintaan ke
InferencePooldikirim ke replika dengan antrean terpendek dan cache KV yang paling berguna, bukan round robin.- Komponen: Gateway API Inference Extension (
InferencePool,InferenceObjective, Endpoint Picker). - Tanggung jawab: Melakukan scraping metrik server model, memberi skor endpoint (kedalaman antrean, pemanfaatan KV-cache, afinitas prefix-cache, adaptor LoRA), mematuhi prioritas per tujuan saat beban tinggi.
- Antarmuka: Kubernetes API (
inference.networking.k8s.io/v1,inference.networking.x-k8s.io/v1alpha2), ext_proc gRPC (9002).
- Komponen: Gateway API Inference Extension (
- Kebijakan keamanan dan autentikasi upstream: Kredensial untuk backend
yang memerlukannya dimasukkan oleh gateway dan tidak pernah didistribusikan ke
aplikasi.
- Komponen:
BackendSecurityPolicy, Envoy GatewaySecurityPolicy, pemroses TLS. - Tanggung jawab: Memasukkan kunci API ke backend, menghentikan TLS klien di
Gateway, menerapkan kebijakan autentikasi dan otorisasi klien jika diperlukan. - Antarmuka:
SecretKubernetes yang dirujuk oleh kebijakan.
- Komponen:
- Pembatasan kapasitas berbasis token (opsional): Penggunaan diukur dalam token, bukan hanya dalam permintaan.
- Komponen: Pemroses eksternal (
llmRequestCosts), Envoy GatewayBackendTrafficPolicy(pembatasan kapasitas global), layanan pembatasan kapasitas, Redis. - Tanggung jawab: Mengekstrak token input, output, dan total dari setiap respons, melampirkannya sebagai biaya permintaan, menerapkan anggaran per konsumen atau per model di semua replika proxy.
- Antarmuka: Kubernetes API, Redis (6379).
- Komponen: Pemroses eksternal (
- Pengelolaan traffic: Kemampuan Gateway API standar berlaku untuk traffic AI.
- Komponen:
Gateway,HTTPRoute,AIGatewayRoute,BackendTrafficPolicy. - Tanggung jawab: Pencocokan berbasis host, jalur, dan header, waktu tunggu yang sesuai untuk pembuatan yang lama, percobaan ulang, pemisahan traffic berbobot, dan penggantian berbasis prioritas antar-backend.
- Antarmuka: Kubernetes API.
- Komponen:
- Kemampuan observasi: Metrik permintaan, latensi, dan token tersedia untuk setiap model.
- Komponen: Log akses dan statistik proxy Envoy, metrik pemroses eksternal (penggunaan token, durasi permintaan, waktu ke token pertama), metrik Endpoint Picker.
- Tanggung jawab: Mengekspos metrik berformat Prometheus dan log akses terstruktur yang dapat di-scrape oleh stack kemampuan observasi GDC atau Prometheus yang dikelola pelanggan.
- Antarmuka: Endpoint metrik Prometheus, log output standar.
- Pengelolaan artefak air-gapped: Setiap image dan diagram di-stage di Harbor sebelum penginstalan.
- Komponen: Harbor,
seed_registry.sh, akun robot, secret penarikan image, resourceEnvoyProxy(image proxy dan secret penarikan). - Tanggung jawab: Melakukan seeding image dan chart Helm OCI dari workstation yang terhubung, menyematkan versi, merender chart secara offline dengan
helm template. - Antarmuka: OCI Distribution API, Kubernetes API.
- Komponen: Harbor,
Prinsip arsitektur
- Standards First: Gateway dikonfigurasi melalui Kubernetes Gateway API dan Inference Extension-nya, serta menggunakan API yang kompatibel dengan OpenAI untuk aplikasi, sehingga aplikasi, rute, dan backend tetap portabel di seluruh implementasi gateway.
- Mengutamakan Keamanan: Semua komponen dan data berada dalam batas GDC dengan air gap. TLS dihentikan di
Gateway, kredensial backend dimasukkan oleh gateway, dan akses jaringan dibatasi dengan objekNetworkPolicydanProjectNetworkPolicy. - Kedaulatan Data: Perintah, respons, bobot model, dan data penggunaan tidak pernah keluar dari organisasi GDC pelanggan; tidak diperlukan konektivitas eksternal untuk pengoperasian.
- Pemisahan Kepentingan: Gateway API yang berorientasi pada peran memungkinkan Administrator Platform memiliki kebijakan
GatewayClass,Gateway, TLS, dan kebijakan jaringan, sementara tim aplikasi memiliki resourceAIGatewayRoute,AIServiceBackend, danInferencePooldi namespace mereka sendiri. - Bidang Kontrol dan Data yang Terpisah: Pengontrol hanya menerjemahkan konfigurasi; jalur permintaan terdiri dari proxy Envoy, sidecar pemroses eksternalnya, dan Endpoint Picker, yang terus menyalurkan traffic jika pengontrol dimulai ulang.
- Terbuka & Fleksibel: Arsitektur ini menggunakan software open source di seluruh bagiannya (Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension, Ollama, vLLM) dan resource Gateway API yang sama dapat disajikan oleh implementasi alternatif.
- Skalabilitas & Performa: Bidang data diskalakan secara horizontal dengan menambahkan replika proxy dan secara vertikal dengan menyesuaikan CPU dan memori; load balancing yang mendukung server model menjaga GPU tetap jenuh tanpa membebani replika individual secara berlebihan.
- Pengalaman Pengguna Akhir yang Disederhanakan: Satu endpoint, satu format API, dan satu kredensial untuk setiap model mempersingkat jalur dari deployment model hingga penggunaan.
- Ketahanan: Health check dan replikasi Kubernetes, percobaan ulang Envoy, dan penggantian berbasis prioritas antara backend menjaga endpoint tetap tersedia saat replika model individual gagal.
Pertimbangan
- Skalabilitas dan Performa:
- Komponen gateway adalah workload khusus CPU; proxy Envoy
DeploymentdariGatewaydiskalakan secara horizontal dengan meningkatkan jumlah replikanya (resourceEnvoyProxy) dan secara vertikal dengan meningkatkan permintaan CPU dan memori. Pemeriksaan isi oleh pemroses eksternal memerlukan CPU yang sebanding dengan ukuran permintaan dan respons; respons yang di-streaming diproses secara inkremental. - Load balancing berbasis server model hanya berlaku untuk backend yang dilampirkan sebagai
InferencePool; backend yang dilampirkan sebagaiAIServiceBackenddi-load balance oleh proxy di seluruh endpointService-nya. - Gateway tidak menambahkan kapasitas GPU: throughput dan latensi dibatasi oleh server model. Ukur deployment model dengan set panduan pendamping (vLLM untuk throughput tinggi, Ollama untuk kemudahan penggunaan dan evaluasi khusus CPU).
- Generasi yang panjang memerlukan waktu tunggu permintaan dan waktu tunggu tidak ada aktivitas yang lebih lama daripada API HTTP biasa; konfigurasikan pada rute dan kebijakan, bukan pada klien.
- Komponen gateway adalah workload khusus CPU; proxy Envoy
- Pengelolaan Resource:
- Semua komponen gateway berjalan di node CPU dan tidak memerlukan akselerator; tabel berikut memberikan ukuran indikatif untuk deployment fungsional. Implementasi referensi menetapkan permintaan dan batas yang tepat; nilai produksi bergantung pada rasio permintaan dan ukuran payload.
- Tabel port berikut mencantumkan setiap port yang harus diizinkan oleh kebijakan jaringan.
- Perencanaan GPU termasuk dalam deployment model: nama resource akselerator ditemukan dari node seperti yang dijelaskan dalam kumpulan panduan pendamping.
Ukuran indikatif komponen gateway (khusus CPU)
| Komponen | Replika | CPU (permintaan) | Memori (permintaan) | Catatan |
|---|---|---|---|---|
| Pengontrol Envoy Gateway | 1 | 100 jt–500 jt | 256Mi–1Gi | Bidang kontrol; tidak berada di jalur permintaan |
| Pengontrol Envoy Agent Router | 1 | 100 jt–500 jt | 256Mi–512Mi | Bidang kontrol dan server ekstensi |
Proxy Envoy Pod (proxy + sidecar pemroses eksternal) |
1–2 per Gateway |
500m–2 | 512Mi–2Gi | Menskalakan dengan rasio permintaan dan ukuran payload |
| Pemilih Endpoint | 1 per InferencePool |
100 jt–500 jt | 256Mi–512Mi | Mengambil metrik server model |
| Layanan pembatasan kapasitas (opsional) | 1 | 100 jt–500 jt | 256Mi–512Mi | Hanya dengan pembatasan kapasitas global |
| Redis (opsional) | 1 | 100 jt–500 jt | 256Mi–1Gi | Hanya dengan pembatasan kapasitas global |
Port jaringan
| Port | Komponen | Tujuan |
|---|---|---|
| 80 / 443 | Proxy Envoy (Gateway pemroses) |
Titik entri HTTP/HTTPS di VIP LoadBalancer |
| 1063 | Pengontrol Envoy Agent Router (server ekstensi) | Panggilan gRPC dari pengelola ekstensi Envoy Gateway |
| 9002 | Pemilih Endpoint | Panggilan gRPC ext_proc dari proxy Envoy |
| 6379 | Redis | Penghitung pembatasan kapasitas |
| 8000 | vLLM | API dan metrik yang kompatibel dengan OpenAI dari server model |
| 11434 | Ollama | API yang kompatibel dengan Ollama dan OpenAI dari server model |
- Ketersediaan dan Keandalan:
- Proxy dan pemroses eksternal berjalan di
Podyang sama; beberapa replika di balikLoadBalancerServicemenyamarkan kegagalanPodindividual, dan pengontrol dapat dimulai ulang tanpa mengganggu traffic. - Aturan
AIGatewayRoutedapat mencantumkan beberapa backend dengan prioritas sehingga gateway beralih ke set replika atau server model lain saat backend tidak responsif. - Pemilih Endpoint adalah
Deploymentper kumpulan; jika tidak tersedia, permintaan keInferencePooltersebut akan gagal hingga tersedia kembali. Jalankan dengan permintaan resource dan pemeriksaan kesiapan, serta pantau seperti komponen bidang data. - Redis hanya menyimpan penghitung pembatasan kapasitas; pemadaman layanan Redis memengaruhi pembatasan kapasitas, bukan pemilihan rute.
- Proxy dan pemroses eksternal berjalan di
- Kompleksitas Operasional:
- Penyelarasan versi antara Envoy Gateway, Envoy Agent Router, dan Gateway API Inference Extension: upgrade ketiganya bersama dengan kombinasi yang telah diuji (Envoy Gateway 1.8.4, Envoy Agent Router 1.1.0, Gateway API Inference Extension 1.5.0).
- Siklus proses air-gap: setiap image dan diagram di-seed ulang ke Harbor untuk
setiap upgrade; resource
EnvoyProxydan nilai diagram menyematkan registry dan rahasia pull. - Dua lapisan konfigurasi:
GatewayClass/Gateway/EnvoyProxymilik platform danAIGatewayRoute/AIServiceBackend/InferencePoolmilik tim; mengaktivasi model baru berarti menambahkan aturan rute dan backend, bukan gateway baru. - Pemantauan: rasio permintaan, latensi (termasuk waktu ke token pertama), penggunaan token per model dan per konsumen, penskoran Endpoint Picker, dan pemakaian GPU server model.
InferenceObjectivemasih merupakan API alfa (v1alpha2); perkirakan perubahan skema antara rilis Ekstensi Inferensi.
- Keamanan dan Kepatuhan:
- Seluruh solusi beroperasi dalam perimeter keamanan GDC dengan air gap.
- Kebijakan jaringan bersifat wajib: namespace
NetworkPolicymengizinkan traffic dari proxy ke port server model (8000, 11434) dan ke Endpoint Picker (9002), danProjectNetworkPolicymengizinkan traffic klien ke VIPLoadBalancersaat konsumen berada di luar project. - TLS dihentikan di
Gatewaydengan sertifikat yang disimpan diSecretKubernetes; klien hanya melihat endpoint gateway. - Kredensial upstream (misalnya kunci API yang diperlukan oleh server model)
disimpan di
Secretyang direferensikan olehBackendSecurityPolicydan diinjeksikan oleh gateway, sehingga aplikasi tidak pernah menyimpan kredensial backend. - Pembatasan kapasitas berbasis token membatasi konsumsi kapasitas GPU yang mahal per konsumen atau per model.
- Akun robot Harbor dan secret pull image Kubernetes memastikan akses yang aman ke image container; RBAC Gateway API yang berorientasi pada peran memisahkan tanggung jawab platform dan aplikasi.
Keputusan desain
Keputusan desain utama berikut telah dibuat untuk arsitektur referensi ini:
Keputusan 1: Implementasi gateway AI: Envoy Agent Router open source di Envoy Gateway versus distribusi alternatif
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
| Gateway AI adalah pilihan arsitektur utama dengan alternatif yang layak, mulai dari opsi open source yang dikelola sendiri hingga penawaran yang didukung secara komersial: (a) Envoy Agent Router di Envoy Gateway (open source), (b) kgateway dan agentgateway (implementasi Gateway API open source yang juga menangani traffic penyedia LLM, alat MCP, dan komunikasi agen-ke-agen dalam satu bidang data, secara opsional dengan dukungan vendor dari solo.io), (c) Solo Enterprise untuk agentgateway sebagai opsi premium yang didukung secara komersial. | Implementasi referensi menggunakan Envoy Agent Router open source di Envoy Gateway. Alternatifnya tetap menjadi pilihan yang valid di balik resource Gateway API yang sama; distribusi yang didukung secara komersial direkomendasikan untuk lingkungan produksi yang memerlukan dukungan vendor khusus. | Keunggulan open source: ringan dan sesuai standar, perutean L7 berperforma tinggi, tanpa biaya lisensi, ideal untuk mengevaluasi solusi sebelum berkomitmen pada penawaran berbayar; Envoy Agent Router adalah opsi yang divalidasi dalam kumpulan panduan ini. Kekurangan open source: dukungan diberikan secara maksimal oleh tim Solusi dan berbasis komunitas, yang mungkin tidak memuaskan lingkungan produksi inti. Keunggulan premium: perjanjian Dukungan untuk Perusahaan untuk siklus proses gateway dan, sering kali, kemampuan agentic tingkat lanjut. Kekurangan premium: perjanjian lisensi atau dukungan berbayar dan hubungan vendor tambahan. |
Keputusan 2: Kubernetes Gateway API dengan Inference Extension versus Ingress atau gateway API eksklusif
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
| Endpoint inferensi dapat diekspos dengan Ingress API lama, format konfigurasi khusus gateway, atau Kubernetes Gateway API. Load balancing berbasis model juga memerlukan cara untuk mendeskripsikan pool server model dan prioritasnya. | Solusi ini distandardisasi pada Kubernetes Gateway API (GatewayClass, Gateway, rute) yang diimplementasikan oleh Envoy Gateway, dan pada Gateway API Inference Extension (InferencePool, InferenceObjective, Endpoint Picker) untuk pemilihan rute berbasis model. |
Gateway API adalah standar Kubernetes yang menggantikan Ingress, berorientasi peran (tim platform versus tim aplikasi), dan portabel di berbagai implementasi. Inference Extension adalah standar komunitas untuk pemilihan rute yang mendukung server model (kedalaman antrean, cache KV, prioritas) dan didukung oleh Envoy Agent Router secara langsung; distribusi gateway alternatif menerapkan API yang sama, sehingga Keputusan 1 dapat dibatalkan. |
Keputusan 3: Perutean berbasis isi pada kolom model permintaan yang kompatibel dengan OpenAI sebagai endpoint terpadu
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
Aplikasi dapat menangani model melalui satu endpoint per model (berbasis host atau jalur), melalui header kustom yang ditetapkan oleh klien, atau melalui kolom model yang sudah dibawa oleh setiap permintaan yang kompatibel dengan OpenAI. |
Gateway mengekspos satu endpoint yang kompatibel dengan OpenAI dan merutekan di kolom model: pemroses eksternal mengekstraknya ke header x-ai-eg-model dan aturan AIGatewayRoute cocok dengan header tersebut. |
Klien dan SDK yang kompatibel dengan OpenAI yang sudah ada berfungsi tanpa perubahan dan beralih model dengan mengubah satu string; endpoint, kredensial, dan penempatan model dapat berubah tanpa menyentuh aplikasi; aturan yang sama dapat memetakan nama model ke beberapa backend untuk pemisahan traffic, penggantian, atau penggantian nama model. |
Keputusan 4: Penyisipan artefak dengan air gap ke Harbor versus pengambilan on-demand
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
| Penginstalan upstream mengambil image container dari registry publik dan diagram Helm sebagai artefak OCI sesuai permintaan, yang tidak mungkin dilakukan di lingkungan air-gap. | Semua image container (proxy Envoy, Envoy Gateway, pengontrol Envoy Agent Router dan pemroses eksternal, layanan pembatasan kapasitas, Endpoint Picker, Redis) serta diagram Helm Envoy Gateway dan Envoy Agent Router di-seed ke dalam project Harbor dengan seed_registry.sh (crane), diagram dirender secara offline dengan helm template dari Harbor, dan resource EnvoyProxy serta nilai diagram menyematkan registry Harbor dan rahasia pull. |
Satu langkah seeding yang dapat diulang dan diaudit per versi; cluster tidak memerlukan konektivitas eksternal; penyematan versi membuat upgrade menjadi eksplisit dan dapat dibatalkan. |
Keputusan 5: Pembatasan kapasitas opsional berbasis token dengan Redis versus batas berbasis permintaan saja
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
| Kapasitas GPU digunakan per token, bukan per permintaan; batas jumlah permintaan tidak dapat melindungi model bersama dari beberapa perintah yang sangat besar atau pembuatan yang panjang. Pembatasan kapasitas global di Envoy Gateway memerlukan penyimpanan penghitung bersama. | Pembatasan kapasitas berbasis token adalah fitur opsional dari arsitektur: pemroses eksternal mencatat token input, output, dan total per permintaan (llmRequestCosts), BackendTrafficPolicy menerapkan anggaran, dan instance Redis (Redis 8.10, yang di-deploy di cluster atau instance yang ada) menyimpan penghitung. Deployment tanpa pembatasan kapasitas tidak memerlukan Redis. |
Penggunaan diukur dalam unit yang mencerminkan biaya, anggaran diterapkan secara konsisten di semua replika proxy, dan dependensi hanya dibayar oleh pelanggan yang memerlukan kuota. |
Keputusan 6: Topologi: gateway control plane dan data plane di namespace khusus cluster standar, model di namespace aplikasi
| Konteks | Keputusan Penting | Alasan |
|---|---|---|
| Gateway dapat berjalan di cluster khusus, di setiap namespace aplikasi, atau sekali per cluster standar di samping model yang dihadapinya. Model open-weight di GDC dengan air gap di-deploy di cluster standar (set panduan pendamping). | Bidang kontrol Envoy Gateway dan Envoy Agent Router serta bidang data proxy Envoy berjalan di namespace khusus cluster standar yang menghosting model; AIGatewayRoute, AIServiceBackend, InferencePool, dan deployment model berada di namespace aplikasi dan direferensikan di seluruh namespace. |
Permintaan tetap berada di dalam jaringan cluster antara proxy dan Pod model (latensi terendah, tanpa load balancer tambahan), Administrator Platform memiliki namespace gateway, sedangkan tim aplikasi memiliki rute dan modelnya, dan Endpoint Picker dapat langsung mengambil data dari server model. Gateway klien per project yang meneruskan ke gateway server pusat tetap menjadi ekstensi topologi ini untuk penggunaan multi-project. |
Asumsi dan batasan
- Lingkungan GDC dengan air gap 1.16.2-hf1 atau yang lebih baru tersedia dengan cluster standar yang menjalankan Kubernetes v1.32.13-gke.400 atau yang lebih baru.
- Resource hardware yang memadai (terutama GPU) tersedia untuk backend penyajian model; komponen gateway itu sendiri berjalan di node CPU. Model sungguhan memerlukan GPU; model kecil di Ollama dapat berjalan di CPU hanya untuk evaluasi fungsional.
- Instance Harbor telah disiapkan dan dapat diakses, serta workstation dengan akses internet dan konektivitas ke lingkungan GDC (Harbor dan Kubernetes API) tersedia untuk melakukan seeding image dan diagram.
- Pengguna memiliki izin yang diperlukan: peran project Harbor Instance Viewer
dan Standard Cluster Admin plus
StandardClusterRoleBindingke perancluster-admindi cluster standar untuk penginstalan cakupan cluster (CRD,GatewayClass, namespace), lihat implementasi referensi. - Backend penyajian model mengekspos API yang kompatibel dengan OpenAI; backend yang dilampirkan sebagai
InferencePooljuga mengekspos metrik yang kompatibel dengan vLLM yang diandalkan oleh Endpoint Picker. - Batasan: dukungan untuk komponen open source (Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension) adalah upaya terbaik dari tim Solusi; dukungan vendor khusus memerlukan distribusi yang didukung secara komersial (Keputusan 1).
- Batasan:
InferenceObjectiveadalah API alfa (inference.networking.x-k8s.io/v1alpha2) dan dapat berubah di antara rilis Inference Extension. - Batasan: VIP
LoadBalanceruntukGatewaydanProjectNetworkPolicydiperlukan untuk konsumen di luar project; di dalam project, klien dalam cluster ataukubectl port-forwarddapat menjangkau gatewayServicesecara langsung. - Batasan: Gemini di GDC, penyesuaian model, model AI Generatif non-LLM, dan penyajian model multi-node tidak termasuk dalam cakupan untuk versi solusi ini.
Alur penggunaan
Berikut adalah alur pengguna yang komprehensif untuk gateway AI di GDC dengan air gap: pertama, jalur permintaan yang diandalkan oleh developer aplikasi, lalu jalur penyiapan yang diikuti oleh Administrator Platform.
1. Jalur permintaan developer
Aplikasi atau agen hanya memerlukan endpoint gateway, kredensial klien jika gateway menerapkannya, dan nama model.
- Mengirim permintaan: Aplikasi memanggil
POST /v1/chat/completionsdi endpoint gateway dengan isi JSON yang kompatibel dengan OpenAI yang memberi nama model (misalnya"model": "gemma"), persis seperti cara aplikasi memanggil layanan yang kompatibel dengan OpenAI. - Memasuki gateway: Permintaan mencapai VIP
LoadBalancerdariGateway; proxy Envoy menghentikan TLS dan mencocokkan pemroses dan rute. - Memproses isi: Proxy menyerahkan permintaan ke pemroses eksternal Envoy Agent Router, yang mengurai isi, mengekstrak nama model ke header
x-ai-eg-model, dan menerjemahkan payload ke skema backend jika berbeda. - Memilih backend: Aturan
AIGatewayRouteyang cocok dengan nama model memilihAIServiceBackend(misalnya OllamaService) atauInferencePool(misalnya set replika vLLM); untukInferencePool, Endpoint Picker memilih replika dengan antrean terpendek dan kecocokan KV-cache terbaik. - Meneruskan dan merespons: Proxy memasukkan kredensial upstream saat
BackendSecurityPolicyberlaku, meneruskan permintaan kePodyang dipilih, melakukan streaming respons kembali, dan memungkinkan pemroses eksternal mencatat penggunaan token, yang memberikan metrik dan, jika dikonfigurasi, batas kapasitas berbasis token. - Beralih model: Untuk menggunakan model lain, developer mengubah string
model; tidak diperlukan endpoint, kredensial, atau library klien baru.
2. Jalur penyiapan Administrator Platform
- Menyisipkan artefak ke Harbor: Buat akun robot Harbor, lalu salin image container serta diagram Helm Envoy Gateway dan Envoy Agent Router ke Harbor dengan
seed_registry.shdari workstation yang memiliki akses internet. - Instal Envoy Gateway: Render diagram CRD dan pengontrol dari Harbor
dengan
helm templatedan terapkan di namespace gateway; buat resourceEnvoyProxyyang menyematkan image proxy dan rahasia pull, lalu verifikasi pengontrol denganGatewayClass,Gateway, danHTTPRoutedasar. - Menginstal Envoy Agent Router: Instal CRD Envoy Agent Router dan CRD Gateway API Inference Extension, deploy pengontrol Envoy Agent Router, dan konfigurasi ulang Envoy Gateway untuk memanggil server ekstensinya (port 1063) dan untuk menerima backend
InferencePool; secara opsional, deploy Redis dan aktifkan layanan pembatasan kapasitas global. - Mengekspos gateway: Buat
GatewayClassdanGatewaydengan pemroses HTTP dan HTTPS (sertifikat TLSSecret), tunggu VIPLoadBalancer, dan terapkanProjectNetworkPolicyuntuk konsumen di luar project. - Lampirkan model: Deploy backend penyajian model dengan set panduan pendamping, lalu buat resource
AIServiceBackenduntukServiceyang kompatibel dengan OpenAI dan resource Endpoint Picker plusInferencePooluntuk set replika yang kompatibel dengan vLLM, bersama dengan objekNetworkPolicynamespace. - Publikasikan rute: Buat
AIGatewayRoutedengan satu aturan per nama model (perutean berbasis isi) dan, jika diperlukan, objekBackendSecurityPolicydanBackendTrafficPolicyuntuk kredensial upstream dan anggaran token. - Validasi dan operasikan: Panggil
/v1/modelsdan/v1/chat/completionsmelalui VIP (atau penggantiankubectl port-forward), periksa metrik proxy, pemroses eksternal, dan Endpoint Picker, lalu serahkan nama endpoint dan model ke tim aplikasi. Skalakan replika proxy dan deployment model secara independen; upgrade Envoy Gateway, Envoy Agent Router, dan Inference Extension secara bersamaan.
Langkah-langkah mendetail disediakan dalam implementasi referensi Envoy Agent Router dan panduan pengguna Perutean berbasis isi dengan Envoy Agent Router.
Materi tambahan
- Implementasi referensi Envoy Agent Router
- Panduan pengguna perutean berbasis isi dengan Envoy Agent Router
- Arsitektur referensi LLM open-weight
- Dokumentasi Envoy Agent Router
- Envoy Gateway
- Kubernetes Gateway API
- Ekstensi Inferensi Gateway API
- Dokumentasi Google Distributed Cloud dengan air gap