


תיאור הבעיה
ארגונים שמריצים מודלי שפה גדולים (LLM) בסביבות עם air gap צוברים במהירות נקודות קצה (endpoints) של מודלים: כל מודל עם משקלים פתוחים שמופעל ב-Google Distributed Cloud (GDC) עם air gap (ראו את המדריך הנלווה "מודלים עם משקלים פתוחים ב-GDC עם air gap") חושף את ה-Service שלו ב-Kubernetes, את הכתובת שלו, את פרטי הכניסה שלו ואת מחזור החיים התפעולי שלו.
מפתחי אפליקציות וסוכנים נתקלים במגבלות של הארכיטקטורה, וצריכים להגדיר נקודת קצה אחת לכל מודל בתוך הקוד ולשכתב את השילובים בכל איטרציה של המודל. הפיצול הזה יוצר חוב טכני ומאט את הפריסה של עומסי עבודה קריטיים לארגון, שכוללים כמה שלבים ומבוססים על סוכנים.
שכבות רשת רגילות גם לא מותאמות ל-AI: מאזן עומסים רגיל מתייחס לתנועת הסקה כמו HTTP גנרי, והוא לא יכול לקרוא את השדה model של בקשה, לתעדף עומסי עבודה שרגישים לזמן אחזור, להביא בחשבון אסימונים במקום בקשות או להפנות בקשה לרפליקה של שרת המודל שכבר מכילה את מטמון ה-KV הרלוונטי. באשכולות GPU יקרים עם air gap, זה מוביל לניצול חלקי של החומרה ולהחזר על השקעה נמוך. Gemini ב-GDC מספק מודלים מנוהלים פורצי דרך, אבל לקוחות שמשלבים אותם עם מודלים פתוחים עם משקלים שמתארחים באופן עצמאי צריכים שכבת הסקה שמציעה גמישות כמו בענן, בלי לפגוע בריבונות הנתונים: אסור שאף בקשה, הנחיה או משקל מודל יצאו מהגבולות של GDC.
הפתרון המוצע
במסמך הזה מתוארת ארכיטקטורת העזר של שער AI בניהול עצמי ב-GDC עם air gap: שכבת הסקה מאובטחת ומרכזית שנותנת לאפליקציות נקודת קצה אחת שתואמת ל-OpenAI לכל המודלים, ומנתבת כל בקשה לקצה העורפי המתאים. הטמעת העזר מבוססת על Kubernetes Gateway API: Envoy Gateway הוא ההטמעה של Gateway API (מישור הבקרה ומישור הנתונים של Envoy proxy) ו-Envoy Agent Router (לשעבר Envoy AI Gateway) מרחיב אותו עם עיבוד בקשות ספציפיות ל-AI: חילוץ מודלים מגוף הבקשה, תרגום בקשות ותגובות, אימות במעלה הזרם, חשבונאות של טוקנים, ובאופן אופציונלי, הגבלת קצב של יצירת בקשות שמבוססת על טוקנים. התוסף Gateway API Inference מוסיף בחירת נקודת קצה שמותאמת לשרת המודל (InferencePool ו-Endpoint Picker) כדי להשתמש ביעילות בקיבולת של ה-GPU. כל פריטי המידע שנוצר מאוחסנים במאגר Harbor של הארגון ב-GDC, וכל ה-stack פועל באשכול רגיל ללא קישוריות חיצונית.
מה כלול: הארכיטקטורה הזו כוללת את פריסת Envoy Gateway ו-Envoy Agent Router באשכול רגיל, את המשאבים של Gateway API (GatewayClass, Gateway) ואת המשאבים של Envoy Agent Router (AIGatewayRoute, AIServiceBackend, BackendSecurityPolicy, GatewayConfig) שחושפים נקודת קצה מאוחדת שתואמת ל-OpenAI, ניתוב מבוסס-גוף בשדה model, את Gateway API Inference Extension (InferencePool, InferenceObjective, Endpoint Picker) לאיזון עומסים עם מודעות למודל, הגבלת קצב אופציונלית של יצירת בקשות מבוססת-טוקנים באמצעות Redis, סיום TLS בשער, כללי מדיניות רשת (NetworkPolicy / ProjectNetworkPolicy) וניהול פריטי מידע שנוצרו בתהליך הפיתוח (Artifact) עם air gap ב-Harbor. הקצה העורפי של פרסום המודל שמאחורי השער (Ollama, vLLM) נפרס באמצעות המדריך הנלווה "הגדרת מודלים פתוחים ב-GDC עם air gap".
מה לא כלול: הארכיטקטורה הזו לא כוללת מוצר של שער AI מנוהל, פריסה וכוונון של המודלים עצמם (קבוצת מדריכים נלווים), כוונון מודלים, אופני GenAI שאינם LLM, תנועה מסוכן לכלי (MCPRoute) או הפצות של שערים שנתמכות באופן מסחרי. Gemini ב-GDC הוא יכולת מנוהלת של המוצר. ההקצאה שלו לא נכללת בהיקף, והגרסה הזו של קבוצת המדריכים מאמתת את השער באמצעות מודלים פתוחים שמתארחים באופן עצמאי.
קהל היעד: קהל היעד העיקרי של המסמך הזה כולל מנהלי פלטפורמות שאחראים לפריסה ולהפעלה של השער באשכול רגיל, ואדריכלים טכניים שמתכננים פלטפורמות AI בסביבה עם air gap. מפתחי אפליקציות שמשתמשים בנקודת הקצה המאוחדת הם קהל משני, שיכול להפיק תועלת מהבנת האופן שבו הבקשות שלהם מנותבות.
ארכיטקטורה
הפתרון פועל כולו באשכול רגיל של הארגון ב-GDC עם air gap. בשכבת השירותים, ה-Kubernetes Gateway API יוצר סטנדרטיזציה של מודל ההגדרות האישיות. מישור הבקרה של שער ה-AI (בקר Envoy Gateway ובקר Envoy Agent Router) קורא את משאבי ה-Gateway API וה-Envoy Agent Router ומגדיר את מישור הנתונים: שרת proxy של Envoy Deployment שהוא נקודת הכניסה של הבקשה (נחשף דרך Service מסוג LoadBalancer) והמעבד החיצוני של Envoy Agent Router שפועל כ-sidecar ב-proxy Pod ומפעיל את הלוגיקה הספציפית ל-AI. בשכבת האפליקציה, עומסי העבודה של הלקוח (אפליקציות וסוכנים) שולחים בקשת AI לשרת ה-proxy (1), שרת ה-proxy מעביר את הבקשה למעבד החיצוני, שמחלץ את שם המודל, מתרגם את הבקשה ומתעד את השימוש בטוקנים (2), שרת ה-proxy מעביר את התנועה המאוזנת ל-Pods של ההסקה של המודל שנבחר (3), והמודל פועל בצומתי ה-GPU של שכבת התשתית (4). ה-backends של פרסום המודל מחוברים לשער בתור AIServiceBackend (כל Service שתואם ל-OpenAI) או בתור InferencePool שהבורר של נקודת הקצה שלו בוחר את הרפליקה הכי טובה לכל בקשה. קובצי אימג' של קונטיינרים ותרשימי Helm נשלפים מ-Harbor.
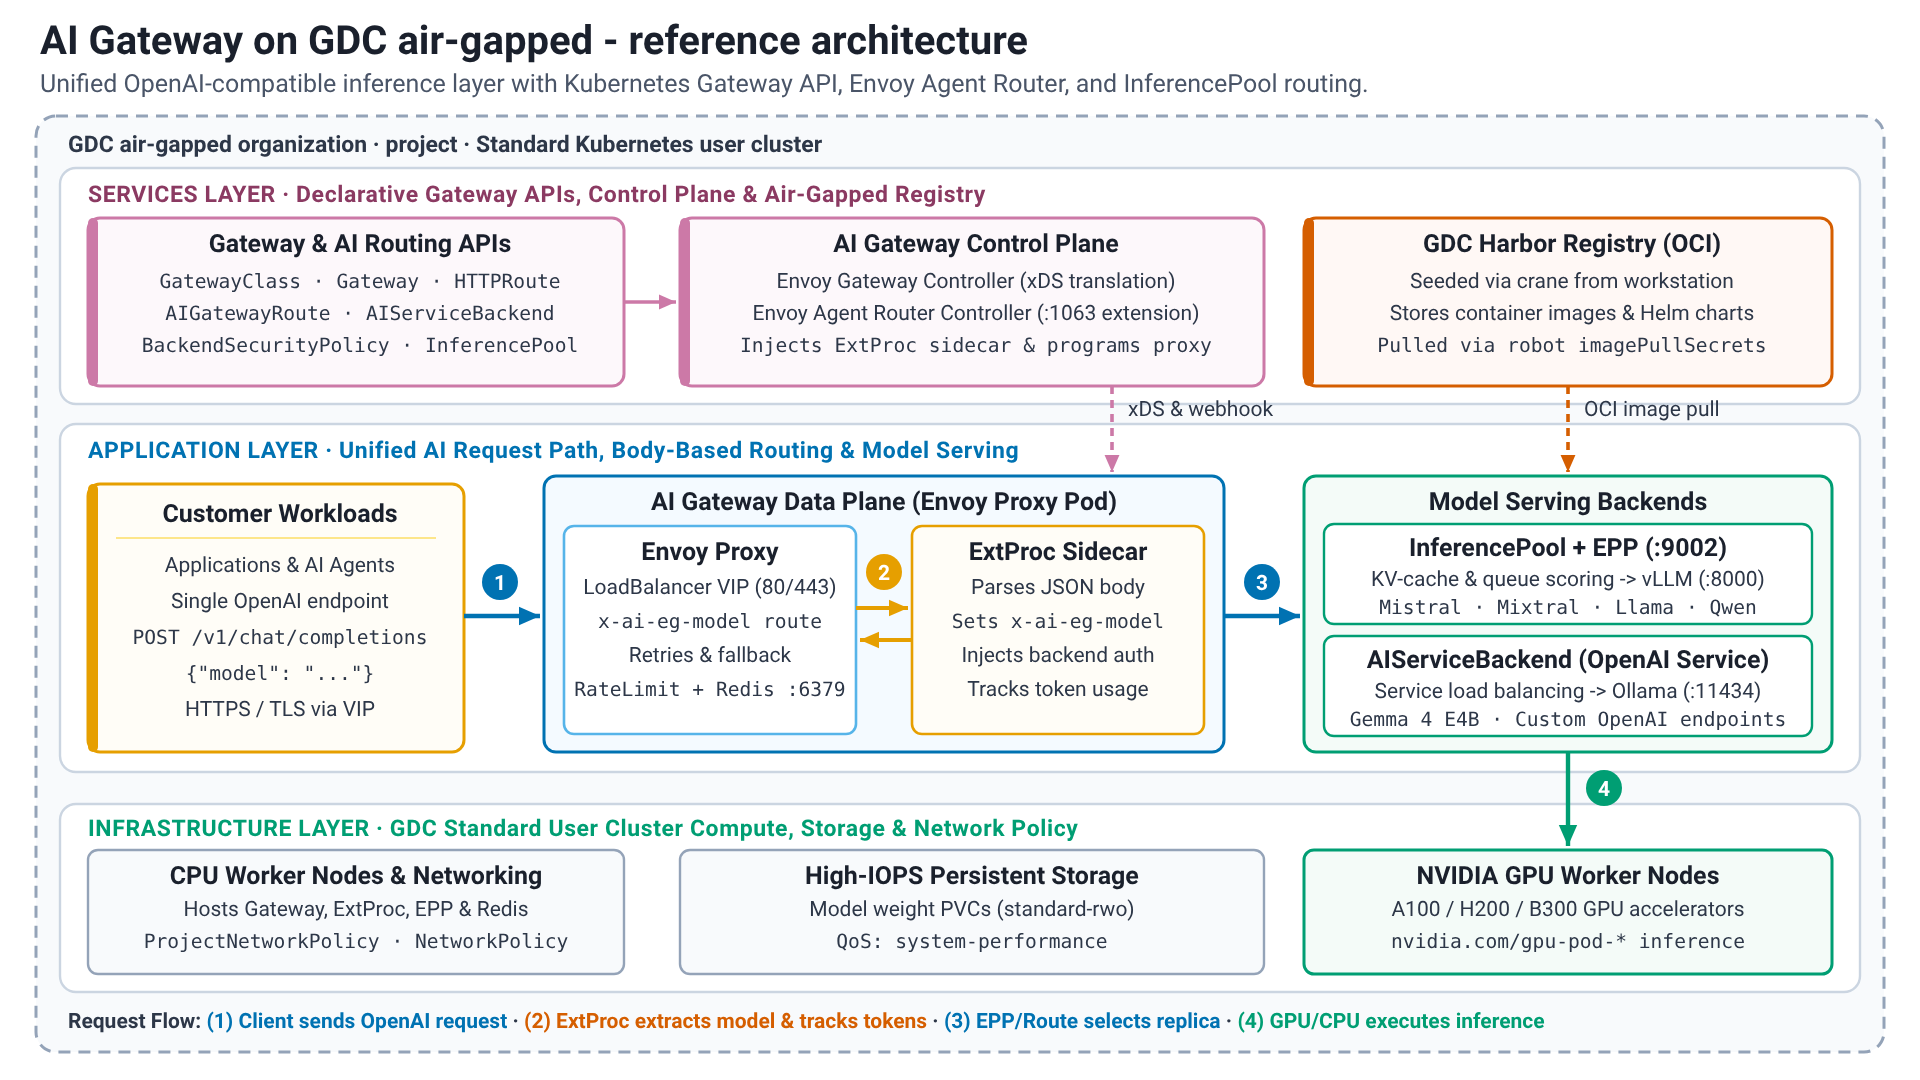
רכיבי הפתרון
הפתרון משתמש ברכיבים הבאים:
| רכיב הפתרון | תחומי האחריות | זרימת נתונים | ממשקים |
|---|---|---|---|
| Kubernetes Gateway API | מודל משאבים סטנדרטי שמבוסס על תפקידים, לכניסה ולניתוב: GatewayClass (בבעלות הפלטפורמה), Gateway (מאזינים, TLS) ומשאבי ניתוב (בבעלות צוותי האפליקציות). היורש של Ingress API בלי הערות ספציפיות לספק. |
הגדרות הצהרתיות בלבד; הבקרים עוקבים אחרי המשאבים והם לא נושאים תנועת בקשות. | Kubernetes API (gateway.networking.k8s.io/v1); ה-CRD מותקנים מתרשים ה-CRD של Envoy Gateway. |
| בקר Envoy Gateway (מישור הבקרה) | מטמיע את Gateway API: מקצה שרת proxy אחד של Envoy Deployment ו-LoadBalancer Service לכל Gateway, מתרגם מסלולים וכללי מדיניות (BackendTrafficPolicy, SecurityPolicy, EnvoyExtensionPolicy, Backend, EnvoyProxy) להגדרת xDS, מפעיל את שירות הגבלת קצב של יצירת בקשות הגלובלי כשהוא מוגדר, וקורא לשרת התוספים של Envoy Agent Router דרך מנהל התוספים שלו כדי שרכיבי ה-backend של InferencePool יתווספו לתרגום. |
צופה ב-Kubernetes API ומעביר את הגדרת xDS לשרתי ה-proxy; אין תנועת בקשות. | Kubernetes API (צפייה), xDS gRPC לכיוון שרתי ה-proxy, gRPC לכיוון שרת התוסף (יציאה 1063). |
| בקר הנתב של Envoy Agent (מישור הבקרה) | הוא מתאים בין המשאבים של aigateway.envoyproxy.io/v1beta1, AIGatewayRoute (כללי מסלול בשם המודל שחולץ), AIServiceBackend (קצה עורפי עם סכימת ה-API שלו), BackendSecurityPolicy (פרטי כניסה במעלה הזרם) ו-GatewayConfig (הגדרות של מעבד חיצוני לכל Gateway), למשאבים של Envoy Gateway, מוסיף את ה-sidecar של המעבד החיצוני ל-Pods של שרת ה-proxy של Envoy ומפעיל את שרת התוספים שמשמש את Envoy Gateway. |
הגדרה בלבד. | Kubernetes API, שרת תוסף gRPC (יציאה 1063), תגובת webhook לשינוי הרשאות גישה להחדרת sidecar. |
| שרת proxy של Envoy (מישור נתונים) | נקודת כניסה לבקשות: סיום TLS, התאמה של מאזינים ונתיבים, איזון עומסים בין נקודות קצה (endpoints) בקצה העורפי, אכיפה של הגבלת קצב של יצירת בקשות וזמנים קצובים לתפוגה, ניסיונות חוזרים וחזרה לקצוות עורפיים חלופיים, והנפקה של יומני גישה ומדדים. | מקבל בקשות לקוח ב-VIP של LoadBalancer (80/443), מתייעץ עם המעבד החיצוני לגבי כל בקשת AI, מעביר את הבקשה לנקודת הקצה שנבחרה בקצה העורפי (Service או Pod שנבחר על ידי Endpoint Picker) ומעביר את התשובה בחזרה ללקוח. |
HTTP/HTTPS ללקוחות (API שתואם ל-OpenAI), ext_proc gRPC ל-sidecar ולבוחר נקודות הקצה, HTTP לקצוות העורפיים, gRPC לשירות הגבלת קצב של יצירת בקשות. |
| מעבד חיצוני (ExtProc) של Envoy Agent Router | מנתח את גוף הבקשה שתואם ל-OpenAI, מחלץ את השדה model לכותרת הניתוב x-ai-eg-model, מחיל שינויים בשם המודל, מתרגם את המטען הייעודי (payload) של הבקשה והתגובה בין סכימת ה-API של הלקוח לבין סכימת ה-API של הקצה העורפי, מוסיף את פרטי הכניסה במעלה הזרם שהוגדרו על ידי BackendSecurityPolicy, ומחלץ את השימוש בטוקנים (קלט, פלט, סה"כ) מהתגובה למטא-נתונים דינמיים שמשמשים להגבלת קצב של יצירת בקשות ולמדדים שמבוססים על טוקנים. |
קונטיינר משני (sidecar) בשרת ה-proxy של Envoy Pod; מעבד את גופי הבקשות והתשובות, כולל תשובות בסטרימינג. |
Envoy ext_proc gRPC; נקודת קצה של מדדי Prometheus. |
| תוסף הסקת המסקנות של Gateway API (InferencePool + Endpoint Picker) | InferencePool (inference.networking.k8s.io/v1) מקבץ את ה-Pod של פריסת שרת מודל אחת (בורר תוויות, יציאת יעד, למשל 8000) ומפנה לבורר נקודות הקצה (EPP) שלו. InferenceObjective (v1alpha2) מקצה עדיפות לכל מודל או יעד. ה-EPP מגרד את המדדים של שרת המודל (עומק תור הבקשות, ניצול המטמון של KV, מתאמי LoRA שנטענו) ובוחר את נקודת הקצה לכל בקשה. |
שרת ה-proxy קורא ל-EPP (ext_proc, יציאה 9002) עם כותרות הבקשה. ה-EPP עונה עם נקודת הקצה שבה צריך להשתמש, ושרת ה-proxy מעביר את הבקשה לאותה Pod. |
Kubernetes API (CRD), gRPC ext_proc (9002), גירוד (scrape) של שרתי המודלים ב-Prometheus. |
| Redis (אופציונלי) | מאגר הגיבוי של שירות הגבלת קצב של יצירת בקשות של Envoy: מונים משותפים למגבלות שמבוססות על בקשות ולמגבלות שמבוססות על אסימונים בכל הרפליקות של שרתי ה-proxy. נדרש רק כשמוגדרת הגבלת קצב גלובלית של יצירת בקשות. | שירות הגבלת הקצב קורא את המונים ביציאה 6379 ומגדיל אותם בכל בקשה מוגבלת. | פרוטוקול Redis (6379). Redis 8.10 פרוס באשכול, או מכונה קיימת של Redis. |
| קצוות עורפיים של פרסום מודלים (Ollama או vLLM) | מציגים את המודלים עם משקולות פתוחות מאחורי השער, שנפרסו באמצעות המדריך הנלווה להגדרת מודלים עם משקולות פתוחות ב-GDC עם air gap. מצורף כ-AIServiceBackend (כל Service שתואם ל-OpenAI, לדוגמה Ollama) או כ-InferencePool (שרתי מודלים כמו vLLM שחושפים את המדדים שבהם Endpoint Picker נותן ניקוד). |
מקבלים את הבקשות שנותבו מה-proxy, מריצים את ההסקה על צומתי ה-GPU (או על ה-CPU להערכה פונקציונלית עם מודלים קטנים) ומחזירים את התשובה שתואמת ל-OpenAI. | API בארכיטקטורת REST שתואם ל-OpenAI: vLLM ביציאה 8000, Ollama ביציאה 11434, מדדי Prometheus (vLLM) ל-Endpoint Picker. |
| Harbor | מאחסן את קובצי האימג' של הקונטיינרים (שרת proxy של Envoy, Envoy Gateway, בקר Envoy Agent Router ומעבד חיצוני, שירות הגבלת קצב של יצירת בקשות, Endpoint Picker, Redis) ואת תרשימי Helm (פריטי מידע שנוצרו בתהליך הפיתוח של OCI) של הפתרון. | פריטי המידע מועתקים מהמרשמים הציבוריים אל Harbor באמצעות seed_registry.sh (crane) מתחנת עבודה עם גישה לאינטרנט. האשכול שולף תמונות באמצעות חשבון רובוט דרך סודות לשליפת תמונות, והתרשימים מוצגים מ-Harbor באמצעות helm template. |
OCI Distribution API, ממשק המשתמש של Harbor וחשבונות רובוט. |
| אשכול רגיל וצומתי GPU | מארח את כל רכיבי השער (מספיקים צומתי CPU) ואת Pods של ההסקה (צומתי GPU עם משאבי המאיץ שנמצאו מהצמתים). מספק LoadBalancer כתובות IP וירטואליות, אחסון מתמיד למשקלי המודל ואכיפה של מדיניות הרשת ב-Kubernetes. |
פלטפורמה בסיסית; הבקשות נכנסות דרך ה-VIP של LoadBalancer ב-Gateway ונשארות בתוך רשת האשכול. |
Kubernetes API, ממשקי API של GDC networking (networking.gdc.goog/v1 ProjectNetworkPolicy), מסוף GDC ו-gdcloud לאדמין של הפלטפורמה. |
תכונות ויכולות
ארכיטקטורת העזר הזו מספקת את היכולות העיקריות הבאות:
- נקודת קצה מאוחדת שתואמת ל-OpenAI: האפליקציות קוראות לכתובת אחת (
/v1/chat/completions,/v1/modelsוכו') לכל מודל שמוגש מאחורי השער.- רכיבים:
Gateway,AIGatewayRoute, שרת proxy של Envoy, מעבד חיצוני. - תחומי אחריות: חשיפת כתובת IP וירטואלית יציבה, סיום TLS, קבלת פורמט הבקשה שתואם ל-OpenAI ותרגום שלו לסכימת הקצה העורפי לפי הצורך.
- ממשקים: HTTPS REST (JSON, כולל אירועים שנשלחים מהשרת לסטרימינג).
- רכיבים:
- ניתוב מבוסס-גוף (מודע למודל): השער קורא את השדה
modelשל גוף הבקשה ומנתב את הבקשה לקצה העורפי התואם, בלי לוגיקה של נקודת קצה בצד הלקוח.- רכיבים: מעבד חיצוני,
AIGatewayRouteכללים שתואמים ל-x-ai-eg-model,AIServiceBackend,InferencePool. - תחומי האחריות: חילוץ שם המודל, התאמת כללי המסלול, שינוי שמות המודלים (
modelNameOverride), חלוקת התנועה לפי משקל וחזרה לשירותי Backend חלופיים לפי עדיפות. - ממשקים: Kubernetes API (
aigateway.envoyproxy.io/v1beta1).
- רכיבים: מעבד חיצוני,
- איזון עומסים שמותאם לשרת המודל: בקשות ל-
InferencePoolנשלחות לרפליקה עם התור הכי קצר ומטמון ה-KV הכי שימושי, במקום בשיטת Round Robin.- רכיבים: Gateway API Inference Extension (
InferencePool,InferenceObjective, Endpoint Picker). - תחומי אחריות: גירוף מדדים של שרת המודל, ניקוד נקודות קצה (עומק התור, ניצול מטמון KV, זיקה למטמון קידומת, מתאמי LoRA), כיבוד סדרי עדיפויות לכל מטרה תחת עומס.
- ממשקים: Kubernetes API (
inference.networking.k8s.io/v1,inference.networking.x-k8s.io/v1alpha2), ext_proc gRPC (9002).
- רכיבים: Gateway API Inference Extension (
- מדיניות אבטחה ואימות במעלה הזרם: פרטי כניסה לקצוות עורפיים שדורשים אותם מוזרקים על ידי השער, ואף פעם לא מופצים לאפליקציות.
- רכיבים:
BackendSecurityPolicy, Envoy GatewaySecurityPolicy, מאזיני TLS. - תחומי אחריות: הזרקת מפתחות API לקצה העורפי, סיום TLS של הלקוח ב-
Gateway, אכיפת מדיניות האימות וההרשאה של הלקוח במקרה הצורך. - ממשקים:
Secrets של Kubernetes שאליהם מתייחסים כללי המדיניות.
- רכיבים:
- הגבלת קצב של יצירת בקשות לפי טוקנים (אופציונלי): השימוש נמדד בטוקנים, לא רק בבקשות.
- רכיבים: מעבד חיצוני (
llmRequestCosts), Envoy GatewayBackendTrafficPolicy(הגבלת קצב גלובלית), שירות הגבלת קצב, Redis. - תחומי אחריות: חילוץ טוקנים של קלט, פלט וסך הכל מכל תשובה, צירוף שלהם כעלויות בקשה, אכיפת תקציבים לכל צרכן או לכל מודל בכל הרפליקות של שרתי ה-proxy.
- thought ממשקים: Kubernetes API, Redis (6379).
- רכיבים: מעבד חיצוני (
- ניהול תנועה: יכולות רגילות של Gateway API חלות על תנועת AI.
- רכיבים:
Gateway,HTTPRoute,AIGatewayRoute,BackendTrafficPolicy. - תחומי אחריות: התאמה על סמך מארח, נתיב וכותרת, זמן קצוב לתפוגה שמתאים ליצירת תוכן ארוך, ניסיונות חוזרים, חלוקת תנועה משוקללת וחלופה על סמך עדיפות בין קצוות עורפיים.
- ממשקים: Kubernetes API.
- רכיבים:
- ניראות: מדדי הבקשות, זמן האחזור והטוקנים זמינים לכל מודל.
- רכיבים: יומני גישה ונתונים סטטיסטיים של שרת ה-proxy של Envoy, מדדים של מעבד חיצוני (שימוש בטוקנים, משך הבקשה, זמן עד הטוקן הראשון), מדדים של Endpoint Picker.
- תחומי אחריות: חשיפת מדדים בפורמט Prometheus ויומני גישה מובְנים, שאפשר לאסוף באמצעות מחסנית הניטור של GDC או Prometheus בניהול הלקוח.
- ממשקים: נקודות קצה של מדדי Prometheus, יומני פלט סטנדרטיים (stdout).
- ניהול פריטי מידע שנוצרו בתהליך הפיתוח (Artifact) עם Air Gap: כל קובץ אימג' ותרשים מועברים ל-Harbor לפני ההתקנה.
- רכיבים: Harbor,
seed_registry.sh, חשבונות רובוט, סודות למשיכת קובצי אימג', משאבEnvoyProxy(קובץ אימג' של שרת proxy וסוד למשיכת קובצי אימג'). - תחומי אחריות: הפצת אימג'ים ותרשימי OCI Helm מתחנת עבודה מחוברת, הצמדת גרסאות, רינדור תרשימים אופליין באמצעות
helm template. - ממשקים: OCI Distribution API, Kubernetes API.
- רכיבים: Harbor,
עקרונות ארכיטקטוניים
- תקנים קודם כול: השער מוגדר דרך Kubernetes Gateway API והתוסף שלו להסקת מסקנות, ומתקשר עם אפליקציות באמצעות API שתואם ל-OpenAI. כך אפשר להעביר אפליקציות, נתיבים ורכיבי backend בין הטמעות שונות של שערים.
- אבטחה לפני הכול: כל הרכיבים ומיקום אחסון הנתונים נמצאים בתוך הגבול של GDC עם air gap. סיום TLS ב-
Gateway, פרטי הכניסה לקצה העורפי מוזרקים על ידי השער, והגישה לרשת מוגבלת באמצעות אובייקטים שלNetworkPolicyו-ProjectNetworkPolicy. - ריבונות הנתונים: פרומפטים, תגובות, משקלי מודלים ונתוני שימוש אף פעם לא יוצאים מהארגון של הלקוח ב-GDC, ולא נדרשת קישוריות חיצונית כדי להפעיל את המודל.
- הפרדת תחומי האחריות: Gateway API מבוסס על תפקידים, ומאפשר למנהל הפלטפורמה לנהל את
GatewayClass,Gateway, TLS ומדיניות רשת ב-Kubernetes, בזמן שצוותי האפליקציות מנהלים את המשאבים שלAIGatewayRoute,AIServiceBackendו-InferencePoolבמרחבי השמות שלהם. - מישור בקרה ומישור נתונים מנותקים: הבקרים רק מתרגמים את ההגדרות. נתיב הבקשה מורכב משרת ה-proxy של Envoy, ממעבד ה-sidecar החיצוני שלו ומבורר נקודות הקצה, שממשיכים לשרת את התנועה אם הבקר מופעל מחדש.
- פתוחה וגמישה: הארכיטקטורה משתמשת בתוכנת קוד פתוח (Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension, Ollama, vLLM) ואפשר להשתמש בהטמעות חלופיות כדי להציג את אותם משאבים של Gateway API.
- יכולת התאמה וביצועים: מישור הנתונים מותאם אופקית על ידי הוספת רפליקות של שרתי proxy, ואנכית על ידי התאמת המעבד (CPU) והזיכרון. איזון עומסים שמותאם לשרת המודל שומר על רוויה של יחידות ה-GPU בלי להעמיס על רפליקות ספציפיות.
- חוויית משתמש קצה פשוטה יותר: נקודת קצה אחת, פורמט API אחד ופרטי כניסה אחד לכל מודל מקצרים את הדרך מפריסת המודל ועד לשימוש בו.
- עמידות: בדיקות תקינות ורפליקציה של Kubernetes, ניסיונות חוזרים של Envoy וגיבוי מבוסס-עדיפות בין קצוות עורפיים שומרים על נקודת הקצה זמינה כשעותקים ספציפיים של המודל נכשלים.
לתשומת ליבכם
- יכולת התאמה לעומס וביצועים:
- רכיבי השער הם עומסי עבודה של מעבד (CPU) בלבד. שרת ה-proxy של Envoy
DeploymentשלGatewayמשתנה אופקית על ידי הגדלת מספר הרפליקות (משאבEnvoyProxy) ואנכית על ידי הגדלת בקשות המעבד (CPU) והזיכרון. בדיקת גוף הבקשה על ידי המעבד החיצוני צורכת משאבי מעבד (CPU) באופן יחסי לגודל הבקשה והתגובה. תגובות בסטרימינג מעובדות באופן מצטבר. - איזון עומסים שמותאם לשרת המודל חל רק על קצוות עורפיים שמצורפים בתור
InferencePool. קצוות עורפיים שמצורפים בתורAIServiceBackendמאוזנים על ידי שרת ה-Proxy בנקודות הקצה שלServiceשלהם. - השער לא מוסיף קיבולת GPU: קצב הנתונים והזמן האחזור מוגבלים על ידי שרתי המודלים. קובעים את גודל פריסות המודלים באמצעות קבוצת המדריכים הנלווים (vLLM לתפוקה גבוהה, Ollama לקלות שימוש והערכה של מעבד בלבד).
- תהליכי יצירה ארוכים דורשים זמן קצוב ארוך יותר לבקשות ולזמן חוסר פעילות בהשוואה לממשקי API רגילים של HTTP. צריך להגדיר אותם בנתיבים ובכללי המדיניות, ולא בלקוחות.
- רכיבי השער הם עומסי עבודה של מעבד (CPU) בלבד. שרת ה-proxy של Envoy
- ניהול משאבים:
- כל רכיבי השער פועלים בצומתי מעבד (CPU) ולא נדרש מאיץ. בטבלה הבאה מוצגות מידות משוערות לפריסה פונקציונלית. ההטמעה של קובץ העזר מגדירה את הבקשות והמגבלות המדויקות. ערכי הייצור תלויים בקצב הבקשות ובגודל המטען הייעודי (payload).
- בטבלת היציאות הבאה מפורטות כל היציאות שצריך לאשר במדיניות רשת ב-Kubernetes.
- תכנון ה-GPU שייך לפריסות המודלים: שמות המשאבים של המאיצים מתגלים מהצמתים, כפי שמתואר במדריך הנלווה.
גודל משוער של רכיבי השער (מעבד בלבד)
| רכיב | עותקים | מעבד (בקשה) | זיכרון (בקשה) | הערות |
|---|---|---|---|---|
| בקר Envoy Gateway | 1 | 100 מיליון עד 500 מיליון | 256Mi עד 1Gi | מישור הבקרה; לא בנתיב הבקשה |
| בקר Envoy Agent Router | 1 | 100 מיליון עד 500 מיליון | 256Mi עד 512Mi | מישור הבקרה ושרת התוספים |
Envoy proxy Pod (שרת proxy + מעבד חיצוני) |
1-2 לכל Gateway |
500 מ'–2 | 512Mi–2Gi | התאמה לקצב הבקשות ולגודל המטען הייעודי (payload) |
| כלי לבחירת נקודת קצה (endpoint) | 1 לכל InferencePool |
100 מיליון עד 500 מיליון | 256Mi עד 512Mi | מגרד את המדדים של שרת המודל |
| שירות הגבלת קצב של יצירת בקשות (אופציונלי) | 1 | 100 מיליון עד 500 מיליון | 256Mi עד 512Mi | רק עם הגבלת קצב גלובלית של יצירת בקשות |
| Redis (אופציונלי) | 1 | 100 מיליון עד 500 מיליון | 256Mi עד 1Gi | רק עם הגבלת קצב גלובלית של יצירת בקשות |
יציאות רשת
| יציאה | רכיב | מטרה |
|---|---|---|
| 80 / 443 | שרת proxy של Envoy (Gateway הגדרות מסוג listener) |
נקודת כניסה מסוג HTTP או HTTPS ב-VIP של LoadBalancer |
| 1063 | בקר Envoy Agent Router (שרת תוספים) | קריאות gRPC ממנהל התוספים של Envoy Gateway |
| 9002 | כלי לבחירת נקודת קצה (endpoint) | שיחות ext_proc gRPC משרת ה-proxy של Envoy |
| 6379 | Redis | מונים של הגבלת קצב של יצירת בקשות |
| 8000 | vLLM | API תואם ל-OpenAI ומדדים של שרת המודל |
| 11434 | Ollama | API תואם ל-Ollama ול-OpenAI של שרת המודל |
- זמינות ואמינות:
- שרת ה-proxy והמעבד החיצוני פועלים באותו
Pod. כמה רפליקות מאחוריLoadBalancerServiceמסתירות כשלים בודדים ב-Pod, והבקרים יכולים לבצע הפעלה מחדש בלי להפריע לתנועה. - בכללים של
AIGatewayRouteאפשר לציין כמה קצוות עורפיים עם עדיפויות, כדי שהשער יחזור לקבוצת רפליקות או לשרת מודל אחרים כשהקצה העורפי לא תקין. - הכלי לבחירת נקודות קצה הוא
Deploymentלכל מאגר. אם הוא לא זמין, הבקשות לאותוInferencePoolייכשלו עד שהוא יחזור לפעול. מריצים אותו עם בקשות למשאבים ובדיקות מוכנות, ועוקבים אחריו כמו רכיב של מישור נתונים. - Redis מכיל רק מוני הגבלת קצב של יצירת בקשות. הפסקה זמנית בפעילות של Redis משפיעה על הגבלת הקצב של יצירת בקשות, ולא על הניתוב.
- שרת ה-proxy והמעבד החיצוני פועלים באותו
- מורכבות תפעולית:
- התאמת גרסאות בין Envoy Gateway, Envoy Agent Router ו-Gateway API Inference Extension: שדרגו את שלושתם ביחד עם השילוב שנבדק (Envoy Gateway 1.8.4, Envoy Agent Router 1.1.0, Gateway API Inference Extension 1.5.0).
- מחזור חיים עם air gap: כל קובץ אימג' ותרשים נזרעים מחדש ב-Harbor בכל שדרוג. המשאב
EnvoyProxyוערכי התרשים מצמידים את המרשם ואת סוד המשיכה. - שתי שכבות של הגדרות:
GatewayClass/Gateway/EnvoyProxyבבעלות הפלטפורמה ו-AIGatewayRoute/AIServiceBackend/InferencePoolבבעלות הצוות. כדי להוסיף מודל חדש, צריך להוסיף כלל מסלול ו-backend, ולא שער חדש. - מעקב: קצב בקשות, זמן אחזור (כולל הזמן עד לטוקן הראשון), שימוש בטוקנים לכל מודל ולכל צרכן, ניקוד של Endpoint Picker וניצול ה-GPU של שרתי המודלים.
-
InferenceObjectiveהוא עדיין API בשלב אלפא (v1alpha2). צפויים שינויים בסכימה בין גרסאות של Inference Extension.
- אבטחה ותאימות:
- הפתרון כולו פועל במסגרת היקף האבטחה של GDC עם air gap.
- חובה להגדיר מדיניות רשת ב-Kubernetes: מרחב השמות
NetworkPolicyמאפשר תנועה מהשרת proxy ליציאות של שרת המודל (8000, 11434) ול-Endpoint Picker (9002), ו-ProjectNetworkPolicyמאפשר תנועה של לקוחות ל-VIP שלLoadBalancerכשהצרכנים נמצאים מחוץ לפרויקט. - סיום TLS מסתיים ב-
Gatewayעם אישור שמאוחסן ב-Secretשל Kubernetes. הלקוחות רואים רק את נקודת הקצה של השער. - פרטי הכניסה במעלה הזרם (לדוגמה, מפתח API שנדרש על ידי שרת מודל) מאוחסנים ב-
Secretשאליהם מפנהBackendSecurityPolicy, ומוזרקים על ידי השער, כך שהאפליקציות אף פעם לא מכילות פרטי כניסה לקצה העורפי. - הגבלת קצב של יצירת בקשות שמבוססת על טוקנים מגבילה את הצריכה של קיבולת GPU יקרה לכל צרכן או לכל מודל.
- חשבונות רובוט של Harbor וסודות לשליפת קובצי אימג' של Kubernetes מבטיחים גישה מאובטחת לקובצי אימג' של קונטיינרים. RBAC של Gateway API שמכוון לתפקידים מפריד בין תחומי האחריות של הפלטפורמה והאפליקציה.
החלטות עיצוביות
אלה החלטות התכנון העיקריות שהתקבלו בארכיטקטורה לדוגמה:
החלטה 1: הטמעת שער AI: נתב Envoy Agent בקוד פתוח ב-Envoy Gateway לעומת הפצות חלופיות
| הקשר | החלטה חשובה | ההסבר |
|---|---|---|
| שער ה-AI הוא הבחירה האדריכלית העיקרית עם חלופות אפשריות, מאפשרויות קוד פתוח בניהול עצמי ועד להצעות שנתמכות באופן מסחרי: (א) Envoy Agent Router ב-Envoy Gateway (קוד פתוח), (ב) kgateway ו-agentgateway (הטמעות של Gateway API בקוד פתוח שמטפלות גם בתנועה של ספקי LLM, בכלי MCP ובתקשורת בין סוכנים במישור נתונים אחד, עם תמיכה אופציונלית של ספק מ-solo.io), (ג) Solo Enterprise ל-agentgateway כאפשרות פרימיום שנתמכת באופן מסחרי. | הטמעת ההפניה משתמשת ב-Envoy Agent Router בקוד פתוח ב-Envoy Gateway. החלופות נשארות אפשרויות תקינות מאחורי אותם משאבים של Gateway API. מומלץ להשתמש בהפצה שנתמכת באופן מסחרי בסביבות ייצור שדורשות תמיכה ייעודית של ספק. | יתרונות של קוד פתוח: קל משקל ותואם לתקנים, ניתוב L7 עם ביצועים גבוהים, ללא דמי רישיון, אידיאלי להערכת הפתרון לפני התחייבות להצעה בתשלום. Envoy Agent Router הוא האפשרות שאומתה בקבוצת המדריכים הזו. חסרונות של קוד פתוח: התמיכה היא על בסיס מאמץ סביר של צוות הפתרונות ושל הקהילה, וייתכן שהיא לא תתאים לסביבות ייצור מרכזיות. יתרונות של גרסאות פרימיום: הסכמי תמיכת Enterprise למחזור החיים של השער, ולעיתים קרובות גם יכולות אג'נטיות מתקדמות. חסרונות של גרסת פרימיום: הסכם רישוי או תמיכה בתשלום וקשר עם ספק נוסף. |
החלטה 2: Kubernetes Gateway API עם Inference Extension לעומת Ingress או Gateway API קנייני
| הקשר | החלטה חשובה | ההסבר |
|---|---|---|
| אפשר לחשוף נקודות קצה להסקת מסקנות באמצעות Ingress API הקודם, פורמט הגדרה ספציפי לשער או Kubernetes Gateway API. באיזון עומסים עם מודעות למודלים, צריך גם דרך לתאר את מאגרי שרתי המודלים ואת העדיפויות שלהם. | הפתרון מתבסס על Kubernetes Gateway API (GatewayClass, Gateway, נתיבים) שמוטמע על ידי Envoy Gateway, ועל Gateway API Inference Extension (InferencePool, InferenceObjective, בחירת נקודת קצה) לניתוב לפי מודל. |
Gateway API הוא תקן Kubernetes שמחליף את Ingress, מבוסס על תפקידים (צוותי פלטפורמה לעומת צוותי אפליקציות) וניתן להעברה בין הטמעות. התוסף Inference Extension הוא הסטנדרט הקהילתי לניתוב שמודע לשרת המודל (עומק התור, מטמון KV, עדיפויות) ונתמך על ידי Envoy Agent Router באופן מיידי. ההפצות החלופיות של השער מטמיעות את אותם ממשקי API, מה שמאפשר לבטל את החלטה 1. |
החלטה 3: ניתוב מבוסס-גוף בשדה model של בקשות תואמות ל-OpenAI כנקודת הקצה המאוחדת
| הקשר | החלטה חשובה | ההסבר |
|---|---|---|
אפליקציות יכולות לפנות למודלים דרך נקודת קצה אחת לכל מודל (על סמך מארח או נתיב), דרך כותרת בהתאמה אישית שהלקוח מגדיר או דרך השדה model שכבר קיים בכל בקשה שתואמת ל-OpenAI. |
השער חושף נקודת קצה אחת שתואמת ל-OpenAI ומנתב בשדה model: המעבד החיצוני מחלץ אותו לכותרת x-ai-eg-model וכללי AIGatewayRoute תואמים לכותרת הזו. |
לקוחות וערכות SDK קיימים שתואמים ל-OpenAI פועלים ללא שינוי ומחליפים מודלים על ידי שינוי של מחרוזת אחת. אפשר לשנות נקודות קצה, פרטי כניסה ומיקום של מודלים בלי לגעת באפליקציות. אותם כללים יכולים למפות שם של מודל לכמה קצוות עורפיים לצורך חלוקת תנועה, חלופות או שינוי של שמות מודלים. |
החלטה 4: הפצת פריטי מידע שנוצרו עם air gap ל-Harbor לעומת משיכות על פי דרישה
| הקשר | החלטה חשובה | ההסבר |
|---|---|---|
| ההתקנה במעלה הזרם שולפת קובצי אימג' של קונטיינרים ממאגרים ציבוריים ותרשימי Helm כארטיפקטים של OCI על פי דרישה, וזה בלתי אפשרי בסביבה עם air gap. | כל קובצי האימג' של הקונטיינרים (שרת proxy של Envoy, Envoy Gateway, בקר Envoy Agent Router ומעבד חיצוני, שירות הגבלת קצב של יצירת בקשות, Endpoint Picker, Redis) ותרשימי Helm של Envoy Gateway ו-Envoy Agent Router נשלחים לפרויקט Harbor באמצעות seed_registry.sh (crane), התרשימים מוצגים אופליין באמצעות helm template מ-Harbor, והמשאב EnvoyProxy וערכי התרשים מצמידים את המרשם של Harbor ואת הסוד למשיכה. |
שלב אחד של סידינג (seeding) שניתן לחזור עליו ולבקר אותו לכל גרסה; האשכול אף פעם לא צריך קישוריות חיצונית; הצמדת גרסה הופכת את השדרוגים למפורשים וניתנים לביטול. |
החלטה 5: הגבלת קצב אופציונלית מבוססת-אסימונים באמצעות Redis לעומת מגבלות מבוססות-בקשות בלבד
| הקשר | החלטה חשובה | ההסבר |
|---|---|---|
| קיבולת ה-GPU נצרכת לכל טוקן, ולא לכל בקשה. מגבלה על מספר הבקשות לא יכולה להגן על מודל משותף מפני כמה הנחיות גדולות מאוד או יצירות ארוכות. הגבלת קצב גלובלית של יצירת בקשות ב-Envoy Gateway דורשת מאגר משותף של מוני בקשות. | הגבלת קצב של יצירת בקשות שמבוססת על טוקנים היא תכונה אופציונלית של הארכיטקטורה: המעבד החיצוני מתעד את הטוקנים של הקלט, הפלט והסך הכולל לכל בקשה (llmRequestCosts), BackendTrafficPolicy אוכף את התקציב, ומכונה של Redis (Redis 8.10, שנפרסה באשכול או במכונה קיימת) מאחסנת את המונים. בפריסות בלי הגבלת קצב של יצירת בקשות לא צריך את Redis. |
השימוש נמדד ביחידה שמשקפת את העלות, התקציבים נאכפים באופן עקבי בכל הרפליקות של שרתי ה-proxy, והתשלום על התלות מתבצע רק על ידי לקוחות שצריכים מכסות. |
החלטה 6: טופולוגיה: מישור הבקרה והנתונים של השער במרחב שמות ייעודי של אשכול רגיל, מודלים במרחבי שמות של אפליקציות
| הקשר | החלטה חשובה | ההסבר |
|---|---|---|
| אפשר להריץ את השער באשכול ייעודי, בכל מרחב שמות של אפליקציה או פעם אחת בכל אשכול רגיל לצד המודלים שהוא מציג. מודלים פתוחים ב-GDC עם air gap נפרסים באשכולות רגילים (מדריך נלווה). | מישור הבקרה של Envoy Gateway ו-Envoy Agent Router ומישור הנתונים של Envoy proxy פועלים במרחב שמות ייעודי של האשכול הרגיל שמארח את המודלים; AIGatewayRoute, AIServiceBackend, InferencePool ופריסות המודלים נמצאים במרחבי השמות של האפליקציה, ויש אליהם הפניות בין מרחבי השמות. |
הבקשות נשארות בתוך רשת האשכול בין שרת ה-proxy לבין Pod המודלים (זמן האחזור הכי קצר, בלי מאזני עומסים נוספים), מנהל הפלטפורמה הוא הבעלים של מרחב השמות של השער, וצוותי האפליקציות הם הבעלים של הנתיבים והמודלים שלהם. בנוסף, הכלי לבחירת נקודות קצה יכול לגרד את שרתי המודלים ישירות. שער לקוח לכל פרויקט שמעביר לשער שרת מרכזי נשאר הרחבה של הטופולוגיה הזו לצריכה של כמה פרויקטים. |
הנחות ומגבלות
- סביבת GDC עם air gap בגרסה 1.16.2-hf1 ואילך זמינה עם אשכול רגיל שפועל בו Kubernetes בגרסה v1.32.13-gke.400 ואילך.
- משאבי חומרה מספיקים (במיוחד GPUs) קיימים בשביל הקצה העורפי של פרסום המודל. רכיבי השער עצמם פועלים בצומתי CPU. מודלים אמיתיים צריכים מעבדי GPU. מודלים קטנים ב-Ollama יכולים לפעול ב-CPU רק לצורך הערכה פונקציונלית.
- מופע Harbor מוגדר ונגיש, ותחנת עבודה עם גישה לאינטרנט וקישוריות לסביבת GDC (ממשק API של Harbor ו-Kubernetes) זמינה להוספת תמונות ותרשימים.
- למשתמשים יש את ההרשאות הנדרשות: תפקידי הפרויקט "צפייה במכונה של Harbor" ו"אדמין של אשכול רגיל", וגם
StandardClusterRoleBindingלתפקידcluster-adminבאשכול הרגיל להתקנה ברמת האשכול (CRD,GatewayClass, מרחבי שמות). אפשר לעיין בהטמעה לדוגמה. - ה-backends של פרסום המודל חושפים API שתואם ל-OpenAI. ה-backends שמצורפים בתור
InferencePoolחושפים גם את המדדים שתואמים ל-vLLM, שעליהם מסתמך בורר נקודות הקצה. - מגבלה: התמיכה ברכיבי קוד פתוח (Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension) היא במסגרת המאמץ המרבי של צוות הפתרונות. כדי לקבל תמיכה ייעודית מהספק, צריך הפצה שנתמכת באופן מסחרי (החלטה 1).
- מגבלה:
InferenceObjectiveהוא ממשק API בגרסת אלפא (inference.networking.x-k8s.io/v1alpha2) ועשוי להשתנות בין גרסאות של Inference Extension. - מגבלה: נדרשים כתובת VIP של
LoadBalancerל-Gatewayו-ProjectNetworkPolicyלצרכנים מחוץ לפרויקט. בתוך הפרויקט, לקוחות באשכול אוkubectl port-forwardיכולים להגיע ישירות לשערService. - מגבלה: Gemini ב-GDC, כוונון מודלים, מודלים של AI גנרטיבי שהם לא LLM ופרסום מודלים בכמה צמתים לא נכללים בגרסה הזו של הפתרון.
מסלול המשתמש באפליקציה
בהמשך מתואר מסלול המשתמש המלא של שער ה-AI ב-GDC עם air gap: קודם נתיב הבקשה שמפתח האפליקציה מסתמך עליו, ואז נתיב ההגדרה שמנהל הפלטפורמה מבצע.
1. נתיב הבקשה של המפתח
אפליקציה או סוכן צריכים רק את נקודת הקצה של השער, פרטי כניסה של לקוח אם השער אוכף זאת, ואת שם המודל.
- שליחת הבקשה: האפליקציה קוראת ל-
POST /v1/chat/completionsבנקודת הקצה של השער עם גוף JSON שתואם ל-OpenAI, שמציין את שם המודל (לדוגמה"model": "gemma"), בדיוק כמו שהיא הייתה קוראת לכל שירות שתואם ל-OpenAI. - כניסה לשער: הבקשה מגיעה ל-VIP של
LoadBalancerב-Gateway. שרת ה-proxy של Envoy מסיים את ה-TLS ומתאים את המאזין והמסלול. - עיבוד גוף הבקשה: שרת ה-Proxy מעביר את הבקשה למעבד החיצוני Envoy Agent Router, שמנתח את גוף הבקשה, מחלץ את שם המודל לכותרת
x-ai-eg-modelומתרגם את המטען הייעודי (payload) לסכימה של ה-backend אם היא שונה. - בחירת הקצה העורפי: הכלל של
AIGatewayRouteשתואם לשם המודל בוחרAIServiceBackend(לדוגמה, OllamaService) אוInferencePool(לדוגמה, קבוצת רפליקות של vLLM). בשבילInferencePool, בורר נקודות הקצה בוחר את הרפליקה עם התור הכי קצר וההתאמה הכי טובה למטמון KV. - העברה ותגובה: שרת ה-proxy מוסיף את פרטי הכניסה של ה-upstream כשחל
BackendSecurityPolicy, מעביר את הבקשה אלPodשנבחר, מעביר את התגובה בסטרימינג בחזרה ומאפשר למעבד החיצוני לתעד את השימוש בטוקנים, שמזין את המדדים, וכשמוגדרת מגבלת קצב של יצירת בקשות שמבוססת על טוקנים, גם את המגבלה הזו. - החלפת מודלים: כדי להשתמש במודל אחר, המפתח משנה את המחרוזת
model. לא צריך נקודת קצה, פרטי כניסה או ספריית לקוח חדשים.
2. נתיב ההגדרה של מנהל הפלטפורמה
- הוספת פריטי מידע שנוצרו בתהליך הפיתוח (Artifacts) ל-Harbor: יוצרים את חשבונות הרובוט של Harbor, ואז מעתיקים את קובצי האימג' של הקונטיינרים ואת תרשימי ה-Helm של Envoy Gateway ו-Envoy Agent Router ל-Harbor באמצעות
seed_registry.shמתחנת עבודה עם גישה לאינטרנט. - התקנת Envoy Gateway: עיבוד תרשימי ה-CRD והבקר מ-Harbor באמצעות
helm templateוהחלה שלהם במרחב השמות של השער; יצירת המשאבEnvoyProxyשמצמיד את תמונת ה-proxy וסוד המשיכה, ואימות הבקר באמצעותGatewayClass,Gatewayו-HTTPRouteבסיסיים. - התקנת Envoy Agent Router: מתקינים את ה-CRD של Envoy Agent Router ואת ה-CRD של Gateway API Inference Extension, פורסים את הבקר של Envoy Agent Router ומגדירים מחדש את Envoy Gateway כך שיקרא לשרת התוסף שלו (יציאה 1063) ויקבל קצוות עורפיים של
InferencePool. אפשר גם לפרוס את Redis ולהפעיל את שירות הגבלת הקצב הגלובלי של יצירת בקשות. - חשיפת השער: יוצרים את
GatewayClassואתGatewayעם מאזיני HTTP ו-HTTPS (אישור TLSSecret), ממתינים ל-VIP שלLoadBalancerומחילים אתProjectNetworkPolicyלצרכנים מחוץ לפרויקט. - צירוף מודלים: פורסים את הקצוות העורפיים של פרסום המודלים באמצעות קבוצת המדריכים הנלווים, ואז יוצרים משאבי
AIServiceBackendל-Services ול-InferencePoolשתואמים ל-OpenAI, וגם משאבי Endpoint Picker לקבוצות של רפליקות שתואמות ל-vLLM, יחד עם אובייקטים של מרחב השמותNetworkPolicy. - פרסום המסלול: יוצרים את
AIGatewayRouteעם כלל אחד לכל שם מודל (ניתוב מבוסס-גוף), ובמידת הצורך, אובייקטים שלBackendSecurityPolicyו-BackendTrafficPolicyלאישורים במעלה הזרם ולתקציבי טוקנים. - אימות והפעלה: קוראים ל-
/v1/modelsול-/v1/chat/completionsדרך ה-VIP (או חלופה שלkubectl port-forward), בודקים את המדדים של שרת ה-proxy, המעבד החיצוני ובורר נקודות הקצה, ומעבירים את שמות נקודות הקצה והמודלים לצוותי האפליקציות. אפשר לשנות את קנה המידה של הרפליקות של שרתי ה-Proxy ושל פריסות המודלים בנפרד, ולשדרג את Envoy Gateway, את Envoy Agent Router ואת Inference Extension ביחד.
השלבים המפורטים מופיעים בהטמעת העזר של Envoy Agent Router ובמדריך למשתמש בנושא ניתוב מבוסס-גוף באמצעות Envoy Agent Router.
חומרים נוספים
- הטמעת עזר של Envoy Agent Router
- ניתוב מבוסס-גוף באמצעות מדריך למשתמש של Envoy Agent Router
- ארכיטקטורת עזר למודלי LLM עם משקלים פתוחים
- המסמכים של Envoy Agent Router
- Envoy Gateway
- Kubernetes Gateway API
- Gateway API Inference Extension
- מסמכי התיעוד של Google Distributed Cloud במודל Air-gapped