


Énoncé du problème
Les organisations qui exécutent des grands modèles de langage (LLM) dans des environnements sous air gap accumulent rapidement des points de terminaison de modèle : chaque modèle à pondération ouverte diffusé sur Google Distributed Cloud (GDC) sous air gap (voir l'ensemble de guides d'accompagnement "Modèles à pondération ouverte sur GDC sous air gap") expose son propre Service Kubernetes, sa propre adresse, ses propres identifiants et son propre cycle de vie opérationnel.
Les développeurs d'applications et d'agents se retrouvent dans des silos architecturaux, codant en dur un point de terminaison par modèle et réécrivant les intégrations à chaque itération de modèle. Cette fragmentation crée une dette technique et ralentit le déploiement de charges de travail d'agents critiques en plusieurs étapes.
Les couches réseau standards sont également "aveugles à l'IA" : un équilibreur de charge classique traite le trafic d'inférence comme du trafic HTTP générique et ne peut pas lire le champ model d'une requête, prioriser les charges de travail sensibles à la latence, prendre en compte les jetons au lieu des requêtes, ni diriger une requête vers l'instance répliquée du serveur de modèles qui contient déjà le cache KV pertinent. Dans les clusters de GPU sous air gap coûteux, cela entraîne une sous-utilisation du matériel et un faible retour sur investissement. Bien que Gemini sur GDC fournisse des modèles de frontière gérés, les clients qui les combinent avec des modèles à pondération ouverte auto-hébergés ont besoin d'une couche d'inférence offrant une agilité semblable à celle du cloud sans compromettre la souveraineté des données : aucune requête, aucun prompt ni aucune pondération de modèle ne peut quitter la limite de GDC.
Solution proposée
Ce document décrit l'architecture de référence d'une passerelle d'IA autogérée sur GDC sous air gap : une couche d'inférence sécurisée et centralisée qui fournit aux applications un point de terminaison unique compatible avec OpenAI pour tous les modèles et achemine chaque requête vers le bon backend. L'implémentation de référence s'appuie sur l'API Kubernetes Gateway : Envoy Gateway est l'implémentation de l'API Gateway (plan de contrôle et plan de données du proxy Envoy) et Envoy Agent Router (anciennement Envoy AI Gateway) l'étend avec un traitement des requêtes spécifique à l'IA : extraction du modèle à partir du corps de la requête, traduction des requêtes et des réponses, authentification en amont, traçabilité des jetons et, éventuellement, limitation du débit basée sur les jetons. L'extension d'inférence de l'API Gateway ajoute une sélection de points de terminaison compatible avec les serveurs de modèles (InferencePool et Endpoint Picker) afin que la capacité des GPU soit utilisée efficacement. Tous les artefacts sont stockés en préproduction dans le registre Harbor de l'organisation GDC, et l'ensemble de la pile s'exécute dans un cluster standard sans aucune connectivité externe.
Éléments inclus : cette architecture couvre le déploiement d'Envoy Gateway et d'Envoy Agent Router dans un cluster standard, les ressources de l'API Gateway (GatewayClass, Gateway) et les ressources d'Envoy Agent Router (AIGatewayRoute, AIServiceBackend, BackendSecurityPolicy, GatewayConfig) qui exposent un point de terminaison unifié compatible avec OpenAI, le routage basé sur le corps dans le champ model, l'extension d'inférence de l'API Gateway (InferencePool, InferenceObjective, sélecteur de point de terminaison) pour l'équilibrage de charge tenant compte du modèle, la limitation facultative du débit basée sur les jetons avec Redis, la terminaison TLS au niveau de la passerelle, les règles de réseau (NetworkPolicy/ProjectNetworkPolicy) et la gestion des artefacts sous air gap dans Harbor. Les backends de mise en service du modèle derrière la passerelle (Ollama, vLLM) sont déployés avec l'ensemble de guides d'accompagnement "Modèles Open Weight sur GDC avec isolation physique".
Ce qui n'est pas inclus : cette architecture ne couvre pas un produit de passerelle d'IA géré, le déploiement et le réglage des modèles eux-mêmes (ensemble de guides complémentaires), l'ajustement des modèles, les modalités d'IA générative non LLM, le trafic agent-outil (MCPRoute) ou les distributions de passerelles commercialement compatibles. Gemini sur GDC est une fonctionnalité de produit gérée. Son provisionnement n'entre pas dans le champ d'application de ce guide, et cette version du guide valide la passerelle avec des modèles Open Weights auto-hébergés.
Audience : ce document s'adresse principalement aux administrateurs de plate-forme chargés de déployer et d'exploiter la passerelle dans un cluster standard, ainsi qu'aux architectes techniques qui conçoivent des plates-formes d'IA dans l'environnement air gap. Les développeurs d'applications qui utilisent le point de terminaison unifié constituent une audience secondaire qui bénéficie de la compréhension du routage de leurs requêtes.
Architecture
La solution s'exécute entièrement dans un cluster standard de l'organisation GDC sous air gap. Dans la couche Services, l'API Gateway Kubernetes standardise le modèle de configuration. Le plan de contrôle de la passerelle d'IA (le contrôleur Envoy Gateway et le contrôleur Envoy Agent Router) lit les ressources de l'API Gateway et d'Envoy Agent Router, puis configure le plan de données : un proxy Envoy Deployment qui est le point d'entrée de la requête (exposé via un Service de type LoadBalancer) et le processeur externe Envoy Agent Router qui s'exécute en tant que side-car dans le proxy Pod et exécute la logique spécifique à l'IA. Dans la couche d'application, les charges de travail client (applications et agents) envoient une requête d'IA au proxy (1). Le proxy transmet la requête au processeur externe, qui extrait le nom du modèle, traduit la requête et enregistre l'utilisation des jetons (2). Le proxy transfère le trafic équilibré vers les Pod d'inférence du modèle sélectionné (3), et le modèle s'exécute sur les nœuds GPU de la couche d'infrastructure (4). Les backends de mise en service du modèle sont associés à la passerelle en tant que AIServiceBackend (tout Service compatible avec OpenAI) ou en tant que InferencePool dont le sélecteur de point de terminaison sélectionne la meilleure instance répliquée par requête. Les images de conteneurs et les charts Helm sont extraits de Harbor.
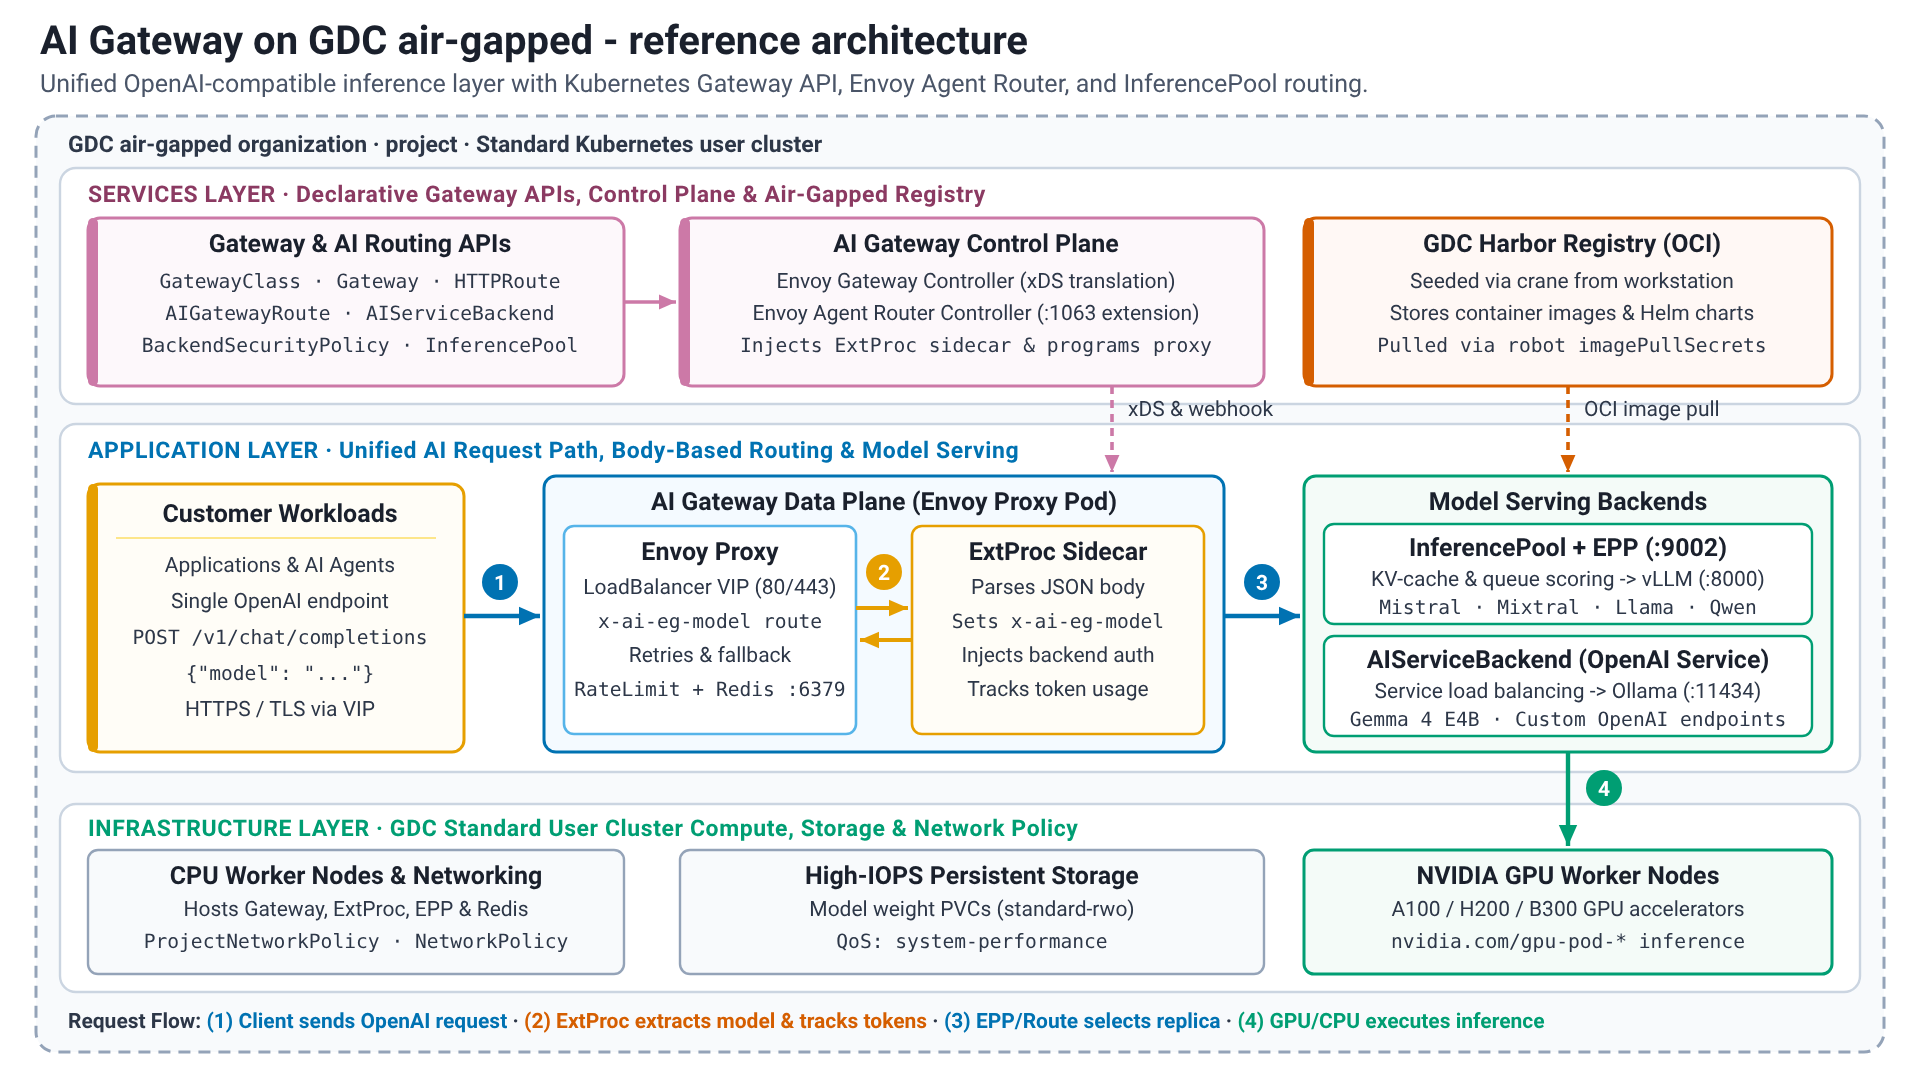
Composants de la solution
La solution utilise les composants suivants :
| Composant de la solution | Responsabilités | Flux de données | Interfaces |
|---|---|---|---|
| API Kubernetes Gateway | Modèle de ressources standard orienté rôles pour l'entrée et le routage : GatewayClass (propriété de la plate-forme), Gateway (écouteurs, TLS) et ressources de routage (propriété des équipes d'application). Successeur de l'API Ingress sans annotations spécifiques au fournisseur. |
Configuration déclarative uniquement : les ressources sont surveillées par les contrôleurs et ne transportent aucun trafic de requête. | API Kubernetes (gateway.networking.k8s.io/v1) ; les CRD sont installés à partir du chart CRD Envoy Gateway. |
| Contrôleur Envoy Gateway (plan de contrôle) | Implémente l'API Gateway : provisionne un proxy Envoy Deployment et LoadBalancer Service par Gateway, traduit les routes et les règles (BackendTrafficPolicy, SecurityPolicy, EnvoyExtensionPolicy, Backend, EnvoyProxy) en configuration xDS, exécute le service de limitation de débit global lorsqu'il est configuré, et appelle le serveur d'extension Envoy Agent Router via son gestionnaire d'extensions afin que les backends InferencePool soient ajoutés à la traduction. |
Surveille l'API Kubernetes et transmet la configuration xDS aux proxys ; aucun trafic de requêtes. | API Kubernetes (watch), xDS gRPC vers les proxys, gRPC vers le serveur d'extension (port 1063). |
| Contrôleur de routeur de l'agent Envoy (plan de contrôle) | Rapproche les ressources aigateway.envoyproxy.io/v1beta1, AIGatewayRoute (règles de routage sur le nom du modèle extrait), AIServiceBackend (un backend avec son schéma d'API), BackendSecurityPolicy (identifiants en amont) et GatewayConfig (paramètres du processeur externe par Gateway) dans les ressources Envoy Gateway, injecte le side-car du processeur externe dans les Pod du proxy Envoy et diffuse le serveur d'extension utilisé par Envoy Gateway. |
Configuration uniquement. | API Kubernetes, serveur d'extension gRPC (port 1063), webhook d'admission de mutation pour l'injection side-car. |
| Proxy Envoy (plan de données) | Point d'entrée de la requête : met fin au protocole TLS, met en correspondance les écouteurs et les routes, équilibre la charge entre les points de terminaison de backend, applique les limites de débit et les délais avant expiration, effectue de nouvelles tentatives et bascule vers d'autres backends, et émet des journaux d'accès et des métriques. | Il reçoit les requêtes client sur l'adresse IP virtuelle LoadBalancer (80/443), consulte le processeur externe pour chaque requête d'IA, transfère la requête au point de terminaison de backend sélectionné (un Service ou le Pod choisi par le sélecteur de point de terminaison) et renvoie la réponse au client. |
HTTP/HTTPS vers les clients (API compatible avec OpenAI), ext_proc gRPC vers le side-car et le sélecteur de point de terminaison, HTTP vers les backends, gRPC vers le service de limitation du débit. |
| Processeur externe (ExtProc) du routeur de l'agent Envoy | Analyse le corps de la requête compatible avec OpenAI, extrait le champ model dans l'en-tête de routage x-ai-eg-model, applique les remplacements de nom de modèle, traduit les charges utiles de requête et de réponse entre le schéma de l'API cliente et le schéma de l'API backend, injecte les identifiants en amont définis par BackendSecurityPolicy, et extrait l'utilisation des jetons (entrée, sortie, total) de la réponse dans les métadonnées dynamiques utilisées pour la limitation du débit et les métriques basées sur les jetons. |
Conteneur side-car dans le proxy Envoy Pod ; traite les corps de requête et de réponse, y compris les réponses diffusées en continu. |
gRPC ext_proc Envoy ; point de terminaison des métriques Prometheus. |
| Extension d'inférence de l'API Gateway (InferencePool + Endpoint Picker) | InferencePool (inference.networking.k8s.io/v1) regroupe les Pod d'un déploiement de serveur de modèles (sélecteur d'étiquettes, port cible, par exemple 8000) et fait référence à son sélecteur de points de terminaison (EPP). InferenceObjective (v1alpha2) attribue une priorité par modèle ou objectif. L'EPP extrait les métriques du serveur de modèles (profondeur de la file d'attente des requêtes, utilisation du cache KV, adaptateurs LoRA chargés) et sélectionne le point de terminaison pour chaque requête. |
Le proxy appelle l'EPP (ext_proc, port 9002) avec les en-têtes de requête. L'EPP répond avec le point de terminaison à utiliser. Le proxy transmet la requête à ce Pod. |
API Kubernetes (CRD), gRPC ext_proc (9002), scraping Prometheus des serveurs de modèles. |
| Redis (facultatif) | Magasin de stockage du service de limitation du débit Envoy : compteurs partagés pour les limites basées sur les requêtes et les jetons sur toutes les instances répliquées du proxy. Nécessaire uniquement lorsque la limitation globale du débit est configurée. | Le service de limitation du débit lit et incrémente les compteurs sur le port 6379 pour chaque requête limitée. | Protocole Redis (6379). Redis 8.10 déployé dans le cluster ou une instance Redis existante. |
| Backends de mise en service du modèle (Ollama/vLLM) | Diffusez les modèles à pondération ouverte derrière la passerelle, déployés avec l'ensemble de guides d'accompagnement "Modèles à pondération ouverte sur GDC sous air gap". Associé en tant que AIServiceBackend (tout Service compatible avec OpenAI, par exemple Ollama) ou en tant que InferencePool (serveurs de modèles tels que vLLM qui exposent les métriques sur lesquelles le sélecteur de point de terminaison attribue des scores). |
Recevoir les requêtes acheminées depuis le proxy, exécuter l'inférence sur les nœuds GPU (ou sur le processeur pour l'évaluation fonctionnelle avec de petits modèles) et renvoyer la réponse compatible avec OpenAI. | API REST compatible avec OpenAI : vLLM sur le port 8000, Ollama sur le port 11434 ; métriques Prometheus (vLLM) pour le sélecteur de point de terminaison. |
| Harbor | Stocke les images de conteneur (proxy Envoy, Envoy Gateway, contrôleur et processeur externe Envoy Agent Router, service de limitation du débit, Endpoint Picker, Redis) et les charts Helm (artefacts OCI) de la solution. | Les artefacts sont copiés des registres publics vers Harbor avec seed_registry.sh (crane) depuis un poste de travail disposant d'un accès à Internet. Le cluster extrait les images avec un compte de robot via des secrets d'extraction d'images, et les charts sont affichés depuis Harbor avec helm template. |
API de distribution OCI, interface utilisateur Harbor et comptes de robot. |
| Cluster Standard et nœuds GPU | Héberge tous les composants de la passerelle (les nœuds de processeur sont suffisants) et les Pod d'inférence (nœuds de GPU avec les ressources d'accélérateur découvertes à partir des nœuds). Fournit des adresses IP virtuelles LoadBalancer, un stockage persistant pour les pondérations de modèle et l'application des règles de réseau. |
Plate-forme de base : les requêtes entrent via l'adresse IP virtuelle LoadBalancer de l'Gateway et restent dans le réseau du cluster. |
API Kubernetes, API de mise en réseau GDC (networking.gdc.goog/v1 ProjectNetworkPolicy), console GDC et gdcloud pour l'administrateur de la plate-forme. |
Fonctionnalités et capacités
Cette architecture de référence offre les fonctionnalités de base suivantes :
- Point de terminaison unifié compatible avec OpenAI : les applications appellent une adresse (
/v1/chat/completions,/v1/models, etc.) pour chaque modèle diffusé derrière la passerelle.- Composants :
Gateway,AIGatewayRoute, proxy Envoy, processeur externe. - Responsabilités : exposer une adresse IP virtuelle stable, mettre fin au protocole TLS, accepter le format de requête compatible avec OpenAI et le traduire dans le schéma du backend si nécessaire.
- Interfaces : HTTPS REST (JSON, y compris les événements envoyés par le serveur pour le streaming).
- Composants :
- Routage basé sur le corps (sensible au modèle) : la passerelle lit le champ
modeldu corps de la requête et achemine la requête vers le backend correspondant sans aucune logique de point de terminaison côté client.- Composants : processeur externe, règles
AIGatewayRoutecorrespondant àx-ai-eg-model,AIServiceBackend,InferencePool. - Responsabilités : extraire le nom du modèle, faire correspondre les règles de routage, renommer les modèles (
modelNameOverride), répartir le trafic en fonction de la pondération et basculer vers d'autres backends par priorité. - Interfaces : API Kubernetes (
aigateway.envoyproxy.io/v1beta1).
- Composants : processeur externe, règles
- Équilibrage de charge tenant compte du serveur de modèles : les requêtes adressées à un
InferencePoolsont envoyées à l'instance répliquée avec la file d'attente la plus courte et le cache KV le plus utile, au lieu d'utiliser le round robin (à tour de rôle).- Composants : extension d'inférence de l'API Gateway (
InferencePool,InferenceObjective, sélecteur de point de terminaison). - Responsabilités : Récupérer les métriques du serveur de modèles, évaluer les points de terminaison (profondeur de la file d'attente, utilisation du cache KV, affinité du cache de préfixe, adaptateurs LoRA), respecter les priorités par objectif en cas de charge.
- Interfaces : API Kubernetes (
inference.networking.k8s.io/v1,inference.networking.x-k8s.io/v1alpha2), ext_proc gRPC (9002).
- Composants : extension d'inférence de l'API Gateway (
- Règles d'authentification et de sécurité en amont : les identifiants des backends qui en ont besoin sont injectés par la passerelle et ne sont jamais distribués aux applications.
- Composants :
BackendSecurityPolicy, Envoy GatewaySecurityPolicy, écouteurs TLS. - Responsabilités : injecter des clés API vers les backends, arrêter le protocole TLS client au niveau de
Gateway, appliquer les règles d'authentification et d'autorisation du client si nécessaire. - Interfaces :
SecretKubernetes référencés par les règles.
- Composants :
- Limitation du débit basée sur les jetons (facultatif) : l'utilisation est mesurée en jetons, et pas seulement en requêtes.
- Composants : processeur externe (
llmRequestCosts), Envoy GatewayBackendTrafficPolicy(limitation globale du débit), service de limitation du débit, Redis. - Responsabilités : extraire les jetons d'entrée, de sortie et totaux de chaque réponse, les associer en tant que coûts de requête, appliquer des budgets par consommateur ou par modèle à toutes les instances répliquées du proxy.
- Interfaces : API Kubernetes, Redis (6379).
- Composants : processeur externe (
- Gestion du trafic : les fonctionnalités standards de l'API Gateway s'appliquent au trafic d'IA.
- Composants :
Gateway,HTTPRoute,AIGatewayRoute,BackendTrafficPolicy. - Responsabilités : correspondance basée sur l'hôte, le chemin d'accès et l'en-tête, délais d'expiration adaptés aux générations longues, nouvelles tentatives, répartition pondérée du trafic et remplacement basé sur la priorité entre les backends.
- Interfaces : API Kubernetes.
- Composants :
- Observabilité : des métriques de requêtes, de latence et de jetons sont disponibles pour chaque modèle.
- Composants : journaux d'accès et statistiques du proxy Envoy, métriques du processeur externe (utilisation des jetons, durée de la requête, délai avant le premier jeton), métriques du sélecteur de point de terminaison.
- Responsabilités : exposer des métriques au format Prometheus et des journaux d'accès structurés que la pile d'observabilité GDC ou un Prometheus géré par le client peuvent scraper.
- Interfaces : points de terminaison de métriques Prometheus, journaux de sortie standard.
- Gestion des artefacts sous air gap : chaque image et chaque chart sont mis en préproduction dans Harbor avant l'installation.
- Composants : Harbor,
seed_registry.sh, comptes de robot, secrets d'extraction d'image, ressourceEnvoyProxy(image de proxy et secret d'extraction). - Responsabilités : amorcer des images et des charts Helm OCI à partir d'un poste de travail connecté, épingler des versions, afficher des charts hors connexion avec
helm template. - Interfaces : API de distribution OCI, API Kubernetes.
- Composants : Harbor,
Principes architecturaux
- Priorité aux normes : la passerelle est configurée via l'API Kubernetes Gateway et son extension d'inférence, et communique avec les applications via l'API compatible avec OpenAI. Ainsi, les applications, les routes et les backends restent portables entre les implémentations de passerelle.
- Priorité à la sécurité : tous les composants et toutes les données résident dans la limite de l'environnement isolé de GDC. La terminaison TLS se fait au niveau de
Gateway, les identifiants de backend sont injectés par la passerelle et l'accès au réseau est limité avec les objetsNetworkPolicyetProjectNetworkPolicy. - Souveraineté des données : les requêtes, les réponses, les pondérations de modèle et les données d'utilisation ne quittent jamais l'organisation GDC du client. Aucune connectivité externe n'est requise pour le fonctionnement.
- Séparation des responsabilités : l'API Gateway orientée rôles permet à l'administrateur de la plate-forme de posséder les ressources
GatewayClass,Gateway, TLS et les règles de réseau, tandis que les équipes d'application possèdent leurs ressourcesAIGatewayRoute,AIServiceBackendetInferencePooldans leurs propres espaces de noms. - Plans de contrôle et de données dissociés : les contrôleurs ne font que traduire la configuration. Le chemin de la requête se compose du proxy Envoy, de son side-car de processeur externe et du sélecteur de point de terminaison, qui continuent de diffuser le trafic si un contrôleur redémarre.
- Ouverte et flexible : l'architecture utilise des logiciels Open Source (Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension, Ollama, vLLM) et les mêmes ressources de l'API Gateway peuvent être diffusées par d'autres implémentations.
- Évolutivité et performances : le plan de données évolue horizontalement en ajoutant des instances répliquées de proxy et verticalement en ajustant le processeur et la mémoire. L'équilibrage de charge compatible avec le serveur de modèles maintient les GPU saturés sans surcharger les instances répliquées individuelles.
- Expérience utilisateur final simplifiée : un seul point de terminaison, un seul format d'API et un seul identifiant pour chaque modèle raccourcissent le chemin entre le déploiement du modèle et sa consommation.
- Résilience : les vérifications d'état et la réplication Kubernetes, les nouvelles tentatives Envoy et le remplacement basé sur la priorité entre les backends permettent de maintenir la disponibilité du point de terminaison en cas d'échec des instances répliquées de modèle individuelles.
Remarques
- Évolutivité et performances :
- Les composants de la passerelle sont des charges de travail CPU uniquement. Le
Deploymentdu proxy Envoy d'unGatewayévolue horizontalement en augmentant le nombre d'instances répliquées (ressourceEnvoyProxy) et verticalement en augmentant les demandes de CPU et de mémoire. L'inspection du corps par le processeur externe consomme du processeur proportionnellement à la taille de la requête et de la réponse. Les réponses diffusées en streaming sont traitées de manière incrémentielle. - L'équilibrage de charge tenant compte du serveur de modèles ne s'applique qu'aux backends associés en tant que
InferencePool. Les backends associés en tant queAIServiceBackendsont équilibrés par le proxy sur les points de terminaison de leurService. - La passerelle n'ajoute pas de capacité de GPU : le débit et la latence sont limités par les serveurs de modèles. Dimensionnez les déploiements de modèles à l'aide de l'ensemble de guides complémentaires (vLLM pour un débit élevé, Ollama pour une utilisation facile et une évaluation basée uniquement sur le processeur).
- Les générations longues nécessitent des délais avant expiration des requêtes et d'inactivité plus longs que les API HTTP standards. Configurez-les sur les routes et les règles plutôt que sur les clients.
- Les composants de la passerelle sont des charges de travail CPU uniquement. Le
- Gestion des ressources :
- Tous les composants de la passerelle s'exécutent sur des nœuds de processeur et ne nécessitent aucun accélérateur. Le tableau suivant indique les tailles indicatives pour un déploiement fonctionnel. L'implémentation de référence définit les requêtes et les limites exactes. Les valeurs de production dépendent du taux de demandes et de la taille des charges utiles.
- Le tableau de ports suivant répertorie tous les ports que les règles de réseau doivent accepter.
- La planification des GPU appartient aux déploiements de modèles : les noms des ressources d'accélérateur sont découverts à partir des nœuds, comme décrit dans l'ensemble de guides d'accompagnement.
Dimensionnement indicatif des composants de la passerelle (CPU uniquement)
| Composant | Instances répliquées | CPU (demande) | Mémoire (demande) | Remarques |
|---|---|---|---|---|
| Contrôleur Envoy Gateway | 1 | 100 M à 500 M | 256 Mio à 1 Gio | Plan de contrôle ; pas dans le chemin de la requête |
| Contrôleur de routeur d'agent Envoy | 1 | 100 M à 500 M | 256 Mi à 512 Mi | Plan de contrôle et serveur d'extension |
Proxy Envoy Pod (proxy + side-car de processeur externe) |
1 à 2 par Gateway |
500 m–2 | 512 Mio à 2 Gio | Effectuer un scaling en fonction du taux de demandes et de la taille de la charge utile |
| Sélecteur de point de terminaison | 1 par InferencePool |
100 M à 500 M | 256 Mi à 512 Mi | Scrape les métriques du serveur de modèles |
| Service de limitation du débit (facultatif) | 1 | 100 M à 500 M | 256 Mi à 512 Mi | Uniquement avec la limitation du débit globale |
| Redis (facultatif) | 1 | 100 M à 500 M | 256 Mio à 1 Gio | Uniquement avec la limitation du débit globale |
ses ports réseau ;
| Port | Composant | Objectif |
|---|---|---|
| 80 / 443 | Proxy Envoy (Gateway écouteurs) |
Point d'entrée HTTP/HTTPS sur l'adresse IP virtuelle LoadBalancer |
| 1063 | Contrôleur de routeur de l'agent Envoy (serveur d'extension) | Appels gRPC depuis le gestionnaire d'extensions Envoy Gateway |
| 9002 | Sélecteur de point de terminaison | Appels gRPC ext_proc depuis le proxy Envoy |
| 6379 | Redis | Compteurs de limitation du débit |
| 8000 | vLLM | API et métriques compatibles avec OpenAI du serveur de modèles |
| 11434 | Ollama | API compatible avec Ollama et OpenAI du serveur de modèles |
- Disponibilité et fiabilité :
- Le proxy et le processeur externe s'exécutent dans le même
Pod. Plusieurs instances répliquées derrière leServiceLoadBalancermasquent les défaillances individuelles dePod, et les contrôleurs peuvent redémarrer sans interrompre le trafic. - Les règles
AIGatewayRoutepeuvent lister plusieurs backends avec des priorités, de sorte que la passerelle bascule vers un autre ensemble d'instances répliquées ou un autre serveur de modèles lorsqu'un backend n'est pas opérationnel. - Le sélecteur de point de terminaison est un
Deploymentpar pool. S'il n'est pas disponible, les requêtes adressées à ceInferencePooléchouent jusqu'à ce qu'il soit de nouveau disponible. Exécutez-le avec des requêtes de ressources et des vérifications d'aptitude, et surveillez-le comme un composant du plan de données. - Redis ne contient que des compteurs de limitation du débit. Une panne de Redis affecte la limitation du débit, pas le routage.
- Le proxy et le processeur externe s'exécutent dans le même
- Complexité opérationnelle :
- Alignement des versions entre Envoy Gateway, Envoy Agent Router et l'extension d'inférence de l'API Gateway : mettez à niveau les trois ensemble avec la combinaison testée (Envoy Gateway 1.8.4, Envoy Agent Router 1.1.0, extension d'inférence de l'API Gateway 1.5.0).
- Cycle de vie sous air gap : chaque image et chaque chart sont réinjectés dans Harbor pour chaque mise à niveau. La ressource
EnvoyProxyet les valeurs du chart épinglent le registre et le secret d'extraction. - Deux couches de configuration :
GatewayClass/Gateway/EnvoyProxyappartenant à la plate-forme etAIGatewayRoute/AIServiceBackend/InferencePoolappartenant à l'équipe. L'intégration d'un nouveau modèle implique l'ajout d'une règle de routage et d'un backend, et non d'une nouvelle passerelle. - Surveillance : taux de demandes, latence (y compris le délai d'émission du premier jeton), utilisation des jetons par modèle et par consommateur, notation du sélecteur de point de terminaison et utilisation des GPU des serveurs de modèles.
InferenceObjectiveest toujours une API alpha (v1alpha2). Attendez-vous à des modifications de schéma entre les versions de l'extension d'inférence.
- Sécurité et conformité :
- La solution complète fonctionne dans le périmètre de sécurité isolé de GDC.
- Les règles de réseau sont obligatoires : un espace de noms
NetworkPolicyautorise le trafic du proxy vers les ports du serveur de modèles (8000, 11434) et vers le sélecteur de points de terminaison (9002), et unProjectNetworkPolicyautorise le trafic client vers l'adresse IP virtuelleLoadBalancerlorsque les clients résident en dehors du projet. - TLS se termine au niveau de
Gatewayavec un certificat stocké dans unSecretKubernetes. Les clients ne voient que le point de terminaison de la passerelle. - Les identifiants en amont (par exemple, une clé API requise par un serveur de modèles) sont stockés dans des
Secretréférencés par unBackendSecurityPolicyet injectés par la passerelle. Ainsi, les applications ne détiennent jamais d'identifiants de backend. - La limitation du débit basée sur les jetons limite la consommation de la capacité de GPU coûteuse par consommateur ou par modèle.
- Les comptes de robot Harbor et les secrets d'extraction d'images Kubernetes garantissent un accès sécurisé aux images de conteneurs. Le RBAC de l'API Gateway orienté rôles sépare les responsabilités de la plate-forme et de l'application.
Décisions de conception
Les décisions de conception clés suivantes ont été prises pour cette architecture de référence :
Décision 1 : Implémentation de la passerelle d'IA : Envoy Agent Router Open Source sur Envoy Gateway par rapport aux distributions alternatives
| Contexte | Décision clé | Explication |
|---|---|---|
| La passerelle d'IA est le principal choix architectural, avec des alternatives viables, des options Open Source autogérées aux offres commerciales : (a) Envoy Agent Router sur Envoy Gateway (Open Source), (b) kgateway et agentgateway (implémentations d'API Gateway Open Source qui gèrent également le trafic des fournisseurs de LLM, les outils MCP et la communication d'agent à agent dans un seul plan de données, éventuellement avec l'assistance du fournisseur solo.io), (c) Solo Enterprise pour agentgateway en tant qu'option premium commercialement prise en charge. | L'implémentation de référence utilise le routeur d'agent Envoy Open Source sur Envoy Gateway. Les alternatives restent des choix valides derrière les mêmes ressources de l'API Gateway. Une distribution bénéficiant d'une assistance commerciale est recommandée pour les environnements de production qui nécessitent une assistance dédiée de la part du fournisseur. | Avantages de l'open source : routage L7 léger, conforme aux normes et hautes performances, sans frais de licence, idéal pour évaluer la solution avant de s'engager dans une offre payante. Envoy Agent Router est l'option validée dans cet ensemble de guides. Inconvénients de l'open source : l'assistance est fournie dans la mesure du possible par l'équipe Solutions et est gérée par la communauté, ce qui peut ne pas convenir aux environnements de production principaux. Avantages premium : formules d'assistance Enterprise pour le cycle de vie de la passerelle et, souvent, capacités agentiques avancées. Inconvénients des solutions premium : contrat de licence ou d'assistance payant et relation supplémentaire avec un fournisseur. |
Décision 2 : API Kubernetes Gateway avec l'extension d'inférence par rapport à Ingress ou à une API de passerelle propriétaire
| Contexte | Décision clé | Explication |
|---|---|---|
| Les points de terminaison d'inférence peuvent être exposés avec l'ancienne API Ingress, un format de configuration spécifique à la passerelle ou l'API Kubernetes Gateway. L'équilibrage de charge basé sur les modèles nécessite également un moyen de décrire les pools de serveurs de modèles et leurs priorités. | La solution est standardisée sur l'API Kubernetes Gateway (GatewayClass, Gateway, routes) implémentée par Envoy Gateway, et sur l'extension d'inférence de l'API Gateway (InferencePool, InferenceObjective, Endpoint Picker) pour le routage basé sur les modèles. |
L'API Gateway est la norme Kubernetes qui succède à Ingress. Elle est orientée rôles (équipes de plate-forme et d'application) et portable entre les implémentations. L'extension d'inférence est la norme de la communauté pour le routage tenant compte du serveur de modèles (profondeur de file d'attente, cache KV, priorités) et est compatible avec Envoy Agent Router sans configuration supplémentaire. Les autres distributions de passerelle implémentent les mêmes API, ce qui permet de revenir sur la décision 1. |
Décision 3 : Routage basé sur le corps sur le champ model des requêtes compatibles avec OpenAI en tant que point de terminaison unifié
| Contexte | Décision clé | Explication |
|---|---|---|
Les applications peuvent s'adresser aux modèles via un point de terminaison par modèle (basé sur l'hôte ou le chemin d'accès), via un en-tête personnalisé défini par le client ou via le champ model que chaque requête compatible avec OpenAI contient déjà. |
La passerelle expose un point de terminaison compatible avec OpenAI et effectue le routage sur le champ model : le processeur externe l'extrait dans l'en-tête x-ai-eg-model et les règles AIGatewayRoute correspondent à cet en-tête. |
Les clients et SDK compatibles avec OpenAI existants fonctionnent sans modification et changent de modèle en modifiant une chaîne. Les points de terminaison, les identifiants et l'emplacement du modèle peuvent changer sans toucher aux applications. Les mêmes règles peuvent mapper un nom de modèle à plusieurs backends pour la répartition du trafic, le remplacement ou le remplacement du nom du modèle. |
Décision 4 : Ensemencement d'artefacts sous air gap dans Harbor par rapport aux extractions à la demande
| Contexte | Décision clé | Explication |
|---|---|---|
| L'installation en amont extrait des images de conteneurs de registres publics et des charts Helm en tant qu'artefacts OCI à la demande, ce qui est impossible dans un environnement sous air gap. | Toutes les images de conteneur (proxy Envoy, Envoy Gateway, contrôleur et processeur externe Envoy Agent Router, service de limitation du débit, Endpoint Picker, Redis) et les charts Helm Envoy Gateway et Envoy Agent Router sont insérés dans un projet Harbor avec seed_registry.sh (crane). Les charts sont affichés hors connexion avec helm template depuis Harbor, et la ressource EnvoyProxy et les valeurs des charts épinglent le registre Harbor et le secret d'extraction. |
Une étape d'amorçage reproductible et vérifiable par version ; le cluster n'a jamais besoin de connectivité externe ; l'épinglage de version rend les mises à niveau explicites et réversibles. |
Décision 5 : Limitation facultative du débit basée sur des jetons avec Redis par rapport aux limites basées sur les requêtes uniquement
| Contexte | Décision clé | Explication |
|---|---|---|
| La capacité du GPU est consommée par jeton, et non par requête. Une limite du nombre de requêtes ne peut pas protéger un modèle partagé contre quelques requêtes très volumineuses ou de longues générations. La limitation globale du débit dans Envoy Gateway nécessite un magasin de compteurs partagé. | La limitation du débit basée sur les jetons est une fonctionnalité facultative de l'architecture : le processeur externe enregistre les jetons d'entrée, de sortie et totaux par requête (llmRequestCosts), un BackendTrafficPolicy applique le budget et une instance Redis (Redis 8.10, déployée dans le cluster ou une instance existante) stocke les compteurs. Les déploiements sans limitation du débit n'ont pas besoin de Redis. |
L'utilisation est mesurée dans l'unité qui reflète le coût, les budgets sont appliqués de manière cohérente sur toutes les instances répliquées du proxy, et la dépendance n'est payée que par les clients qui ont besoin de quotas. |
Décision 6 : Topologie : plan de contrôle et de données de la passerelle dans un espace de noms dédié d'un cluster standard, modèles dans les espaces de noms d'application
| Contexte | Décision clé | Explication |
|---|---|---|
| La passerelle peut s'exécuter dans un cluster dédié, dans chaque espace de noms d'application ou une fois par cluster standard à côté des modèles qu'elle gère. Les modèles à pondération ouverte sur GDC sous air gap sont déployés dans des clusters standards (ensemble de guides d'accompagnement). | Le plan de contrôle Envoy Gateway et Envoy Agent Router, ainsi que le plan de données du proxy Envoy s'exécutent dans un espace de noms dédié du cluster standard qui héberge les modèles. AIGatewayRoute, AIServiceBackend, InferencePool et les déploiements de modèles résident dans les espaces de noms de l'application et sont référencés dans les espaces de noms. |
Les requêtes restent dans le réseau du cluster entre le proxy et les Pod du modèle (latence la plus faible, pas d'équilibreurs de charge supplémentaires), l'administrateur de la plate-forme est propriétaire de l'espace de noms de la passerelle, tandis que les équipes d'application sont propriétaires de leurs routes et modèles, et le sélecteur de point de terminaison peut scraper directement les serveurs de modèles. Une passerelle client par projet qui transfère vers une passerelle de serveur centralisée reste une extension de cette topologie pour la consommation multiprojets. |
Hypothèses et limites
- L'environnement GDC sous air gap 1.16.2-hf1 ou version ultérieure est disponible avec un cluster standard qui exécute Kubernetes v1.32.13-gke.400 ou version ultérieure.
- Des ressources matérielles suffisantes (en particulier des GPU) sont présentes pour les backends de mise en service du modèle. Les composants de la passerelle eux-mêmes s'exécutent sur des nœuds de processeur. Les modèles réels ont besoin de GPU. Les petits modèles sur Ollama peuvent s'exécuter sur un processeur uniquement pour une évaluation fonctionnelle.
- L'instance Harbor est configurée et accessible, et un poste de travail disposant d'un accès à Internet et d'une connectivité à l'environnement GDC (API Harbor et Kubernetes) est disponible pour l'amorçage des images et des charts.
- Les utilisateurs disposent des autorisations nécessaires : rôles de projet "Lecteur d'instance Harbor" et "Administrateur de cluster standard", ainsi qu'un
StandardClusterRoleBindingau rôlecluster-adminsur le cluster standard pour l'installation au niveau du cluster (CRD,GatewayClass, espaces de noms). Consultez l'implémentation de référence. - Les backends de mise en service du modèle exposent une API compatible avec OpenAI. Les backends associés en tant que
InferencePoolexposent également les métriques compatibles avec vLLM sur lesquelles repose le sélecteur de point de terminaison. - Limitation : l'assistance pour les composants Open Source (Envoy Gateway, Envoy Agent Router, Gateway API Inference Extension) est fournie dans la mesure du possible par l'équipe Solutions. L'assistance dédiée du fournisseur nécessite une distribution commercialement compatible (décision 1).
- Limitation :
InferenceObjectiveest une API alpha (inference.networking.x-k8s.io/v1alpha2) et peut changer entre les versions de l'extension d'inférence. - Limitation : une adresse IP virtuelle
LoadBalancerpour l'Gatewayet unProjectNetworkPolicysont requis pour les clients en dehors du projet. Dans le projet, les clients du cluster oukubectl port-forwardpeuvent accéder directement à la passerelleService. - Limitation : Gemini sur GDC, l'ajustement des modèles, les modèles d'IA générative non LLM et la mise en service de modèles multinœuds ne sont pas inclus dans cette version de la solution.
Parcours utilisateur
Voici un parcours utilisateur complet pour la passerelle d'IA sur GDC sous air gap : d'abord le chemin de requête sur lequel s'appuie un développeur d'applications, puis le chemin de configuration que suit l'administrateur de la plate-forme.
1. Chemin d'accès de la requête du développeur
Une application ou un agent n'a besoin que du point de terminaison de la passerelle, d'un identifiant client si la passerelle en applique un, et du nom du modèle.
- Envoyer la requête : l'application appelle
POST /v1/chat/completionssur le point de terminaison de la passerelle avec un corps JSON compatible avec OpenAI qui nomme le modèle (par exemple,"model": "gemma"), exactement comme elle appellerait n'importe quel service compatible avec OpenAI. - Entrée dans la passerelle : la requête atteint l'adresse IP virtuelle
LoadBalancerdeGateway. Le proxy Envoy met fin au protocole TLS et met en correspondance l'écouteur et la route. - Traiter le corps : le proxy transmet la requête au processeur externe Envoy Agent Router, qui analyse le corps, extrait le nom du modèle dans l'en-tête
x-ai-eg-modelet traduit la charge utile vers le schéma du backend s'il est différent. - Sélectionner le backend : la règle
AIGatewayRoutequi correspond au nom du modèle sélectionne unAIServiceBackend(par exemple, OllamaService) ou unInferencePool(par exemple, un ensemble d'instances répliquées vLLM). Pour unInferencePool, le sélecteur de point de terminaison choisit l'instance répliquée avec la file d'attente la plus courte et la meilleure correspondance de cache KV. - Transférer et répondre : le proxy injecte les identifiants en amont lorsqu'une
BackendSecurityPolicys'applique, transfère la requête auPodchoisi, renvoie la réponse en streaming et permet au processeur externe d'enregistrer l'utilisation des jetons, ce qui alimente les métriques et, lorsqu'elle est configurée, la limitation du débit basée sur les jetons. - Changer de modèle : pour utiliser un autre modèle, le développeur modifie la chaîne
model. Aucun nouveau point de terminaison, identifiant ou bibliothèque cliente n'est nécessaire.
2. Parcours de configuration de l'administrateur de plate-forme
- Amorcer des artefacts dans Harbor : créez les comptes de robot Harbor, puis copiez les images de conteneur et les charts Helm Envoy Gateway et Envoy Agent Router dans Harbor avec
seed_registry.shdepuis un poste de travail disposant d'un accès à Internet. - Installer Envoy Gateway : affichez les graphiques CRD et de contrôleur depuis Harbor avec
helm templateet appliquez-les dans l'espace de noms de la passerelle. Créez la ressourceEnvoyProxyqui épingle l'image du proxy et le secret d'extraction, puis vérifiez le contrôleur avec unGatewayClass, unGatewayet unHTTPRoutede base. - Installer Envoy Agent Router : installez les CRD Envoy Agent Router et les CRD de l'extension d'inférence de l'API Gateway, déployez le contrôleur Envoy Agent Router et reconfigurez Envoy Gateway pour appeler son serveur d'extension (port 1063) et accepter les backends
InferencePool. Vous pouvez également déployer Redis et activer le service de limitation de débit global. - Exposer la passerelle : créez la
GatewayClasset laGatewayavec des écouteurs HTTP et HTTPS (certificat TLSSecret), attendez l'adresse IP virtuelleLoadBalanceret appliquez laProjectNetworkPolicypour les clients en dehors du projet. - Associer des modèles : déployez les backends de mise en service du modèle avec l'ensemble de guides d'accompagnement, puis créez des ressources
AIServiceBackendpour lesServicecompatibles avec OpenAI etInferencePool, ainsi que des ressources de sélecteur de point de terminaison pour les ensembles d'instances répliquées compatibles avec vLLM, ainsi que les objets d'espace de nomsNetworkPolicy. - Publier la route : créez l'objet
AIGatewayRouteavec une règle par nom de modèle (routage basé sur le corps) et, si nécessaire, les objetsBackendSecurityPolicyetBackendTrafficPolicypour les identifiants en amont et les budgets de jetons. - Valider et utiliser : appelez
/v1/modelset/v1/chat/completionsvia l'adresse IPV (ou une solution de remplacementkubectl port-forward), vérifiez les métriques du proxy, du processeur externe et du sélecteur de point de terminaison, puis transmettez les noms du point de terminaison et du modèle aux équipes de l'application. Faites évoluer les instances répliquées du proxy et les déploiements de modèles indépendamment. Mettez à niveau Envoy Gateway, Envoy Agent Router et l'extension d'inférence ensemble.
La procédure détaillée est décrite dans l'implémentation de référence du routeur d'agent Envoy et dans le guide de l'utilisateur du routage basé sur le corps avec le routeur d'agent Envoy.
Autres ressources
- Implémentation de référence du routeur de l'agent Envoy
- Routage basé sur le corps avec le guide de l'utilisateur d'Envoy Agent Router
- Architecture de référence des LLM à pondération ouverte
- Documentation sur Envoy Agent Router
- Passerelle Envoy
- API Kubernetes Gateway
- Extension d'inférence de l'API Gateway
- Documentation de Google Distributed Cloud sous air gap