


Ce document décrit la hiérarchie des ressources Google Distributed Cloud (GDC) sous air gap et la manière dont les ressources sont gérées dans une instance sous air gap. Pour en savoir plus sur la gestion des ressources dans plusieurs zones, consultez la présentation des déploiements multizones.
La hiérarchie des ressources GDC a deux objectifs :
- Fournir une hiérarchie de propriété, qui lie le cycle de vie d'une ressource à son parent immédiat dans la hiérarchie
- Fournir des points de liaison et un héritage pour les stratégies de contrôle des accès et les règles d'administration
La hiérarchie des ressources GDC ressemble au système de fichiers des systèmes d'exploitation, qui permet d'organiser et de gérer des entités de manière hiérarchique. En règle générale, chaque ressource possède exactement un parent. Cette organisation hiérarchique des ressources vous permet de définir des stratégies de contrôle des accès, telles que Identity and Access Management (IAM), qui sont héritées par les ressources enfants.
Pour en savoir plus sur les bonnes pratiques d'organisation de vos limites d'accès, consultez Concevoir des limites d'accès entre les ressources.
Structure des ressources en détail
Les entités suivantes sont des types de ressources reconnus dans la hiérarchie des ressources GDC :
Les ressources GDC sont organisées de façon hiérarchique. La plupart des ressources de la hiérarchie des ressources ont exactement un parent. L'exception ne s'applique qu'à la ressource la plus élevée. Au niveau le plus bas de la hiérarchie, les ressources de service sont les composants fondamentaux sur lesquels reposent tous les services GDC.
Une organisation se trouve au sommet de la hiérarchie des ressources GDC. Toutes les ressources appartenant à une organisation sont regroupées sous la ressource d'organisation. Elle permet de bénéficier d'une visibilité et d'un contrôle centralisés sur chaque ressource appartenant à une organisation.
Les projets et les clusters Kubernetes partagés sont au niveau de l'organisation. Elles peuvent être associées les unes aux autres pour organiser les ressources de service. Toutefois, les projets et les clusters partagés fonctionnent indépendamment les uns des autres. Cette flexibilité offre de nombreuses options différentes pour organiser les services et les charges de travail. Par exemple, vous pouvez disposer d'un cluster partagé dédié à un seul projet. De même, un cluster partagé peut s'étendre sur plusieurs projets.
Les ressources de service sont des entités qui doivent appartenir à un projet et ne peuvent pas être partagées entre plusieurs projets. Les machines virtuelles (VM), les clusters Kubernetes standards, les bases de données, les buckets de stockage et les sauvegardes sont des exemples de ressources de service. La plupart de ces ressources de niveau inférieur ont pour parent des ressources de projet.
Le diagramme suivant présente un exemple de hiérarchie des ressources GDC :
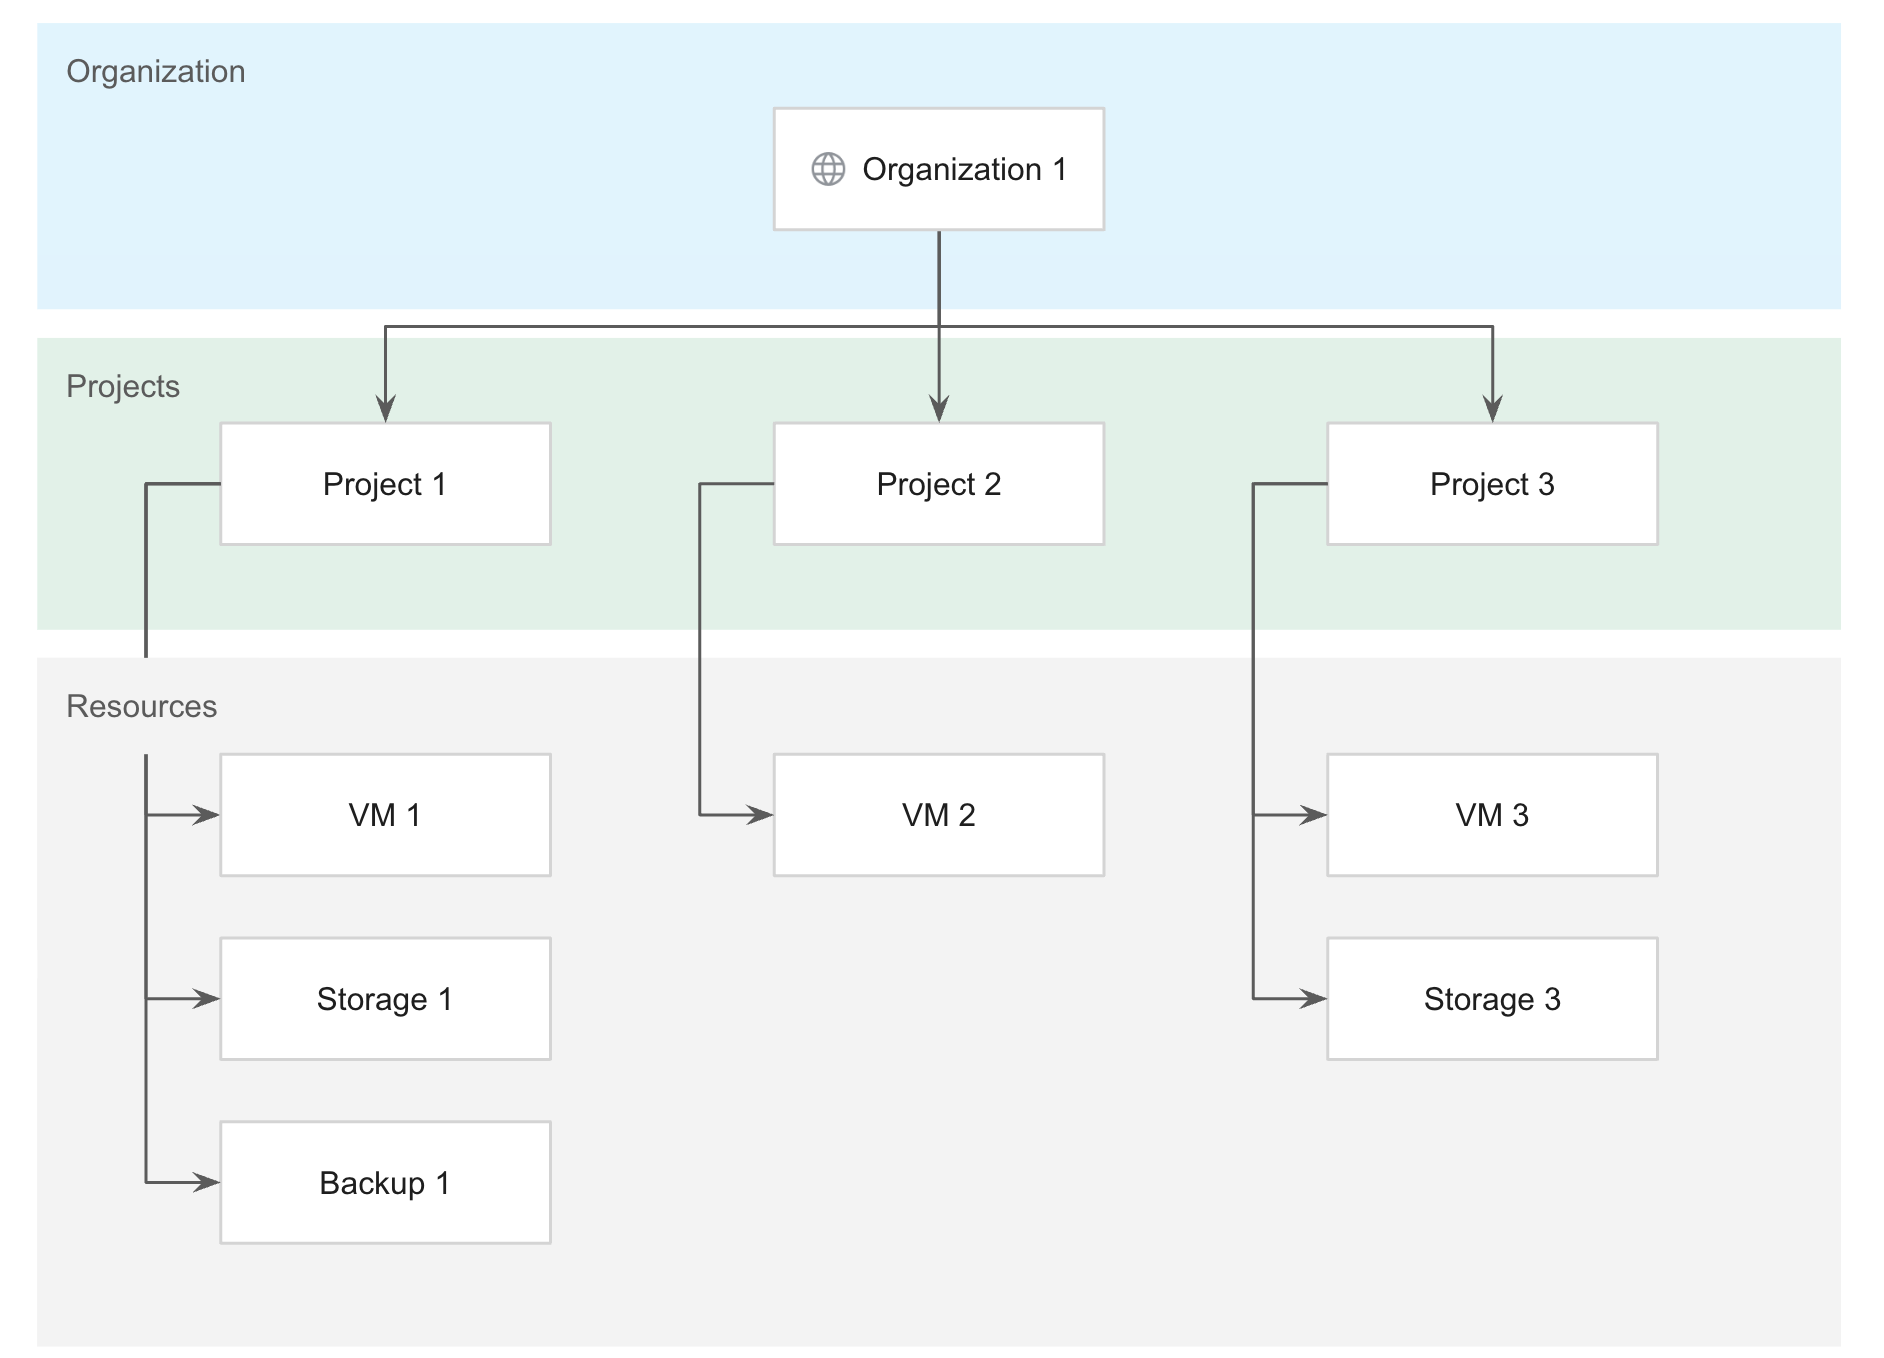
Pour en savoir plus sur les bonnes pratiques d'organisation de votre hiérarchie des ressources pour une gestion optimale des charges de travail, consultez Concevoir la séparation des charges de travail utilisateur.
Organisation
La ressource d'organisation représente une unité administrative ou une fonction commerciale, comme une entreprise. Elle constitue la ressource de premier niveau dans la hiérarchie des ressources GDC. Une organisation définit une limite de sécurité qui englobe les ressources d'infrastructure à administrer ensemble afin que les utilisateurs puissent déployer des charges de travail d'application. Les organisations sont mondiales et couvrent toutes les zones d'un univers. Dans une organisation, les ressources de service telles que les VM et les volumes de stockage sont regroupées de manière logique par projets.
Tous les projets, clusters et ressources de service appartiennent à votre organisation, et non à leurs créateurs. Cela signifie qu'aucun type de ressource d'une organisation n'est supprimé si l'utilisateur qui l'a créé quitte l'organisation. Au lieu de cela, tous les types de ressources suivent le cycle de vie de l'organisation dans GDC.
Les stratégies de contrôle des accès IAM appliquées à la ressource d'organisation s'appliquent à l'ensemble de la hiérarchie sur toutes les ressources de l'organisation. Pour en savoir plus sur l'attribution de stratégies et d'autorisations à l'échelle de l'organisation, consultez les sections Règles d'administration et IAM.
Projet
Un projet est une unité de location que chaque service doit intégrer. Les projets permettent de regrouper logiquement les ressources de service. Les projets sont mondiaux et couvrent toutes les zones d'un univers.
Les projets permettent de segmenter les ressources de service au sein d'une organisation et fournissent une limite de cycle de vie et de règles pour la gestion des ressources. Les ressources de service au sein d'un projet ne peuvent jamais survivre au projet lui-même ni être déplacées d'un projet à un autre. Il est donc possible de contrôler une ressource pendant toute sa durée de vie. Par conséquent, vous devez déployer des ressources de tout type dans un espace de noms de projet.
Un projet est considéré comme un espace de noms Kubernetes approprié qui s'étend sur plusieurs clusters partagés d'une organisation. L'uniformité d'espace de noms considère tous les espaces de noms portant un nom donné comme le même espace de noms pour tous les clusters partagés au sein d'une même organisation. L'espace de noms unique a un propriétaire cohérent pour l'ensemble des clusters partagés. Les fournisseurs de services créent des services au niveau du projet en créant des composants de plan de contrôle et de plan de données dans l'espace de noms.
L'espace de noms d'un projet héberge les éléments suivants :
- API de service au niveau du projet
- Configurations des règles au niveau du projet, telles que les rôles et les liaisons de rôle
Vous ne pouvez associer un projet qu'à un sous-ensemble de clusters partagés dans une organisation. Vous pouvez déployer des charges de travail conteneurisées sur ces clusters partagés dans un espace de noms de projet. Le concept d'uniformité d'espace de noms s'applique à l'espace de noms du projet sur ces clusters partagés. Les règles au niveau de l'espace de noms, telles que les règles d'accès basé sur les rôles (RBAC), s'appliquent à tous ces espaces de noms.
Pour en savoir plus sur les projets, consultez la présentation des projets.
Cluster Kubernetes partagé
Un cluster Kubernetes est un ensemble de nœuds qui exécutent des charges de travail conteneurisées dans le cadre de GKE sur GDC. Vous pouvez provisionner des clusters Kubernetes pour répondre aux exigences de calcul de vos applications.
Un cluster partagé est une configuration de cluster limitée à l'organisation, qui doit être associée à un ou plusieurs projets. Le cluster standard est une autre configuration de cluster qui ne fonctionne que dans un seul projet, mais qui est considérée comme une ressource de service dans la hiérarchie des ressources. Ces configurations de cluster Kubernetes sont conçues pour créer une architecture Kubernetes offrant des options de gestion des conteneurs dans les environnements de développement logiciel, par exemple pour les tests, le développement et la production. Pour en savoir plus sur les bonnes pratiques de séparation des charges de travail de conteneur, consultez Concevoir la séparation des charges de travail.
Pour en savoir plus sur les différents types de clusters dans GDC, consultez Configurations de clusters Kubernetes.
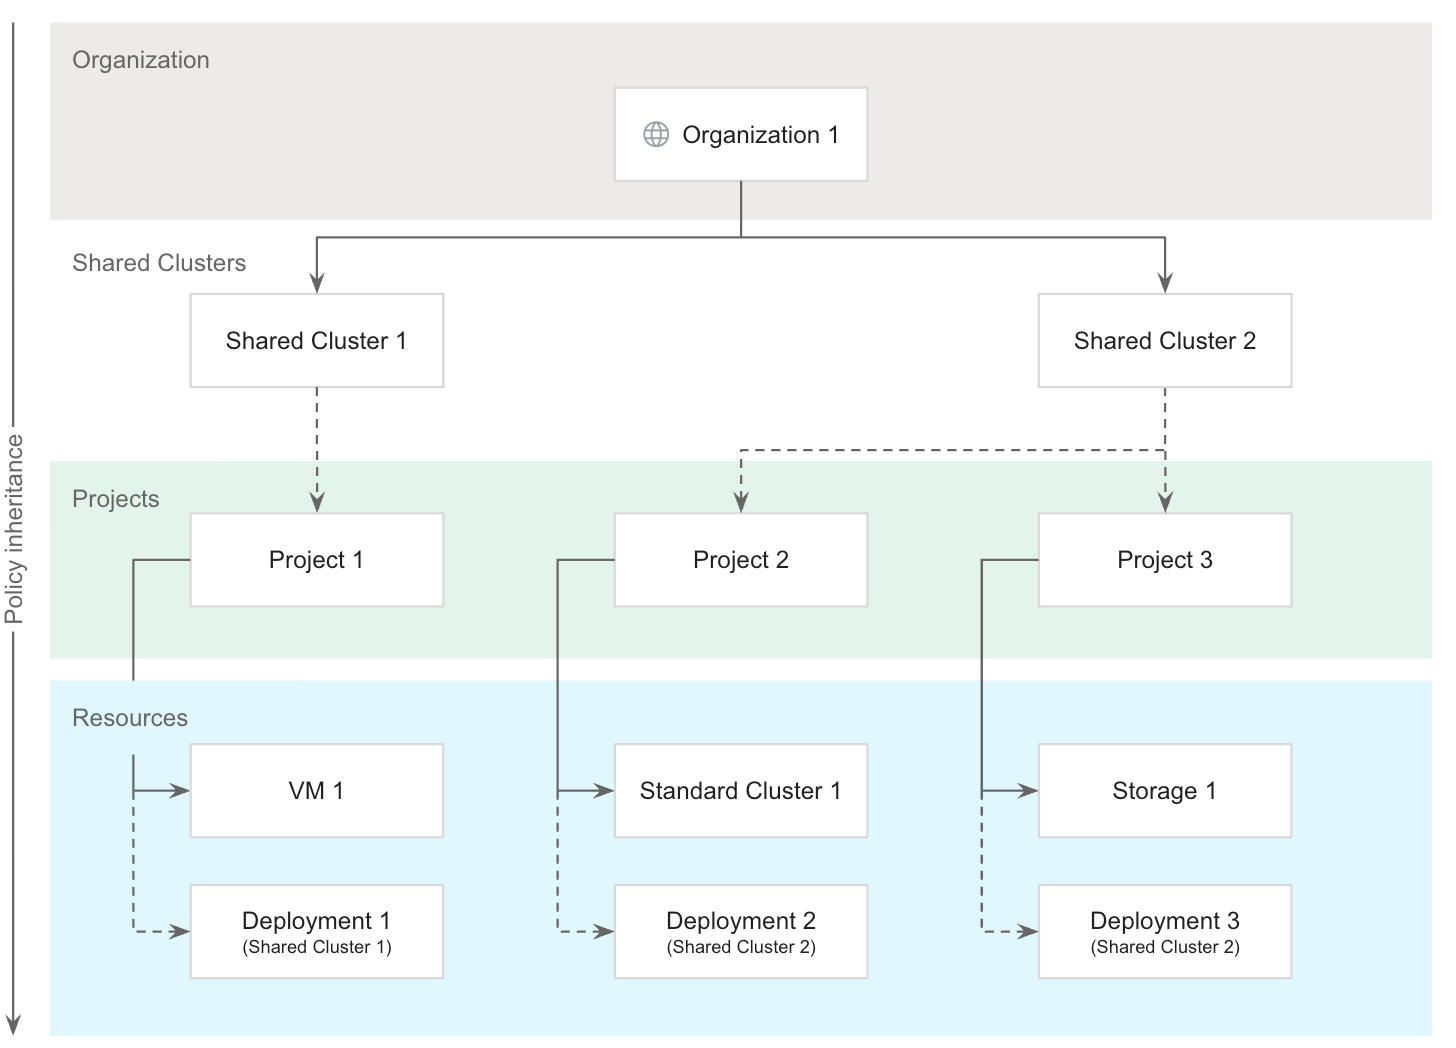
Les clusters partagés subdivisent les ressources d'infrastructure en pools isolés qui seront utilisés par les projets d'une organisation. Les clusters sont également séparés logiquement les uns des autres pour fournir différents domaines de défaillance et garanties d'isolation. L'application de règles par organisation garantit que les clusters partagés peuvent être partagés entre les équipes et les utilisateurs, tout en maintenant les garanties de performances et de ressources. De plus, les règles d'administration permettent aux charges de travail de VM de s'exécuter parallèlement aux charges de travail de conteneur sans introduire de complexité opérationnelle.
Les clusters sont utiles lorsque vous devez déployer des charges de travail conteneurisées. Toutefois, avec l'option de déploiement de charges de travail basées sur des VM, l'existence d'un cluster Kubernetes n'est pas requise dans GDC.
Les clusters sont des ressources zonales uniquement et ne peuvent pas s'étendre sur plusieurs zones. Pour exploiter des clusters dans un déploiement multizone, vous devez déployer manuellement des clusters dans chaque zone.
Pour en savoir plus sur les clusters Kubernetes, consultez Présentation des clusters Kubernetes.
Ressource de service
Les ressources de service incluent de nombreuses entités, telles que :
- VM
- Clusters Kubernetes standards
- Bases de données
- Buckets de stockage
- Charges de travail conteneurisées
- Sauvegardes
Les ressources de service doivent appartenir à un projet et ne peuvent pas être partagées entre plusieurs projets. Ce cycle de vie spécifique au projet signifie que les ressources de service au sein d'un projet ne peuvent jamais survivre au projet lui-même. Il est donc possible de contrôler une ressource pendant toute sa durée de vie.
Les ressources de service peuvent être déployées au niveau mondial ou zonal, selon leur type. Consultez la documentation du service concerné pour en savoir plus sur les options de déploiement multizone. Les ressources de service sont activées par défaut et peuvent être désactivées à l'aide d'une règle d'administration.