


Questa guida illustra il contesto concettuale necessario per eseguire il deployment di un workload basato su macchina virtuale (VM) in un cluster Google Distributed Cloud (GDC) con air gap su bare metal utilizzando un runtime VM. Il workload in questa guida è una piattaforma di sistema di emissione di biglietti di esempio disponibile su hardware on-premise.
Architettura
Gerarchia delle risorse
In GDC, esegui il deployment dei componenti che compongono il sistema di ticketing in un'organizzazione tenant dedicata per il team operativo, identica a qualsiasi organizzazione cliente. Un'organizzazione è una raccolta di cluster, risorse di infrastruttura e workload di applicazioni che vengono amministrati insieme. Ogni organizzazione in un'istanza GDC utilizza un insieme dedicato di server, garantendo un isolamento efficace tra i tenant. Per ulteriori informazioni sull'infrastruttura, consulta Progetta i confini di accesso.
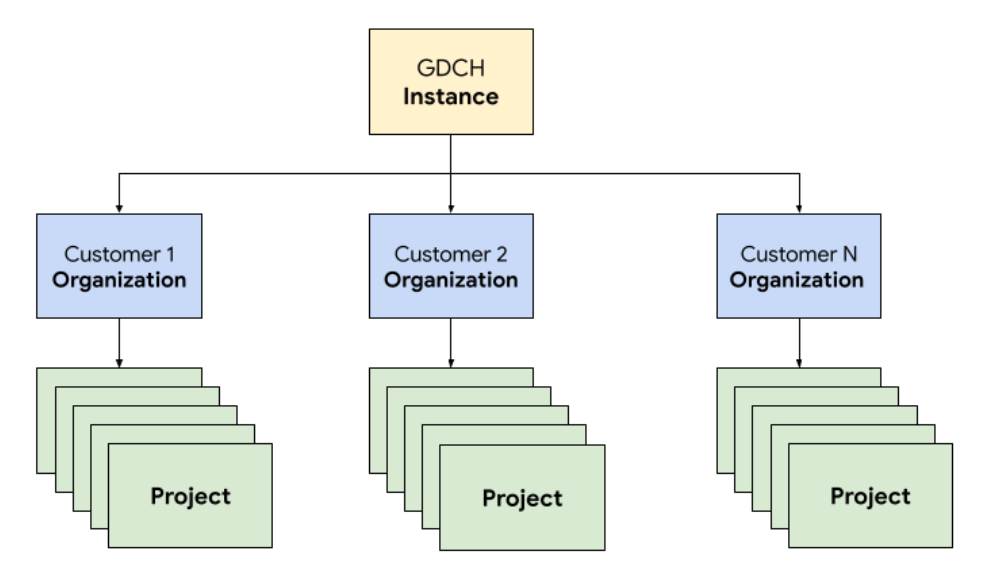
Inoltre, esegui il deployment e gestisci le risorse del sistema di ticketing insieme in un progetto, che fornisce l'isolamento logico all'interno di un'organizzazione utilizzando criteri e applicazione del software. Le risorse di un progetto hanno lo scopo di accoppiare i componenti che devono rimanere insieme per il loro ciclo di vita.
Il sistema di emissione dei biglietti segue un'architettura a tre livelli che si basa su un bilanciatore del carico per indirizzare il traffico tra i server delle applicazioni che si connettono a un server di database che archivia i dati persistenti.
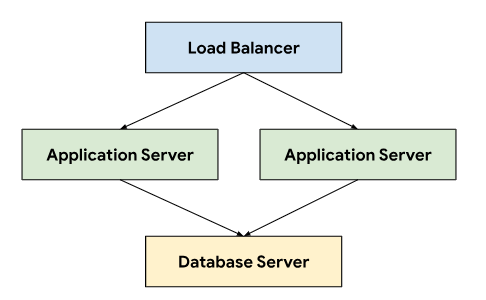
Questa architettura consente la scalabilità e la gestibilità, poiché ogni livello può essere sviluppato e gestito in modo indipendente. Inoltre, fornisce una chiara separazione delle responsabilità, semplificando il debug e la risoluzione dei problemi. L'incapsulamento di questi livelli all'interno di un progetto GDC ti consente di eseguire il deployment e gestire i componenti insieme, ad esempio i server di applicazioni e database.
Networking
L'esecuzione del sistema di ticketing in un ambiente di produzione richiede il deployment di due o più server applicazioni per ottenere un'alta affidabilità in caso di errore del nodo. In combinazione con un bilanciatore del carico, questa topologia consente anche di distribuire il carico su più macchine per scalare l'applicazione in orizzontale. La piattaforma Kubernetes-native di GDC utilizza Cloud Service Mesh per instradare in modo sicuro il traffico ai server delle applicazioni che compongono il sistema di emissione dei biglietti.
Cloud Service Mesh è un'implementazione di Google basata sul progetto open source che gestisce, osserva e protegge i servizi. Per ospitare il sistema di emissione di biglietti su GDC, vengono utilizzate le seguenti funzionalità di Cloud Service Mesh:
- Bilanciamento del carico: Cloud Service Mesh disaccoppia il flusso di traffico dalla scalabilità dell'infrastruttura, aprendo molte funzionalità di gestione del traffico, tra cui il routing dinamico delle richieste. Il sistema di emissione di biglietti richiede connessioni client persistenti, quindi attiviamo le sessioni fisse utilizzando
DestinationRulesper configurare il comportamento di routing del traffico.
Terminazione TLS: Cloud Service Mesh espone i gateway in entrata utilizzando i certificati TLS e fornisce l'autenticazione del trasporto all'interno del cluster tramite mTLS (Mutual Transport Layer Security) senza dover modificare il codice dell'applicazione.
Ripristino da errori: Cloud Service Mesh fornisce una serie di funzionalità critiche per il ripristino da errori, tra cui timeout, interruttori di sicurezza, controlli di integrità attivi e limitazione di nuovi tentativi.
All'interno del cluster Kubernetes, utilizziamo oggetti Service standard come modo astratto per esporre i server delle applicazioni e del database alla rete. I servizi forniscono un modo pratico per scegliere come target le istanze utilizzando un selettore e forniscono la risoluzione dei nomi all'interno del cluster utilizzando un server DNS sensibile al cluster.
apiVersion: v1
kind: Service
metadata:
  name: http-ingress
spec:
  selector:
    app.kubernetes.io/component: application-server
  ports:
  - name: http
    port: 80
---
apiVersion: v1
kind: Service
metadata:
  name: database-ingress
spec:
  selector:
    app.kubernetes.io/component: database-server
  ports:
  - name: mysql
    port: 3306
Computing
Il sistema di ticketing consiglia di utilizzare macchine bare metal o virtuali per ospitare le installazioni on-premise e abbiamo utilizzato la gestione delle macchine virtuali (VM) di GDC Virtual per eseguire il deployment dei server delle applicazioni e dei database come workload delle VM. La definizione delle risorse Kubernetes ci ha permesso di specificare sia VirtualMachine sia VirtualMachineDisk per personalizzare le risorse in modo da soddisfare le nostre esigenze per i diversi tipi di server. VirtualMachineExternalAccess ci consente di configurare il trasferimento di dati in entrata e in uscita per la VM.
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachineDisk
metadata:
  name: vm1-boot-disk
spec:
  size: 100G
  source:
    image:
      name: ts-ticketing-system-app-server-2023-08-18-203258
      namespace: vm-system
---
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachine
metadata:
  labels:
    app.kubernetes.io/component: application-server
  name: vm1
  namespace: support
spec:
  compute:
    vcpus: 8
    memory: 12G
  disks:
  - boot: true
    virtualMachineDiskRef:
      name: vm1-boot-disk

---
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachineExternalAccess
metadata:
  name: vm1
  namespace: support
spec:
  enabled: true
  ports:
   - name: ssh
     protocol: TCP
     port: 22
Per l'immagine sistema operativo guest, abbiamo creato un'immagine personalizzata per soddisfare i nostri requisiti di conformità e sicurezza. La connessione alle istanze VM in esecuzione è possibile tramite SSH utilizzando VirtualMachineAccessRequest, che ci consente di limitare la possibilità di connettersi alle VM tramite RBAC di Kubernetes ed evitare la necessità di creare account utente locali nelle immagini personalizzate. La richiesta di accesso definisce anche un
durata (TTL) che consente alle richieste di accesso basate sul tempo di gestire le VM che
scadono automaticamente.
Automazione
Come prodotto finale chiave di questo progetto, abbiamo progettato un approccio per installare istanze del sistema di ticketing in modo ripetibile, in grado di supportare un'automazione estesa e ridurre la deviazione della configurazione tra i deployment.
Pipeline di rilascio
La personalizzazione delle immagini del server dell'applicazione e del database inizia da un'immagine del sistema operativo di base, che viene modificata in base alle esigenze per installare le dipendenze necessarie per ogni immagine del server. Abbiamo selezionato un'immagine sistema operativo di base per la sua ampia adozione nell'hosting di sistemi di gestione dei ticket in installazioni on-premise. Questa immagine sistema operativo di base fornisce anche le funzionalità di rafforzamento della sicurezza necessarie per soddisfare le guide all'implementazione tecnica della sicurezza (STIG) necessarie per fornire un'immagine conforme che soddisfi i controlli NIST-800-53.
La nostra pipeline di integrazione continua (CI) ha utilizzato il seguente flusso di lavoro per personalizzare le immagini dei server di applicazioni e database:
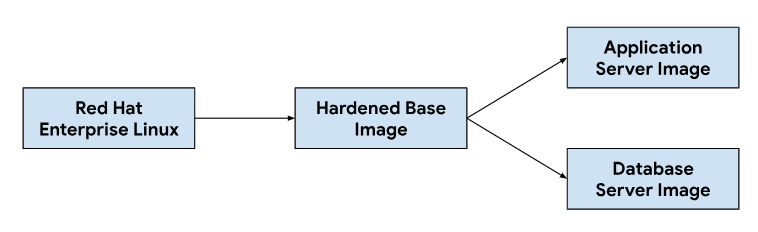
Quando gli sviluppatori apportano modifiche agli script di personalizzazione o alle dipendenze delle immagini, attiviamo un flusso di lavoro automatizzato nei nostri strumenti di CI per generare un nuovo set di immagini che vengono raggruppate con le release di GDC. Nell'ambito della creazione delle immagini, aggiorniamo anche le dipendenze del sistema operativo (yum update) e riduciamo le dimensioni dell'immagine con la compressione per ridurre le dimensioni dell'immagine necessarie per trasferire le immagini negli ambienti dei clienti.
Ciclo di vita dello sviluppo software
Il ciclo di vita dello sviluppo software (SDLC) è un processo che aiuta le organizzazioni a pianificare, creare, testare ed eseguire il deployment del software. Seguendo un SDLC ben definito, le organizzazioni si assicurano che il software venga sviluppato in modo coerente e ripetibile e identificano tempestivamente i potenziali problemi. Oltre a creare immagini nella nostra pipeline di integrazione continua (CI), abbiamo anche definito ambienti per sviluppare e preparare versioni di release pre-release del sistema di ticketing per i test e la garanzia di qualità.
Il deployment di un'istanza separata del sistema di ticketing per progetto GDC ci ha permesso di testare le modifiche in isolamento, senza influire sulle istanze esistenti nella stessa istanza GDC. Abbiamo utilizzato l'API ResourceManager per creare e rimuovere in modo dichiarativo i progetti utilizzando le risorse Kubernetes.
apiVersion: resourcemanager.gdc.goog/v1
kind: Project
metadata:
  name: ticketing-system-dev
---
apiVersion: resourcemanager.gdc.goog/v1
kind: Project
metadata:
  name: ticketing-system-qa
---
apiVersion: resourcemanager.gdc.goog/v1
kind: Project
metadata:
  name: ticketing-system-staging
In combinazione con il packaging dei grafici e la gestione dell'infrastruttura come le macchine virtuali sotto forma di codice, gli sviluppatori possono eseguire rapidamente l'iterazione apportando modifiche e testando nuove funzionalità insieme alle istanze di produzione. L'API dichiarativa consente inoltre ai framework di esecuzione dei test automatici di eseguire test di regressione regolari e verificare le funzionalità esistenti.
Operabilità
L'operabilità è la facilità con cui un sistema può essere gestito e mantenuto. È un aspetto importante nella progettazione di qualsiasi applicazione software. Un monitoraggio efficace contribuisce all'operabilità perché consente di identificare e risolvere i problemi prima che abbiano un impatto significativo sul sistema. Il monitoraggio può essere utilizzato anche per identificare opportunità di miglioramento e stabilire una base di riferimento per gli obiettivi del livello di servizio (SLO).
Monitoraggio
Abbiamo integrato il sistema di ticketing con l'infrastruttura di osservabilità GDC esistente, inclusi logging e metriche. Per le metriche, esponiamo gli endpoint HTTP di ogni VM che consente all'applicazione di eseguire lo scraping dei punti dati prodotti dai server dell'applicazione e del database. Questi endpoint includono metriche di sistema raccolte utilizzando l'esportatore di nodi dell'applicazione e metriche specifiche dell'applicazione.
Con gli endpoint esposti in ogni VM, abbiamo configurato il comportamento di polling dell'applicazione utilizzando la risorsa personalizzata MonitoringTarget per definire l'intervallo di scraping e annotare le metriche.
apiVersion: monitoring.gdc.goog/v1
kind: MonitoringTarget
metadata:
  name: database-monitor
spec:
  podMetricsEndpoints:
    path:
      value: /metrics
    port:
      annotation: application.io/dbMetrics
    scrapeInterval: 60s
Per il logging, abbiamo installato e configurato un processore di logging e metriche in ogni VM per seguire i log pertinenti e inviare i dati di log allo strumento di logging, dove i dati vengono indicizzati e interrogati tramite l'istanza di monitoraggio. Gli audit log vengono inoltrati a un endpoint speciale configurato con conservazione estesa per la conformità. Le applicazioni basate su container possono utilizzare la risorsa personalizzata LoggingTarget e
AuditLoggingTarget per indicare alla pipeline di logging di
raccogliere i log da servizi specifici nel tuo progetto.
In base ai dati disponibili nei processori di logging e monitoraggio, abbiamo creato avvisi utilizzando la risorsa personalizzata MonitoringRule, che ci consente di gestire questa configurazione come codice nel nostro pacchetto di grafici. L'utilizzo di un'API dichiarativa per definire avvisi e dashboard ci consente anche di archiviare questa configurazione nel nostro repository di codice e di seguire gli stessi processi di revisione del codice e integrazione continua su cui facciamo affidamento per qualsiasi altra modifica al codice.
Modalità di errore
I primi test hanno rivelato diverse modalità di errore relative alle risorse che ci hanno aiutato a stabilire la priorità delle metriche e degli avvisi da aggiungere per primi. Abbiamo iniziato monitorando l'utilizzo elevato di memoria e disco, poiché la configurazione errata del database inizialmente ha portato le tabelle buffer a consumare tutta la memoria disponibile e l'over-logging ha riempito il disco del volume permanente collegato. Dopo aver modificato la dimensione del buffer di archiviazione e implementato una strategia di rotazione dei log, abbiamo introdotto avvisi che vengono attivati se le VM si avvicinano a un utilizzo elevato della memoria o del disco.
apiVersion: monitoring.gdc.goog/v1
kind: MonitoringRule
metadata:
  name: monitoring-rule
spec:
  interval: 60s
  limit: 0
  alertRules:
  - alert: vm1_disk_usage
    expr:
      (node_filesystem_size_bytes{container_name="compute"} -
      node_filesystem_avail_bytes{container_name="compute"}) * 100 /
      node_filesystem_size_bytes{container_name="compute"} > 90
    labels:
      severity: error
      code: TS-R0001
      resource: vm1
    annotations:
      message: "vm1 disk usage above 90% utilization"
Dopo aver verificato la stabilità del sistema, abbiamo spostato l'attenzione sulle modalità di errore dell'applicazione all'interno del sistema di gestione dei ticket. Poiché il debug dei problemi all'interno dell'applicazione spesso richiedeva l'utilizzo di Secure Shell (SSH) in ogni VM del server applicazioni per controllare i log del sistema di ticketing, abbiamo configurato un'applicazione per inoltrare questi log allo strumento di logging per creare lo stack di osservabilità di GDC ed eseguire query su tutti i log operativi del sistema di ticketing nell'istanza di monitoraggio.
Il logging centralizzato ci ha anche permesso di eseguire query sui log di più VM contemporaneamente, consolidando la nostra visione di ogni componente del sistema.
Backup
I backup sono importanti per l'operatività di un sistema software perché consentono di ripristinarlo in caso di errore.
GDC offre il backup e il ripristino delle VM tramite le risorse Kubernetes. La creazione di una risorsa personalizzata VirtualMachineBackupRequest con una risorsa personalizzata VirtualMachineBackupPlanTemplate ci consente di eseguire il backup del volume permanente collegato a ogni VM nello spazio di archiviazione degli oggetti, dove i backup possono essere conservati in base a un criterio di conservazione impostato.
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachineBackupPlanTemplate
metadata:
  name: vm-backup-plan
spec:
  backupRepository: "backup-repository"
---
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachineBackupRequest
metadata:
  name: "db-vm-backup"
spec:
  virtualMachineBackupPlanTemplate: vm-backup-plan
  virtualMachine: db1
  virtualMachineBackupName: db-vm-backup
Analogamente, il ripristino dello stato di una VM dal backup comporta la creazione di una risorsa personalizzata VirtualMachineRestoreRequest per ripristinare i server delle applicazioni e del database senza modificare il codice o la configurazione di nessuno dei due servizi.
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachineRestoreRequest
metadata:
  name: vm-restore-1
spec:
  virtualMachineBackup: db-vm-backup
  restoreName: restore1
  restoredResourceName: db1
Upgrade
Per supportare il ciclo di vita del software del sistema di emissione dei biglietti e delle sue dipendenze, abbiamo identificato tre tipi di upgrade del software, ciascuno gestito singolarmente per ridurre al minimo i tempi di inattività e l'interruzione del servizio:
- Upgrade del sistema operativo.
- Upgrade della piattaforma, ad esempio patch e versioni principali.
- Aggiornamenti della configurazione.
Per gli upgrade del sistema operativo, creiamo e rilasciamo continuamente nuove immagini VM per i server di applicazioni e database che vengono distribuite con ogni release di GDC. Queste immagini contengono correzioni per le vulnerabilità della sicurezza e aggiornamenti al sistema operativo sottostante.
Gli upgrade della piattaforma del sistema di ticketing richiedono l'applicazione di aggiornamenti alle immagini VM esistenti, pertanto non possiamo fare affidamento su un'infrastruttura immutabile per eseguire l'applicazione di patch e gli aggiornamenti delle versioni di release principali. Per gli upgrade della piattaforma, testiamo e verifichiamo la versione della patch o la versione di release principale nei nostri ambienti di sviluppo e gestione temporanea prima di rilasciare un pacchetto di upgrade autonomo insieme alla release di GDC.
Infine, gli aggiornamenti della configurazione vengono applicati senza tempi di inattività tramite le API del sistema di ticketing per i set di aggiornamento e altri dati utente. Sviluppiamo e testiamo gli aggiornamenti della configurazione nei nostri ambienti di sviluppo e gestione temporanea prima di raggruppare più set di aggiornamenti durante il processo di release di GDC.
Integrazioni
Provider di identità
Per offrire ai clienti un percorso senza interruzioni e consentire alle organizzazioni di eseguire l'onboarding dei propri utenti, integriamo il sistema di ticketing con più provider di identità disponibili in GDC. In genere, i clienti aziendali e del settore pubblico dispongono di provider di identità ben gestiti per concedere e revocare i diritti ai propri dipendenti. A causa dei requisiti di conformità e della facilità di governance di identità e governance degli accessi, questi clienti vogliono utilizzare i propri provider di identità esistenti come fonte di verità per gestire l'accesso dei propri dipendenti al sistema di ticketing.
Il sistema di gestione dei ticket supporta i provider SAML 2.0 e OIDC tramite il suo modulo provider multi-identità, che abbiamo pre-abilitato nell'immagine VM del server applicazioni. I clienti si autenticano tramite il provider di identità della loro organizzazione, che crea automaticamente gli utenti e assegna i ruoli all'interno del sistema di ticketing.
Il traffico in uscita verso i server del provider di identità è consentito tramite la risorsa personalizzata ProjectNetworkPolicy, che limita la raggiungibilità dei servizi esterni da un'organizzazione in GDC. Queste policy ci consentono di controllare in modo dichiarativo gli endpoint a cui il sistema di ticketing può accedere sulla rete.
Importazione degli avvisi
Oltre a consentire agli utenti di accedere per creare manualmente richieste di assistenza, creiamo anche incidenti nel sistema di gestione dei ticket in risposta agli avvisi di sistema.
Per ottenere questa integrazione, abbiamo personalizzato un webhook Kubernetes open source per ricevere avvisi dall'applicazione e gestire il ciclo di vita degli incidenti utilizzando l'endpoint API del sistema di ticketing esposto tramite Cloud Service Mesh.
Le chiavi API vengono archiviate utilizzando l'archivio dei secret di GDC, supportato dai secret di Kubernetes controllati tramite controllo dell'accesso basato su ruoli (RBAC). Altre configurazioni, come gli endpoint API e i campi di personalizzazione degli incidenti, vengono gestite tramite lo spazio di archiviazione di coppie chiave-valore di Kubernetes ConfigMap.
Il sistema di ticketing offre integrazioni con i server di posta per consentire ai clienti di ricevere assistenza via email. I workflow automatizzati convertono le email dei clienti inbound in richieste di assistenza e inviano risposte automatiche ai clienti con i link alle richieste, consentendo al nostro team di assistenza di gestire meglio la posta in arrivo, monitorare e risolvere sistematicamente le richieste via email e fornire un servizio clienti migliore.
apiVersion: networking.gdc.goog/v1
kind: ProjectNetworkPolicy
metadata:
  name: allow-ingress-traffic-from-ticketing-system
spec:
  subject:
    subjectType: UserWorkload
  ingress:
  - from:
    - projects:
        matchNames:
        - ticketing-system
L'esposizione dell'email come servizio Kubernetes fornisce anche il Service Discovery e la risoluzione dei nomi di dominio, oltre a disaccoppiare ulteriormente il backend del server email da client come il sistema di gestione dei ticket.
Conformità
Audit logging
Gli audit log contribuiscono alla postura di conformità fornendo un modo per monitorare e controllare l'utilizzo del software e un record dell'attività del sistema. I log di controllo registrano i tentativi di accesso da parte di utenti non autorizzati, monitorano l'utilizzo delle API e identificano potenziali rischi per la sicurezza. Gli audit log soddisfano i requisiti di conformità, come quelli imposti dall'Health Insurance Portability and Accountability Act (HIPAA), dal Payment Card Industry Data Security Standard (PCI DSS) e dal Sarbanes-Oxley Act (SOX).
GDC fornisce un sistema per registrare le attività amministrative e gli accessi all'interno della piattaforma e conservare questi log per un periodo di tempo configurabile. Il deployment della risorsa personalizzata AuditLoggingTarget configura la pipeline di logging per raccogliere gli audit log dalla nostra applicazione.
Per il sistema di ticketing, abbiamo configurato le destinazioni dell'audit logging sia per gli eventi di audit del sistema raccolti sia per gli eventi specifici dell'applicazione generati dall'audit log di sicurezza del sistema di ticketing. Entrambi i tipi di log vengono inviati a un'istanza Loki centralizzata in cui possiamo scrivere query e visualizzare dashboard nell'istanza di monitoraggio.
Controllo degli accessi
Il controllo degli accessi è il processo di concessione o negazione dell'accesso alle risorse in base all'identità dell'utente o del processo che richiede l'accesso. In questo modo, i dati vengono protetti da accessi non autorizzati e solo gli utenti autorizzati possono apportare modifiche al sistema. In GDC, ci affidiamo all'RBAC di Kubernetes per dichiarare le policy e applicare l'autorizzazione alle risorse di sistema che costituiscono l'applicazione del sistema di ticketing.
La definizione di un ProjectRole in GDC ci consente di concedere un accesso granulare alle risorse Kubernetes utilizzando un ruolo di autorizzazione preimpostato.
apiVersion: resourcemanager.gdc.goog/v1
kind: ProjectRole
metadata:
  name: ticketing-system-admin
  labels:
    resourcemanager.gdc.goog/rbac-selector: system
spec:
  rules:
  - apiGroups:
    - ""
    resources:
    - configmaps
    - events
    - pods/log
    - services
    verbs:
    - get
    - list
Disaster recovery
Replica dei database
Per soddisfare i requisiti di ripristino di emergenza (RE), eseguiamo il deployment del sistema di gestione dei ticket in una configurazione principale-secondaria su più istanze GDC. In questa modalità, le richieste al sistema di gestione dei ticket vengono normalmente indirizzate al sito principale, mentre il sito secondario replica continuamente il log binario del database. In caso di failover, il sito secondario viene promosso a nuovo sito principale e le richieste vengono quindi indirizzate al nuovo sito principale.
Sfruttiamo le funzionalità di replica del database per configurare i server di database primari e di replica per ogni istanza GDC in base ai parametri impostati.
Per abilitare la replica per un'istanza esistente in esecuzione da un periodo di tempo superiore a quello di conservazione del log binario, possiamo ripristinare il database di replica utilizzando il backup del database per avviare la replica dal database primario.
In modalità principale, i server delle applicazioni e il database funzionano come oggi, ma il database primario è configurato per abilitare la replica. Ad esempio:
Abilita il log binario.
Imposta l'ID server.
Crea un account utente di replica.
Creazione backup
In modalità di replica, i server delle applicazioni disattiveranno il servizio web di emissione dei biglietti per evitare di connettersi direttamente al database di replica. Il database di replica deve essere configurato per avviare la replica dal database primario, ad esempio:
Imposta l'ID server.
Configura le credenziali dell'utente di replica e i dettagli della connessione principale, come l'host e la porta.
Ripristina dalla posizione del log binario di ripresa del backup.
La replica del database richiede la connettività di rete affinché la replica possa connettersi al database primario per avviare la replica. Per esporre l'endpoint del database primario per la replica, utilizziamo Cloud Service Mesh per creare un mesh di servizi Ingress che supporti la terminazione TLS nel mesh di servizi, in modo simile a come gestiamo il trasferimento di dati HTTPS per l'applicazione web del sistema di emissione di biglietti.