


במדריך הזה נסביר את ההקשר הרעיוני שנדרש כדי לפרוס עומס עבודה שמבוסס על מכונה וירטואלית (VM) באשכול של Google Distributed Cloud (GDC) עם air gap על Bare Metal, באמצעות סביבת זמן ריצה של VM. עומס העבודה במדריך הזה הוא פלטפורמה לדוגמה של מערכת כרטיסים שזמינה בחומרה מקומית.
ארכיטקטורה
היררכיית המשאבים
ב-GDC, אתם פורסים את הרכיבים שמרכיבים את מערכת הכרטיסים בארגון דייר ייעודי לצוות התפעול, שזהה לכל ארגון של לקוח. ארגון הוא אוסף של אשכולות, משאבי תשתית ועומסי עבודה של אפליקציות שמנוהלים ביחד. כל ארגון במכונה של GDC משתמש בקבוצה ייעודית של שרתים, שמספקת בידוד חזק בין הדיירים. מידע נוסף על התשתית זמין במאמר תכנון גבולות הגישה.
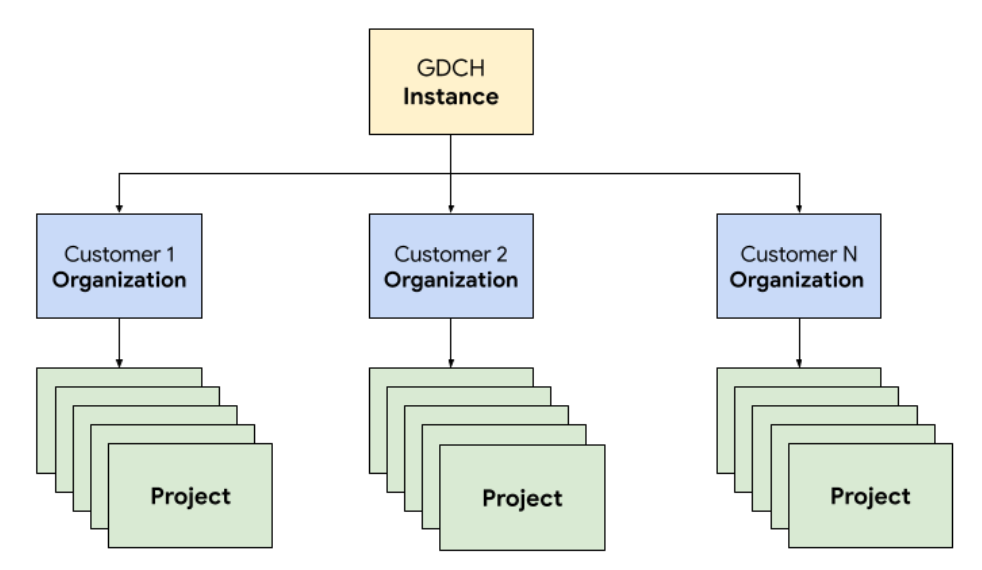
בנוסף, אתם פורסים ומנהלים את המשאבים של מערכת הכרטיסים ביחד בפרויקט, מה שמאפשר בידוד לוגי בתוך הארגון באמצעות מדיניות תוכנה ואכיפה. המשאבים בפרויקט נועדו לשלב רכיבים שצריכים להישאר יחד במהלך מחזור החיים שלהם.
מערכת הכרטיסים פועלת לפי ארכיטקטורה תלת-שכבתית שמסתמכת על מאזן עומסים כדי לנתב את התנועה בין שרתי האפליקציות שמחוברים לשרת מסד נתונים שבו מאוחסנים נתונים קבועים.
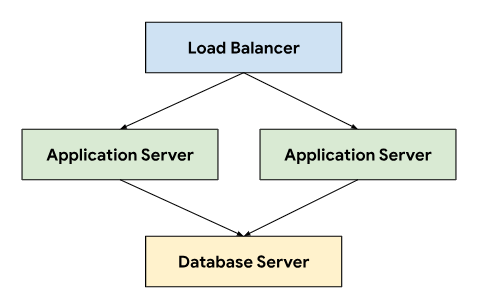
הארכיטקטורה הזו מאפשרת מדרגיות וקלות תחזוקה, כי אפשר לפתח ולתחזק כל שכבה בנפרד. הוא גם מספק הפרדה ברורה של תחומי האחריות, מה שמפשט את ניפוי הבאגים ופתרון הבעיות. כשמכילים את השכבות האלה בפרויקט GDC, אפשר לפרוס ולנהל רכיבים ביחד, למשל את שרתי האפליקציה ומסד הנתונים.
Networking
כדי להפעיל את מערכת הכרטיסים בסביבת ייצור, צריך לפרוס שני שרתי אפליקציות או יותר כדי להשיג זמינות גבוהה במקרה של כשל בצומת. בשילוב עם מאזן עומסים, הטופולוגיה הזו מאפשרת גם לפזר את העומס בין כמה מכונות כדי לשנות את קנה המידה של האפליקציה באופן אופקי. פלטפורמת ה-Kubernetes המקורית של GDC משתמשת ב-Cloud Service Mesh כדי לנתב באופן מאובטח את התנועה לשרתי האפליקציות שמרכיבים את מערכת הכרטיסים.
Cloud Service Mesh הוא הטמעה של Google שמבוססת על פרויקט בקוד פתוח שמנהל שירותים, עוקב אחריהם ומאבטח אותם. התכונות הבאות של Cloud Service Mesh משמשות לאירוח של מערכת הכרטיסים ב-GDC:
- איזון עומסים: Cloud Service Mesh מפריד בין זרימת התנועה לבין התאמה לעומס של התשתית, וכך מאפשר להשתמש בתכונות רבות לניהול תנועה, כולל ניתוב דינמי של בקשות. מערכת הכרטיסים דורשת חיבורים קבועים של לקוחות, לכן אנחנו מפעילים סשנים קבועים באמצעות
DestinationRulesכדי להגדיר את אופן הפעולה של ניתוב התנועה.
סיום TLS: Cloud Service Mesh חושף שערי כניסה באמצעות אישורי TLS ומספק אימות תעבורה בתוך האשכול באמצעות mTLS (אבטחת שכבת תעבורה הדדית) בלי לשנות את קוד האפליקציה.
התאוששות מכשלים: Cloud Service Mesh מספק כמה תכונות קריטיות להתאוששות מכשלים, כולל זמנים קצובים לתפוגה, מפסקי זרם, בדיקות תקינות פעילות וניסיונות חוזרים מוגבלים.
באשכול Kubernetes, אנחנו משתמשים באובייקטים רגילים של Service כדרך מופשטת לחשוף את שרתי האפליקציה ומסד הנתונים לרשת. השירותים מספקים דרך נוחה לטרגט מכונות יעד באמצעות בורר, ומספקים תרגום שם (name resolution) בתוך האשכול באמצעות שרת DNS שמודע לאשכול.
apiVersion: v1
kind: Service
metadata:
  name: http-ingress
spec:
  selector:
    app.kubernetes.io/component: application-server
  ports:
  - name: http
    port: 80
---
apiVersion: v1
kind: Service
metadata:
  name: database-ingress
spec:
  selector:
    app.kubernetes.io/component: database-server
  ports:
  - name: mysql
    port: 3306
Compute
מערכת הכרטיסים ממליצה להשתמש במכונות וירטואליות או במכונות Bare Metal כדי לארח התקנות מקומיות, והשתמשנו בניהול המכונות הווירטואליות (VM) של GDC כדי לפרוס את שרתי האפליקציות ומסדי הנתונים כעומסי עבודה של מכונות וירטואליות. הגדרת המשאבים ב-Kubernetes אפשרה לנו לציין גם את VirtualMachine וגם את VirtualMachineDisk כדי להתאים את המשאבים לצרכים שלנו בסוגי השרתים השונים. VirtualMachineExternalAccess מאפשר לנו להגדיר העברת נתונים נכנסת והעברת נתונים יוצאת עבור ה-VM.
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachineDisk
metadata:
  name: vm1-boot-disk
spec:
  size: 100G
  source:
    image:
      name: ts-ticketing-system-app-server-2023-08-18-203258
      namespace: vm-system
---
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachine
metadata:
  labels:
    app.kubernetes.io/component: application-server
  name: vm1
  namespace: support
spec:
  compute:
    vcpus: 8
    memory: 12G
  disks:
  - boot: true
    virtualMachineDiskRef:
      name: vm1-boot-disk

---
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachineExternalAccess
metadata:
  name: vm1
  namespace: support
spec:
  enabled: true
  ports:
   - name: ssh
     protocol: TCP
     port: 22
לגבי קובץ האימג' של מערכת ההפעלה של האורח, יצרנו קובץ אימג' בהתאמה אישית כדי לעמוד בדרישות שלנו לתאימות ולאבטחה. אפשר להתחבר למכונות וירטואליות פועלות באמצעות SSH באמצעות VirtualMachineAccessRequest, שמאפשר לנו להגביל את היכולת להתחבר למכונות וירטואליות דרך Kubernetes RBAC, ולמנוע את הצורך ליצור חשבונות משתמשים מקומיים בתמונות בהתאמה אישית. בבקשת הגישה מוגדר גם זמן חיים (TTL), שמאפשר לבקשות גישה שמבוססות על זמן לנהל את המכונות הווירטואליות שתוקף הגישה אליהן פג באופן אוטומטי.
אוטומציה
כחלק מהתוצרים העיקריים של הפרויקט, תכננו גישה להתקנת מכונות של מערכת הכרטיסים באופן שניתן לחזור עליו, שיכול לתמוך באוטומציה נרחבת ולצמצם את השינויים בהגדרות בין פריסות.
תהליך ההשקה
כדי להתאים אישית את קובצי האימג' של האפליקציה ושל שרת מסד הנתונים, מתחילים מקובץ אימג' בסיסי של מערכת ההפעלה ומשנים אותו לפי הצורך כדי להתקין את יחסי התלות שנדרשים לכל קובץ אימג' של שרת. בחרנו קובץ אימג' בסיסי של מערכת ההפעלה בגלל השימוש הנרחב בו לאירוח מערכות כרטיסים בהתקנות מקומיות. קובץ האימג' הבסיסי של מערכת ההפעלה מספק גם יכולות הקשחת אבטחה שנדרשות כדי לעמוד במדריכי ההטמעה הטכנית של האבטחה (STIG), שדרושים כדי לספק קובץ אימג' תואם שעומד באמצעי הבקרה של NIST-800-53.
צינור עיבוד הנתונים של האינטגרציה הרציפה (CI) השתמש בתהליך העבודה הבא כדי להתאים אישית את קובצי האימג' של האפליקציה ושל שרת מסד הנתונים:
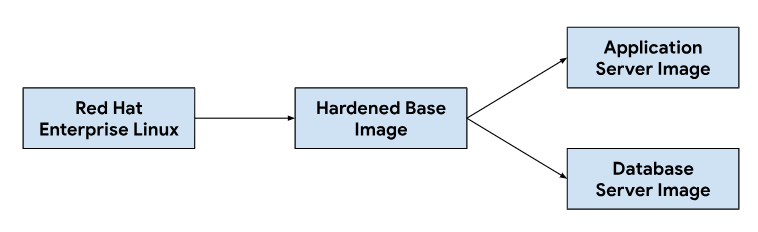
כשהמפתחים מבצעים שינויים בסקריפטים של ההתאמה האישית או ביחסי התלות של קובצי האימג', אנחנו מפעילים תהליך עבודה אוטומטי בכלי ה-CI שלנו כדי ליצור קבוצה חדשה של קובצי אימג' שמצורפים לגרסאות של GDC. כחלק מבניית התמונה, אנחנו גם מרעננים את יחסי התלות של מערכת ההפעלה (עדכון yum) ומפחיתים את צפיפות התמונה באמצעות דחיסה, כדי להקטין את גודל התמונה שנדרש להעברת תמונות לסביבות הלקוחות.
מחזור החיים של פיתוח תוכנה
מחזור החיים של פיתוח תוכנה (SDLC) הוא תהליך שעוזר לארגונים לתכנן, ליצור, לבדוק ולפרוס תוכנות. כשארגונים פועלים לפי SDLC מוגדר היטב, הם יכולים לוודא שהתוכנה מפותחת באופן עקבי וניתן לשחזור, ולזהות בעיות פוטנציאליות בשלב מוקדם. בנוסף ליצירת קובצי אימג' בצינור עיבוד הנתונים של האינטגרציה הרציפה (CI), הגדרנו גם סביבות לפיתוח ול-staging של גרסאות טרום-השקה של מערכת הכרטיסים, לצורך בדיקות ואבטחת איכות.
פריסת מכונה נפרדת של מערכת הכרטיסים לכל פרויקט ב-GDC אפשרה לנו לבדוק שינויים בבידוד, בלי להשפיע על מכונות קיימות באותו פרויקט ב-GDC. השתמשנו ב-ResourceManager API כדי ליצור ולהרוס פרויקטים באופן הצהרתי באמצעות משאבים ב-Kubernetes.
apiVersion: resourcemanager.gdc.goog/v1
kind: Project
metadata:
  name: ticketing-system-dev
---
apiVersion: resourcemanager.gdc.goog/v1
kind: Project
metadata:
  name: ticketing-system-qa
---
apiVersion: resourcemanager.gdc.goog/v1
kind: Project
metadata:
  name: ticketing-system-staging
בשילוב עם אריזת תרשימים וניהול תשתית כמו מכונות וירטואליות כקוד, המפתחים יכולים לחזור במהירות על ביצוע שינויים ובדיקת תכונות חדשות לצד מכונות ייצור. ה-API ההצהרתי גם מאפשר למסגרות אוטומטיות של ביצוע בדיקות לבצע בדיקות רגרסיה קבועות ולאמת יכולות קיימות.
יכולת תפעול
תפעוליות היא הקלות שבה אפשר להפעיל ולתחזק מערכת. זהו שיקול חשוב בתכנון של כל אפליקציית תוכנה. מעקב יעיל תורם לתפעוליות כי הוא מאפשר לזהות בעיות ולטפל בהן לפני שהן משפיעות באופן משמעותי על המערכת. אפשר גם להשתמש במעקב כדי לזהות הזדמנויות לשיפור ולקבוע בסיס ליעדים למדידת רמת השירות (SLO).
מעקב
שילבנו את מערכת הכרטיסים עם תשתית הניטור הקיימת של GDC, כולל רישום ביומן ומדדים. לגבי מדדים, אנחנו חושפים נקודות קצה (endpoint) של HTTP מכל מכונה וירטואלית, שמאפשרות לאפליקציה לאסוף נקודות על הגרף שנוצרו על ידי האפליקציה ושרתי מסד הנתונים. נקודות הקצה האלה כוללות מדדי מערכת שנאספים באמצעות ייצוא של צומת האפליקציה ומדדים ספציפיים לאפליקציה.
כדי להגדיר את התנהגות הסקר של האפליקציה, השתמשנו במשאב בהתאמה אישית MonitoringTarget כדי להגדיר את מרווח הגירוד ולהוסיף הערות למדדים.
apiVersion: monitoring.gdc.goog/v1
kind: MonitoringTarget
metadata:
  name: database-monitor
spec:
  podMetricsEndpoints:
    path:
      value: /metrics
    port:
      annotation: application.io/dbMetrics
    scrapeInterval: 60s
לצורך רישום ביומן, התקנו והגדרנו מעבד של רישום ביומן ומדדים בכל מכונה וירטואלית, כדי לעקוב אחרי היומנים הרלוונטיים ולשלוח את נתוני היומן לכלי הרישום ביומן, שבו הנתונים נוספים לאינדקס ונשלחות אליהם שאילתות דרך מכונת המעקב. יומני הביקורת מועברים לנקודת קצה מיוחדת שמוגדרת עם שמירה מורחבת לצורך תאימות. באפליקציות שמבוססות על קונטיינרים, אפשר להשתמש במשאבים המותאמים אישית LoggingTarget ו-AuditLoggingTarget כדי להורות לצינור עיבוד הנתונים של הרישום ביומן לאסוף יומנים משירותים ספציפיים בפרויקט.
על סמך הנתונים שזמינים במעבדי הרישום ביומן והמעקב, יצרנו התראות באמצעות המשאב בהתאמה אישית MonitoringRule, שמאפשר לנו לנהל את ההגדרה הזו כקוד באריזת התרשים שלנו. השימוש ב-API הצהרתי להגדרת התראות ומרכזי בקרה מאפשר לנו גם לאחסן את ההגדרות האלה במאגר המקורות של הקוד, ולפעול לפי אותם תהליכים של סקירת קוד ושילוב רציף (CI) שאנחנו מסתמכים עליהם בכל שינוי אחר בקוד.
מצבי כשל
בדיקות מוקדמות חשפו כמה מצבי כשל שקשורים למשאבים, שעזרו לנו לתעדף את המדדים וההתראות שצריך להוסיף קודם. התחלנו במעקב אחרי שימוש גבוה בזיכרון ובדיסק, כי הגדרה שגויה של מסד הנתונים גרמה בהתחלה לכך שטבלאות המאגר הזמני צרכו את כל הזיכרון הזמין, ורישום יתר ביומן מילא את הדיסק של אמצעי האחסון הקבוע המצורף. אחרי שהתאמנו את גודל שטח האחסון הזמני והטמענו אסטרטגיה להחלפת יומנים, הוספנו התראות שמופעלות אם המכונות הווירטואליות מתקרבות לשימוש גבוה בזיכרון או בדיסק.
apiVersion: monitoring.gdc.goog/v1
kind: MonitoringRule
metadata:
  name: monitoring-rule
spec:
  interval: 60s
  limit: 0
  alertRules:
  - alert: vm1_disk_usage
    expr:
      (node_filesystem_size_bytes{container_name="compute"} -
      node_filesystem_avail_bytes{container_name="compute"}) * 100 /
      node_filesystem_size_bytes{container_name="compute"} > 90
    labels:
      severity: error
      code: TS-R0001
      resource: vm1
    annotations:
      message: "vm1 disk usage above 90% utilization"
אחרי שווידאנו שהמערכת יציבה, התמקדנו במצבי הכשל של האפליקציה במערכת הכרטיסים. כדי לנפות באגים באפליקציה, בדרך כלל היינו צריכים להשתמש ב-Secure Shell (SSH) בכל מכונה וירטואלית של שרת אפליקציות כדי לבדוק את היומנים של מערכת הכרטיסים. לכן הגדרנו אפליקציה שתעביר את היומנים האלה לכלי הרישום ביומן, כדי להשתמש ב-GDC observability stack ולשלוח שאילתות לכל היומנים התפעוליים של מערכת הכרטיסים במכונה של כלי המעקב.
הרישום המרכזי ביומן גם מאפשר לנו לשלוח שאילתות ליומנים מכמה מכונות וירטואליות בו-זמנית, וכך לאחד את התצוגה של כל רכיב במערכת.
גיבויים
גיבויים חשובים לתפעול של מערכת תוכנה כי הם מאפשרים לשחזר את המערכת במקרה של תקלה.
ב-GDC אפשר לגבות ולשחזר מכונות וירטואליות באמצעות משאבים ב-Kubernetes. יצירת משאב מותאם אישית של VirtualMachineBackupRequest עם משאב מותאם אישית של VirtualMachineBackupPlanTemplate מאפשרת לנו לגבות את אמצעי האחסון הקבוע שמחובר לכל VM במאגר אובייקטים, שבו אפשר לשמור את הגיבויים בהתאם למדיניות שמירת נתונים מוגדרת.
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachineBackupPlanTemplate
metadata:
  name: vm-backup-plan
spec:
  backupRepository: "backup-repository"
---
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachineBackupRequest
metadata:
  name: "db-vm-backup"
spec:
  virtualMachineBackupPlanTemplate: vm-backup-plan
  virtualMachine: db1
  virtualMachineBackupName: db-vm-backup
באופן דומה, שחזור מצב של מכונה וירטואלית מגיבוי כולל יצירת משאב בהתאמה אישית של VirtualMachineRestoreRequest, כדי לשחזר גם את שרתי האפליקציה וגם את שרתי מסד הנתונים בלי לשנות את הקוד או את ההגדרות של אף אחד מהשירותים.
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachineRestoreRequest
metadata:
  name: vm-restore-1
spec:
  virtualMachineBackup: db-vm-backup
  restoreName: restore1
  restoredResourceName: db1
שדרוגים
כדי לתמוך במחזור החיים של התוכנה של מערכת הכרטיסים וביחסי התלות שלה, זיהינו שלושה סוגים של שדרוגי תוכנה, שכל אחד מהם מטופל בנפרד כדי לצמצם את זמן ההשבתה ואת השיבושים בשירות:
- שדרוגים של מערכת ההפעלה.
- שדרוגים של הפלטפורמה, כמו תיקונים וגרסאות ראשיות.
- עדכוני הגדרות אישיות.
לשדרוגי מערכת ההפעלה, אנחנו יוצרים ומפיצים באופן קבוע קובצי אימג' חדשים של מכונות וירטואליות לשרתי האפליקציות ולשרתי מסדי הנתונים, שמופצים בכל גרסה של GDC. התמונות האלה מכילות תיקונים לנקודות חולשה באבטחה ועדכונים למערכת ההפעלה הבסיסית.
כדי לשדרג את הפלטפורמה של מערכת הכרטיסים, צריך לעדכן את קובצי האימג' הקיימים של המכונות הווירטואליות. לכן אי אפשר להסתמך על תשתית שלא ניתנת לשינוי כדי לבצע תיקונים ועדכונים של גרסאות הפצה עיקריות. לפני שאנחנו משיקים חבילת שדרוג נפרדת יחד עם גרסת GDC, אנחנו בודקים ומאמתים את התיקון או את גרסת ההפצה הראשית בסביבות הפיתוח וההכנה שלנו.
לבסוף, עדכוני ההגדרות מוחלים ללא זמן השבתה באמצעות ממשקי ה-API של מערכת הכרטיסים עבור קבוצות עדכונים ונתוני משתמשים אחרים. אנחנו מפתחים ובודקים עדכוני הגדרות בסביבות הפיתוח וההכנה שלנו, לפני שאנחנו אורזים כמה קבוצות של עדכונים יחד במהלך תהליך ההפצה של GDC.
שילובים
ספקי זהויות
כדי לספק ללקוחות חוויה חלקה ולאפשר לארגונים להוסיף את המשתמשים שלהם, אנחנו משלבים את מערכת הכרטיסים עם כמה ספקי זהויות שזמינים ב-GDC. בדרך כלל, ללקוחות ארגוניים וללקוחות מהמגזר הציבורי יש ספקי זהויות משלהם שמנוהלים היטב, כדי להעניק לעובדים שלהם הרשאות ולבטל אותן. בגלל דרישות תאימות וקלות הניהול של הזהויות ו-Access Governance, הלקוחות האלה רוצים להשתמש בספקי הזהויות הקיימים שלהם כמקור האמת לניהול הגישה של העובדים שלהם למערכת הכרטיסים.
מערכת הכרטיסים תומכת בספקי SAML 2.0 ו-OIDC באמצעות מודול ספק הזהויות המרובות, שהפעלנו מראש בתמונת ה-VM של שרת האפליקציות. הלקוחות מאמתים את הזהות שלהם באמצעות ספק הזהויות של הארגון, שיוצר באופן אוטומטי משתמשים ומקצה תפקידים במערכת הכרטיסים.
אפשר להוציא נתונים לשרתים של ספק הזהויות באמצעות המשאב המותאם אישית ProjectNetworkPolicy, שמגביל את הגישה לשירותים חיצוניים מארגון ב-GDC. כללי המדיניות האלה מאפשרים לנו לקבוע באופן הצהרתי לאילו נקודות קצה (endpoints) מערכת הכרטיסים יכולה לגשת ברשת.
הטמעת התראות
בנוסף לאפשרות של המשתמשים להיכנס לחשבון כדי ליצור בקשות תמיכה באופן ידני, אנחנו גם יוצרים אירועים במערכת הכרטיסים בתגובה להתראות מערכת.
כדי להשיג את השילוב הזה, התאמנו אישית תגובה לפעולה מאתר אחר (webhook) של Kubernetes בקוד פתוח כדי לקבל התראות מהאפליקציה ולנהל את מחזור החיים של האירועים באמצעות נקודת הקצה ל-API של מערכת הכרטיסים שנחשפה דרך Cloud Service Mesh.
מפתחות ה-API מאוחסנים באמצעות מאגר הסודות של GDC, שמגובה על ידי סודות של Kubernetes שנשלטים באמצעות בקרת גישה מבוססת-תפקידים (RBAC). הגדרות אחרות, כמו נקודות קצה ל-API ושדות להתאמה אישית של אירועים, מנוהלות באמצעות אחסון של ערכי מפתח ב-Kubernetes ConfigMap.
אימייל
מערכת הכרטיסים מציעה שילובים של שרתי אימייל כדי לאפשר ללקוחות לקבל תמיכה באימייל. תהליכי עבודה אוטומטיים ממירים אימיילים נכנסים מלקוחות לבקשות תמיכה, ושולחים ללקוחות תשובות אוטומטיות עם קישורים לבקשות. כך צוות התמיכה יכול לנהל טוב יותר את תיבת הדואר הנכנס, לעקוב באופן שיטתי אחרי בקשות באימייל ולטפל בהן, ולספק שירות לקוחות טוב יותר.
apiVersion: networking.gdc.goog/v1
kind: ProjectNetworkPolicy
metadata:
  name: allow-ingress-traffic-from-ticketing-system
spec:
  subject:
    subjectType: UserWorkload
  ingress:
  - from:
    - projects:
        matchNames:
        - ticketing-system
חשיפת האימייל כשירות Kubernetes מספקת גם זיהוי שירותים ותרגום שם דומיין, ומפרידה עוד יותר בין הקצה העורפי של שרת האימייל לבין לקוחות כמו מערכת ניהול הפניות לתמיכה.
תאימות
רישום ביומן ביקורת
יומני הביקורת תורמים לסטטוס העמידה בהוראות הדין, כי הם מאפשרים לעקוב אחרי השימוש בתוכנה ולתעד את הפעילות במערכת. יומני ביקורת מתעדים ניסיונות גישה של משתמשים לא מורשים, עוקבים אחרי השימוש ב-API ומזהים סיכוני אבטחה פוטנציאליים. יומני הביקורת עומדים בדרישות התאימות, כמו אלה שנקבעו בחוק היבילות ואחריות הדיווח של ביטוח בריאות (HIPAA), בתקן אבטחת הנתונים המקובל בתעשיית כרטיסי תשלום (PCI DSS) ובחוק סרבנס-אוקסלי (SOX).
ב-GDC יש מערכת שמתעדת את פעילויות האדמין והגישה בתוך הפלטפורמה, ושומרת את היומנים האלה למשך פרק זמן שניתן להגדרה. פריסת המשאב המותאם אישית AuditLoggingTarget מגדירה את צינור עיבוד הנתונים של הרישום ביומן לאיסוף יומני ביקורת מהאפליקציה שלנו.
במערכת הכרטיסים, הגדרנו יעדים לרישום ביומן הביקורת גם לאירועי ביקורת המערכת שנאספו וגם לאירועים ספציפיים לאפליקציה שנוצרו על ידי יומן הביקורת של אבטחת מערכת הכרטיסים. שני סוגי היומנים נשלחים למכונה מרכזית של Loki, שבה אנחנו יכולים לכתוב שאילתות ולצפות במרכזי בקרה במכונת המעקב.
בקרת גישה
בקרת גישה היא התהליך שבו מעניקים או דוחים גישה למשאבים על סמך הזהות של המשתמש או התהליך שמבקש גישה. כך אפשר להגן על הנתונים מפני גישה לא מורשית ולוודא שרק משתמשים מורשים יכולים לבצע שינויים במערכת. ב-GDC, אנחנו מסתמכים על Kubernetes RBAC כדי להצהיר על כללי מדיניות ולאכוף הרשאות למשאבי המערכת שכוללים את האפליקציה של מערכת הכרטיסים.
הגדרת ProjectRole ב-GDC מאפשרת לנו לתת גישה מפורטת למשאבים ב-Kubernetes באמצעות תפקיד הרשאה מוגדר מראש.
apiVersion: resourcemanager.gdc.goog/v1
kind: ProjectRole
metadata:
  name: ticketing-system-admin
  labels:
    resourcemanager.gdc.goog/rbac-selector: system
spec:
  rules:
  - apiGroups:
    - ""
    resources:
    - configmaps
    - events
    - pods/log
    - services
    verbs:
    - get
    - list
תוכנית התאוששות מאסון (DR)
שכפול מסד נתונים
כדי לעמוד בדרישות של תוכנית התאוששות מאסון (DR), אנחנו פורסים את מערכת ניהול הפניות לתמיכה בהגדרת ראשי-משני בכמה מכונות GDC. במצב הזה, בקשות למערכת ניהול הפניות לתמיכה מנותבות בדרך כלל לאתר הראשי, והאתר המשני משכפל באופן רציף את היומן הבינארי של מסד הנתונים. במקרה של אירוע יתירות כשל, האתר המשני מקודם לאתר הראשי החדש והבקשות מנותבות אליו.
אנחנו מתבססים על יכולות השכפול של מסד הנתונים כדי להגדיר את שרתי מסד הנתונים הראשיים והמשוכפלים לכל מכונה של GDC, על סמך הפרמטרים שהוגדרו.
כדי להפעיל רפליקציה במכונה קיימת שפועלת יותר זמן מתקופת השמירה של היומן הבינארי, אפשר לשחזר את מסד הנתונים של הרפליקה באמצעות גיבוי של מסד הנתונים, כדי להתחיל את הרפליקציה ממסד הנתונים הראשי.
במצב הראשי, שרתי האפליקציה ומסד הנתונים פועלים כמו היום, אבל מסד הנתונים הראשי מוגדר לאפשר רפליקציה. לדוגמה:
מפעילים את היומן הבינארי.
מגדירים את מזהה השרת.
יוצרים חשבון משתמש לרפליקציה.
יוצרים גיבוי.
במצב רפליקה, שרתי האפליקציה ישביתו את שירות האינטרנט של הכרטיסים כדי להימנע מחיבור ישיר למסד הנתונים של הרפליקה. צריך להגדיר את מסד הנתונים של הרפליקה כך שיתחיל את הרפליקציה ממסד הנתונים הראשי, לדוגמה:
מגדירים את מזהה השרת.
מגדירים את פרטי הכניסה של משתמש הרפליקציה ואת פרטי החיבור הראשי, כמו המארח והיציאה.
שחזור מגיבוי ממשיך את המיקום של היומן הבינארי.
שכפול מסד נתונים דורש קישוריות לרשת כדי שהרפליקה תוכל להתחבר למסד הנתונים הראשי ולהתחיל את תהליך השכפול. כדי לחשוף את נקודת הקצה של מסד הנתונים הראשי לצורך רפליקציה, אנחנו משתמשים ב-Cloud Service Mesh כדי ליצור רשת שירות Ingress שתומכת בסיום TLS ברשת השירות, בדומה לאופן שבו אנחנו מטפלים בהעברת נתוני HTTPS לאפליקציית האינטרנט של מערכת הכרטיסים.