


Ce guide présente le contexte conceptuel requis pour déployer une charge de travail basée sur une machine virtuelle (VM) dans un cluster Google Distributed Cloud (GDC) avec isolation physique sur Bare Metal à l'aide d'un environnement d'exécution de VM. La charge de travail de ce guide est un exemple de plate-forme de système de billetterie disponible sur du matériel sur site.
Architecture
Hiérarchie des ressources
Dans GDC, vous déployez les composants qui constituent le système de billetterie dans une organisation de locataire dédiée à l'équipe des opérations, identique à n'importe quelle organisation client. Une organisation est un ensemble de clusters, de ressources d'infrastructure et de charges de travail d'application qui sont administrés ensemble. Chaque organisation d'une instance GDC utilise un ensemble de serveurs dédié, ce qui assure une isolation forte entre les locataires. Pour en savoir plus sur l'infrastructure, consultez Concevoir des limites d'accès.
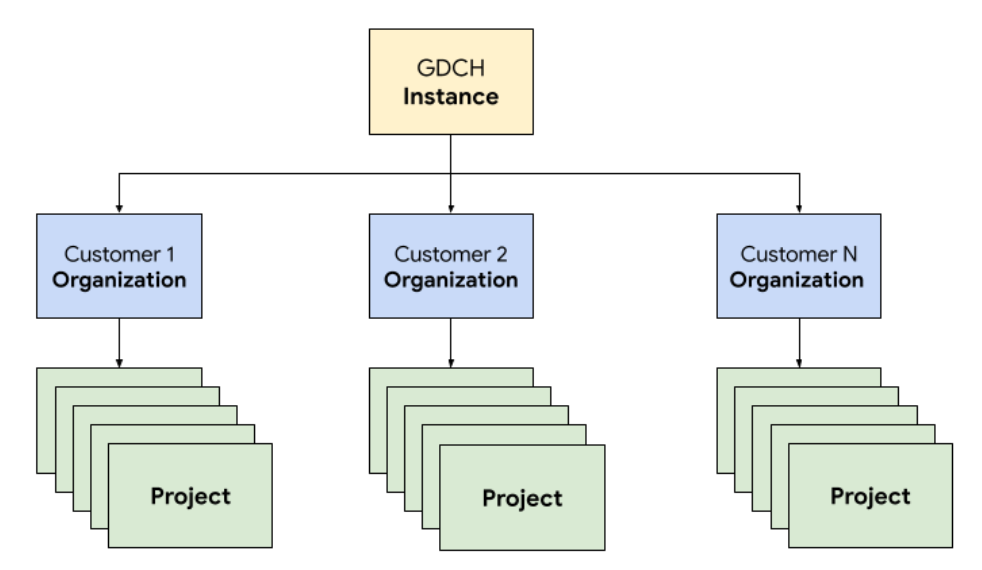
De plus, vous déployez et gérez les ressources du système de billetterie ensemble dans un projet, ce qui permet une isolation logique au sein d'une organisation à l'aide de règles logicielles et de leur application. Les ressources d'un projet sont destinées à coupler des composants qui doivent rester ensemble pendant leur cycle de vie.
Le système de suivi des demandes suit une architecture à trois niveaux qui s'appuie sur un équilibreur de charge pour diriger le trafic vers les serveurs d'applications qui se connectent à un serveur de base de données stockant les données persistantes.
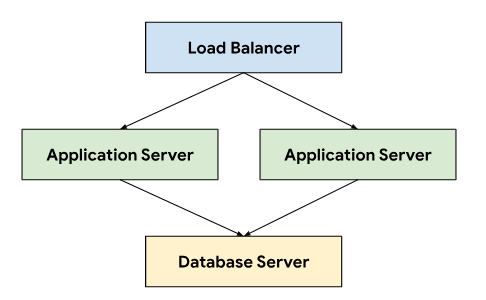
Cette architecture permet d'assurer l'évolutivité et la facilité de maintenance, car chaque niveau peut être développé et géré indépendamment. Il permet également de séparer clairement les domaines de contrôle, ce qui simplifie le débogage et le dépannage. L'encapsulation de ces niveaux dans un projet GDC vous permet de déployer et de gérer des composants ensemble, par exemple vos serveurs d'applications et de bases de données.
Mise en réseau
Pour exécuter le système de billetterie dans un environnement de production, vous devez déployer au moins deux serveurs d'applications afin d'obtenir une haute disponibilité en cas de défaillance d'un nœud. Combinée à un équilibreur de charge, cette topologie permet également de répartir la charge sur plusieurs machines afin de faire évoluer l'application horizontalement. La plate-forme Kubernetes native de GDC utilise Cloud Service Mesh pour acheminer de manière sécurisée le trafic vers les serveurs d'applications qui composent le système de billetterie.
Cloud Service Mesh est une implémentation de Google basée sur le projet Open Source qui gère, observe et sécurise les services. Les fonctionnalités suivantes de Cloud Service Mesh sont utilisées pour héberger le système de billetterie sur GDC :
- Équilibrage de charge : Cloud Service Mesh dissocie le flux de trafic du scaling de l'infrastructure, ce qui ouvre de nombreuses fonctionnalités de gestion du trafic, y compris le routage dynamique des requêtes. Le système de billetterie nécessite des connexions client persistantes. Nous activons donc les sessions persistantes à l'aide de
DestinationRulespour configurer le comportement de routage du trafic.
Terminaison TLS : Cloud Service Mesh expose les passerelles d'entrée à l'aide de certificats TLS et fournit une authentification de transport au sein du cluster via mTLS (Mutual Transport Layer Security) sans avoir à modifier le code de l'application.
Reprise après échec : Cloud Service Mesh offre un certain nombre de fonctionnalités majeures de reprise après échec. Vous pouvez ainsi paramétrer des délais avant expiration, des disjoncteurs, des vérifications d'état actives et un nombre de tentatives limité.
Dans le cluster Kubernetes, nous utilisons des objets Service standards comme moyen abstrait d'exposer l'application et les serveurs de base de données au réseau. Les services permettent de cibler facilement des instances à l'aide d'un sélecteur et de résoudre les noms au sein du cluster à l'aide d'un serveur DNS compatible avec le cluster.
apiVersion: v1
kind: Service
metadata:
  name: http-ingress
spec:
  selector:
    app.kubernetes.io/component: application-server
  ports:
  - name: http
    port: 80
---
apiVersion: v1
kind: Service
metadata:
  name: database-ingress
spec:
  selector:
    app.kubernetes.io/component: database-server
  ports:
  - name: mysql
    port: 3306
Calcul
Le système de billetterie recommande d'utiliser des machines Bare Metal ou virtuelles pour héberger les installations sur site. Nous avons utilisé la gestion des machines virtuelles (VM) de GDC pour déployer les serveurs d'applications et de bases de données en tant que charges de travail de VM. La définition des ressources Kubernetes nous a permis de spécifier à la fois VirtualMachine et VirtualMachineDisk pour adapter les ressources à nos besoins pour les différents types de serveurs. VirtualMachineExternalAccess nous permet de configurer le transfert de données entrant et sortant pour la VM.
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachineDisk
metadata:
  name: vm1-boot-disk
spec:
  size: 100G
  source:
    image:
      name: ts-ticketing-system-app-server-2023-08-18-203258
      namespace: vm-system
---
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachine
metadata:
  labels:
    app.kubernetes.io/component: application-server
  name: vm1
  namespace: support
spec:
  compute:
    vcpus: 8
    memory: 12G
  disks:
  - boot: true
    virtualMachineDiskRef:
      name: vm1-boot-disk

---
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachineExternalAccess
metadata:
  name: vm1
  namespace: support
spec:
  enabled: true
  ports:
   - name: ssh
     protocol: TCP
     port: 22
Pour l'image de l'OS invité, nous avons créé une image personnalisée afin de répondre à nos exigences de conformité et de sécurité. Il est possible de se connecter à des instances de VM en cours d'exécution via SSH à l'aide de VirtualMachineAccessRequest, ce qui nous permet de limiter la possibilité de se connecter aux VM via le RBAC Kubernetes et d'éviter d'avoir à créer des comptes utilisateur locaux dans les images personnalisées. La demande d'accès définit également une valeur TTL (Time To Live) permettant aux demandes d'accès basées sur le temps de gérer les VM qui expirent automatiquement.
Automatisation
En tant que livrable clé de ce projet, nous avons conçu une approche permettant d'installer des instances du système de billetterie de manière reproductible, ce qui peut favoriser une automatisation étendue et réduire la dérive de configuration entre les déploiements.
Pipeline de versions
La personnalisation des images de serveur d'application et de base de données commence par une image de système d'exploitation de base, en modifiant l'image de base si nécessaire pour installer les dépendances requises pour chaque image de serveur. Nous avons sélectionné une image d'OS de base pour son adoption généralisée dans l'hébergement de systèmes de billetterie dans des installations sur site. Cette image d'OS de base fournit également les fonctionnalités de renforcement de la sécurité requises pour respecter les guides de mise en œuvre technique de sécurité (STIG) nécessaires pour fournir une image conforme aux contrôles NIST-800-53.
Notre pipeline d'intégration continue (CI) a utilisé le workflow suivant pour personnaliser les images de serveur d'application et de base de données :
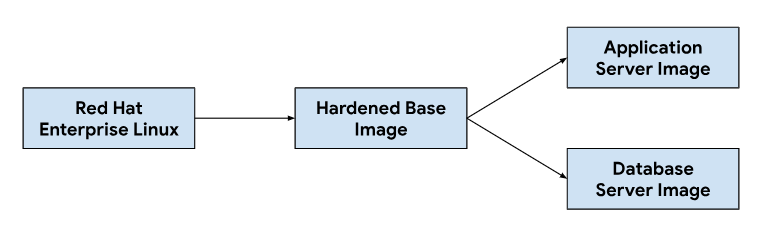
Lorsque les développeurs modifient les scripts de personnalisation ou les dépendances d'image, nous déclenchons un workflow automatisé dans nos outils d'intégration continue pour générer un nouvel ensemble d'images qui sont regroupées avec les versions de GDC. Lors de la création de l'image, nous actualisons également les dépendances de l'OS (mise à jour yum) et nous compressons l'image pour réduire la taille de l'image nécessaire au transfert des images vers les environnements client.
Cycle de vie du développement logiciel
Le cycle de vie du développement logiciel (SDLC, Software Development Life Cycle) est un processus qui aide les organisations à planifier, créer, tester et déployer des logiciels. En suivant un SDLC bien défini, les organisations s'assurent que les logiciels sont développés de manière cohérente et reproductible, et identifient les problèmes potentiels dès le début. En plus de créer des images dans notre pipeline d'intégration continue (CI), nous avons également défini des environnements pour développer et préproduire des versions préliminaires du système de billetterie à des fins de test et d'assurance qualité.
Le déploiement d'une instance distincte du système de billetterie par projet GDC nous a permis de tester les modifications de manière isolée, sans affecter les instances existantes sur la même instance GDC. Nous avons utilisé l'API ResourceManager pour créer et supprimer de manière déclarative des projets à l'aide de ressources Kubernetes.
apiVersion: resourcemanager.gdc.goog/v1
kind: Project
metadata:
  name: ticketing-system-dev
---
apiVersion: resourcemanager.gdc.goog/v1
kind: Project
metadata:
  name: ticketing-system-qa
---
apiVersion: resourcemanager.gdc.goog/v1
kind: Project
metadata:
  name: ticketing-system-staging
En combinant l'empaquetage de graphiques et la gestion de l'infrastructure (comme les machines virtuelles) en tant que code, les développeurs peuvent rapidement effectuer des modifications et tester de nouvelles fonctionnalités parallèlement aux instances de production. L'API déclarative permet également aux frameworks d'exécution de tests automatisés d'effectuer des tests de régression réguliers et de vérifier les fonctionnalités existantes.
Exploitabilité
L'opérabilité est la facilité avec laquelle un système peut être utilisé et géré. Il s'agit d'un aspect important à prendre en compte lors de la conception de toute application logicielle. Une surveillance efficace contribue à l'exploitabilité, car elle permet d'identifier et de résoudre les problèmes avant qu'ils n'aient un impact significatif sur le système. La surveillance peut également être utilisée pour identifier les opportunités d'amélioration et établir une référence pour les objectifs de niveau de service (SLO).
Surveillance
Nous avons intégré le système de tickets à l'infrastructure d'observabilité GDC existante, y compris la journalisation et les métriques. Pour les métriques, nous exposons des points de terminaison HTTP à partir de chaque VM, ce qui permet à l'application de récupérer les points de données produits par les serveurs d'applications et de bases de données. Ces points de terminaison incluent les métriques système collectées à l'aide de l'exportateur de nœuds d'application et les métriques spécifiques à l'application.
Les points de terminaison étant exposés dans chaque VM, nous avons configuré le comportement d'interrogation de l'application à l'aide de la ressource personnalisée MonitoringTarget pour définir l'intervalle de scraping et annoter les métriques.
apiVersion: monitoring.gdc.goog/v1
kind: MonitoringTarget
metadata:
  name: database-monitor
spec:
  podMetricsEndpoints:
    path:
      value: /metrics
    port:
      annotation: application.io/dbMetrics
    scrapeInterval: 60s
Pour la journalisation, nous avons installé et configuré un processeur de journalisation et de métriques dans chaque VM afin de suivre les journaux pertinents et d'envoyer les données de journalisation à l'outil de journalisation, où les données sont indexées et interrogées via l'instance de surveillance. Les journaux d'audit sont transférés vers un point de terminaison spécial configuré avec une conservation étendue pour des raisons de conformité. Les applications basées sur des conteneurs peuvent utiliser les ressources personnalisées LoggingTarget et AuditLoggingTarget pour indiquer au pipeline de journalisation de collecter les journaux de services spécifiques de votre projet.
En fonction des données disponibles dans les processeurs de journalisation et de surveillance, nous avons créé des alertes à l'aide de la ressource personnalisée MonitoringRule, qui nous permet de gérer cette configuration en tant que code dans notre empaquetage de chart. L'utilisation d'une API déclarative pour définir les alertes et les tableaux de bord nous permet également de stocker cette configuration dans notre dépôt de code et de suivre les mêmes processus de revue de code et d'intégration continue que ceux sur lesquels nous nous appuyons pour toute autre modification de code.
Modes de défaillance
Les premiers tests ont révélé plusieurs modes de défaillance liés aux ressources, ce qui nous a aidés à hiérarchiser les métriques et les alertes à ajouter en premier. Nous avons commencé par surveiller l'utilisation élevée de la mémoire et du disque, car une mauvaise configuration de la base de données a initialement entraîné l'utilisation de toute la mémoire disponible par les tables de tampon, et une journalisation excessive a rempli le disque de volume persistant associé. Après avoir ajusté la taille de la mémoire tampon de stockage et mis en œuvre une stratégie de rotation des journaux, nous avons introduit des alertes qui s'exécutent si les VM approchent d'une utilisation élevée de la mémoire ou du disque.
apiVersion: monitoring.gdc.goog/v1
kind: MonitoringRule
metadata:
  name: monitoring-rule
spec:
  interval: 60s
  limit: 0
  alertRules:
  - alert: vm1_disk_usage
    expr:
      (node_filesystem_size_bytes{container_name="compute"} -
      node_filesystem_avail_bytes{container_name="compute"}) * 100 /
      node_filesystem_size_bytes{container_name="compute"} > 90
    labels:
      severity: error
      code: TS-R0001
      resource: vm1
    annotations:
      message: "vm1 disk usage above 90% utilization"
Après avoir vérifié la stabilité du système, nous nous sommes concentrés sur les modes de défaillance des applications dans le système de tickets. Comme le débogage des problèmes au sein de l'application nous obligeait souvent à utiliser Secure Shell (SSH) sur chaque VM de serveur d'application pour vérifier les journaux du système de billetterie, nous avons configuré une application pour transférer ces journaux vers l'outil de journalisation afin de s'appuyer sur la pile d'observabilité GDC et d'interroger tous les journaux opérationnels du système de billetterie dans l'instance de surveillance.
La journalisation centralisée nous a également permis d'interroger les journaux de plusieurs VM en même temps, ce qui nous a permis de consolider notre vue de chaque composant du système.
Sauvegardes
Les sauvegardes sont importantes pour l'opérabilité d'un système logiciel, car elles permettent de restaurer le système en cas de défaillance.
GDC propose la sauvegarde et la restauration de VM via des ressources Kubernetes. La création d'une ressource personnalisée VirtualMachineBackupRequest avec une ressource personnalisée VirtualMachineBackupPlanTemplate nous permet de sauvegarder le volume persistant associé à chaque VM dans un store d'objets, où les sauvegardes peuvent être conservées conformément à un ensemble de règles de conservation.
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachineBackupPlanTemplate
metadata:
  name: vm-backup-plan
spec:
  backupRepository: "backup-repository"
---
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachineBackupRequest
metadata:
  name: "db-vm-backup"
spec:
  virtualMachineBackupPlanTemplate: vm-backup-plan
  virtualMachine: db1
  virtualMachineBackupName: db-vm-backup
De même, la restauration de l'état d'une VM à partir d'une sauvegarde implique la création d'une ressource personnalisée VirtualMachineRestoreRequest pour restaurer les serveurs d'applications et de bases de données sans modifier le code ni la configuration de l'un ou l'autre service.
apiVersion: virtualmachine.gdc.goog/v1
kind: VirtualMachineRestoreRequest
metadata:
  name: vm-restore-1
spec:
  virtualMachineBackup: db-vm-backup
  restoreName: restore1
  restoredResourceName: db1
Mises à niveau
Pour prendre en charge le cycle de vie logiciel du système de billetterie et de ses dépendances, nous avons identifié trois types de mises à niveau logicielles, chacune gérée individuellement pour minimiser les temps d'arrêt et les interruptions de service :
- Mises à niveau de l'OS.
- Mises à niveau de la plate-forme, telles que les correctifs et les versions majeures.
- Mises à jour de la configuration.
Pour les mises à niveau de l'OS, nous créons et publions en continu de nouvelles images de VM pour les serveurs d'applications et de bases de données, qui sont distribuées avec chaque version de GDC. Ces images contiennent des correctifs pour les failles de sécurité et des mises à jour du système d'exploitation sous-jacent.
Les mises à niveau de la plate-forme du système de billetterie nécessitent l'application de mises à jour aux images de VM existantes. Nous ne pouvons donc pas nous appuyer sur une infrastructure immuable pour appliquer des correctifs et des mises à jour de versions majeures. Pour les mises à niveau de la plate-forme, nous testons et vérifions la version du correctif ou de la version majeure dans nos environnements de développement et de préproduction avant de publier un package de mise à niveau autonome avec la version GDC.
Enfin, les mises à jour de configuration sont appliquées sans temps d'arrêt via les API du système de tickets pour les ensembles de mises à jour et d'autres données utilisateur. Nous développons et testons les mises à jour de configuration dans nos environnements de développement et de préproduction avant de regrouper plusieurs ensembles de mises à jour lors du processus de publication de GDC.
Intégrations
Fournisseurs d'identité
Pour offrir aux clients un parcours fluide et permettre aux organisations d'intégrer leurs utilisateurs, nous intégrons le système de tickets à plusieurs fournisseurs d'identité disponibles dans GDC. En règle générale, les clients des entreprises et du secteur public disposent de leurs propres fournisseurs d'identité bien gérés pour accorder et révoquer les droits de leurs employés. En raison des exigences de conformité et de la facilité de gouvernance des identités et des accès, ces clients souhaitent utiliser leurs fournisseurs d'identité existants comme source de vérité pour gérer l'accès de leurs employés au système de billetterie.
Le système de billetterie est compatible avec les fournisseurs SAML 2.0 et OIDC via son module de fournisseur d'identité multiple, que nous avons préactivé dans l'image de VM de notre serveur d'applications. Les clients s'authentifient via le fournisseur d'identité de leur organisation, qui crée automatiquement des utilisateurs et attribue des rôles dans le système de tickets.
La sortie vers les serveurs du fournisseur d'identité est autorisée via la ressource personnalisée ProjectNetworkPolicy, qui limite l'accès aux services externes depuis une organisation dans GDC. Ces règles nous permettent de contrôler de manière déclarative les points de terminaison auxquels le système de billetterie peut accéder sur le réseau.
Ingestion des alertes
En plus de permettre aux utilisateurs de se connecter pour créer manuellement des demandes d'assistance, nous créons également des incidents dans le système de tickets en réponse aux alertes système.
Pour réaliser cette intégration, nous avons personnalisé un webhook Kubernetes Open Source afin de recevoir des alertes de l'application et de gérer le cycle de vie des incidents à l'aide du point de terminaison de l'API du système de tickets exposé via Cloud Service Mesh.
Les clés API sont stockées à l'aide du store de secrets GDC, qui s'appuie sur des secrets Kubernetes contrôlés par le contrôle des accès basé sur les rôles (RBAC). Les autres configurations, telles que les points de terminaison de l'API et les champs de personnalisation des incidents, sont gérées via le stockage clé-valeur Kubernetes ConfigMap.
Le système de gestion des demandes propose des intégrations de serveur de messagerie pour permettre aux clients de recevoir une assistance par e-mail. Les workflows automatisés convertissent les e-mails entrants des clients en demandes d'assistance et envoient des réponses automatiques aux clients avec des liens vers les demandes. Notre équipe d'assistance peut ainsi mieux gérer sa boîte de réception, suivre et résoudre systématiquement les demandes par e-mail, et fournir un meilleur service client.
apiVersion: networking.gdc.goog/v1
kind: ProjectNetworkPolicy
metadata:
  name: allow-ingress-traffic-from-ticketing-system
spec:
  subject:
    subjectType: UserWorkload
  ingress:
  - from:
    - projects:
        matchNames:
        - ticketing-system
L'exposition de l'e-mail en tant que service Kubernetes permet également de détection de services et la résolution de noms de domaine, et de dissocier davantage le backend du serveur de messagerie des clients tels que le système de tickets.
Conformité
Journal d'audit
Les journaux d'audit contribuent à la stratégie de conformité en permettant de suivre et de surveiller l'utilisation des logiciels, et en fournissant un enregistrement de l'activité du système. Les journaux d'audit enregistrent les tentatives d'accès par des utilisateurs non autorisés, suivent l'utilisation de l'API et identifient les risques de sécurité potentiels. Les journaux d'audit répondent aux exigences de conformité, telles que celles imposées par la loi HIPAA (Health Insurance Portability and Accountability Act), la norme PCI DSS (Payment Card Industry Data Security Standard) et la loi SOX (Sarbanes-Oxley Act).
GDC fournit un système permettant d'enregistrer les activités d'administration et les accès au sein de la plate-forme, et de conserver ces journaux pendant une période configurable. Le déploiement de la ressource personnalisée AuditLoggingTarget configure le pipeline de journalisation pour collecter les journaux d'audit de notre application.
Pour le système de billetterie, nous avons configuré des cibles de journalisation d'audit pour les événements d'audit système collectés et les événements spécifiques à l'application générés par le journal d'audit de sécurité du système de billetterie. Les deux types de journaux sont envoyés à une instance Loki centralisée, où nous pouvons écrire des requêtes et afficher des tableaux de bord dans l'instance de surveillance.
Contrôle des accès
Le contrôle des accès est le processus qui consiste à accorder ou à refuser l'accès aux ressources en fonction de l'identité de l'utilisateur ou du processus qui demande l'accès. Cela permet de protéger les données contre les accès non autorisés et de s'assurer que seuls les utilisateurs autorisés peuvent apporter des modifications au système. Dans GDC, nous utilisons le RBAC Kubernetes pour déclarer des règles et appliquer l'autorisation aux ressources système qui constituent l'application du système de billetterie.
La définition d'un ProjectRole dans GDC nous permet d'accorder un accès précis aux ressources Kubernetes à l'aide d'un rôle d'autorisation prédéfini.
apiVersion: resourcemanager.gdc.goog/v1
kind: ProjectRole
metadata:
  name: ticketing-system-admin
  labels:
    resourcemanager.gdc.goog/rbac-selector: system
spec:
  rules:
  - apiGroups:
    - ""
    resources:
    - configmaps
    - events
    - pods/log
    - services
    verbs:
    - get
    - list
Reprise après sinistre
Réplication de base de données
Pour répondre aux exigences de reprise après sinistre (DR), nous déployons le système de billetterie dans une configuration principale-secondaire sur plusieurs instances GDC. Dans ce mode, les requêtes adressées au système de tickets sont normalement acheminées vers le site principal, tandis que le site secondaire réplique en continu le journal binaire de la base de données. En cas de basculement, le site secondaire est promu pour devenir le nouveau site principal, et les requêtes sont ensuite acheminées vers le nouveau site principal.
Nous nous appuyons sur les fonctionnalités de réplication de base de données pour configurer les serveurs de base de données principal et répliqué par instance GDC en fonction des paramètres définis.
Pour activer la réplication pour une instance existante qui s'exécute depuis plus longtemps que la période de conservation du journal binaire, nous pouvons restaurer la base de données de l'instance répliquée à l'aide d'une sauvegarde de base de données afin de commencer la réplication à partir de la base de données principale.
En mode principal, les serveurs d'applications et la base de données fonctionnent de la même manière qu'aujourd'hui, mais la base de données principale est configurée pour permettre la réplication. Exemple :
Activez le journal binaire.
Définissez l'ID du serveur.
Créez un compte utilisateur de réplication.
Créer une sauvegarde
En mode instance répliquée, les serveurs d'applications désactivent le service Web de billetterie pour éviter de se connecter directement à la base de données de l'instance répliquée. La base de données de l'instance dupliquée doit être configurée pour démarrer la réplication à partir de la base de données principale, par exemple :
Définissez l'ID du serveur.
Configurez les identifiants de l'utilisateur de réplication et les détails de la connexion principale, tels que l'hôte et le port.
Restaurez la position du journal binaire à partir de la sauvegarde.
La réplication de base de données nécessite une connectivité réseau pour que l'instance répliquée se connecte à la base de données principale afin de démarrer la réplication. Pour exposer le point de terminaison de la base de données principale pour la réplication, nous utilisons Cloud Service Mesh afin de créer un maillage de services d&#Ingress;entrée compatible avec la terminaison TLS au niveau du maillage de services, de la même manière que nous gérons le transfert de données HTTPS pour l'application Web du système de billetterie.