


Glosarium di Vertex AI Translation di Google Distributed Cloud (GDC) dengan air gap memungkinkan Anda menentukan terminologi khusus domain untuk terjemahan yang konsisten di seluruh pasangan bahasa. Dengan mengonfigurasi pasangan istilah sumber dan target, Anda dapat mengontrol cara layanan menerjemahkan kosakata khusus seperti nama produk, kata-kata ambigu, dan istilah pinjaman.
Entri glosarium dapat terdiri dari satu kata (juga disebut sebagai token) atau frasa pendek, biasanya lebih pendek dari lima kata. Vertex AI Translation menerapkan entri yang cocok selama penerjemahan, tetapi mengabaikan entri yang cocok dengan kata-kata yang diabaikan.
Metode glosarium
Vertex AI Translation menawarkan metode glosarium berikut di GDC:
| Metode | Deskripsi |
|---|---|
CreateGlossary |
Buat glosarium. |
GetGlossary |
Menampilkan glosarium yang disimpan. |
ListGlossaries |
Menampilkan daftar glosarium dalam sebuah project. |
DeleteGlossary |
Menghapus glosarium yang tidak lagi Anda perlukan. |
Sebelum memulai
Sebelum membuat glosarium untuk menentukan terminologi terjemahan, Anda harus memiliki project bernama translation-glossary-project. Resource kustom project harus terlihat seperti contoh berikut:
  apiVersion: resourcemanager.gdc.goog/v1
  kind: Project
  metadata:
    labels:
      atat.config.google.com/clin-number: CLIN_NUMBER
      atat.config.google.com/task-order-number: TASK_ORDER_NUMBER
    name: translation-glossary-project
    namespace: platform
Untuk mendapatkan izin yang diperlukan untuk menggunakan glosarium, minta IAM Project Admin untuk memberi Anda peran berikut di namespace project Anda:
- AI Translation Developer: Dapatkan peran AI Translation Developer (
ai-translation-developer) untuk mengakses layanan Vertex AI Translation. - Project Bucket Admin: Dapatkan peran Project Bucket Admin (
project-bucket-admin) untuk mengelola bucket penyimpanan dan objek dalam bucket, yang memungkinkan Anda membuat dan mengupload file.
Untuk mengetahui informasi selengkapnya tentang prasyarat, lihat Menyiapkan project terjemahan.
Membuat file glosarium
Anda harus membuat file glosarium untuk menyimpan istilah bahasa sumber dan bahasa target. Bagian ini berisi dua tata letak glosarium berbeda yang dapat Anda gunakan untuk menentukan istilah.
Tabel berikut menjelaskan batas yang didukung di Distributed Cloud untuk file glosarium:
| Deskripsi | Batas |
|---|---|
| Ukuran file maksimal | 10,4 juta (10.485.760) byte UTF-8 |
| Panjang maksimum istilah glosarium | 1.024 byte UTF-8 |
| Jumlah maksimum resource glosarium untuk satu project | 10.000 |
Pilih salah satu tata letak berikut untuk file glosarium Anda:
- Glosarium searah: Tentukan terjemahan yang diharapkan untuk pasangan istilah sumber dan target dalam bahasa tertentu. Glosarium searah mendukung format file TSV, CSV, dan TMX.
- Glosarium kumpulan padanan istilah: Tentukan terjemahan yang diharapkan dalam beberapa bahasa di setiap baris. Glosarium kumpulan padanan istilah mendukung format file CSV.
Glosarium searah
Vertex AI Translation API menerima nilai yang dipisahkan tab (TSV) dan
nilai yang dipisahkan koma (CSV). Setiap baris berisi pasangan istilah yang dipisahkan oleh
tab (\t) atau koma (,) untuk format file ini.
Vertex AI Translation API juga menerima format Translation Memory eXchange (TMX), yaitu format XML standar untuk menyediakan pasangan istilah sumber dan target terjemahan. File input yang didukung dalam format berdasarkan TMX versi 1.4.
Contoh berikut menunjukkan struktur yang diperlukan untuk format file TSV, CSV, dan TMX dari glosarium searah:
TSV dan CSV
Gambar berikut menunjukkan dua kolom dalam file TSV atau CSV. Kolom pertama berisi istilah bahasa sumber, dan kolom kedua berisi istilah bahasa target.
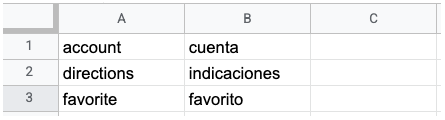
Jangan sertakan baris header dalam file TSV atau CSV searah; baris pertama harus berisi data istilah. Permintaan glosarium membuat file tersedia untuk Vertex AI Translation API.
TMX
Contoh berikut mengilustrasikan struktur yang diperlukan dalam file TMX:
<?xml version='1.0' encoding='utf-8'?>
<!DOCTYPE tmx SYSTEM "tmx14.dtd">
<tmx version="1.4">
  <header segtype="sentence" o-tmf="UTF-8" adminlang="en" srclang="en" datatype="PlainText"/>
  <body>
    <tu>
      <tuv xml:lang="en">
        <seg>account</seg>
      </tuv>
      <tuv xml:lang="es">
        <seg>cuenta</seg>
      </tuv>
    </tu>
    <tu>
      <tuv xml:lang="en">
        <seg>directions</seg>
      </tuv>
      <tuv xml:lang="es">
        <seg>indicaciones</seg>
      </tuv>
    </tu>
  </body>
</tmx>
Jika file Anda berisi tag XML yang tidak ditampilkan dalam contoh ini, Vertex AI Translation API akan mengabaikan tag tersebut.
Sertakan elemen berikut dalam file TMX Anda untuk memastikan pemrosesan yang berhasil oleh Vertex AI Translation API:
<header>: Identifikasi bahasa sumber menggunakan atributsrclang.<tu>: Sertakan sepasang elemen<tuv>dengan bahasa sumber dan target yang sama. Elemen<tuv>ini mematuhi hal berikut:- Setiap elemen
<tuv>mengidentifikasi bahasa teks yang dimuat menggunakan atributxml:lang. Gunakan kode ISO-639-1 untuk mengidentifikasi bahasa sumber dan bahasa target. Lihat daftar bahasa yang didukung dan kode bahasanya masing-masing. - Jika elemen
<tu>berisi lebih dari dua elemen<tuv>, Vertex AI Translation API hanya akan memproses elemen<tuv>pertama yang cocok dengan bahasa sumber dan elemen<tuv>pertama yang cocok dengan bahasa target. Layanan akan mengabaikan elemen<tuv>lainnya. - Jika elemen
<tu>tidak memiliki pasangan elemen<tuv>yang cocok, Vertex AI Translation API akan mengabaikan elemen<tu>yang tidak valid.
- Setiap elemen
<seg>: Mewakili string teks umum. Vertex AI Translation API mengecualikan tag markup dari elemen<seg>sebelum memproses file. Jika elemen<tuv>berisi lebih dari satu elemen<seg>, Vertex AI Translation API akan menggabungkan teks menjadi satu elemen yang dipisahkan dengan spasi di antara string teks.
Setelah mengidentifikasi istilah glosarium dalam glosarium searah, upload file ke bucket penyimpanan dan sediakan untuk Vertex AI Translation API dengan membuat dan mengimpor glosarium.
Glosarium kumpulan padanan istilah
Vertex AI Translation API menerima file glosarium untuk kumpulan padanan istilah menggunakan format CSV. Untuk menentukan kumpulan padanan istilah, buat file CSV multi-kolom yang setiap barisnya mencantumkan satu istilah glosarium dalam beberapa bahasa. Lihat daftar bahasa yang didukung dan kode bahasanya masing-masing.
Gambar berikut menunjukkan contoh file CSV multi-kolom. Setiap baris mewakili istilah glosarium, dan setiap kolom mewakili terjemahan istilah tersebut ke dalam berbagai bahasa.
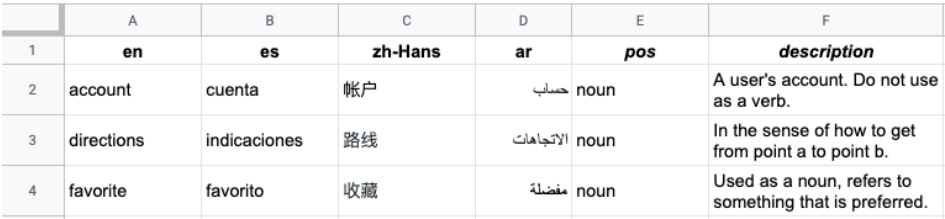
Header adalah baris pertama dalam file, yang mengidentifikasi bahasa untuk setiap
kolom. Baris header menggunakan kode bahasa standar ISO-639-1 atau BCP-47. Vertex AI Translation API tidak menggunakan informasi kelas kata (pos), dan nilai posisi tertentu tidak divalidasi.
Setiap baris berikutnya berisi padanan istilah glosarium dalam bahasa yang diidentifikasi di header. Anda dapat mengosongkan kolom jika istilah tidak tersedia dalam semua bahasa.
Setelah mengidentifikasi istilah glosarium dalam kumpulan padanan istilah, upload file ke bucket penyimpanan dan sediakan untuk Vertex AI Translation API dengan membuat dan mengimpor glosarium.
Mengupload file glosarium ke bucket penyimpanan
Ikuti langkah-langkah berikut untuk mengupload file glosarium ke bucket penyimpanan:
- Konfigurasikan gdcloud CLI untuk penyimpanan objek.
Buat bucket penyimpanan di namespace project Anda. Gunakan kelas penyimpanan
Standard.Anda dapat membuat bucket penyimpanan dengan men-deploy resource
Bucketdi namespace project Anda:apiVersion: object.gdc.goog/v1 kind: Bucket metadata: name: glossary-bucket namespace: translation-glossary-project spec: description: bucket for translation glossary storageClass: Standard bucketPolicy: lockingPolicy: defaultObjectRetentionDays: 90Berikan izin
readpada bucket serta izinget,list, danwatchpadasecretsdi namespace project ke akun layanan (ai-translation-system-sadang-vai-translation-sie-sa) yang digunakan oleh layanan Vertex AI Translation.Ikuti langkah-langkah berikut untuk membuat peran dan binding peran menggunakan resource kustom di server API pengelolaan. Pengguna yang sudah memiliki izin
secretsharus menerapkan resource ini, atau permintaan akan gagal denganattempting to grant RBAC permissions not currently held:Buat peran dengan men-deploy resource
Roledi namespace project:apiVersion: rbac.authorization.k8s.io/v1 kind: Role metadata: name: ai-translation-glossary-reader namespace: translation-glossary-project rules: - apiGroups: - object.gdc.goog resources: - buckets verbs: - read-object - apiGroups: - "" resources: - secrets verbs: - get - list - watchBuat binding peran dengan men-deploy resource
RoleBindingdi namespace project:apiVersion: rbac.authorization.k8s.io/v1 kind: RoleBinding metadata: name: ai-translation-glossary-reader-rolebinding namespace: translation-glossary-project roleRef: apiGroup: rbac.authorization.k8s.io kind: Role name: ai-translation-glossary-reader subjects: - kind: ServiceAccount name: ai-translation-system-sa namespace: g-vai-translation-sie - kind: ServiceAccount name: g-vai-translation-sie-sa namespace: g-vai-translation-sie
Upload file glosarium ke bucket penyimpanan yang Anda buat. Untuk mengetahui informasi selengkapnya, lihat Mengupload dan mendownload objek penyimpanan di project.
Membuat glosarium
Metode CreateGlossary membuat glosarium dan menampilkan ID ke operasi yang berjalan lama yang menghasilkan glosarium.
Untuk membuat glosarium, ganti hal berikut sebelum menggunakan data permintaan apa pun:
ENDPOINT: endpoint Vertex AI Translation yang Anda gunakan untuk organisasi Anda. Untuk mengetahui informasi selengkapnya, lihat status dan endpoint layanan.PROJECT_ID: project ID Anda.BUCKET_NAME: nama bucket penyimpanan tempat file glosarium Anda berada.GLOSSARY_FILENAME: nama file glosarium Anda di bucket penyimpanan.
Berikut adalah sintaksis untuk permintaan HTTP guna membuat glosarium:
POST https://ENDPOINT/v3/projects/PROJECT_ID/glossaries
Berdasarkan file glosarium yang Anda buat, pilih salah satu opsi berikut untuk membuat glosarium:
Searah
Untuk membuat glosarium searah, tentukan pasangan bahasa
(language_pair) dengan bahasa sumber (source_language_code) dan
bahasa target (target_language_code).
Ikuti langkah-langkah berikut untuk membuat glosarium searah:
Simpan isi permintaan berikut dalam file JSON bernama
request.json:{ "language_pair": { "source_language_code": "SOURCE_LANGUAGE", "target_language_code": "TARGET_LANGUAGE" }, "input_config": { "s3_source": { "input_uri": "s3://BUCKET_NAME/GLOSSARY_FILENAME" } } }Ganti kode berikut:
SOURCE_LANGUAGE: kode bahasa dari bahasa sumber glosarium. Lihat daftar bahasa yang didukung dan kode bahasanya masing-masing.TARGET_LANGUAGE: kode bahasa target glosarium. Lihat daftar bahasa yang didukung dan kode bahasanya masing-masing.
Buat permintaan. Contoh berikut menggunakan metode REST API dan command line, tetapi Anda juga dapat menggunakan library klien untuk membuat glosarium searah.
curl
curl -X POST \
-H "Authorization: Bearer TOKEN" \
-H "Content-Type: application/json; charset=utf-8" \
-d @request.json \
"https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
Ganti TOKEN dengan
token autentikasi
yang Anda peroleh.
PowerShell
$cred = TOKEN
$headers = @{ "Authorization" = "Bearer $cred" }
Invoke-WebRequest
  -Method POST
  -Headers $headers
  -ContentType: "application/json; charset=utf-8"
  -InFile request.json
  -Uri "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
  | Select-Object -Expand Content
Ganti TOKEN dengan
token autentikasi
yang Anda peroleh.
Python
Tetapkan variabel lingkungan yang diperlukan pada skrip Python.
Tambahkan kode berikut ke skrip Python yang Anda buat:
import time
import google.auth
import google.auth.transport.requests
import requests

def create_glossary(project_id="PROJECT_ID", input_uri="s3://BUCKET_NAME/GLOSSARY_FILENAME",
                    source_lang_code="SOURCE_LANGUAGE", target_lang_code="TARGET_LANGUAGE"):
    # Client 3.8.0 has no s3_source field, so call REST (token audience without :443).
    creds, _ = google.auth.default()
    creds = creds.with_gdch_audience("https://ENDPOINT")
    creds.refresh(google.auth.transport.requests.Request())
    session = requests.Session()
    session.verify = "CERT_NAME"
    session.headers["Authorization"] = f"Bearer {creds.token}"
    body = {"language_pair": {"source_language_code": source_lang_code,
                              "target_language_code": target_lang_code},
            "input_config": {"s3_source": {"input_uri": input_uri}}}
    r = session.post(f"https://ENDPOINT/v3/projects/{project_id}/glossaries", json=body)
    r.raise_for_status()
    op = r.json()
    while not op.get("done"):
        time.sleep(2)
        op = session.get(f"https://ENDPOINT/v3/{op['name']}").json()
    return op  # The service assigns the glossary ID: op["metadata"]["name"]
Ganti kode berikut:
SOURCE_LANGUAGE: kode bahasa dari bahasa sumber glosarium. Lihat daftar bahasa yang didukung beserta kode bahasanya masing-masing.TARGET_LANGUAGE: kode bahasa target glosarium. Lihat daftar bahasa yang didukung beserta kode bahasanya masing-masing.CERT_NAME: nama file sertifikat Certificate Authority (CA), sepertiorg-1-trust-bundle-ca.cert. Untuk mengetahui informasi selengkapnya, lihat Membuat file sertifikat CA paket kepercayaan di lingkungan pengembangan.
Simpan skrip Python.
Jalankan skrip Python:
python SCRIPT_NAMEGanti
SCRIPT_NAMEdengan nama yang Anda berikan untuk skrip Python, sepertiglossary.py.
Untuk mengetahui informasi selengkapnya tentang metode projects.glossaries.create, lihat referensi REST API Vertex AI Translation.
Anda akan menerima respons JSON yang mirip dengan yang berikut ini:
{
"name": "projects/PROJECT_ID/operations/OPERATION_ID",
"metadata": {
    "@type": "type.googleapis.com/google.cloud.translation.v3.CreateGlossaryMetadata",
    "name": "projects/PROJECT_ID/glossaries/GLOSSARY_ID",
    "state": "RUNNING",
    "submitTime": "TIME"
  }
}
Dalam respons:
OPERATION_ID: ID yang ditetapkan server dari operasi yang berjalan lama yang membuat glosarium. Layanan menampilkan ID ini di kolomnamerespons, atau Anda dapat menemukannya dengan memanggilprojects.operations.list. Anda dapat meneruskanprojects/PROJECT_ID/operations/OPERATION_IDkeprojects.operations.getuntuk memeriksa status operasi pembuatan glosarium.GLOSSARY_ID: ID glosarium yang ditetapkan server (Gdiikuti dengan angka), yang Anda gunakan dalam permintaan dapatkan, terjemahkan, dan hapus.
Kumpulan padanan istilah
Untuk membuat glosarium kumpulan padanan istilah, tentukan kumpulan bahasa
(language_codes_set) dengan kode bahasa (language_codes)
glosarium.
Ikuti langkah-langkah berikut untuk membuat glosarium kumpulan padanan istilah:
Simpan isi permintaan berikut dalam file JSON bernama
request.json:{ "language_codes_set": { "language_codes": ["LANGUAGE_CODE_1", "LANGUAGE_CODE_2", "LANGUAGE_CODE_3" ] }, "input_config": { "s3_source": { "input_uri": "s3://BUCKET_NAME/GLOSSARY_FILENAME" } } }Ganti
LANGUAGE_CODE_1,LANGUAGE_CODE_2, danLANGUAGE_CODE_3dengan kode bahasa glosarium. Lihat daftar bahasa yang didukung beserta kode bahasanya masing-masing.Buat permintaan:
curl
curl -X POST \
    -H "Authorization: Bearer TOKEN" \
    -H "Content-Type: application/json; charset=utf-8" \
    -d @request.json \
    "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
Ganti TOKEN dengan
token autentikasi
yang Anda peroleh.
Anda akan menerima respons JSON yang mirip dengan yang berikut ini:
{
  "name": "projects/PROJECT_ID/operations/OPERATION_ID",
  "metadata": {
    "@type": "type.googleapis.com/google.cloud.translation.v3.CreateGlossaryMetadata",
    "name": "projects/PROJECT_ID/glossaries/GLOSSARY_ID",
    "state": "RUNNING",
    "submitTime": "TIME"
  }
}
Dalam respons:
OPERATION_ID: ID yang ditetapkan server dari operasi yang berjalan lama yang membuat glosarium. Layanan menampilkan ID ini di kolomnamerespons, atau Anda dapat menemukannya dengan memanggilprojects.operations.list. Anda dapat meneruskanprojects/PROJECT_ID/operations/OPERATION_IDkeprojects.operations.getuntuk memeriksa status operasi pembuatan glosarium.GLOSSARY_ID: ID glosarium yang ditetapkan server (Gdiikuti dengan angka), yang Anda gunakan dalam permintaan dapatkan, terjemahkan, dan hapus.
PowerShell
$cred = TOKEN
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
  -Method POST `
  -Headers $headers `
  -ContentType: "application/json; charset=utf-8" `
  -InFile request.json `
  -Uri "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
  | Select-Object -Expand Content
Ganti TOKEN dengan
token autentikasi
yang Anda peroleh.
Anda akan menerima respons JSON yang mirip dengan yang berikut ini:
{
  "name": "projects/PROJECT_ID/operations/OPERATION_ID",
  "metadata": {
    "@type": "type.googleapis.com/google.cloud.translation.v3.CreateGlossaryMetadata",
    "name": "projects/PROJECT_ID/glossaries/GLOSSARY_ID",
    "state": "RUNNING",
    "submitTime": "TIME"
  }
}
Dalam respons:
OPERATION_ID: ID yang ditetapkan server dari operasi yang berjalan lama yang membuat glosarium. Layanan menampilkan ID ini di kolomnamerespons, atau Anda dapat menemukannya dengan memanggilprojects.operations.list. Anda dapat meneruskanprojects/PROJECT_ID/operations/OPERATION_IDkeprojects.operations.getuntuk memeriksa status operasi pembuatan glosarium.GLOSSARY_ID: ID glosarium yang ditetapkan server (Gdiikuti dengan angka), yang Anda gunakan dalam permintaan dapatkan, terjemahkan, dan hapus.
Python
Tetapkan variabel lingkungan yang diperlukan pada skrip Python.
Tambahkan kode berikut ke skrip Python yang Anda buat:
import time
import google.auth
import google.auth.transport.requests
import requests

def create_glossary(project_id="PROJECT_ID", input_uri="s3://BUCKET_NAME/GLOSSARY_FILENAME",
                    lang_1="LANGUAGE_CODE_1", lang_2="LANGUAGE_CODE_2"):
    # Client 3.8.0 has no s3_source field, so call REST (token audience without :443).
    creds, _ = google.auth.default()
    creds = creds.with_gdch_audience("https://ENDPOINT")
    creds.refresh(google.auth.transport.requests.Request())
    session = requests.Session()
    session.verify = "CERT_NAME"
    session.headers["Authorization"] = f"Bearer {creds.token}"
    body = {"language_codes_set": {"language_codes": [lang_1, lang_2]},
            "input_config": {"s3_source": {"input_uri": input_uri}}}
    r = session.post(f"https://ENDPOINT/v3/projects/{project_id}/glossaries", json=body)
    r.raise_for_status()
    op = r.json()
    while not op.get("done"):
        time.sleep(2)
        op = session.get(f"https://ENDPOINT/v3/{op['name']}").json()
    return op  # The service assigns the glossary ID: op["metadata"]["name"]
Ganti kode berikut:
LANGUAGE_CODE_1danLANGUAGE_CODE_2: kode bahasa dari bahasa dalam glosarium. Lihat daftar bahasa yang didukung beserta kode bahasanya masing-masing.CERT_NAME: nama file sertifikat Certificate Authority (CA), sepertiorg-1-trust-bundle-ca.cert. Untuk mengetahui informasi selengkapnya, lihat Membuat file sertifikat CA paket kepercayaan di lingkungan pengembangan.
Simpan skrip Python.
Jalankan skrip Python:
python SCRIPT_NAMEGanti
SCRIPT_NAMEdengan nama yang Anda berikan untuk skrip Python, sepertiglossary.py.
Untuk mengetahui informasi selengkapnya tentang metode projects.glossaries.create, lihat referensi REST API Vertex AI Translation.
Bergantung pada ukuran file glosarium, pembuatan glosarium biasanya memerlukan waktu kurang dari 10 menit. Anda dapat mengambil status operasi ini untuk mengetahui kapan operasi selesai.
Mendapatkan glosarium
Metode GetGlossary menampilkan glosarium yang disimpan. Jika glosarium tidak ada, output akan menampilkan nilai NOT_FOUND. Untuk memanggil metode GetGlossary,
tentukan project ID dan ID glosarium Anda. Metode
CreateGlossary dan ListGlossaries
menampilkan ID glosarium. Vertex AI Translation API hanya menerima permintaan HTTPS.
Misalnya, permintaan berikut menampilkan informasi tentang glosarium tertentu dalam project Anda:
curl
curl -X GET \
   -H "Authorization: Bearer TOKEN" \
   "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries/GLOSSARY_ID"
Ganti TOKEN dengan
token autentikasi
yang Anda peroleh.
Python
from google.cloud import translate_v3 as translate
from google.api_core.client_options import ClientOptions

def get_glossary(creds, name="projects/PROJECT_ID/glossaries/GLOSSARY_ID"):
    """Get a glossary by its full name. The service assigns the glossary ID."""
    client = translate.TranslationServiceClient(
        credentials=creds, client_options=ClientOptions(api_endpoint="ENDPOINT:443"))
    response = client.get_glossary(name=name)
    print(f"Glossary name: {response.name}")
Teruskan kredensial Distributed Cloud (creds) yang dikonfigurasi dengan audiens
https://ENDPOINT:443, seperti yang ditunjukkan dalam
Menerjemahkan teks.
Untuk mengetahui informasi selengkapnya tentang metode get_glossary, lihat library klien Python.
Membuat daftar glosarium
Metode ListGlossaries menampilkan daftar resource Glossary dalam project, yang masing-masing berisi name (projects/PROJECT_ID/glossaries/GLOSSARY_ID) lengkap. Jika project tidak memiliki glosarium, output akan menampilkan {}. Jika project
tidak ada, output akan menampilkan nilai NOT_FOUND. Untuk memanggil metode
ListGlossaries, tentukan project ID dan
endpoint Vertex AI Translation Anda.
Vertex AI Translation API hanya menerima permintaan HTTPS.
Misalnya, permintaan berikut menampilkan glosarium dalam project Anda:
curl -X GET \
    -H "Authorization: Bearer TOKEN" \
    "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries?page_size=10"
Ganti TOKEN dengan
token autentikasi
yang Anda peroleh.
Menghapus glosarium
Metode DeleteGlossary menghapus glosarium. Jika glosarium tidak ada,
output akan menampilkan nilai NOT_FOUND. Untuk memanggil metode DeleteGlossary,
tentukan project ID, ID glosarium, dan
endpoint Vertex AI Translation.
Metode
CreateGlossary dan ListGlossaries
menampilkan ID glosarium. Vertex AI Translation API hanya menerima permintaan HTTPS.
Misalnya, permintaan berikut akan menghapus glosarium dari project Anda:
curl -X DELETE \
    -H "Authorization: Bearer TOKEN" \
    "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries/GLOSSARY_ID"
Ganti TOKEN dengan
token autentikasi
yang Anda peroleh.