


Les glossaires de Vertex AI Translation sur Google Distributed Cloud (GDC) avec air gap vous permettent de définir une terminologie spécifique à un domaine pour une traduction cohérente entre les paires de langues. En configurant des paires de termes source et cible, vous contrôlez la façon dont le service traduit le vocabulaire spécialisé, comme les noms de produits, les mots ambigus et les termes empruntés.
Les entrées de glossaire peuvent être composées de mots simples (également appelés jetons) ou de phrases courtes, généralement de moins de cinq mots. Vertex AI Translation applique les entrées correspondantes lors de la traduction, mais ignore les entrées qui correspondent à des mots vides.
Méthodes de glossaire
Vertex AI Translation propose les méthodes de glossaire suivantes dans GDC :
| Méthode | Description |
|---|---|
CreateGlossary |
Créer un glossaire |
GetGlossary |
Renvoie un glossaire stocké. |
ListGlossaries |
Renvoie la liste des glossaires d'un projet. |
DeleteGlossary |
Supprimer un glossaire dont vous n'avez plus besoin. |
Avant de commencer
Avant de créer un glossaire pour définir votre terminologie de traduction, vous devez disposer d'un projet nommé translation-glossary-project. La ressource personnalisée du projet doit ressembler à l'exemple suivant :
  apiVersion: resourcemanager.gdc.goog/v1
  kind: Project
  metadata:
    labels:
      atat.config.google.com/clin-number: CLIN_NUMBER
      atat.config.google.com/task-order-number: TASK_ORDER_NUMBER
    name: translation-glossary-project
    namespace: platform
Pour obtenir les autorisations nécessaires pour utiliser un glossaire, demandez à l'administrateur de projet IAM de vous accorder les rôles suivants dans l'espace de noms de votre projet :
- Développeur AI Translation : obtenez le rôle Développeur AI Translation (
ai-translation-developer) pour accéder au service Vertex AI Translation. - Administrateur de buckets de projet : obtenez le rôle d'administrateur de buckets de projet (
project-bucket-admin) pour gérer les buckets de stockage et les objets qu'ils contiennent, ce qui vous permet de créer et d'importer des fichiers.
Pour en savoir plus sur les conditions préalables, consultez Configurer un projet de traduction.
Créer un fichier de glossaire
Vous devez créer un fichier de glossaire pour stocker les termes de votre langue source et de votre langue cible. Cette section contient les deux différentes mises en page de glossaire que vous pouvez utiliser pour définir vos termes.
Le tableau suivant décrit les limites applicables aux fichiers de glossaire sur Distributed Cloud :
| Description | Limite |
|---|---|
| Taille maximale du fichier | 10,4 millions (10 485 760) d'octets UTF-8 |
| Longueur maximale d'un terme de glossaire | 1 024 octets UTF-8 |
| Nombre maximal de ressources de glossaire pour un projet | 10 000 |
Choisissez l'une des mises en page suivantes pour votre fichier de glossaire :
- Glossaire unidirectionnel : spécifiez la traduction attendue pour une paire de termes source et cible dans une langue spécifique. Les glossaires unidirectionnels sont compatibles avec les formats de fichiers TSV, CSV et TMX.
- Glossaire d'ensemble de termes équivalents : spécifiez la traduction attendue dans plusieurs langues sur chaque ligne. Les glossaires d'ensembles de termes équivalents sont compatibles avec les formats de fichier CSV.
Glossaire unidirectionnel
L'API Vertex AI Translation accepte les valeurs séparées par des tabulations (TSV) et les valeurs séparées par des virgules (CSV). Chaque ligne contient une paire de termes séparés par une tabulation (\t) ou une virgule (,) pour ces formats de fichier.
L'API Vertex AI Translation accepte également le format TMX (Translation Memory eXchange), un format XML standard permettant de fournir les paires de termes source et cible de la traduction. Les fichiers d'entrée acceptés sont au format TMX, version 1.4.
Les exemples suivants montrent la structure requise pour les formats de fichiers TSV, CSV et TMX des glossaires unidirectionnels :
TSV et CSV
L'image suivante montre deux colonnes dans un fichier TSV ou CSV. La première colonne contient le terme dans la langue source, et la deuxième colonne contient le terme dans la langue cible.
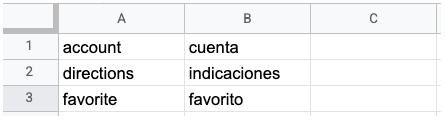
N'incluez pas de ligne d'en-tête dans un fichier TSV ou CSV unidirectionnel. La première ligne doit contenir des données de termes. La requête de glossaire met le fichier à la disposition de l'API Vertex AI Translation.
TMX
L'exemple suivant illustre la structure requise dans un fichier TMX :
<?xml version='1.0' encoding='utf-8'?>
<!DOCTYPE tmx SYSTEM "tmx14.dtd">
<tmx version="1.4">
  <header segtype="sentence" o-tmf="UTF-8" adminlang="en" srclang="en" datatype="PlainText"/>
  <body>
    <tu>
      <tuv xml:lang="en">
        <seg>account</seg>
      </tuv>
      <tuv xml:lang="es">
        <seg>cuenta</seg>
      </tuv>
    </tu>
    <tu>
      <tuv xml:lang="en">
        <seg>directions</seg>
      </tuv>
      <tuv xml:lang="es">
        <seg>indicaciones</seg>
      </tuv>
    </tu>
  </body>
</tmx>
Si votre fichier contient des balises XML qui ne sont pas présentées dans cet exemple, l'API Vertex AI Translation les ignore.
Incluez les éléments suivants dans votre fichier TMX pour vous assurer qu'il est traité correctement par l'API Vertex AI Translation :
<header>: identifiez la langue source à l'aide de l'attributsrclang.<tu>: incluez une paire d'éléments<tuv>avec les mêmes langues source et cible. Ces éléments<tuv>sont conformes aux exigences suivantes :- Chaque élément
<tuv>identifie la langue du texte contenu à l'aide de l'attributxml:lang. Utilisez les codes ISO-639-1 pour identifier les langues source et cible. Consultez la liste des langues acceptées et leurs codes de langue respectifs. - Si un élément
<tu>contient plus de deux éléments<tuv>, l'API Vertex AI Translation ne traite que le premier élément<tuv>correspondant à la langue source et le premier élément<tuv>correspondant à la langue cible. Le service ignore le reste des éléments<tuv>. - Si un élément
<tu>ne comporte pas de paire d'éléments<tuv>correspondante, l'API Vertex AI Translation ignore l'élément<tu>non valide.
- Chaque élément
<seg>: représente des chaînes de texte généralisées. L'API Vertex AI Translation exclut les balises d'un élément<seg>avant de traiter le fichier. Si un élément<tuv>contient plusieurs éléments<seg>, l'API Vertex AI Translation concatène le texte en un seul élément avec un espace entre les chaînes de texte.
Après avoir identifié les termes de glossaire dans votre glossaire unidirectionnel, importez le fichier dans un bucket de stockage et mettez-le à la disposition de l'API Vertex AI Translation en créant et en important un glossaire.
Glossaire des ensembles de termes équivalents
L'API Vertex AI Translation accepte les fichiers de glossaire pour les ensembles de termes équivalents au format CSV. Pour définir des ensembles de termes équivalents, créez un fichier CSV à plusieurs colonnes dans lequel chaque ligne répertorie un terme de glossaire dans plusieurs langues. Consultez la liste des langues acceptées et leurs codes de langue respectifs.
L'image suivante montre un exemple de fichier CSV à plusieurs colonnes. Chaque ligne représente un terme du glossaire, et chaque colonne représente une traduction du terme dans différentes langues.
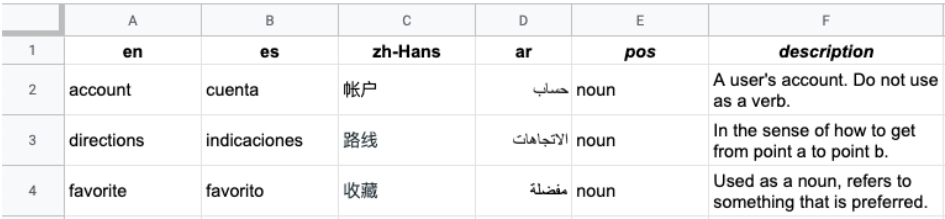
L'en-tête est la première ligne du fichier, qui identifie la langue de chaque colonne. La ligne d'en-tête utilise les codes de langue standards ISO-639-1 ou BCP-47. L'API Vertex AI Translation n'utilise pas les informations de partie du discours (pos), et les valeurs de position spécifiques ne sont pas validées.
Chaque ligne suivante contient des termes de glossaire équivalents dans les langues identifiées dans l'en-tête. Vous pouvez laisser des colonnes vides si le terme n'est pas disponible dans toutes les langues.
Après avoir identifié les termes du glossaire dans votre ensemble de termes équivalents, importez le fichier dans un bucket de stockage et mettez-le à la disposition de l'API Vertex AI Translation en créant et en important un glossaire.
Importer votre fichier de glossaire dans un bucket de stockage
Pour importer votre fichier de glossaire dans un bucket de stockage, procédez comme suit :
- Configurez la CLI gdcloud pour le stockage d'objets.
Créez un bucket de stockage dans l'espace de noms de votre projet. Utilisez une classe de stockage
Standard.Vous pouvez créer le bucket de stockage en déployant une ressource
Bucketdans l'espace de noms de votre projet :apiVersion: object.gdc.goog/v1 kind: Bucket metadata: name: glossary-bucket namespace: translation-glossary-project spec: description: bucket for translation glossary storageClass: Standard bucketPolicy: lockingPolicy: defaultObjectRetentionDays: 90Accordez les autorisations
readsur le bucket et les autorisationsget,listetwatchsursecretsdans l'espace de noms du projet aux comptes de service (ai-translation-system-saetg-vai-translation-sie-sa) utilisés par le service Vertex AI Translation.Suivez ces étapes pour créer le rôle et la liaison de rôle à l'aide de ressources personnalisées sur le serveur d'API de gestion. Un utilisateur qui dispose déjà des autorisations
secretsdoit appliquer ces ressources, sinon la requête échoue avec l'erreurattempting to grant RBAC permissions not currently held:Créez le rôle en déployant une ressource
Roledans l'espace de noms du projet :apiVersion: rbac.authorization.k8s.io/v1 kind: Role metadata: name: ai-translation-glossary-reader namespace: translation-glossary-project rules: - apiGroups: - object.gdc.goog resources: - buckets verbs: - read-object - apiGroups: - "" resources: - secrets verbs: - get - list - watchCréez la liaison de rôle en déployant une ressource
RoleBindingdans l'espace de noms du projet :apiVersion: rbac.authorization.k8s.io/v1 kind: RoleBinding metadata: name: ai-translation-glossary-reader-rolebinding namespace: translation-glossary-project roleRef: apiGroup: rbac.authorization.k8s.io kind: Role name: ai-translation-glossary-reader subjects: - kind: ServiceAccount name: ai-translation-system-sa namespace: g-vai-translation-sie - kind: ServiceAccount name: g-vai-translation-sie-sa namespace: g-vai-translation-sie
Importez votre fichier de glossaire dans le bucket de stockage que vous avez créé. Pour en savoir plus, consultez Importer et télécharger des objets de stockage dans des projets.
Créer un glossaire
La méthode CreateGlossary crée un glossaire et renvoie l'identifiant à l'opération de longue durée qui génère le glossaire.
Pour créer un glossaire, remplacez les éléments suivants avant d'utiliser les données de requête :
ENDPOINT: point de terminaison Vertex AI Translation que vous utilisez pour votre organisation. Pour en savoir plus, consultez l'état et les points de terminaison du service.PROJECT_ID: ID de votre projet.BUCKET_NAME: nom du bucket de stockage où se trouve le fichier de glossaire.GLOSSARY_FILENAME: nom de votre fichier de glossaire dans le bucket de stockage.
Voici la syntaxe d'une requête HTTP permettant de créer un glossaire :
POST https://ENDPOINT/v3/projects/PROJECT_ID/glossaries
En fonction du fichier de glossaire que vous avez créé, choisissez l'une des options suivantes pour créer un glossaire :
Unidirectionnel
Pour créer un glossaire unidirectionnel, spécifiez une paire de langues (language_pair) avec une langue source (source_language_code) et une langue cible (target_language_code).
Pour créer un glossaire unidirectionnel, procédez comme suit :
Enregistrez le corps de requête suivant dans un fichier JSON nommé
request.json:{ "language_pair": { "source_language_code": "SOURCE_LANGUAGE", "target_language_code": "TARGET_LANGUAGE" }, "input_config": { "s3_source": { "input_uri": "s3://BUCKET_NAME/GLOSSARY_FILENAME" } } }Remplacez les éléments suivants :
SOURCE_LANGUAGE: code de la langue source du glossaire. Consultez la liste des langues acceptées et leurs codes de langue respectifs.TARGET_LANGUAGE: code de la langue cible du glossaire. Consultez la liste des langues acceptées et leurs codes de langue respectifs.
Envoyez la requête. Les exemples suivants utilisent une méthode de l'API REST et la ligne de commande, mais vous pouvez également utiliser des bibliothèques clientes pour créer un glossaire unidirectionnel.
curl
curl -X POST \
-H "Authorization: Bearer TOKEN" \
-H "Content-Type: application/json; charset=utf-8" \
-d @request.json \
"https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
Remplacez TOKEN par le jeton d'authentification que vous avez obtenu.
PowerShell
$cred = TOKEN
$headers = @{ "Authorization" = "Bearer $cred" }
Invoke-WebRequest
  -Method POST
  -Headers $headers
  -ContentType: "application/json; charset=utf-8"
  -InFile request.json
  -Uri "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
  | Select-Object -Expand Content
Remplacez TOKEN par le jeton d'authentification que vous avez obtenu.
Python
Installez la dernière version de la bibliothèque cliente Vertex AI Translation.
Définissez les variables d'environnement requises dans un script Python.
Ajoutez le code suivant au script Python que vous avez créé :
import time
import google.auth
import google.auth.transport.requests
import requests

def create_glossary(project_id="PROJECT_ID", input_uri="s3://BUCKET_NAME/GLOSSARY_FILENAME",
                    source_lang_code="SOURCE_LANGUAGE", target_lang_code="TARGET_LANGUAGE"):
    # Client 3.8.0 has no s3_source field, so call REST (token audience without :443).
    creds, _ = google.auth.default()
    creds = creds.with_gdch_audience("https://ENDPOINT")
    creds.refresh(google.auth.transport.requests.Request())
    session = requests.Session()
    session.verify = "CERT_NAME"
    session.headers["Authorization"] = f"Bearer {creds.token}"
    body = {"language_pair": {"source_language_code": source_lang_code,
                              "target_language_code": target_lang_code},
            "input_config": {"s3_source": {"input_uri": input_uri}}}
    r = session.post(f"https://ENDPOINT/v3/projects/{project_id}/glossaries", json=body)
    r.raise_for_status()
    op = r.json()
    while not op.get("done"):
        time.sleep(2)
        op = session.get(f"https://ENDPOINT/v3/{op['name']}").json()
    return op  # The service assigns the glossary ID: op["metadata"]["name"]
Remplacez les éléments suivants :
SOURCE_LANGUAGE: code de la langue source du glossaire. Consultez la liste des langues acceptées et leurs codes de langue respectifs.TARGET_LANGUAGE: code de la langue cible du glossaire. Consultez la liste des langues acceptées et leurs codes de langue respectifs.CERT_NAME: nom du fichier de certificat (CA) de l'autorité de certification, tel queorg-1-trust-bundle-ca.cert. Pour en savoir plus, consultez Générer le fichier de certificat CA du groupe d'approbations dans un environnement de développement.
Enregistrez le script Python.
Exécutez le script Python :
python SCRIPT_NAMERemplacez
SCRIPT_NAMEpar le nom que vous avez donné à votre script Python, par exempleglossary.py.
Pour en savoir plus sur la méthode projects.glossaries.create, consultez la documentation de référence de l'API REST Vertex AI Translation.
Vous devez recevoir une réponse JSON semblable à la suivante :
{
"name": "projects/PROJECT_ID/operations/OPERATION_ID",
"metadata": {
    "@type": "type.googleapis.com/google.cloud.translation.v3.CreateGlossaryMetadata",
    "name": "projects/PROJECT_ID/glossaries/GLOSSARY_ID",
    "state": "RUNNING",
    "submitTime": "TIME"
  }
}
Dans la réponse :
OPERATION_ID: ID attribué par le serveur de l'opération de longue durée qui crée le glossaire. Le service renvoie cet ID dans le champnamede la réponse. Vous pouvez également le trouver en appelantprojects.operations.list. Vous pouvez transmettreprojects/PROJECT_ID/operations/OPERATION_IDàprojects.operations.getpour vérifier l'état de l'opération de création du glossaire.GLOSSARY_ID: ID du glossaire attribué par le serveur (Gsuivi de chiffres), que vous utilisez dans les requêtes d'obtention, de traduction et de suppression.
Ensemble de termes équivalents
Pour créer un glossaire d'ensemble de termes équivalents, spécifiez un ensemble de langues (language_codes_set) avec les codes de langue (language_codes) du glossaire.
Pour créer un glossaire d'ensembles de termes équivalents, procédez comme suit :
Enregistrez le corps de requête suivant dans un fichier JSON nommé
request.json:{ "language_codes_set": { "language_codes": ["LANGUAGE_CODE_1", "LANGUAGE_CODE_2", "LANGUAGE_CODE_3" ] }, "input_config": { "s3_source": { "input_uri": "s3://BUCKET_NAME/GLOSSARY_FILENAME" } } }Remplacez
LANGUAGE_CODE_1,LANGUAGE_CODE_2etLANGUAGE_CODE_3par les codes des langues du glossaire. Consultez la liste des langues acceptées et leurs codes de langue respectifs.Envoyez la requête :
curl
curl -X POST \
    -H "Authorization: Bearer TOKEN" \
    -H "Content-Type: application/json; charset=utf-8" \
    -d @request.json \
    "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
Remplacez TOKEN par le jeton d'authentification que vous avez obtenu.
Vous devez recevoir une réponse JSON semblable à la suivante :
{
  "name": "projects/PROJECT_ID/operations/OPERATION_ID",
  "metadata": {
    "@type": "type.googleapis.com/google.cloud.translation.v3.CreateGlossaryMetadata",
    "name": "projects/PROJECT_ID/glossaries/GLOSSARY_ID",
    "state": "RUNNING",
    "submitTime": "TIME"
  }
}
Dans la réponse :
OPERATION_ID: ID attribué par le serveur de l'opération de longue durée qui crée le glossaire. Le service renvoie cet ID dans le champnamede la réponse. Vous pouvez également le trouver en appelantprojects.operations.list. Vous pouvez transmettreprojects/PROJECT_ID/operations/OPERATION_IDàprojects.operations.getpour vérifier l'état de l'opération de création du glossaire.GLOSSARY_ID: ID du glossaire attribué par le serveur (Gsuivi de chiffres), que vous utilisez dans les requêtes d'obtention, de traduction et de suppression.
PowerShell
$cred = TOKEN
$headers = @{ "Authorization" = "Bearer $cred" }

Invoke-WebRequest `
  -Method POST `
  -Headers $headers `
  -ContentType: "application/json; charset=utf-8" `
  -InFile request.json `
  -Uri "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries"
  | Select-Object -Expand Content
Remplacez TOKEN par le jeton d'authentification que vous avez obtenu.
Vous devez recevoir une réponse JSON semblable à la suivante :
{
  "name": "projects/PROJECT_ID/operations/OPERATION_ID",
  "metadata": {
    "@type": "type.googleapis.com/google.cloud.translation.v3.CreateGlossaryMetadata",
    "name": "projects/PROJECT_ID/glossaries/GLOSSARY_ID",
    "state": "RUNNING",
    "submitTime": "TIME"
  }
}
Dans la réponse :
OPERATION_ID: ID attribué par le serveur de l'opération de longue durée qui crée le glossaire. Le service renvoie cet ID dans le champnamede la réponse. Vous pouvez également le trouver en appelantprojects.operations.list. Vous pouvez transmettreprojects/PROJECT_ID/operations/OPERATION_IDàprojects.operations.getpour vérifier l'état de l'opération de création du glossaire.GLOSSARY_ID: ID du glossaire attribué par le serveur (Gsuivi de chiffres), que vous utilisez dans les requêtes d'obtention, de traduction et de suppression.
Python
Installez la dernière version de la bibliothèque cliente Vertex AI Translation.
Définissez les variables d'environnement requises dans un script Python.
Ajoutez le code suivant au script Python que vous avez créé :
import time
import google.auth
import google.auth.transport.requests
import requests

def create_glossary(project_id="PROJECT_ID", input_uri="s3://BUCKET_NAME/GLOSSARY_FILENAME",
                    lang_1="LANGUAGE_CODE_1", lang_2="LANGUAGE_CODE_2"):
    # Client 3.8.0 has no s3_source field, so call REST (token audience without :443).
    creds, _ = google.auth.default()
    creds = creds.with_gdch_audience("https://ENDPOINT")
    creds.refresh(google.auth.transport.requests.Request())
    session = requests.Session()
    session.verify = "CERT_NAME"
    session.headers["Authorization"] = f"Bearer {creds.token}"
    body = {"language_codes_set": {"language_codes": [lang_1, lang_2]},
            "input_config": {"s3_source": {"input_uri": input_uri}}}
    r = session.post(f"https://ENDPOINT/v3/projects/{project_id}/glossaries", json=body)
    r.raise_for_status()
    op = r.json()
    while not op.get("done"):
        time.sleep(2)
        op = session.get(f"https://ENDPOINT/v3/{op['name']}").json()
    return op  # The service assigns the glossary ID: op["metadata"]["name"]
Remplacez les éléments suivants :
LANGUAGE_CODE_1etLANGUAGE_CODE_2: codes de langue des langues du glossaire. Consultez la liste des langues acceptées et leurs codes de langue respectifs.CERT_NAME: nom du fichier de certificat (CA) de l'autorité de certification, tel queorg-1-trust-bundle-ca.cert. Pour en savoir plus, consultez Générer le fichier de certificat CA du groupe d'approbations dans un environnement de développement.
Enregistrez le script Python.
Exécutez le script Python :
python SCRIPT_NAMERemplacez
SCRIPT_NAMEpar le nom que vous avez donné à votre script Python, par exempleglossary.py.
Pour en savoir plus sur la méthode projects.glossaries.create, consultez la documentation de référence de l'API REST Vertex AI Translation.
Selon la taille du fichier de glossaire, la création d'un glossaire prend généralement moins de 10 minutes. Vous pouvez récupérer l'état de cette opération pour savoir quand elle est terminée.
Obtenir un glossaire
La méthode GetGlossary renvoie un glossaire stocké. Si le glossaire n'existe pas, la sortie renvoie la valeur NOT_FOUND. Pour appeler la méthode GetGlossary, spécifiez l'ID du projet et l'ID du glossaire. Les méthodes CreateGlossary et ListGlossaries renvoient l'ID du glossaire. L'API Vertex AI Translation n'accepte que les requêtes HTTPS.
Par exemple, les requêtes suivantes renvoient des informations sur un glossaire spécifique de votre projet :
curl
curl -X GET \
   -H "Authorization: Bearer TOKEN" \
   "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries/GLOSSARY_ID"
Remplacez TOKEN par le jeton d'authentification que vous avez obtenu.
Python
from google.cloud import translate_v3 as translate
from google.api_core.client_options import ClientOptions

def get_glossary(creds, name="projects/PROJECT_ID/glossaries/GLOSSARY_ID"):
    """Get a glossary by its full name. The service assigns the glossary ID."""
    client = translate.TranslationServiceClient(
        credentials=creds, client_options=ClientOptions(api_endpoint="ENDPOINT:443"))
    response = client.get_glossary(name=name)
    print(f"Glossary name: {response.name}")
Transmettez les identifiants Distributed Cloud (creds) configurés avec l'audience https://ENDPOINT:443, comme indiqué dans Traduire du texte.
Pour en savoir plus sur la méthode get_glossary, consultez la bibliothèque cliente Python.
Répertorier des glossaires
La méthode ListGlossaries renvoie une liste de ressources Glossary dans un projet, chacune contenant le name complet (projects/PROJECT_ID/glossaries/GLOSSARY_ID). Si le projet ne comporte aucun glossaire, la sortie renvoie {}. Si le projet n'existe pas, la sortie renvoie la valeur NOT_FOUND. Pour appeler la méthode ListGlossaries, spécifiez l'ID de votre projet et le point de terminaison Vertex AI Translation.
L'API Vertex AI Translation n'accepte que les requêtes HTTPS.
Par exemple, la requête suivante renvoie les glossaires de votre projet :
curl -X GET \
    -H "Authorization: Bearer TOKEN" \
    "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries?page_size=10"
Remplacez TOKEN par le jeton d'authentification que vous avez obtenu.
Supprimer un glossaire
La méthode DeleteGlossary supprime un glossaire. Si le glossaire n'existe pas, la sortie renvoie la valeur NOT_FOUND. Pour appeler la méthode DeleteGlossary, spécifiez l'ID de votre projet, l'ID du glossaire et le point de terminaison Vertex AI Translation.
Les méthodes CreateGlossary et ListGlossaries renvoient l'ID du glossaire. L'API Vertex AI Translation n'accepte que les requêtes HTTPS.
Par exemple, la requête suivante supprime un glossaire de votre projet :
curl -X DELETE \
    -H "Authorization: Bearer TOKEN" \
    "https://ENDPOINT/v3/projects/PROJECT_ID/glossaries/GLOSSARY_ID"
Remplacez TOKEN par le jeton d'authentification que vous avez obtenu.