


Présentation
Le serveur d'historique persistant (PHS) de Managed Service pour Apache Spark fournit des interfaces Web permettant d'afficher l'historique des jobs exécutés sur des clusters Managed Service pour Apache Spark actifs ou supprimés. Il est disponible dans la version d'image 1.5 et ultérieure de Managed Service pour Apache Spark, et s'exécute sur un cluster Managed Service pour Apache Spark à nœud unique. Il fournit des interfaces Web aux fichiers et données suivants :
Fichiers d'historique des jobs MapReduce et Spark
Fichiers d'historique des jobs Flink (consultez Composant Flink facultatif de Dataproc pour créer un cluster Managed Service pour Apache Spark afin d'exécuter des jobs Flink)
Fichiers de données de l'historique de l'application créés par le service d'historique YARN v2 et stockés dans une instance Bigtable.
Journaux d'agrégation YARN
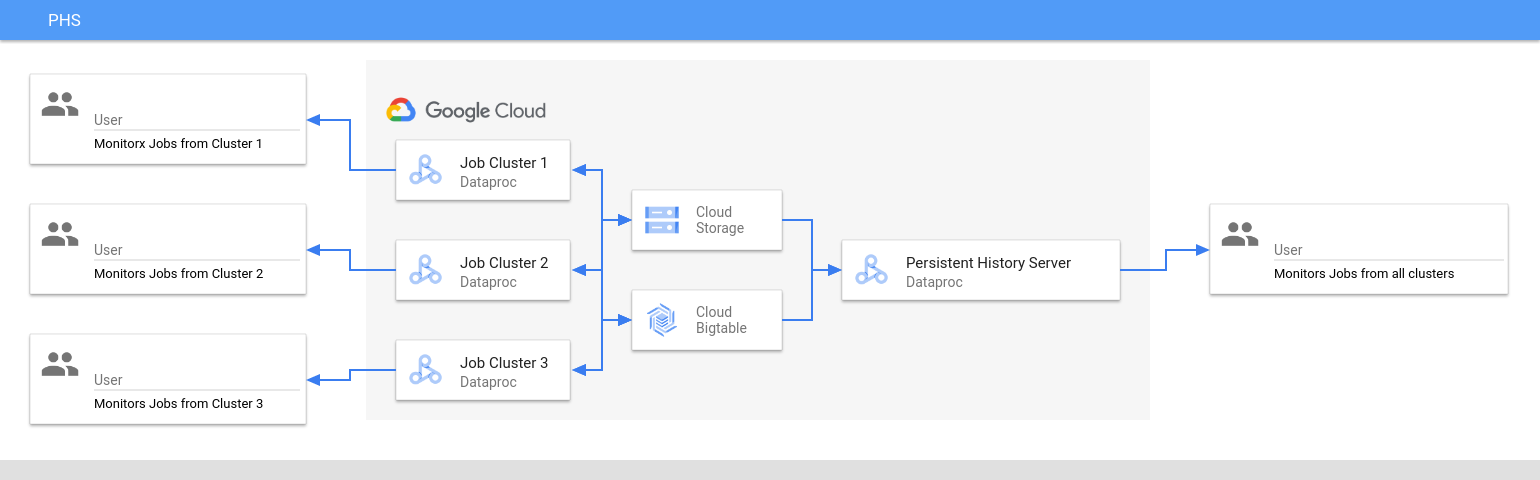
Le serveur d'historique persistant accède aux fichiers d'historique des jobs Spark et MapReduce, aux fichiers d'historique des jobs Flink et aux fichiers journaux YARN écrits dans Cloud Storage pendant la durée de vie des clusters de jobs Managed Service pour Apache Spark, et les affiche.
Limites
La version de l'image du cluster PHS et la version de l'image du ou des clusters de jobs Managed Service pour Apache Spark doivent correspondre. Par exemple, vous pouvez utiliser un cluster PHS de version d'image Managed Service pour Apache Spark 2.0 pour afficher les fichiers d'historique des jobs qui ont été exécutés sur des clusters de jobs de version d'image Managed Service pour Apache Spark 2.0 situés dans le projet où se trouve le cluster PHS.
Un cluster PHS n'est pas compatible avec Kerberos et l'authentification personnelle.
Créer un cluster PHS Managed Service pour Apache Spark
Vous pouvez exécuter la commande gcloud dataproc clusters create suivante dans un terminal local ou dans Cloud Shell avec les options et les propriétés de cluster suivantes pour créer un cluster à nœud unique Managed Service pour Apache Spark Persistent History Server.
gcloud dataproc clusters create CLUSTER_NAME \
    --project=PROJECT \
    --region=REGION \
    --single-node \
    --enable-component-gateway \
    --optional-components=COMPONENT \
    --properties=PROPERTIES
- CLUSTER_NAME : spécifiez le nom du cluster PHS.
- PROJECT : spécifiez le projet à associer au cluster PHS. Ce projet doit être le même que celui associé au cluster qui exécute vos jobs (voir Créer un cluster de jobs Dataproc).
- REGION : spécifiez une région Compute Engine où se trouvera le cluster PHS.
--single-node: un cluster PHS est un cluster à nœud unique Dataproc.--enable-component-gateway: cette option active les interfaces Web de la passerelle des composants sur le cluster PHS.- COMPONENT : utilisez cette option pour installer un ou plusieurs composants facultatifs sur le cluster. Vous devez spécifier le composant facultatif
FLINKpour exécuter le service Web Flink HistoryServer sur le cluster PHS afin d'afficher les fichiers d'historique des jobs Flink. - PROPERTIES. Spécifiez une ou plusieurs propriétés de cluster.
Vous pouvez également ajouter l'option --image-version pour spécifier la version de l'image du cluster PHS. La version de l'image PHS doit correspondre à la version de l'image du ou des clusters de jobs Managed Service pour Apache Spark. Consultez la section Limites.
Remarques :
- Les exemples de valeurs de propriété de cette section utilisent un caractère générique "*" pour permettre au PHS de correspondre à plusieurs répertoires du bucket spécifié dans lequel différents clusters de jobs écrivent (mais consultez la section Considérations sur l'efficacité des caractères génériques).
- Les options
--propertiesdistinctes sont présentées dans les exemples suivants pour faciliter la lisibilité. La pratique recommandée lorsque vous utilisezgcloud dataproc clusters createpour créer un cluster Managed Service pour Apache Spark consiste à utiliser un flag--propertiespour spécifier une liste de propriétés séparées par une virgule (voir Mise en forme des propriétés du cluster).
Propriétés :
yarn:yarn.nodemanager.remote-app-log-dir=gs://bucket-name/*/yarn-logs: ajoutez cette propriété pour spécifier l'emplacement Cloud Storage où le PHS accédera aux journaux YARN écrits par les clusters de jobs.spark:spark.history.fs.logDirectory=gs://bucket-name/*/spark-job-history: ajoutez cette propriété pour activer l'historique persistant des jobs Spark. Cette propriété spécifie l'emplacement où le PHS accédera aux journaux d'historique des jobs Spark écrits par les clusters de jobs.Dans les clusters Managed Service pour Apache Spark 2.0 ou version ultérieure, les deux propriétés suivantes doivent également être définies pour activer les journaux d'historique PHS Spark (voir Options de configuration du serveur d'historique Spark). La valeur
spark.history.custom.executor.log.urlest une valeur littérale qui contient des {{ESPACES RÉSERVÉS}} pour les variables qui seront définies par le serveur d'historique persistant. Ces variables ne sont pas définies par les utilisateurs. Transmettez la valeur de la propriété comme indiqué.--properties=spark:spark.history.custom.executor.log.url.applyIncompleteApplication=false
--properties=spark:spark.history.custom.executor.log.url={{YARN_LOG_SERVER_URL}}/{{NM_HOST}}:{{NM_PORT}}/{{CONTAINER_ID}}/{{CONTAINER_ID}}/{{USER}}/{{FILE_NAME}}mapred:mapreduce.jobhistory.read-only.dir-pattern=gs://bucket-name/*/mapreduce-job-history/done: ajoutez cette propriété pour activer l'historique persistant des jobs MapReduce. Cette propriété spécifie l'emplacement Cloud Storage où le PHS accédera aux journaux d'historique des jobs MapReduce écrits par les clusters de jobs.dataproc:yarn.atsv2.bigtable.instance=projects/project-id/instance_id/bigtable-instance-id: après avoir configuré Yarn Timeline Service v2, ajoutez cette propriété pour utiliser le cluster PHS afin d'afficher les données de l'historique sur les interfaces Web YARN Application Timeline Service V2 et Tez (voir Interfaces Web de la passerelle des composants).flink:historyserver.archive.fs.dir=gs://bucket-name/*/flink-job-history/completed-jobs: utilisez cette propriété pour configurer leHistoryServerFlink afin de surveiller une liste de répertoires séparés par une virgule.
Exemples de propriétés :
--properties=spark:spark.history.fs.logDirectory=gs://bucket-name/*/spark-job-history
--properties=mapred:mapreduce.jobhistory.read-only.dir-pattern=gs://bucket-name/*/mapreduce-job-history/done
--properties=flink:flink.historyserver.archive.fs.dir=gs://bucket-name/*/flink-job-history/completed-jobs
Créer un cluster de jobs Managed Service pour Apache Spark
Vous pouvez exécuter la commande suivante dans un terminal local ou dans Cloud Shell pour créer un cluster de jobs Managed Service pour Apache Spark qui exécute des jobs et écrit des fichiers d'historique des jobs sur un serveur d'historique persistant (PHS).
gcloud dataproc clusters create CLUSTER_NAME \ --project=PROJECT \ --region=REGION \ --optional-components=COMPONENT \ --enable-component-gateway \ --properties=PROPERTIES \ other args ...
- CLUSTER_NAME : spécifiez le nom du cluster de jobs.
- PROJECT : spécifiez le projet associé au cluster de jobs.
- REGION : spécifiez la région Compute Engine où se trouvera le cluster de jobs.
--enable-component-gateway: cette option active les interfaces Web de la passerelle des composants sur le cluster de jobs.- COMPONENT : utilisez cette option pour installer un ou plusieurs composants facultatifs sur le cluster. Spécifiez le composant facultatif
FLINKpour exécuter des jobs Flink sur le cluster. PROPERTIES : ajoutez une ou plusieurs des propriétés de cluster suivantes pour définir des emplacements Cloud Storage non définis par défaut liés à l'historique persistant et d'autres propriétés de cluster de jobs.
Remarques :
- Les exemples de valeurs de propriété de cette section utilisent un caractère générique "*" pour permettre au PHS de correspondre à plusieurs répertoires du bucket spécifié dans lequel différents clusters de jobs écrivent (mais consultez la section Considérations sur l'efficacité des caractères génériques).
- Les options
--propertiesdistinctes sont présentées dans les exemples suivants pour faciliter la lisibilité. La pratique recommandée lorsque vous utilisezgcloud dataproc clusters createpour créer un cluster Managed Service pour Apache Spark consiste à utiliser un flag--propertiespour spécifier une liste de propriétés séparées par une virgule (voir Mise en forme des propriétés du cluster).
Propriétés :
yarn:yarn.nodemanager.remote-app-log-dir: par défaut, les journaux YARN agrégés sont activés sur les clusters de jobs Managed Service pour Apache Spark et écrits dans le bucket temporaire du cluster. Ajoutez cette propriété pour spécifier un autre emplacement Cloud Storage où le cluster écrira les journaux d'agrégation pour l'accès par le serveur d'historique persistant.--properties=yarn:yarn.nodemanager.remote-app-log-dir=gs://bucket-name/directory-name/yarn-logs
spark:spark.history.fs.logDirectoryetspark:spark.eventLog.dir: par défaut, les fichiers d'historique des jobs Spark sont enregistrés dans le buckettemp bucketdu cluster, dans le répertoire/spark-job-history. Vous pouvez ajouter ces propriétés pour spécifier différents emplacements Cloud Storage pour ces fichiers. Si les deux propriétés sont utilisées, elles doivent pointer vers des répertoires du même bucket.--properties=spark:spark.history.fs.logDirectory=gs://bucket-name/directory-name/spark-job-history
--properties=spark:spark.eventLog.dir=gs://bucket-name/directory-name/spark-job-history
mapred:mapreduce.jobhistory.done-diretmapred:mapreduce.jobhistory.intermediate-done-dir: par défaut, les fichiers d'historique des jobs MapReduce sont enregistrés dans letemp bucketdu cluster, dans les répertoires/mapreduce-job-history/doneet/mapreduce-job-history/intermediate-done. L'emplacement intermédiairemapreduce.jobhistory.intermediate-done-direst un espace de stockage temporaire. Les fichiers intermédiaires sont déplacés vers l'emplacementmapreduce.jobhistory.done-dirune fois le job MapReduce terminé. Vous pouvez ajouter ces propriétés pour spécifier différents emplacements Cloud Storage pour ces fichiers. Si les deux propriétés sont utilisées, elles doivent pointer vers des répertoires du même bucket.--properties=mapred:mapreduce.jobhistory.done-dir=gs://bucket-name/directory-name/mapreduce-job-history/done
--properties=mapred:mapreduce.jobhistory.intermediate-done-dir=gs://bucket-name/directory-name/mapreduce-job-history/intermediate-done
spark:spark.history.fs.gs.outputstream.type: cette propriété s'applique aux clusters de version d'image2.0et2.1qui utilisent la version2.0.xdu connecteur Cloud Storage (version du connecteur par défaut pour les clusters de version d'image2.0et2.1). Il contrôle la façon dont les jobs Spark envoient des données à Cloud Storage. Le paramètre par défaut estBASIC, qui envoie les données à Cloud Storage une fois le job terminé. Lorsque la valeur est définie surFLUSHABLE_COMPOSITE, les données sont copiées dans Cloud Storage à intervalles réguliers pendant l'exécution du job, comme défini parspark:spark.history.fs.gs.outputstream.sync.min.interval.ms.--properties=spark:spark.history.fs.gs.outputstream.type=FLUSHABLE_COMPOSITE
spark:spark.history.fs.gs.outputstream.sync.min.interval.ms: cette propriété s'applique aux clusters de version d'image2.0et2.1qui utilisent la version2.0.xdu connecteur Cloud Storage (version du connecteur par défaut pour les clusters de version d'image2.0et2.1). Il contrôle la fréquence en millisecondes à laquelle les données sont transférées vers Cloud Storage lorsquespark:spark.history.fs.gs.outputstream.typeest défini surFLUSHABLE_COMPOSITE. L'intervalle de temps par défaut est5000ms. La valeur de l'intervalle de temps en millisecondes peut être spécifiée avec ou sans le suffixems.--properties=spark:spark.history.fs.gs.outputstream.sync.min.interval.ms=INTERVALms
spark:spark.history.fs.gs.outputstream.sync.min.interval: cette propriété s'applique aux clusters de version d'image2.2et ultérieures qui utilisent la version3.0.xdu connecteur Cloud Storage (version par défaut du connecteur pour les clusters de version d'image2.2). Elle remplace l'ancienne propriétéspark:spark.history.fs.gs.outputstream.sync.min.interval.mset accepte les valeurs avec suffixe temporel, telles quems,setm. Il contrôle la fréquence à laquelle les données sont transférées vers Cloud Storage lorsquespark:spark.history.fs.gs.outputstream.typeest défini surFLUSHABLE_COMPOSITE.--properties=spark:spark.history.fs.gs.outputstream.sync.min.interval=INTERVAL
dataproc:yarn.atsv2.bigtable.instance: après avoir configuré Yarn Timeline Service v2, ajoutez cette propriété pour écrire les données de l'historique YARN dans l'instance Bigtable spécifiée afin de les afficher sur les interfaces Web YARN Application Timeline Service V2 et Tez du cluster PHS. Remarque : La création du cluster échouera si l'instance Bigtable n'existe pas.--properties=dataproc:yarn.atsv2.bigtable.instance=projects/project-id/instance_id/bigtable-instance-id
flink:jobhistory.archive.fs.dir: le JobManager Flink archive les jobs Flink terminés en important les informations sur les jobs archivés dans un répertoire du système de fichiers. Utilisez cette propriété pour définir le répertoire d'archive dansflink-conf.yaml.--properties=flink:jobmanager.archive.fs.dir=gs://bucket-name/job-cluster-1/flink-job-history/completed-jobs
Utiliser PHS avec des charges de travail par lot Spark
Pour utiliser le serveur d'historique persistant avec Managed Service pour Apache Spark Serverless pour les charges de travail par lot Spark :
Sélectionnez ou spécifiez le cluster PHS lorsque vous envoyez une charge de travail par lot Spark.
Utiliser le PHS avec Managed Service pour Apache Spark sur Google Kubernetes Engine
Pour utiliser le serveur d'historique persistant avec Managed Service pour Apache Spark sur GKE :
Sélectionnez ou spécifiez le cluster PHS lorsque vous créez un cluster virtuel Managed Service pour Apache Spark sur GKE.
Interfaces Web de la passerelle des composants
Dans la console Google Cloud , sur la page Clusters de Managed Service pour Apache Spark, cliquez sur le nom du cluster PHS pour ouvrir la page Détails du cluster. Dans l'onglet Interfaces Web, sélectionnez les liens de la passerelle des composants pour ouvrir les interfaces Web exécutées sur le cluster PHS.

Interface Web du serveur d'historique Spark
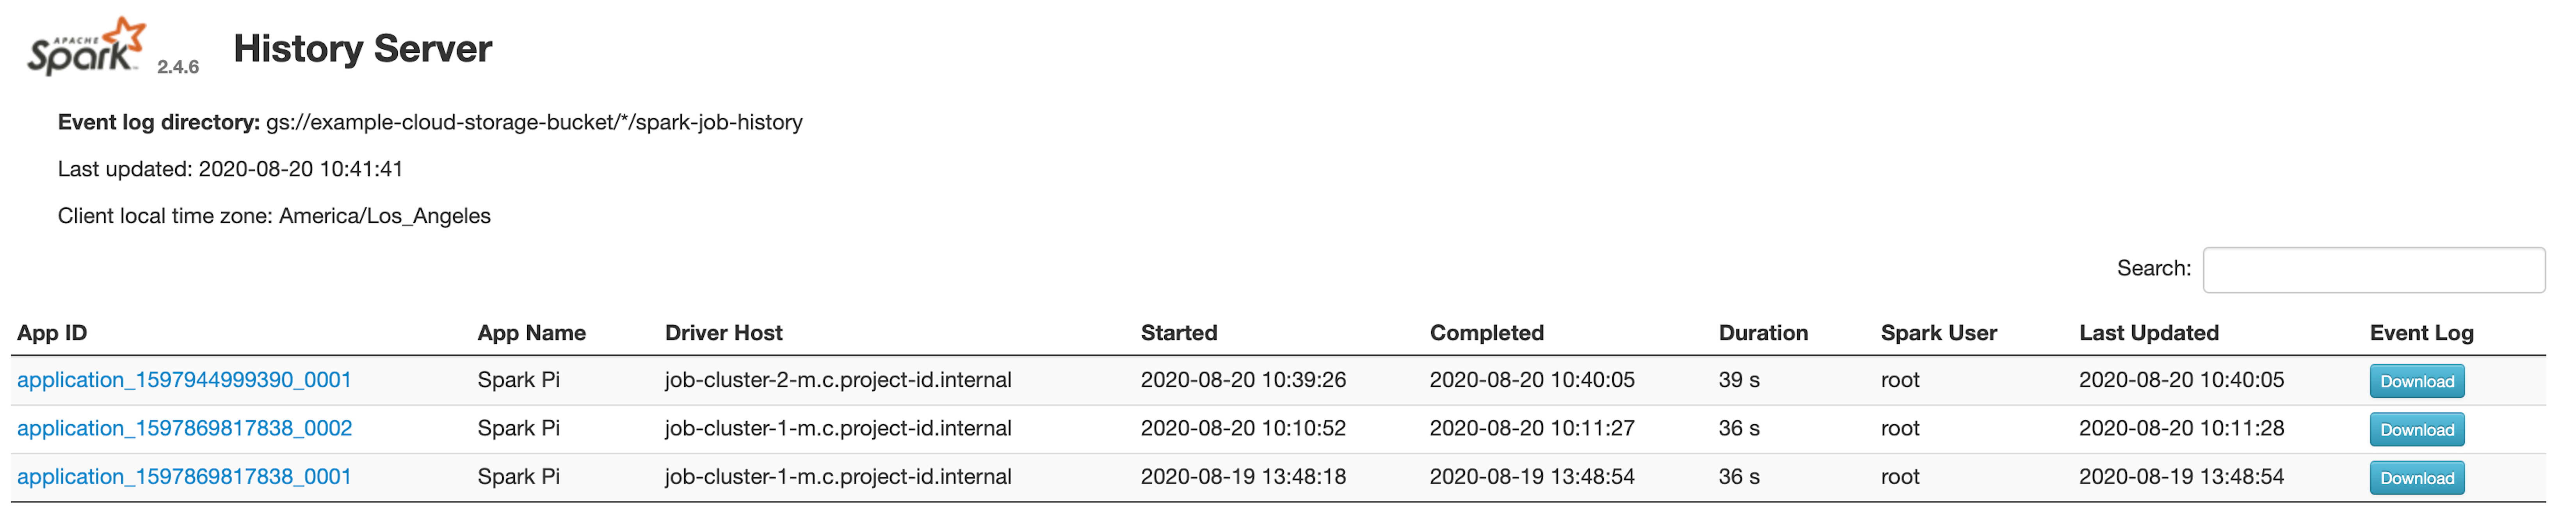
La capture d'écran suivante montre l'interface Web du serveur d'historique Spark affichant des liens vers les jobs Spark exécutés sur job-cluster-1 et job-cluster-2 après avoir configuré les emplacements spark.history.fs.logDirectory et spark:spark.eventLog.dir des clusters de jobs et l'emplacement spark.history.fs.logDirectory du cluster PHS comme suit :
| job-cluster-1 | gs://example-cloud-storage-bucket/job-cluster-1/spark-job-history |
| job-cluster-2 | gs://example-cloud-storage-bucket/job-cluster-2/spark-job-history |
| phs-cluster | gs://example-cloud-storage-bucket/*/spark-job-history |
Recherche par nom d'application
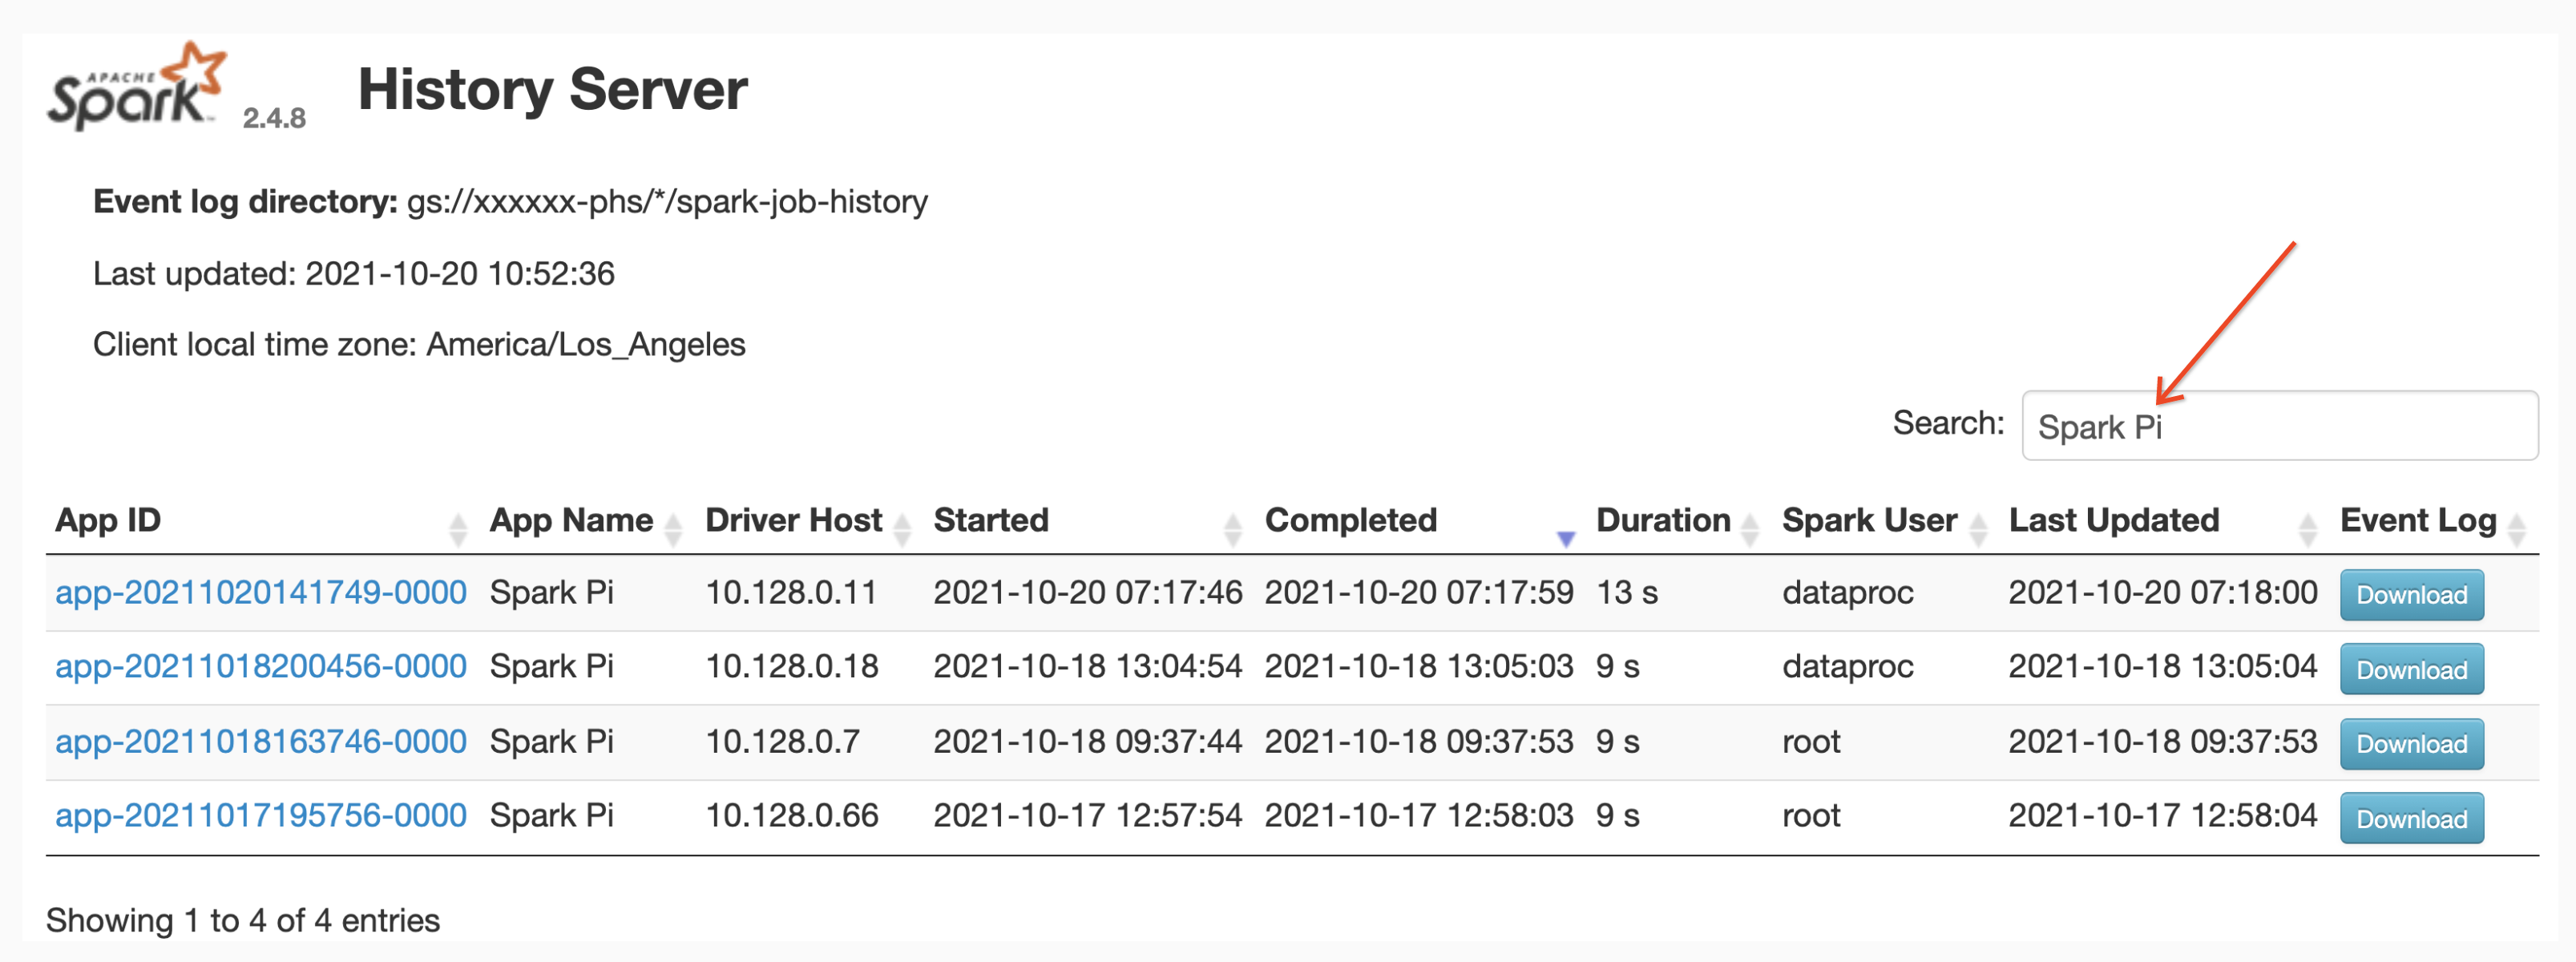
Vous pouvez lister les jobs par nom d'application dans l'interface Web du serveur d'historique Spark en saisissant un nom d'application dans le champ de recherche. Le nom de l'application peut être défini de l'une des manières suivantes (par ordre de priorité) :
- Défini dans le code de l'application lors de la création du contexte Spark
- Défini par la propriété spark.app.name lors de l'envoi du job
- Définie par Managed Service pour Apache Spark sur le nom complet de la ressource REST du job (
projects/project-id/regions/region/jobs/job-id)
Les utilisateurs peuvent saisir le nom d'une application ou d'une ressource dans le champ Rechercher pour trouver et lister des jobs.
Journaux des événements
L'interface Web du serveur d'historique Spark fournit un bouton Journal des événements sur lequel vous pouvez cliquer pour télécharger les journaux d'événements Spark. Ces journaux sont utiles pour examiner le cycle de vie de l'application Spark.
Tâches Spark
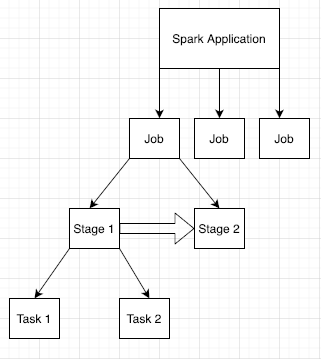
Les applications Spark sont divisées en plusieurs tâches, elles-mêmes divisées en plusieurs étapes. Chaque étape peut comprendre plusieurs tâches, qui sont exécutées sur des nœuds d'exécution (nœuds de calcul).
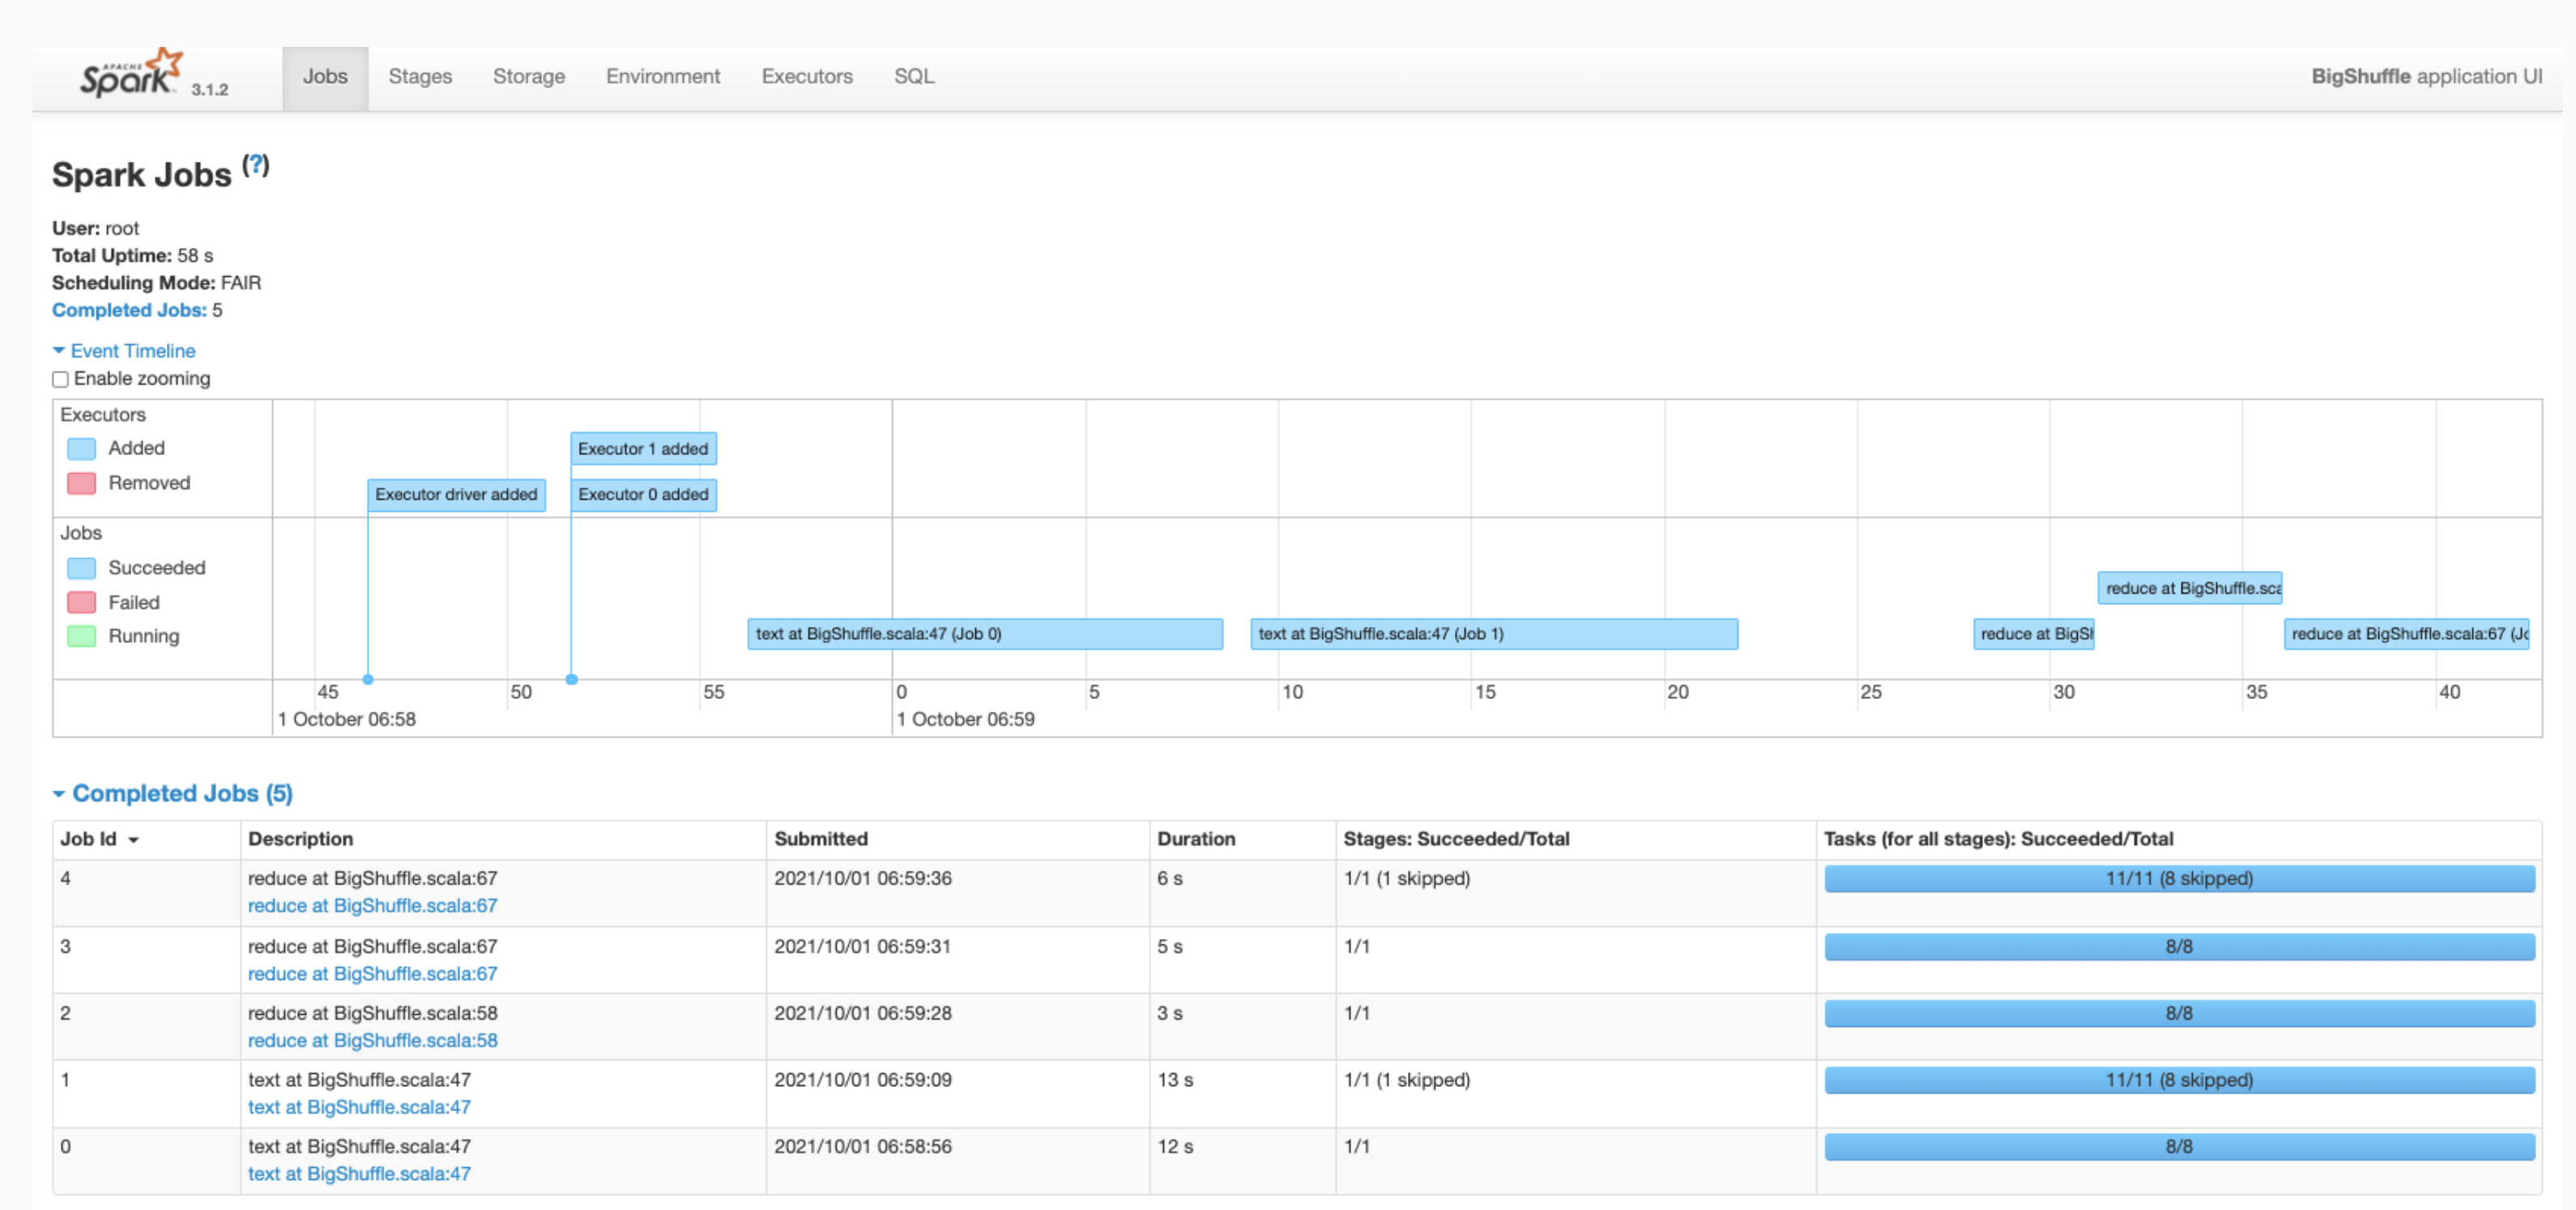
Cliquez sur un ID d'application Spark dans l'interface Web pour ouvrir la page "Jobs Spark", qui fournit une chronologie des événements et un résumé des jobs au sein de l'application.
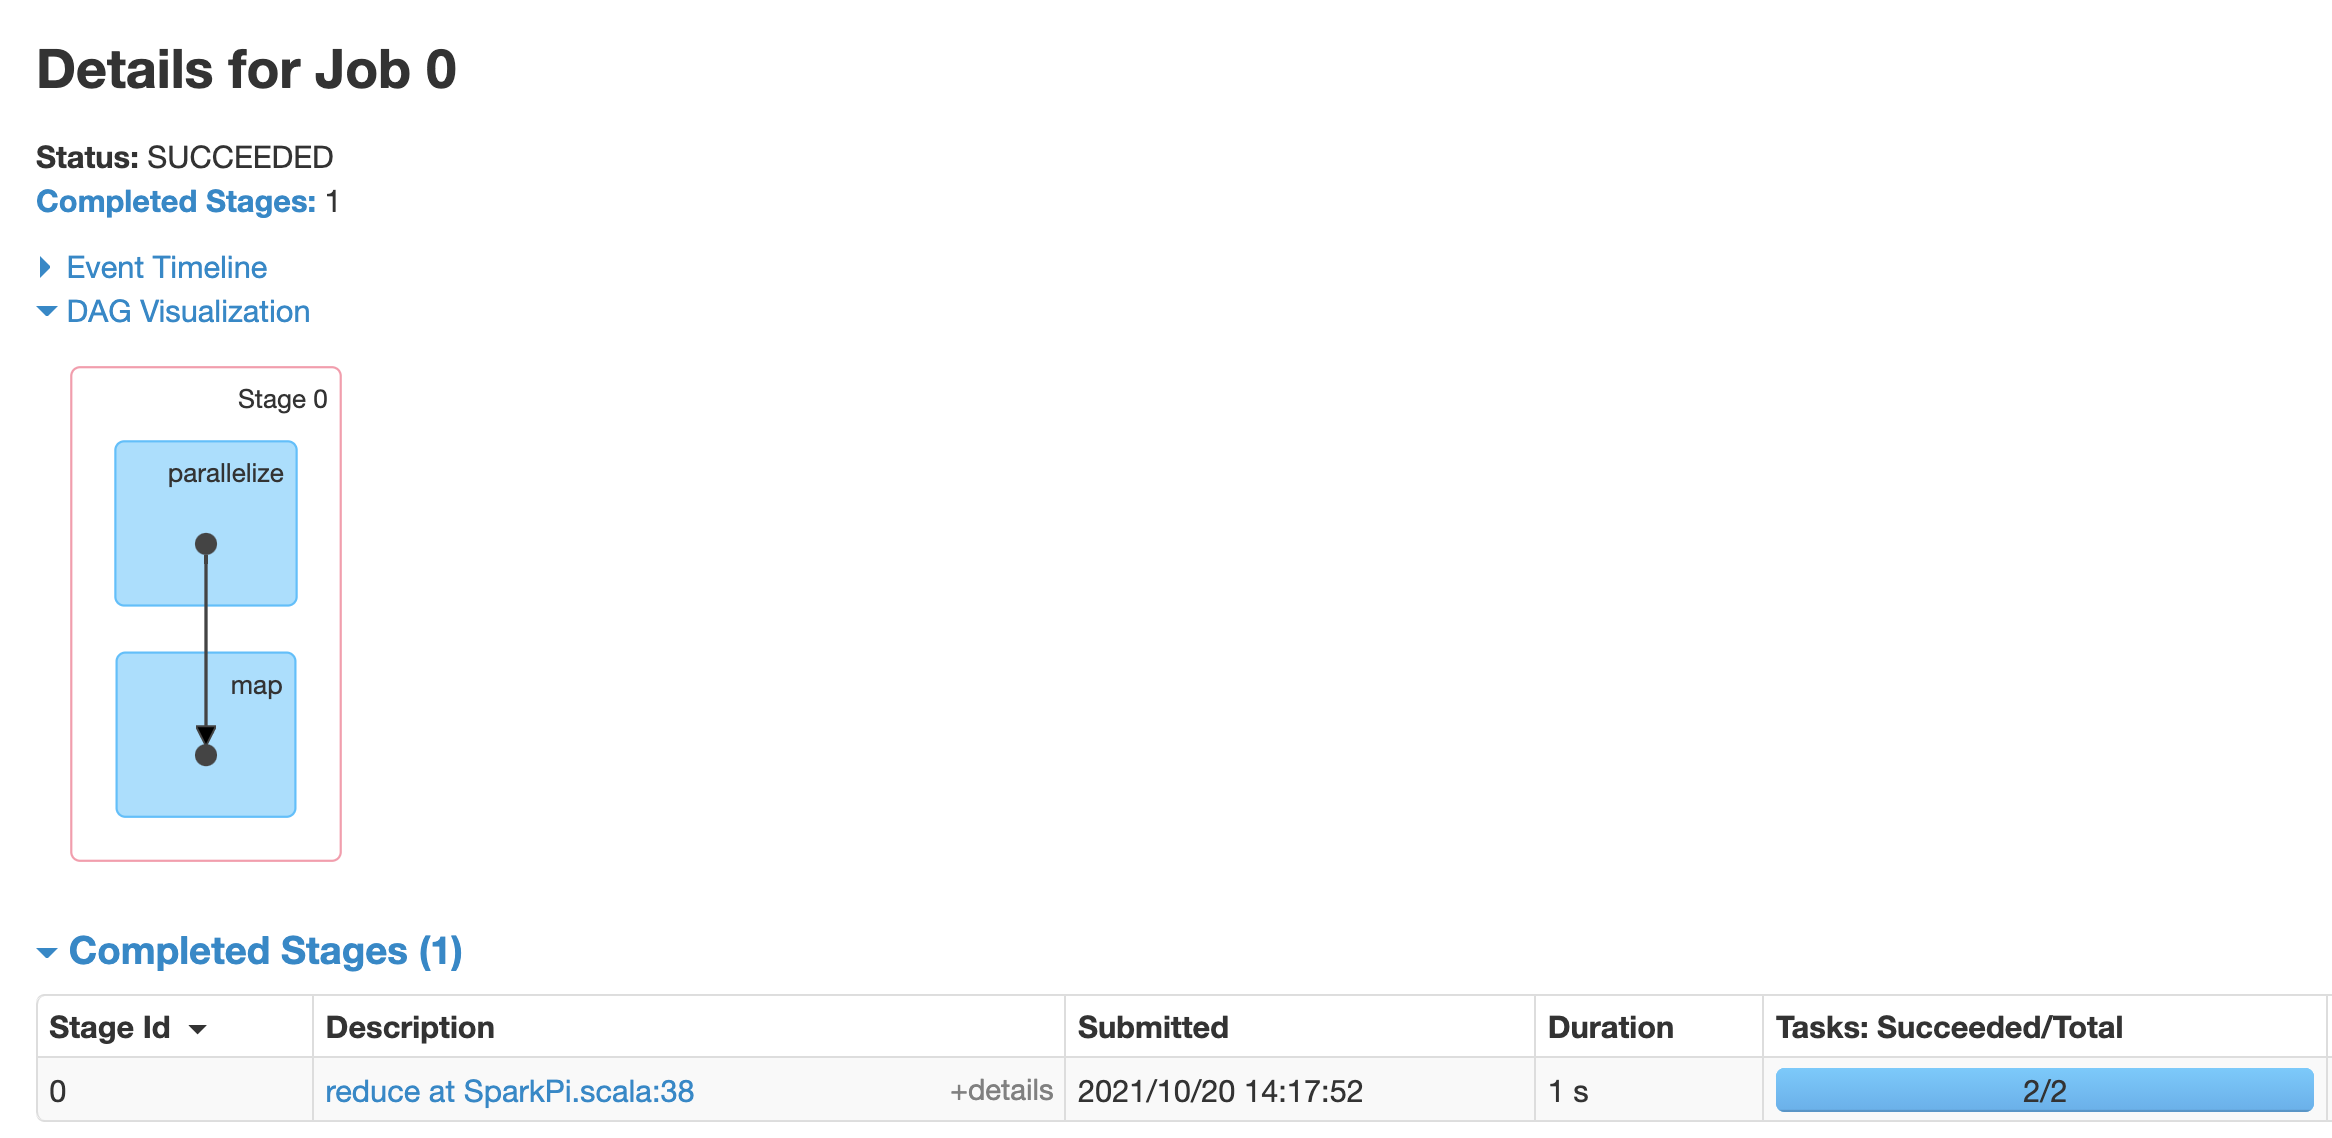
Cliquez sur une tâche pour ouvrir la page "Détails de la tâche" avec un graphe orienté acyclique et un résumé des étapes de la tâche.
Cliquez sur une étape ou utilisez l'onglet "Étapes" pour sélectionner une étape et ouvrir la page d'informations de l'étape.
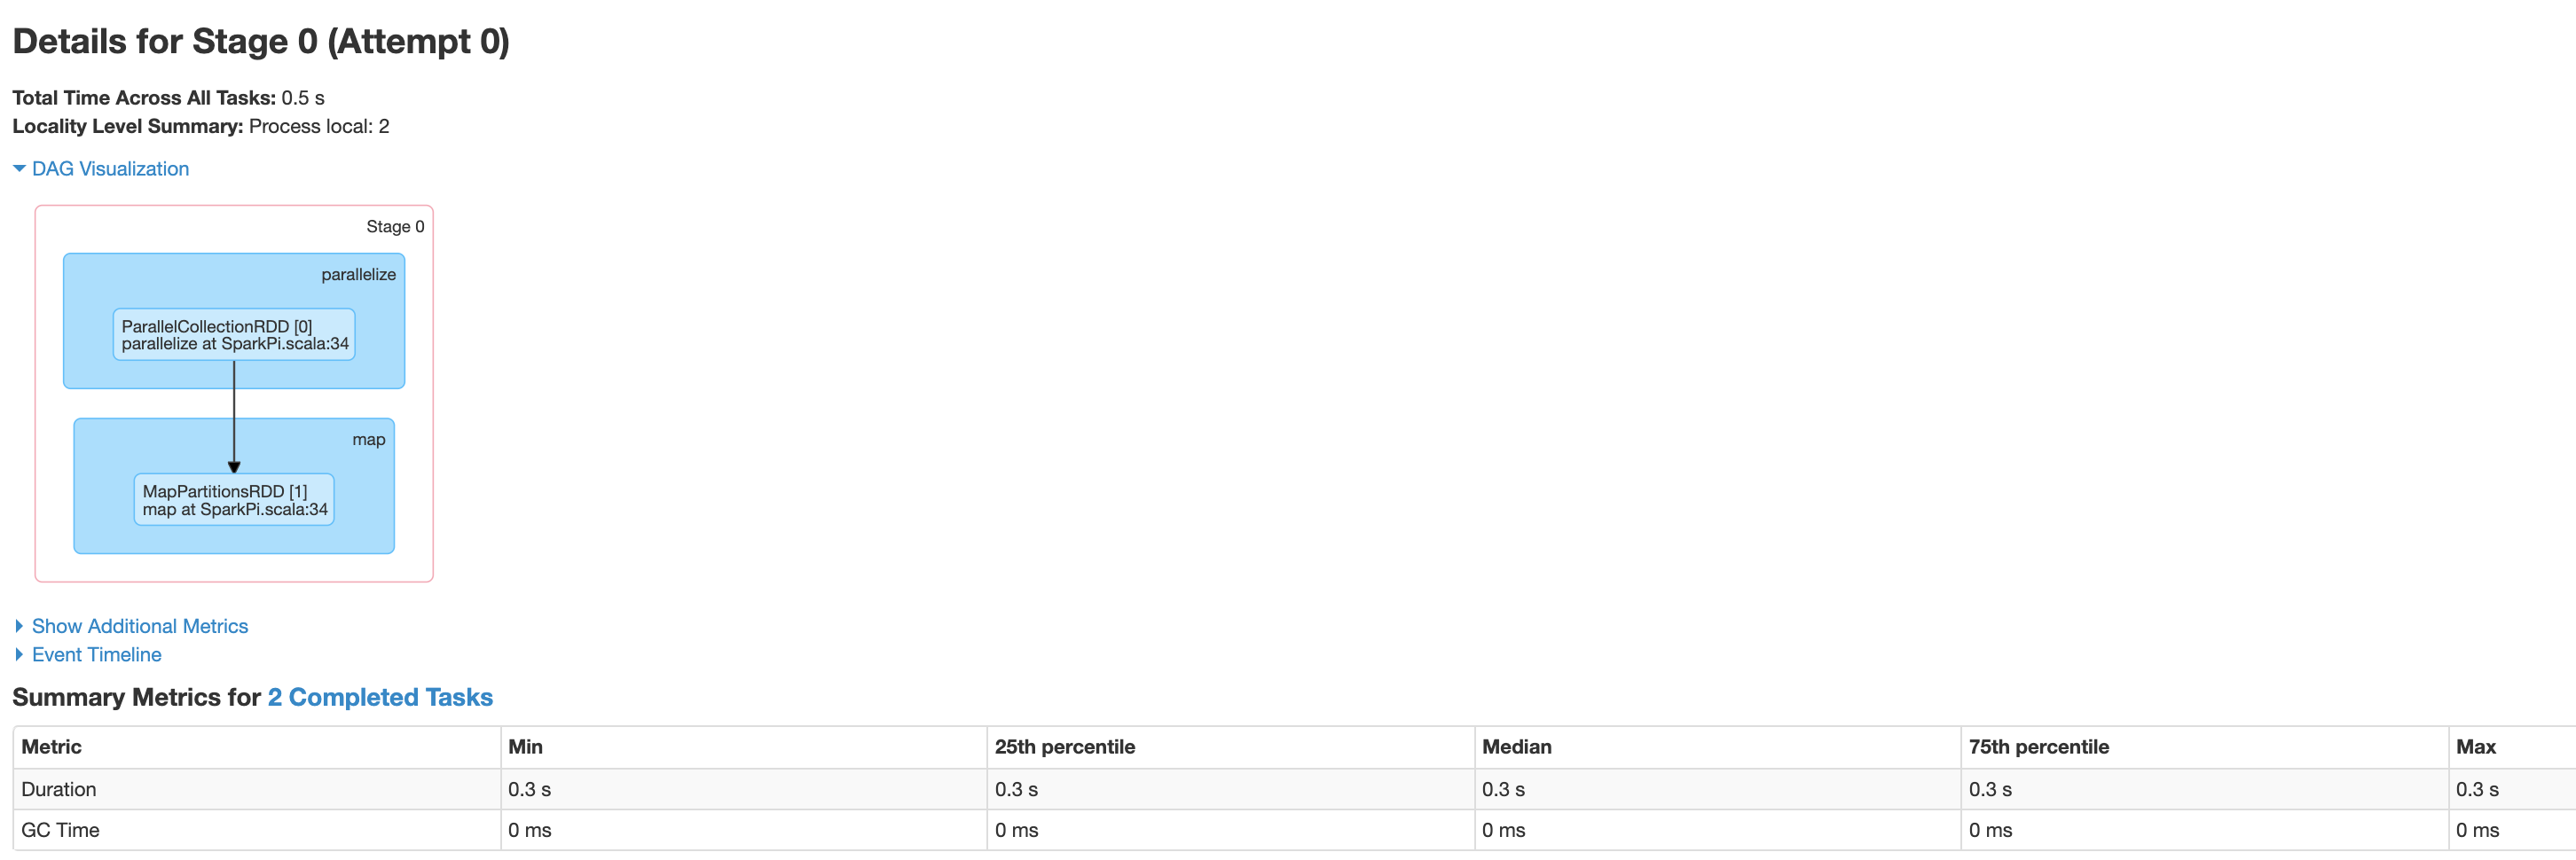
Les détails de l'étape incluent une visualisation du DAG, une chronologie des événements et des métriques pour les tâches de la phase. Vous pouvez utiliser cette page pour résoudre les problèmes liés aux tâches "étranglées", aux retards du programmeur et aux erreurs de mémoire insuffisante. Le visualiseur de DAG affiche la ligne de code à partir de laquelle la phase est dérivée, ce qui vous aide à suivre les problèmes dans le code.
Cliquez sur l'onglet "Executors" (Exécuteurs) pour obtenir des informations sur les nœuds de pilote et d'exécuteur de l'application Spark.
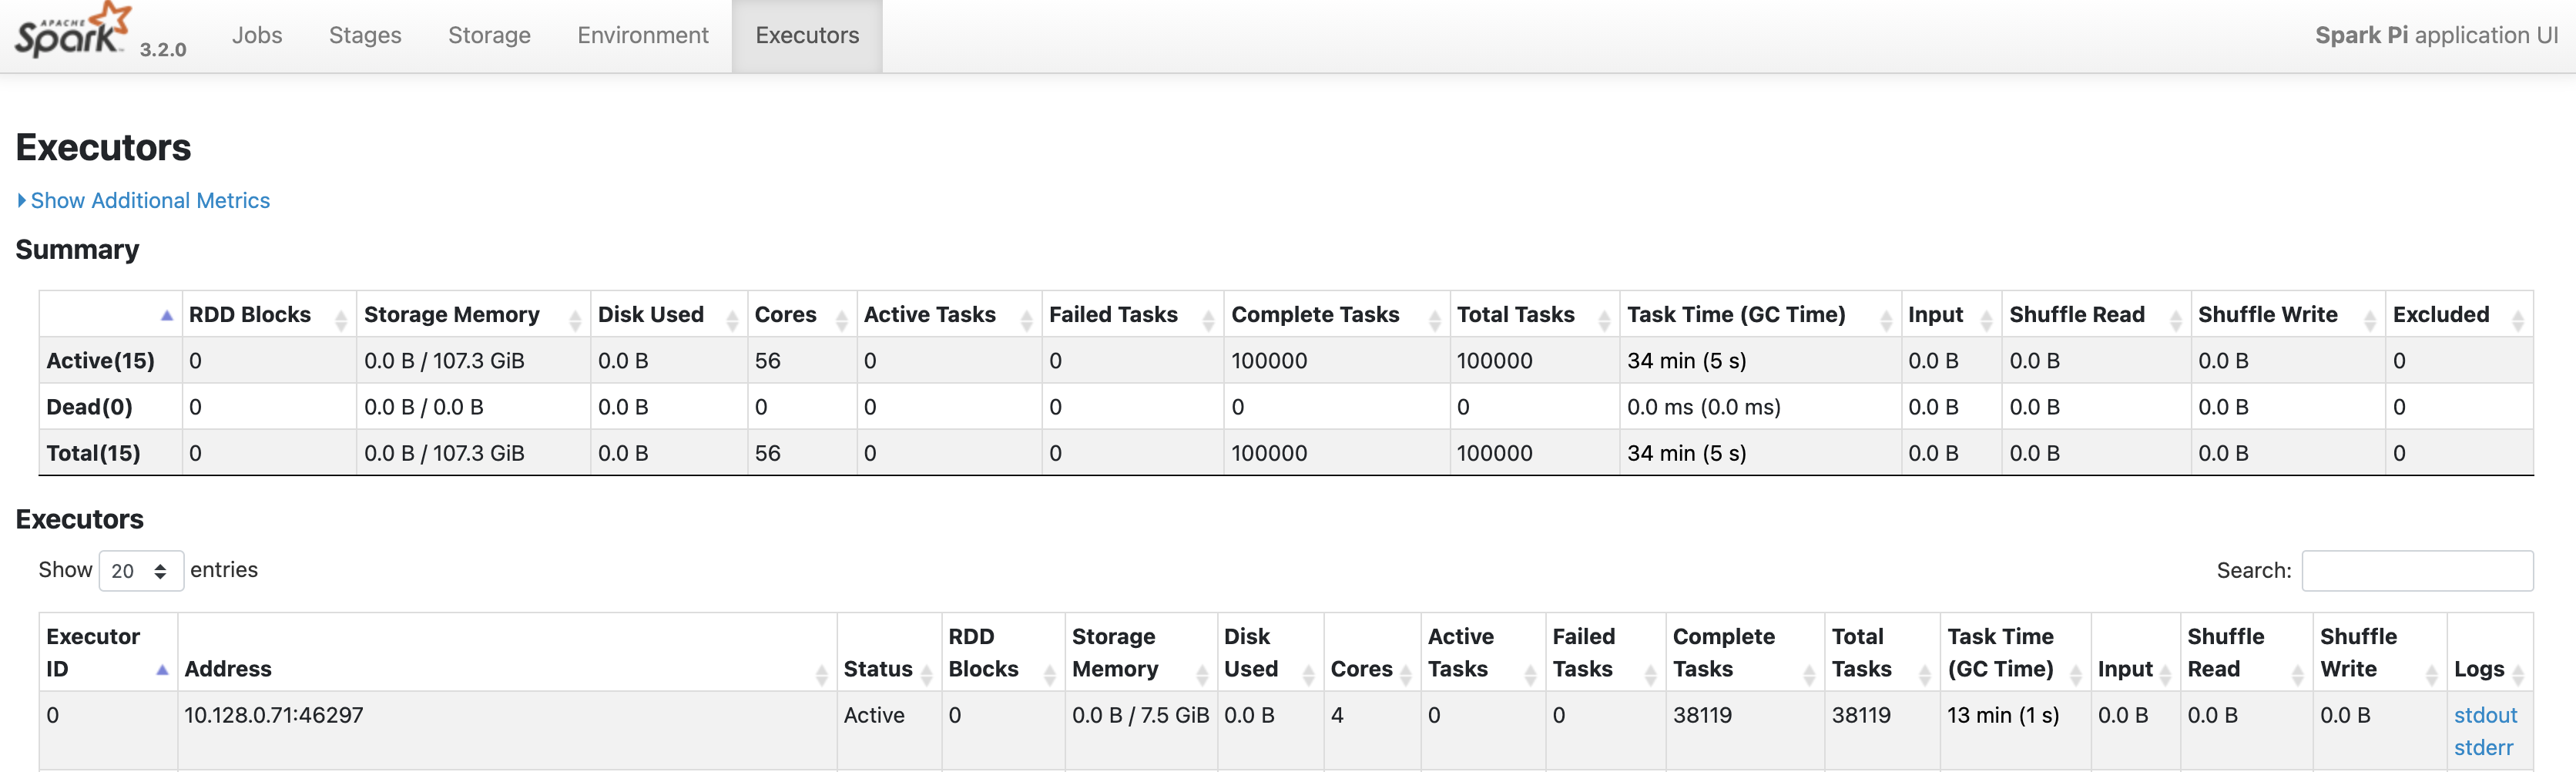
Les informations importantes de cette page incluent le nombre de cœurs et le nombre de tâches exécutées sur chaque exécuteur.
Interface Web Tez
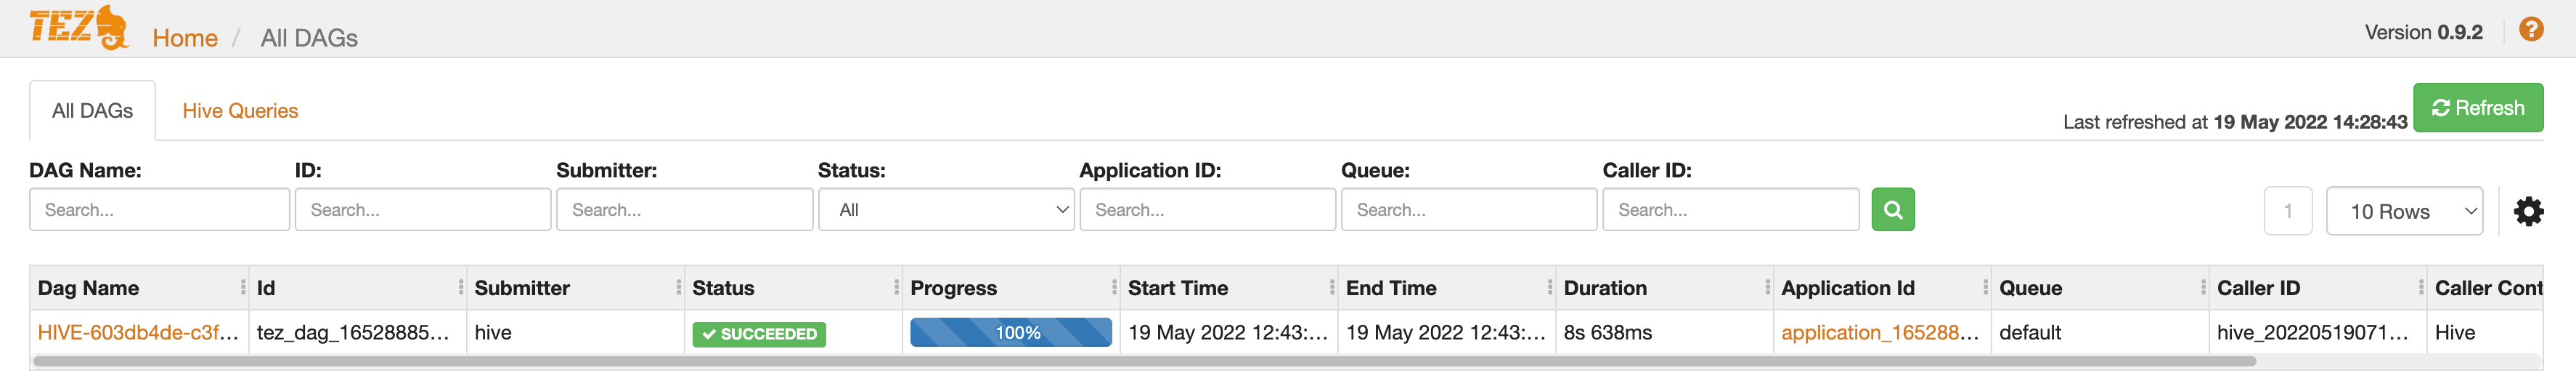
Tez est le moteur d'exécution par défaut pour Hive et Pig sur Managed Service pour Apache Spark. L'envoi d'un job Hive sur un cluster de jobs Managed Service pour Apache Spark lance une application Tez.
Si vous avez configuré Yarn Timeline Service v2 et défini la propriété dataproc:yarn.atsv2.bigtable.instance lorsque vous avez créé les clusters de jobs PHS et Managed Service pour Apache Spark, YARN écrit les données d'historique des jobs Hive et Pig générées dans l'instance Bigtable spécifiée pour les récupérer et les afficher sur l'interface Web Tez exécutée sur le serveur PHS.
Interface Web YARN Application Timeline V2
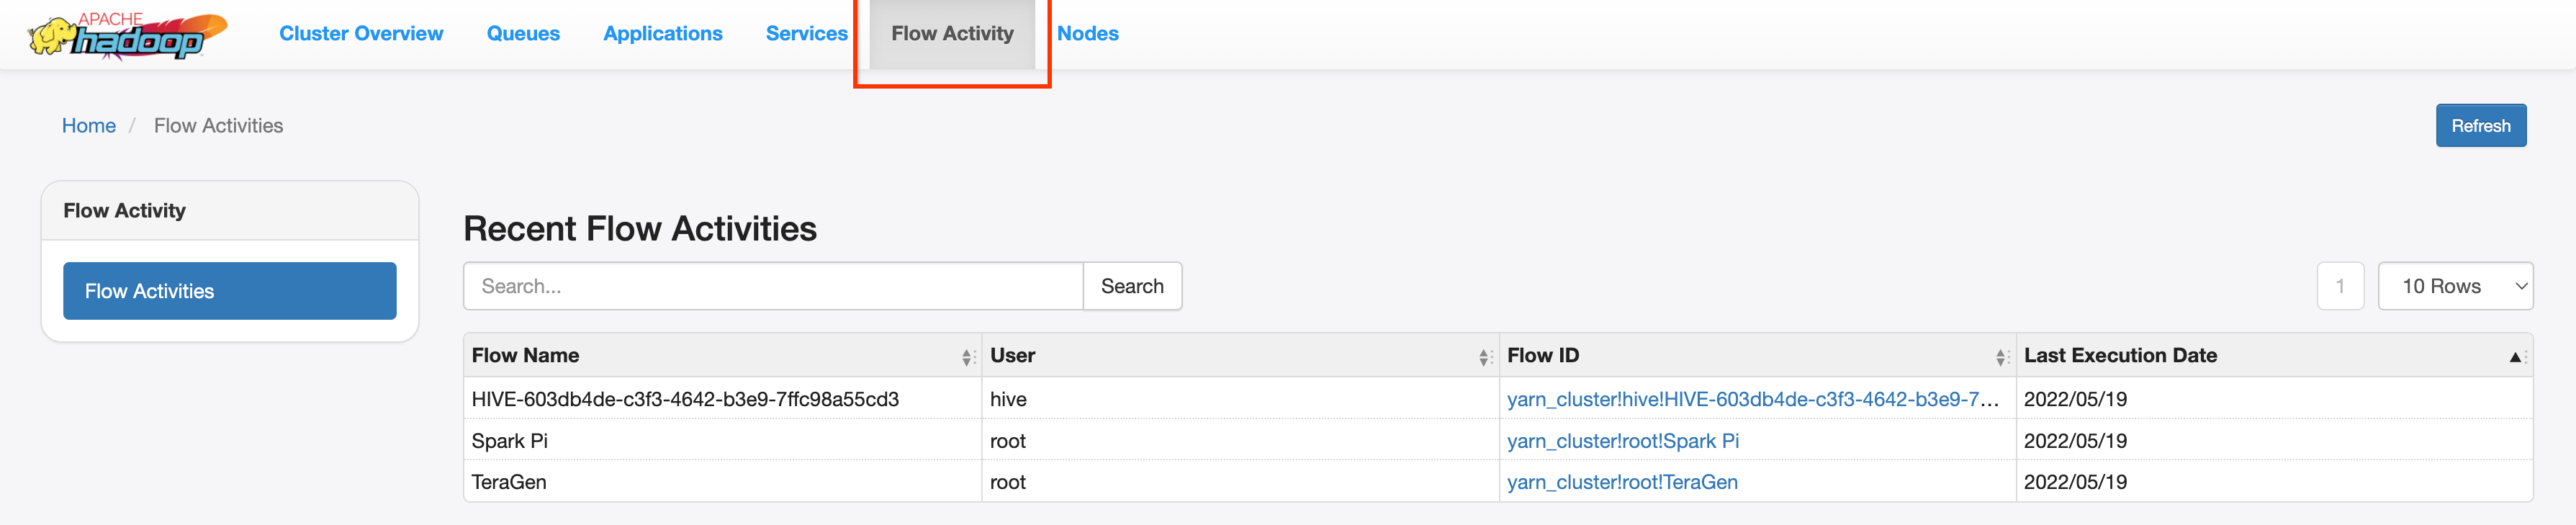
Si vous avez configuré Yarn Timeline Service v2 et défini la propriété dataproc:yarn.atsv2.bigtable.instance lorsque vous avez créé les clusters de jobs PHS et Managed Service pour Apache Spark, YARN écrit les données d'historique des jobs générées dans l'instance Bigtable spécifiée pour les récupérer et les afficher dans l'interface Web du service d'historique des applications YARN exécuté sur le serveur PHS. Les jobs Managed Service pour Apache Spark sont listés sous l'onglet Activité du flux de l'interface Web.
Configurer Yarn Timeline Service v2
Pour configurer Yarn Timeline Service v2, configurez une instance Bigtable et, si nécessaire, vérifiez les rôles de compte de service comme suit :
Vérifiez les rôles du compte de service, si nécessaire. Le compte de service de VM par défaut utilisé par les VM du cluster Dataproc dispose des autorisations nécessaires pour créer et configurer l'instance Bigtable pour le service d'historique YARN. Si vous créez votre job ou votre cluster PHS avec un compte de service de VM personnalisé, ce compte doit disposer du rôle Bigtable
AdministratorouBigtable User.
Schéma de table requis
La compatibilité du PHS Managed Service pour Apache Spark avec YARN Timeline Service v2 nécessite un schéma spécifique créé dans l'instance Bigtable. Managed Service pour Apache Spark crée le schéma requis lorsqu'un cluster de jobs ou un cluster PHS est créé avec la propriété dataproc:yarn.atsv2.bigtable.instance définie pour pointer vers l'instance Bigtable.
Voici le schéma d'instance Bigtable requis :
| Tables | Familles de colonnes |
|---|---|
| prod.timelineservice.application | c,i,m |
| prod.timelineservice.app_flow | m |
| prod.timelineservice.entity | c,i,m |
| prod.timelineservice.flowactivity | i |
| prod.timelineservice.flowrun | i |
| prod.timelineservice.subapplication | c,i,m |
Récupération de mémoire Bigtable
Vous pouvez configurer la récupération de mémoire Bigtable en fonction de l'âge pour les tables ATSv2 :
Installez cbt (y compris la création du fichier
.cbrtc file).Créez la règle de récupération de mémoire ATSv2 basée sur l'âge :
export NUMBER_OF_DAYS = number \
cbt setgcpolicy prod.timelineservice.application c maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.application i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.application m maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.app_flow m maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.entity c maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.entity i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.entity m maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.flowactivity i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.flowrun i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.subapplication c maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.subapplication i maxage=${NUMBER_OF_DAYS} \
cbt setgcpolicy prod.timelineservice.subapplication m maxage=${NUMBER_OF_DAYS}
Remarques :
NUMBER_OF_DAYS : le nombre maximal de jours est de 30d.