


En este documento, se describen las herramientas y los archivos que puedes usar para supervisar y solucionar problemas de las cargas de trabajo por lotes de Managed Service para Apache Spark .
Soluciona problemas de cargas de trabajo desde la Google Cloud consola de
Cuando un trabajo por lotes falla o tiene un rendimiento deficiente, un primer paso recomendado es abrir su página Detalles del lote desde la página Lotes en la Google Cloud consola.
Usa la pestaña Resumen: tu centro de solución de problemas
La pestaña Resumen, que está seleccionada de forma predeterminada cuando se abre la página Detalles del lote, muestra métricas críticas y registros filtrados para ayudarte a realizar una evaluación inicial rápida del estado del lote. Después de esta evaluación inicial, puedes realizar un análisis más profundo con herramientas más especializadas disponibles en la página Detalles del lote, como la IU de Spark, el Explorador de registros y Gemini Cloud Assist.
Aspectos destacados de las métricas de lotes
La pestaña Resumen de la página Detalles del lote incluye gráficos que muestran valores importantes de métricas de cargas de trabajo por lotes. Los gráficos de métricas se propagan después de que se completa y ofrecen una indicación visual de posibles problemas, como la contención de recursos, la asimetría de datos o la limitación de memoria.
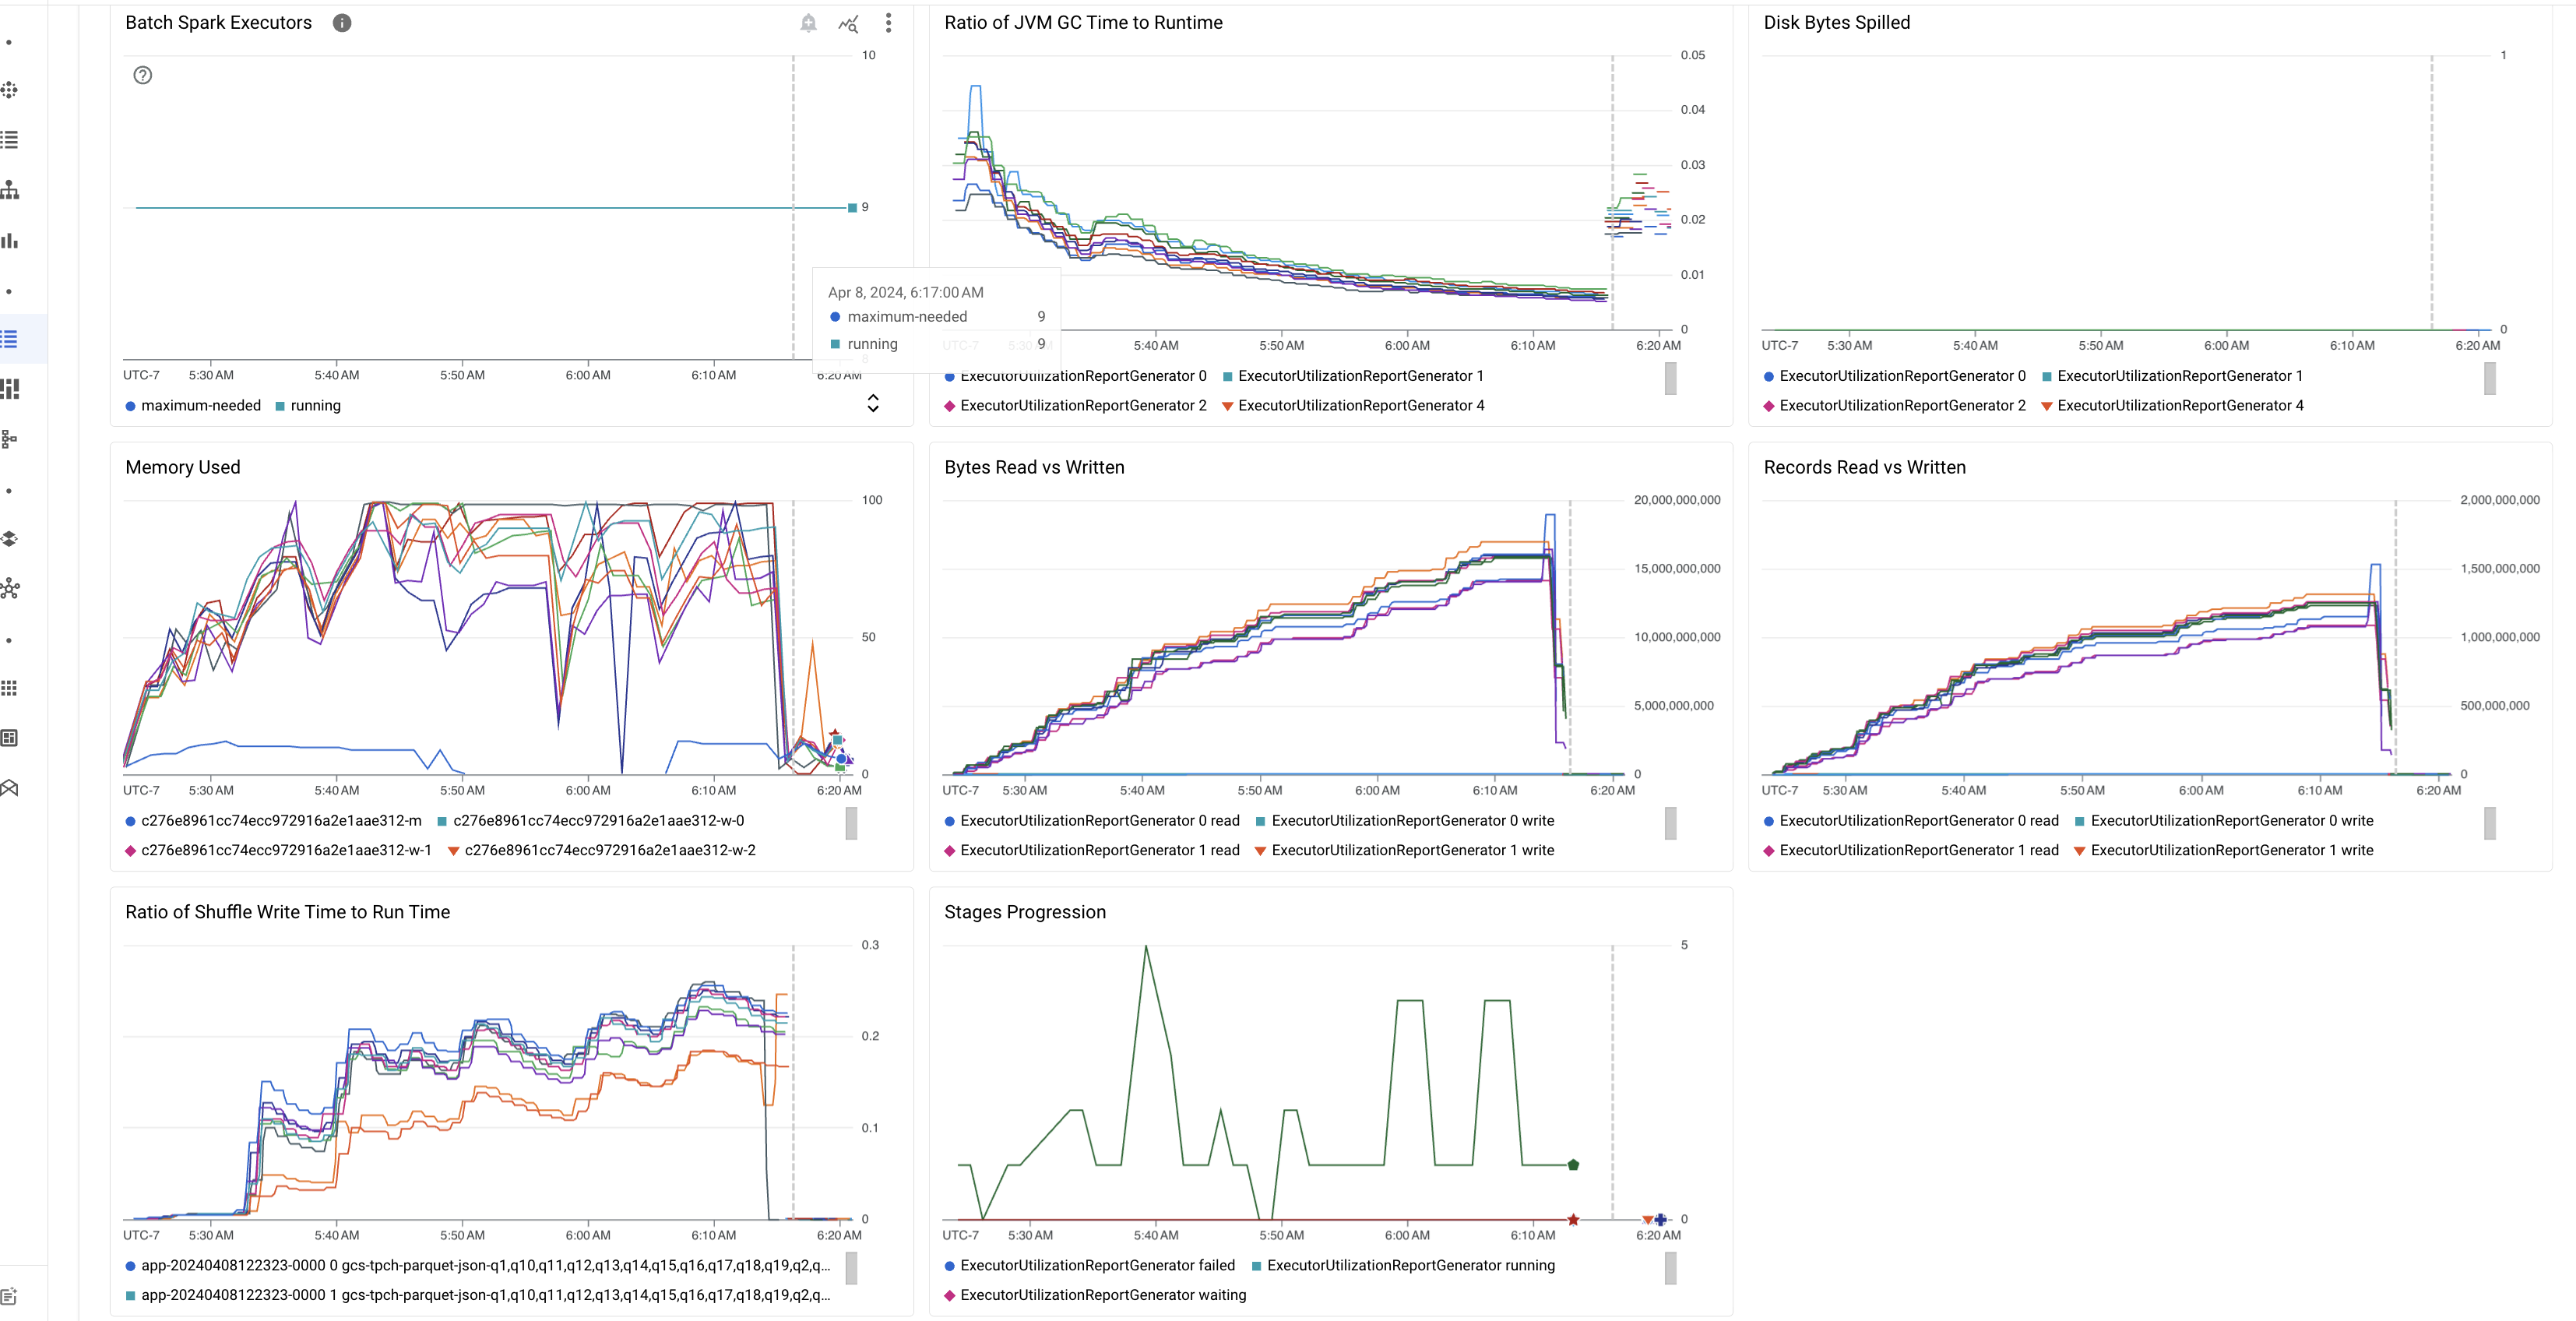
En la siguiente tabla, se enumeran las métricas de cargas de trabajo de Spark que se muestran en la página Detalles del lote en la Google Cloud consola de y se describe cómo los valores de las métricas pueden proporcionar información sobre el estado y el rendimiento de las cargas de trabajo.
| Métrica | ¿Qué muestra? |
|---|---|
| Métricas a nivel del ejecutor | |
| Proporción de tiempo de GC de JVM con respecto al tiempo de ejecución | Esta métrica muestra la proporción de tiempo de GC (recolección de elementos no utilizados) de JVM con respecto al tiempo de ejecución por ejecutor. Las proporciones altas pueden indicar fugas de memoria dentro de las tareas que se ejecutan en ejecutores particulares o estructuras de datos ineficientes, lo que puede generar una alta rotación de objetos. |
| Bytes de disco volcados | Esta métrica muestra la cantidad total de bytes de disco volcados en diferentes ejecutores. Si un ejecutor muestra una gran cantidad de bytes de disco volcados, esto puede indicar una asimetría de datos. Si la métrica aumenta con el tiempo, esto puede indicar que hay etapas con limitación de memoria o fugas de memoria. |
| Bytes leídos y escritos | Esta métrica muestra los bytes escritos en comparación con los bytes leídos por ejecutor. Las grandes discrepancias en los bytes leídos o escritos pueden indicar situaciones en las que las uniones replicadas conducen a la amplificación de datos en ejecutores específicos. |
| Registros leídos y escritos | Esta métrica muestra los registros leídos y escritos por ejecutor. Una gran cantidad de registros leídos con una baja cantidad de registros escritos puede indicar un cuello de botella en la lógica de procesamiento en ejecutores específicos, lo que hace que se lean los registros mientras se espera. Los ejecutores que se retrasan constantemente en las lecturas y escrituras pueden indicar contención de recursos en esos nodos o ineficiencias de código específicas del ejecutor. |
| Proporción de tiempo de escritura de shuffle con respecto al tiempo de ejecución | La métrica muestra la cantidad de tiempo que el ejecutor pasó en el tiempo de ejecución de shuffle en comparación con el tiempo de ejecución general. Si este valor es alto para algunos ejecutores, puede indicar una asimetría de datos o una serialización de datos ineficiente. Puedes identificar las etapas con tiempos de escritura de shuffle largos en la IU de Spark. Busca tareas atípicas dentro de esas etapas que tarden más que el tiempo promedio en completarse. Verifica si los ejecutores con tiempos de escritura de shuffle altos también muestran una alta actividad de E/S de disco. Una serialización más eficiente y pasos de partición adicionales podrían ayudar. Las escrituras de registros muy grandes en comparación con las lecturas de registros pueden indicar una duplicación de datos no deseada debido a uniones ineficientes o transformaciones incorrectas. |
| Métricas a nivel de la aplicación | |
| Avance entre etapas | Esta métrica muestra la cantidad de etapas en las etapas con errores, en espera y en ejecución. Una gran cantidad de etapas con errores o en espera puede indicar una asimetría de datos. Verifica las particiones de datos y depura el motivo de la falla de la etapa con la pestaña Etapas en la IU de Spark. |
| Ejecutores de Spark por lotes | Esta métrica muestra la cantidad de ejecutores que podrían ser necesarios en comparación con la cantidad de ejecutores en ejecución. Una gran diferencia entre los ejecutores necesarios y los que están en ejecución puede indicar problemas de ajuste de escala automático. |
| Métricas a nivel de la VM | |
| Memoria usada | Esta métrica muestra el porcentaje de memoria de la VM en uso. Si el porcentaje de la instancia principal es alto, puede indicar que el controlador tiene una limitación de memoria. Para otros nodos de VM, un porcentaje alto puede indicar que los ejecutores se están quedando sin memoria, lo que puede generar una gran cantidad de volcados de disco y un tiempo de ejecución de la carga de trabajo más lento. Usa la IU de Spark para analizar los ejecutores y verificar si hay un tiempo de GC alto y una gran cantidad de fallas de tareas. También depura el código de Spark para el almacenamiento en caché de conjuntos de datos grandes y la transmisión innecesaria de variables. |
Registros del trabajo
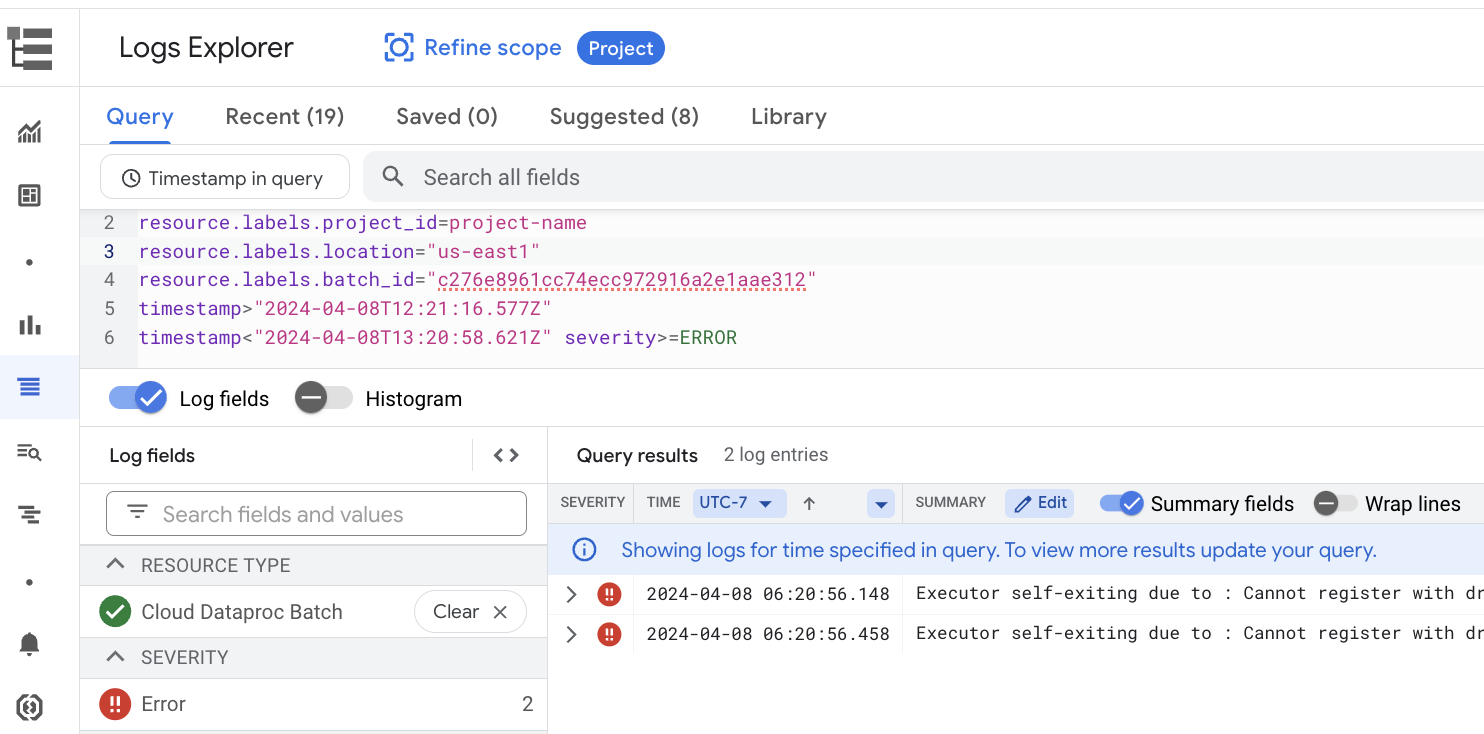
La página Detalles del lote incluye una sección Registros del trabajo que enumera las advertencias y los errores filtrados de los registros del trabajo (carga de trabajo por lotes). Esta función permite identificar rápidamente los problemas críticos sin necesidad de analizar manualmente los archivos de registro extensos. Puedes seleccionar una Gravedad de registro (por ejemplo, Error) en el menú desplegable y agregar un Filtro de texto para limitar los resultados. Para realizar un análisis más detallado, haz clic en el ícono Ver en el Explorador de registros
para abrir los registros de lotes seleccionados en el Explorador de registros.
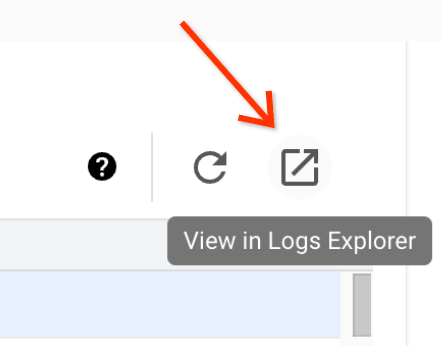
Ejemplo: Explorador de registros se abre después de elegir Errors en el selector de gravedad
de la página Detalles del lote en la consola de Google Cloud .
IU de Spark
La IU de Spark recopila detalles de ejecución de Apache Spark de las cargas de trabajo por lotes de Managed Service para Apache Spark. No se aplican cargos por la función de IU de Spark, que está habilitada de forma predeterminada.
Los datos recopilados por la función de IU de Spark se conservan durante 90 días. Puedes usar esta interfaz web para supervisar y depurar cargas de trabajo de Spark sin tener que crear un servidor de historial persistente.
Roles y permisos necesarios de Identity and Access Management
Se requieren los siguientes permisos para usar la función de IU de Spark con cargas de trabajo por lotes.
Permiso de recopilación de datos:
dataproc.batches.sparkApplicationWrite. Este permiso se debe otorgar a la cuenta de servicio que ejecuta cargas de trabajo por lotes. Este permiso se incluye en elManaged Service for Apache Spark Workerrol, que se otorga automáticamente a la cuenta de servicio predeterminada de Compute Engine que Managed Service para Apache Spark usa de forma predeterminada (consulta Cuenta de servicio de Managed Service para Apache Spark). Sin embargo, si especificas una cuenta de servicio personalizada para tu carga de trabajo por lotes, debes agregar eldataproc.batches.sparkApplicationWritepermiso a esa cuenta de servicio (por lo general, otorgando a la cuenta de servicio el rolWorkerde Managed Service para Apache Spark).Permiso de acceso a la IU de Spark:
dataproc.batches.sparkApplicationRead. Este permiso se debe otorgar a un usuario para acceder a la IU de Spark en la Google Cloud consola. Este permiso se incluye en losDataproc Viewer,Dataproc EditoryDataproc Administratorroles. Para abrir la IU de Spark en la Google Cloud consola de, debes tener uno de estos roles o un rol personalizado que incluya este permiso.
Abre la IU de Spark
La página de la IU de Spark está disponible en las cargas de trabajo por lotes de la consola de Google Cloud .
Ve a la página Sesiones interactivas de Managed Service para Apache Spark.
Haz clic en un ID de lote para abrir la página Detalles del lote.
Haz clic en Ver IU de Spark en el menú superior.
El botón Ver IU de Spark está inhabilitado en los siguientes casos:
- Si no se otorga un permiso obligatorio
- Si desmarcas la casilla de verificación Habilitar IU de Spark en la página Detalles del lote
- Si configuras la propiedad
spark.dataproc.appContext.enabledcomofalsecuando envías una carga de trabajo por lotes
Registros de Managed Service para Apache Spark
Logging está habilitado de forma predeterminada en Managed Service para Apache Spark, y los registros de cargas de trabajo persisten después de que finaliza una carga de trabajo. Managed Service para Apache Spark recopila registros de cargas de trabajo en Cloud Logging.
Puedes acceder a los registros de Managed Service para Apache Spark en el recurso Cloud Dataproc Batch en el Explorador de registros.
Consulta los registros de Managed Service para Apache Spark
El Explorador de registros en la Google Cloud consola de proporciona un panel de consultas para ayudarte a compilar una consulta para examinar los registros de cargas de trabajo por lotes. Estos son los pasos que puedes seguir para compilar una consulta para examinar los registros de cargas de trabajo por lotes:
- Se selecciona tu proyecto actual. Puedes hacer clic en Refinar alcance Proyecto para seleccionar un proyecto diferente.
Define una consulta de registros por lotes.
Usa los menús de filtro para filtrar una carga de trabajo por lotes.
En Todos los recursos, selecciona el recurso Cloud Managed Service para Apache Spark Batch.
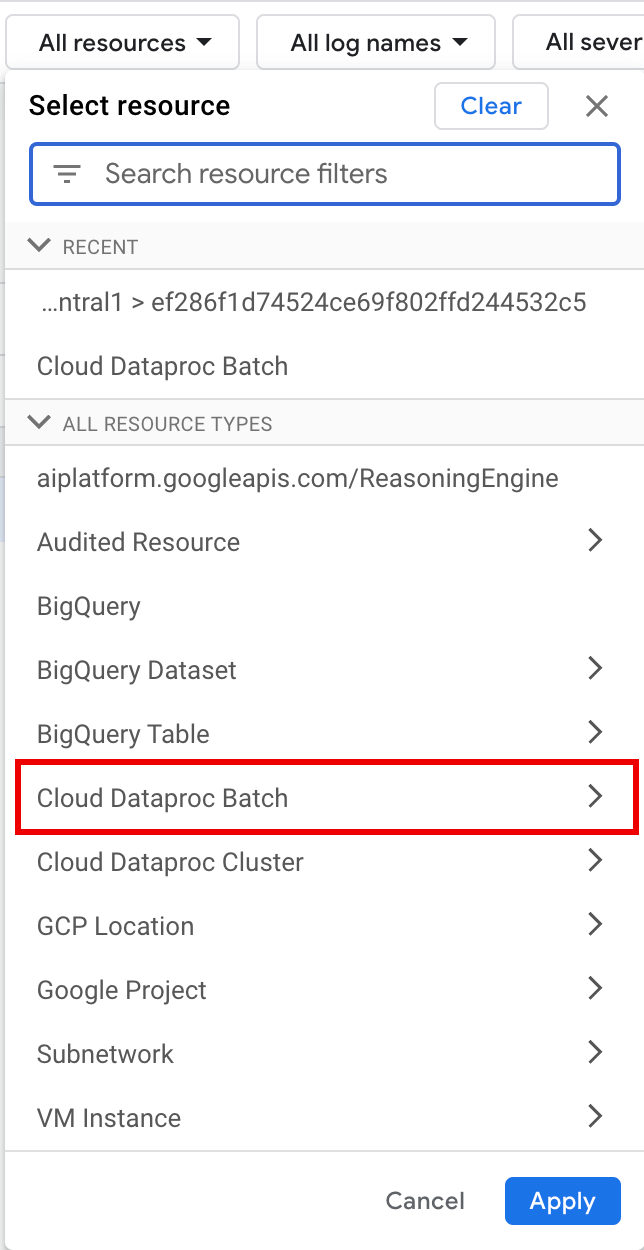
En el panel Seleccionar recurso, selecciona la UBICACIÓN del lote y, luego, el ID DE LOTE. Estos parámetros de lote se enumeran en la página **Lotes** de Managed Service para Apache Spark en la Google Cloud consola.
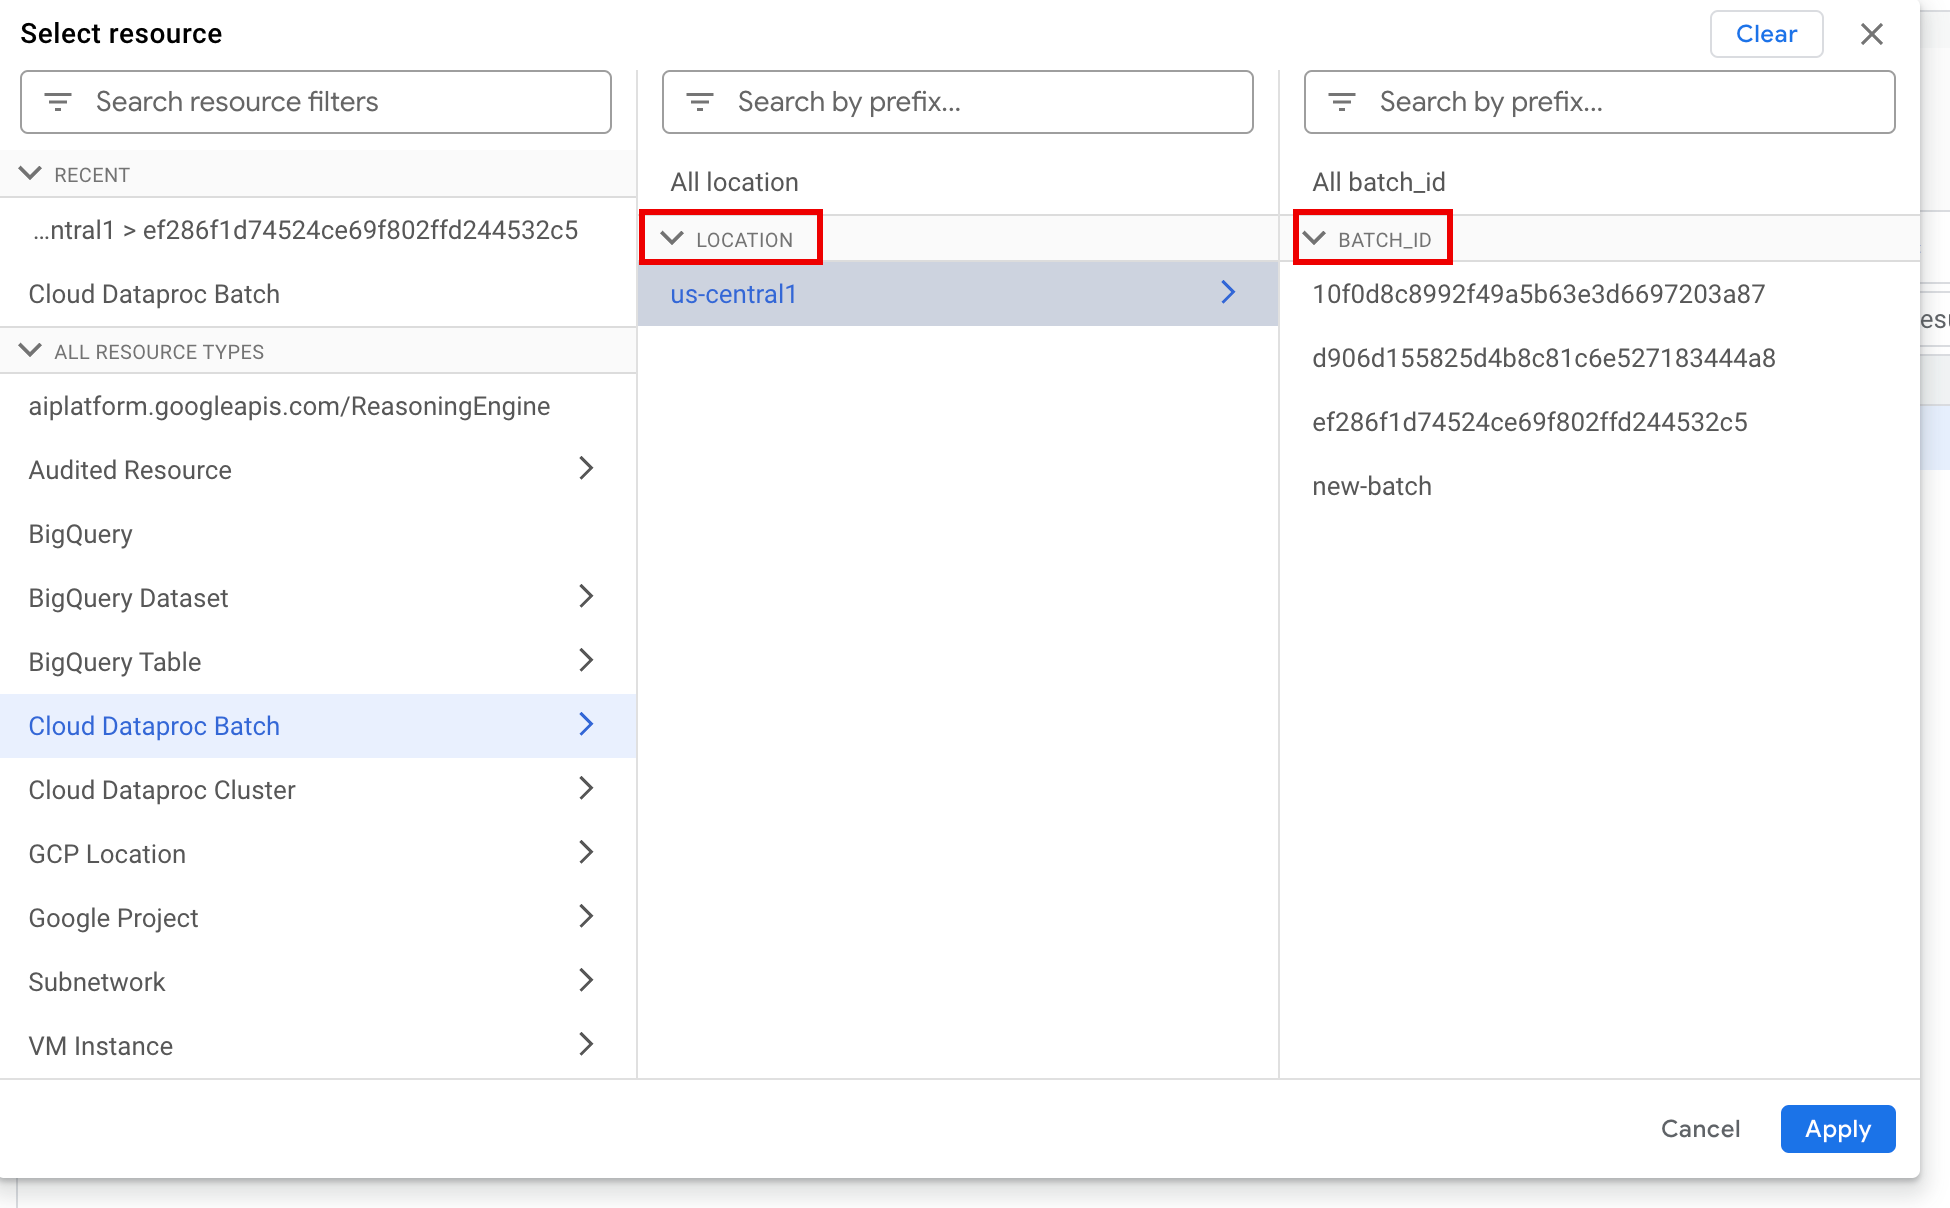
Haz clic en Aplicar.
En Seleccionar nombres de registro , ingresa
dataproc.googleapis.comen el cuadro Buscar nombres de registro para limitar los tipos de registros que se consultarán. Selecciona uno o más de los nombres de archivos de registro enumerados.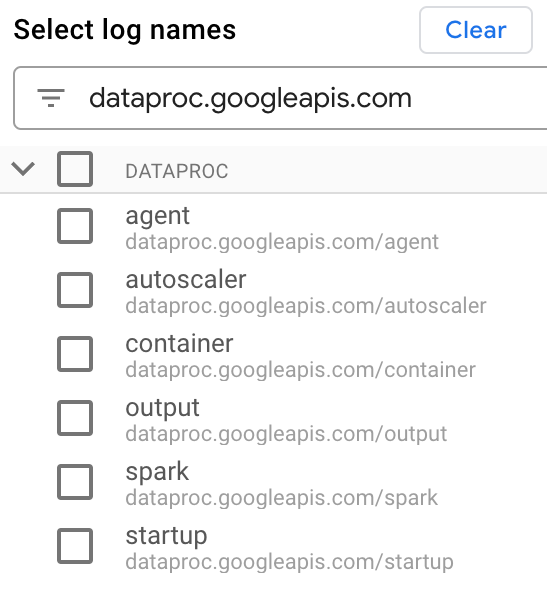
Usa el editor de consultas para filtrar los registros específicos de la VM.
Especifica el tipo de recurso y el nombre del recurso de VM como se muestra en el siguiente ejemplo:
resource.type="cloud_dataproc_batch"
labels."dataproc.googleapis.com/resource_name"="VM_NAME_PREFIX-BATCH_UUID-VM_SUFFIX"
- VM_NAME_PREFIX: Usa
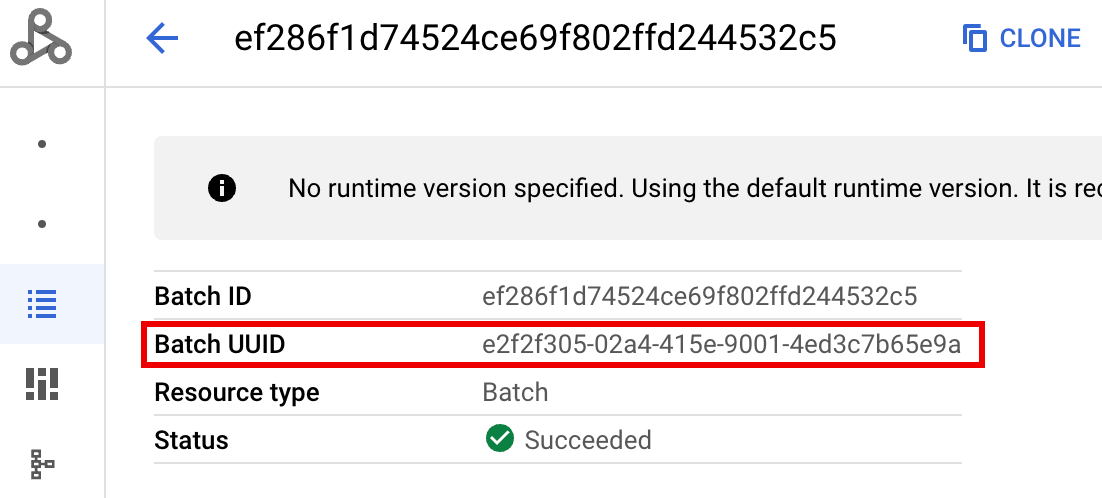
gdpic-rmpara las cargas de trabajo por lotes que se ejecutan en Managed Service para Apache Spark3.0y versiones posteriores del entorno de ejecución; usagdpic-srvls-batchpara las cargas de trabajo por lotes que se ejecutan en versiones anteriores del entorno de ejecución. - BATCH_UUID: El UUID del lote aparece en la página Detalles del lote
en la Google Cloud consola, que se abre cuando haces clic en el
ID de lote en la página Lotes.
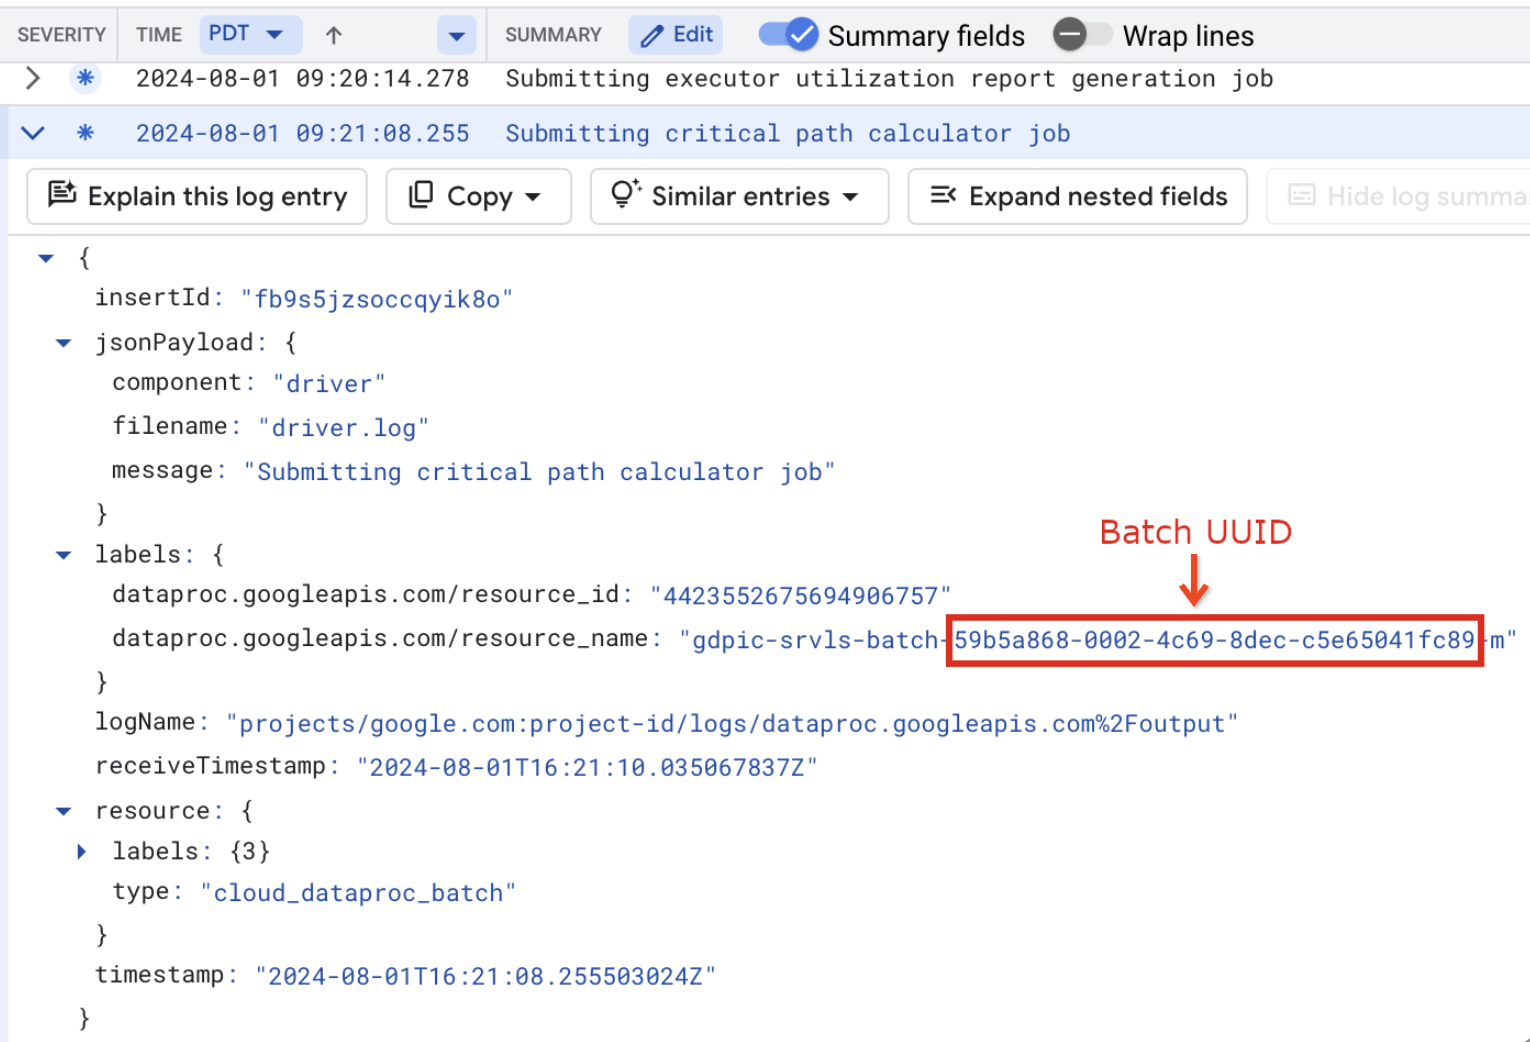
Los registros por lotes también enumeran el UUID del lote en el nombre del recurso de VM. Este es un ejemplo de un batch driver.log:
- VM_NAME_PREFIX: Usa
Haz clic en Ejecutar consulta.
Tipos de registros y consultas de muestra de Managed Service para Apache Spark
En la siguiente lista, se describen diferentes tipos de registros de Managed Service para Apache Spark y se proporcionan consultas de muestra del Explorador de registros para cada tipo de registro.
dataproc.googleapis.com/output: Este archivo de registro contiene el resultado de la carga de trabajo por lotes. Managed Service para Apache Spark transmite el resultado por lotes al espacio de nombresoutput, y establece el nombre de archivo enJOB_ID.driver.log.Consulta de muestra del Explorador de registros para registros de salida:
resource.type="cloud_dataproc_batch"
resource.labels.location="REGION"
resource.labels.batch_id="BATCH_ID"
logName="projects/PROJECT_ID/logs/dataproc.googleapis.com%2Foutput"
dataproc.googleapis.com/spark: El espacio de nombressparkagrega registros de Spark para los daemons y los ejecutores que se ejecutan en las VMs de instancia principal y de trabajador del clúster de Managed Service para Apache Spark. Cada entrada de registro incluye una etiqueta de componentemaster,workeroexecutorpara identificar la fuente del registro, de la siguiente manera:executor: Registros de ejecutores de código de usuario. Por lo general, son registros distribuidos.master: Registros de la instancia principal del administrador de recursos independiente de Spark, que son similares a los registrosResourceManagerde YARN de Managed Service para Apache Spark.worker: Registros del trabajador del administrador de recursos independiente de Spark, que son similares a los registrosNodeManagerde YARN de Managed Service para Apache Spark.
Consulta de muestra del Explorador de registros para todos los registros en el espacio de nombres
spark:resource.type="cloud_dataproc_batch" resource.labels.location="REGION" resource.labels.batch_id="BATCH_ID" logName="projects/PROJECT_ID/logs/dataproc.googleapis.com%2Fspark"
Consulta de muestra del Explorador de registros para los registros de componentes independientes de Spark en el espacio de nombres
spark:resource.type="cloud_dataproc_batch" resource.labels.location="REGION" resource.labels.batch_id="BATCH_ID" logName="projects/PROJECT_ID/logs/dataproc.googleapis.com%2Fspark" jsonPayload.component="COMPONENT"
dataproc.googleapis.com/startup: El espacio de nombresstartupincluye los registros de inicio por lotes (clúster) . Se incluyen todos los registros de secuencias de comandos de inicialización. Los componentes se identifican por etiqueta, por ejemplo:startup-script[855]: ... activate-component-spark[3050]: ... enable spark-worker
resource.type="cloud_dataproc_batch"
resource.labels.location="REGION"
resource.labels.batch_id="BATCH_ID"
logName="projects/PROJECT_ID/logs/dataproc.googleapis.com%2Fstartup"
labels."dataproc.googleapis.com/resource_name"="VM_NAME_PREFIX-BATCH_UUID-VM_SUFFIX"
dataproc.googleapis.com/agent: El espacio de nombresagentagrega registros de agentes de Managed Service para Apache Spark. Cada entrada de registro incluye una etiqueta de nombre de archivo que identifica la fuente del registro.Consulta de muestra del Explorador de registros para los registros de agentes generados por una VM de trabajador especificada:
resource.type="cloud_dataproc_batch"
resource.labels.location="REGION"
resource.labels.batch_id="BATCH_ID"
logName="projects/PROJECT_ID/logs/dataproc.googleapis.com%2Fagent"
labels."dataproc.googleapis.com/resource_name"="VM_NAME_PREFIX-BATCHUUID-wWORKER#"
dataproc.googleapis.com/autoscaler: El espacio de nombresautoscaleragrega registros de ajuste de escala automático de Managed Service para Apache Spark.Consulta de muestra del Explorador de registros para los registros de ajuste de escala automático generados por una VM de trabajador especificada:
resource.type="cloud_dataproc_batch"
resource.labels.location="REGION"
resource.labels.batch_id="BATCH_ID"
logName="projects/PROJECT_ID/logs/dataproc.googleapis.com%2Fautoscaler"
labels."dataproc.googleapis.com/resource_name"="VM_NAME_PREFIX-BATCHUUID-wWORKER#"
Para obtener más información, consulta Registros de Managed Service para Apache Spark.
Para obtener información sobre los registros de auditoría de Managed Service para Apache Spark, consulta Registro de auditoría de Managed Service para Apache Spark.
Métricas de cargas de trabajo
Managed Service para Apache Spark proporciona métricas de lotes y de Spark que puedes ver desde el Explorador de métricas o la página Detalles del lote en la Google Cloud consola de.
Métricas de lotes
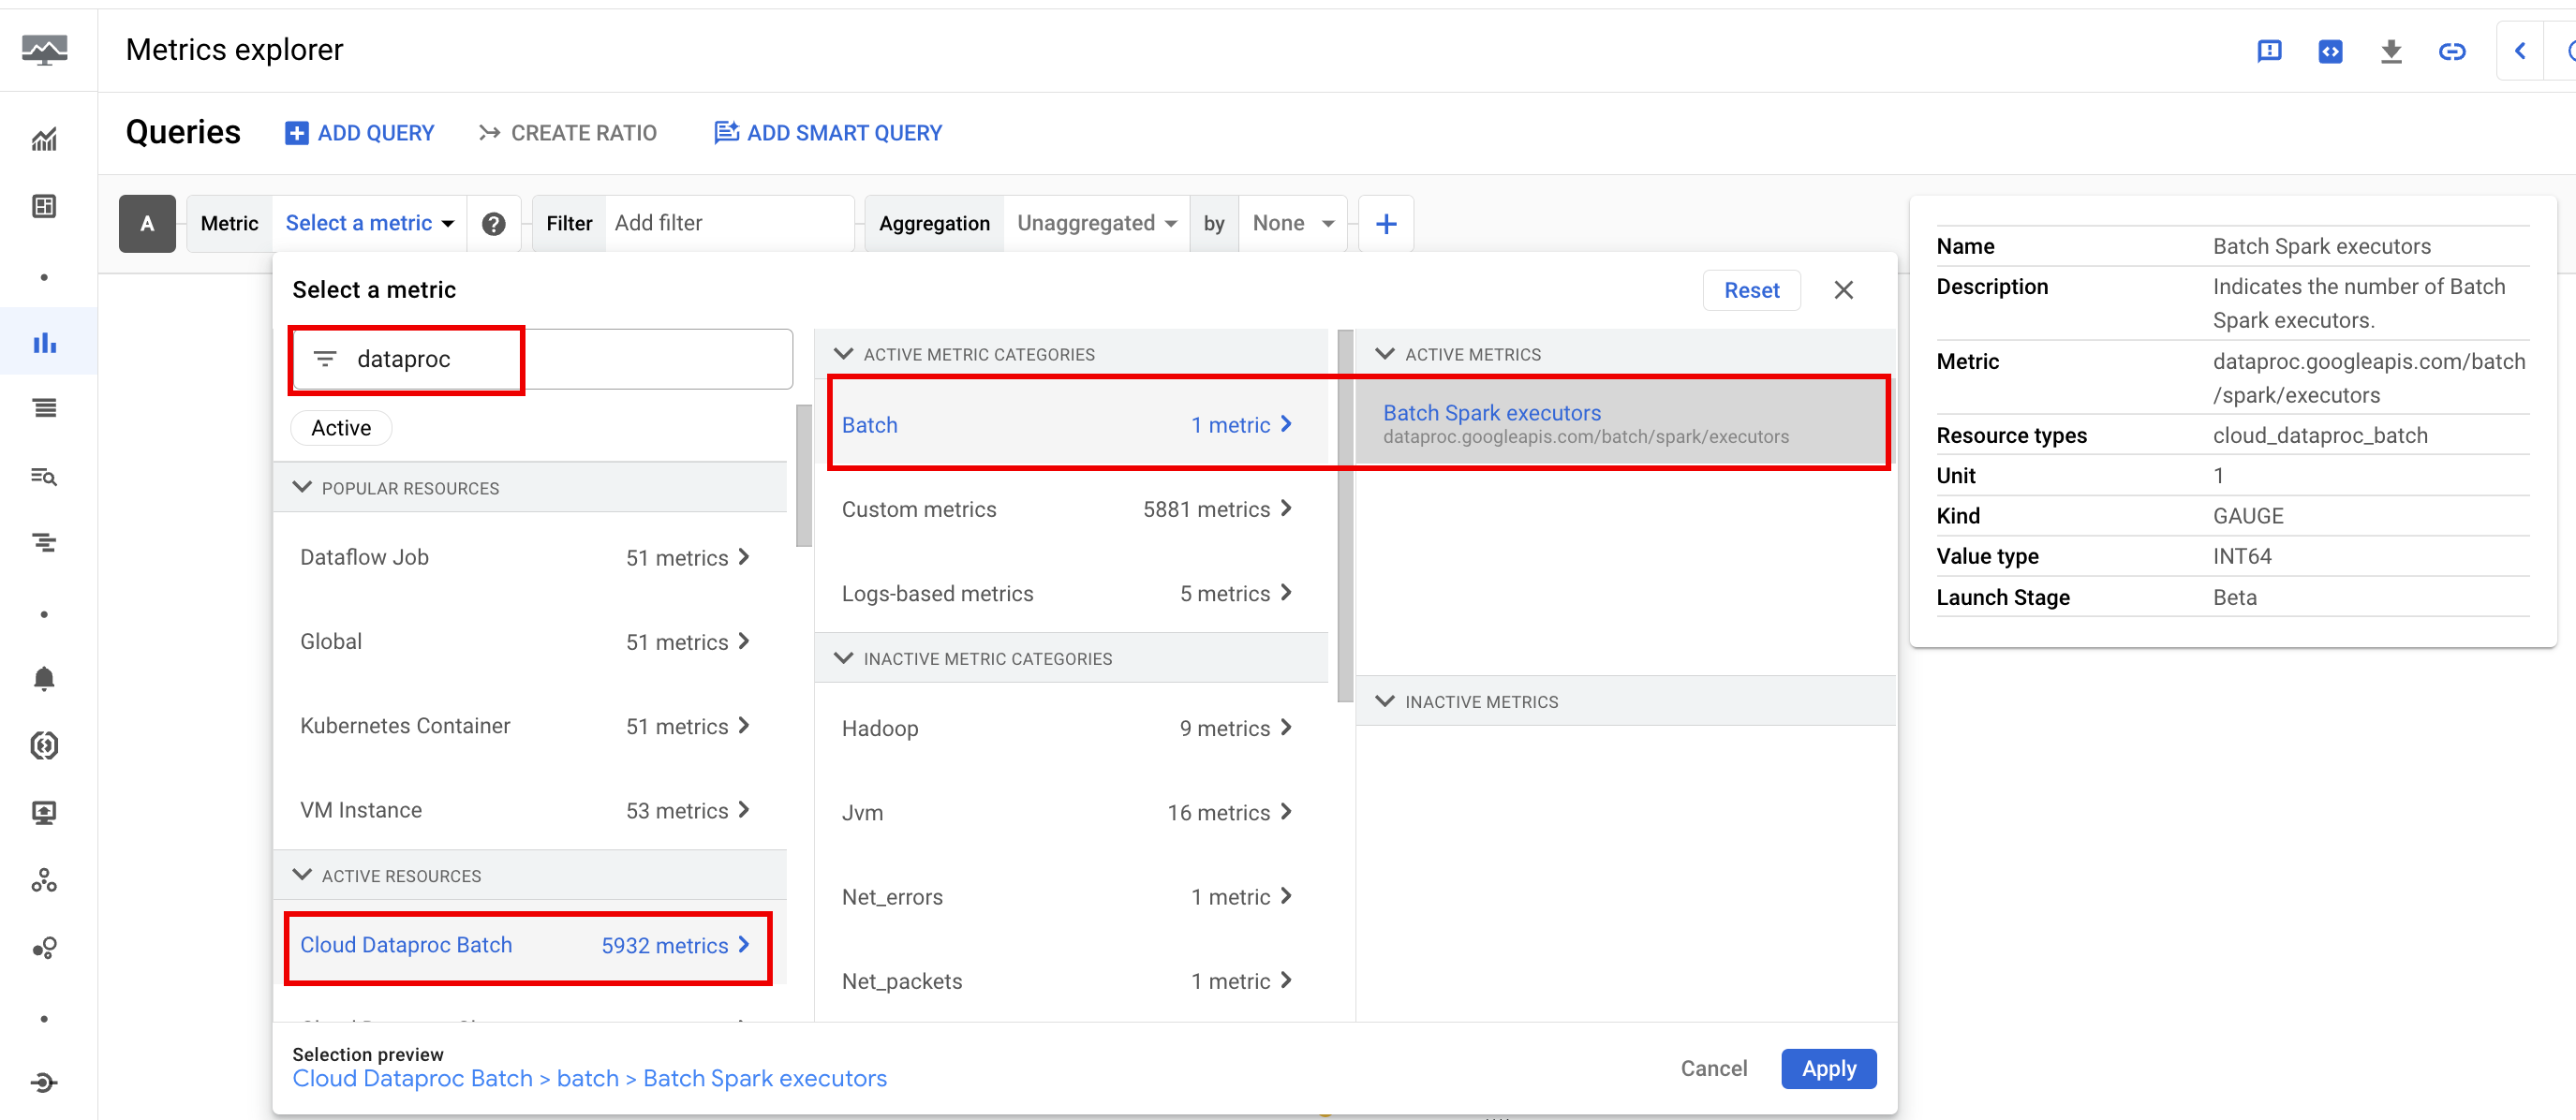
Las métricas de recursos batch de Managed Service para Apache Spark proporcionan información sobre los recursos por lotes, como la cantidad de ejecutores por lotes. Las métricas de lotes tienen el prefijo dataproc.googleapis.com/batch.
Métricas de Spark
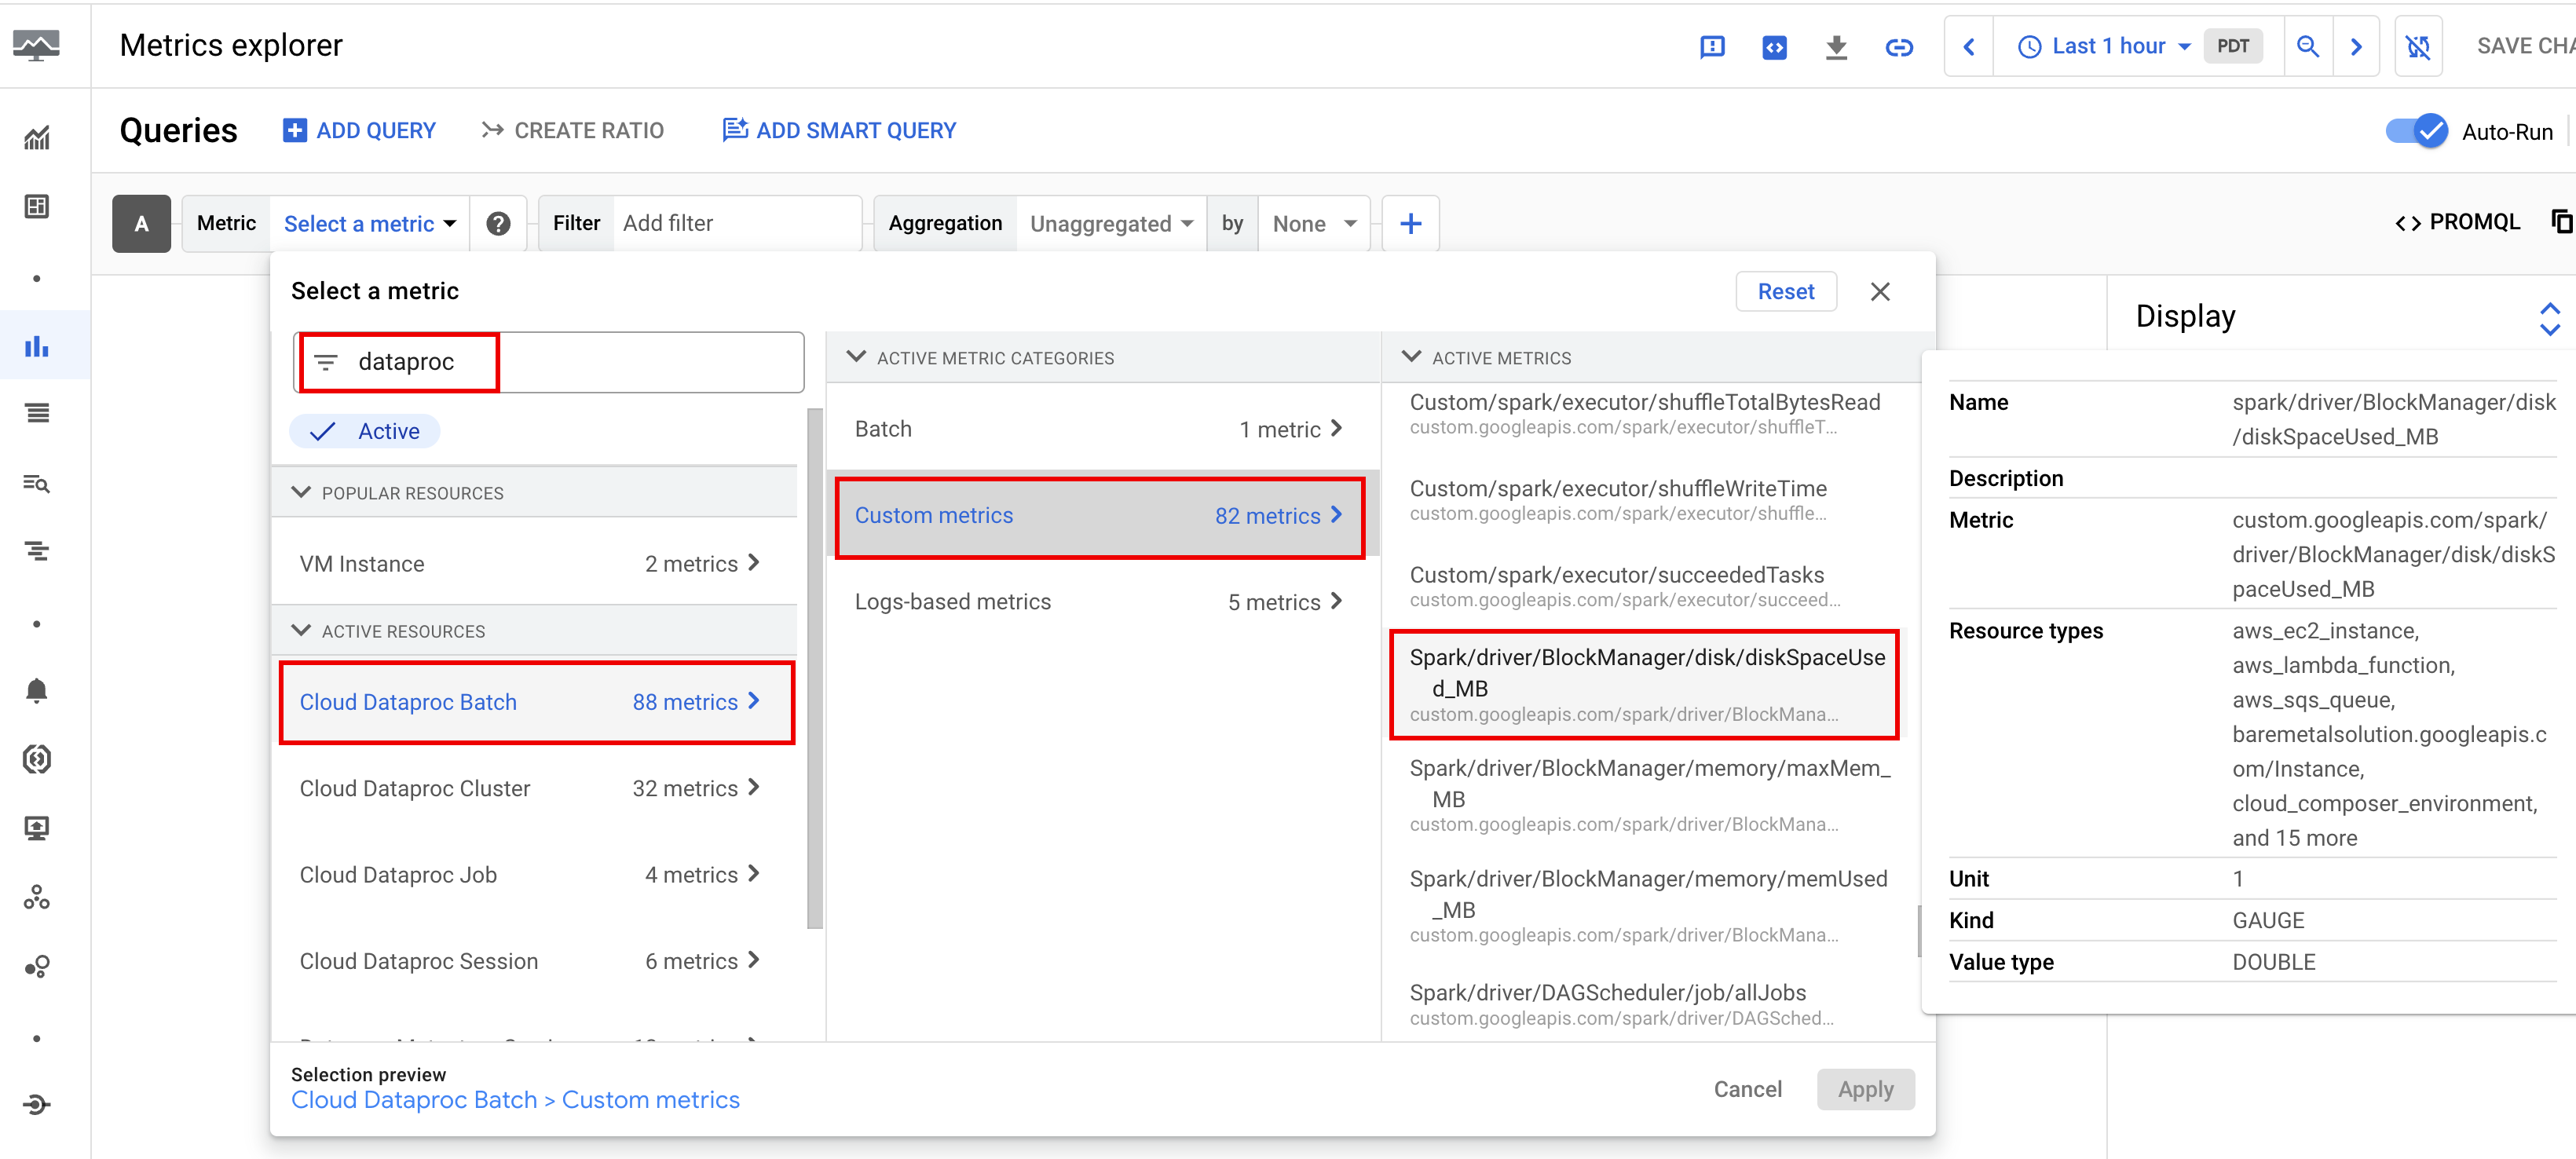
De forma predeterminada, Managed Service para Apache Spark habilita la recopilación de métricas de Spark disponibles, a menos que uses propiedades de recopilación de métricas de Spark para inhabilitar o anular la recopilación de una o más métricas de Spark.
Las métricas de Spark disponibles
incluyen métricas de controladores y ejecutores de Spark, y métricas del sistema. Las métricas de Spark disponibles tienen el prefijo custom.googleapis.com/.
Configura alertas de métricas
Puedes crear alertas de métricas de Managed Service para Apache Spark para recibir notificaciones sobre problemas de cargas de trabajo.
Crea gráficos
Puedes crear gráficos que visualicen las métricas de cargas de trabajo con el
Explorador de métricas en la
Google Cloud consola. Por ejemplo, puedes crear un gráfico para mostrar disk:bytes_used y, luego, filtrar por batch_id.
Cloud Monitoring
Monitoring usa metadatos y métricas de cargas de trabajo para proporcionar estadísticas sobre el estado y el rendimiento de las cargas de trabajo de Managed Service para Apache Spark. Las métricas de cargas de trabajo incluyen métricas de Spark, métricas de lotes y métricas de operaciones.
Puedes usar Cloud Monitoring en la Google Cloud consola para explorar métricas, agregar gráficos, crear paneles y crear alertas.
Crea paneles
Puedes crear un panel para supervisar las cargas de trabajo con métricas de varios proyectos y diferentes Google Cloud productos. Para obtener más información, consulta Crea y administra paneles personalizados.
Servidor de historial persistente
Managed Service para Apache Spark crea los recursos de procesamiento necesarios para ejecutar una carga de trabajo, ejecuta la carga de trabajo en esos recursos y, luego, borra los recursos cuando finaliza la carga de trabajo. Las métricas y los eventos de cargas de trabajo no persisten después de que se completa una carga de trabajo. Sin embargo, puedes usar un servidor de historial persistente (PHS) para conservar el historial de aplicaciones de cargas de trabajo (registros de eventos) en Cloud Storage.
Para usar un PHS con una carga de trabajo por lotes, haz lo siguiente:
Crea un servidor de historial persistente (PHS) de Managed Service para Apache Spark.
Especifica tu PHS cuando envíes una carga de trabajo.
Usa la puerta de enlace del componente para conectarte al PHS y ver los detalles de la aplicación, las etapas del programador, los detalles a nivel de la tarea y la información del entorno y del ejecutor.
Ajuste automático
- Habilita el ajuste automático para Managed Service para Apache Spark: Puedes habilitar el ajuste automático para Managed Service para Apache Spark cuando envías cada carga de trabajo por lotes de Spark recurrente con la Google Cloud consola de, gcloud CLI o la API de Managed Service para Apache Spark.
Console
Sigue estos pasos para habilitar el ajuste automático en cada carga de trabajo por lotes de Spark recurrente:
En la Google Cloud consola de, ve a la página Lotes de Managed Service para Apache Spark.
Para crear una carga de trabajo por lotes, haz clic en Crear.
En la sección Contenedor, completa el nombre de Cohorte, que identifica el lote como uno de una serie de cargas de trabajo recurrentes. El análisis asistido por Gemini se aplica a la segunda y las siguientes cargas de trabajo que se envían con este nombre de cohorte. Por ejemplo, especifica
TPCH-Query1como el nombre de cohorte para una carga de trabajo programada que ejecuta una consulta TPC-H diaria.Completa otras secciones de la página Crear lote según sea necesario y, luego, haz clic en Enviar. Para obtener más información, consulta Envía una carga de trabajo por lotes.
gcloud
Ejecuta el siguiente comando
gcloud dataproc batches submit
de la gcloud CLI de forma local en una ventana de terminal o en Cloud Shell
para habilitar el ajuste automático en cada carga de trabajo por lotes de Spark recurrente:
gcloud dataproc batches submit COMMAND \
    --region=REGION \
    --cohort=COHORT \
    other arguments ...
Reemplaza lo siguiente:
- COMMAND: el tipo de carga de trabajo de Spark, como
Spark,PySpark,Spark-Sql, oSpark-R. - REGION: la región en la que se ejecutará tu carga de trabajo.
- COHORT: el nombre de la cohorte, que
identifica el lote como uno de una serie de cargas de trabajo recurrentes.
El análisis asistido por Gemini se aplica a la segunda y las siguientes cargas de trabajo que se envían
con este nombre de cohorte. Por ejemplo, especifica
TPCH Query 1como el nombre de cohorte para una carga de trabajo programada que ejecuta una consulta TPC-H diaria.
API
Incluye el RuntimeConfig.cohort
nombre en una solicitud batches.create
para habilitar el ajuste automático en cada carga de trabajo por lotes de Spark
recurrente. El ajuste automático se aplica a la segunda y las siguientes cargas de trabajo que se envían con este nombre de cohorte. Por ejemplo, especifica TPCH-Query1 como el nombre de cohorte para una carga de trabajo programada que ejecuta una consulta TPC-H diaria.
Ejemplo:
...
runtimeConfig:
  cohort: TPCH-Query1
...