


Les comptes de service dans Managed Service pour Apache Spark vous permettent d'authentifier les charges de travail par lot et les sessions interactives pour accéder de manière sécurisée aux ressources Google Cloud . Les charges de travail s'exécutent avec les identifiants de l'utilisateur final ou du compte de service. Lorsque des identifiants de compte de service sont utilisés, le compte de service spécifique attribué pour exécuter la charge de travail dépend de la version d'exécution du lot ou de la session.
Comptes de service d'exécution antérieurs à la version 3.0
Les versions d'exécution Spark antérieures à 3.0 avec des identifiants de compte de service utilisent le compte de service Compute Engine par défaut ou un compte de service personnalisé spécifié par l'utilisateur pour envoyer une charge de travail par lot ou créer une session interactive.
Comptes de service d'exécution 3.0 ou version ultérieure
Les versions d'exécution Spark 3.0 et ultérieures avec des identifiants de compte de service utilisent un compte de service personnalisé spécifié par l'utilisateur pour envoyer une charge de travail par lot ou créer une session interactive.
Les environnements d'exécution Managed Service pour Apache Spark 3.0 et versions ultérieures créent le compte de service Agent de service de nœud Resource Manager pour Dataproc, service-project-number@gcp-sa-dataprocrmnode.iam.gserviceaccount.com, avec le rôle Agent de service de nœud Resource Manager pour Dataproc dans un projet utilisateur Google Cloud Managed Service pour Apache Spark. Ce compte de service effectue les opérations système suivantes sur les ressources Managed Service pour Apache Spark situées dans le projet où une charge de travail est créée :
- Cloud Logging et Cloud Monitoring
- Opérations de base du nœud Resource Manager de Managed Service pour Apache Spark, telles que
get,heartbeatetmintOAuthToken
Afficher et gérer les rôles des comptes de service IAM
Pour afficher et gérer les rôles attribués au compte de service de la charge de travail par lot ou de la session, procédez comme suit :
Dans la console Google Cloud , accédez à la page IAM.
Cliquez sur Inclure les attributions de rôles fournies par Google.
Affichez les rôles répertoriés pour le compte de service par défaut ou personnalisé de la charge de travail ou de la session par lot.
L'image suivante montre le rôle Nœud de calcul Managed Service pour Apache Spark requis, listé pour le compte de service Compute Engine par défaut,
project_number-compute@developer.gserviceaccount.com, que Managed Service pour Apache Spark utilise par défaut comme compte de service de charge de travail ou de session.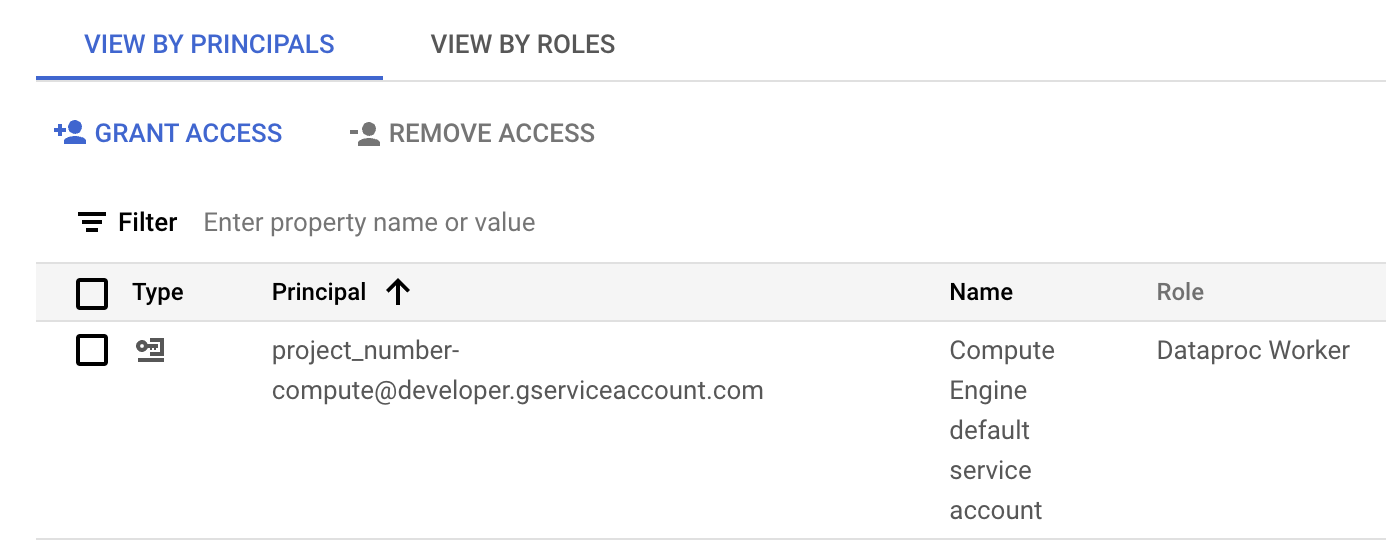
Le rôle de nœud de calcul Managed Service pour Apache Spark attribué au compte de service Compute Engine par défaut dans la section IAM de la console Google Cloud . Vous pouvez cliquer sur l'icône en forme de crayon affichée sur la ligne du compte de service pour accorder ou supprimer des rôles de compte de service.
Utiliser un compte de service multiprojet
Vous pouvez envoyer une charge de travail par lot qui utilise un compte de service d'un projet différent de celui de la charge de travail par lot (le projet dans lequel le lot est envoyé). Dans cette section, le projet dans lequel se trouve le compte de service est appelé service account project, et le projet dans lequel le lot est envoyé est appelé batch project.
Pourquoi utiliser un compte de service multiprojet pour exécuter une charge de travail par lot ? Cela peut s'expliquer par le fait que le compte de service de l'autre projet s'est vu attribuer des rôles IAM qui fournissent un accès précis aux ressources de ce projet.
Procédure de configuration
Les exemples de cette section s'appliquent à l'envoi d'une charge de travail par lot exécutée avec une version d'exécution antérieure à 3.0.
Dans le projet du compte de service :
Activer l'association des comptes de service à plusieurs projets
Si ce n'est pas déjà fait, activez l'API Managed Service pour Apache Spark.
Rôles requis pour activer les API
Pour activer des API, vous devez disposer de l'autorisation
serviceusage.services.enable. Si vous avez créé le projet, vous disposez probablement déjà de cette autorisation via le rôle Propriétaire (roles/owner). Sinon, vous pouvez l'obtenir via le rôle Administrateur Service Usage (roles/serviceusage.serviceUsageAdmin). Découvrez comment attribuer des rôles.Attribuez à votre compte de messagerie (l'utilisateur qui crée le cluster) le rôle Utilisateur du compte de service sur le projet du compte de service ou, pour un contrôle plus précis, sur le compte de service dans le projet du compte de service.
Pour en savoir plus, consultez Gérer l'accès aux projets, aux dossiers et aux organisations pour attribuer des rôles au niveau du projet et Gérer l'accès aux comptes de service pour attribuer des rôles au niveau du compte de service.
Exemples de gcloud CLI :
L'exemple de commande suivant attribue à l'utilisateur le rôle "Utilisateur du compte de service" au niveau du projet :
gcloud projects add-iam-policy-binding SERVICE_ACCOUNT_PROJECT_ID \
    --member=USER_EMAIL \
    --role="roles/iam.serviceAccountUser"
Remarques :
USER_EMAIL: indiquez l'adresse e-mail de votre compte utilisateur au formatuser:user-name@example.com.
L'exemple de commande suivant attribue à l'utilisateur le rôle "Utilisateur du compte de service" au niveau du compte de service :
gcloud iam service-accounts add-iam-policy-binding VM_SERVICE_ACCOUNT_EMAIL \
    --member=USER_EMAIL \
    --role="roles/iam.serviceAccountUser"
Remarques :
USER_EMAIL: indiquez l'adresse e-mail de votre compte utilisateur au formatuser:user-name@example.com.
Attribuez au compte de service le rôle Nœud de calcul Managed Service pour Apache Spark sur le projet de lot.
Exemple gcloud CLI :
gcloud projects add-iam-policy-binding BATCH_PROJECT_ID \
    --member=serviceAccount:SERVICE_ACCOUNT_NAME@SERVICE_ACCOUNT_PROJECT_ID.iam.gserviceaccount.com \
    --role="roles/dataproc.worker"
Dans le projet de traitement par lot :
Attribuez au compte de service de l'agent de service Managed Service pour Apache Spark les rôles Utilisateur du compte de service et Créateur de jetons du compte de service sur le projet du compte de service ou, pour un contrôle plus précis, sur le compte de service dans le projet du compte de service. Vous autorisez ainsi le compte de service de l'agent de service Managed Service pour Apache Spark du projet de traitement par lot à créer des jetons pour le compte de service du projet de compte de service.
Pour en savoir plus, consultez Gérer l'accès aux projets, aux dossiers et aux organisations pour attribuer des rôles au niveau du projet et Gérer l'accès aux comptes de service pour attribuer des rôles au niveau du compte de service.
Exemples de gcloud CLI :
Les commandes suivantes attribuent au compte de service de l'agent de service Managed Service pour Apache Spark dans le projet de traitement par lot les rôles d'utilisateur du compte de service et de créateur de jetons du compte de service au niveau du projet :
gcloud projects add-iam-policy-binding SERVICE_ACCOUNT_PROJECT_ID \
    --member=serviceAccount:service-BATCH_PROJECT_NUMBER@dataproc-accounts.iam.gserviceaccount.com \
    --role="roles/iam.serviceAccountUser"
gcloud projects add-iam-policy-binding SERVICE_ACCOUNT_PROJECT_ID \
    --member=serviceAccount:service-BATCH_PROJECT_NUMBER@dataproc-accounts.iam.gserviceaccount.com \
    --role="roles/iam.serviceAccountTokenCreator"
Les exemples de commandes suivants attribuent au compte de service de l'agent de service Managed Service pour Apache Spark dans le projet de traitement par lot les rôles d'utilisateur du compte de service et de créateur de jetons du compte de service au niveau du compte de service :
gcloud iam service-accounts add-iam-policy-binding VM_SERVICE_ACCOUNT_EMAIL \
    --member=serviceAccount:service-BATCH_PROJECT_NUMBER@dataproc-accounts.iam.gserviceaccount.com \
    --role="roles/iam.serviceAccountUser"
gcloud iam service-accounts add-iam-policy-binding VM_SERVICE_ACCOUNT_EMAIL \
    --member=serviceAccount:service-BATCH_PROJECT_NUMBER@dataproc-accounts.iam.gserviceaccount.com \
    --role="roles/iam.serviceAccountTokenCreator"
Attribuez au compte de service de l'agent de service Compute Engine du projet de traitement par lot le rôle Créateur de jetons du compte de service sur le projet du compte de service ou, pour un contrôle plus précis, sur le compte de service du projet du compte de service. Vous autorisez ainsi le compte de service de l'agent de service Compute Agent du projet de traitement par lot à créer des jetons pour le compte de service du projet de compte de service.
Pour en savoir plus, consultez Gérer l'accès aux projets, aux dossiers et aux organisations pour attribuer des rôles au niveau du projet et Gérer l'accès aux comptes de service pour attribuer des rôles au niveau du compte de service.
Exemples de gcloud CLI :
L'exemple de commande suivant attribue au compte de service de l'agent de service Compute Engine du projet Batch le rôle "Créateur de jetons du compte de service" au niveau du projet :
gcloud projects add-iam-policy-binding SERVICE_ACCOUNT_PROJECT_ID \
    --member=serviceAccount:service-BATCH_PROJECT_NUMBER@compute-system.iam.gserviceaccount.com \
    --role="roles/iam.serviceAccountTokenCreator"
L'exemple de commande suivant attribue au compte de service de l'agent de service Compute Engine dans le projet de cluster le rôle "Créateur de jetons du compte de service" au niveau du compte de service :
gcloud iam service-accounts add-iam-policy-binding VM_SERVICE_ACCOUNT_EMAIL \
    --member=serviceAccount:service-BATCH_PROJECT_NUMBER@compute-system.iam.gserviceaccount.com \
    --role="roles/iam.serviceAccountTokenCreator"
Envoyer la charge de travail par lot
Une fois les étapes de configuration terminées, vous pouvez envoyer une charge de travail par lot. Veillez à spécifier le compte de service du projet de compte de service comme compte de service à utiliser pour la charge de travail par lot.
Résoudre les problèmes d'échec liés aux autorisations
Des autorisations incorrectes ou insuffisantes pour le compte de service utilisé par votre charge de travail ou session par lot peuvent entraîner des échecs de création de lot ou de session qui signalent un message d'erreur "Échec de l'initialisation du nœud de calcul du pilote pour le lot en 600 secondes". Cette erreur indique que le pilote Spark n'a pas pu démarrer dans le délai imparti, souvent en raison d'un manque d'accès aux ressources Google Cloud .
Pour résoudre ce problème, vérifiez que votre compte de service dispose des rôles ou autorisations minimales suivants :
- Rôle Nœud de calcul Managed Service pour Apache Spark (
roles/dataproc.worker) : ce rôle accorde les autorisations nécessaires à Managed Service pour Apache Spark pour gérer et exécuter des charges de travail et des sessions Spark. - Lecteur des objets Storage (
roles/storage.objectViewer), Créateur des objets Storage (roles/storage.objectCreator) ou Administrateur des objets Storage (roles/storage.admin) : si votre application Spark lit ou écrit dans des buckets Cloud Storage, le compte de service doit disposer des autorisations appropriées pour accéder aux buckets. Par exemple, si vos données d'entrée se trouvent dans un bucket Cloud Storage,Storage Object Viewerest requis. Si votre application écrit des résultats dans un bucket Cloud Storage,Storage Object CreatorouStorage Object Adminest nécessaire. - Éditeur de données BigQuery (
roles/bigquery.dataEditor) ou Lecteur de données BigQuery (roles/bigquery.dataViewer) : si votre application Spark interagit avec BigQuery, vérifiez que le compte de service dispose des rôles BigQuery appropriés. - Autorisations Cloud Logging : le compte de service doit disposer des autorisations nécessaires pour écrire des journaux dans Logging afin de permettre un débogage efficace. En règle générale, le rôle
Logging Writer(roles/logging.logWriter) est suffisant.
Échecs courants liés aux autorisations ou aux accès
Rôle
dataproc.workermanquant : sans ce rôle principal, l'infrastructure Managed Service pour Apache Spark ne peut pas provisionner ni gérer correctement le nœud pilote.Autorisations Cloud Storage insuffisantes : si votre application Spark tente de lire des données d'entrée à partir d'un bucket Cloud Storage ou d'y écrire des données de sortie sans les autorisations de compte de service nécessaires, l'initialisation du pilote peut échouer, car il n'a pas accès aux ressources critiques.
Problèmes de réseau ou de pare-feu : VPC Service Controls ou les règles de pare-feu peuvent bloquer par inadvertance l'accès du compte de service aux API ou aux ressources Google Cloud .
Pour vérifier et mettre à jour les autorisations du compte de service :
- Accédez à la page IAM et administration > IAM de la console Google Cloud .
- Recherchez le compte de service utilisé pour vos charges de travail ou sessions par lot.
- Vérifiez que les rôles nécessaires sont attribués. Si ce n'est pas le cas, ajoutez-les.
Pour obtenir la liste des rôles et des autorisations Managed Service pour Apache Spark, consultez Autorisations et rôles IAM Managed Service pour Apache Spark.