


Mit der Datenherkunft in Knowledge Catalog (ehemals Dataplex Universal Catalog) können Sie Datenbewegungen verfolgen, die Herkunft von Daten nachvollziehen und Fehler in Datenpipelines beheben. Wenn Herkunftsdiagramme, Prozessmetadaten, Tabellendetails oder Links auf Spaltenebene nicht wie erwartet angezeigt werden oder unerwartete Gebühren für die Knowledge Catalog Premium-Verarbeitung anfallen, können Sie Ihre Projektberechtigungen, API-Einstellungen und unterstützten Jobtypen prüfen.
Wenn Sie Hilfe bei der Behebung eines Problems benötigen, das in diesem Dokument nicht behandelt wird, wenden Sie sich an den Cloud Customer Care.
Projekttypen
Daten-Assets können sich in verschiedenen Projekten befinden. Im Folgenden finden Sie eine Zusammenfassung möglicher Projekte und ihrer Asset-Namen.
BigQuery-Speicherprojekt
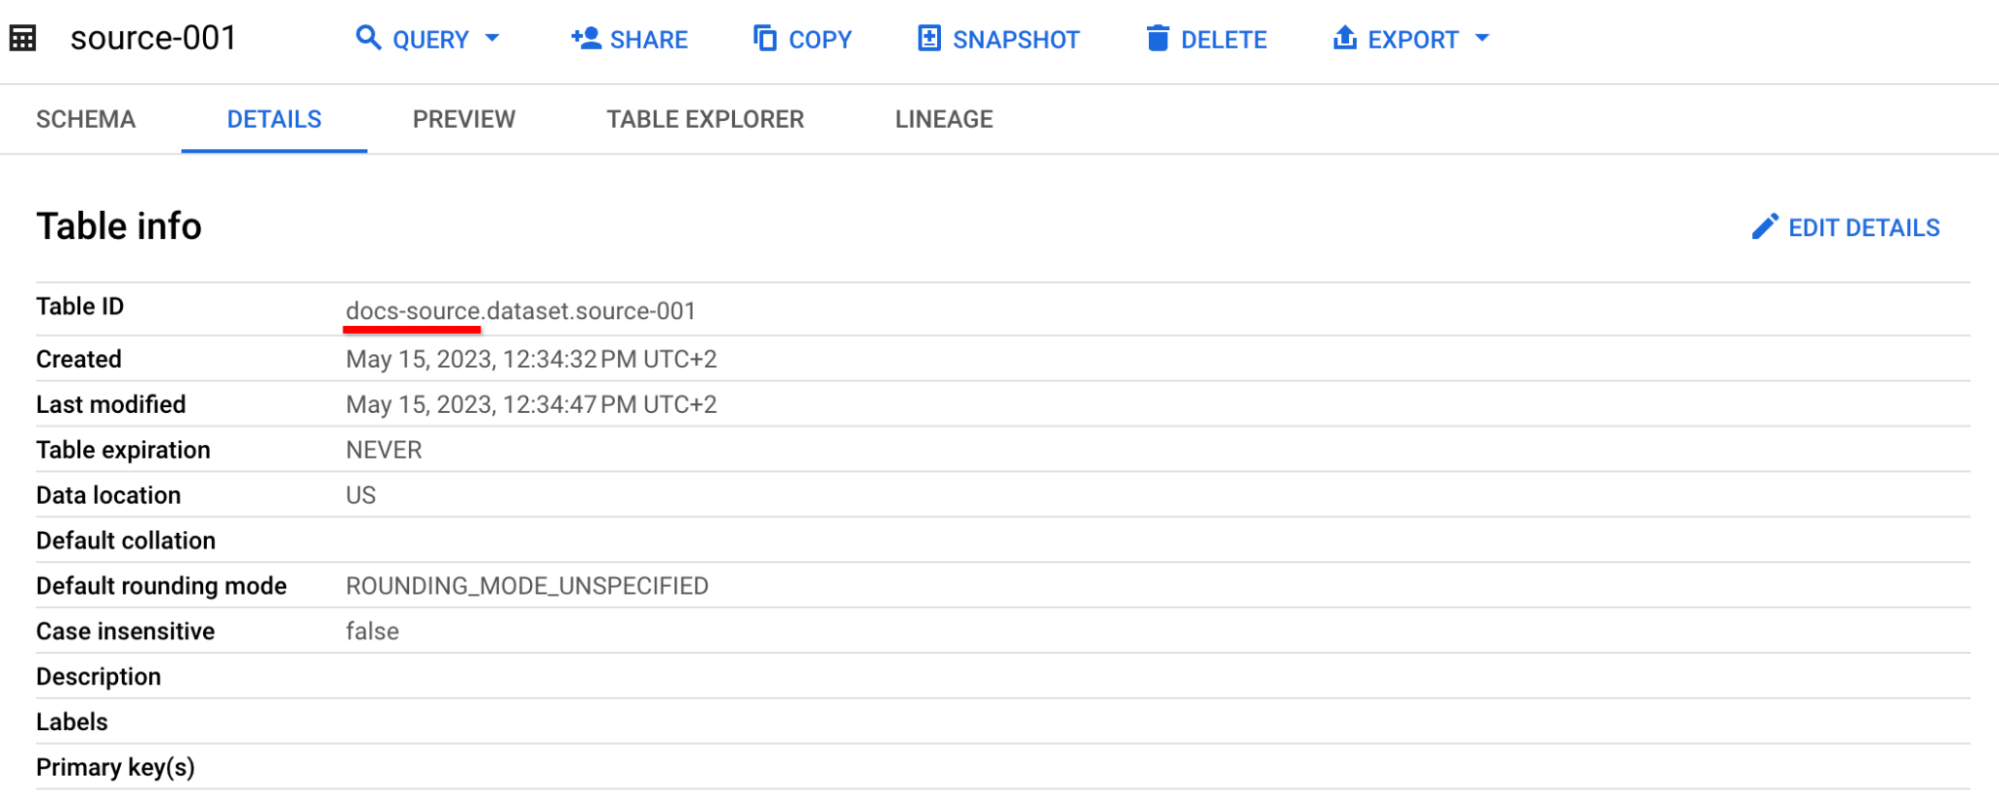
In diesem Projekt werden Ihre BigQuery-Daten-Assets gespeichert. Sie finden sie in den Asset-Details als Teil von Table ID vor dem ersten Punkt.
Compute-Projekt
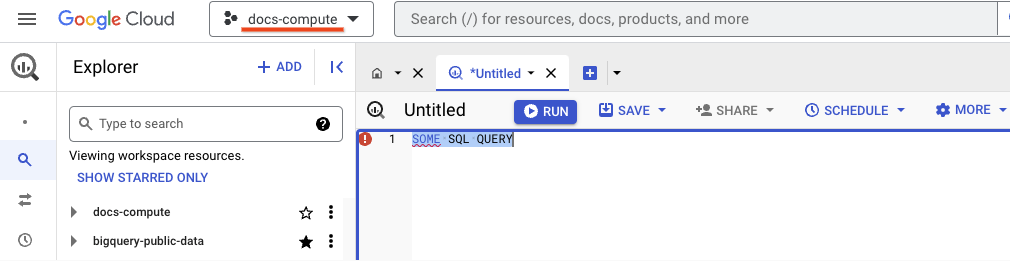
In diesem Projekt werden die Metadaten zur Datenherkunft gespeichert. In BigQuery ist dies der Ort, an dem Sie einen Job ausführen. Wenn Sie einen Job über dieGoogle Cloud Console ausführen, finden Sie den Namen des Compute-Projekts in der Projektauswahl:
Wenn Sie Anfragen an die BigQuery API senden, geben Sie das Compute-Projekt in der URL an, z. B.:
POST /bigquery/v2/projects/docs-compute/jobs HTTP/1.1
Host: bigquery.googleapis.com
User-Agent: Go-http-client/1.1
Authorization: <REDACTED 1031 BYTES>
Accept-Encoding: gzip
{
  "configuration": {
    "query": {
      "useLegacySql": false,
      "query": "CREATE OR REPLACE TABLE `docs-target.dataset.target-002` AS SELECT * FROM `docs-source.dataset.source-002`;"
    }
  },
  "jobReference": {
    "projectId": "docs-compute",
    "jobId": "docs-compute-job-id",
    "location": "us",
  }
}
Aktives Projekt
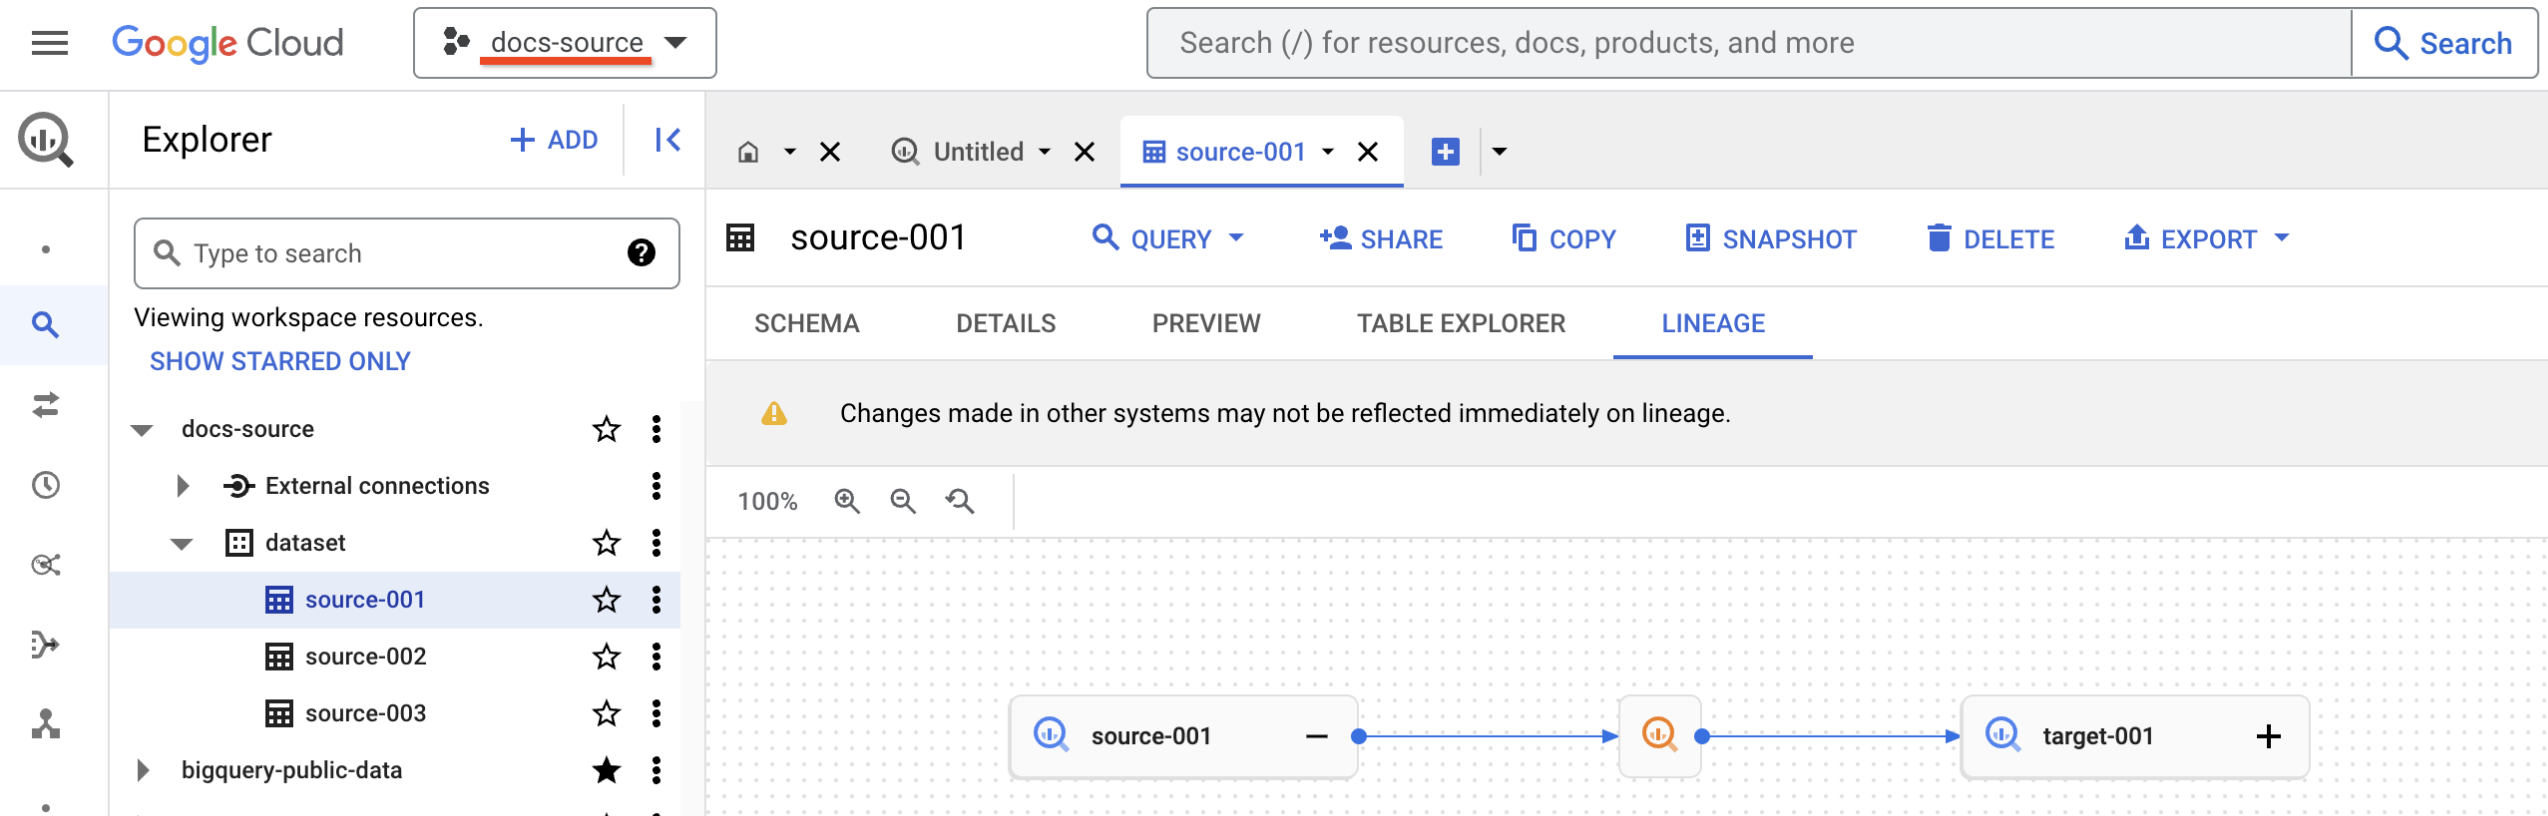
Dies ist das Projekt, aus dem Sie die Datenherkunft aufrufen. In derGoogle Cloud Console wird das aktive Projekt in der Projektauswahl angezeigt. Wenn Sie die API verwenden, ist das aktive Projekt das Projekt, von dem aus Sie API-Aufrufe ausführen.
BigQuery-Datenherkunft wird nicht angezeigt
Das folgende Problem tritt nach dem Ausführen eines BigQuery-Jobs auf. In diesem Fall kann das Problem durch drei Szenarien verursacht werden:
- Die Data Lineage API ist im aktiven Projekt oder im Compute-Projekt deaktiviert.
- Sie haben nicht die Rolle Data Lineage-Betrachter (
roles/datalineage.viewer) im aktiven oder im Compute-Projekt. - Die Datenherkunft ist noch nicht verfügbar. Je nach Volumen und Komplexität der verarbeiteten Daten kann es zwischen 30 Minuten und 24 Stunden dauern, bis die Datenherkunft angezeigt wird.
Wenn die Meldung „Herkunft konnte aufgrund fehlender Berechtigungen nicht abgerufen werden“ angezeigt wird, fehlen Ihnen Berechtigungen für das aktive Projekt. Andernfalls fehlen Ihnen Berechtigungen für das Compute-Projekt.
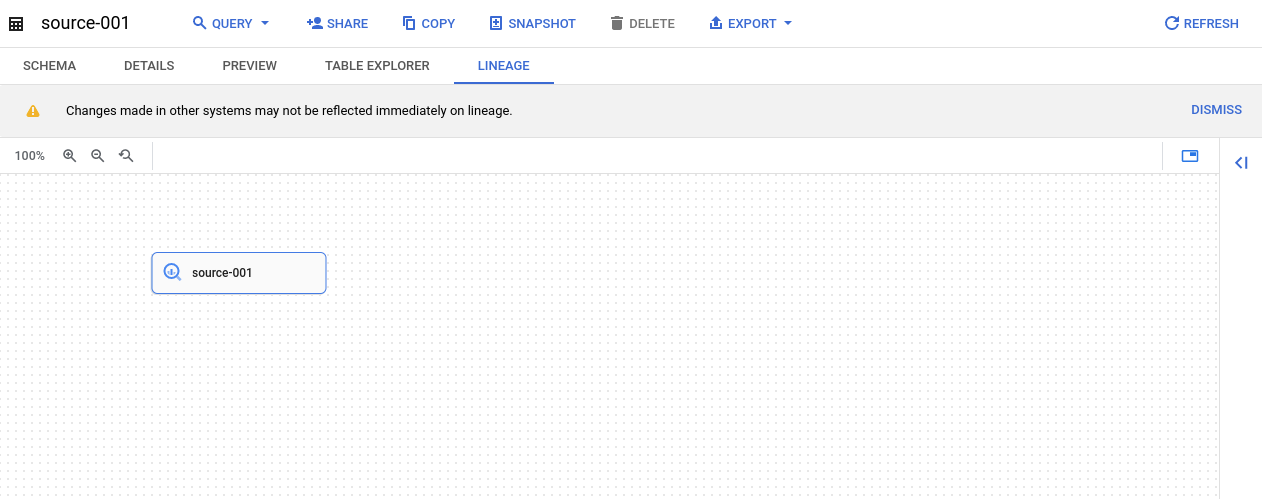
Prüfen Sie zur Behebung dieses Problems, ob die Data Lineage API für das Compute-Projekt aktiviert ist. Nachdem Sie die API aktiviert haben, müssen Sie einen Job ausführen, um die Datenherkunft zu sehen. Je nach Volumen und Komplexität der verarbeiteten Daten kann es zwischen 30 Minuten und 24 Stunden dauern, bis die Datenherkunft angezeigt wird.
Prüfen Sie als Nächstes, ob die Data Lineage API für das aktive Projekt aktiviert ist.
Wenn die Data Lineage API aktiviert ist, weisen Sie die Rolle „Data Lineage Viewer“ (roles/datalineage.viewer) sowohl im aktiven als auch im Compute-Projekt zu.
BigQuery-Prozessmetadaten werden nicht angezeigt
Das folgende Problem tritt auf, wenn Sie den Detailbereich der Tabelle öffnen. Es werden nicht alle Details wie die SQL-Anweisung oder das Attribut Process type angezeigt.
Dies geschieht, obwohl die Datenherkunft korrekt angezeigt wird.
Dies kann passieren, wenn Sie nicht berechtigt sind, Metadaten im Compute-Projekt anzusehen.
Beispiel:
- BigQuery-Quelltabelle:
docs-source.dataset.source-001 - BigQuery-Zieltabelle:
docs-target.dataset.target-001 - Datenherkunft zwischen
docs-source.dataset.source-001unddocs-target.dataset.target-001im Compute-Projektdocs-compute - Sie haben die Rolle Data Lineage-Betrachter für die aktiven und Computing-
docs-compute-Projekte.
Wenn Sie auf die BigQuery-Prozessdetails klicken, wird in der Google Cloud Console die folgende Meldung angezeigt:
You don't have permission to view BigQuery process metadata in project X.
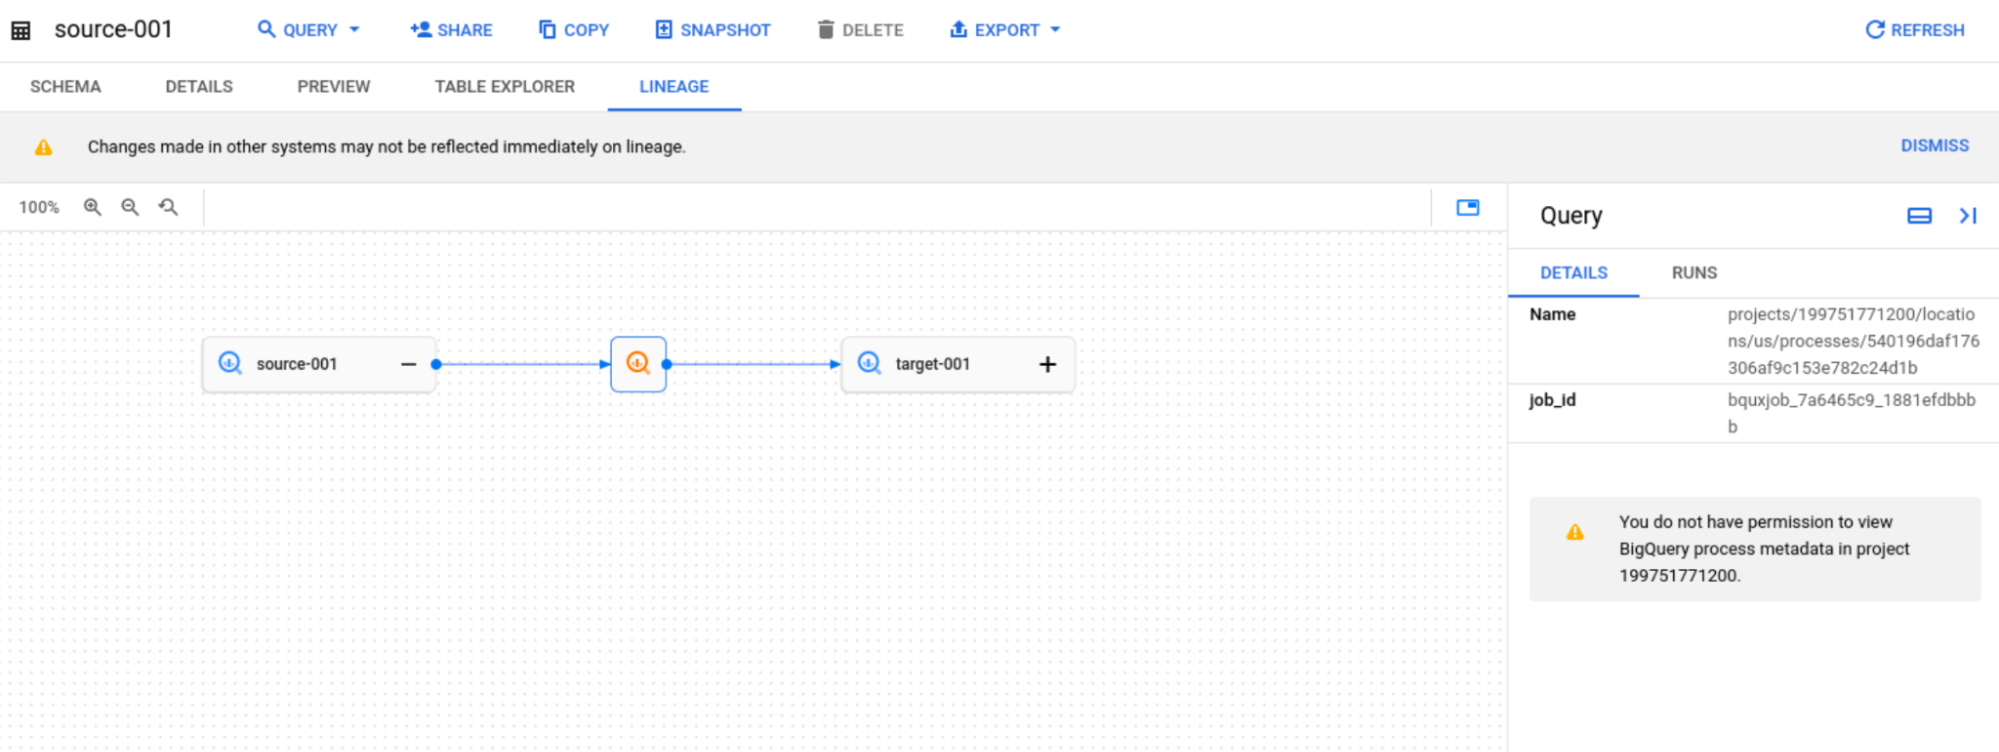
Um dieses Problem zu beheben, weisen Sie dem Nutzer im Compute-Projekt die Berechtigung bigquery.jobs.get zu (z. B. in der Rolle BigQuery Resource Viewer enthalten).
BigQuery-Tabellendetails werden nicht angezeigt
Das folgende Problem tritt auf, wenn Sie den Bereich mit den Tabellendetails öffnen, in dem nur das Attribut Fully qualified name angezeigt wird. Dies geschieht, obwohl die Datenherkunft korrekt angezeigt wird. Dies kann passieren, wenn Sie nicht alle erforderlichen Berechtigungen in den Speicherprojekten der Tabelle haben.
Beispiel:
- BigQuery-Tabelle
docs-source.dataset.source-001 - BigQuery-Tabelle
docs-target.dataset.target-001 - Datenherkunft zwischen
docs-source.dataset.source-001unddocs-target.dataset.target-001mit dem Compute-Projektdocs-compute - Sie haben die Rolle Data Lineage-Betrachter für die aktiven und Computing-
docs-compute-Projekte.
In diesem Fall wird die Meldung Entry with this fully qualified name is not available in Knowledge Catalog or
you do not have permissions to view it angezeigt, wenn Sie auf die BigQuery-Knotendetails klicken.
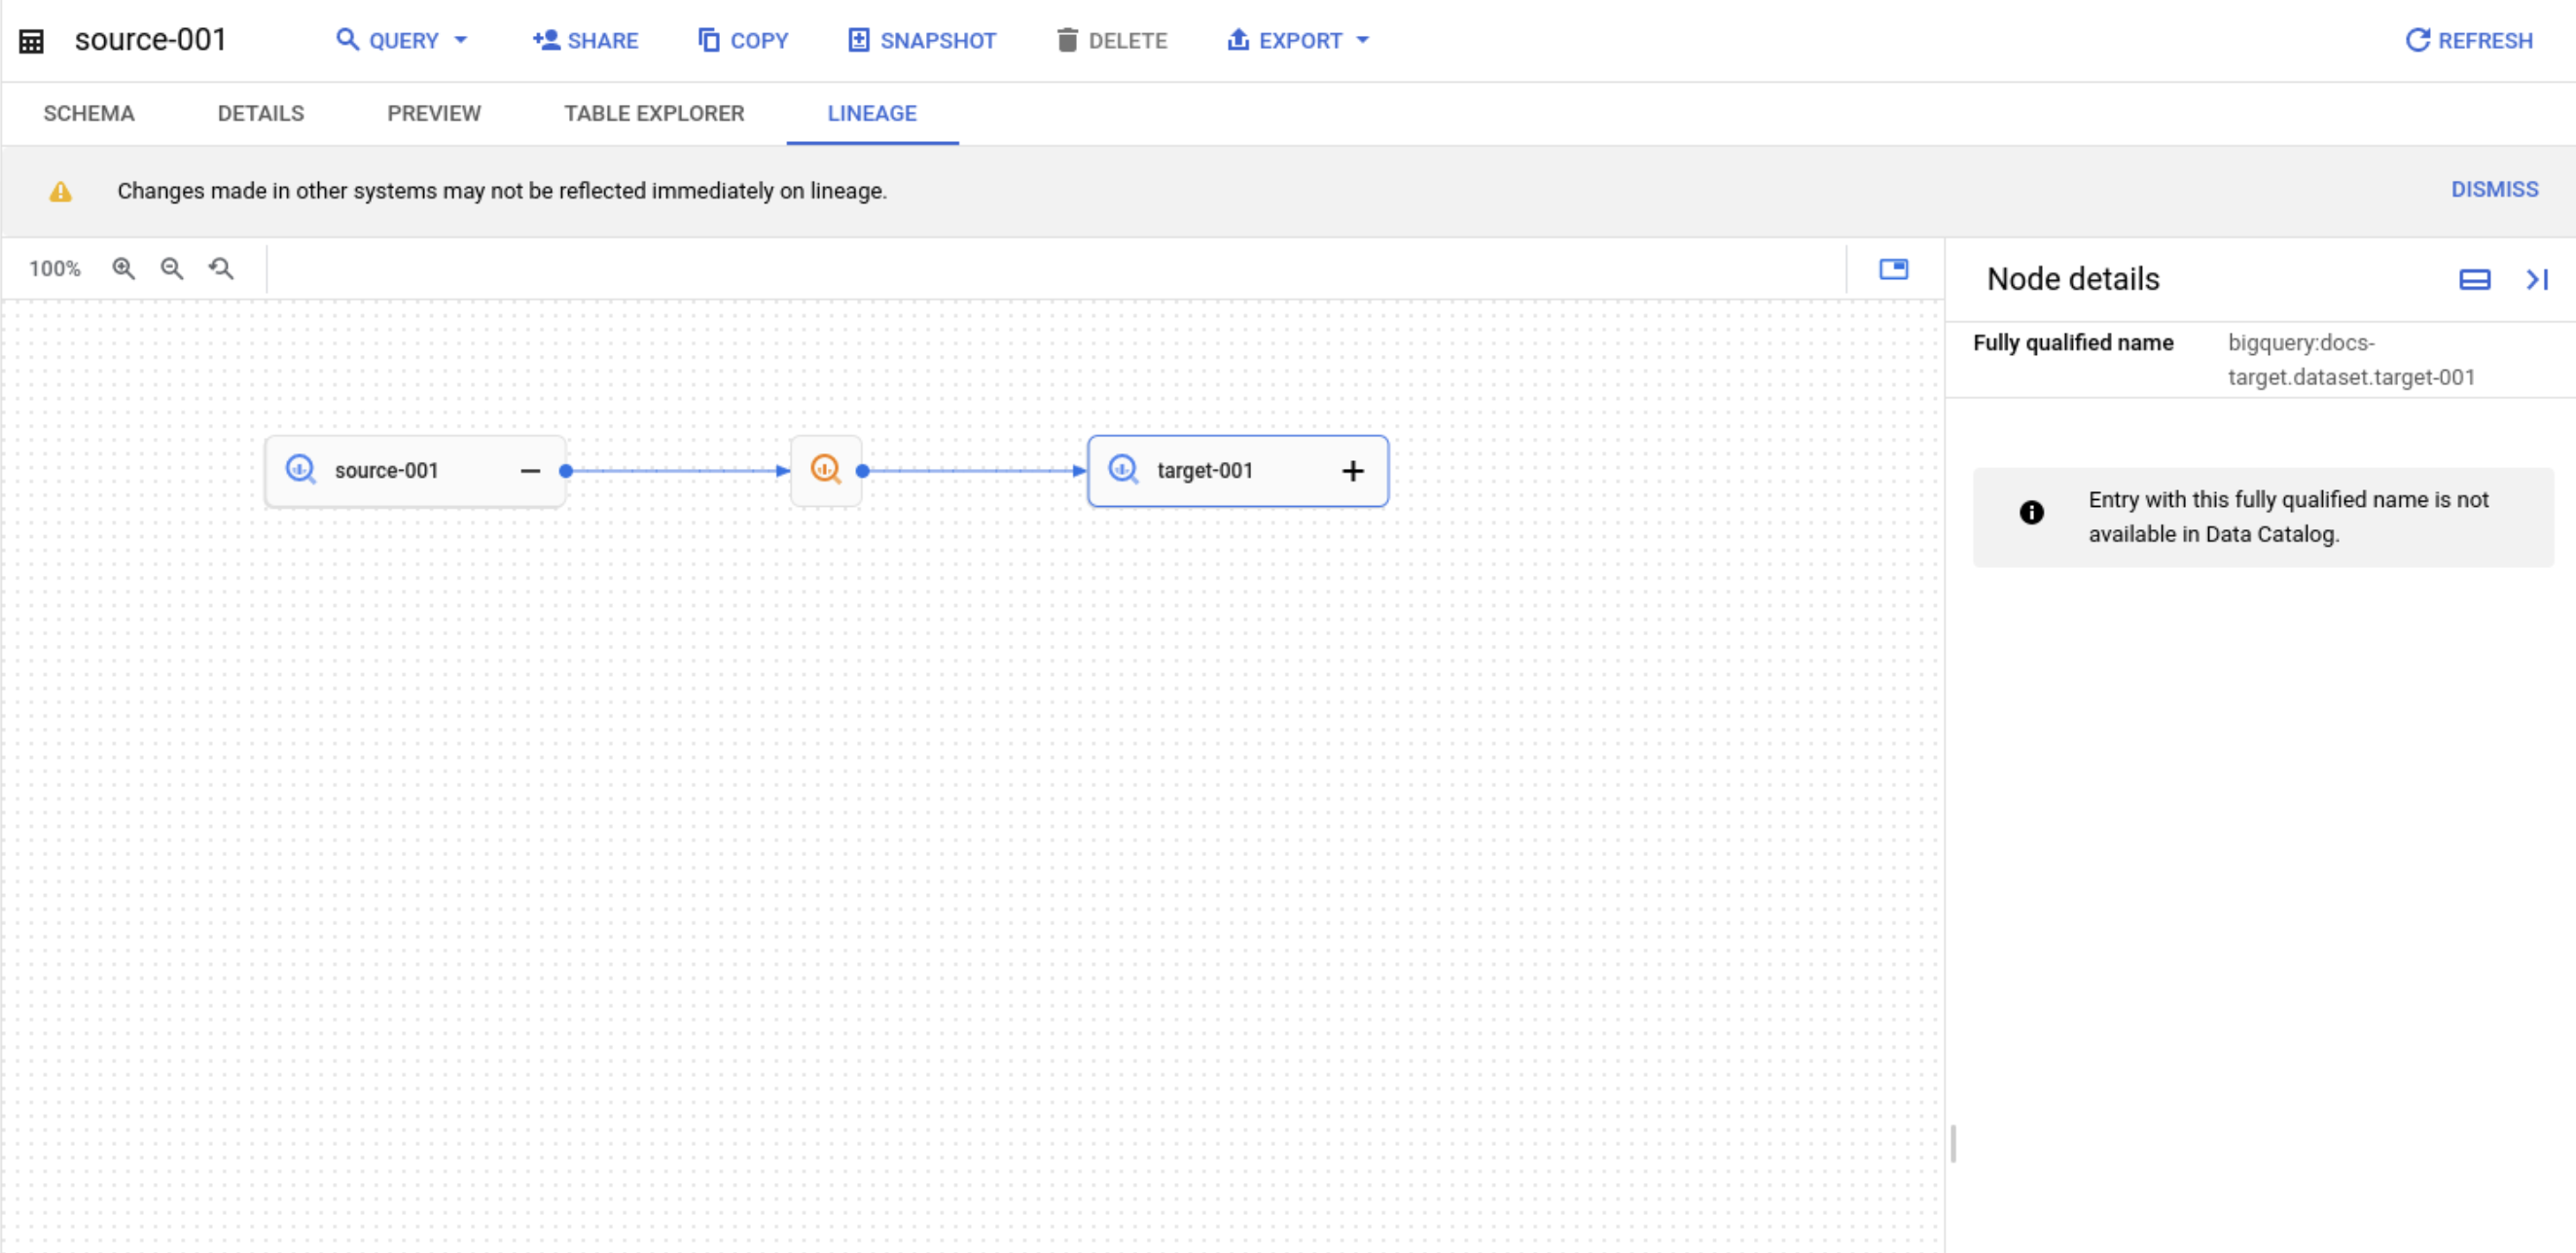
Um dieses Problem zu beheben, gewähren Sie die Berechtigung bigquery.tables.get (z. B. in der Rolle BigQuery-Datenbetrachter enthalten) im Speicherprojekt.
In der Herkunft auf Spaltenebene wird „Es sind keine Spalten zum Auswählen vorhanden“ angezeigt
Das folgende Problem tritt auf, wenn Sie ein Asset in der Google Cloud Console aufrufen und das Herkunftsdiagramm auf Tabellenebene korrekt angezeigt wird, aber bei Auswahl der Herkunft auf Spaltenebene die Meldung „Es sind keine Spalten zum Auswählen vorhanden“ angezeigt wird oder keine Spalte-zu-Spalte-Links angezeigt werden.
Dieses Problem kann in den folgenden Szenarien auftreten:
- Benutzerdefinierte OpenLineage-Ereignisse: Ereignisse, die über den Data Lineage API-Endpunkt
ProcessOpenLineageRunEventaufgenommen werden, unterstützen nur die Datenherkunft auf Tabellenebene. Benutzerdefinierte Facetten auf Spaltenebene werden in derGoogle Cloud Console nicht gerendert. - Nicht unterstützte Datenquellen oder Systeme: Herkunftsgrafiken auf Spaltenebene werden nur für BigQuery-SQL-Transformationen und Managed Service for Apache Spark-Jobs generiert. Andere integrierte Systeme (z. B. Cloud Data Fusion und Vertex AI) unterstützen nur die Herkunft auf Tabellenebene.
- Nicht unterstützte BigQuery-Jobtypen: Die Herkunft auf Spaltenebene wird nicht für BigQuery-Ladejobs, Kopierjobs oder Routinen erfasst.
- Externe Tabellen: Für externe Tabellen wird keine vorgelagerte Herkunft auf Spaltenebene erfasst.
- Unstrukturierte Assets oder Assets auf Speicherebene: Dateibasierte Assets (z. B. Cloud Storage-Rohdateien oder -Buckets) sind in der Regel nicht strukturiert. Die Datenherkunft kann jedoch Spalten für sie anzeigen, wenn die Herkunft auf Spaltenebene an das System gemeldet wird. Wenn für das Datei-Asset keine Herkunft auf Spaltenebene gemeldet wird, können Sie keine Spalten auswählen.
- Komplexe verschachtelte Typen: Die Herkunft auf Spaltenebene verfolgt nur Spalten der obersten Ebene. Sie können keine Felder einzeln auswählen, die in komplexen Datentypen (wie
STRUCToderJSON) verschachtelt sind. - Partitionierungs-Pseudospalten: Systempartitionierungsspalten (z. B.
_PARTITIONDATEund_PARTITIONTIME) werden in Herkunftsdiagrammen auf Spaltenebene nicht erkannt. - Linklimits überschritten: Wenn ein Transformationsjob mehr als 1.500 Links auf Spaltenebene generiert, überspringt Knowledge Catalog die Erfassung der Herkunft auf Spaltenebene und behält nur die Herkunft auf Tabellenebene bei.
- Organisationsübergreifende Assets: Wenn ein Herkunftspfad ein Asset in einer anderen Organisation durchläuft, können Sie nicht auf die Schema- und Spaltendetails zugreifen, wenn Sie nicht derselben Organisation wie das Asset angehören.
Unerwartete Gebühren für die Verarbeitung in der Premium-Stufe des Knowledge Catalog
Sie haben die Dataplex API (dataplex.googleapis.com) deaktiviert, um Gebühren zu vermeiden, aber Sie sehen weiterhin tägliche Gebühren für die SKU „Knowledge Catalog Premium Processing“.
Dieses Problem kann auftreten, wenn die Data Lineage API (datalineage.googleapis.com) aktiviert bleibt. Die Data Lineage API wird unter der SKU „Knowledge Catalog Premium Processing“ abgerechnet, aber in der Google Cloud Console als separate API verwaltet. Wenn Sie die Dataplex API deaktivieren, wird die Data Lineage API nicht deaktiviert und die Gebühren werden nicht gestoppt.
Wenn Sie herausfinden möchten, ob die Datenherkunft die Ursache für die Gebühren ist, suchen Sie in Ihrem Cloud Billing-Bericht nach dem Label goog-dataplex-workload-type mit dem Wert LINEAGE.
Wenn Sie die Gebühren beenden möchten, deaktivieren Sie die Datenherkunft, indem Sie die Data Lineage API in Ihren Projekten deaktivieren.