


Knowledge Catalog を使用すると、Gemini を活用した機能を使用して、構造化データと非構造化データにわたる技術メタデータとビジネス セマンティクスを統合できます。生成されたコンテキスト グラフを使用して、アセットの検出、データ品質の検証、生成 AI アプリケーションのグラウンディングを行い、ハルシネーションを減らすことができます。
このドキュメントは、データ エンジニア、コンテキスト エンジニア、データ サイエンティスト、データ スチュワード、AI デベロッパーを対象としています。BigQuery や Cloud Storage などのデータベース システムとストレージ システムに精通していること、また、検索拡張生成(RAG)や Model Context Protocol(MCP)などの生成 AI のコンセプトを基本的に理解していることを前提としています。
Knowledge Catalog の詳細なチュートリアルについては、次の動画をご覧ください。
業界固有のデータの複雑さを解決する
現代の企業では、データは複雑で高度に分散されており、構造化形式と非構造化形式の両方で存在しています。ビジネス リクエストが単一のデータベース スキーマまたはドキュメント ストアにマッピングされることはほとんどありません。これらのサイロを安全に連携させながら、クロスドメインの質問に迅速かつ信頼性の高い回答を提供することは、運用上の大きな課題です。
Knowledge Catalog は、このギャップを埋めるセマンティック基盤として機能し、AI エージェントと分析ツールがグラウンディングされた関連コンテキストを取得できるようにします。
主なユーザーロール
コンテキスト エンジニア(データ エンジニア)。データベースと Cloud Storage 間でメタデータの集計を自動化し、リネージを使用して変換をトレースし、拡充と評価のワークフローを構築します。
データ スチュワード(ガバナンス チーム)。AI 生成の説明の人間参加型レビュー、用語集によるビジネス用語の標準化、ドメイン固有のコンテキストをカタログ エントリに付加するカスタム アスペクトの定義により、メタデータの品質を管理します。
AI デベロッパー。MCP サーバーまたはコンテキスト取得 API を使用して、信頼できるエンタープライズ データスキーマで LLM と AI アプリケーションをグラウンディングします。
業界でのユースケース
次の表に、実際に発生する複雑な質問、技術的な境界を越える方法、Knowledge Catalog が組織でそれらに対処するのにどのように役立つかを示します。
| 業種 | データと運用に関する課題 | 解決すべきビジネス上の問題 | Knowledge Catalog がどのように対処するか |
|---|---|---|---|
| e コマース |
|
「返品率が高く、到着時に損傷の兆候を示す顧客の写真がある電子機器製品を見つけてください。」 | データ形式をまたぐセマンティック グラウンディング: トランザクション データベースからメタデータを自動的に検出し、Cloud Storage ストレージ バケット内の非構造化画像にリンクします。これにより、AI ツールは異なるストレージ システム間でクエリを解決できます。 |
| 製造 |
|
「前四半期に安全チェックに不合格となった西部地域の機械に関連するすべての検査レポートの要約を生成してください。」 | リージョン別および非構造化データのクロール: 非構造化 PDF 検査レポートをアセットのメタデータとともにクロールしてカタログ化し、生成 AI エージェントがリージョン別にレポートを検索、コンパイル、要約できるようにします。 |
| 医療 |
|
「最近の検査のバイタルサインと予約頻度を考慮すると、30 日以内の再入院リスクが最も高い患者は誰ですか?」 | データ品質とリネージ: 電子医療記録フィード全体でラインレベルのデータ品質プロファイリングとリネージマップを計算します。これにより、臨床予測モデルが検証済みの高品質な患者のバイタルのみに依存するようになります。 |
| 金融サービス |
|
「収益上位 10 社のうち、『パフォーマンスの問題』について苦情を申し立てたのはどの顧客ですか?また、それが第 3 四半期の予測にどのように影響しますか?」 | 統合コンテキスト グラフ: 顧客レコード、サポート フィードバック、財務テーブルを統合し、自然言語クエリでクライアントの収益統計と非構造化フィードバック ファイルを結合して、財務への影響を予測できるようにします。 |
これらの運用上の課題に対処するため、Knowledge Catalog には、データ エンジニア、データ サイエンティスト、AI デベロッパーがガバナンスされたデータシステムを構築するのに役立つ主な機能が用意されています。
Model Context Protocol(MCP)で AI エージェントをグラウンディングする。ローカルまたはリモートの MCP サーバーを使用して、メタデータ、スキーマ、リネージ、ビジネスルールを AI エージェントに直接公開します。これらのサーバーにより、モデルはアクションを提案する前に、運用上の期待値を確認できます。
AI と分析の発見を加速する。自然言語のセマンティック検索を使用して、関連するデータアセットを検索します。生成された要約と推奨事項により、ユーザーは手動のドキュメント レビューを待たずにデータを見つけることができます。
データ プロダクトを大規模に管理する。サービスレベル契約(SLA)、契約、所有権の詳細、使用上の注意を含むアセットのコレクションを、検索とサブスクリプション用の単一の管理対象ユニットにパッケージ化します。
Knowledge Catalog の仕組み
Knowledge Catalog は、3 つの柱からなるライフサイクルを通じてデータ マネジメントとコンテキストを統合します。次の図は、このサービスが AI エージェントのグラウンディングのために物理データアセットをビジネス セマンティクスにマッピングする方法を示しています。
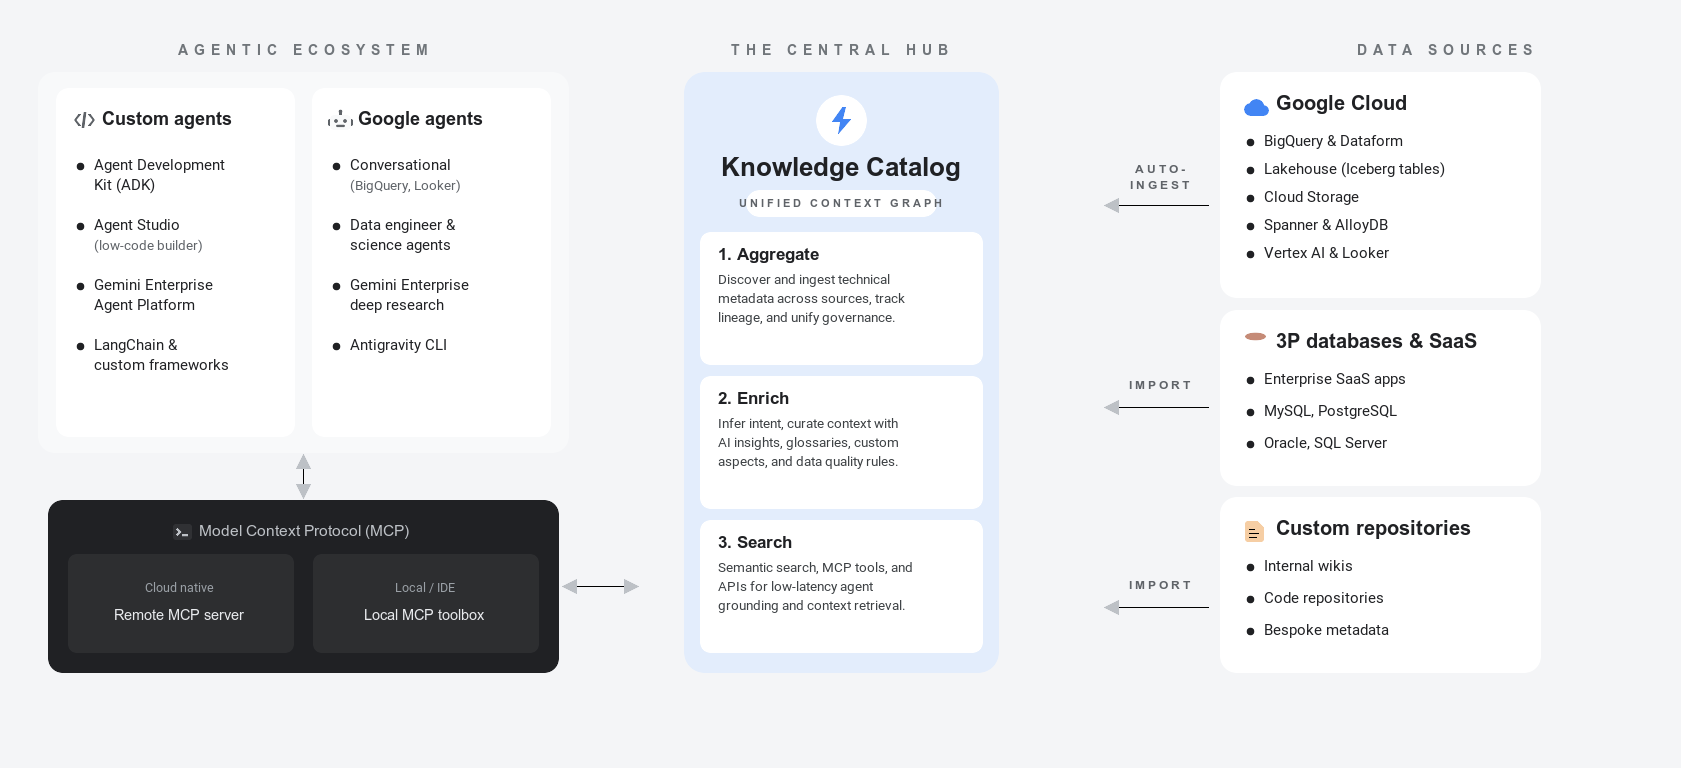
これらのメタデータのコンセプトの詳細については、メタデータについてをご覧ください。
以降のセクションでは、メタデータ ライフサイクルの 3 つの柱について説明し、小売企業がデータベース テーブル、ファイル、外部カタログ エントリにそれらを適用する方法を示します。
集約(検出と取り込み)。Knowledge Catalog は、基盤となるデータを移動することなく、データ エステート全体の技術メタデータを自動的にクロールしてインデックスに登録します。
- 組み込みデータベース。自動カタログ化により、BigQuery、AlloyDB for PostgreSQL、Spanner などのプラットフォーム全体でスキーマと属性がキャプチャされます。
- マネージド接続。カスタム パイプラインを記述せずに、Oracle や PostgreSQL などの外部システム、または Collibra などのパートナー レジストリから定義を取り込みます。
- データリネージ: パイプライン全体で列レベルの変換をトレースして、データの出所と変化を追跡します。
- 例: 小売企業が、
ordersテーブルやorder_itemsテーブルなどのトランザクション データベース メタデータを自動的に取り込み、Cloud Storage バケットに保存されている非構造化商品ファイルのインデックスを作成します。外部データベースをリンクして、検出可能なディレクトリに統合メタデータ インデックスを確立します。
メタデータの集約とデータの取り込みの詳細(クリックして展開)
- サポートされているデータソース: 自動取り込みでサポートされているすべての Google Cloud と外部ソースを一覧表示します。
- マネージド接続の概要: 外部システムから技術スキーマを取り込む方法について説明します。
- データリネージを追跡する: 列レベルのパイプライン変換とデータフローを可視化する方法について説明します。
拡充(コンテキストをキュレートして信頼性を検証する)。Knowledge Catalog は、技術的な構造にビジネス上の意味を付加し、信頼シグナルを確立します。
- AI 生成インサイト。Gemini はクエリログを分析して、列の説明、テーブルの概要、推奨される結合を生成します。
- 用語集とアスペクト。ビジネス用語と論理テンプレートを使用して、内部指標名を共有ボキャブラリにマッピングします。
- データ品質と異常検出。クリーンネス ガイドラインを適用し、機械学習スキャンを実行して統計的な外れ値やデータの更新速度の問題を検出し、重要な信頼シグナルを生成します。
- ガバナンス審査。ワークフローのレビュー プロセスを使用して、公開前にメタデータの更新を検証し、リスクを管理します。
- 例: 小売チームは、データ分析情報をトリガーして列の説明を推奨し、データ品質ルールを実行することで、アセットを拡充します。用語集とアスペクトを作成して、ビジネス定義をアクティブな注文にマッピングします。
メタデータの拡充と信頼性の検証の詳細(クリックして展開)
- データ分析情報を構成する: データセットの説明と概要を自動的に生成する方法について説明します。
- ビジネス用語集を管理する: 標準用語とビジネス用語をカスタマイズする方法について説明します。
- アスペクトを使用してメタデータを拡充する: 構造化メタデータ プロパティを論理アセットにアタッチする方法について説明します。
- データ品質ルールを再利用する: データベース検証ルールを確立して再利用する方法について説明します。
- データ プロファイリングの概要: スキーマの異常と統計ドリフトのスキャンを構成する方法について説明します。
検索と取得(アクセスとグラウンディング)。AI アプリケーションとビジネス ユーザーは、統合コンテキスト グラフをクエリしてデータに安全にアクセスします。
- グラウンディング エージェント。LLM ベースのアプリとエージェントをカタログに接続します。
- Context API。低レイテンシのグラウンディング ペイロード リクエストを実行する。
- セマンティック検索。自然言語クエリを使用して適切なアセットを見つけます。
- データ パッケージング。テーブル、ライセンスの詳細、SLA のコレクションを、安全なセルフサービス データ パッケージにバンドルします。
- 例: アナリストが自然言語のセマンティック検索を実行してアセットを特定します。AI アプリケーションは、MCP サーバーまたはコンテキスト取得 API を使用してこのインデックスを安全に利用し、高品質のアセットが安全なビューにパッケージ化されます。
コンテキストの取得とエージェントのグラウンディングの詳細(クリックして展開)
- Model Context Protocol(MCP)の概要: 生成 AI エージェントとアプリケーション レイヤを Knowledge Catalog のコンテキストにブリッジする方法について説明します。
- LookupContext を使用してコンテキストを取得する: エージェントのプロンプトに使用する主要な運用ペイロードを抽出する方法について説明します。
- アセットを検索する: 自然言語のセマンティック クエリ構文を使用したアセット検索機能について説明します。
Google Cloud と AI エコシステムの Knowledge Catalog
データ基盤を構築する際は、Knowledge Catalog が関連サービスとどのように統合されるかを理解することが重要です。
Google Cloud データベースとモデル
- BigQuery。Knowledge Catalog は、BigQuery のデータセット、テーブル、ビューを自動的にクロールしてインデックスに登録します。Gemini を活用したデータ分析情報をトリガーして、クエリ履歴の分析、説明の公開、検証済みのサンプルクエリの提案を行います。
- Looker(Google Cloud コア)。Knowledge Catalog は、Looker ダッシュボード、Look、LookML 構造(ビュー、Explore、ディメンション、メジャーなど)を取り込みます。この取り込みにより、リネージ マッピングが構築され、運用値がビジネス セマンティクスにどのようにマッピングされるかが追跡されます。
- Lighthouse ランタイム カタログ。Knowledge Catalog は、オープンソースの Iceberg ワークロードのランタイム metastore である Lighthouse と統合されています。Lighthouse ワークロードの上に技術メタデータを自動的にインデックス化し、統合されたアクティブ コンテキストを提供します。
AI エージェント プラットフォームとアシスタント
- 会話分析。分析インターフェースでは、カタログ用語とルックアップ ツールを使用して、ユーザーが検証済みのグラウンディングを使用して自然言語でビジネス指標をクエリできます。
- AI エージェント向け Gemini。高精度のアシスタント エージェントは、カタログ メタデータを使用してデータベース検索を実行し、ハルシネーションを軽減します。
- Gemini Enterprise Agent Platform。Knowledge Catalog は、ターゲット プラットフォーム環境内の一元化されたデータ ガバナンス標準として機能します。Gemini Enterprise Agent Platform とクロスリンクして、プラットフォームのエージェント レジストリにツールとコンテキストを提供します。
Google Cloud データベースと AI サービスの統合
Knowledge Catalog は、他のGoogle Cloud プロダクトと連携してデータ基盤を形成します。次の表に、Knowledge Catalog が関連サービスと統合され、補完する方法を示します。
| サービス | 主要な役割 | Knowledge Catalog との統合方法 |
|---|---|---|
| Knowledge Catalog | ガバナンスとエージェントのコンテキスト | 統合されたセマンティック コンテキスト グラフとして機能し、データ品質チェック スキャンを実行して、グラウンディングされたスキーマを AI モデルとアプリケーションに公開します。 |
| BigQuery | エンタープライズ データ ウェアハウジング | データセットを保存、クエリ、処理します。これらのテーブルを自動的にクロール、インデックス登録し、ビジネス分類の側面で拡充します。 |
| Gemini Enterprise Agent Platform | AI モデルの開発 | 基盤モデルを構築、デプロイ、ホストします。カスタム エージェントは、メタデータ コンテキストを取得して論理的推論をグラウンディングします。 |
| Cloud Storage | 非構造化ファイル ストレージ | 未加工の非構造化ファイルを保存します。非構造化検出スキャンを自動的に実行して PDF と画像を解析し、関係マップを構築します。 |
セマンティクスとデータ形式
エージェント型システムを効果的に指示してグラウンディングするには、物理的なデータ構造とセマンティックな意味を区別する必要があります。
- セマンティクス。データに関連付けられたビジネス上の意味、意図、関係。技術スキーマは、データベース タイプ、文字長、整数制約などの構造的なストレージ仕様を定義しますが、セマンティクスはデータセットが実際に表す内容を記述します。たとえば、
txn_qtyという名前の列を「購入数量」のビジネス定義にマッピングできます。 - 構造化データ。定義されたスキーマとリレーショナル形式で保存された情報。たとえば、BigQuery テーブル、Spanner データベース、運用 Postgres テーブルなどです。Knowledge Catalog は、このメタデータを自動的にクロールし、列と制約を記録します。
Agentic Data Cloud のコンテキスト オーケストレーション
Google の Agentic Data Cloud フレームワーク内では、Knowledge Catalog がセマンティック オーケストレーション プレーンとして機能します。コンテキスト エンジンは、開発者がデータベース スキーマとルールをプロンプトに手動でハードコードする必要はなく、エージェントがインテリジェントな意思決定を行うために必要な正確なセマンティック コンテキストを動的に提供します。
次の図は、Knowledge Catalog がデータ コンテキストをオーケストレートして提供する仕組みを示しています。
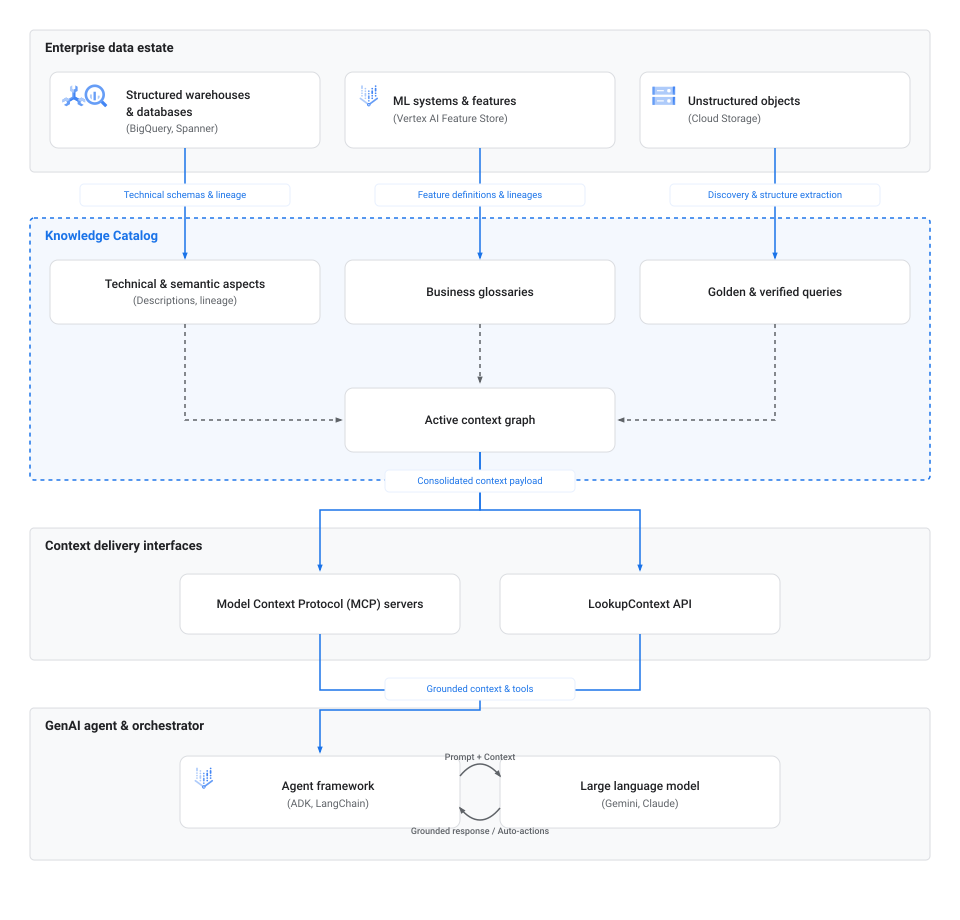
コンテキスト オーケストレーション ワークフローは、次のフェーズで構成されます。
- 取り込みと検出。運用データベース、Spanner や BigQuery などのウェアハウス、Cloud Storage などの非構造化オブジェクト ストア、Lighthouse などのランタイム メタストアは、技術スキーマ、リネージマップ、メタデータ定義を Knowledge Catalog に直接フィードします。
- コンテキスト マッピング。Knowledge Catalog 内では、これらのメタデータ プロパティが、技術的な側面、ビジネス用語集、検証済みのクエリなどのセマンティック要素にリンクされ、アクティブ コンテキスト グラフが構築されます。
- 配信インターフェース。AI アプリケーションとオーケストレーターは、MCP や直接
LookupContextAPI エンドポイントなどの標準コネクタを使用して、この統合コンテキスト グラフをプログラムで取得します。 - エージェントのグラウンディング。Agent Development Kit(ADK)や LangChain などのオーケストレーション フレームワークは、このメタデータ コンテキストを LLM プロンプトに直接挿入します。この挿入により、エージェントの推論が検証済みの組織ルールにグラウンディングされるため、ハルシネーションなしでデータベースをクエリしたり、自動化されたアクションを実行したりできます。
AI エージェント プロファイル
自動化するワークフローに応じて、Knowledge Catalog を利用するさまざまなクラスのエージェントを構築できます。
- データ検出エージェント。これらのアシスタントは、ユーザーがデータ資産を検索してナビゲートするのに役立ちます。キーワードのマッチタイプを使用する代わりに、自然言語で長い形式のインテントと制約を分析して、最も関連性の高い物理アセットを取得します。
- メタデータ拡充エージェント。これらのバックグラウンド エージェントは、Wiki、README ファイル、チャットログから非構造化テキストを取り込み、テキストを正式なメタデータに解析して、メタデータをアスペクトとして Knowledge Catalog に書き込み、メタデータを最新の状態に保ちます。
- データ品質とパイプライン エージェント。これらの自律型エージェントは、データリネージとプロファイル統計情報をクエリして、品質ルールの評価、スキーマ ドリフトの検出、データ変換パイプラインの構築または修復を行います。
オーケストレーション ツール
これらのエージェントを構築して統合するには、次のツールを使用します。
- Model Context Protocol(MCP)。エージェントを外部リソースにリンクするための標準化されたオープン プロトコル。エージェントがカタログに接続するように構成するには、リモート MCP サーバーまたはローカル MCP ツールボックスを使用します。詳細については、Knowledge Catalog の Model Context Protocol(MCP)についてをご覧ください。
- Agent Development Kit(ADK)。生成 AI エージェントの構築、実行、テストを簡素化する Google のフレームワーク。Catalog Service API への組み込みバインディングを提供します。詳細については、 ADK のホームページをご覧ください。
- LookupContext API。データアセットの統合 YAML または JSON コンテキスト ペイロードを抽出する REST および gRPC API エンドポイント。LLM プロンプトに直接挿入できます。詳細については、LookupContext API を使用してコンテキストを取得するをご覧ください。
MCP を使用してコンテキストにアクセスする
Model Context Protocol(MCP)は、AI エージェントとツールが Knowledge Catalog などのデータソースにシームレスに接続できるようにする標準化されたブリッジです。次の比較表を使用して、統合に最適なオプションを決定してください。
| 実装 | 最適な用途 | キーの詳細 | エンドポイントまたは設定 |
|---|---|---|---|
| リモート MCP サーバー | クラウド ファーストのデプロイ、Cloud Run などのサーバーレス環境、マネージド外部サービス。 | Google がホストするエンドポイント。ローカル サーバーの管理は不要です。 | エンドポイント: https://dataplex.googleapis.com/mcp設定するには、リモート MCP サーバーを使用するをご覧ください。 |
| ローカル MCP ツールボックス | ローカル エージェントの開発、迅速なプロトタイピング、VS Code や Cursor などのデスクトップ IDE 統合。 | ワークスペース環境と Knowledge Catalog の間のローカル プロキシとして機能するコマンドライン ツール。 | バイナリのインストールと .mcp.json の設定が必要です。設定するには、ローカル MCP サーバーを使用するをご覧ください。 |
エージェント データ コンテキストのベスト プラクティス
信頼性の高いエージェント エクスペリエンスを構築するには、Knowledge Catalog でメタデータを整理してクエリする際に、次のベスト プラクティスを考慮してください。
- アスペクトを追加する。AI エージェントは、名前だけでは公式の本番環境テーブルと一時的なサンドボックス モックアップを区別できません。カスタムの信頼シグナル アスペクトを定義して適用し、信頼できるデータ プロダクトを認定します。これにより、エージェントがこれらのリソースに対するクエリを優先または制限できるようになります。
- コンテキスト予算を使用してルックアップを最適化する。
LookupContextAPI を呼び出すときに、context_budgetパラメータを指定します。API は、指定されたトークン制約内で、リネージやプライマリの説明など、最も重要なメタデータを最初に最適化して適合させます。 - 関連リソースを指定して結合パスを公開する。コンテキストの問い合わせでは、関連するテーブルまたはアセットを最大 10 個リストします。アセットのグループを指定すると、コンテキスト エンジンが結合パスと関係を自動入力します。これにより、エージェントはテーブルのインターフェースを理解できます。
- セマンティック用語集を構造化する。ビジネス用語集の用語と略語を標準化します。この標準化により、会話型ツールはビジネス固有の同義語や指標を正確に解決できます。
- ゴールデン クエリを公開する。検証済みの自然言語クエリと、それに対応する正しい SQL を Knowledge Catalog エントリに直接添付します。これらの検証済みテンプレートに基づいて推論をグラウンディングすることで、テキストから SQL への変換エージェントで SQL 変換エラーが発生するのを防ぐことができます。
Dataplex Universal Catalog から Knowledge Catalog に移行する
Dataplex Universal Catalog は Knowledge Catalog に進化しました。この移行の詳細については、Dataplex Universal Catalog から Knowledge Catalog への移行をご覧ください。
制限事項
デプロイを計画する際は、次の制限事項を考慮してください。
サポートされている統合。Knowledge Catalog は主要なサードパーティ システムをサポートしていますが、特定の自動セマンティック抽出は組み込みの Google Cloud サービスに限定される場合があります。
割り当て上限。コンテキストの取得とメタデータの抽出オペレーションには、標準の Google Cloud API の割り当てが適用されます。
次のステップ
MCP を使用してエージェントをグラウンディングする
Model Context Protocol を使用して、AI エージェントとデベロッパー ツールを Knowledge Catalog に接続します。