


Knowledge Catalog vous permet d'unifier les métadonnées techniques et la sémantique métier sur les données structurées et non structurées à l'aide de fonctionnalités optimisées par Gemini. Vous pouvez ensuite utiliser le graphique de contexte obtenu pour découvrir des éléments, vérifier la qualité des données et ancrer les applications d'IA générative afin de réduire les hallucinations.
Ce document est destiné aux ingénieurs de données et de contexte, aux data scientists, aux intendants de données et aux développeurs d'IA. Il suppose que vous connaissez les systèmes de base de données et de stockage, tels que BigQuery ou Cloud Storage, et que vous avez une compréhension de base des concepts d'IA générative, tels que la génération augmentée par récupération (RAG) ou le protocole MCP (Model Context Protocol).
Pour une présentation détaillée de Knowledge Catalog, regardez la vidéo suivante :
Résoudre la complexité des données spécifiques à un secteur
Dans les entreprises modernes, les données sont complexes, hautement distribuées et existent dans des formats structurés et non structurés. Les requêtes d'entreprise correspondent rarement à un seul schéma de base de données ou à un seul magasin de documents. Aligner ces silos de manière sécurisée tout en fournissant des réponses immédiates et fiables aux questions interdomaines est un défi opérationnel majeur.
Knowledge Catalog sert de base sémantique pour combler cette lacune, en permettant aux agents IA et aux outils d'analyse de récupérer un contexte pertinent et ancré.
Rôles utilisateur clés
Ingénieurs de contexte (ingénieurs de données). Automatisez l'agrégation des métadonnées dans les bases de données et Cloud Storage, suivez les transformations grâce à la traçabilité, et créez des workflows d'enrichissement et d'évaluation.
Responsables des données (équipes de gouvernance). Contrôlez la qualité des métadonnées en fournissant des révisions human-in-the-loop (avec intervention humaine) des descriptions générées par l'IA, en standardisant les vocabulaires d'entreprise avec des glossaires et en définissant des aspects personnalisés pour associer un contexte spécifique au domaine aux entrées du catalogue.
Développeurs IA. Ancrez les LLM et les applications d'IA avec des schémas de données d'entreprise fiables à l'aide de serveurs MCP ou d'API de récupération de contexte.
Cas d'utilisation dans différents secteurs
Le tableau suivant illustre les questions complexes qui se posent en pratique, la manière dont elles dépassent les limites techniques et la manière dont Knowledge Catalog aide les organisations à y répondre :
| Secteur | Défis liés aux données et aux opérations | Problème métier à résoudre | Comment Knowledge Catalog y répond |
|---|---|---|---|
| E-commerce |
|
"Trouve des produits électroniques présentant des taux de retour élevés et des photos de clients montrant des signes de dommages à l'arrivée." | Ancrage sémantique dans tous les formats de données : découvre automatiquement les métadonnées des bases de données transactionnelles et les associe à des images non structurées dans des buckets de stockage Cloud Storage, ce qui permet aux outils d'IA de résoudre la requête dans des systèmes de stockage disparates. |
| Industrie |
|
"Génère des résumés de tous les rapports d'inspection des machines de la région Ouest qui n'ont pas réussi les contrôles de sécurité au cours du dernier trimestre." | Exploration régionale et non structurée : explore et catalogue les rapports d'inspection PDF non structurés ainsi que les métadonnées des éléments, ce qui permet aux agents d'IA générative de localiser, de compiler et de résumer les rapports par région. |
| Santé |
|
"Quels patients présentent le risque le plus élevé de réadmission dans les 30 jours, d'après les signes vitaux récents et la fréquence des rendez-vous ?" | Qualité et traçabilité des données : calcule le profilage de la qualité des données au niveau des lignes et les cartes de traçabilité dans les flux de dossiers médicaux électroniques, ce qui permet de s'assurer que les modèles prédictifs cliniques ne s'appuient que sur des données vitales vérifiées et de haute qualité concernant les patients. |
| Services financiers |
|
"Quels sont les 10 clients générant le plus de revenus qui se sont plaints de 'problèmes de performances' et quel est l'impact sur les projections du troisième trimestre ?" | Graphe de contexte unifié : unifie les fiches client, les commentaires d'assistance et les tableaux financiers, ce qui permet aux requêtes en langage naturel de joindre les statistiques de revenus des clients aux fichiers de commentaires non structurés pour prévoir l'impact financier. |
Pour relever ces défis opérationnels, Knowledge Catalog fournit des fonctionnalités clés qui aident les ingénieurs de données, les data scientists et les développeurs d'IA à créer des systèmes de données gouvernés :
Ancrez les agents IA avec le protocole MCP (Model Context Protocol). Exposez les métadonnées, les schémas, la traçabilité et les règles métier directement aux agents IA à l'aide de serveurs MCP locaux ou distants. Ces serveurs permettent aux modèles de vérifier les attentes opérationnelles avant de proposer des actions.
Accélérez la découverte pour l'IA et l'analyse. Trouvez des éléments de données pertinents à l'aide de la recherche sémantique en langage naturel. Les résumés et recommandations génératifs aident les utilisateurs à localiser les données sans attendre les examens manuels de la documentation.
Gouverner les produits de données à grande échelle Regroupez des collections d'éléments avec des contrats de niveau de service (SLA), des contrats, des informations sur la propriété et des notes d'utilisation dans des unités uniques et régies pour la recherche et l'abonnement.
Fonctionnement de Knowledge Catalog
Knowledge Catalog unifie la gestion des données et le contexte via un cycle de vie en trois piliers. Le schéma suivant illustre la façon dont le service mappe les éléments de données physiques à la sémantique métier pour l'ancrage des agents IA :
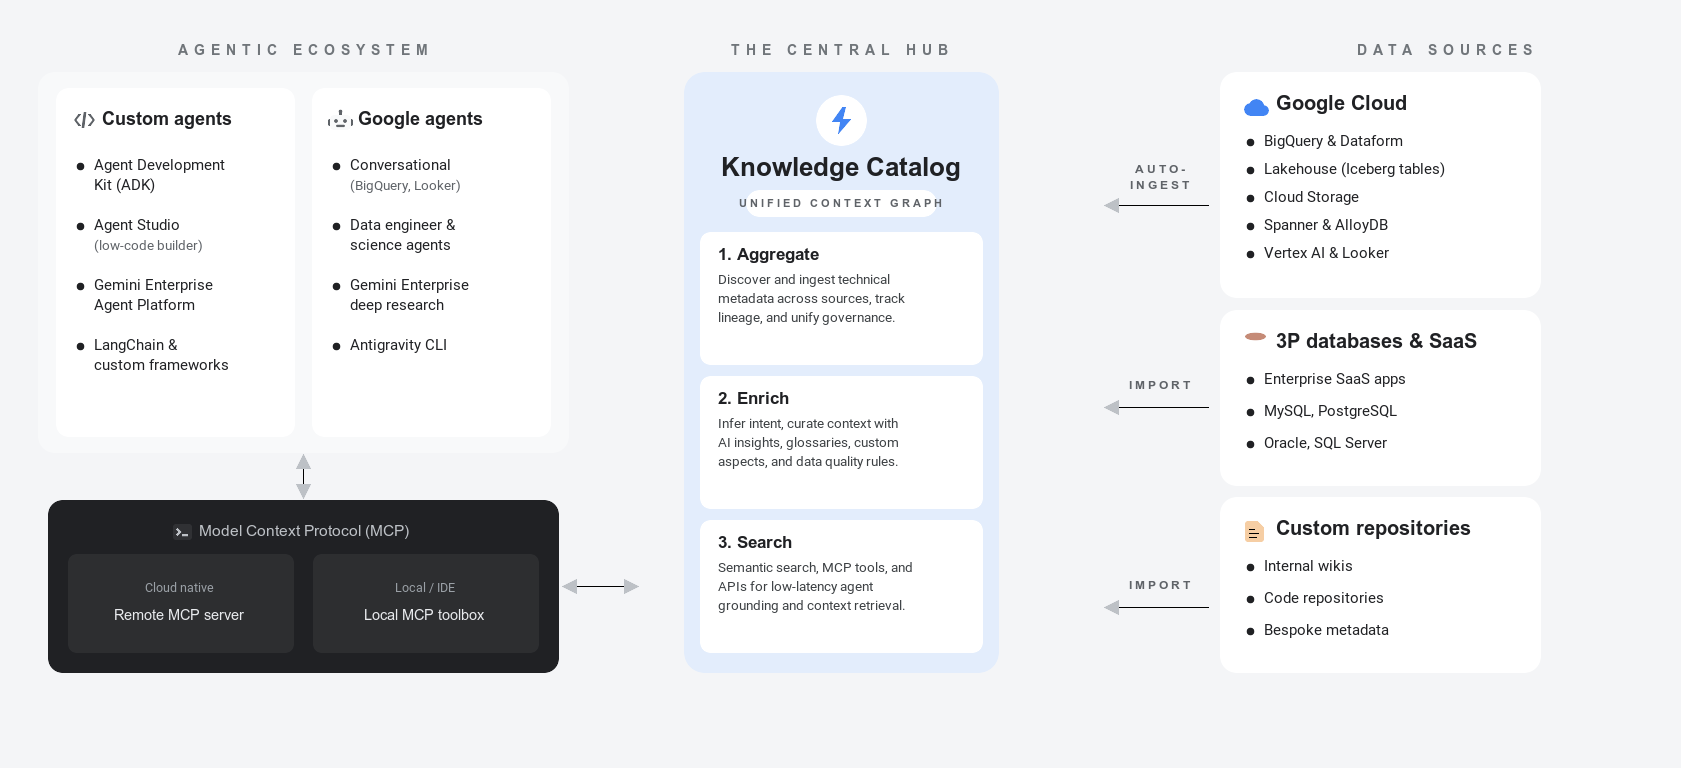
Pour en savoir plus sur ces concepts de métadonnées, consultez À propos des métadonnées.
Les sections suivantes décrivent les trois piliers du cycle de vie des métadonnées et illustrent comment une entreprise de vente au détail les applique aux tables de base de données, aux fichiers et aux entrées de catalogue externes :
Agrégation (découverte et ingestion). Knowledge Catalog explore et indexe automatiquement les métadonnées techniques de votre patrimoine de données sans déplacer les données sous-jacentes :
- Bases de données intégrées Le catalogage automatisé capture les schémas et les attributs sur des plates-formes telles que BigQuery, AlloyDB pour PostgreSQL et Spanner.
- Connectivité gérée. Ingérez des définitions à partir de systèmes externes, tels qu'Oracle ou PostgreSQL, ou de registres partenaires, tels que Collibra, sans écrire de pipelines personnalisés.
- Traçabilité des données. Suivez les transformations au niveau des colonnes dans les pipelines pour savoir d'où proviennent vos données et comment elles ont été modifiées.
- Exemple : Une entreprise de commerce de détail ingère automatiquement les métadonnées de base de données transactionnelle, telles que les tables
ordersetorder_items, et indexe les fichiers de produits non structurés stockés dans des buckets Cloud Storage. Ils associent des bases de données externes pour établir un index de métadonnées unifié dans un répertoire visible.
En savoir plus sur l'agrégation des métadonnées et l'ingestion des données (cliquez pour développer)
- Sources de données compatibles : liste toutes les sources Google Cloud et externes compatibles avec l'ingestion automatisée.
- Présentation de la connectivité gérée : explique comment ingérer des schémas techniques à partir de systèmes externes.
- Suivre la traçabilité des données : décrit comment visualiser les transformations de pipeline et le flux de données au niveau des colonnes.
Enrichissement (sélectionner le contexte et vérifier la fiabilité). Knowledge Catalog associe une signification métier aux structures techniques et établit des signaux de confiance :
- Insights générés par IA. Gemini analyse les journaux de requêtes pour générer des descriptions de colonnes, des résumés de tables et des jointures recommandées.
- Glossaires et aspects. Mappez les noms de métriques internes à un vocabulaire partagé à l'aide de termes métier et de modèles logiques.
- Qualité des données et détection d'anomalies. Appliquez des consignes de propreté et exécutez des analyses de machine learning pour détecter les anomalies statistiques ou les problèmes de fraîcheur des données, ce qui génère des signaux de confiance clés.
- Examens de gouvernance. Gérez les risques en utilisant des processus d'examen des workflows pour vérifier les mises à jour des métadonnées avant leur publication.
- Exemple : L'équipe Retail enrichit les éléments en déclenchant des insights sur les données pour recommander des descriptions de colonnes et en exécutant des règles de qualité des données. Ils mappent les définitions d'entreprise aux commandes actives en créant des glossaires et des aspects.
En savoir plus sur l'enrichissement des métadonnées et la vérification de la fiabilité (cliquez pour développer)
- Configurer les insights sur les données : explique comment générer des descriptions et des résumés d'ensembles de données automatisés.
- Gérer les glossaires d'entreprise : décrit comment personnaliser les termes standards et les vocabulaires d'entreprise.
- Enrichir les métadonnées avec des aspects : montre comment associer des propriétés de métadonnées structurées à des éléments logiques.
- Réutiliser des règles de qualité des données : montre comment établir et réutiliser des règles de validation de base de données.
- Présentation du profilage des données : décrit comment configurer des analyses pour détecter les anomalies de schéma et la dérive statistique.
Recherche et récupération (accès et ancrage). Les applications d'IA et les utilisateurs professionnels interrogent le graphique contextuel unifié pour accéder aux données de manière sécurisée :
- Agents d'ancrage. Connectez vos applications et agents basés sur un LLM au catalogue.
- API Context. Effectuer des requêtes de charge utile d'ancrage à faible latence.
- Recherche sémantique. Trouvez les bons assets à l'aide de requêtes en langage naturel.
- Empaquetage des données. Regroupez des collections de tables, des détails de licence et des SLA dans des packages de données sécurisés en libre-service.
- Exemple : Les analystes effectuent des recherches sémantiques en langage naturel pour localiser des éléments. Les applications d'IA consomment cet index de manière sécurisée à l'aide de serveurs MCP ou de l'API de récupération de contexte, et les éléments de haute qualité sont empaquetés dans une vue sécurisée.
En savoir plus sur la récupération de contexte et l'ancrage de l'agent (cliquez pour développer)
- Présentation du protocole MCP (Model Context Protocol) : explique comment relier les agents d'IA générative et les couches d'application au contexte de Knowledge Catalog.
- Récupérer le contexte à l'aide de LookupContext : montre comment extraire des charges utiles opérationnelles clés pour les requêtes d'agent.
- Rechercher des éléments : décrit les fonctionnalités de recherche d'éléments à l'aide de la syntaxe de requête sémantique en langage naturel.
Knowledge Catalog dans l'écosystème Google Cloud et d'IA
Il est essentiel de comprendre comment Knowledge Catalog s'intègre aux services associés lors de la création d'une base de données.
Google Cloud bases de données et modèles
- BigQuery. Knowledge Catalog explore et indexe automatiquement les ensembles de données, les tables et les vues BigQuery. Il déclenche des insights sur les données optimisés par Gemini pour analyser l'historique des requêtes, publier des descriptions et suggérer des exemples de requêtes vérifiés.
- Looker (Google Cloud Core). Knowledge Catalog ingère les tableaux de bord, les Looks et les structures LookML de Looker, comme les vues, les explorations, les dimensions et les mesures. Cette ingestion crée des mappages de traçabilité pour suivre la correspondance entre les valeurs opérationnelles et la sémantique métier.
- Catalogue d'environnements d'exécution Lakehouse. Knowledge Catalog s'intègre au catalogue d'environnements d'exécution Lakehouse, le metastore d'exécution pour les charges de travail Iceberg Open Source. Il indexe automatiquement les métadonnées techniques en plus des charges de travail du catalogue d'environnements d'exécution Lakehouse pour fournir un contexte actif unifié.
Plates-formes d'agents IA et assistants
- Conversational Analytics. Les interfaces d'analyse utilisent des termes du catalogue et des outils de recherche pour permettre aux utilisateurs d'interroger des métriques d'entreprise en langage naturel avec un ancrage validé.
- Gemini pour les agents IA. Les agents d'assistance de haute précision utilisent les métadonnées du catalogue pour effectuer des recherches dans la base de données, ce qui réduit les hallucinations.
- Gemini Enterprise Agent Platform. Knowledge Catalog sert de norme centrale de gouvernance des données dans les environnements de la plate-forme cible. Il est relié à Gemini Enterprise Agent Platform pour fournir des outils et du contexte au registre d'agents de la plate-forme.
Google Cloud Intégration de base de données et de service d'IA
Knowledge Catalog fonctionne avec d'autres produitsGoogle Cloud pour former votre base de données. Le tableau suivant montre comment Knowledge Catalog s'intègre aux services associés et les complète :
| Service | Rôle principal | Intégration à Knowledge Catalog |
|---|---|---|
| Knowledge Catalog | Gouvernance et contexte agentique | Sert de graphique de contexte sémantique unifié, exécute des analyses de contrôle de la qualité des données et expose des schémas ancrés aux modèles et applications d'IA. |
| BigQuery | Entreposage de données d'entreprise | Stocke, interroge et traite les ensembles de données. Explore, indexe et enrichit automatiquement ces tables avec des aspects de classification métier. |
| Gemini Enterprise Agent Platform | Développement de modèles d'IA | Crée, déploie et héberge des modèles de fondation. Les agents personnalisés récupèrent le contexte des métadonnées pour ancrer le raisonnement logique. |
| Cloud Storage | Stockage de fichiers non structurés | Stocke les fichiers bruts non structurés. Exécute automatiquement des analyses de découverte non structurées pour analyser les PDF et les images afin de créer des cartes de relations. |
Sémantique et formats de données
Pour instruire et ancrer efficacement les systèmes agentiques, vous devez distinguer la structure physique des données de leur signification sémantique :
- Sémantique. La signification, l'intention et les relations métier associées à vos données. Bien que les schémas techniques définissent des spécifications de stockage structurelles, telles qu'un type de base de données, une longueur de caractère ou une contrainte d'entier, la sémantique décrit ce que l'ensemble de données représente réellement. Par exemple, vous pouvez mapper une colonne nommée
txn_qtyà la définition commerciale de "quantité achetée". - Données structurées. Informations stockées dans des schémas et des formats relationnels définis. Par exemple, les tables BigQuery, les bases de données Spanner et les tables Postgres opérationnelles. Knowledge Catalog explore automatiquement ces métadonnées et enregistre les colonnes et les contraintes.
Orchestration du contexte du cloud de données agentique
Dans le framework cloud de données agentique de Google, Knowledge Catalog sert de plan d'orchestration sémantique. Plutôt que d'obliger les développeurs à coder manuellement en dur les schémas et les règles de base de données dans les requêtes, le moteur de contexte fournit de manière dynamique le contexte sémantique précis dont un agent a besoin pour prendre des décisions intelligentes.
La figure suivante montre comment Knowledge Catalog orchestre et fournit le contexte des données :
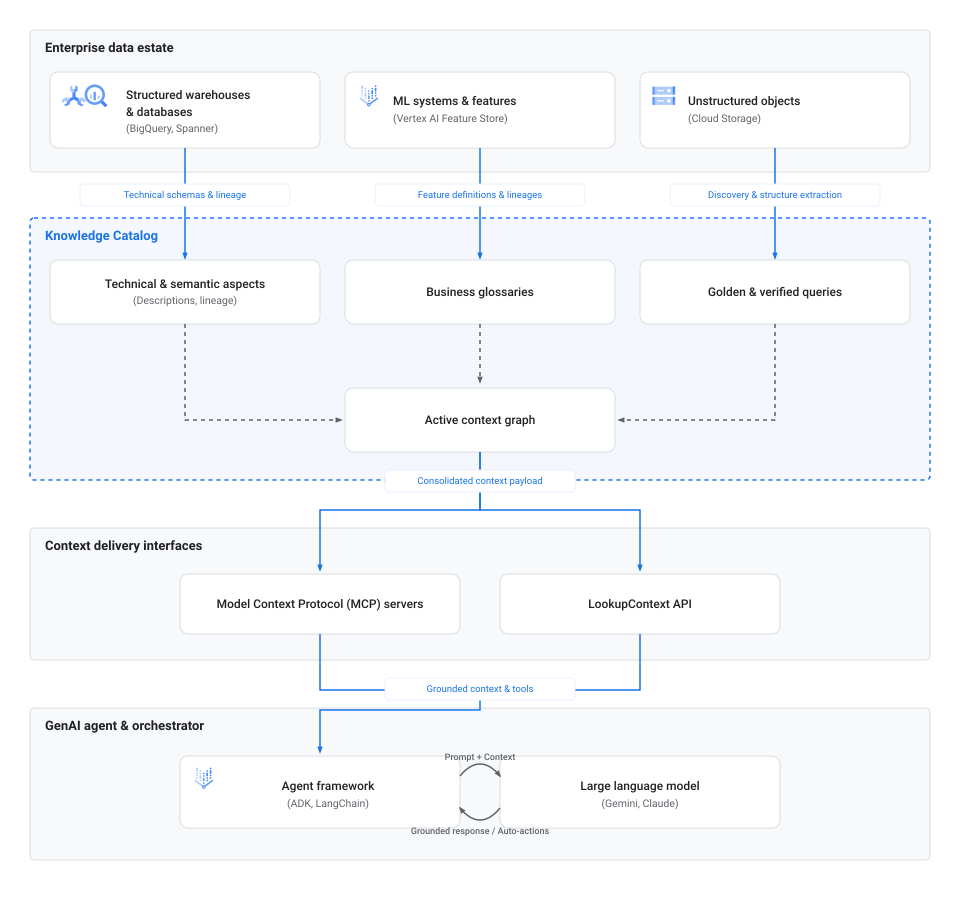
Le workflow d'orchestration du contexte comprend les phases suivantes :
- Ingestion et découverte. Les bases de données opérationnelles, les entrepôts comme Spanner et BigQuery, les stores d'objets non structurés comme Cloud Storage et les metastores d'exécution comme le catalogue d'environnements d'exécution Lakehouse alimentent directement Knowledge Catalog en schémas techniques, cartes de traçabilité et définitions de métadonnées.
- Mappage de contexte. Dans Knowledge Catalog, ces propriétés de métadonnées sont associées à des éléments sémantiques, y compris des aspects techniques, des glossaires d'entreprise et des requêtes validées, pour assembler le graphique de contexte actif.
- Interfaces de livraison. Les applications et les orchestrateurs d'IA récupèrent ce graphique de contexte consolidé de manière programmatique à l'aide de connecteurs standards, tels que MCP ou des points de terminaison de l'API
LookupContextdirects. - Ancrage de l'agent. Les frameworks d'orchestration, tels que l'Agent Development Kit (ADK) ou LangChain, injectent ce contexte de métadonnées directement dans les requêtes LLM. Cette injection ancre le raisonnement de l'agent dans des règles organisationnelles vérifiées, ce qui lui permet d'interroger des bases de données ou d'exécuter des actions automatisées sans hallucinations.
Profils d'agents IA
En fonction des workflows que vous souhaitez automatiser, vous pouvez créer différentes classes d'agents optimisés par Knowledge Catalog :
- Agents de découverte de données. Ces assistants aident les utilisateurs à rechercher et à parcourir le patrimoine de données. Au lieu d'utiliser la correspondance des mots clés, ils analysent l'intention et les contraintes de forme longue en langage naturel pour récupérer les assets physiques les plus pertinents.
- Agents d'enrichissement des métadonnées. Ces agents d'arrière-plan ingèrent du texte non structuré provenant de wikis, de fichiers README ou de journaux de chat, analysent le texte pour en extraire des métadonnées formelles et écrivent ces métadonnées sous forme d'aspects dans Knowledge Catalog pour les maintenir à jour.
- Agents de qualité des données et de pipeline. Ces agents autonomes évaluent les règles de qualité, détectent la dérive des schémas, et créent ou réparent les pipelines de transformation de données en interrogeant la traçabilité des données et les statistiques de profil.
Outils d'orchestration
Pour créer et intégrer ces agents, vous pouvez utiliser les outils suivants :
- Protocole MCP (Model Context Protocol). Un protocole ouvert et standardisé pour associer des agents à des ressources externes. Vous pouvez configurer les agents pour qu'ils se connectent au catalogue à l'aide du serveur MCP distant ou de la boîte à outils MCP locale. Pour en savoir plus, consultez À propos du protocole MCP (Model Context Protocol) dans Knowledge Catalog.
- Agent Development Kit (ADK). Framework de Google qui simplifie la création, l'exécution et le test d'agents d'IA générative, offrant des liaisons intégrées à l'API Catalog Service. Pour en savoir plus, consultez la page d'accueil de l'ADK.
- API LookupContext. Un point de terminaison d'API REST et gRPC qui extrait une charge utile de contexte YAML ou JSON unifiée pour les éléments de données, prête à être injectée directement dans les requêtes LLM. Pour en savoir plus, consultez Récupérer le contexte à l'aide de l'API LookupContext.
Accéder au contexte avec MCP
Le protocole MCP (Model Context Protocol) est un pont standardisé qui permet aux agents IA et aux outils d'IA de se connecter de manière fluide à des sources de données telles que Knowledge Catalog. Utilisez le tableau de comparaison suivant pour déterminer la meilleure option pour votre intégration :
| Implémentation | Application idéale | Informations essentielles | Point de terminaison ou configuration |
|---|---|---|---|
| Serveur MCP distant | Déploiements cloud-first, environnements sans serveur comme Cloud Run et services externes gérés. | Point de terminaison hébergé par Google qui ne nécessite aucune gestion de serveur local. | Point de terminaison : https://dataplex.googleapis.com/mcpPour configurer, consultez Utiliser un serveur MCP distant. |
| Boîte à outils MCP locale | Développement d'agents en local, prototypage rapide et intégrations d'IDE de bureau comme VS Code ou Cursor. | Outil de ligne de commande agissant comme un proxy local entre votre environnement d'espace de travail et Knowledge Catalog. | Nécessite l'installation binaire et les paramètres .mcp.json.Pour configurer, consultez Utiliser un serveur MCP local. |
Bonnes pratiques pour le contexte de données agentique
Pour créer des expériences d'agent fiables, gardez à l'esprit les bonnes pratiques suivantes lorsque vous organisez et interrogez des métadonnées dans Knowledge Catalog :
- Ajoutez des aspects. Les agents IA ne peuvent pas distinguer les tables de production officielles des maquettes de bac à sable temporaires uniquement par leur nom. Définissez et appliquez un aspect de signal de confiance personnalisé pour certifier les produits de données faisant autorité, ce qui permet de s'assurer que les agents priorisent ou limitent les requêtes à ces ressources.
- Optimisez les recherches à l'aide de budgets de contexte. Lorsque vous appelez l'API
LookupContext, spécifiez le paramètrecontext_budget. L'API optimise et ajuste d'abord les métadonnées les plus importantes, telles que la traçabilité et les descriptions principales, dans les limites de jetons que vous avez spécifiées. - Fournissez des ressources associées pour exposer les chemins de jointure. Dans vos requêtes de contexte, listez jusqu'à 10 tables ou éléments associés. En fournissant un groupe d'éléments, vous permettez au moteur de contexte de remplir automatiquement les chemins de jointure et les relations, ce qui aide l'agent à comprendre comment les tables interagissent.
- Structurer les glossaires sémantiques. Standardisez les termes et les abréviations dans les glossaires d'entreprise. Cette standardisation aide les outils de conversation à résoudre avec précision les synonymes et les métriques spécifiques à l'entreprise.
- Publiez les requêtes de référence. Associez des requêtes en langage naturel validées et leurs équivalents SQL corrects directement aux entrées du Knowledge Catalog. En ancrant le raisonnement dans ces modèles validés, vous évitez les erreurs de conversion SQL dans les agents text-to-SQL.
Passer de Dataplex Universal Catalog à Knowledge Catalog
Dataplex Universal Catalog est devenu Knowledge Catalog. Pour en savoir plus sur cette transition, consultez Passer de Dataplex Universal Catalog à Knowledge Catalog.
Limites
Lorsque vous planifiez votre déploiement, tenez compte des limites suivantes :
Intégrations compatibles Bien que Knowledge Catalog soit compatible avec les principaux systèmes tiers, certaines extractions sémantiques automatisées peuvent être limitées aux services Google Cloud intégrés.
Limites de quota Les quotas d'API Google Cloud standards s'appliquent aux opérations de récupération de contexte et d'extraction de métadonnées.
Étapes suivantes
À propos du contexte des données
Découvrez comment le contexte actif transforme les métadonnées passives pour ancrer les agents IA et éviter les hallucinations.
Établir un contexte de données de base
Créez un glossaire d'entreprise, définissez des types d'aspects personnalisés et enrichissez les éléments dans BigQuery.
Ancrer des agents avec MCP
Connectez des agents IA et des outils pour les développeurs à Knowledge Catalog à l'aide de Model Context Protocol.
Rechercher des ressources
Recherchez et explorez les ressources du catalogue dans Google Cloud et les systèmes tiers à l'aide du langage naturel.
Automatiser les analyses de la qualité des données
Définissez des règles de validation et surveillez la propreté des données dans les tables grâce à des analyses de qualité automatisées.
Découvrir des cas d'utilisation interactifs
Découvrez des solutions concrètes pour l'enrichissement du contexte, la traçabilité des données et les workflows agentiques.