


O Knowledge Catalog permite unificar metadados técnicos e semântica de negócios em dados estruturados e não estruturados usando recursos com tecnologia do Gemini. Em seguida, use o gráfico de contexto resultante para descobrir recursos, verificar a qualidade dos dados e embasar aplicativos de IA generativa para reduzir alucinações.
Este documento é destinado a engenheiros de dados e contexto, cientistas de dados, gestores de dados e desenvolvedores de IA. É necessário ter familiaridade com sistemas de banco de dados e armazenamento, como o BigQuery ou o Cloud Storage, e uma compreensão básica de conceitos de IA generativa, como geração aumentada por recuperação (RAG) ou Protocolo de Contexto de Modelo (MCP).
Para um tutorial detalhado do Knowledge Catalog, assista este vídeo:
Resolva a complexidade de dados específica do setor
Nas empresas modernas, os dados são complexos, altamente distribuídos e existem em formatos estruturados e não estruturados. As solicitações de negócios raramente são mapeadas para um único esquema de banco de dados ou armazenamento de documentos. Alinhar esses silos de forma segura e, ao mesmo tempo, fornecer respostas imediatas e confiáveis a perguntas de vários domínios é um grande desafio operacional.
O Knowledge Catalog atua como a base semântica que preenche essa lacuna, permitindo que agentes de IA e ferramentas de análise recuperem um contexto embasado e relevante.
Principais funções do usuário
Engenheiros de contexto (engenheiros de dados). Automatize a agregação de metadados em bancos de dados e no Cloud Storage, rastreie transformações com linhagem e crie fluxos de trabalho de enriquecimento e avaliação.
Administradores de dados (equipes de governança). Supervisione a qualidade dos metadados com revisões human-in-the-loop de descrições geradas por IA, padronize vocabulários de negócios com glossários e defina aspectos personalizados para anexar contexto específico do domínio às entradas do catálogo.
Desenvolvedores de IA. Embase LLMs e aplicativos de IA com esquemas de dados empresariais confiáveis usando servidores MCP ou APIs de recuperação de contexto.
Casos de uso do setor
A tabela a seguir ilustra as perguntas complexas que surgem na prática, como elas ultrapassam os limites técnicos e como o Knowledge Catalog ajuda as organizações a resolvê-las:
| Setor | Desafios operacionais e de dados | Problema de negócios a ser resolvido | Como o Knowledge Catalog resolve isso |
|---|---|---|---|
| E-commerce |
|
"Encontre produtos eletrônicos com altas taxas de devolução e fotos de clientes mostrando sinais de danos na entrega." | Embasamento semântico em vários formatos de dados:descobre automaticamente metadados de bancos de dados transacionais e os vincula a imagens não estruturadas em buckets de armazenamento do Cloud Storage, permitindo que as ferramentas de IA resolvam a consulta em sistemas de armazenamento diferentes. |
| Manufatura |
|
"Gere resumos de todos os relatórios de inspeção relacionados a máquinas na região oeste que não passaram nas verificações de segurança no último trimestre." | Rastreamento regional e não estruturado:rastreia e cataloga relatórios de inspeção em PDF não estruturados com metadados de recursos, permitindo que os agentes de IA generativa localizem, compilem e resumam relatórios por região. |
| Saúde |
|
"Quais pacientes têm o maior risco de readmissão em 30 dias, considerando os sinais vitais recentes e a frequência de consultas?" | Qualidade e linhagem de dados:calcula o perfil de qualidade de dados em nível de linha e os mapas de linhagem em feeds de histórico de saúde eletrônicos, o que ajuda a garantir que os modelos preditivos clínicos dependam apenas de sinais vitais verificados e de alta qualidade dos pacientes. |
| Serviços financeiros |
|
"Quais dos 10 clientes com maior receita reclamaram de 'problemas de desempenho' e como isso afeta as projeções do terceiro trimestre?" | Gráfico de contexto unificado:unifica registros de clientes, feedback de suporte e tabelas financeiras, permitindo que consultas em linguagem natural combinem estatísticas de receita de clientes com arquivos de feedback não estruturados para prever o impacto financeiro. |
Para lidar com esses desafios operacionais, o Knowledge Catalog oferece recursos importantes que ajudam engenheiros de dados, cientistas de dados e desenvolvedores de IA a criar sistemas de dados controlados:
Embasar agentes de IA com o Protocolo de Contexto de Modelo (MCP). Exponha metadados, esquemas, linhagem e regras de negócios diretamente aos agentes de IA usando servidores MCP locais ou remotos. Esses servidores permitem que os modelos verifiquem as expectativas operacionais antes de propor ações.
Acelere a descoberta para IA e análise. Encontre recursos de dados relevantes usando a pesquisa semântica de linguagem natural. Os resumos e as recomendações generativas ajudam os usuários a localizar dados sem esperar por revisões manuais de documentação.
Governe produtos de dados em grande escala. Empacote coleções de recursos com contratos de nível de serviço (SLAs), contratos, detalhes de propriedade e notas de uso em unidades únicas e controladas para pesquisa e assinatura.
Como o Knowledge Catalog funciona
O Knowledge Catalog unifica o gerenciamento de dados e o contexto com um ciclo de vida de três pilares. O diagrama a seguir ilustra como o serviço mapeia recursos de dados físicos para a semântica de negócios para o embasamento do agente de IA:
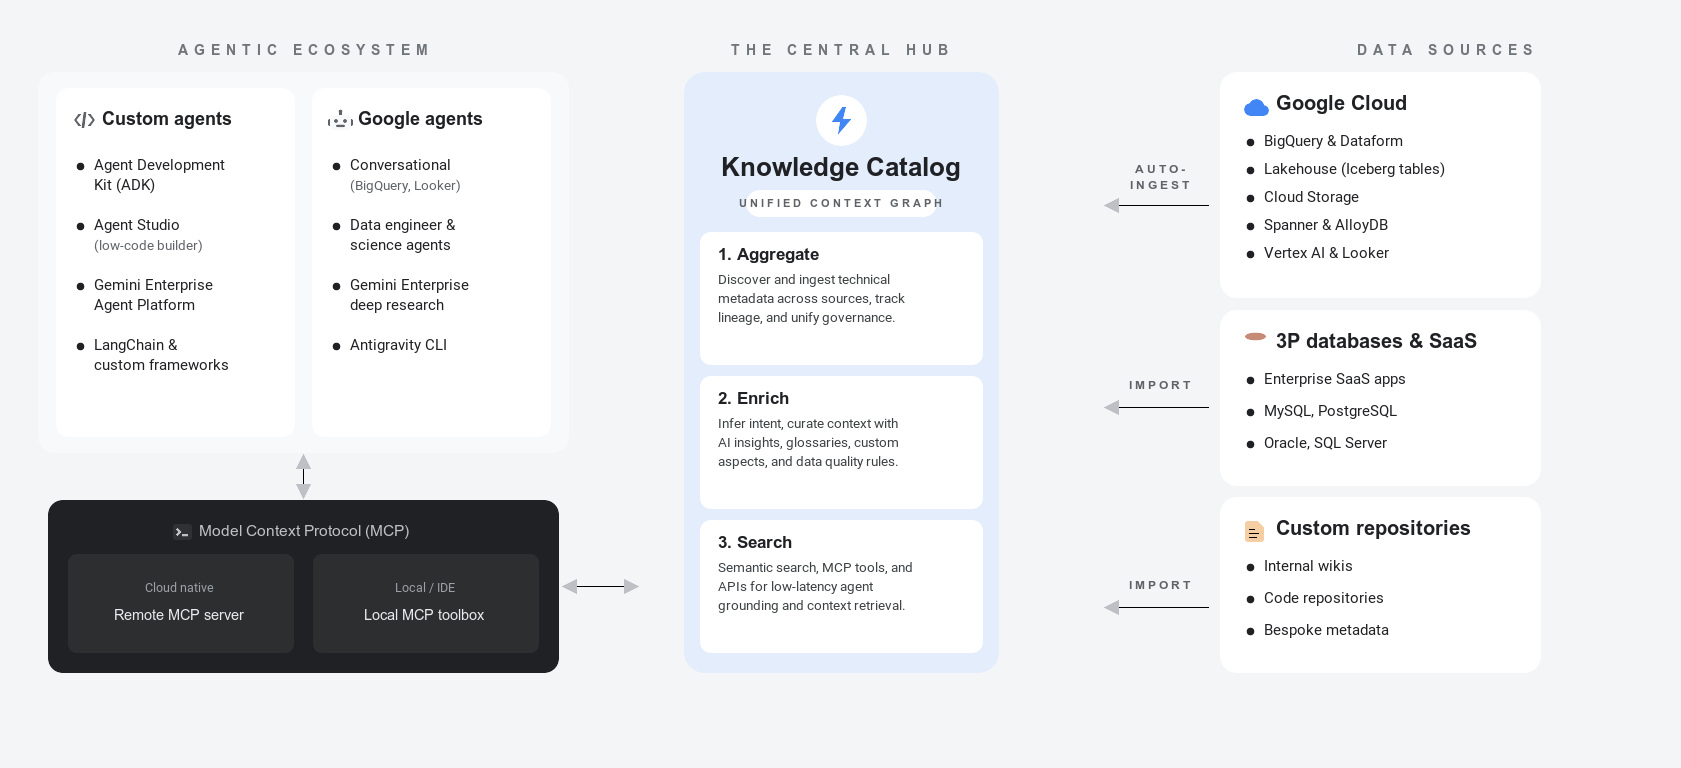
Para mais informações sobre esses conceitos de metadados, consulte Sobre metadados.
As seções a seguir descrevem os três pilares do ciclo de vida dos metadados e ilustram como uma empresa de varejo os aplica a tabelas de banco de dados, arquivos e entradas de catálogo externo:
Agregação (descoberta e ingestão). O Knowledge Catalog rastreia e indexa automaticamente metadados técnicos em todo o seu patrimônio de dados sem mover os dados subjacentes:
- Bancos de dados integrados. A catalogação automatizada captura esquemas e atributos em plataformas como BigQuery, AlloyDB para PostgreSQL e Spanner.
- Conectividade gerenciada. Ingira definições de sistemas externos, como Oracle ou PostgreSQL, ou registros de parceiros, como o Collibra, sem escrever pipelines personalizados.
- Linhagem de dados: Rastreie transformações no nível da coluna em pipelines para acompanhar de onde os dados vêm e como eles mudaram.
- Exemplo:uma empresa de varejo ingere automaticamente metadados de banco de dados transacionais, como as tabelas
orderseorder_items, e indexa arquivos de produtos não estruturados armazenados em buckets do Cloud Storage. Eles vinculam bancos de dados externos para estabelecer um índice de metadados unificado em um diretório detectável.
Para saber mais sobre agregação de metadados e ingestão de dados (clique para abrir)
- Fontes de dados compatíveis: lista todas as fontes externas e do Google Cloud compatíveis com a ingestão automatizada.
- Visão geral da conectividade gerenciada: explica como ingerir esquemas técnicos de sistemas externos.
- Rastrear a linhagem de dados: descreve como visualizar as transformações de pipeline no nível da coluna e o fluxo de dados.
Enriquecimento (organizar o contexto e verificar a confiança). O Knowledge Catalog atribui significado comercial a estruturas técnicas e estabelece indicadores de confiança:
- Insights gerados com IA. O Gemini analisa os registros de consulta para gerar descrições de colunas, resumos de tabelas e junções recomendadas.
- Glossários e aspectos. Mapeie nomes de métricas internas para um vocabulário compartilhado usando termos de negócios e modelos lógicos.
- Qualidade de dados e detecção de anomalias. Aplique diretrizes de limpeza e execute verificações de machine learning para detectar outliers estatísticos ou problemas de atualização de dados, gerando indicadores de confiança importantes.
- Análises de governança. Gerencie riscos usando processos de revisão de fluxo de trabalho para verificar as atualizações de metadados antes da publicação.
- Exemplo:a equipe de varejo enriquece os recursos acionando insights de dados para recomendar descrições de colunas e executar regras de qualidade de dados. Eles mapeiam definições de negócios para pedidos ativos criando glossários e aspectos.
Para saber mais sobre o enriquecimento de metadados e a verificação de confiança (clique para abrir)
- Configurar insights de dados: explica como gerar descrições e resumos automatizados de conjuntos de dados.
- Gerenciar glossários empresariais: descreve como personalizar termos padrão e vocabulários empresariais.
- Enriquecer metadados com aspectos: mostra como anexar propriedades de metadados estruturados a recursos lógicos.
- Reutilizar regras de qualidade de dados: mostra como estabelecer e reutilizar regras de validação de banco de dados.
- Visão geral da criação de perfil de dados: descreve como configurar verificações para anomalias de esquema e desvio estatístico.
Pesquisa e recuperação (acesso e embasamento). Os aplicativos de IA e os usuários empresariais consultam o gráfico de contexto unificado para acessar dados com segurança:
- Agentes de embasamento. Conecte seus apps e agentes baseados em LLM ao catálogo.
- API Context. Realizar solicitações de payload de embasamento de baixa latência.
- Pesquisa semântica. Encontre os recursos certos usando consultas de linguagem natural.
- Empacotamento de dados. Agrupe coleções de tabelas, detalhes de licenciamento e SLAs em pacotes de dados seguros e de autoatendimento.
- Exemplo:os analistas realizam pesquisas semânticas em linguagem natural para localizar recursos. Os aplicativos de IA consomem esse índice com segurança usando servidores MCP ou a API de recuperação de contexto, e os recursos de alta qualidade são empacotados em uma visualização segura.
Para saber mais sobre recuperação de contexto e embasamento de agentes (clique para abrir)
- Visão geral do Protocolo de Contexto de Modelo (MCP): explica como conectar agentes de IA generativa e camadas de aplicativos ao contexto do Catálogo de Conhecimento.
- Recuperar contexto usando LookupContext: mostra como extrair payloads operacionais importantes para comandos de agentes.
- Pesquisar recursos: descreve os recursos de pesquisa de recursos usando a sintaxe de consulta semântica de linguagem natural.
Knowledge Catalog no ecossistema de Google Cloud e IA
Entender como o Knowledge Catalog se integra aos serviços relacionados é essencial para criar uma base de dados.
Google Cloud bancos de dados e modelos
- BigQuery: O Knowledge Catalog rastreia e indexa automaticamente conjuntos de dados, tabelas e visualizações do BigQuery. Ele aciona insights de dados com tecnologia do Gemini para analisar históricos de consultas, publicar descrições e sugerir exemplos de consultas verificadas.
- Looker (Google Cloud Core). O Knowledge Catalog ingere painéis, Looks e estruturas do LookML do Looker, como visualizações, análises, dimensões e medições. Essa ingestão cria mapeamentos de linhagem para rastrear como os valores operacionais se correlacionam com a semântica de negócios.
- Catálogo do ambiente de execução do Lighthouse. O Knowledge Catalog se integra ao Lighthouse, o metastore de ambiente de execução para cargas de trabalho do Iceberg de código aberto. Ele indexa automaticamente os metadados técnicos sobre as cargas de trabalho do Lighthouse para fornecer um contexto ativo unificado.
Plataformas e assistentes de agentes de IA
- Análise de conversação. As interfaces de análise usam termos de catálogo e ferramentas de pesquisa para permitir que os usuários consultem métricas de negócios em linguagem natural com embasamento verificado.
- Gemini para agentes de IA. Os agentes assistentes de alta precisão usam metadados de catálogo para executar pesquisas em bancos de dados, reduzindo as alucinações.
- Gemini Enterprise Agent Platform. O Knowledge Catalog serve como o padrão central de governança de dados nos ambientes da plataforma de destino. Ele se conecta à Gemini Enterprise Agent Platform para fornecer ferramentas e contexto ao Agent Registry da plataforma.
Google Cloud integração de banco de dados e serviço de IA
O Knowledge Catalog funciona com outros produtos doGoogle Cloud para formar sua base de dados. A tabela a seguir destaca como o Knowledge Catalog se integra e complementa os serviços relacionados:
| Serviço | Função principal | Como ele se integra ao Knowledge Catalog |
|---|---|---|
| Knowledge Catalog | Governança e contexto agêntico | Serve como o grafo de contexto semântico unificado, executando verificações de qualidade de dados e expondo esquemas fundamentados para modelos e aplicativos de IA. |
| BigQuery | Armazenamento em data warehouse empresarial | Armazena, consulta e processa conjuntos de dados; rastreia, indexa e enriquece automaticamente essas tabelas com aspectos de classificação de negócios. |
| Gemini Enterprise Agent Platform | Desenvolvimento de modelos de IA | Cria, implanta e hospeda modelos de fundação. Os agentes personalizados recuperam o contexto de metadados para fundamentar o raciocínio lógico. |
| Cloud Storage | Armazenamento de arquivos não estruturados | Armazena arquivos brutos e não estruturados; executa automaticamente verificações de descoberta não estruturadas para analisar PDFs e imagens e criar mapas de relacionamento. |
Semântica e formatos de dados
Para instruir e embasar sistemas de agentes de forma eficaz, é preciso distinguir entre a estrutura física dos dados e o significado semântico:
- Semântica. O significado, a intenção e as relações comerciais associadas
aos seus dados. Embora os esquemas técnicos definam especificações de armazenamento estrutural, como um tipo de banco de dados, comprimento de caracteres ou restrição de números inteiros, a semântica descreve o que o conjunto de dados realmente representa. Por
exemplo, é possível mapear uma coluna chamada
txn_qtypara a definição de negócios de "quantidade comprada". - Dados estruturados. Informações armazenadas em esquemas definidos e formatos relacionais. Exemplos incluem tabelas do BigQuery, bancos de dados do Spanner e tabelas operacionais do Postgres. O Knowledge Catalog rastreia automaticamente esses metadados e registra colunas e restrições.
Orquestração de contexto da nuvem de dados agêntica
No framework da nuvem de dados agêntica do Google, o Knowledge Catalog serve como o plano de orquestração semântica. Em vez de exigir que os desenvolvedores codifiquem manualmente esquemas e regras de banco de dados em comandos, o mecanismo de contexto fornece dinamicamente o contexto semântico preciso que um agente precisa para tomar decisões inteligentes.
A figura a seguir mostra como o Knowledge Catalog orquestra e fornece o contexto de dados:
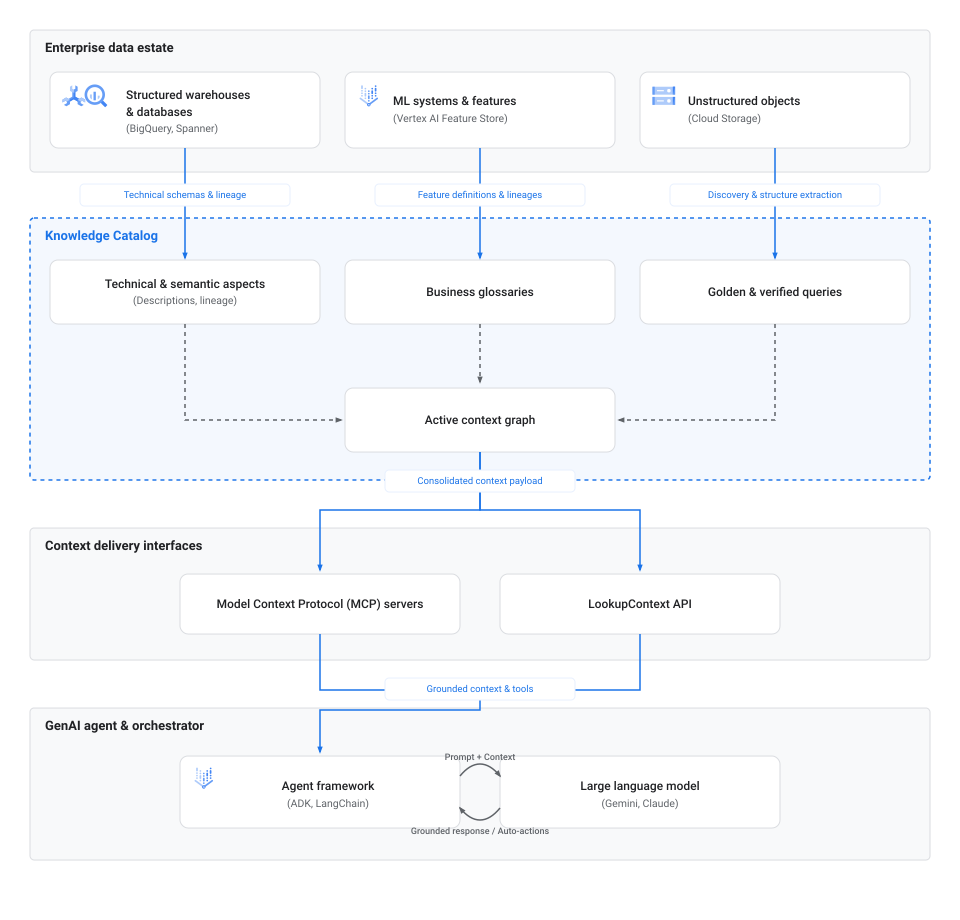
O fluxo de trabalho de orquestração de contexto consiste nas seguintes fases:
- Ingestão e descoberta. Bancos de dados operacionais, warehouses como o Spanner e o BigQuery, repositórios de objetos não estruturados como o Cloud Storage e metastores de ambiente de execução como o Lighthouse alimentam esquemas técnicos, mapas de linhagem e definições de metadados diretamente no Knowledge Catalog.
- Mapeamento de conteúdo. No Knowledge Catalog, essas propriedades de metadados são vinculadas a elementos semânticos, incluindo aspectos técnicos, glossários empresariais e consultas verificadas, para montar o gráfico de contexto ativo.
- Interfaces de entrega. Os aplicativos e orquestradores de IA recuperam esse
gráfico de contexto consolidado de forma programática usando conectores padrão,
como MCP ou endpoints de API
LookupContextdiretos. - Embasamento do agente. Os frameworks de orquestração, como o Kit de Desenvolvimento de Agente (ADK) ou o LangChain, injetam esse contexto de metadados diretamente nos comandos do LLM. Essa injeção fundamenta o raciocínio do agente em regras organizacionais verificadas, o que permite que ele consulte bancos de dados ou execute ações automatizadas sem alucinações.
Perfis de agentes de IA
Dependendo dos fluxos de trabalho que você quer automatizar, é possível criar diferentes classes de agentes com tecnologia do Knowledge Catalog:
- Agentes de descoberta de dados. Esses assistentes ajudam os usuários a pesquisar e navegar pelo patrimônio de dados. Em vez de usar a correspondência de palavras-chave, eles analisam a intenção e as restrições de formato longo em linguagem natural para recuperar os recursos físicos mais relevantes.
- Agentes de enriquecimento de metadados. Esses agentes em segundo plano ingerem texto não estruturado de wikis, arquivos README ou registros de chat, analisam o texto em metadados formais e gravam os metadados como aspectos no Knowledge Catalog para mantê-los atualizados.
- Qualidade de dados e agentes de pipeline. Esses agentes autônomos avaliam regras de qualidade, detectam desvios de esquema e criam ou reparam pipelines de transformação de dados consultando a linhagem de dados e as estatísticas de perfil.
Ferramentas de orquestração
Para criar e integrar esses agentes, use as seguintes ferramentas:
- Protocolo de Contexto de Modelo (MCP). Um protocolo aberto e padronizado para vincular agentes a recursos externos. É possível configurar os agentes para se conectarem ao catálogo usando o servidor MCP remoto ou a caixa de ferramentas MCP local. Para mais informações, consulte Sobre o Protocolo de Contexto de Modelo (MCP) no Knowledge Catalog.
- Kit de Desenvolvimento de Agente (ADK). Um framework do Google que simplifica a criação, a execução e o teste de agentes de IA generativa, oferecendo vinculações integradas à API Catalog Service. Para mais informações, consulte a página inicial do ADK.
- API LookupContext. Um endpoint de API REST e gRPC que extrai um payload de contexto YAML ou JSON unificado para recursos de dados, pronto para ser injetado diretamente em comandos de LLM. Para mais informações, consulte Recuperar contexto usando a API LookupContext.
Acessar o contexto com o MCP
O Protocolo de Contexto de Modelo (MCP) é uma ponte padronizada que permite que agentes e ferramentas de IA se conectem de forma integrada a fontes de dados, como o Knowledge Catalog. Use a tabela de comparação a seguir para determinar a melhor opção para sua integração:
| Implementação | Ideal para | Detalhes importantes | Endpoint ou configuração |
|---|---|---|---|
| Servidor MCP remoto | Implantações que priorizam a nuvem, ambientes sem servidor como o Cloud Run e serviços externos gerenciados. | Endpoint hospedado pelo Google que não requer gerenciamento de servidor local. | Endpoint: https://dataplex.googleapis.com/mcpPara configurar, consulte Usar um servidor MCP remoto. |
| Caixa de ferramentas do MCP local | Desenvolvimento de agentes locais, prototipagem rápida e integrações de IDE para computador, como VS Code ou Cursor. | Ferramenta de linha de comando que atua como um proxy local entre o ambiente do seu espaço de trabalho e o Knowledge Catalog. | Requer instalação binária e configurações de .mcp.json.Para configurar, consulte Usar um servidor MCP local. |
Práticas recomendadas para o contexto de dados de agentes
Para criar experiências agênticas confiáveis, siga estas práticas recomendadas ao organizar e consultar metadados no Knowledge Catalog:
- Adicionar aspectos. Os agentes de IA não conseguem distinguir entre tabelas de produção oficiais e simulações temporárias de sandbox apenas pelo nome. Defina e aplique um aspecto de indicador de confiança personalizado para certificar produtos de dados autoritativos, o que ajuda a garantir que os agentes priorizem ou restrinjam as consultas a esses recursos.
- Otimize as pesquisas usando orçamentos de contexto. Ao chamar a API
LookupContext, especifique o parâmetrocontext_budget. A API otimiza e ajusta primeiro os metadados mais importantes, como linhagem e descrições primárias, dentro das restrições de token especificadas. - Forneça recursos relacionados para expor caminhos de mesclagem. Nas consultas de contexto, liste até 10 tabelas ou recursos relacionados. Ao fornecer um grupo de ativos, o mecanismo contextual pode preencher automaticamente os caminhos de junção e as relações, o que ajuda o agente a entender como as tabelas se conectam.
- Estruturar glossários semânticos. Padronize termos e abreviações em glossários empresariais. Essa padronização ajuda as ferramentas de conversação a resolver sinônimos e métricas específicos de negócios com precisão.
- Publicar consultas de ouro. Anexe consultas em linguagem natural verificadas e as equivalentes em SQL diretamente às entradas do Knowledge Catalog. Ao fundamentar o raciocínio nesses modelos verificados, você evita erros de conversão de SQL em agentes de texto para SQL.
Fazer a transição do Dataplex Universal Catalog para o Knowledge Catalog
O Dataplex Universal Catalog evoluiu para o Knowledge Catalog. Para mais informações sobre essa transição, consulte Fazer a transição do Dataplex Universal Catalog para o Knowledge Catalog.
Limitações
Ao planejar a implantação, considere as seguintes limitações:
Integrações aceitas. Embora o Knowledge Catalog ofereça suporte aos principais sistemas de terceiros, algumas extrações semânticas automatizadas podem ser limitadas aos serviços integrados do Google Cloud .
Limites de cota. As cotas padrão da API Google Cloud se aplicam às operações de recuperação de contexto e extração de metadados.
A seguir
Sobre o contexto de dados
Entender como o contexto ativo transforma metadados passivos para embasar agentes de IA e evitar alucinações.
Estabelecer o contexto de dados fundamental
Criar um glossário empresarial, definir tipos de aspecto personalizados e enriquecer recursos no BigQuery.
Agentes de embasamento com MCP
Conecte agentes de IA e ferramentas para desenvolvedores ao Catálogo de Conhecimento usando o Protocolo de Contexto de Modelo.
Pesquisar recursos
Encontre e explore recursos de catálogo no Google Cloud e em sistemas de terceiros usando linguagem natural.
Automatizar as verificações de qualidade de dados
Defina regras de validação e monitore a limpeza de dados em tabelas com verificações de qualidade automatizadas.
Explore casos de uso interativos
Conheça soluções reais para enriquecimento de contexto, linhagem de dados e Agentic Workflows.