


Knowledge Catalog (舊稱 Dataplex Universal Catalog) 可讓您定義及評估 BigQuery 和 Iceberg REST Catalog 資料表中的資料品質。您可以自動掃描資料、根據定義的規則驗證資料,並在資料不符合品質規定時記錄警告。自動資料品質功能可讓您以程式碼的形式管理資料品質規則和部署作業,提高資料產生管道的完整性。
如要掃描資料中的異常狀況,請參閱「Knowledge Catalog 資料剖析掃描」。掃描作業可產生資料品質規則。您也可以使用內建的品質規則,或建立自訂規則。
Knowledge Catalog 提供監控、疑難排解和 Cloud Logging 警告功能,並與自動資料品質功能整合。
概念模型
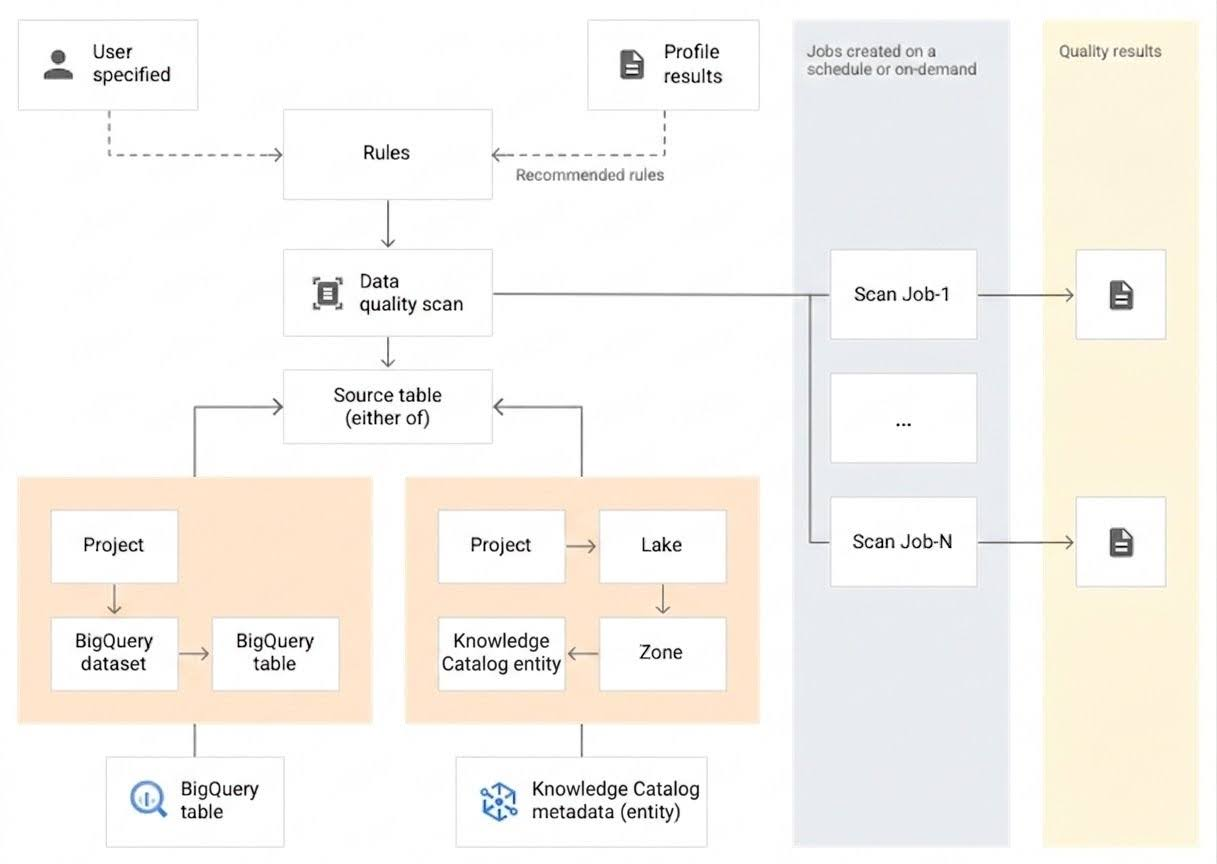
資料品質掃描是一種 Knowledge Catalog 資料掃描,會根據一組內建規則驗證資料。資料掃描是一項 Knowledge Catalog 工作,會從 BigQuery 和 Cloud Storage (透過 BigQuery 外部資料表) 取樣資料,並推論各種中繼資料。如要使用自動資料品質功能評估資料表品質,請建立 data quality 類型的 DataScan 物件。掃描作業只會在一個 BigQuery 資料表上執行。掃描作業會使用 Google 租戶專案中的資源,因此您不必自行設定基礎架構。
建立及使用資料品質掃描作業的步驟如下:
- 定義資料品質規則
- 設定規則執行
- 分析資料品質掃描結果
- 設定監控和警告功能
- 排解資料品質失敗問題
規則定義
與資料品質掃描作業相關聯的資料品質規則,會定義資料預期。您可以透過下列方式建立資料品質規則:
- 使用 Knowledge Catalog 資料剖析提供的建議
- 使用內建規則或系統規則範本
- 建立自訂 SQL 規則
- 重複使用資料品質規則
內建規則
Knowledge Catalog 支援下列內建規則類別:
- 資料列層級
如果是資料列層級類別規則,則會對每個資料列套用預期。每列會獨立通過或不通過條件。例如
column_A_value < 1。資料列層級檢查需要指定通過門檻。如果通過規則的資料列百分比低於門檻值,規則就會失敗。
- 匯總
如果是匯總規則,則會針對整個資料匯總的單一值套用預期。例如:
Avg(someCol) >= 10。如要通過,檢查結果必須為布林值true。匯總規則不會為每個資料列提供獨立的通過或失敗計數。
這兩類規則都可以設定下列參數:
- 要套用規則的資料欄
- 維度
下表列出支援的資料列層級和匯總規則類型:
| 規則類型 ( Google Cloud 控制台中的名稱) |
資料列層級或匯總規則 | 說明 | 支援的資料欄類型 | 規則專屬參數 |
|---|---|---|---|---|
RangeExpectation(範圍檢查) |
資料列層級 | 檢查值是否介於最小值和最大值之間。 | 所有數值、日期和時間戳記類型的資料欄。 | 必要:
|
NonNullExpectation(空值檢查) |
資料列層級 | 驗證資料欄值並非空值。 | 所有支援的資料欄類型。 | 必要:
|
SetExpectation(設定檢查) |
資料列層級 | 檢查資料欄中的值是否為一組指定值之一。 | 所有支援的資料欄類型,Record 和 Struct 除外。 |
必要:
|
RegexExpectation(規則運算式檢查) |
資料列層級 | 根據指定的規則運算式檢查值。 | 字串 | 必要:
|
Uniqueness(唯一性檢查) |
匯總 | 檢查資料欄中的所有值是否不重複。 | 所有支援的資料欄類型,Record 和 Struct 除外。 |
必要:
|
StatisticRangeExpectation(統計資料檢查) |
匯總 | 檢查指定的統計測量值是否符合預期範圍。 | 所有支援的數值資料欄類型。 | 必要:
|
支援的自訂 SQL 規則類型
SQL 規則可讓您靈活運用自訂邏輯擴充驗證。這些規則分為以下類型。
| 規則類型 | 資料列層級或匯總規則 | 說明 | 支援的資料欄類型 | 規則專屬參數 | 範例 |
|---|---|---|---|---|---|
| 資料列條件 | 資料列層級 | 在 WHERE 子句中定義 SQL 運算式,為每個資料列指定預期。SQL 運算式應評估每個資料列為 true (通過) 或 false (失敗)。Knowledge Catalog 會計算符合這項預期條件的資料列百分比,並與通過門檻百分比比較,判斷規則是否成功。 運算式可以包含其他資料表的參照,例如建立參照完整性檢查。 |
所有資料欄 | 必要:
|
grossWeight <= netWeight |
| 資料表條件 (匯總 SQL 運算式) |
匯總 | 這些規則會在每個資料表執行一次。提供評估布林值的 SQL 運算式,true 代表通過檢查,false 則代表檢查失敗。SQL 運算式可透過運算式子查詢,參照其他資料表。 |
所有資料欄 | 必要:
|
簡單匯總範例:avg(price) > 100使用運算式子查詢比較不同資料表的值: (SELECT COUNT(*) FROM `example_project.example_dataset.different-table`) < COUNT(*) |
| SQL 斷言 | 匯總 | 斷言規則會使用資料品質查詢,找出不符合查詢中指定的一或多項條件的資料列。請提供要評估的 SQL 陳述式,以便傳回符合無效狀態的資料列。如果查詢傳回任何資料列,則規則失敗。 省略 SQL 陳述式結尾的分號。 SQL 陳述式可使用運算式子查詢,參照其他資料表。 |
所有資料欄 | 必要:
|
簡單的匯總範例,確保 discount_pct 不大於 100:SELECT * FROM example_project.example_dataset.table WHERE discount_pct > 100使用運算式子查詢比較不同資料表中的值: SELECT * FROM `example_project.example_dataset.different-table` WHERE gross_weight > (SELECT avg(gross_weight) FROM `example_project.example_dataset.different-table`)
|
如需規則範例,請參閱「自動資料品質範例規則」。
如要瞭解支援的 SQL 函式,請參閱 GoogleSQL 參考資料。
重複使用資料品質規則
您可以重複使用 Knowledge Catalog 資料品質規則,透過規則範本在多項資料品質規則中,共用複雜或標準化的業務規則定義。舉例來說,您可以建立電子郵件驗證規則範本,或兩個資料表之間的外鍵驗證規則範本,然後在資料掃描作業中重複使用這些範本。
規則可重複使用性提供下列主要功能:
- 資料品質規則範本:建立自訂規則範本,儲存複雜或標準化的業務規則定義,並在多項資料品質規則中共用。建立
data-quality-rule-template項目,並新增data-quality-rule-template方面,定義範本邏輯。 - 將資料規則視為中繼資料:在 Knowledge Catalog 中,將資料品質規則宣告為 BigQuery 資料表或組織詞彙等項目的面向。使用
data-rules切面類型,將這些規則附加至項目。 - 系統規則範本:使用系統規則範本,建立常用規則。
詳情請參閱「重複使用資料品質規則」。
維度
維度可讓您匯總多項資料品質規則的結果,以便監控及發出快訊。每項資料品質規則都必須與維度建立關聯。Knowledge Catalog 提供下列維度:
- 即時程度
- 「即時程度」是指資料上次更新的時間。這項資訊有助於判斷資料是否夠新,足以派上用場。
- 資料量
- 資料量:評估是否包含所有預期資料。
- 完整度
- 完整性:評估資料是否包含預期用途所需的所有資訊。
- 有效性
- 有效性會評估資料是否符合內建標準,例如格式、可接受的範圍或其他條件。舉例來說,如果有效日期必須採用
YYYY/mm/dd格式,則 08-12-2019 就是無效資料。再舉一個例子,如果某項商品的有效特價介於 $10 美元和 $20 美元之間,則 $100 美元的特價就是無效資料。 - 一致性
- 一致性是指資料在多個執行個體 (例如資料表和資料欄) 中具有相同的值。舉例來說,如果從銷售資料庫或使用資料庫讀取產品收益時,收益不一致,就會發生資料不一致的情況。
- 準確率
- 準確性是指資料的正確性。請注意,有效的資料不一定準確。舉例來說,棕色可能是有效的髮色,但如果某人沒有棕色頭髮,那就是不準確的資料。
- 唯一性
- 獨特性是指資料是否獨特且不重複。
規則中的輸入類型
所有值參數都會以字串值的形式傳遞至 API。Knowledge Catalog 的輸入內容必須符合 BigQuery 指定格式。
二進位類型的參數可以採用 Base64 編碼字串的形式傳遞。
| 類型 | 支援的格式 | 範例 |
|---|---|---|
| 二進位檔 | Base64 編碼值 | YXBwbGU= |
| 時間戳記 | YYYY-[M]M-[D]D[( |T)[H]H:[M]M:[S]S[.F]] [time_zone] OR YYYY-[M]M-[D]D[( |T)[H]H:[M]M:[S]S[.F]][time_zone_offset] |
2014-09-27 12:30:00.45-08 |
| 日期 | YYYY-M[M]-D[D] | 2014-09-27 |
| 時間 | [H]H:[M]M:[S]S[.DDDDDD] | 12:30:00.45 |
| DateTime | YYYY-[M]M-[D]D [[H]H:[M]M:[S]S[.DDDDDD]] | 2014-09-27 12:30:00.45 |
資料參照參數
建立自訂 SQL 規則時,您可以使用規則中的資料參照參數 ${data()},參照資料來源資料表及其所有前提條件篩選器,而不必明確提及來源資料表及其篩選器。Knowledge Catalog 會將參數解讀為來源資料表及其篩選器的參照。前置條件篩選器的例子包括資料列篩選器、取樣百分比和增量篩選器。
舉例來說,假設您有一個名為 my_project_id.dim_dataset.dim_currency 的資料來源表格。您想執行增量資料品質掃描,只掃描每天的新資料。資料表會套用資料列篩選器,篩選出當天的項目 transaction_timestamp >= current_date()。
如要找出今天 discount_pct 的資料列,自訂 SQL 規則如下:
discount_pct IN (SELECT discount_pct FROM my_project_id.dim_dataset.dim_currency WHERE transaction_timestamp >= current_date())
如果使用資料參照參數,就能簡化規則。將資料表和其前置條件篩選器的提及內容替換為 ${data()} 參數:
discount_pct IN (SELECT discount_pct FROM ${data()})
Knowledge Catalog 會將 ${data()} 參數解讀為參照含有當天項目的資料來源資料表 my_project_id.dim_dataset.dim_currency WHERE transaction_timestamp >= current_date()。在這個範例中,資料參照參數僅參照增量資料。
${data()} 參數須區分大小寫。
在子查詢中使用別名參照來源資料表中的資料欄時,請使用資料參照參數參照來源資料表,或省略資料表參照。請勿在 WHERE 子句中使用直接資料表參照,來參照來源資料表中的資料欄。
建議:
使用資料參照參數參照來源資料表:
discount_pct IN (
SELECT discount_pct FROM
`my_project_id.dim_dataset.dim_currency` AS temp-table
WHERE
temp-table.transaction_timestamp = ${data()}.timestamp
)
省略資料表參照:
discount_pct IN (
SELECT discount_pct FROM
`another_project.another_dataset.another_table` AS temp-table
WHERE
temp-table.transaction_timestamp = timestamp
不建議使用:
請勿使用直接表格參照來參照來源資料表中的資料欄:
discount_pct IN (
SELECT discount_pct FROM
`my_project_id.dim_dataset.dim_currency` AS temp-table
WHERE
temp-table.transaction_timestamp = `my_project_id.dim_dataset.dim_currency`.timestamp
)
使用不同表格的有效做法:
比較「不同」表格的資料欄時,可以使用直接表格參照:
discount_pct IN (
SELECT discount_pct FROM
`my_project_id.dim_dataset.dim_currency` AS temp-table
WHERE
temp-table.transaction_timestamp = `another_project.another_dataset.another_table`.timestamp
)
偵錯查詢
建立規則時,您可以選擇加入偵錯查詢,與規則一併執行。偵錯查詢是 SQL 陳述式,最多可傳回 10 個純量值。如果規則失敗,這些值有助於診斷原因。每項規則最多可新增一項偵錯查詢,長度不得超過 1024 個字元。
請參考下列 example_project.example_dataset.table 資料表的 SQL 斷言規則,檢查每項商品的平均收益是否超過 100:
SELECT
  *
FROM
  `example_project.example_dataset.table`
WHERE
  SUM(revenue) / COUNT(DISTINCT item_id) > 100
如果上述規則失敗,您可以查看總收益、不重複商品數量和每項商品平均收益等指標,協助診斷問題。下列偵錯查詢會傳回這些指標:
SELECT
  SUM(revenue),
  COUNT(DISTINCT item_id),
  SUM(revenue) / COUNT(DISTINCT item_id)
FROM `example_project.example_dataset.table`
規則執行
您可以安排資料品質掃描作業,按照特定時間間隔執行,也可以視需要執行掃描。
執行身分
根據預設,Knowledge Catalog 會使用集中式服務代理 (service-PROJECT_NUMBER@gcp-sa-dataplex.iam.gserviceaccount.com) 執行資料品質掃描。
您可以指定自訂服務帳戶,或使用自己的使用者憑證 (EUC),覆寫這項預設執行身分。這能帶來以下優勢:
- 最小權限原則:僅將特定資料品質工作所需的 IAM 權限授予專屬服務帳戶,盡可能減少過度佈建的存取權。
- 精細的存取控管:將權限範圍限定在特定資源,以便與 BigQuery 中的資料列層級和資料欄層級存取政策整合。
- 提升稽核能力:將自訂服務帳戶或使用者憑證指派給特定掃描作業,讓稽核記錄中的活動追蹤和記錄更清楚。
- 統一計費:使用自訂執行身分時,處理和儲存費用會直接集中在 BigQuery (不計入 Knowledge Catalog Premium SKU)。這樣一來,您就能享有 BigQuery 企業折扣和運算單元承諾使用合約。
如要瞭解如何設定自訂執行身分,請參閱「設定執行身分」。
網路需求
如要執行掃描,您必須在用於掃描的虛擬私有雲子網路上啟用Private Google Access。如未指定子網路,請確認預設子網路已啟用 Private Google Access。
執行資料品質掃描作業時,Knowledge Catalog 會建立工作。如果工作設定有誤或執行時間超出預期,您可以取消工作。
指定資料品質掃描時,您可以將工作範圍設為下列其中一項:
- 完整資料表
- 每項工作都會驗證整個資料表。
- 異動項目
- 每項工作都會驗證增量資料。如要判斷增量,請在表格中提供可做為標記的
Date/Timestamp欄。通常,這是資料表分區的資料欄。
篩選資料
您可以使用資料列篩選器,篩選要掃描資料品質的資料。建立資料列篩選器後,您就能專注於特定時間範圍或特定區隔 (例如特定區域) 內的資料。使用篩選器可以縮短執行時間並降低成本。例如,您可以篩除時間戳記早於特定日期的資料。
範例資料
您可以指定要從資料中取樣的記錄百分比,以便執行資料品質掃描。對較小的資料樣本建立資料品質掃描,可縮短執行時間,並降低查詢整個資料集的成本。
篩選規則
執行資料品質掃描作業時,您可以使用 AIP-160 篩選器語法,選擇性執行特定規則。Knowledge Catalog 會根據掃描中定義的規則中繼資料,或透過 data-rules 切面附加至目錄項目的規則,執行篩選作業。
篩選器語法
篩選器語法遵循 AIP-160 指南。您可以使用標準 AIP-160 運算子 (例如 =、!=、>、<、=~),並使用 AND 或 OR 結合多個條件。
使用 AIP-160 篩選器字串時,請按照下列步驟操作:
- 在 Google Cloud 控制台中:使用 AIP-160 語法直接輸入篩選器,例如
name = "critical_check"。 - 在 API 呼叫中:篩選器字串通常是另一個 JSON 字串常值中的值。這需要逸出 AIP-160 字串中的雙引號。例如:
"filter": "name = \"critical_check\""。
可篩選的欄位
您可以篩選規則定義中的大部分欄位:
name:規則的顯示名稱。dimension:資料品質維度 (例如VALIDITY)。column:規則適用的資料欄名稱。threshold:規則的通過門檻。ignore_null:布林值。當true時,NULL列會視為通過。attributes:指派給規則的自訂鍵/值組合。
以下範例說明常見的篩選器模式。數值和布林值不加引號。
依名稱篩選
- 完全相符:
name = "critical_check" - 比對模式:
name =~ "temp_.*"
依維度篩選
- 比對特定維度:
dimension = "COMPLETENESS" - 比對多個維度:
dimension = "VALIDITY" OR dimension = "ACCURACY"
依資料欄和門檻篩選
- 比對特定資料欄:
column = "user_id" - 符合門檻:
threshold > 0.95 - 比對範圍:
threshold >= 0.8 AND threshold < 0.9
依 ignore_null 篩選
- 比對布林值:
ignore_null = true
依自訂屬性篩選
- 檢查金鑰是否存在:
attributes:environment - 比對鍵和值:
attributes.environment = "prod" - 使用規則運算式比對:
attributes.tag =~ "prio-.*" - 比對組合:
attributes.environment = "prod" AND attributes.criticality = "high"
資料品質掃描結果
您可以在 Knowledge Catalog 和 BigQuery 查看資料品質掃描結果。您也可以使用下列方法查看及分析掃描結果:
將結果匯出至 BigQuery
您可以將掃描結果匯出至 BigQuery 資料表,以便進一步分析。如要自訂報表,您可以將 BigQuery 資料表資料連結至 Looker 資訊主頁。您可以使用多項掃描作業的同一個結果資料表,建立匯總報表。
將結果發布為 Knowledge Catalog 中繼資料
您可以將資料品質掃描結果發布為 Knowledge Catalog 中繼資料。最新結果會儲存至代表來源資料表的 Knowledge Catalog 項目,位於
data-quality-scorecard系統切面類型下方。您可以在 Google Cloud 控制台的來源資料表 BigQuery 和 Knowledge Catalog 頁面,透過「資料品質」分頁查看結果。您也可以使用 API 擷取結果。如要進一步瞭解 Knowledge Catalog 中繼資料,請參閱「關於 Knowledge Catalog 的中繼資料管理」。
查看資料品質分數
每項掃描結果都會提供資料品質分數,指出通過的規則百分比。分數會顯示在整體工作層級、資料欄層級 (如果規則是針對資料欄評估) 和維度層級。使用資料品質分數,將資料表或資料欄的資料品質正規化、追蹤趨勢,以及找出不符合品質規定的資料。
詳情請參閱「查看資料品質掃描結果」。
監控與快訊
您可以透過下列方法監控資料品質掃描作業,並接收相關快訊:
在 Cloud Logging 設定快訊
您可以在 Logs Explorer 中,使用
data_scan和data_quality_scan_rule_result記錄監控資料品質工作。針對每項資料品質工作,
data_scan_type欄位設為DATA_QUALITY的data_scan記錄會包含下列資訊:- 用於資料掃描的資料來源。
- 工作執行詳細資料,例如建立時間、開始時間、結束時間和工作狀態。
- 資料品質工作的結果:通過或失敗。
- 維度層級通過或失敗。
每項成功的工作都包含
data_quality_scan_rule_result記錄,其中包含該工作中每項規則的下列詳細資訊:- 設定資訊,例如規則名稱、規則類型、評估類型和維度。
- 結果資訊,例如通過或失敗、總列數、通過列數、空值列數和評估列數。
您可以透過 API 和Google Cloud 控制台取得記錄中的資訊。您可以根據這項資訊設定快訊。詳情請參閱「在 Logging 中設定警告」。
傳送電子郵件通知報表
您可以傳送電子郵件通知報表,提醒使用者資料品質工作的狀態和結果。通知報表適用於下列情境:
- 資料品質分數低於指定目標分數
- 工作失敗
- 工作已完成
您可以在建立資料品質掃描作業時設定通知報表。
在 Cloud Billing 監控 DCU 運算費用
資料品質掃描無伺服器運算不會將時間序列指標傳送至 Cloud Monitoring。如要依專案、掃描 ID 或資料表追蹤及歸因資料品質 DCU 費用,請使用
goog-dataplex-datascan-*系統標籤在 BigQuery 中查詢 Cloud Billing 匯出作業。詳情請參閱「透過 Cloud Billing 匯出功能監控及歸因 Dataplex DCU 費用」。
排解資料品質失敗問題
規則執行失敗時,Knowledge Catalog 會提供查詢,以便取得失敗的記錄。執行這項查詢,即可查看不符合規則的記錄。詳情請參閱「排解資料品質失敗問題」。
限制
- gcloud CLI 不支援規則建議。
- 維度選項固定為預先定義的七個維度之一。
- 每項資料品質掃描作業的規則數量上限為 1000。
- 資料欄層級的資料品質分數僅支援透過 API 回報。
- 您只能對 BigQuery、Iceberg REST Catalog 資料表、SAP Business Data Cloud Delta Lake 資料表和 Apache Hive 資料表執行資料品質規則。
定價
- 如要進一步瞭解定價,請參閱「Knowledge Catalog 定價」。
- 如要使用 Cloud Billing 匯出至 BigQuery,追蹤及歸因資料品質掃描 DCU 用量和費用,請參閱「使用 Cloud Billing 匯出功能監控及歸因 Dataplex DCU 費用」。
後續步驟
- 瞭解如何使用自動分析資料品質功能。
- 瞭解如何重複使用資料品質規則。
- 瞭解如何以程式碼形式管理資料品質規則。
- 按照教學課程建構政策即程式碼資料品質工作流程。
- 瞭解可用於資料剖析的 Terraform 資源。請參閱以下內容:
- Terraform 登錄檔中的 Dataplex 資料掃描資源。
- GitHub 上的 Dataplex 資料掃描資源說明文件,支援以 YAML 為基礎的規則設定。
- 瞭解資料剖析。
- 瞭解如何使用資料剖析功能。