


本頁面提供管道生命週期總覽,從管道程式碼到 Dataflow 工作。
本頁面說明下列概念:
- 執行圖是什麼,以及 Apache Beam 管道如何變成 Dataflow 工作
- Dataflow 如何處理錯誤
- 瞭解 Dataflow 如何自動平行處理及分配管道中的處理邏輯,交由執行工作的 worker 處理
- Dataflow 可能進行的工作最佳化
執行圖
執行 Dataflow 管道時,Dataflow 會從建構 Pipeline 物件的程式碼建立執行圖,包括所有轉換及其相關聯的處理函式,例如 DoFn 物件。這是管道執行圖表,這個階段稱為「圖表建構時間」。
在建構圖表期間,Apache Beam 會在本機執行管道程式碼主要進入點的程式碼,並在呼叫來源、接收器或轉換步驟時停止,然後將這些呼叫轉換為圖表的節點。因此,管道進入點中的一段程式碼 (Java 和 Go main 方法或 Python 指令碼的頂層) 會在本機上執行,也就是執行管道的機器。在 DoFn 物件的方法中宣告的相同程式碼,會在 Dataflow 工作站中執行。
舉例來說,Apache Beam SDK 隨附的 WordCount 範例包含一系列轉換,可讀取、擷取、計算、格式化及寫入文字集合中的個別字詞,以及每個字詞的出現次數。下圖顯示 WordCount 管道中的轉換如何擴展為執行圖:
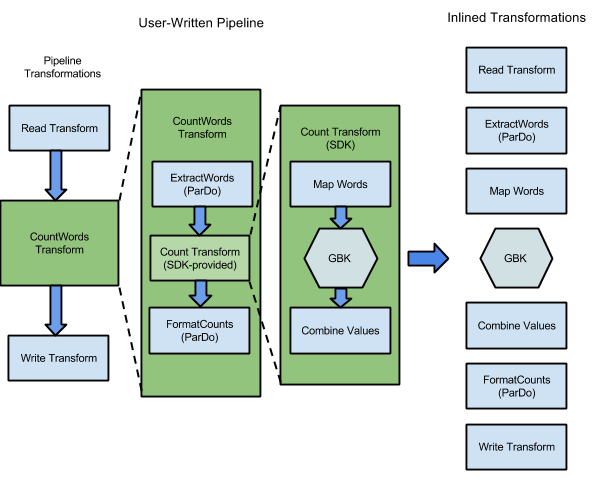
圖 1:WordCount 範例執行圖
執行圖表通常與您建構管道時指定轉換的順序不同。這是因為 Dataflow 服務會在受管理雲端資源上執行作業之前,對執行圖表執行各種最佳化和融合作業。執行管道時,Dataflow 服務會遵守資料依附元件。不過,如果步驟之間沒有資料依附關係,則可以依任意順序執行。
如要查看 Dataflow 為管道產生的未最佳化執行圖,請在 Dataflow 監控介面中選取工作。如要進一步瞭解如何查看工作,請參閱「使用 Dataflow 監控介面」。
在建構圖表期間,Apache Beam 會驗證管道參照的任何資源 (例如 Cloud Storage 值區、BigQuery 資料表,以及 Pub/Sub 主題或訂閱項目) 是否確實存在且可存取。驗證作業是透過對相應服務的標準 API 呼叫完成,因此請務必確保用於執行管道的使用者帳戶與必要服務的連線正常,且已獲授權可呼叫服務的 API。將管道提交至 Dataflow 服務前,Apache Beam 也會檢查其他錯誤,並確保管道圖表不含任何非法作業。
然後,執行圖表會轉換為 JSON 格式,並傳輸至 Dataflow 服務端點。
接著,Dataflow 服務會驗證 JSON 執行圖表。圖表通過驗證後,就會成為 Dataflow 服務上的工作。您可以使用 Dataflow 監控介面查看工作、執行圖表、狀態和記錄資訊。
Java
Dataflow 服務會將回應傳送至執行 Dataflow 程式的機器。這項回應會封裝在 DataflowPipelineJob 物件中,其中包含 Dataflow 工作的 jobId。使用 jobId,透過 Dataflow 監控介面和 Dataflow 指令列介面監控、追蹤及排解工作問題。
詳情請參閱「DataflowPipelineJob 的 API 參考資料」。
Python
Dataflow 服務會將回應傳送至執行 Dataflow 程式的機器。這項回應會封裝在 DataflowPipelineResult 物件中,其中包含 Dataflow 工作的 job_id。使用 job_id,透過 Dataflow 監控介面和 Dataflow 指令列介面監控、追蹤及排解工作問題。
Go
Dataflow 服務會將回應傳送至執行 Dataflow 程式的機器。這項回應會封裝在 dataflowPipelineResult 物件中,其中包含 Dataflow 工作的 jobID。使用 jobID,透過 Dataflow 監控介面和 Dataflow 指令列介面監控、追蹤及排解工作問題。
在本機執行管道時,也會建構圖表,但圖表不會轉換為 JSON 或傳輸至服務。而是會在啟動 Dataflow 程式的同一部電腦上,在本機執行圖表。詳情請參閱「設定本機執行的 PipelineOptions」。
錯誤及例外狀況處理
管道在處理資料時可能會擲回例外狀況。部分錯誤是暫時性的,例如暫時無法存取外部服務。其他錯誤則屬於永久性錯誤,例如因輸入資料損毀或無法剖析而導致的錯誤,或是運算期間的空指標。
Dataflow 會處理任意套裝組合中的元素,並在該套裝組合中的任何元素擲回錯誤時,重試整個套裝組合。以批次模式執行時,內含失敗項目的套裝組合會重試四次。如果單一套裝組合失敗達四次,管道就會完全失敗。在串流模式下執行時,如果套裝組合包含失敗的項目,系統會無限次重試,可能導致管道永久停滯。
以批次模式處理時,管道工作完全失敗前,您可能會看到大量個別失敗的項目。如果任何一組項目在四次重試後仍失敗,就會發生這種情況。舉例來說,如果管道嘗試處理 100 個套裝組合,Dataflow 可能會產生數百個個別失敗,直到單一套裝組合達到四次失敗的退出條件為止。
啟動工作站錯誤 (例如無法在工作站上安裝套件) 是暫時性的。這種情況會導致無限次重試,並可能造成管道永久停滯。
平行處理和分布
Dataflow 服務會自動將管道中的處理邏輯平行化,並分配至 worker 和執行緒。Dataflow 會使用程式設計模型中的抽象概念,代表平行處理函式。舉例來說,ParDo 轉換會導致 Dataflow 將以 DoFn 物件表示的處理程式碼,分配給多個 worker 同時執行。
Dataflow 支援兩種互補的平行處理維度:
- 水平平行處理:管道資料會分割並在多個工作站例項中並行處理,並使用水平自動調度資源動態管理。
- 垂直平行處理:管道資料會在每個工作站 VM 的多個 CPU 核心和執行緒中處理,並使用動態執行緒調度和垂直自動調度功能進行管理。
Dataflow 會自動管理作業平行處理、處理動態工作重新平衡,並透過融合和合併最佳化功能,將執行圖最佳化。不可分割的資料來源、高擴散傳遞功能步驟、鍵值傾斜和下游接收器限制等因素,都可能限制管道的平行處理。
如需有關 Dataflow 如何分割資料、擴充 Worker 數量,以及解決平行處理瓶頸的深入指南,請參閱「瞭解 Dataflow 中的平行處理」。
融合最佳化
驗證管道執行圖的 JSON 格式後,Dataflow 服務可能會修改圖表以進行最佳化。最佳化作業可能包括將管道執行圖中的多個步驟或轉換,合併為單一步驟。融合步驟可避免 Dataflow 服務需要具體化管道中的每個中繼 PCollection,這可能會耗費大量記憶體和處理負擔。
雖然您在管道建構中指定的所有轉換都會在服務上執行,但為了確保管道執行效率最高,轉換可能會以不同順序執行,或是做為較大的融合轉換的一部分。Dataflow 服務會遵守執行圖中各步驟之間的資料依附元件,但除此之外,步驟可能會以任何順序執行。
融合示例
下圖顯示 Dataflow 服務如何最佳化及融合 Apache Beam SDK for Java 隨附的 WordCount 範例執行圖,以提升執行效率:
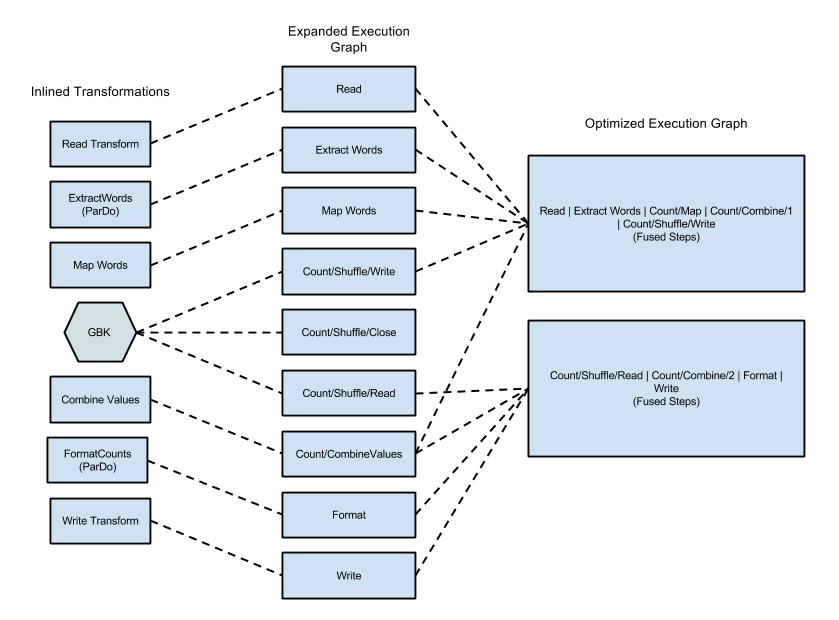
圖 2:WordCount 範例最佳化執行圖
防止融合
有時 Dataflow 可能會錯誤地猜測管道中作業的最佳融合方式,這會限制 Dataflow 使用所有可用工作站的能力。在這種情況下,您可以使用 Redistribute 轉換,提示 Dataflow 重新分配資料。
如要新增 Redistribute 轉換,請呼叫下列其中一種方法:
Redistribute.arbitrarily:表示資料可能不平衡。Dataflow 會選擇最佳演算法,重新分配資料。Redistribute.byKey:表示鍵/值配對的PCollection可能不平衡,應根據鍵重新分配。通常,Dataflow 會將單一鍵的所有元素共置於同一個背景工作執行緒。不過,我們無法保證金鑰共置,且元素會獨立處理。
如果管道包含 Redistribute 轉換,Dataflow 通常會防止 Redistribute 轉換前後的步驟融合,並重組資料,讓 Redistribute 轉換下游的步驟有更理想的平行處理能力。
監控融合
您可以在 Google Cloud 控制台、使用 gcloud CLI 或 API 存取最佳化圖表和融合階段。
控制台
如要在控制台中查看圖表的融合階段和步驟,請在 Dataflow 工作的「執行詳細資料」分頁中,開啟「階段工作流程」圖表檢視畫面。
如要查看階段的融合元件步驟,請在圖表中按一下融合階段。在「階段資訊」窗格中,「元件步驟」列會顯示合併的階段。有時,單一複合轉換的部分會融合到多個階段。
gcloud
如要使用 gcloud CLI 存取最佳化圖表和融合階段,請執行下列 gcloud 指令:
gcloud dataflow jobs describe --full JOB_ID --format json
將 JOB_ID 替換為 Dataflow 工作 ID。
如要擷取相關位元,請將 gcloud 指令的輸出內容透過管道傳送至 jq:
gcloud dataflow jobs describe --full JOB_ID --format json | jq '.pipelineDescription.executionPipelineStage\[\] | {"stage_id": .id, "stage_name": .name, "fused_steps": .componentTransform }'
如要查看輸出回應檔案中融合階段的說明,請在 ComponentTransform 陣列中查看 ExecutionStageSummary 物件。
API
如要使用 API 存取最佳化圖表和融合階段,請呼叫 project.locations.jobs.get。
如要查看輸出回應檔案中融合階段的說明,請在 ComponentTransform 陣列中查看 ExecutionStageSummary 物件。
合併最佳化
匯總作業是大規模資料處理的重要概念。
匯總功能會將概念上相差甚遠的資料彙整在一起,因此非常適合用於相互關聯。Dataflow 程式設計模型會將匯總作業表示為 GroupByKey、CoGroupByKey 和 Combine 轉換。
Dataflow 的匯總作業會合併整個資料集的資料,包括可能分散在多個工作站的資料。在這種彙整作業期間,最有效率的做法通常是盡可能在本地合併資料,再跨執行個體合併資料。套用 GroupByKey 或其他匯總轉換時,Dataflow 服務會在主要分組作業前,自動在本機執行部分合併作業。
執行部分或多層合併時,Dataflow 服務會根據管道處理的是批次或串流資料,做出不同的決策。對於有界資料,這項服務會優先考量效率,並盡可能執行本機合併作業。對於無界資料,服務會優先考量降低延遲時間,因此可能不會執行部分合併,因為這可能會增加延遲時間。