


如果 Dataflow 管道或工作發生問題,請參閱本頁列出的錯誤訊息和修正建議。
記錄類型 dataflow.googleapis.com/worker-startup、dataflow.googleapis.com/harness-startup 和 dataflow.googleapis.com/kubelet 中的錯誤,表示工作設定有問題。也可能表示有狀況導致正常記錄路徑無法運作。
管道在處理資料時可能會擲回例外狀況。部分錯誤只是暫時性,例如暫時無法存取外部服務。部分錯誤是永久性的,例如輸入資料損毀或無法剖析,或運算期間出現空值指標。
Dataflow 會處理任意組合中的元素,並在組合中的任何元素發生錯誤時,重試整個組合。在批次模式下執行時,內含失敗項目的套裝組合會重試四次。如果單一套裝組合失敗達四次,管道就會完全失敗。在串流模式下執行時,系統會無限次重試包含失敗項目的套件,這可能會導致管道永久停滯。
使用者程式碼 (例如 DoFn 執行個體) 中的例外狀況會回報至 Dataflow 監控介面。如果使用 BlockingDataflowPipelineRunner 執行管道,控制台或終端機視窗也會顯示錯誤訊息。
建議您新增例外狀況處理常式以防範程式碼中的錯誤。舉例來說,如果您想捨棄在 ParDo 中未通過某些自訂輸入驗證的元素,請在 ParDo 中使用 try/catch 區塊來處理例外狀況,並記錄及捨棄元素。如果是正式環境工作負載,請實作未處理訊息模式。如要追蹤錯誤數量,請使用匯總轉換。
缺少記錄檔
如果找不到工作的記錄,請從所有 Cloud Logging 記錄路由器接收器中,移除含有 resource.type="dataflow_step" 的排除篩選器。
如要進一步瞭解如何移除記錄排除項目,請參閱「移除排除項目」指南。
輸出內容重複
執行 Dataflow 工作時,輸出內容包含重複的記錄。
如果 Dataflow 工作使用至少一次管道串流模式,就可能發生這個問題。這個模式可確保記錄至少會處理一次。不過,這個模式可能會產生重複記錄。
如果工作流程無法容許重複記錄,請使用「僅限一次」串流模式。這種模式有助於確保資料在管道中移動時,記錄不會遭到捨棄或重複。
如要確認工作使用的串流模式,請參閱「查看工作的串流模式」。
如要進一步瞭解串流模式,請參閱「設定管道串流模式」。
管道錯誤
下列各節列出您可能會遇到的常見管道錯誤,以及解決或排解錯誤的步驟。
必須啟用部分 Cloud API
嘗試執行 Dataflow 工作時,發生下列錯誤:
Some Cloud APIs need to be enabled for your project in order for Cloud Dataflow to run this job.
這是因為專案未啟用某些必要 API。
如要解決這個問題並執行 Dataflow 工作,請在專案中啟用下列Google Cloud API:
- Compute Engine API (Compute Engine)
- Cloud Logging API
- Cloud Storage
- Cloud Storage JSON API
- BigQuery API
- Pub/Sub
- Datastore API
如需詳細操作說明,請參閱「入門指南」一節,瞭解如何啟用Google Cloud API。
「@*」和「@N」是保留的分區規格
嘗試執行工作時,記錄檔中會顯示下列錯誤,且工作失敗:
Workflow failed. Causes: "@*" and "@N" are reserved sharding specs. Filepattern must not contain any of them.
如果暫存檔案的 Cloud Storage 路徑 (tempLocation 或 temp_location) 檔案名稱包含 at 符號 (@),後面接著數字或星號 (*),就會發生這項錯誤。
如要解決這個問題,請變更檔案名稱,在 at 符號後方加上支援的字元。
錯誤的要求
執行 Dataflow 工作時,Cloud Monitoring 記錄會顯示一系列類似以下的警告:
Unable to update setup work item STEP_ID error: generic::invalid_argument: Http(400) Bad Request
Update range task returned 'invalid argument'. Assuming lost lease for work with id LEASE_ID
with expiration time: TIMESTAMP, now: TIMESTAMP. Full status: generic::invalid_argument: Http(400) Bad Request
如果 worker 狀態資訊因處理延遲而過時或不同步,就會出現錯誤要求警告。即使出現無效要求警告,Dataflow 工作通常仍會成功。如果是這種情況,請忽略警告。
無法在不同位置讀取和寫入
執行 Dataflow 工作時,記錄檔中可能會顯示下列錯誤:
message:Cannot read and write in different locations: source: SOURCE_REGION, destination: DESTINATION_REGION,reason:invalid
如果來源和目的地位於不同區域,就會發生這項錯誤。如果暫存位置和目的地不在同一個區域,也可能發生這種情況。舉例來說,如果工作從 Pub/Sub 讀取資料,然後先寫入 Cloud Storage temp bucket,再寫入 BigQuery 資料表,則 Cloud Storage temp bucket 和 BigQuery 資料表必須位於相同區域。
即使單一區域位於多區域位置的範圍內,多區域位置仍與單一區域位置不同。例如,us (multiple regions in the United States) 和 us-central1 是不同的區域。
如要解決這個問題,請將目的地、來源和暫存位置設在相同區域。Cloud Storage bucket 位置無法變更,因此您可能需要在正確的區域建立新的 Cloud Storage bucket。
連線逾時
執行 Dataflow 工作時,記錄檔中可能會顯示下列錯誤:
org.springframework.web.client.ResourceAccessException: I/O error on GET request for CONNECTION_PATH: Connection timed out (Connection timed out); nested exception is java.net.ConnectException: Connection timed out (Connection timed out)
如果 Dataflow worker 無法與資料來源或目的地建立或維持連線,就會發生這個問題。
如要解決問題,請按照下列疑難排解步驟操作:
沒有這個物件
執行 Dataflow 工作時,記錄檔中可能會顯示下列錯誤:
..., 'server': 'UploadServer', 'status': '404'}>, <content <No such object:...
如果部分執行中的 Dataflow 工作使用相同的 temp_location,暫存管道執行時建立的臨時工作檔案,通常就會發生這類錯誤。如果多個並行工作共用同一個 temp_location,這些工作可能會互相覆寫暫存資料,並可能發生競爭狀況。為避免這個問題,建議您為每項工作使用不重複的 temp_location。
Dataflow 無法判斷待處理工作
從 Pub/Sub 執行串流管道時,會出現下列警告:
Dataflow is unable to determine the backlog for Pub/Sub subscription
Dataflow 管道從 Pub/Sub 提取資料時,Dataflow 必須重複向 Pub/Sub 要求資訊。這項資訊包括訂閱項目的待處理訊息數量,以及最舊未確認訊息的存在時間。Dataflow 有時會因內部系統問題而無法從 Pub/Sub 擷取這項資訊,導致待處理工作暫時累積。
詳情請參閱「使用 Cloud Pub/Sub 串流」。
DEADLINE_EXCEEDED 或伺服器沒有回應
執行工作時,您可能會遇到 RPC 逾時例外狀況,或下列其中一項錯誤:
DEADLINE_EXCEEDED
或:
Server Unresponsive
這類錯誤通常是由下列其中一個原因造成:
工作使用的虛擬私有雲 (VPC) 網路可能缺少防火牆規則。防火牆規則必須在管道選項指定的虛擬私有雲網路中,啟用 VM 之間的所有 TCP 流量。詳情請參閱「Dataflow 的防火牆規則」。
在某些情況下,worker 無法互相通訊。執行不使用 Dataflow Shuffle 或 Streaming Engine 的 Dataflow 工作時,worker 必須在虛擬私有雲網路中使用 TCP 通訊埠
12345和12346相互通訊。在這種情況下,錯誤訊息會包含 worker 控管工具名稱和遭封鎖的 TCP 通訊埠。錯誤訊息應如下所示:DEADLINE_EXCEEDED: (g)RPC timed out when SOURCE_WORKER_HARNESS talking to DESTINATION_WORKER_HARNESS:12346.Rpc to WORKER_HARNESS:12345 completed with error UNAVAILABLE: failed to connect to all addresses Server unresponsive (ping error: Deadline Exceeded, UNKNOWN: Deadline Exceeded...)如要解決這個問題,請使用
gcloud compute firewall-rules create規則旗標,允許網路流量傳送至通訊埠12345和12346。以下範例示範 Google Cloud CLI 指令:gcloud compute firewall-rules create FIREWALL_RULE_NAME \ --network NETWORK \ --action allow \ --direction IN \ --target-tags dataflow \ --source-tags dataflow \ --priority 0 \ --rules tcp:12345-12346更改下列內容:
FIREWALL_RULE_NAME:防火牆規則名稱NETWORK:網路名稱
工作受限於重組作業。
如要解決這個問題,請進行下列一或多項變更。
Java
- 如果工作並非使用服務式重組,請設定
--experiments=shuffle_mode=service,改用服務式 Dataflow Shuffle。如需詳細資訊和可用性,請參閱「Dataflow Shuffle」。 - 新增更多工作站。執行管道時,請嘗試將
--numWorkers設為較高的值。 - 增加工作站已連接磁碟的大小。執行管道時,請嘗試將
--diskSizeGb設為更高的值。 - 使用採用 SSD 的永久磁碟。執行管道時,請嘗試設定
--workerDiskType="compute.googleapis.com/projects/PROJECT_ID/zones/ZONE/diskTypes/pd-ssd"。
Python
- 如果工作未使用服務式重組,請設定
--experiments=shuffle_mode=service,改用服務式 Dataflow Shuffle。如需詳細資訊和可用性,請參閱「Dataflow Shuffle」。 - 新增更多工作站。執行管道時,請嘗試將
--num_workers設為更高的值。 - 增加工作站已連接磁碟的大小。執行管道時,請嘗試將
--disk_size_gb設為更高的值。 - 使用採用 SSD 的永久磁碟。執行管道時,請嘗試設定
--worker_disk_type="compute.googleapis.com/projects/PROJECT_ID/zones/ZONE/diskTypes/pd-ssd"。
Go
- 如果工作未使用服務式重組,請設定
--experiments=shuffle_mode=service,改用服務式 Dataflow Shuffle。如需詳細資訊和可用性,請參閱「Dataflow Shuffle」。 - 新增更多工作站。執行管道時,請嘗試將
--num_workers設為更高的值。 - 增加工作站已連接磁碟的大小。執行管道時,請嘗試將
--disk_size_gb設為更高的值。 - 使用採用 SSD 的永久磁碟。執行管道時,請嘗試設定
--disk_type="compute.googleapis.com/projects/PROJECT_ID/zones/ZONE/diskTypes/pd-ssd"。
- 如果工作並非使用服務式重組,請設定
傳回空白分割
執行 Dataflow 工作時,worker 記錄中可能會顯示下列訊息:
Continuing to process work-id WORK_ID without splitting. Reader split status was: INTERNAL: Empty split returned and SDK split status was: ...
如果工作正常執行,這則訊息不會造成影響,可以忽略。如果服務嘗試分割已完成的工作,可能會因競爭狀況而出現這則訊息。
使用者程式碼發生編碼錯誤、IOException 或非預期行為
Apache Beam SDK 和 Dataflow worker 依賴常見的第三方元件。這些元件會匯入其他依附元件。版本衝突可能會導致服務產生非預期的行為,此外,部分程式庫不具前瞻相容性。您可能需要固定在執行期間範圍內的列出版。SDK 和 Worker 依附元件包含依附元件及其必要版本的清單。
機型必須使用 Hyperdisk Balanced 磁碟類型
嘗試執行 Dataflow 工作時,發生下列錯誤:
MACHINE_TYPE machine types require the Hyperdisk Balanced disk type.
如果使用的機型需要 Hyperdisk Balanced 磁碟 (例如 C4A 或 N4),但指定的磁碟類型不相容 (例如 pd-standard),就會發生這個問題。
如要解決這個問題,當您使用的機型需要 Hyperdisk Balanced 磁碟時,請勿指定 workerDiskType (Python 為 worker_disk_type,Go 為 disk_type) 管道選項,或將其設為 hyperdisk-balanced。
執行 LookupEffectiveGuestPolicies 時發生錯誤
執行 Dataflow 工作時,記錄檔中可能會顯示下列錯誤:
OSConfigAgent Error policies.go:49: Error running LookupEffectiveGuestPolicies:
error calling LookupEffectiveGuestPolicies: code: "Unauthenticated",
message: "Request is missing required authentication credential.
Expected OAuth 2 access token, login cookie or other valid authentication credential.
如果整個專案都啟用 OS 設定管理功能,就會發生這項錯誤。
如要解決這個問題,請停用套用至整個專案的 VM 管理員政策。如果無法停用整個專案的 VM 管理員政策,可以放心忽略這項錯誤,並在記錄監控工具中篩除。
違反外部 IP 存取限制
執行或複製 Dataflow 工作時,發生下列錯誤:
Constraint constraints/compute.vmExternalIpAccess violated for project PROJECT_ID.
如果組織政策限制禁止 VM 執行個體使用外部 IP 位址,但 Dataflow 工作設為使用外部 IP 位址,就會發生這項錯誤。
如要解決這個問題,請明確設定工作,使其僅使用內部 IP 位址:
- 在 Google Cloud 控制台:在「Worker IP Address Configuration」(工作站 IP 位址設定) 清單中,選取「Private」(私人)。
- 使用 SDK:設定
--usePublicIps=false管道選項。
詳情請參閱「關閉外部 IP 位址」。
Java Runtime Environment 偵測到嚴重錯誤
worker 啟動時發生下列錯誤:
A fatal error has been detected by the Java Runtime Environment
如果管道使用 Java Native Interface (JNI) 執行非 Java 程式碼,且該程式碼或 JNI 繫結含有錯誤,就會發生這個錯誤。
googclient_deliveryattempt 屬性鍵錯誤
Dataflow 工作失敗,並顯示下列其中一項錯誤:
The request contains an attribute key that is not valid (key=googclient_deliveryattempt). Attribute keys must be non-empty and must not begin with 'goog' (case-insensitive).
或:
Invalid extensions name: googclient_deliveryattempt
如果 Dataflow 工作具有下列特性,就會發生這項錯誤:
- Dataflow 工作使用 Streaming Engine。
- 管道有 Pub/Sub 接收器。
- 管道會使用提取訂閱項目。
- 管道會使用其中一個 Pub/Sub 服務 API 發布訊息,而非使用內建的 Pub/Sub I/O 接收器。
- Pub/Sub 使用 Java 或 C# 用戶端程式庫。
- Pub/Sub 訂閱項目有無效信件主題。
發生這項錯誤的原因是,當您使用 Pub/Sub Java 或 C# 用戶端程式庫,並啟用訂閱項目的 dead-letter 主題時,傳送嘗試會位於 googclient_deliveryattempt 訊息屬性,而非 delivery_attempt 欄位。詳情請參閱「處理訊息失敗」頁面的「追蹤傳送嘗試」一節。
如要解決這個問題,請進行下列一或多項變更。
- 停用 Streaming Engine。
- 請使用內建的 Apache Beam
PubSubIO連接器,而非 Pub/Sub 服務 API。 - 使用其他類型的 Pub/Sub 訂閱項目。
- 移除無效信件主題。
- 請勿將 Java 或 C# 用戶端程式庫與 Pub/Sub 提取訂閱項目搭配使用。如需其他選項,請參閱用戶端程式庫程式碼範例。
- 在管道程式碼中,如果屬性索引鍵開頭為
goog,請先清除訊息屬性,再發布訊息。
偵測到熱鍵 ...
發生下列錯誤:
A hot key HOT_KEY_NAME was detected in...
如果資料含有熱鍵,就會發生這些錯誤。熱鍵是指含有足夠元素,會對管道效能造成負面影響的鍵。這些鍵會限制 Dataflow 平行處理元素的能力,進而增加執行時間。
如要在管道中偵測到熱鍵時,將人類可讀的金鑰列印到記錄檔,請使用熱鍵管道選項。
如要解決這個問題,請檢查資料是否均勻分布。如果某個索引鍵的值過多而不成比例,請考慮採取下列做法:
- 重新輸入資料。套用
ParDo轉換以輸出新的鍵/值組合。 - Java 工作請使用
Combine.PerKey.withHotKeyFanout轉換。 - Python 工作請使用
CombinePerKey.with_hot_key_fanout轉換。 - 啟用 Dataflow Shuffle。
如要在 Dataflow 監控介面中查看熱鍵,請參閱「疑難排解批次工作中的進度落後項目」。
工作圖表過大
工作可能會失敗,並顯示下列錯誤:
The job graph is too large. Please try again with a smaller job graph,
or split your job into two or more smaller jobs.
如果工作的圖表大小超過 10 MB,就會發生這個錯誤。管道中的某些條件可能會導致工作圖表超出限制。常見條件包括:
Create轉換包含了大量記憶體內資料。- 大型
DoFn執行個體已針對遠端工作站傳輸作業進行序列化。 - 做為匿名內部類別執行個體的
DoFn,(可能無意間) 提取了大量資料進行序列化。 - 有向無環圖 (DAG) 正用於列舉大型清單的程式化迴圈。
如要避免這些狀況,請考慮重組管道。
金鑰承諾過大
執行串流工作時,worker 記錄檔中會顯示下列錯誤:
KeyCommitTooLargeException
在串流情境中,只要個別工作項目修訂版本超過修訂版本大小上限,就會發生這項錯誤。如要進一步瞭解修訂版本大小限制,請參閱「配額與限制」。
如果修訂版本超過限制,Dataflow 會拒絕修訂版本、在 worker 記錄中擲回 KeyCommitTooLargeException,並嘗試使用較小的起始套裝組合大小 (套裝組合截斷) 重新處理工作項目:
- 暫時性例外狀況 (套件截斷成功):如果套件可以拆分為較小的修訂版本,且輸出內容符合限制,您可能會在管道繼續進行之前,看到單一或不常發生的
KeyCommitTooLargeException錯誤。不過,由於使用較小的套裝組合重試,處理速度會暫時降低。 - 持續例外狀況 (金鑰處理停滯):如果起始套件大小已縮減至單一輸入訊息或計時器,但產生的輸出內容或狀態修改仍超過提交限制,則無法進一步分割工作項目。由於 Dataflow 會持續重試並失敗,因此該鍵的處理作業會完全停滯,且 worker 記錄會顯示重複、持續發生的
KeyCommitTooLargeException,且不會自行解決。
緩解策略
如要降低發生這類錯誤的可能性,請採取下列策略:
- 請確保處理單一元素或視窗時,不會產生超過提交大小限制的輸出內容或狀態修改。舉例來說,如果轉換作業接受相對較小的輸入元素,並傳回大得多的輸出內容 (例如讀取檔案名稱並輸出大型檔案的完整內容),則即使只處理單一輸入元素,產生的輸出內容也可能超過修訂版本大小限制。
- 如果多個元素是依鍵分組,但未使用
Combine轉換,請考慮增加鍵空間 (例如附加時間值區或次要 ID),減少每個鍵分組的元素數量。 - 如果某個鍵的元素在短時間內頻繁發出,可能會導致該鍵在視窗中產生數 GB 的事件。重寫管道來偵測高頻率鍵,並只輸出指出該鍵在該視窗中頻繁出現的輸出。
- 使用次線性空間
Combine轉換,進行交換和結合運算。如果合併器無法縮減資料大小,請勿使用。舉例來說,如果字串合併器會將字串附加在一起,效果會比不使用合併器更差。
拒絕超過 7168K 的郵件
執行透過範本建立的 Dataflow 工作時,工作可能會失敗,並顯示下列錯誤:
Error: CommitWork failed: status: APPLICATION_ERROR(3): Pubsub publish requests are limited to 10MB, rejecting message over 7168K (size MESSAGE_SIZE) to avoid exceeding limit with byte64 request encoding.
如果寫入無效信件佇列的訊息超過 7168 K 的大小限制,就會發生這項錯誤。如要解決這個問題,請啟用 Streaming Engine,其大小限制較高。如要啟用 Streaming Engine,請使用下列管道選項。
Java
--enableStreamingEngine=true
Python
--enable_streaming_engine=true
要求實體過大
提交工作時,控制台或終端機視窗會顯示下列其中一項錯誤:
413 Request Entity Too Large
The size of serialized JSON representation of the pipeline exceeds the allowable limit
Failed to create a workflow job: Invalid JSON payload received
Failed to create a workflow job: Request payload exceeds the allowable limit
提交工作時,如果遇到 JSON 酬載相關錯誤,表示管道的 JSON 表示法超過 20 MB 的要求大小上限。
工作大小取決於管道的 JSON 表示法。管道越大,要求就越大。Dataflow 的要求上限為 20 MB。
如要預估管道的 JSON 要求大小,請使用下列選項執行管道:
Java
--dataflowJobFile=PATH_TO_OUTPUT_FILE
Python
--dataflow_job_file=PATH_TO_OUTPUT_FILE
Go
Go 不支援以 JSON 格式輸出工作。
這個指令會將您工作的 JSON 表示法寫入檔案。序列化檔案大小是要求大小的良好估計值,由於要求中包含一些額外資訊,實際大小會略大。
管道中的某些狀況可能會導致 JSON 表示法超過上限。常見狀況包括:
Create轉換包含了大量記憶體內資料。- 大型
DoFn執行個體已針對遠端工作站傳輸作業進行序列化。 - 做為匿名內部類別執行個體的
DoFn,(可能無意間) 提取了大量資料進行序列化。
如要避免這些狀況,請考慮重組管道。
SDK 管道選項或暫存檔案清單超過大小上限
執行管道時,發生下列其中一項錯誤:
SDK pipeline options or staging file list exceeds size limit.
Please keep their length under 256K Bytes each and 512K Bytes in total.
或:
Value for field 'resource.properties.metadata' is too large: maximum size
如果因超過 Compute Engine 中繼資料限制而無法啟動管道,就會發生這些錯誤。這些限制無法變更。 Dataflow 會使用 Compute Engine 中繼資料做為管道選項。如要瞭解限制,請參閱 Compute Engine 自訂中繼資料限制。
下列情況可能導致 JSON 表示法超出限制:
- 要暫存的 JAR 檔案過多。
sdkPipelineOptions要求欄位過大。
如要預估管道的 JSON 要求大小,請使用下列選項執行管道:
Java
--dataflowJobFile=PATH_TO_OUTPUT_FILE
Python
--dataflow_job_file=PATH_TO_OUTPUT_FILE
Go
Go 不支援以 JSON 格式輸出工作。
這個指令的輸出檔案大小必須小於 256 KB。錯誤訊息中的 512 KB 是指輸出檔案的總大小,以及 Compute Engine VM 執行個體的自訂中繼資料選項。
您可以從專案中執行的 Dataflow 工作,大致估算 VM 執行個體的自訂中繼資料選項。選擇任何執行中的 Dataflow 工作。選取 VM 執行個體,然後前往該 VM 的 Compute Engine VM 執行個體詳細資料頁面,查看自訂中繼資料部分。自訂中繼資料和檔案的總長度應小於 512 KB。由於系統不會為失敗的工作啟動 VM,因此無法準確預估失敗工作的費用。
如果 JAR 清單達到 256 KB 的上限,請檢查清單並減少不必要的 JAR 檔案。如果還是太大,請嘗試使用 uber JAR 執行 Dataflow 工作。如需示範如何建立及使用 uber JAR 的範例,請參閱「建構及部署 Uber JAR」。
如果 sdkPipelineOptions 要求欄位過大,請在執行管道時加入下列選項。Java、Python 和 Go 的管道選項相同。
--experiments=no_display_data_on_gce_metadata
重組鍵過大
worker 記錄檔中會顯示下列錯誤:
Shuffle key too large
如果套用對應的編碼器後,傳送至特定 (Co-)GroupByKey 的序列化金鑰過大,就會發生這項錯誤。Dataflow 對序列化重組金鑰設有限制。
如要解決這個問題,請縮減鍵的大小,或使用更節省空間的編碼器。
詳情請參閱「Dataflow 的實際工作環境限制」。
全域視窗中的側邊輸入過時快取
使用 Apache Beam SDK for Python 執行串流管道時,全域視窗中的側邊輸入內容可能會出現無法預測的更新延遲。Worker 可能會長時間保留舊的側邊輸入值,尤其是在處理連續的主要輸入資料時。這個問題通常會影響使用 Pub/Sub 做為主要和側邊輸入內容的管道。
如要解決這個問題,請在使用 Apache Beam SDK 2.56.0 以上版本時,啟用 disable_global_windowed_args_caching 實驗旗標:
--experiments=disable_global_windowed_args_caching
BoundedSource 物件總數 ... 超過允許的上限
使用 Java 執行工作時,可能會發生下列其中一項錯誤:
Total number of BoundedSource objects generated by splitIntoBundles() operation is larger than the allowable limit
或:
Total size of the BoundedSource objects generated by splitIntoBundles() operation is larger than the allowable limit
Java
如果您使用 TextIO、AvroIO、BigQueryIO 透過 EXPORT 或其他檔案型來源讀取大量檔案,就可能發生這項錯誤。具體限制取決於來源的詳細資料,但單一管道中的檔案數量約為數萬個。舉例來說,在 AvroIO.Read 中嵌入結構定義可減少檔案數量。
如果您為管道建立了自訂資料來源,且來源的 splitIntoBundles 方法傳回的 BoundedSource 物件清單在序列化後超過 20 MB,也可能發生這項錯誤。
自訂來源的 splitIntoBundles() 作業產生的 BoundedSource 物件總大小上限為 20 MB。
如要避開這項限制,請採取下列任一做法:
要求酬載大小超過上限:20971520 位元組
執行管道時,工作可能會失敗,並顯示下列錯誤:
com.google.api.client.googleapis.json.GoogleJsonResponseException: 400 Bad Request
POST https://dataflow.googleapis.com/v1b3/projects/PROJECT_ID/locations/REGION/jobs/JOB_ID/workItems:reportStatus
{
  "code": 400,
  "errors": [
    {
      "domain": "global",
      "message": "Request payload size exceeds the limit: 20971520 bytes.",
      "reason": "badRequest"
    }
  ],
  "message": "Request payload size exceeds the limit: 20971520 bytes.",
  "status": "INVALID_ARGUMENT"
}
如果使用 Dataflow 執行工具的工作圖表非常大,就可能發生這項錯誤。大型工作圖表可能會產生大量指標,需要回報給 Dataflow 服務。如果這些指標的大小超過 20 MB 的 API 要求限制,工作就會失敗。
如要解決這個問題,請將管道遷移至 Dataflow 可攜式執行工具。可攜式執行器會使用更有效率的方法回報報表指標,且沒有 20 MB 的限制。
ModuleNotFoundError: No module named 'pkg_resources'
執行 Dataflow 工作時,在 worker 啟動或依附元件安裝期間發生下列錯誤:
ModuleNotFoundError: No module named 'pkg_resources'
發生這個問題的原因是,自 setuptools 82.0.0 版 (2026 年 2 月 8 日發布) 起,pkg_resources 模組已移除。這個模組先前已淘汰,並由 importlib.resources 和 importlib.metadata 取代。
如要解決這個問題,請採用下列任一方法:
固定
setuptools:如果依附元件需要回溯相容的setuptools版本才能成功建構,請在setup.py檔案中使用setup_requires引數,強制指定版本需求。例如:import setuptools setuptools.setup( name='PACKAGE-NAME', version='PACKAGE-VERSION', # Pin to a version prior to 82.0.0 setup_requires=['setuptools<82.0.0'], install_requires=['incompatible-package', ...], packages=setuptools.find_packages() )更新依附元件:查看程式庫和依附元件需求,更新至與最新版本
setuptools相容且不依賴pkg_resources的新版本。移除不必要的程式庫:從需求或設定檔案中,移除工作不需要的程式庫。舉例來說,某些舊版
cx_Oracle已確認會在建構程序中觸發這個問題。
NameError
使用 Dataflow 服務執行管道時,會發生下列錯誤:
NameError
在本機執行時 (例如使用 DirectRunner 執行),不會發生這項錯誤。
如果 DoFn 使用全域命名空間中的值,但 Dataflow worker 無法使用這些值,就會發生這項錯誤。
根據預設,在 Dataflow 工作序列化期間,系統不會儲存主要工作階段中定義的全域匯入、函式和變數。
如要解決這個問題,請採用下列其中一種方法。如果 DoFn 是在主檔案中定義,並參照全域命名空間中的匯入項目和函式,請將 --save_main_session 管道選項設為 True。這項變更會將全域命名空間的狀態序列化,並載入 Dataflow worker。
如果全域命名空間中有無法醃漬的物件,就會發生醃漬錯誤。如果錯誤與 Python 發行版本中應提供的模組有關,請在本機匯入模組,並在使用該模組的位置匯入。
例如,您不應使用下列指令:
import re
…
def myfunc():
  # use re module
而應改為使用下列指令:
def myfunc():
  import re
  # use re module
或者,如果 DoFn 跨越多個檔案,請使用其他方法封裝工作流程並管理依附元件。
物件受值區的資料保留政策規範
當您有寫入 Cloud Storage bucket 的 Dataflow 工作時,工作會失敗並顯示下列錯誤:
Object 'OBJECT_NAME' is subject to bucket's retention policy or object retention and cannot be deleted or overwritten
您可能也會看到下列錯誤:
Unable to rename "gs://BUCKET"
第一個錯誤發生在 Dataflow 工作寫入的 Cloud Storage bucket 啟用物件保留功能時。詳情請參閱「啟用及使用物件保留設定」。
如要解決這個問題,請採取下列任一解決方法:
寫入
temp資料夾未設有資料保留政策的 Cloud Storage bucket。從工作寫入的值區中移除資料保留政策。詳情請參閱「設定物件的保留設定」。
第二個錯誤可能表示 Cloud Storage bucket 已啟用物件保留功能,或 Dataflow worker 服務帳戶沒有 Cloud Storage bucket 的寫入權限。
如果看到第二個錯誤,且 Cloud Storage bucket 已啟用物件保留功能,請嘗試上述解決方法。如果 Cloud Storage bucket 未啟用物件保留功能,請確認 Dataflow worker 服務帳戶是否具備 Cloud Storage bucket 的寫入權限。詳情請參閱「存取 Cloud Storage bucket」。
處理卡住或正在進行的作業
如果 Dataflow 執行 DoFn 的時間超過 TIME_INTERVAL 中指定的時間,且未傳回任何內容,系統會顯示下列訊息。
Java
下列其中一則記錄訊息 (視版本而定):
Processing stuck in step STEP_NAME for at least TIME_INTERVAL
Operation ongoing in bundle BUNDLE_ID for at least TIME_INTERVAL without outputting or completing: at STACK_TRACE
Python
Operation ongoing for over TIME_INTERVAL in state STATE in step STEP_ID without returning. Current Traceback: TRACEBACK
Go
Operation ongoing in transform TRANSFORM_ID for at least TIME_INTERVAL without outputting or completing in state STATE
這種行為有兩種可能原因:
DoFn程式碼速度緩慢,或正在等待某個緩慢的外部作業完成。- 您的
DoFn程式碼可能停滯、死結或處理速度異常緩慢。
如要判斷是哪一種情況,請展開 Cloud Monitoring 記錄項目,查看堆疊追蹤。尋找指出 DoFn 程式碼卡住或遇到其他問題的訊息。如果沒有任何訊息,問題可能是 DoFn 程式碼的執行速度。建議使用 Cloud Profiler 或其他工具,調查程式碼的效能。
如果管道是以 Java VM 建構 (使用 Java 或 Scala),您可以調查程式碼停滯的原因。請按照下列步驟,擷取整個 JVM (不只是卡住的執行緒) 的完整執行緒傾印檔:
- 記下記錄項目中的 worker 名稱。
- 在 Google Cloud 控制台的 Compute Engine 區段中,找出您記下的 worker 名稱對應的 Compute Engine 執行個體。
- 使用 SSH 連線至該名稱的執行個體。
執行下列指令:
curl http://localhost:8081/threadz
正在執行套裝組合中的作業
執行從 JdbcIO 讀取的管道時,從 JdbcIO 讀取分區的速度緩慢,且 worker 記錄檔中會顯示下列訊息:
Operation ongoing in bundle process_bundle-[0-9-]* for PTransform{id=Read from JDBC with Partitions\/JdbcIO.Read\/JdbcIO.ReadAll\/ParDo\(Read\)\/ParMultiDo\(Read\).*, state=process} for at least (0[1-9]h[0-5][0-9]m[0-5][0-9]s) without outputting or completing:
如要解決這個問題,請對管道進行下列一或多項變更:
使用分區可提高工作平行處理程度。讀取時使用更多、更小的分區,以提升擴充性。
請檢查分區欄是索引欄,還是來源中的實際分區欄。請在來源資料庫中,為這個資料欄啟用索引和分區功能,以達到最佳效能。
使用
lowerBound和upperBound參數,略過尋找邊界。
Pub/Sub 配額錯誤
從 Pub/Sub 執行串流管道時,會發生下列錯誤:
429 (rateLimitExceeded)
或:
Request was throttled due to user QPS limit being reached
如果專案的 Pub/Sub 配額不足,就會發生這些錯誤。
如要確認專案是否配額不足,請按照下列步驟檢查用戶端錯誤:
- 前往 Google Cloud 控制台。
- 在左側的選單中,選取 [APIs & services] (API 和服務)。
- 在「搜尋框」中搜尋 Cloud Pub/Sub。
- 按一下 [Usage] (用量) 分頁標籤。
- 查看「回應代碼」,找出
(4xx)用戶端錯誤代碼。
依據機構政策的規定,您無法提出要求
執行管道時,發生下列錯誤:
Error trying to get gs://BUCKET_NAME/FOLDER/FILE:
{"code":403,"errors":[{"domain":"global","message":"Request is prohibited by organization's policy","reason":"forbidden"}],
"message":"Request is prohibited by organization's policy"}
如果 Cloud Storage bucket 位於 service perimeter 外,就會發生這項錯誤。
如要解決這個問題,請建立輸出規則,允許存取 service perimeter 以外的 bucket。
無法存取暫存套件
原本成功執行的工作可能會失敗,並顯示下列錯誤:
Staged package...is inaccessible
如何解決這個問題:
- 確認用於暫存的 Cloud Storage bucket 沒有存留時間設定,以免暫存套件遭到刪除。
確認 Dataflow 專案的 worker 服務帳戶有權存取用於暫存的 Cloud Storage bucket。權限不一致的原因可能包括:
- 用於暫存的 Cloud Storage bucket 位於其他專案。
- 用於暫存的 Cloud Storage bucket 已從精細存取權遷移至統一 bucket 層級存取權。由於 IAM 和 ACL 政策不一致,將暫存 bucket 遷移至統一 bucket 層級存取權後,Cloud Storage 資源將無法使用 ACL。ACL 包含 Dataflow 專案 worker 服務帳戶對暫存 bucket 的權限。
詳情請參閱「跨Google Cloud專案存取 Cloud Storage bucket」。
工作項目失敗 4 次
批次工作失敗時,會發生下列錯誤:
The job failed because a work item has failed 4 times.
如果批次工作中的單一作業導致 worker 程式碼失敗四次,就會發生這項錯誤。Dataflow 會將工作判定為失敗,並顯示這則訊息。
在串流模式下執行時,內含失敗項目的套裝組合會無限重試,可能導致管道永久停滯。
您無法設定這項失敗門檻。詳情請參閱「管道錯誤和例外狀況處理」。
如要解決這個問題,請在工作的 Cloud Monitoring 記錄中找出四個個別失敗。在 worker 記錄中,尋找顯示例外狀況或錯誤的錯誤等級或嚴重等級記錄項目。例外狀況或錯誤應至少出現四次。如果記錄僅包含與存取外部資源 (例如 MongoDB) 相關的一般逾時錯誤,請確認 worker 服務帳戶有權存取資源的子網路。
輪詢結果檔案逾時
如要完整瞭解如何排解「Timeout in polling result file」(輪詢結果檔案逾時) 錯誤,請參閱「排解 Flex 範本問題」。
Write Correct File/Write/WriteImpl/PreFinalize 失敗
執行工作時,工作會間歇性失敗,並出現下列錯誤:
Workflow failed. Causes: S27:Write Correct File/Write/WriteImpl/PreFinalize failed., Internal Issue (ID): ID:ID, Unable to expand file pattern gs://BUCKET_NAME/temp/FILE
如果多項工作同時執行,且使用相同的子資料夾做為暫存位置,就會發生這項錯誤。
如要解決這個問題,請勿將同一個子資料夾設為多個管道的暫時儲存位置。請為每個管道提供不重複的子資料夾,做為暫時儲存位置。
元素超過 protobuf 訊息大小上限
執行 Dataflow 工作時,如果管道含有大型元素,可能會看到類似下列範例的錯誤:
Exception serializing message!
ValueError: Message org.apache.beam.model.fn_execution.v1.Elements exceeds maximum protobuf size of 2GB
或:
Buffer size ... exceeds GRPC limit 2147483548. This is likely due to a single element that is too large.
或:
Output element size exceeds the allowed limit. (... > 83886080) See https://cloud.google.com/dataflow/quotas#limits for more details.
您可能也會看到類似以下範例的警告:
Data output stream buffer size ... exceeds 536870912 bytes. This is likely due to a large element in a PCollection.
如果管道包含大型元素,就會發生這些錯誤。
如要解決這個問題,請將 Python SDK 升級至 Apache Beam 2.57.0 以上版本。Python SDK 2.57.0 以上版本改善了大型元素的處理方式,並新增相關記錄。
如果升級後仍發生錯誤,或您並未使用 Python SDK,請找出發生錯誤的工作步驟,並嘗試縮減該步驟中的元素大小。
如果管道中的 PCollection 物件含有大型元素,管道的 RAM 需求就會增加。大型元素也可能導致執行階段錯誤,尤其是跨越融合階段的邊界時。
如果管道不小心具體化大型可疊代項目,就可能產生大型元素。例如,如果管道將 GroupByKey 作業的輸出內容傳遞至不必要的 Reshuffle 作業,就會將清單具體化為單一元素。這些清單可能包含每個鍵的大量值。
如果錯誤發生在使用側邊輸入的步驟中,請注意,使用側邊輸入可能會導致融合障礙。檢查產生大型元素的轉換和使用該元素的轉換是否屬於同一個階段。
建構管道時,請遵循下列最佳做法:
- 在
PCollections中,請使用多個小型元素,而非單一大型元素。 - 將大型 Blob 儲存在外部儲存系統中。請使用
PCollections傳遞中繼資料,或使用自訂編碼器縮減元素大小。 - 如果必須傳遞可能超過 2 GB 的 PCollection 做為側邊輸入,請使用可疊代檢視,例如
AsIterable和AsMultiMap。
Dataflow 工作中單一元素的大小上限為 2 GB (Streaming Engine 為 80 MB)。詳情請參閱「配額與限制」。
Dataflow 無法處理代管轉換作業...
如果 Dataflow 無法自動升級 I/O 轉換至最新支援版本,使用代管 I/O 的管道可能會失敗,並顯示這項錯誤。錯誤中提供的 URN 和步驟名稱,應會指出 Dataflow 無法升級的確切轉換。
如要進一步瞭解這項錯誤,請前往Logs Explorer,查看 Dataflow 記錄檔名稱 managed-transforms-worker 和 managed-transforms-worker-startup。
如果記錄檔探索工具提供的資訊不足以排解錯誤,請與 Cloud Customer Care 聯絡。
封存工作錯誤
下列各節列出您嘗試使用 API 封存 Dataflow 工作時,可能會遇到的常見錯誤。
未提供值
嘗試使用 API 封存 Dataflow 工作時,可能會發生下列錯誤:
The field mask specifies an update for the field job_metadata.user_display_properties.archived in job JOB_ID, but no value is provided. To update a field, please provide a field for the respective value.
發生這項錯誤的原因如下:
為
updateMask欄位指定的路徑格式不正確。這個問題可能是拼寫錯誤所致。JobMetadata未正確指定。在JobMetadata欄位中,針對userDisplayProperties使用鍵/值組合"archived":"true"。
如要解決這個錯誤,請確認傳送至 API 的指令符合必要格式。詳工作詳情請參閱「封存工作」。
API 無法辨識該值
嘗試使用 API 封存 Dataflow 工作時,可能會發生下列錯誤:
The API does not recognize the value VALUE for the field job_metadata.user_display_properties.archived for job JOB_ID. REASON: Archived display property can only be set to 'true' or 'false'
如果封存工作鍵/值組合中提供的值不支援,就會發生這項錯誤。封存工作鍵/值組合支援的值為 "archived":"true" 和 "archived":"false"。
如要解決這個錯誤,請確認傳送至 API 的指令符合必要格式。詳情請參閱「封存工作」。
無法同時更新狀態和遮罩
嘗試使用 API 封存 Dataflow 工作時,可能會發生下列錯誤:
Cannot update both state and mask.
如果嘗試在同一個 API 呼叫中同時更新工作狀態和封存狀態,就會發生這項錯誤。您無法在同一個 API 呼叫中,同時更新工作狀態和 updateMask 查詢參數。
如要解決這個錯誤,請在另一個 API 呼叫中更新工作狀態。請先更新工作狀態,再更新工作封存狀態。
無法修改工作流程
嘗試使用 API 封存 Dataflow 工作時,可能會發生下列錯誤:
Workflow modification failed.
嘗試封存執行中的工作時,通常會發生這項錯誤。
如要解決這項錯誤,請等待工作完成後再封存。已完成的工作會處於下列其中一種工作狀態:
JOB_STATE_CANCELLEDJOB_STATE_DRAINEDJOB_STATE_DONEJOB_STATE_FAILEDJOB_STATE_UPDATED
詳情請參閱「偵測 Dataflow 工作完成」。
容器映像檔錯誤
下列各節說明使用自訂容器時可能遇到的常見錯誤,以及解決或疑難排解錯誤的步驟。錯誤通常會以前置字元顯示下列訊息:
Unable to pull container image due to error: DETAILED_ERROR_MESSAGE
「containeranalysis.occurrences.list」權限遭拒
記錄檔中顯示下列錯誤:
Error getting old patchz discovery occurrences: generic::permission_denied: permission "containeranalysis.occurrences.list" denied for project "PROJECT_ID", entity ID "" [region="REGION" projectNum=PROJECT_NUMBER projectID="PROJECT_ID"]
未啟用 Container Analysis API。在某些情況下,必須使用 Container Analysis API 才能掃描安全漏洞。
API。
詳情請參閱 Artifact Analysis 說明文件中的「OS 掃描總覽」和「設定存取控管」。
同步處理 Pod 時發生錯誤 ... 無法「StartContainer」
worker 啟動時發生下列錯誤:
Error syncing pod POD_ID, skipping: [failed to "StartContainer" for CONTAINER_NAME with CrashLoopBackOff: "back-off 5m0s restarting failed container=CONTAINER_NAME pod=POD_NAME].
Pod 是在 Dataflow worker 上執行的 Docker 容器共置群組。如果 Pod 中的其中一個 Docker 容器無法啟動,就會發生這個錯誤。如果失敗無法復原,Dataflow worker 就無法啟動,Dataflow 批次工作最終會失敗,並顯示類似下列的錯誤:
The Dataflow job appears to be stuck because no worker activity has been seen in the last 1h.
如果其中一個容器在啟動期間持續異常終止,通常就會發生這項錯誤。
如要瞭解根本原因,請查看失敗前一刻擷取的記錄。如要分析記錄,請使用Logs Explorer。在 Logs Explorer 中,將記錄檔限制為從容器啟動錯誤的 worker 發出的記錄項目。如要限制記錄項目,請完成下列步驟:
- 在 Logs Explorer 中,找出
Error syncing pod記錄項目。 - 如要查看與記錄項目相關聯的標籤,請展開記錄項目。
- 按一下與
resource_name相關聯的標籤,然後點選「Show matching entries」(顯示相符的項目)。
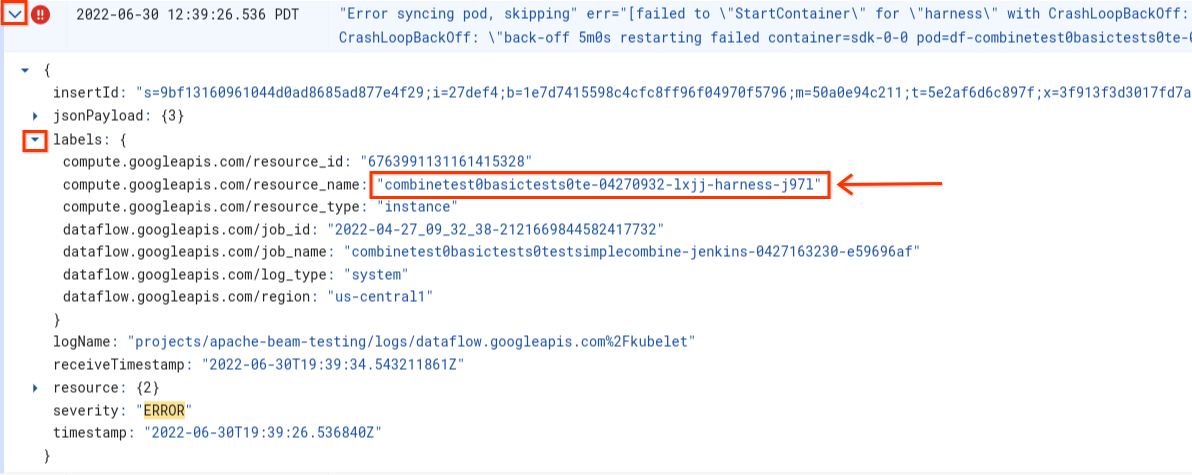
在 Logs Explorer 中,Dataflow 記錄會整理成多個記錄串流。Error syncing pod 訊息會顯示在名為 kubelet 的記錄中。不過,失敗容器的記錄可能位於不同的記錄串流。每個容器都有名稱。請參閱下表,判斷哪個記錄串流可能包含與失敗容器相關的記錄。
| 容器名稱 | 記錄檔名稱 |
|---|---|
| sdk、sdk0、sdk1、sdk-0-0 等 | docker |
| harness | harness、harness-startup |
| python、java-batch、java-streaming | worker-startup、worker |
| 構件 | 構件 |
查詢 Logs Explorer 時,請務必在查詢建立工具介面中加入相關記錄檔名稱,或不限制記錄檔名稱。
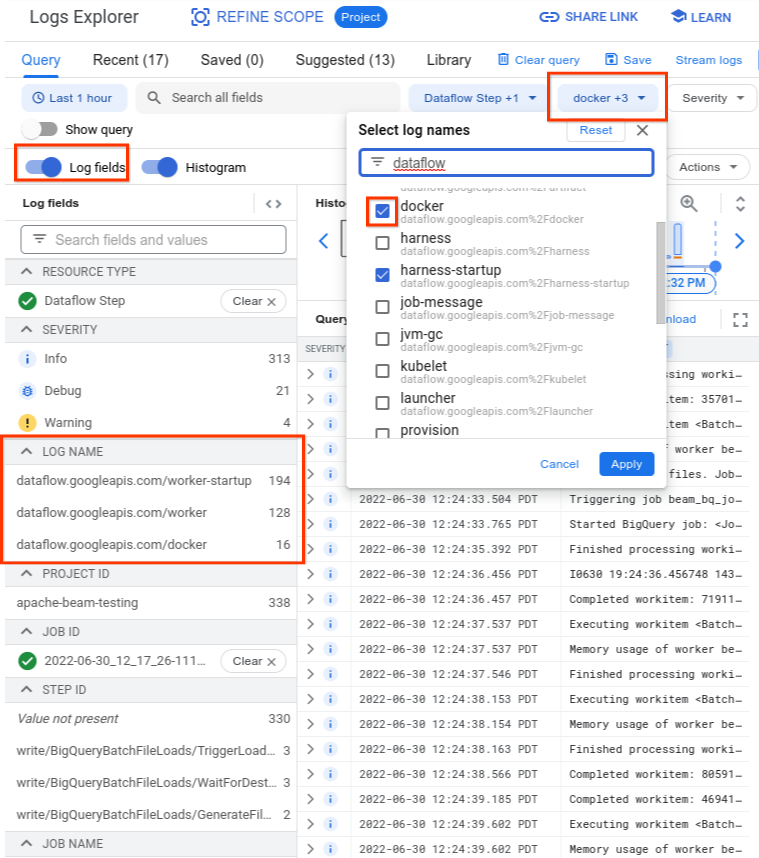
選取相關記錄後,查詢結果可能如下所示:
resource.type="dataflow_step"
resource.labels.job_id="2022-06-29_08_02_54-JOB_ID"
labels."compute.googleapis.com/resource_name"="testpipeline-jenkins-0629-DATE-cyhg-harness-8crw"
logName=("projects/apache-beam-testing/logs/dataflow.googleapis.com%2Fdocker"
OR
"projects/apache-beam-testing/logs/dataflow.googleapis.com%2Fworker-startup"
OR
"projects/apache-beam-testing/logs/dataflow.googleapis.com%2Fworker")
由於回報容器故障症狀的記錄有時會回報為 INFO,因此請在分析中加入 INFO 記錄。
容器故障的常見原因包括:
- Python 管道有額外的依附元件,會在執行階段安裝,但安裝失敗。您可能會看到
pip install failed with error等錯誤。這項問題可能是因為需求衝突,或網路設定受限,導致 Dataflow worker 無法透過網際網路從公開存放區提取外部依附元件。 worker 在管道執行期間因記憶體不足錯誤而失敗。您可能會看到下列其中一則錯誤訊息:
java.lang.OutOfMemoryError: Java heap spaceShutting down JVM after 8 consecutive periods of measured GC thrashing. Memory is used/total/max = 24453/42043/42043 MB, GC last/max = 58.97/99.89 %, #pushbacks=82, gc thrashing=true. Heap dump not written.
如要對記憶體不足問題進行偵錯,請參閱「排解 Dataflow 記憶體不足錯誤」。
Dataflow 無法提取容器映像檔。詳情請參閱「映像檔提取要求失敗並顯示錯誤」。
使用的容器與 worker VM 的 CPU 架構不相容。在測試工具啟動記錄中,您可能會看到類似以下的錯誤:
exec /opt/apache/beam/boot: exec format error。如要檢查容器映像檔的架構,請執行docker image inspect $IMAGE:$TAG並尋找Architecture關鍵字。如果顯示Error: No such image: $IMAGE:$TAG,您可能需要先執行docker pull $IMAGE:$TAG來提取映像檔。如要瞭解如何建構多架構映像檔,請參閱「建構多架構容器映像檔」。
找出導致容器失敗的錯誤後,請嘗試解決錯誤,然後重新提交管道。
範本啟動失敗,並發生錯誤
啟動 Flex 範本時,工作記錄中顯示下列錯誤:
Error: Template launch failed: exit status 13
Error occurred in the launcher container: Template launch failed. See console logs.
Worker 記錄包含類似下列追蹤記錄的堆疊追蹤:
TypeError: canonicalize_version() got an unexpected keyword argument 'strip_trailing_zero'
ERROR:absl:Internal Error Type : RuntimeError
ERROR:absl:Error Message : Full trace: Traceback (most recent call last):
File "/usr/local/lib/python3.9/site-packages/apache_beam/utils/processes.py", line 89, in check_output
out = subprocess.check_output(*args, **kwargs)
IFile "/usr/local/lib/python3.9/subprocess.py", line 424, in check_output
return run(*popenargs, stdout=PIPE, timeout=timeout, check=True,
File "/usr/local/lib/python3.9/subprocess.py", line 528, in run
raise CalledProcessError(retcode, process.args,
subprocess.CalledProcessError: Command '['/usr/local/bin/python', 'setup.py', 'sdist', '--dist-dir', '/tmp/tmp196n6g8d']' returned non-zero exit status 1.
如果範本啟動器在設定期間發現衝突的依附元件,特別是 setuptools 套件更新至 71.0 以上版本時,就會發生這些錯誤。請檢查管道的依附元件,並確認封裝依附元件高於或等於 25.0。
映像檔提取要求失敗,並發生錯誤
啟動 worker 時,worker 或工作記錄中會顯示下列其中一項錯誤:
Image pull request failed with error
pull access denied for IMAGE_NAME
manifest for IMAGE_NAME not found: manifest unknown: Failed to fetch
Get IMAGE_NAME: Service Unavailable
如果 worker 無法提取 Docker 容器映像檔,導致無法啟動,就會發生這些錯誤。這個問題會在下列情況發生:
- 自訂 SDK 容器映像檔網址不正確
- worker 缺少憑證或網路存取權,無法存取遠端映像檔
如何解決這個問題:
- 如果您在工作中使用自訂容器映像檔,請確認映像檔網址正確無誤,且含有有效的標記或摘要。Dataflow worker 也需要存取映像檔。
- 從未經驗證的機器執行
docker pull
$image
,確認公開映像檔可提取至本機。
如果是私人映像檔或私人 worker:
- 如果您使用 Container Registry 託管容器映像檔,建議改用 Artifact Registry。Container Registry 已於 2023 年 5 月 15 日淘汰。如果您使用 Container Registry,可以轉換至 Artifact Registry。如果映像檔與用於執行Google Cloud 工作的專案不同,請為預設Google Cloud 服務帳戶設定存取控管。
- 如果使用共用虛擬私有雲 (VPC),請確認 worker 可以存取自訂容器存放區主機。
- 使用
ssh連線至執行中的工作 worker VM,並執行docker pull $image,直接確認 worker 設定正確。
如果 worker 因這項錯誤而連續失敗多次,且工作已開始執行,則工作可能會失敗,並顯示類似下列訊息的錯誤:
Job appears to be stuck.
如果在工作執行期間移除映像檔本身,或撤銷 Dataflow worker 服務帳戶憑證或網路連線能力,導致無法存取映像檔,Dataflow 只會記錄錯誤。Dataflow 不會宣告工作失敗。Dataflow 也會避免長時間執行的串流管道失敗,以免遺失管道狀態。
其他可能發生的錯誤包括存放區配額問題或服務中斷。如果提取公開映像檔時,超出 Docker Hub 配額,或一般第三方存放區發生中斷,建議使用 Artifact Registry 做為映像檔存放區。
SystemError: unknown opcode
提交工作後,Python 自訂容器管道可能會立即失敗,並顯示下列錯誤:
SystemError: unknown opcode
此外,堆疊追蹤可能包含
apache_beam/internal/pickler.py
如要解決這個問題,請確認本機使用的 Python 版本與容器映像檔中的版本相符,包括主版本和子版本。修補程式版本之間的差異 (例如 3.6.7 與 3.6.8) 不會造成相容性問題。子版本之間的差異 (例如 3.6.8 與 3.8.2) 可能會導致管道失敗。
升級串流管道錯誤
如要瞭解如何解決使用執行平行替換工作等功能升級串流管道時發生的錯誤,請參閱「疑難排解串流管道升級問題」。
Portable Runner 控管機制更新
Portable Runner 工作的記錄會顯示下列資訊訊息
The Dataflow Portable Runner container image of this job's workers will be ready for update in 7 days.
這表示在訊息首次傳送後的 7 天內,執行工具線束程序版本會在某個時間點自動更新,導致處理作業短暫暫停。如要控制暫停時間,請參閱「更新現有管道」,啟動會使用最新版 Runner Harness 的替換工作。
worker 錯誤
以下各節列出您可能會遇到的常見 worker 錯誤,以及解決或排解錯誤的步驟。
從 Java worker 框架呼叫 Python DoFn 失敗,並發生錯誤
如果從 Java worker 框架到 Python DoFn 的呼叫失敗,系統會顯示相關錯誤訊息。
如要調查錯誤,請展開 Cloud Monitoring 錯誤記錄項目,並查看錯誤訊息和追蹤記錄。系統會顯示失敗的程式碼,方便您視需要修正。如果您認為錯誤是 Apache Beam 或 Dataflow 的錯誤,請回報錯誤。
EOFError: marshal data too short
worker 記錄中會顯示下列錯誤:
EOFError: marshal data too short
Python 管道 worker 的磁碟空間用盡時,有時會發生這項錯誤。
如要解決這個問題,請參閱「裝置空間已用盡」。
無法連接磁碟
嘗試啟動使用 C3 VM 和永久磁碟的 Dataflow 工作時,工作失敗並顯示下列一或兩項錯誤:
Failed to attach disk(s), status: generic::invalid_argument: One or more operations had an error
Can not allocate sha384 (reason: -2), Spectre V2 : WARNING: Unprivileged eBPF is enabled with eIBRS on...
如果將 C3 VM 與不支援的永久磁碟類型搭配使用,就會發生這些錯誤。詳情請參閱「C3 支援的磁碟類型」。
如要搭配 Dataflow 工作使用 C3 VM,請選擇 pd-ssd worker 磁碟類型。詳情請參閱「Worker 層級選項」。
Java
--workerDiskType=pd-ssd
Python
--worker_disk_type=pd-ssd
Go
disk_type=pd-ssd
裝置沒有足夠的空間
如果工作用盡磁碟空間,worker 記錄檔中可能會顯示下列錯誤:
No space left on device
發生這項錯誤的可能原因如下:
- worker 永久儲存空間的可用空間用盡,可能原因如下:
- 工作在執行階段下載大型依附元件
- 工作使用大型自訂容器
- 工作將大量暫存資料寫入本機磁碟
- 使用 Dataflow Shuffle 時,Dataflow 會設定較低的預設磁碟大小。因此,從 worker 隨機排序遷移的工作可能會發生這項錯誤。
- worker 開機磁碟每秒記錄超過 50 個項目,因此儲存空間已滿。
如要解決這個問題,請按照下列疑難排解步驟操作:
如要查看與單一 worker 相關聯的磁碟資源,請查詢與工作相關聯的 worker VM 執行個體詳細資料。部分磁碟空間會由作業系統、二進位檔、記錄和容器占用。
如要增加永久磁碟或開機磁碟空間,請調整磁碟大小管道選項。
使用 Cloud Monitoring 追蹤 worker VM 執行個體的磁碟空間用量。如要瞭解如何設定,請參閱「從 Monitoring 代理程式接收 worker VM 指標」。
如要找出開機磁碟空間問題,請查看 worker VM 執行個體上的序列埠輸出內容,並尋找類似下列的訊息:
Failed to open system journal: No space left on device
如果您有多個 worker VM 執行個體,可以建立指令碼,一次在所有執行個體上執行 gcloud
compute instances get-serial-port-output。您可以改為查看該輸出內容。
Python 管道在 worker 閒置一小時後失敗
在具有多個 CPU 核心的工作站機器上,搭配 Dataflow Portable Runner 使用 Apache Beam SDK for Python 時,請使用 Apache Beam SDK 2.35.0 以上版本。如果工作使用自訂容器,請使用 Apache Beam SDK 2.46.0 以上版本。
建議您預先建構 Python 容器。這個步驟可以縮短 VM 啟動時間,並提升水平自動調度資源的效能。如要使用這項功能,請在專案中啟用 Cloud Build API,並使用下列參數提交管道:
‑‑prebuild_sdk_container_engine=cloud_build。
詳情請參閱「Dataflow Portable Runner」。
您也可以使用預先安裝所有依附元件的自訂容器映像檔。
RESOURCE_POOL_EXHAUSTED 或 IP_SPACE_EXHAUSTED_WITH_DETAILS
建立 Google Cloud 資源時,可能會發生下列其中一項 worker 集區建立錯誤。
VM 名稱 INSTANCE_NAME 代表 worker VM 名稱。Worker VM 是全代管的 Compute Engine 執行個體,可執行資料處理管道工作。
ZONE_RESOURCE_POOL_EXHAUSTED_WITH_DETAILS
Startup of the worker pool in zone ZONE_NAME failed to bring up any of the desired NUMBER workers. ZONE_RESOURCE_POOL_EXHAUSTED_WITH_DETAILS: Instance 'INSTANCE_NAME' creation failed: The zone 'projects/PROJECT_ID/zones/ZONE_NAME' does not have enough resources available to fulfill the request. '(resource type:RESOURCE_TYPE)'.
發生這項錯誤的原因是,所要求的 worker VM 類型暫時無法使用。根據預設,Dataflow 會選取執行工作的 worker VM 機器類型,以及永久磁碟的大小和類型。
如要解決這個問題,請採取下列任一策略:
- 將 worker VM 更新為其他機器類型,然後重試工作。
- 從其他區域啟動 Dataflow 工作。
使用
min_ram或cpu_count資源提示,啟用自動選取 VM。啟用自動選取 VM 功能後,系統會從符合 RAM 和 CPU 需求的精選機型清單中佈建 worker,有助於避免資源集區耗盡的問題。注意:啟用自動選取 VM 功能後,系統會忽略管道選項中指定的任何機器類型。
如要為這類情境建立錯誤處理機制,您也可以為工作建立重試迴圈。如果發生資源耗盡錯誤,工作會自動重試,直到有可用資源為止。如要建立重試迴圈,請按照下列工作流程操作:
- 建立 Dataflow 工作,並取得工作 ID。
- 輪詢工作狀態,直到狀態為
RUNNING或FAILED。- 如果工作狀態為
RUNNING,請退出重試迴圈。 - 如果工作狀態為
FAILED,請使用 Cloud Logging API 查詢工作記錄中的ZONE_RESOURCE_POOL_EXHAUSTED_WITH_DETAILS字串。詳情請參閱「使用管道記錄」。- 如果記錄不含該字串,請退出重試迴圈。
- 如果記錄檔包含該字串,請建立 Dataflow 工作、取得工作 ID,然後重新啟動重試迴圈。
- 如果工作狀態為
最後,建議您採用最佳做法,將資源分散到多個可用區和區域,以因應服務中斷問題。
IP_SPACE_EXHAUSTED_WITH_DETAILS
Startup of the worker pool in REGION_NAME failed to bring up any of the desired NUMBER workers. ... IP_SPACE_EXHAUSTED_WITH_DETAILS: Instance 'INSTANCE_NAME' creation failed: IP space of 'projects/PROJECT_ID/regions/REGION_NAME/subnetworks/SUBNETWORK_NAME' is exhausted. Insufficient free IP addresses in the IP range 'IP_RANGE'. Consider expanding the current IP range or selecting an alternative IP range. If this is a secondary range, consider adding an additional secondary range.
如果指派給 Dataflow 工作的子網路沒有足夠的可用 IP 位址,無法佈建所要求的 worker VM 數量,就會發生這項錯誤。
如要解決這個問題,請採取下列任一策略:
- 擴充子網路的主要 IP 範圍。
- 如果您使用的是次要範圍,請新增其他次要範圍。
- 請選取其他子網路或 IP 範圍,確保有足夠的可用 IP 位址。
執行階段依附元件錯誤
執行 Dataflow 工作時,如果使用 Apache Beam SDK for Python 搭配跨語言轉換,從 Maven Central 下載 JAR 檔案時,工作可能會失敗並顯示 HTTP Error
403: Forbidden 錯誤。
這個問題是由 Maven Central 的 CDN 供應商變更所造成,該供應商會封鎖 Apache Beam SDK 使用的 Python urllib 程式庫要求。
如要解決這個問題,請升級至 Apache Beam 2.69.0 以上版本。如果無法升級,請參閱本節中的解決方法。
Apache Beam 2.69.0 以上版本的修正
Apache Beam 2.69.0 以上版本包含下列修正項目:
自訂 Maven 存放區網址:您可以使用
--maven_repository_url管道選項指定自訂 Maven 存放區。例如:--maven_repository_url https://maven-central.storage-download.googleapis.com/maven2/使用者代理程式識別:Apache Beam SDK 會傳送特定的
User-Agent標頭,防止要求遭到封鎖。
舊版 SDK 的解決方法
如果無法升級至 Apache Beam 2.69.0 以上版本,請採用下列其中一種解決方法:
- 在自訂容器中預先封裝 JAR (建議):在自訂容器映像檔中預先封裝必要的 JAR 檔案。請將 JAR 檔案放在 Apache Beam 快取目錄 (
/root/.apache_beam/cache/jars/) 中,以免 SDK 在執行階段下載這些檔案。 使用 Google 的 Maven 鏡像:使用
--expansion_service管道選項,指示 Apache Beam SDK 從 Google 的 Maven Central 鏡像下載必要的 JAR。例如:--expansion_service https://maven-central.storage-download.googleapis.com/maven2/org/apache/beam/beam-sdks-java-extensions-schemaio-expansion-service/BEAM_VERSION/beam-sdks-java-extensions-schemaio-expansion-service-BEAM_VERSION.jar在 Cloud Storage 中暫存 JAR:下載必要的 JAR,將其暫存在 Cloud Storage bucket 中,然後將 JAR 的 Cloud Storage 路徑提供給
--expansion_service管道選項。
具有訪客加速器的執行個體不支援即時遷移
Dataflow 管道在提交工作時失敗,並顯示下列錯誤:
UNSUPPORTED_OPERATION: Instance <worker_instance_name> creation failed:
Instances with guest accelerators do not support live migration
如果您要求的 worker 機器類型具有硬體加速器,但未將 Dataflow 設為使用加速器,就可能發生這項錯誤。
使用 --worker_accelerator Dataflow 服務選項或 accelerator
資源提示,要求硬體加速器。
如果使用 Flex 範本,可以透過 --additionalExperiments 選項提供 Dataflow 服務選項。如果操作正確,您可以在Google Cloud 控制台的工作「Job info」(工作資訊) 面板中找到worker_accelerator選項。
專案配額 ... 或存取控管政策禁止執行作業
發生下列錯誤:
Startup of the worker pool in zone ZONE_NAME failed to bring up any of the desired NUMBER workers. The project quota may have been exceeded or access control policies may be preventing the operation; review the Cloud Logging 'VM Instance' log for diagnostics.
發生這項錯誤的原因如下:
- 您已超過 Dataflow worker 建立作業依賴的其中一項 Compute Engine 配額。
- 貴組織設有限制,禁止 VM 執行個體建立程序的某些部分,例如使用的帳戶或指定的可用區。
如要解決這個問題,請按照下列疑難排解步驟操作:
查看 VM 執行個體記錄
- 前往 Cloud Logging 檢視器
- 在「Audited Resource」(已稽核的資源) 下拉式選單中,選取「VM Instance」(VM 執行個體)。
- 在「All logs」(所有記錄) 下拉式選單中,選取「compute.googleapis.com/activity_log」。
- 掃描記錄,找出與 VM 執行個體建立失敗相關的項目。
查看 Compute Engine 配額用量
如要查看 Compute Engine 資源用量與目標可用區 Dataflow 配額的比較,請執行下列指令:
gcloud compute regions describe [REGION]查看下列資源的結果,確認是否有任何資源超出配額:
- CPU
- DISKS_TOTAL_GB
- IN_USE_ADDRESSES
- INSTANCE_GROUPS
- 執行個體
- REGIONAL_INSTANCE_GROUP_MANAGERS
如有需要,請申請變更配額。
查看組織政策限制
- 前往「組織政策」頁面
- 查看限制,確認是否有任何限制可能會限制您使用的帳戶 (預設為 Dataflow 服務帳戶) 或指定可用區建立 VM 執行個體。
- 如果您的政策限制使用外部 IP 位址,請關閉這項工作的外部 IP 位址。如要進一步瞭解如何關閉外部 IP 位址,請參閱「設定網路連線能力和防火牆規則」。
等待 worker 更新時逾時
Dataflow 工作失敗時,會發生下列錯誤:
Root cause: Timed out waiting for an update from the worker. For more information, see https://cloud.google.com/dataflow/docs/guides/common-errors#worker-lost-contact.
這項錯誤可能由多種原因造成,包括:
Worker 超載
有時,當 worker 的記憶體或交換空間用盡時,就會發生逾時錯誤。如要解決這個問題,請先嘗試再次執行工作。如果工作仍失敗,且發生相同錯誤,請嘗試使用記憶體和磁碟空間較多的 worker。舉例來說,請新增下列管道啟動選項:
--worker_machine_type=m1-ultramem-40 --disk_size_gb=500
變更 worker 類型可能會影響已計費用。詳情請參閱「疑難排解 Dataflow 記憶體不足錯誤」。
如果資料含有熱鍵,也可能發生這項錯誤。在這個情境中,部分 worker 在工作執行期間,大部分時間的 CPU 使用率都偏高。不過,worker 數量並未達到允許上限。如要進一步瞭解熱鍵和可能的解決方案,請參閱「編寫 Dataflow 管道時考量擴充性」。
如需這個問題的其他解決方案,請參閱「偵測到熱鍵…」。
Python:全域解譯器鎖定 (GIL)
如果 Python 程式碼使用 Python 擴充機制呼叫 C/C++ 程式碼,請檢查擴充程式碼是否在不存取 Python 狀態的運算密集程式碼部分釋放 Python 全域解譯器鎖定 (GIL)。如果 GIL 長時間未釋出,可能會看到 Unable to retrieve status info from SDK harness <...> within allowed time 和 SDK worker appears to be permanently unresponsive. Aborting the SDK 等錯誤訊息。
Cython 和 PyBind 等擴充功能可協助與程式庫互動,並提供控制 GIL 狀態的原語。您也可以使用 Py_BEGIN_ALLOW_THREADS 和 Py_END_ALLOW_THREADS 巨集,手動釋出 GIL 並重新取得,然後再將控制權交回 Python 直譯器。詳情請參閱 Python 說明文件中的「執行緒狀態和全域解譯器鎖定」。
您可以按照下列步驟,擷取執行中 Dataflow worker 上持有 GIL 的執行緒堆疊追蹤:
# SSH into a running Dataflow worker VM that is currently a straggler, for example:
gcloud compute ssh --zone "us-central1-a" "worker-that-emits-unable-to-retrieve-status-messages" --project "project-id"

# Install nerdctl to inspect a running container with ptrace privileges.
wget https://github.com/containerd/nerdctl/releases/download/v2.0.2/nerdctl-2.0.2-linux-amd64.tar.gz
sudo tar Cxzvvf /var/lib/toolbox  nerdctl-2.0.2-linux-amd64.tar.gz
alias nerdctl="sudo /var/lib/toolbox/nerdctl -n k8s.io"

# Find a container running the Python SDK harness.
CONTAINER_ID=`nerdctl ps | grep sdk-0-0 | awk '{print $1}'`

# Start a shell in the running container.
nerdctl exec --privileged -it $CONTAINER_ID /bin/bash

# Inspect python processes in the running container.
ps -A | grep python
PYTHON_PID=$(ps -A | grep python | head -1 | awk '{print $1}')

# Use pystack to retrieve stacktraces from the python process.
pip install pystack

pystack remote --native $PYTHON_PID

# Find which thread holds the GIL and inspect the stacktrace.
pystack remote --native $PYTHON_PID | grep -iF "Has the GIL" -A 100

# Alternately, use inspect with gdb.
apt update && apt install -y gdb
gdb --quiet \
  --eval-command="set pagination off" \
  --eval-command="thread apply all bt" \
  --eval-command "set confirm off" \
  --eval-command="quit"  -p $PYTHON_PID
在 Python 管道中,Dataflow 預設會假設在 worker 上執行的每個 Python 程序,都會有效率地使用一個 vCPU 核心。如果管道程式碼略過 GIL 限制 (例如使用以 C++ 實作的程式庫),處理元素可能會使用多個 vCPU 核心的資源,而 worker 可能無法取得足夠的 CPU 資源。如要解決這個問題,請減少 worker 上的執行緒數量。
設定耗時較長的 DoFn
如果您未使用可攜式執行工具,則對 DoFn.Setup 執行長時間執行的呼叫可能會導致下列錯誤:
Timed out waiting for an update from the worker
一般來說,請避免在 DoFn.Setup 內執行耗時作業。
發布至主題時發生暫時性錯誤
如果串流工作使用至少一次串流模式,並發布至 Pub/Sub 接收器,工作記錄中會顯示下列錯誤:
There were transient errors publishing to topic
如果工作正常執行,這個錯誤不會造成影響,您可以忽略。Dataflow 會自動重試傳送 Pub/Sub 訊息,並採用輪詢延遲。
金鑰權杖不符,無法擷取資料
下列錯誤表示正在處理的工作項目已重新分配給其他 worker:
Unable to fetch data due to token mismatch for key
這種情況最常發生在自動調度資源期間,但隨時可能發生。系統會重試任何受影響的工作。您可以忽略這項錯誤。
Java 依附元件問題
不相容的類別和程式庫可能會導致 Java 依附元件問題。如果管道有 Java 依附元件問題,可能會發生下列其中一項錯誤:
NoClassDefFoundError:如果整個類別在執行階段無法使用,就會發生這項錯誤。這可能是由一般設定問題引起,也可能是 Beam 的 protobuf 版本與用戶端產生的 proto 不相容所致 (例如這個問題)。NoSuchMethodError:如果類別路徑中的類別使用的版本不含正確方法,或方法簽章已變更,就會發生這項錯誤。
NoSuchFieldError:如果類別路徑中的類別使用的版本不含執行階段所需的欄位,就會發生這項錯誤。FATAL ERROR in native method:如果無法正確載入內建依附元件,就會發生這項錯誤。使用 uber JAR (shaded) 時,請勿在同一個 JAR 中加入使用簽章的程式庫 (例如 Conscrypt)。
如果管道包含使用者專屬的程式碼和設定,程式碼不得包含混合版本的程式庫。如果您使用依附元件管理程式庫,建議您使用 Google Cloud Libraries BOM。
如果您使用的是 Apache Beam SDK,請使用 beam-sdks-java-io-google-cloud-platform-bom 匯入正確的程式庫 BOM:
Maven
<dependencyManagement>
  <dependencies>
    <dependency>
      <groupId>org.apache.beam</groupId>
      <artifactId>beam-sdks-java-google-cloud-platform-bom</artifactId>
      <version>BEAM_VERSION</version>
      <type>pom</type>
      <scope>import</scope>
    </dependency>
  </dependencies>
</dependencyManagement>
Gradle
dependencies {
    implementation(platform("org.apache.beam:beam-sdks-java-google-cloud-platform-bom:BEAM_VERSION"))
}
詳情請參閱「在 Dataflow 中管理管道依附元件」。
JDK 17 以上版本的 InaccessibleObjectException
使用 Java Platform Standard Edition Development Kit (JDK) 17 以上版本執行管道時,worker 記錄檔可能會顯示下列錯誤:
Unable to make protected METHOD accessible:
    module java.MODULE does not "opens java.MODULE" to ...
這個問題發生的原因,是從 Java 9 版開始,必須使用開放模組 Java 虛擬機器 (JVM) 選項,才能存取 JDK 內部。在 Java 16 和更新版本中,一律需要開放模組 JVM 選項,才能存取 JDK 內部。
如要解決這個問題,請在將模組傳遞至 Dataflow 管道開啟時,使用 MODULE/PACKAGE=TARGET_MODULE(,TARGET_MODULE)* 格式和 jdkAddOpenModules 管道選項。這種格式可讓您存取必要的程式庫。
舉例來說,如果錯誤是 module java.base does not "opens java.lang" to
unnamed module @...,請在執行管道時加入下列管道選項:
--jdkAddOpenModules=java.base/java.lang=ALL-UNNAMED
詳情請參閱 DataflowPipelineOptions 類別說明文件。
回報工作項目進度時發生錯誤
如果是 Java 管道,且您未使用可攜式執行工具,可能會看到下列錯誤:
Error reporting workitem progress update to Dataflow service: ...
這項錯誤是由工作項目進度更新期間 (例如分割來源時) 未處理的例外狀況所造成。在多數情況下,如果 Apache Beam 使用者程式碼擲回未處理的例外狀況,工作項目就會失敗,導致管道失敗。不過,Source.split 中的例外狀況會遭到抑制,因為該部分程式碼位於工作項目之外。因此只會記錄錯誤。
如果只是偶爾發生,通常不會造成問題。不過,建議您在 Source.split 程式碼中妥善處理例外狀況。
BigQuery 連接器錯誤
以下各節說明您可能會遇到的常見 BigQuery 連接器錯誤,以及解決或排解錯誤的步驟。
quotaExceeded
使用 BigQuery 連接器,透過串流資料即時插入功能寫入 BigQuery 時,寫入處理量低於預期,且可能發生下列錯誤:
quotaExceeded
處理量偏低可能是因為管道超過可用的 BigQuery 串流資料即時插入配額。如果是,Dataflow worker 記錄中會顯示 BigQuery 的配額相關錯誤訊息 (請尋找 quotaExceeded 錯誤)。
如果看到 quotaExceeded 錯誤,請按照下列步驟解決問題:
- 使用 Apache Beam SDK for Java 時,請設定 BigQuery 接收器選項
ignoreInsertIds()。 - 使用 Apache Beam SDK for Python 時,請使用
ignore_insert_ids選項。
這些設定可讓您享有每秒 1 GB 的 BigQuery 串流資料即時插入處理量 (以專案為單位)。如要進一步瞭解自動簡化訊息的注意事項,請參閱 BigQuery 說明文件。如要將 BigQuery 串流資料即時插入配額提高至 1 GBps 以上,請透過Google Cloud 控制台提交要求。
如果 worker 記錄檔中沒有配額相關錯誤,可能是預設的繫結或批次處理相關參數,無法為管道提供足夠的平行處理量來擴充。您可以調整多項 Dataflow BigQuery 連接器相關設定,在使用串流資料即時插入寫入 BigQuery 時,達到預期效能。舉例來說,如果是 Apache Beam SDK for Java,請調整 numStreamingKeys 以符合 worker 數量上限,並考慮增加 insertBundleParallelism,將 BigQuery 連接器設為使用更多平行執行緒寫入 BigQuery。
如要瞭解 Apache Beam SDK for Java 提供的設定,請參閱 BigQueryPipelineOptions;如要瞭解 Apache Beam SDK for Python 提供的設定,請參閱 WriteToBigQuery 轉換。
rateLimitExceeded
使用 BigQuery 連接器時,發生下列錯誤:
rateLimitExceeded
如果在短時間內傳送過多 BigQuery API 要求,就會發生這項錯誤。BigQuery 設有短期配額限制。Dataflow 管道可能會暫時超出這類配額。在這種情況下,從 Dataflow 管道傳送至 BigQuery 的 API 要求可能會失敗,導致 worker 記錄中出現 rateLimitExceeded 錯誤。
Dataflow 會重試這類失敗作業,因此您可以放心忽略這些錯誤。如果您認為管道受到 rateLimitExceeded 錯誤影響,請與 Cloud Customer Care 聯絡。
其他錯誤
以下各節列出您可能會遇到的其他錯誤,以及解決或排解錯誤的步驟。
無法分配 sha384
工作正常執行,但工作記錄中顯示下列錯誤:
ima: Can not allocate sha384 (reason: -2)
如果工作正常執行,這項錯誤不會造成影響,您可以忽略。worker VM 基本映像檔有時會產生這則訊息。Dataflow 會自動回應並解決基礎問題。
目前有一項功能要求,希望將這則訊息的層級從 WARN 變更為 INFO。詳情請參閱「將 Dataflow 系統啟動錯誤記錄層級降至 WARN 或 INFO」。
初始化動態外掛程式探測器時發生錯誤
工作正常執行,但工作記錄中顯示下列錯誤:
Error initializing dynamic plugin prober" err="error (re-)creating driver directory: mkdir /usr/libexec/kubernetes: read-only file system
如果工作正常執行,這項錯誤不會造成影響,您可以忽略。如果 Dataflow 工作嘗試建立目錄,但沒有必要的寫入權限,就會發生這項錯誤,且工作會失敗。如果工作成功,代表不需要該目錄,或 Dataflow 已解決基礎問題。
目前有一項功能要求,希望將這則訊息的層級從 WARN 變更為 INFO。詳情請參閱「將 Dataflow 系統啟動錯誤記錄層級降至 WARN 或 INFO」。
沒有這個物件:pipeline.pb
使用 JOB_VIEW_ALL 選項列出工作時,會發生下列錯誤:
No such object: BUCKET_NAME/PATH/pipeline.pb
如果從工作的暫存檔案中刪除 pipeline.pb 檔案,就可能發生這項錯誤。
略過 Pod 同步處理
工作正常執行,但工作記錄中顯示下列其中一項錯誤:
Skipping pod synchronization" err="container runtime status check may not have completed yet"
或:
Skipping pod synchronization" err="[container runtime status check may not have completed yet, PLEG is not healthy: pleg has yet to be successful]"
如果工作正常執行,這些錯誤不會造成影響,您可以忽略。如果 Kubernetes kubelet 正在等待容器執行階段初始化,因此略過 Pod 同步作業,就會顯示 container runtime status check may not have completed yet 訊息。這種情況可能由多種原因造成,例如容器執行階段最近啟動或重新啟動。
如果訊息包含 PLEG is not healthy: pleg has yet to be
successful,表示 kubelet 正在等待 Pod 生命週期事件產生器 (PLEG) 恢復正常,然後才會同步處理 Pod。PLEG 負責產生事件,kubelet 會使用這些事件追蹤 Pod 的狀態。
目前有一項功能要求,希望將這則訊息的層級從 WARN 變更為 INFO。詳情請參閱「將 Dataflow 系統啟動錯誤記錄層級降至 WARN 或 INFO」。
建議
如要瞭解 Dataflow Insights 生成的建議,請參閱「洞察」。