


Jika Anda mengalami masalah dengan pipeline atau tugas Dataflow, halaman ini mencantumkan pesan error yang mungkin Anda lihat dan memberikan saran tentang cara memperbaiki setiap error.
Error dalam jenis log dataflow.googleapis.com/worker-startup,
dataflow.googleapis.com/harness-startup, dan dataflow.googleapis.com/kubelet
menunjukkan masalah konfigurasi pada tugas. Pesan ini juga dapat menunjukkan kondisi
yang mencegah jalur logging normal berfungsi.
Pipeline Anda mungkin menampilkan pengecualian saat memproses data. Beberapa error ini bersifat sementara, misalnya saat terjadi kesulitan sementara dalam mengakses layanan eksternal. Beberapa error ini bersifat permanen, seperti error yang disebabkan oleh data input yang rusak atau tidak dapat diurai, atau pointer null selama komputasi.
Dataflow memproses elemen dalam paket arbitrer dan mencoba kembali seluruh paket saat terjadi error untuk elemen apa pun dalam paket tersebut. Saat berjalan dalam mode batch, paket yang menyertakan item yang gagal akan dicoba ulang empat kali. Pipeline akan gagal sepenuhnya jika satu paket gagal empat kali. Saat berjalan dalam mode streaming, paket yang menyertakan item yang gagal akan dicoba ulang tanpa batas waktu, yang dapat menyebabkan pipeline Anda terhenti secara permanen.
Pengecualian dalam kode pengguna, misalnya, instance DoFn Anda, dilaporkan di antarmuka pemantauan Dataflow. Jika menjalankan pipeline dengan BlockingDataflowPipelineRunner, Anda juga akan melihat pesan error yang dicetak di konsol atau jendela terminal.
Pertimbangkan untuk mencegah error dalam kode Anda dengan menambahkan pengendali pengecualian. Misalnya, jika Anda ingin menghapus elemen yang gagal dalam beberapa validasi input kustom yang dilakukan di ParDo, gunakan blok try/catch dalam ParDo untuk menangani pengecualian, serta mencatat dan menghapus elemen. Untuk workload produksi, terapkan pola pesan yang belum diproses. Untuk melacak
jumlah error, gunakan transformasi
agregasi.
File log tidak ada
Jika Anda tidak melihat log untuk tugas Anda, hapus filter pengecualian yang berisi
resource.type="dataflow_step" dari semua sink Router Log Cloud Logging Anda.
Untuk mengetahui detail selengkapnya tentang cara menghapus pengecualian log, lihat panduan Menghapus pengecualian.
Duplikat dalam output
Saat Anda menjalankan tugas Dataflow, output-nya berisi data duplikat.
Masalah ini dapat terjadi saat tugas Dataflow Anda menggunakan mode streaming pipeline setidaknya sekali. Mode ini menjamin bahwa data diproses setidaknya satu kali. Namun, data duplikat mungkin ada dalam mode ini.
Jika alur kerja Anda tidak dapat menoleransi data duplikat, gunakan mode streaming tepat satu kali. Mode ini membantu memastikan bahwa data tidak dihapus atau diduplikasi saat data berpindah melalui pipeline.
Untuk memverifikasi mode streaming yang digunakan tugas Anda, lihat Melihat mode streaming tugas.
Untuk mengetahui informasi selengkapnya tentang mode streaming, lihat Menetapkan mode streaming pipeline.
Error pipeline
Bagian berikut berisi error pipeline umum yang mungkin Anda alami dan langkah-langkah untuk menyelesaikan atau memecahkan masalah error tersebut.
Beberapa Cloud API perlu diaktifkan
Saat Anda mencoba menjalankan tugas Dataflow, error berikut akan terjadi:
Some Cloud APIs need to be enabled for your project in order for Cloud Dataflow to run this job.
Masalah ini terjadi karena beberapa API yang diperlukan tidak diaktifkan di project Anda.
Untuk mengatasi masalah ini dan menjalankan tugas Dataflow, aktifkan APIGoogle Cloud berikut di project Anda:
- Compute Engine API (Compute Engine)
- Cloud Logging API
- Cloud Storage
- Cloud Storage JSON API
- BigQuery API
- Pub/Sub
- Datastore API
Untuk petunjuk mendetail, lihat bagian Memulai tentang mengaktifkan APIGoogle Cloud .
"@*" dan "@N" adalah spesifikasi sharding yang dicadangkan
Saat Anda mencoba menjalankan tugas, error berikut akan muncul di file log, dan tugas akan gagal:
Workflow failed. Causes: "@*" and "@N" are reserved sharding specs. Filepattern must not contain any of them.
Error ini terjadi jika nama file untuk jalur Cloud Storage Anda untuk file sementara (tempLocation atau temp_location) memiliki tanda @ diikuti dengan angka atau tanda bintang (*).
Untuk mengatasi masalah ini, ubah nama file sehingga tanda @ diikuti dengan karakter yang didukung.
Permintaan tidak baik
Saat Anda menjalankan tugas Dataflow, log Cloud Monitoring akan menampilkan serangkaian peringatan yang mirip dengan berikut ini:
Unable to update setup work item STEP_ID error: generic::invalid_argument: Http(400) Bad Request
Update range task returned 'invalid argument'. Assuming lost lease for work with id LEASE_ID
with expiration time: TIMESTAMP, now: TIMESTAMP. Full status: generic::invalid_argument: Http(400) Bad Request
Peringatan permintaan buruk terjadi jika informasi status worker sudah usang atau tidak sinkron karena penundaan pemrosesan. Sering kali, tugas Dataflow Anda berhasil meskipun ada peringatan permintaan tidak valid. Jika demikian, abaikan peringatan tersebut.
Tidak dapat membaca dan menulis di lokasi yang berbeda
Saat menjalankan tugas Dataflow, Anda mungkin melihat error berikut di file log:
message:Cannot read and write in different locations: source: SOURCE_REGION, destination: DESTINATION_REGION,reason:invalid
Error ini terjadi jika sumber dan tujuan berada di region yang berbeda. Hal ini juga dapat terjadi jika lokasi staging dan tujuan berada di region yang berbeda. Misalnya, jika tugas membaca dari Pub/Sub, lalu menulis ke bucket temp Cloud Storage sebelum menulis ke tabel BigQuery, bucket temp Cloud Storage dan tabel BigQuery harus berada di region yang sama.
Lokasi multi-region dianggap berbeda dengan lokasi satu region, meskipun satu region tersebut termasuk dalam cakupan lokasi multi-region.
Misalnya, us (multiple regions in the United States) dan us-central1 adalah region yang berbeda.
Untuk mengatasi masalah ini, pastikan lokasi tujuan, sumber, dan staging Anda berada di region yang sama. Lokasi bucket Cloud Storage tidak dapat diubah, jadi Anda mungkin perlu membuat bucket Cloud Storage baru di region yang benar.
Waktu koneksi habis
Saat menjalankan tugas Dataflow, Anda mungkin melihat error berikut di file log:
org.springframework.web.client.ResourceAccessException: I/O error on GET request for CONNECTION_PATH: Connection timed out (Connection timed out); nested exception is java.net.ConnectException: Connection timed out (Connection timed out)
Masalah ini terjadi saat worker Dataflow gagal membuat atau mempertahankan koneksi dengan sumber atau tujuan data.
Untuk menyelesaikan masalah ini, ikuti langkah-langkah pemecahan masalah berikut:
- Pastikan sumber data berjalan.
- Pastikan tujuan berjalan.
- Tinjau parameter koneksi yang digunakan dalam konfigurasi pipeline Dataflow.
- Pastikan masalah performa tidak memengaruhi sumber atau tujuan.
- Pastikan aturan firewall tidak memblokir koneksi.
Objek tersebut tidak ada
Saat menjalankan tugas Dataflow, Anda mungkin melihat error berikut di file log:
..., 'server': 'UploadServer', 'status': '404'}>, <content <No such object:...
Error ini biasanya terjadi saat beberapa tugas Dataflow yang berjalan menggunakan temp_location yang sama untuk melakukan staging file tugas sementara yang dibuat saat pipeline berjalan. Jika beberapa tugas serentak menggunakan temp_location yang sama,
tugas-tugas ini mungkin akan saling menimpa data sementara, dan kondisi race
mungkin terjadi. Untuk menghindari masalah ini, sebaiknya gunakan temp_location yang unik untuk setiap tugas.
Dataflow tidak dapat menentukan backlog
Saat menjalankan pipeline streaming dari Pub/Sub, peringatan berikut akan muncul:
Dataflow is unable to determine the backlog for Pub/Sub subscription
Saat pipeline Dataflow mengambil data dari Pub/Sub, Dataflow perlu berulang kali meminta informasi dari Pub/Sub. Informasi ini mencakup jumlah backlog pada langganan dan usia pesan tertua yang belum dikonfirmasi. Terkadang, Dataflow tidak dapat mengambil informasi ini dari Pub/Sub karena masalah sistem internal, yang dapat menyebabkan akumulasi backlog sementara.
Untuk mengetahui informasi selengkapnya, lihat Streaming Dengan Cloud Pub/Sub.
DEADLINE_EXCEEDED atau Server Tidak Responsif
Saat menjalankan tugas, Anda mungkin mengalami pengecualian waktu tunggu RPC atau salah satu error berikut:
DEADLINE_EXCEEDED
Atau:
Server Unresponsive
Error ini biasanya terjadi karena salah satu alasan berikut:
Jaringan Virtual Private Cloud (VPC) yang digunakan untuk tugas Anda mungkin tidak memiliki aturan firewall. Aturan firewall harus mengaktifkan semua traffic TCP di antara VM dalam jaringan VPC yang Anda tentukan dalam opsi pipeline. Untuk mengetahui informasi selengkapnya, lihat Aturan firewall untuk Dataflow.
Dalam beberapa kasus, worker tidak dapat berkomunikasi satu sama lain. Saat Anda menjalankan tugas Dataflow yang tidak menggunakan Dataflow Shuffle atau Streaming Engine, worker perlu berkomunikasi satu sama lain menggunakan port TCP
12345dan12346dalam jaringan VPC. Dalam skenario ini, error mencakup nama worker harness dan port TCP yang diblokir. Error tersebut terlihat seperti salah satu contoh berikut:DEADLINE_EXCEEDED: (g)RPC timed out when SOURCE_WORKER_HARNESS talking to DESTINATION_WORKER_HARNESS:12346.Rpc to WORKER_HARNESS:12345 completed with error UNAVAILABLE: failed to connect to all addresses Server unresponsive (ping error: Deadline Exceeded, UNKNOWN: Deadline Exceeded...)Untuk mengatasi masalah ini, gunakan flag rules
gcloud compute firewall-rules createuntuk mengizinkan traffic jaringan ke port12345dan12346. Contoh berikut menunjukkan perintah Google Cloud CLI:gcloud compute firewall-rules create FIREWALL_RULE_NAME \ --network NETWORK \ --action allow \ --direction IN \ --target-tags dataflow \ --source-tags dataflow \ --priority 0 \ --rules tcp:12345-12346Ganti kode berikut:
FIREWALL_RULE_NAME: nama aturan firewall AndaNETWORK: nama jaringan Anda
Tugas Anda terikat shuffle.
Untuk mengatasi masalah ini, lakukan satu atau beberapa perubahan berikut.
Java
- Jika tugas tidak menggunakan shuffle berbasis layanan, beralihlah untuk menggunakan Dataflow Shuffle berbasis layanan dengan menetapkan
--experiments=shuffle_mode=service. Untuk mengetahui detail dan ketersediaan, lihat Dataflow Shuffle. - Menambahkan lebih banyak worker. Coba tetapkan
--numWorkersdengan nilai yang lebih tinggi saat Anda menjalankan pipeline. - Tingkatkan ukuran disk yang terpasang untuk worker. Coba tetapkan
--diskSizeGbdengan nilai yang lebih tinggi saat Anda menjalankan pipeline. - Gunakan persistent disk yang didukung SSD. Coba tetapkan
--workerDiskType="compute.googleapis.com/projects/PROJECT_ID/zones/ZONE/diskTypes/pd-ssd"saat Anda menjalankan pipeline.
Python
- Jika tugas tidak menggunakan shuffle berbasis layanan, beralihlah untuk menggunakan Dataflow Shuffle berbasis layanan dengan menetapkan
--experiments=shuffle_mode=service. Untuk mengetahui detail dan ketersediaan, lihat Dataflow Shuffle. - Tambahkan lebih banyak worker. Coba tetapkan
--num_workersdengan nilai yang lebih tinggi saat Anda menjalankan pipeline. - Tingkatkan ukuran disk yang terpasang untuk worker. Coba tetapkan
--disk_size_gbdengan nilai yang lebih tinggi saat Anda menjalankan pipeline. - Gunakan persistent disk yang didukung SSD. Coba tetapkan
--worker_disk_type="compute.googleapis.com/projects/PROJECT_ID/zones/ZONE/diskTypes/pd-ssd"saat Anda menjalankan pipeline.
Go
- Jika tugas tidak menggunakan shuffle berbasis layanan, beralihlah untuk menggunakan Dataflow Shuffle berbasis layanan dengan menetapkan
--experiments=shuffle_mode=service. Untuk mengetahui detail dan ketersediaan, lihat Dataflow Shuffle. - Menambahkan lebih banyak worker. Coba tetapkan
--num_workersdengan nilai yang lebih tinggi saat Anda menjalankan pipeline. - Tingkatkan ukuran disk yang terpasang untuk worker. Coba tetapkan
--disk_size_gbdengan nilai yang lebih tinggi saat Anda menjalankan pipeline. - Gunakan persistent disk yang didukung SSD. Coba tetapkan
--disk_type="compute.googleapis.com/projects/PROJECT_ID/zones/ZONE/diskTypes/pd-ssd"saat Anda menjalankan pipeline.
- Jika tugas tidak menggunakan shuffle berbasis layanan, beralihlah untuk menggunakan Dataflow Shuffle berbasis layanan dengan menetapkan
Pemisahan kosong ditampilkan
Saat menjalankan tugas Dataflow, pesan berikut mungkin muncul di log worker:
Continuing to process work-id WORK_ID without splitting. Reader split status was: INTERNAL: Empty split returned and SDK split status was: ...
Jika tugas Anda berjalan dengan benar, pesan ini tidak berbahaya, dan Anda dapat mengabaikannya. Pesan ini dapat muncul karena kondisi race saat layanan mencoba membagi pekerjaan yang telah selesai.
Error encoding, IOException, atau perilaku tidak terduga dalam kode pengguna
Apache Beam SDK dan worker Dataflow bergantung pada komponen pihak ketiga yang umum. Komponen ini mengimpor dependensi tambahan. Tabrakan versi dapat menyebabkan perilaku yang tidak terduga dalam layanan. Selain itu, beberapa library tidak kompatibel dengan versi yang lebih baru. Anda mungkin perlu menyematkan ke versi yang tercantum yang berada dalam cakupan selama eksekusi. Dependensi SDK dan Worker berisi daftar dependensi dan versi yang diperlukan.
Jenis mesin memerlukan jenis disk Hyperdisk Balanced
Saat Anda mencoba menjalankan tugas Dataflow, error berikut akan terjadi:
MACHINE_TYPE machine types require the Hyperdisk Balanced disk type.
Masalah ini terjadi saat Anda menggunakan jenis mesin yang memerlukan disk Hyperdisk Balanced, seperti C4A atau N4, tetapi Anda menentukan jenis disk yang tidak kompatibel, seperti pd-standard.
Untuk mengatasi masalah ini, jika Anda menggunakan jenis mesin yang memerlukan
disk Hyperdisk Balanced, jangan tentukan
opsi pipeline workerDiskType (worker_disk_type untuk Python, disk_type untuk Go),
atau tetapkan ke hyperdisk-balanced.
Terjadi error saat menjalankan LookupEffectiveGuestPolicies
Saat menjalankan tugas Dataflow, Anda mungkin melihat error berikut di file log:
OSConfigAgent Error policies.go:49: Error running LookupEffectiveGuestPolicies:
error calling LookupEffectiveGuestPolicies: code: "Unauthenticated",
message: "Request is missing required authentication credential.
Expected OAuth 2 access token, login cookie or other valid authentication credential.
Error ini terjadi jika pengelolaan konfigurasi OS diaktifkan untuk seluruh project.
Untuk mengatasi masalah ini, nonaktifkan kebijakan VM Manager yang berlaku untuk seluruh project. Jika kebijakan VM Manager tidak dapat dinonaktifkan untuk seluruh project, Anda dapat mengabaikan error ini dengan aman dan memfilternya dari alat pemantauan log.
Batasan akses IP eksternal dilanggar
Saat Anda menjalankan atau meng-clone tugas Dataflow, error berikut akan terjadi:
Constraint constraints/compute.vmExternalIpAccess violated for project PROJECT_ID.
Error ini terjadi saat batasan kebijakan organisasi melarang instance VM menggunakan alamat IP eksternal, tetapi tugas Dataflow dikonfigurasi untuk menggunakan alamat IP eksternal.
Untuk mengatasi masalah ini, konfigurasikan tugas secara eksplisit agar hanya menggunakan alamat IP internal:
- Di konsol Google Cloud : Dalam daftar Worker IP Address Configuration, pilih Private.
- Menggunakan SDK: Tetapkan opsi pipeline
--usePublicIps=false.
Untuk mengetahui informasi selengkapnya, lihat Menonaktifkan alamat IP eksternal.
Error fatal telah terdeteksi oleh Java Runtime Environment
Error berikut terjadi selama startup worker:
A fatal error has been detected by the Java Runtime Environment
Error ini terjadi jika pipeline menggunakan Java Native Interface (JNI) untuk menjalankan kode non-Java dan kode tersebut atau binding JNI berisi error.
Error kunci atribut googclient_deliveryattempt
Tugas Dataflow Anda gagal dengan salah satu error berikut:
The request contains an attribute key that is not valid (key=googclient_deliveryattempt). Attribute keys must be non-empty and must not begin with 'goog' (case-insensitive).
Atau:
Invalid extensions name: googclient_deliveryattempt
Error ini terjadi jika tugas Dataflow Anda memiliki karakteristik berikut:
- Tugas Dataflow menggunakan Streaming Engine.
- Pipeline memiliki sink Pub/Sub.
- Pipeline menggunakan langganan pull.
- Pipeline ini menggunakan salah satu API layanan Pub/Sub untuk memublikasikan pesan, bukan menggunakan sink I/O Pub/Sub bawaan.
- Pub/Sub menggunakan library klien Java atau C#.
- Langganan Pub/Sub memiliki topik yang dihentikan pengirimannya.
Error ini terjadi karena saat Anda menggunakan library klien Java atau C# Pub/Sub dan topik yang dihentikan pengirimannya untuk langganan diaktifkan, upaya pengiriman berada di atribut pesan googclient_deliveryattempt, bukan di kolom delivery_attempt. Untuk mengetahui informasi selengkapnya, lihat Melacak upaya pengiriman di halaman "Menangani kegagalan pesan".
Untuk mengatasi masalah ini, lakukan satu atau beberapa perubahan berikut.
- Nonaktifkan Streaming Engine.
- Gunakan konektor
PubSubIOApache Beam bawaan, bukan API layanan Pub/Sub. - Gunakan jenis langganan Pub/Sub yang berbeda.
- Hapus topik yang dihentikan pengirimannya.
- Jangan gunakan library klien Java atau C# dengan langganan pull Pub/Sub Anda. Untuk opsi lainnya, lihat Contoh kode library klien.
- Dalam kode pipeline Anda, jika kunci atribut diawali dengan
goog, hapus atribut pesan sebelum memublikasikan pesan.
Hot key ... terdeteksi
Error berikut akan terjadi:
A hot key HOT_KEY_NAME was detected in...
Error ini terjadi jika data Anda berisi hot key. Hot key adalah kunci dengan elemen yang cukup untuk berdampak negatif pada performa pipeline. Kunci ini membatasi kemampuan Dataflow untuk memproses elemen secara paralel, sehingga meningkatkan waktu eksekusi.
Untuk mencetak kunci yang dapat dibaca manusia ke log saat hot key terdeteksi di pipeline, gunakan opsi pipeline hot key.
Untuk mengatasi masalah ini, pastikan data Anda didistribusikan secara merata. Jika kunci memiliki banyak nilai yang tidak proporsional, pertimbangkan tindakan berikut:
- Kunci ulang data Anda. Terapkan transformasi
ParDountuk menghasilkan key-value pair baru. - Untuk tugas Java, gunakan transformasi
Combine.PerKey.withHotKeyFanout. - Untuk tugas Python, gunakan transformasi
CombinePerKey.with_hot_key_fanout. - Aktifkan Dataflow Shuffle.
Untuk melihat hot key di antarmuka pemantauan Dataflow, lihat Memecahkan masalah straggler dalam tugas batch.
Grafik tugas terlalu besar
Tugas Anda mungkin gagal dengan error berikut:
The job graph is too large. Please try again with a smaller job graph,
or split your job into two or more smaller jobs.
Error ini terjadi jika ukuran grafik tugas Anda melebihi 10 MB. Kondisi tertentu dalam pipeline Anda dapat menyebabkan grafik tugas melebihi batas. Kondisi umum meliputi:
- Transformasi
Createyang menyertakan data dalam memori dalam jumlah besar. - Instance
DoFnbesar yang diserialisasi untuk transmisi ke worker jarak jauh. DoFnsebagai instance class dalam anonim yang (mungkin secara tidak sengaja) menarik sejumlah besar data untuk diserialisasi.- Directed acyclic graph (DAG) digunakan sebagai bagian dari loop terprogram yang menghitung daftar besar.
Untuk menghindari kondisi ini, pertimbangkan untuk merestrukturisasi pipeline Anda.
Key Commit Too Large
Saat menjalankan tugas streaming, error berikut muncul di file log worker:
KeyCommitTooLargeException
Error ini terjadi dalam skenario streaming setiap kali commit item tugas individual melebihi batas ukuran commit maksimum. Untuk mengetahui informasi selengkapnya tentang batas ukuran commit, lihat Kuota dan batas.
Jika commit melebihi batas, Dataflow akan menolak commit, menampilkan
KeyCommitTooLargeException di log worker, dan mencoba memproses ulang
item kerja menggunakan ukuran paket awal yang lebih kecil (pemotongan paket):
- Pengecualian sementara (pemotongan paket berhasil): Jika paket dapat
dipecah menjadi commit yang lebih kecil yang output-nya sesuai dengan batas, Anda mungkin
melihat satu atau beberapa error
KeyCommitTooLargeExceptionsebelum pipeline terus membuat progres. Namun, kecepatan pemrosesan akan berkurang untuk sementara karena percobaan ulang menggunakan paket yang lebih kecil. - Pengecualian berkelanjutan (penghentian pemrosesan kunci): Jika ukuran paket awal
dikurangi hingga satu pesan input atau timer dan
output atau modifikasi status yang dihasilkan masih melebihi batas commit, item
pekerjaan tidak dapat dibagi lebih lanjut. Karena Dataflow terus mencoba ulang dan gagal melakukan commit, pemrosesan untuk kunci tersebut akan berhenti sepenuhnya, dan log worker Anda akan menampilkan kemunculan
KeyCommitTooLargeExceptionyang berulang dan terus-menerus yang tidak dapat diselesaikan sendiri.
Strategi mitigasi
Untuk mengurangi kemungkinan terjadinya error ini, gunakan strategi berikut:
- Pastikan pemrosesan satu elemen atau jendela tidak dapat menghasilkan output atau modifikasi status yang melebihi batas ukuran commit. Misalnya, jika transformasi mengambil elemen input yang relatif kecil dan menampilkan output yang jauh lebih besar — seperti membaca nama file dan memunculkan seluruh konten file besar — output yang dihasilkan dapat melebihi batas ukuran commit meskipun hanya memproses satu elemen input.
- Jika beberapa elemen dikelompokkan menurut kunci tanpa menggunakan transformasi
Combine, pertimbangkan untuk meningkatkan ruang kunci (misalnya, dengan menambahkan bucket waktu atau ID sekunder) untuk mengurangi jumlah elemen yang dikelompokkan per kunci. - Jika elemen untuk kunci dikeluarkan dengan frekuensi tinggi dalam waktu singkat, hal ini dapat menghasilkan banyak GB peristiwa untuk kunci tersebut dalam satu periode. Tulis ulang pipeline untuk mendeteksi kunci frekuensi tinggi dan hanya menampilkan output yang menunjukkan bahwa kunci tersebut sering ada di jendela tersebut.
- Gunakan transformasi ruang sublinear
Combineuntuk operasi komutatif dan asosiatif. Jangan gunakan penggabung jika tidak mengurangi ukuran data. Misalnya, penggabung untuk string yang menambahkan string bersama-sama lebih buruk daripada tidak menggunakan penggabung.
Menolak pesan yang berukuran lebih dari 7.168 K
Saat Anda menjalankan tugas Dataflow yang dibuat dari template, tugas tersebut mungkin gagal dengan error berikut:
Error: CommitWork failed: status: APPLICATION_ERROR(3): Pubsub publish requests are limited to 10MB, rejecting message over 7168K (size MESSAGE_SIZE) to avoid exceeding limit with byte64 request encoding.
Error ini terjadi saat pesan yang ditulis ke antrean yang tidak bisa diproses melebihi batas ukuran 7168 K. Sebagai solusinya, aktifkan Streaming Engine, yang memiliki batas ukuran lebih tinggi. Untuk mengaktifkan Streaming Engine, gunakan opsi pipeline berikut.
Java
--enableStreamingEngine=true
Python
--enable_streaming_engine=true
Request Entity Too Large
Saat Anda mengirimkan tugas, salah satu error berikut akan muncul di konsol atau jendela terminal:
413 Request Entity Too Large
The size of serialized JSON representation of the pipeline exceeds the allowable limit
Failed to create a workflow job: Invalid JSON payload received
Failed to create a workflow job: Request payload exceeds the allowable limit
Jika Anda mengalami error terkait payload JSON saat mengirimkan tugas, representasi JSON pipeline Anda melebihi ukuran permintaan maksimum 20 MB.
Ukuran tugas Anda terkait dengan representasi JSON pipeline. Pipeline yang lebih besar berarti permintaan yang lebih besar. Dataflow memiliki batasan yang membatasi permintaan hingga 20 MB.
Untuk memperkirakan ukuran permintaan JSON pipeline Anda, jalankan pipeline dengan opsi berikut:
Java
--dataflowJobFile=PATH_TO_OUTPUT_FILE
Python
--dataflow_job_file=PATH_TO_OUTPUT_FILE
Go
Output tugas Anda sebagai JSON tidak didukung di Go.
Perintah ini menulis representasi JSON tugas Anda ke file. Ukuran file yang diserialisasi adalah perkiraan yang baik untuk ukuran permintaan. Ukuran sebenarnya sedikit lebih besar karena beberapa informasi tambahan yang disertakan dalam permintaan.
Kondisi tertentu dalam pipeline Anda dapat menyebabkan representasi JSON melebihi batas. Kondisi umum meliputi:
- Transformasi
Createyang menyertakan data dalam memori dalam jumlah besar. - Instance
DoFnbesar yang diserialisasi untuk transmisi ke worker jarak jauh. DoFnsebagai instance class dalam anonim yang (mungkin secara tidak sengaja) menarik sejumlah besar data untuk diserialisasi.
Untuk menghindari kondisi ini, pertimbangkan untuk merestrukturisasi pipeline Anda.
Opsi pipeline SDK atau daftar file staging melebihi batas ukuran
Saat menjalankan pipeline, salah satu error berikut terjadi:
SDK pipeline options or staging file list exceeds size limit.
Please keep their length under 256K Bytes each and 512K Bytes in total.
Atau:
Value for field 'resource.properties.metadata' is too large: maximum size
Error ini terjadi jika pipeline tidak dapat dimulai karena batas metadata Compute Engine terlampaui. Batas ini tidak dapat diubah. Dataflow menggunakan metadata Compute Engine untuk opsi pipeline. Batas ini didokumentasikan dalam batasan metadata kustom Compute Engine.
Skenario berikut dapat menyebabkan representasi JSON melebihi batas:
- Ada terlalu banyak file JAR yang akan di-stage.
- Kolom permintaan
sdkPipelineOptionsterlalu besar.
Untuk memperkirakan ukuran permintaan JSON pipeline Anda, jalankan pipeline dengan opsi berikut:
Java
--dataflowJobFile=PATH_TO_OUTPUT_FILE
Python
--dataflow_job_file=PATH_TO_OUTPUT_FILE
Go
Output tugas Anda sebagai JSON tidak didukung di Go.
Ukuran file output dari perintah ini harus kurang dari 256 KB. Ukuran 512 KB dalam pesan error mengacu pada ukuran total file output dan opsi metadata kustom untuk instance VM Compute Engine.
Anda bisa mendapatkan perkiraan kasar opsi metadata kustom untuk instance VM dari menjalankan tugas Dataflow dalam project. Pilih tugas Dataflow yang sedang berjalan. Ambil instance VM, lalu buka halaman detail instance VM Compute Engine untuk VM tersebut guna memeriksa bagian metadata kustom. Panjang total metadata kustom dan file harus kurang dari 512 KB. Perkiraan yang akurat untuk tugas yang gagal tidak dapat dilakukan, karena VM tidak diaktifkan untuk tugas yang gagal.
Jika daftar JAR Anda mencapai batas 256 KB, tinjau dan kurangi file JAR yang tidak diperlukan. Jika masih terlalu besar, coba jalankan tugas Dataflow menggunakan uber JAR. Untuk contoh yang menunjukkan cara membuat dan menggunakan uber JAR, lihat Membangun dan men-deploy Uber JAR.
Jika kolom permintaan sdkPipelineOptions terlalu besar, sertakan opsi berikut saat Anda menjalankan pipeline. Opsi pipeline sama untuk Java, Python, dan Go.
--experiments=no_display_data_on_gce_metadata
Kunci acak terlalu besar
Error berikut muncul di file log worker:
Shuffle key too large
Error ini terjadi jika kunci yang diserialisasi yang dikeluarkan ke (Co-)GroupByKey tertentu terlalu besar setelah coder yang sesuai diterapkan. Dataflow memiliki batas untuk kunci shuffle yang diserialisasi.
Untuk mengatasi masalah ini, kurangi ukuran kunci atau gunakan coder yang lebih hemat ruang.
Untuk mengetahui informasi selengkapnya, lihat batas produksi untuk Dataflow.
Caching input samping yang usang di jendela global
Saat menjalankan pipeline streaming menggunakan Apache Beam SDK untuk Python, input samping di jendela global mungkin mengalami penundaan yang tidak dapat diprediksi dalam update. Worker mungkin mempertahankan nilai input samping lama untuk jangka waktu yang lama, terutama saat memproses data input utama berkelanjutan. Masalah ini biasanya memengaruhi pipeline yang menggunakan Pub/Sub sebagai input utama dan samping.
Untuk mengatasi masalah ini, jika Anda menggunakan Apache Beam SDK versi 2.56.0 atau yang lebih baru,
aktifkan flag eksperimen disable_global_windowed_args_caching:
--experiments=disable_global_windowed_args_caching
Jumlah total objek BoundedSource ... lebih besar dari batas yang diizinkan
Salah satu error berikut mungkin terjadi saat menjalankan tugas dengan Java:
Total number of BoundedSource objects generated by splitIntoBundles() operation is larger than the allowable limit
Atau:
Total size of the BoundedSource objects generated by splitIntoBundles() operation is larger than the allowable limit
Java
Error ini dapat terjadi jika Anda membaca dari file dalam jumlah yang sangat besar
menggunakan TextIO, AvroIO, BigQueryIO melalui EXPORT, atau sumber berbasis file
lainnya. Batas tertentu bergantung pada detail sumber Anda, tetapi berada dalam urutan puluhan ribu file dalam satu pipeline. Misalnya, menyematkan skema di AvroIO.Read memungkinkan lebih sedikit file.
Error ini juga dapat terjadi jika Anda membuat sumber data kustom untuk pipeline dan metode splitIntoBundles sumber Anda menampilkan daftar objek BoundedSource yang menggunakan lebih dari 20 MB saat diserialisasi.
Batas yang diizinkan untuk ukuran total objek BoundedSource
yang dihasilkan oleh operasi splitIntoBundles() sumber kustom Anda adalah
20 MB.
Untuk mengatasi batasan ini, lakukan salah satu perubahan berikut:
Aktifkan Portable Runner. Runner Portabel mengonversi sumber menjadi DoFn yang dapat dibagi dan tidak memiliki batas pembagian sumber ini.
Ubah subclass
BoundedSourcekustom Anda sehingga ukuran total objekBoundedSourceyang dihasilkan lebih kecil dari batas 20 MB. Misalnya, sumber Anda mungkin menghasilkan lebih sedikit pemisahan pada awalnya, dan mengandalkan Penyeimbangan Ulang Tugas Dinamis untuk memisahkan input lebih lanjut sesuai permintaan.
Ukuran payload permintaan melebihi batas: 20.971.520 byte
Saat Anda menjalankan pipeline, tugas mungkin gagal dengan error berikut:
com.google.api.client.googleapis.json.GoogleJsonResponseException: 400 Bad Request
POST https://dataflow.googleapis.com/v1b3/projects/PROJECT_ID/locations/REGION/jobs/JOB_ID/workItems:reportStatus
{
  "code": 400,
  "errors": [
    {
      "domain": "global",
      "message": "Request payload size exceeds the limit: 20971520 bytes.",
      "reason": "badRequest"
    }
  ],
  "message": "Request payload size exceeds the limit: 20971520 bytes.",
  "status": "INVALID_ARGUMENT"
}
Error ini dapat terjadi saat tugas yang menggunakan runner Dataflow memiliki grafik tugas yang sangat besar. Grafik tugas yang besar dapat menghasilkan sejumlah besar metrik yang perlu dilaporkan kembali ke layanan Dataflow. Jika ukuran metrik ini melebihi batas permintaan API sebesar 20 MB, tugas akan gagal.
Untuk mengatasi masalah ini, migrasikan pipeline Anda untuk menggunakan Dataflow Portable Runner. Runner Portabel menggunakan metode yang lebih efisien untuk melaporkan metrik dan tidak memiliki batasan 20 MB ini.
ModuleNotFoundError: No module named 'pkg_resources'
Saat Anda menjalankan tugas Dataflow, error berikut terjadi selama startup worker atau penginstalan dependensi:
ModuleNotFoundError: No module named 'pkg_resources'
Masalah ini terjadi karena mulai setuptools versi 82.0.0 (dirilis pada
8 Februari 2026), modul pkg_resources telah dihapus. Modul ini sebelumnya tidak digunakan lagi dan telah diganti dengan importlib.resources dan importlib.metadata.
Untuk mengatasi masalah ini, gunakan salah satu metode berikut:
Sematkan
setuptools: Jika dependensi Anda memerlukan versisetuptoolsyang kompatibel dengan versi lama agar berhasil di-build, paksa persyaratan versi tertentu menggunakan argumensetup_requiresdalam filesetup.pyAnda. Misalnya:import setuptools setuptools.setup( name='PACKAGE-NAME', version='PACKAGE-VERSION', # Pin to a version prior to 82.0.0 setup_requires=['setuptools<82.0.0'], install_requires=['incompatible-package', ...], packages=setuptools.find_packages() )Update dependensi: Tinjau persyaratan library dan dependensi Anda untuk mengupdate ke versi yang lebih baru yang kompatibel dengan versi terbaru
setuptoolsdan tidak bergantung padapkg_resources.Hapus library yang tidak diperlukan: Hapus semua library dari file persyaratan atau penyiapan yang tidak diperlukan oleh tugas Anda. Misalnya, beberapa versi
cx_Oracleyang lebih lama telah diidentifikasi sebagai pemicu masalah ini selama proses build.
NameError
Saat Anda menjalankan pipeline menggunakan layanan Dataflow, error berikut akan terjadi:
NameError
Error ini tidak terjadi saat Anda mengeksekusi secara lokal, seperti saat Anda mengeksekusi menggunakan DirectRunner.
Error ini terjadi jika DoFn Anda menggunakan nilai di namespace global yang tidak tersedia di worker Dataflow.
Secara default, impor, fungsi, dan variabel global yang ditentukan dalam sesi utama tidak disimpan selama serialisasi tugas Dataflow.
Untuk mengatasi masalah ini, gunakan salah satu metode berikut. Jika DoFn Anda ditentukan dalam file utama dan mereferensikan impor dan fungsi di namespace global, tetapkan opsi pipeline --save_main_session ke True. Perubahan ini
mem-pickle status namespace global ke dan memuatnya di
worker Dataflow.
Jika Anda memiliki objek di namespace global yang tidak dapat di-pickle, error pickling akan terjadi. Jika error terkait modul yang seharusnya tersedia dalam distribusi Python, impor modul secara lokal, di tempat modul tersebut digunakan.
Misalnya, daripada:
import re
…
def myfunc():
  # use re module
penggunaan:
def myfunc():
  import re
  # use re module
Atau, jika DoFn Anda mencakup beberapa file, gunakan pendekatan yang berbeda untuk memaketkan alur kerja dan mengelola dependensi.
Objek tunduk pada kebijakan retensi bucket
Jika Anda memiliki tugas Dataflow yang menulis ke bucket Cloud Storage, tugas tersebut akan gagal dengan error berikut:
Object 'OBJECT_NAME' is subject to bucket's retention policy or object retention and cannot be deleted or overwritten
Anda mungkin juga melihat error berikut:
Unable to rename "gs://BUCKET"
Error pertama terjadi saat retensi objek diaktifkan di bucket Cloud Storage yang menjadi tujuan penulisan tugas Dataflow. Untuk mengetahui informasi selengkapnya, lihat Mengaktifkan dan menggunakan konfigurasi retensi objek.
Untuk mengatasi masalah ini, gunakan salah satu solusi berikut:
Tulis ke bucket Cloud Storage yang tidak memiliki kebijakan retensi di folder
temp.Hapus kebijakan retensi dari bucket yang menjadi tujuan penulisan tugas. Untuk mengetahui informasi selengkapnya, lihat Menetapkan konfigurasi retensi objek.
Error kedua dapat menunjukkan bahwa retensi objek diaktifkan di bucket Cloud Storage, atau dapat menunjukkan bahwa akun layanan worker Dataflow tidak memiliki izin untuk menulis ke bucket Cloud Storage.
Jika Anda melihat error kedua dan retensi objek diaktifkan di bucket Cloud Storage, coba solusi yang dijelaskan sebelumnya. Jika retensi objek tidak diaktifkan di bucket Cloud Storage, pastikan apakah akun layanan pekerja Dataflow memiliki izin tulis di bucket Cloud Storage. Untuk mengetahui informasi selengkapnya, lihat Mengakses bucket Cloud Storage.
Pemrosesan macet atau operasi sedang berlangsung
Jika Dataflow menghabiskan lebih banyak waktu untuk mengeksekusi DoFn daripada waktu
yang ditentukan dalam TIME_INTERVAL tanpa menampilkan, pesan berikut akan ditampilkan.
Java
Salah satu dari dua pesan log berikut, bergantung pada versinya:
Processing stuck in step STEP_NAME for at least TIME_INTERVAL
Operation ongoing in bundle BUNDLE_ID for at least TIME_INTERVAL without outputting or completing: at STACK_TRACE
Python
Operation ongoing for over TIME_INTERVAL in state STATE in step STEP_ID without returning. Current Traceback: TRACEBACK
Go
Operation ongoing in transform TRANSFORM_ID for at least TIME_INTERVAL without outputting or completing in state STATE
Perilaku ini memiliki dua kemungkinan penyebab:
- Kode
DoFnAnda lambat, atau menunggu beberapa operasi eksternal yang lambat selesai. - Kode
DoFnAnda mungkin macet, mengalami deadlock, atau sangat lambat dalam menyelesaikan pemrosesan.
Untuk menentukan kasusnya, luaskan entri log Cloud Monitoring untuk melihat stack trace. Cari pesan yang menunjukkan bahwa kode DoFn macet
atau mengalami masalah. Jika tidak ada pesan, masalahnya mungkin
kecepatan eksekusi kode DoFn. Pertimbangkan untuk menggunakan
Cloud Profiler atau alat lain untuk
menyelidiki performa kode Anda.
Jika pipeline Anda dibangun di Java VM (menggunakan Java atau Scala), Anda dapat menyelidiki penyebab kode yang macet. Ambil thread dump lengkap dari seluruh JVM (bukan hanya thread yang macet) dengan mengikuti langkah-langkah berikut:
- Catat nama worker dari entri log.
- Di bagian Compute Engine pada konsol Google Cloud , temukan instance Compute Engine dengan nama worker yang Anda catat.
- Gunakan SSH untuk terhubung ke instance dengan nama tersebut.
Jalankan perintah berikut:
curl http://localhost:8081/threadz
Operasi sedang berlangsung dalam paket
Saat Anda menjalankan pipeline yang membaca dari
JdbcIO,
pembacaan yang dipartisi dari JdbcIO lambat, dan pesan berikut muncul
di file log worker:
Operation ongoing in bundle process_bundle-[0-9-]* for PTransform{id=Read from JDBC with Partitions\/JdbcIO.Read\/JdbcIO.ReadAll\/ParDo\(Read\)\/ParMultiDo\(Read\).*, state=process} for at least (0[1-9]h[0-5][0-9]m[0-5][0-9]s) without outputting or completing:
Untuk mengatasi masalah ini, lakukan satu atau beberapa perubahan berikut pada pipeline Anda:
Gunakan partisi untuk meningkatkan paralelisme tugas. Baca dengan partisi yang lebih banyak dan lebih kecil untuk penskalaan yang lebih baik.
Periksa apakah kolom partisi adalah kolom indeks atau kolom partisi yang sebenarnya di sumber. Aktifkan pengindeksan dan partisi pada kolom ini di database sumber untuk mendapatkan performa terbaik.
Gunakan parameter
lowerBounddanupperBounduntuk melewati pencarian batas.
Error kuota Pub/Sub
Saat menjalankan pipeline streaming dari Pub/Sub, error berikut akan terjadi:
429 (rateLimitExceeded)
Atau:
Request was throttled due to user QPS limit being reached
Error ini terjadi jika project Anda tidak memiliki kuota Pub/Sub yang cukup.
Untuk mengetahui apakah project Anda tidak memiliki kuota yang cukup, ikuti langkah-langkah berikut untuk memeriksa error klien:
- Buka Google Cloud console.
- Di menu sebelah kiri, pilih APIs & services.
- Di Kotak Penelusuran, telusuri Cloud Pub/Sub.
- Klik tab Usage.
- Tinjau Kode Respons dan cari kode error klien
(4xx).
Permintaan dilarang oleh kebijakan organisasi
Saat menjalankan pipeline, error berikut terjadi:
Error trying to get gs://BUCKET_NAME/FOLDER/FILE:
{"code":403,"errors":[{"domain":"global","message":"Request is prohibited by organization's policy","reason":"forbidden"}],
"message":"Request is prohibited by organization's policy"}
Error ini terjadi jika bucket Cloud Storage berada di luar perimeter layanan Anda.
Untuk mengatasi masalah ini, buat aturan egress yang mengizinkan akses ke bucket di luar perimeter layanan.
Paket yang di-stage...tidak dapat diakses
Tugas yang biasanya berhasil mungkin gagal dengan error berikut:
Staged package...is inaccessible
Untuk menyelesaikan masalah ini:
- Pastikan bucket Cloud Storage yang digunakan untuk staging tidak memiliki setelan TTL yang menyebabkan paket yang di-stage dihapus.
Pastikan akun layanan worker project Dataflow Anda memiliki izin untuk mengakses bucket Cloud Storage yang digunakan untuk staging. Kesenjangan dalam izin dapat disebabkan oleh salah satu alasan berikut:
- Bucket Cloud Storage yang digunakan untuk staging ada di project yang berbeda.
- Bucket Cloud Storage yang digunakan untuk staging dimigrasikan dari akses terperinci ke akses level bucket yang seragam. Karena inkonsistensi antara kebijakan IAM dan ACL, memigrasikan bucket staging ke akses level bucket yang seragam akan melarang ACL untuk resource Cloud Storage. ACL mencakup izin yang dimiliki oleh akun layanan worker project Dataflow Anda atas bucket staging.
Untuk mengetahui informasi selengkapnya, lihat Mengakses bucket Cloud Storage di seluruh projectGoogle Cloud.
Item pekerjaan telah gagal 4 kali
Error berikut terjadi saat tugas batch gagal:
The job failed because a work item has failed 4 times.
Error ini terjadi jika satu operasi dalam tugas batch menyebabkan kode worker gagal empat kali. Dataflow menggagalkan tugas, dan pesan ini ditampilkan.
Saat berjalan dalam mode streaming, paket yang menyertakan item yang gagal akan dicoba ulang tanpa batas waktu, yang dapat menyebabkan pipeline Anda terhenti secara permanen.
Anda tidak dapat mengonfigurasi nilai minimum kegagalan ini. Untuk mengetahui detail selengkapnya, lihat penanganan error dan pengecualian pipeline.
Untuk mengatasi masalah ini, lihat log Cloud Monitoring dari tugas untuk empat kegagalan individual. Di log worker, cari entri log Error-level atau Fatal-level yang menampilkan pengecualian atau error. Pengecualian atau error akan muncul setidaknya empat kali. Jika log hanya berisi error waktu tunggu generik yang terkait dengan akses ke resource eksternal, seperti MongoDB, pastikan akun layanan worker memiliki izin untuk mengakses subnetwork resource.
Waktu Tunggu di File Hasil Polling
Untuk mengetahui informasi lengkap tentang cara memecahkan masalah error "Waktu tunggu habis dalam file hasil polling", lihat Memecahkan masalah Template Flex.
Write Correct File/Write/WriteImpl/PreFinalize gagal
Saat menjalankan tugas, tugas gagal sesekali, dan terjadi error berikut:
Workflow failed. Causes: S27:Write Correct File/Write/WriteImpl/PreFinalize failed., Internal Issue (ID): ID:ID, Unable to expand file pattern gs://BUCKET_NAME/temp/FILE
Error ini terjadi jika subfolder yang sama digunakan sebagai lokasi penyimpanan sementara untuk beberapa tugas yang berjalan secara serentak.
Untuk mengatasi masalah ini, jangan gunakan subfolder yang sama sebagai lokasi penyimpanan sementara untuk beberapa pipeline. Untuk setiap pipeline, sediakan subfolder unik untuk digunakan sebagai lokasi penyimpanan sementara.
Elemen melebihi ukuran pesan protobuf maksimum
Saat Anda menjalankan tugas Dataflow dan pipeline Anda memiliki elemen besar, Anda mungkin melihat error yang mirip dengan contoh berikut:
Exception serializing message!
ValueError: Message org.apache.beam.model.fn_execution.v1.Elements exceeds maximum protobuf size of 2GB
Atau:
Buffer size ... exceeds GRPC limit 2147483548. This is likely due to a single element that is too large.
Atau:
Output element size exceeds the allowed limit. (... > 83886080) See https://cloud.google.com/dataflow/quotas#limits for more details.
Anda mungkin juga melihat peringatan yang mirip dengan contoh berikut:
Data output stream buffer size ... exceeds 536870912 bytes. This is likely due to a large element in a PCollection.
Error ini terjadi jika pipeline Anda berisi elemen besar.
Untuk mengatasi masalah ini, jika Anda menggunakan Python SDK, upgrade ke Apache Beam versi 2.57.0 atau yang lebih baru. Python SDK versi 2.57.0 dan yang lebih baru meningkatkan pemrosesan elemen besar dan menambahkan logging yang relevan.
Jika error berlanjut setelah upgrade atau jika Anda tidak menggunakan Python SDK, identifikasi langkah dalam tugas tempat error terjadi, dan coba kurangi ukuran elemen dalam langkah tersebut.
Jika objek PCollection dalam pipeline Anda memiliki elemen besar, persyaratan RAM untuk pipeline akan meningkat. Elemen besar juga dapat menyebabkan error runtime, terutama saat melewati batas tahap gabungan.
Elemen besar dapat terjadi saat pipeline secara tidak sengaja mewujudkan iterable yang besar. Misalnya, pipeline yang meneruskan output operasi GroupByKey
ke operasi Reshuffle yang tidak diperlukan akan mewujudkan daftar sebagai elemen
tunggal. Daftar ini berpotensi berisi sejumlah besar nilai untuk setiap kunci.
Jika error terjadi pada langkah yang menggunakan input samping, perlu diketahui bahwa penggunaan input samping dapat menimbulkan hambatan fusi. Periksa apakah transformasi yang menghasilkan elemen besar dan transformasi yang menggunakannya termasuk dalam tahap yang sama.
Saat membuat pipeline, ikuti praktik terbaik berikut:
- Di
PCollections, gunakan beberapa elemen kecil, bukan satu elemen besar. - Menyimpan blob besar dalam sistem penyimpanan eksternal. Gunakan
PCollectionsuntuk meneruskan metadatanya, atau gunakan coder kustom yang mengurangi ukuran elemen. - Jika Anda harus meneruskan PCollection yang dapat melebihi 2 GB sebagai input samping, gunakan tampilan iterable, seperti
AsIterabledanAsMultiMap.
Ukuran maksimum untuk satu elemen dalam tugas Dataflow dibatasi hingga 2 GB (atau 80 MB untuk Streaming Engine). Untuk mengetahui informasi selengkapnya, baca Kuota dan batas.
Dataflow tidak dapat memproses transformasi terkelola...
Pipeline yang menggunakan I/O Terkelola mungkin gagal dengan error ini jika Dataflow tidak dapat mengupgrade secara otomatis transformasi I/O ke versi terbaru yang didukung. URN dan nama langkah yang diberikan dalam error harus menentukan transformasi mana yang gagal diupgrade oleh Dataflow.
Anda mungkin menemukan detail tambahan terkait error ini di
Logs Explorer di bagian
nama log Dataflow managed-transforms-worker dan
managed-transforms-worker-startup.
Jika Logs Explorer tidak memberikan informasi yang memadai untuk memecahkan masalah error, hubungi Cloud Customer Care.
Error tugas arsip
Bagian berikut berisi error umum yang mungkin Anda alami saat mencoba mengarsipkan tugas Dataflow menggunakan API.
Tidak ada nilai yang diberikan
Saat Anda mencoba mengarsipkan tugas Dataflow menggunakan API, error berikut mungkin terjadi:
The field mask specifies an update for the field job_metadata.user_display_properties.archived in job JOB_ID, but no value is provided. To update a field, please provide a field for the respective value.
Error ini terjadi karena salah satu alasan berikut:
Jalur yang ditentukan untuk kolom
updateMasktidak mengikuti format yang benar. Masalah ini dapat terjadi karena kesalahan ketik.JobMetadatatidak ditentukan dengan benar. Di kolomJobMetadata, untukuserDisplayProperties, gunakan key-value pair"archived":"true".
Untuk mengatasi error ini, pastikan perintah yang Anda teruskan ke API sesuai dengan format yang diperlukan. Untuk mengetahui detail selengkapnya, lihat Mengarsipkan lowongan.
API tidak mengenali nilai
Saat Anda mencoba mengarsipkan tugas Dataflow menggunakan API, error berikut mungkin terjadi:
The API does not recognize the value VALUE for the field job_metadata.user_display_properties.archived for job JOB_ID. REASON: Archived display property can only be set to 'true' or 'false'
Error ini terjadi jika nilai yang diberikan dalam key-value pair tugas arsip
bukan nilai yang didukung. Nilai yang didukung untuk pasangan nilai kunci tugas arsip adalah "archived":"true" dan "archived":"false".
Untuk mengatasi error ini, pastikan perintah yang Anda teruskan ke API sesuai dengan format yang diperlukan. Untuk mengetahui detail selengkapnya, lihat Mengarsipkan lowongan.
Tidak dapat memperbarui status dan mask secara bersamaan
Saat Anda mencoba mengarsipkan tugas Dataflow menggunakan API, error berikut mungkin terjadi:
Cannot update both state and mask.
Error ini terjadi saat Anda mencoba memperbarui status tugas dan status arsip dalam panggilan API yang sama. Anda tidak dapat melakukan update pada status tugas dan parameter kueri updateMask dalam panggilan API yang sama.
Untuk mengatasi error ini, perbarui status tugas dalam panggilan API terpisah. Lakukan pembaruan pada status tugas sebelum memperbarui status arsip tugas.
Modifikasi alur kerja gagal
Saat Anda mencoba mengarsipkan tugas Dataflow menggunakan API, error berikut mungkin terjadi:
Workflow modification failed.
Error ini biasanya terjadi saat Anda mencoba mengarsipkan tugas yang sedang berjalan.
Untuk mengatasi error ini, tunggu hingga tugas selesai sebelum mengarsipkannya. Tugas yang telah selesai memiliki salah satu status tugas berikut:
JOB_STATE_CANCELLEDJOB_STATE_DRAINEDJOB_STATE_DONEJOB_STATE_FAILEDJOB_STATE_UPDATED
Untuk mengetahui informasi selengkapnya, lihat Mendeteksi penyelesaian tugas Dataflow.
Error image container
Bagian berikut berisi error umum yang mungkin Anda alami saat menggunakan container kustom dan langkah-langkah untuk menyelesaikan atau memecahkan masalah error tersebut. Error biasanya diawali dengan pesan berikut:
Unable to pull container image due to error: DETAILED_ERROR_MESSAGE
Izin "containeranalysis.occurrences.list" ditolak
Error berikut muncul di file log Anda:
Error getting old patchz discovery occurrences: generic::permission_denied: permission "containeranalysis.occurrences.list" denied for project "PROJECT_ID", entity ID "" [region="REGION" projectNum=PROJECT_NUMBER projectID="PROJECT_ID"]
Container Analysis API tidak diaktifkan. Dalam beberapa kasus, Container Analysis API diperlukan untuk pemindaian kerentanan.
Natural Language API.
Untuk mengetahui informasi selengkapnya, lihat Ringkasan pemindaian OS dan Mengonfigurasi kontrol akses dalam dokumentasi Artifact Analysis.
Error saat menyinkronkan pod ... gagal "StartContainer"
Error berikut terjadi selama startup worker:
Error syncing pod POD_ID, skipping: [failed to "StartContainer" for CONTAINER_NAME with CrashLoopBackOff: "back-off 5m0s restarting failed container=CONTAINER_NAME pod=POD_NAME].
Pod adalah grup container Docker yang ditempatkan bersama dan berjalan di worker Dataflow. Error ini terjadi jika salah satu container Docker di pod gagal dimulai. Jika kegagalan tidak dapat dipulihkan, worker Dataflow tidak akan dapat dimulai, dan tugas batch Dataflow pada akhirnya akan gagal dengan error seperti berikut:
The Dataflow job appears to be stuck because no worker activity has been seen in the last 1h.
Error ini biasanya terjadi saat salah satu container terus mengalami error selama startup.
Untuk memahami penyebab utama, cari log yang diambil tepat sebelum kegagalan. Untuk menganalisis log, gunakan Logs Explorer. Di Logs Explorer, batasi file log ke entri log yang dikeluarkan dari worker dengan error startup container. Untuk membatasi entri log, selesaikan langkah-langkah berikut:
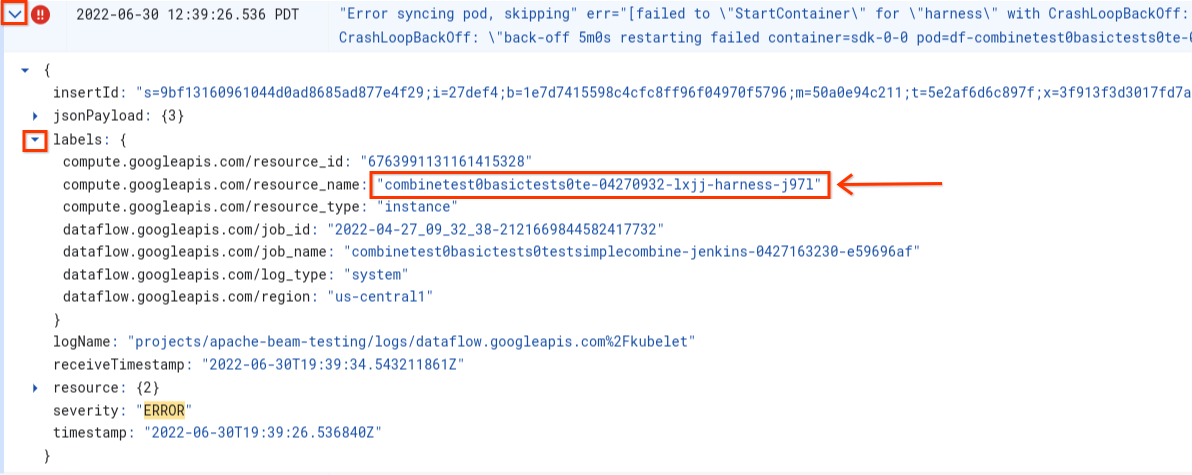
- Di Logs Explorer, temukan entri log
Error syncing pod. - Untuk melihat label yang terkait dengan entri log, luaskan entri log.
- Klik label yang terkait dengan
resource_name, lalu klik Show matching entries.
Di Logs Explorer, log Dataflow diatur ke dalam beberapa aliran log. Pesan Error syncing pod ditampilkan dalam log bernama
kubelet. Namun, log dari container yang gagal dapat berada dalam aliran log yang berbeda. Setiap container memiliki nama. Gunakan tabel berikut untuk menentukan
aliran log mana yang mungkin berisi log yang relevan dengan container yang gagal.
| Nama container | Nama log |
|---|---|
| sdk, sdk0, sdk1, sdk-0-0, dan yang serupa | docker |
| harness | harness, harness-startup |
| python, java-batch, java-streaming | worker-startup, worker |
| artefak | artefak |
Saat Anda membuat kueri Logs Explorer, pastikan kueri tersebut menyertakan nama log yang relevan di antarmuka pembuat kueri atau tidak memiliki batasan pada nama log.
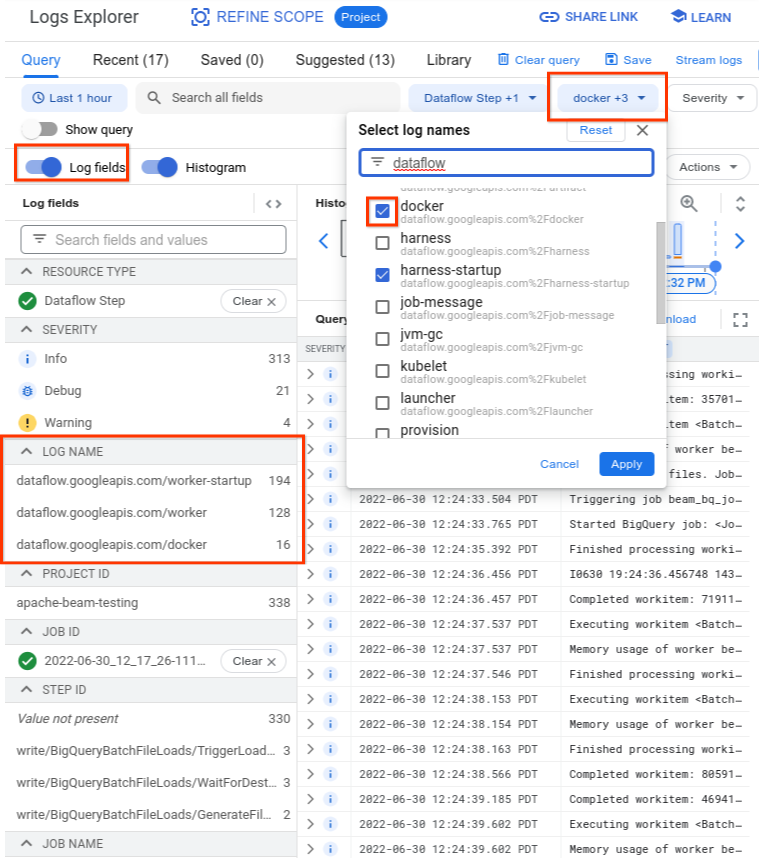
Setelah Anda memilih log yang relevan, hasil kueri mungkin akan terlihat seperti contoh berikut:
resource.type="dataflow_step"
resource.labels.job_id="2022-06-29_08_02_54-JOB_ID"
labels."compute.googleapis.com/resource_name"="testpipeline-jenkins-0629-DATE-cyhg-harness-8crw"
logName=("projects/apache-beam-testing/logs/dataflow.googleapis.com%2Fdocker"
OR
"projects/apache-beam-testing/logs/dataflow.googleapis.com%2Fworker-startup"
OR
"projects/apache-beam-testing/logs/dataflow.googleapis.com%2Fworker")
Karena log yang melaporkan gejala kegagalan container terkadang dilaporkan sebagai INFO, sertakan log INFO dalam analisis Anda.
Penyebab umum kegagalan container meliputi hal-hal berikut:
- Pipeline Python Anda memiliki dependensi tambahan yang diinstal saat runtime, dan penginstalan tidak berhasil. Anda mungkin melihat error seperti
pip install failed with error. Masalah ini mungkin terjadi karena persyaratan yang bertentangan, atau karena konfigurasi jaringan yang dibatasi yang mencegah worker Dataflow mengambil dependensi eksternal dari repositori publik melalui internet. Worker gagal di tengah-tengah operasi pipeline karena error kehabisan memori. Anda mungkin melihat error seperti salah satu error berikut:
java.lang.OutOfMemoryError: Java heap spaceShutting down JVM after 8 consecutive periods of measured GC thrashing. Memory is used/total/max = 24453/42043/42043 MB, GC last/max = 58.97/99.89 %, #pushbacks=82, gc thrashing=true. Heap dump not written.
Untuk men-debug masalah kehabisan memori, lihat Memecahkan masalah error kehabisan memori Dataflow.
Dataflow tidak dapat mengambil image container. Untuk mengetahui informasi selengkapnya, lihat Permintaan pull image gagal dengan error.
Container yang digunakan tidak kompatibel dengan arsitektur CPU worker VM. Dalam log startup harness, Anda mungkin melihat error seperti berikut:
exec
/opt/apache/beam/boot: exec format error
. Untuk memeriksa arsitektur image container, jalankandocker image inspect $IMAGE:$TAGdan cari kata kunciArchitecture. Jika tertulisError: No such image: $IMAGE:$TAG, Anda mungkin perlu mengambil image terlebih dahulu dengan menjalankandocker pull $IMAGE:$TAG. Untuk mengetahui informasi tentang cara membangun image multi-arsitektur, lihat Membangun image container multi-arsitektur.
Setelah Anda mengidentifikasi error yang menyebabkan container gagal, coba atasi error tersebut, lalu kirim ulang pipeline.
Peluncuran template gagal dengan error
Selama startup template fleksibel, error berikut muncul di log tugas:
Error: Template launch failed: exit status 13
Error occurred in the launcher container: Template launch failed. See console logs.
Log worker berisi stacktrace yang mirip dengan log rekaman aktivitas berikut:
TypeError: canonicalize_version() got an unexpected keyword argument 'strip_trailing_zero'
ERROR:absl:Internal Error Type : RuntimeError
ERROR:absl:Error Message : Full trace: Traceback (most recent call last):
File "/usr/local/lib/python3.9/site-packages/apache_beam/utils/processes.py", line 89, in check_output
out = subprocess.check_output(*args, **kwargs)
IFile "/usr/local/lib/python3.9/subprocess.py", line 424, in check_output
return run(*popenargs, stdout=PIPE, timeout=timeout, check=True,
File "/usr/local/lib/python3.9/subprocess.py", line 528, in run
raise CalledProcessError(retcode, process.args,
subprocess.CalledProcessError: Command '['/usr/local/bin/python', 'setup.py', 'sdist', '--dist-dir', '/tmp/tmp196n6g8d']' returned non-zero exit status 1.
Error ini terjadi jika peluncur template menemukan dependensi yang bertentangan selama
penyiapan, khususnya saat
paket setuptools diupdate ke versi yang lebih tinggi atau sama dengan 71.0. Tinjau
dependensi pipeline Anda dan pastikan dependensi pengemasan lebih tinggi atau
sama dengan 25.0.
Permintaan pull image gagal dengan error
Selama startup worker, salah satu error berikut akan muncul di log worker atau tugas:
Image pull request failed with error
pull access denied for IMAGE_NAME
manifest for IMAGE_NAME not found: manifest unknown: Failed to fetch
Get IMAGE_NAME: Service Unavailable
Error ini terjadi jika worker tidak dapat memulai karena worker tidak dapat melakukan pull image container Docker. Masalah ini terjadi dalam skenario berikut:
- URL image container SDK kustom salah
- Worker tidak memiliki kredensial atau akses jaringan ke image jarak jauh
Untuk menyelesaikan masalah ini:
- Jika Anda menggunakan image container kustom dengan tugas Anda, pastikan URL image Anda sudah benar dan memiliki tag atau ringkasan yang valid. Worker Dataflow juga memerlukan akses ke image.
- Pastikan image publik dapat ditarik secara lokal dengan menjalankan
docker pull
$image
dari mesin yang tidak diautentikasi.
Untuk image pribadi atau worker pribadi:
- Jika Anda menggunakan Container Registry untuk menghosting image container, sebaiknya gunakan Artifact Registry. Mulai 15 Mei 2023, Container Registry tidak digunakan lagi. Jika menggunakan Container Registry, Anda dapat beralih ke Artifact Registry. Jika image Anda berada dalam project yang berbeda dengan project yang digunakan untuk menjalankan tugasGoogle Cloud , konfigurasikan kontrol akses untuk akun layanan Google Cloud default.
- Jika menggunakan Virtual Private Cloud (VPC) bersama, pastikan worker dapat mengakses host repositori container kustom.
- Gunakan
sshuntuk terhubung dengan worker VM tugas yang sedang berjalan dan jalankandocker pull $imageuntuk mengonfirmasi secara langsung bahwa worker dikonfigurasi dengan benar.
Jika worker gagal beberapa kali berturut-turut karena error ini dan pekerjaan telah dimulai pada suatu tugas, tugas tersebut dapat gagal dengan error yang mirip dengan pesan berikut:
Job appears to be stuck.
Jika Anda menghapus akses ke image saat tugas sedang berjalan, baik dengan menghapus image itu sendiri atau mencabut Kredensial Akun Layanan pekerja Dataflow atau akses internet untuk mengakses image, Dataflow hanya akan mencatat error ke dalam log. Dataflow tidak akan menggagalkan tugas. Dataflow juga menghindari kegagalan pipeline streaming yang berjalan lama untuk menghindari kehilangan status pipeline.
Error lain yang mungkin terjadi dapat disebabkan oleh masalah kuota repositori atau pemadaman layanan. Jika Anda mengalami masalah yang melebihi kuota Docker Hub untuk mengambil image publik atau pemadaman layanan repositori pihak ketiga secara umum, pertimbangkan untuk menggunakan Artifact Registry sebagai repositori image.
SystemError: unknown opcode
Pipeline container kustom Python Anda mungkin gagal dengan error berikut segera setelah pengiriman tugas:
SystemError: unknown opcode
Selain itu, stack trace mungkin menyertakan
apache_beam/internal/pickler.py
Untuk mengatasi masalah ini, pastikan versi Python yang Anda gunakan secara lokal cocok dengan versi di image container hingga versi utama dan minor. Perbedaan dalam versi patch, seperti 3.6.7 versus 3.6.8, tidak menimbulkan masalah kompatibilitas. Perbedaan versi minor, seperti 3.6.8 versus 3.8.2, dapat menyebabkan kegagalan pipeline.
Error saat mengupgrade pipeline streaming
Untuk mengetahui informasi tentang cara mengatasi error saat Anda mengupgrade pipeline streaming menggunakan fitur seperti menjalankan tugas penggantian paralel, lihat Memecahkan masalah upgrade pipeline streaming.
Update harness Portable Runner
Pesan info berikut muncul di log tugas dari tugas Portable Runner
The Dataflow Portable Runner container image of this job's workers will be ready for update in 7 days.
Artinya, versi proses runner harness akan otomatis diupdate pada suatu waktu 7 hari setelah pengiriman pesan awal, sehingga menyebabkan jeda singkat dalam pemrosesan. Jika Anda ingin mengontrol kapan jeda ini terjadi, lihat Memperbarui pipeline yang ada untuk memulai tugas penggantian yang akan memiliki versi terbaru runner harness.
Error worker
Bagian berikut berisi error worker umum yang mungkin Anda alami dan langkah-langkah untuk menyelesaikan atau memecahkan masalah error tersebut.
Panggilan dari harness worker Java ke DoFn Python gagal dengan status error
Jika panggilan dari harness worker Java ke DoFn Python gagal, pesan error yang relevan akan ditampilkan.
Untuk menyelidiki error, luaskan entri log error Cloud Monitoring, lalu lihat pesan error dan traceback. Alat ini menunjukkan kode mana yang gagal sehingga Anda dapat memperbaikinya jika perlu. Jika Anda yakin bahwa error tersebut adalah bug di Apache Beam atau Dataflow, laporkan bug tersebut.
EOFError: marshal data too short
Error berikut muncul di log worker:
EOFError: marshal data too short
Error ini terkadang terjadi saat worker pipeline Python kehabisan kapasitas disk.
Untuk mengatasi masalah ini, lihat Tidak ada ruang tersisa di perangkat.
Gagal memasang disk
Saat Anda mencoba meluncurkan tugas Dataflow yang menggunakan VM C3 dengan Persistent Disk, tugas tersebut akan gagal dengan salah satu atau kedua error berikut:
Failed to attach disk(s), status: generic::invalid_argument: One or more operations had an error
Can not allocate sha384 (reason: -2), Spectre V2 : WARNING: Unprivileged eBPF is enabled with eIBRS on...
Error ini terjadi saat Anda menggunakan VM C3 dengan jenis Persistent Disk yang tidak didukung. Untuk mengetahui informasi selengkapnya, lihat Jenis disk yang didukung untuk C3.
Untuk menggunakan VM C3 dengan tugas Dataflow Anda, pilih jenis disk worker pd-ssd. Untuk mengetahui informasi selengkapnya, lihat Opsi tingkat worker.
Java
--workerDiskType=pd-ssd
Python
--worker_disk_type=pd-ssd
Go
disk_type=pd-ssd
No space left on device
Jika tugas kehabisan kapasitas disk, error berikut mungkin muncul di log worker:
No space left on device
Error ini dapat terjadi karena salah satu alasan berikut:
- Penyimpanan persisten worker kehabisan ruang kosong, yang dapat terjadi karena
salah satu alasan berikut:
- Tugas mendownload dependensi besar saat runtime
- Tugas menggunakan container kustom yang besar
- Tugas menulis banyak data sementara ke disk lokal
- Saat menggunakan Dataflow Shuffle, Dataflow menetapkan ukuran disk default yang lebih rendah. Akibatnya, error ini mungkin terjadi pada tugas yang berpindah dari shuffle berbasis worker.
- Boot disk worker penuh karena mencatat lebih dari 50 entri per detik.
Untuk menyelesaikan masalah ini, ikuti langkah-langkah pemecahan masalah berikut:
Untuk melihat resource disk yang terkait dengan satu worker, cari detail instance VM untuk worker VM yang terkait dengan tugas Anda. Sebagian kapasitas disk digunakan oleh sistem operasi, biner, log, dan container.
Untuk meningkatkan kapasitas persistent disk atau boot disk, sesuaikan opsi pipeline ukuran disk.
Lacak penggunaan kapasitas disk pada instance worker VM menggunakan Cloud Monitoring. Lihat Menerima metrik worker VM dari agen Monitoring untuk mengetahui petunjuk yang menjelaskan cara menyiapkannya.
Cari masalah kapasitas boot disk dengan Melihat output port serial di instance worker VM dan mencari pesan seperti:
Failed to open system journal: No space left on device
Jika memiliki banyak instance worker VM, Anda dapat membuat skrip untuk menjalankan gcloud
compute instances get-serial-port-output di semua instance sekaligus. Sebagai gantinya, Anda dapat meninjau output tersebut.
Pipeline Python gagal setelah satu jam tidak ada aktivitas worker
Saat menggunakan Apache Beam SDK untuk Python dengan Runner Portabel Dataflow di mesin worker dengan banyak core CPU, gunakan Apache Beam SDK 2.35.0 atau yang lebih baru. Jika tugas Anda menggunakan container kustom, gunakan Apache Beam SDK 2.46.0 atau yang lebih baru.
Pertimbangkan untuk melakukan pra-build container Python Anda. Langkah ini dapat meningkatkan waktu startup VM dan performa penskalaan otomatis horizontal. Untuk menggunakan fitur ini, aktifkan Cloud Build API di project Anda dan kirimkan pipeline dengan parameter berikut:
‑‑prebuild_sdk_container_engine=cloud_build.
Untuk mengetahui informasi selengkapnya, lihat Runner Portabel Dataflow.
Anda juga dapat menggunakan image container kustom dengan semua dependensi yang telah diinstal sebelumnya.
RESOURCE_POOL_EXHAUSTED atau IP_SPACE_EXHAUSTED_WITH_DETAILS
Saat Anda membuat resource Google Cloud , salah satu error pembuatan worker pool berikut mungkin terjadi.
Nama VM INSTANCE_NAME mewakili nama worker VM. Worker VM adalah instance Compute Engine terkelola sepenuhnya yang menjalankan tugas pipeline pemrosesan data Anda.
ZONE_RESOURCE_POOL_EXHAUSTED_WITH_DETAILS
Startup of the worker pool in zone ZONE_NAME failed to bring up any of the desired NUMBER workers. ZONE_RESOURCE_POOL_EXHAUSTED_WITH_DETAILS: Instance 'INSTANCE_NAME' creation failed: The zone 'projects/PROJECT_ID/zones/ZONE_NAME' does not have enough resources available to fulfill the request. '(resource type:RESOURCE_TYPE)'.
Error ini terjadi karena jenis worker VM yang diminta tidak tersedia untuk sementara. Secara default, Dataflow memilih jenis mesin untuk worker VM yang menjalankan tugas Anda, beserta ukuran dan jenis Persistent Disk.
Untuk mengatasi masalah ini, gunakan salah satu strategi berikut:
- Perbarui worker VM ke jenis mesin yang berbeda dan coba lagi tugas tersebut.
- Luncurkan tugas Dataflow Anda dari region yang berbeda.
Aktifkan Pemilihan VM Otomatis menggunakan petunjuk resource
min_ramataucpu_count. Dengan Pemilihan VM Otomatis, worker disediakan dari daftar jenis mesin yang diseleksi yang memenuhi persyaratan RAM dan CPU Anda, yang dapat membantu mencegah masalah kehabisan kumpulan resource.Catatan: Jika Pemilihan VM Otomatis diaktifkan, semua jenis mesin yang ditentukan dalam opsi pipeline akan diabaikan.
Untuk membuat penanganan error untuk jenis skenario ini, Anda juga dapat membuat loop percobaan ulang untuk tugas Anda. Jika terjadi error kehabisan resource, tugas akan otomatis mencoba ulang hingga resource tersedia. Untuk membuat loop percobaan ulang, ikuti alur kerja berikut:
- Buat tugas Dataflow, dan dapatkan ID pekerjaan.
- Lakukan polling status tugas hingga status tugas menjadi
RUNNINGatauFAILED.- Jika status tugas adalah
RUNNING, keluar dari loop percobaan ulang. - Jika status tugas adalah
FAILED, gunakan Cloud Logging API untuk mengkueri log tugas untuk stringZONE_RESOURCE_POOL_EXHAUSTED_WITH_DETAILS. Untuk mengetahui informasi selengkapnya, lihat Menggunakan log pipeline.- Jika log tidak berisi string, keluar dari loop percobaan ulang.
- Jika log berisi string, buat tugas Dataflow, dapatkan ID pekerjaan, dan mulai ulang loop percobaan ulang.
- Jika status tugas adalah
Terakhir, pertimbangkan untuk menerapkan praktik terbaik dalam mendistribusikan resource Anda di beberapa zona dan region untuk menoleransi pemadaman layanan.
IP_SPACE_EXHAUSTED_WITH_DETAILS
Startup of the worker pool in REGION_NAME failed to bring up any of the desired NUMBER workers. ... IP_SPACE_EXHAUSTED_WITH_DETAILS: Instance 'INSTANCE_NAME' creation failed: IP space of 'projects/PROJECT_ID/regions/REGION_NAME/subnetworks/SUBNETWORK_NAME' is exhausted. Insufficient free IP addresses in the IP range 'IP_RANGE'. Consider expanding the current IP range or selecting an alternative IP range. If this is a secondary range, consider adding an additional secondary range.
Error ini terjadi jika subnetwork yang ditetapkan ke tugas Dataflow tidak memiliki alamat IP kosong yang cukup untuk menyediakan jumlah worker VM yang diminta.
Untuk mengatasi masalah ini, gunakan salah satu strategi berikut:
- Perluas rentang IP utama subnetwork.
- Jika Anda menggunakan rentang sekunder, tambahkan rentang sekunder tambahan.
- Pilih subnetwork atau rentang IP alternatif dengan alamat IP yang tersedia dan memadai.
Error dependensi runtime
Saat Anda menjalankan tugas Dataflow yang menggunakan Apache Beam SDK untuk Python dengan transformasi lintas bahasa, tugas tersebut mungkin gagal dengan error HTTP Error
403: Forbidden saat mendownload file JAR dari Maven Central.
Masalah ini disebabkan oleh perubahan pada penyedia CDN Maven Central, yang memblokir
permintaan dari library urllib Python yang digunakan oleh Apache Beam SDK.
Untuk mengatasi masalah ini, upgrade ke Apache Beam versi 2.69.0 atau yang lebih baru. Jika Anda tidak dapat mengupgrade, lihat solusi di bagian ini.
Perbaikan di Apache Beam 2.69.0 dan yang lebih baru
Apache Beam 2.69.0 dan yang lebih baru menyertakan perbaikan berikut:
URL Repositori Maven Kustom: Anda dapat menentukan repositori Maven kustom menggunakan opsi pipeline
--maven_repository_url. Contoh:--maven_repository_url https://maven-central.storage-download.googleapis.com/maven2/Identifikasi Agen Pengguna: Apache Beam SDK mengirimkan header
User-Agenttertentu untuk mencegah permintaan diblokir.
Solusi untuk SDK lama
Jika Anda tidak dapat mengupgrade ke Apache Beam 2.69.0 atau yang lebih baru, gunakan salah satu solusi berikut:
- Mengemas JAR dalam container kustom (Direkomendasikan): Kemas file JAR yang diperlukan dalam image container kustom Anda. Tempatkan JAR di direktori cache Apache Beam (
/root/.apache_beam/cache/jars/) untuk mencegah SDK mendownloadnya saat runtime. Gunakan duplikasi Maven Google: Gunakan opsi pipeline
--expansion_serviceuntuk menginstruksikan Apache Beam SDK agar mendownload JAR yang diperlukan dari duplikasi Maven Central Google. Contoh:--expansion_service https://maven-central.storage-download.googleapis.com/maven2/org/apache/beam/beam-sdks-java-extensions-schemaio-expansion-service/BEAM_VERSION/beam-sdks-java-extensions-schemaio-expansion-service-BEAM_VERSION.jarMenyiapkan JAR di Cloud Storage: Download JAR yang diperlukan, siapkan di bucket Cloud Storage, lalu berikan jalur Cloud Storage JAR ke opsi pipeline
--expansion_service.
Instance dengan akselerator tamu tidak mendukung migrasi langsung
Pipeline Dataflow gagal saat pengiriman tugas dengan error berikut:
UNSUPPORTED_OPERATION: Instance <worker_instance_name> creation failed:
Instances with guest accelerators do not support live migration
Error ini dapat terjadi jika Anda telah meminta jenis mesin worker yang memiliki akselerator hardware, tetapi Anda belum mengonfigurasi Dataflow untuk menggunakan akselerator.
Gunakan opsi layanan Dataflow --worker_accelerator atau petunjuk resource accelerator untuk meminta akselerator hardware.
Jika menggunakan template Flex, Anda dapat menggunakan opsi --additionalExperiments untuk menyediakan opsi layanan Dataflow. Jika dilakukan dengan benar, opsi worker_accelerator dapat ditemukan di Job info panel tugas di konsolGoogle Cloud .
Project quota ... or access control policies preventing the operation
Error berikut akan terjadi:
Startup of the worker pool in zone ZONE_NAME failed to bring up any of the desired NUMBER workers. The project quota may have been exceeded or access control policies may be preventing the operation; review the Cloud Logging 'VM Instance' log for diagnostics.
Error ini terjadi karena salah satu alasan berikut:
- Anda telah melampaui salah satu kuota Compute Engine yang menjadi dasar pembuatan worker Dataflow.
- Organisasi Anda memiliki batasan yang melarang beberapa aspek proses pembuatan instance VM, seperti akun yang digunakan, atau zona yang ditargetkan.
Untuk menyelesaikan masalah ini, ikuti langkah-langkah pemecahan masalah berikut:
Meninjau log Instance VM
- Buka Cloud Logging viewer
- Di menu drop-down Audited Resource, pilih VM Instance.
- Di menu drop-down All logs, pilih compute.googleapis.com/activity_log.
- Pindai log untuk menemukan entri yang terkait dengan kegagalan pembuatan instance VM.
Memeriksa penggunaan kuota Compute Engine
Untuk melihat penggunaan resource Compute Engine dibandingkan dengan kuota Dataflow untuk zona yang Anda targetkan, jalankan perintah berikut:
gcloud compute regions describe [REGION]Tinjau hasil untuk resource berikut guna melihat apakah ada yang melebihi kuota:
- CPU
- DISKS_TOTAL_GB
- IN_USE_ADDRESSES
- INSTANCE_GROUPS
- INSTANCE
- REGIONAL_INSTANCE_GROUP_MANAGERS
Jika perlu, minta perubahan kuota.
Meninjau batasan kebijakan organisasi Anda
- Buka halaman Organization policies
- Tinjau batasan yang mungkin membatasi pembuatan instance VM untuk akun yang Anda gunakan (secara default, akun layanan Dataflow) atau di zona yang Anda targetkan.
- Jika Anda memiliki kebijakan yang membatasi penggunaan alamat IP eksternal, nonaktifkan alamat IP eksternal untuk tugas ini. Untuk mengetahui informasi selengkapnya tentang cara menonaktifkan alamat IP eksternal, lihat Mengonfigurasi aturan akses internet dan firewall.
Waktu tunggu habis saat menunggu update dari worker
Jika tugas Dataflow gagal, error berikut akan terjadi:
Root cause: Timed out waiting for an update from the worker. For more information, see https://cloud.google.com/dataflow/docs/guides/common-errors#worker-lost-contact.
Beberapa penyebab dapat menyebabkan error ini, termasuk:
Kelebihan beban worker
Terkadang, error waktu tunggu terjadi saat worker kehabisan memori atau ruang swap. Untuk mengatasi masalah ini, sebagai langkah pertama, coba jalankan tugas lagi. Jika tugas masih gagal dan error yang sama terjadi, coba gunakan worker dengan memori dan kapasitas disk yang lebih besar. Misalnya, tambahkan opsi startup pipeline berikut:
--worker_machine_type=m1-ultramem-40 --disk_size_gb=500
Mengubah jenis worker dapat memengaruhi biaya yang ditagih. Untuk mengetahui informasi selengkapnya, lihat Memecahkan masalah error kehabisan memori Dataflow.
Error ini juga dapat terjadi jika data Anda berisi hot key. Dalam skenario ini, penggunaan CPU tinggi pada beberapa worker selama sebagian besar durasi tugas. Namun, jumlah worker tidak mencapai jumlah maksimum yang diizinkan. Untuk mengetahui informasi selengkapnya tentang hot key dan kemungkinan solusinya, lihat Menulis pipeline Dataflow dengan mempertimbangkan skalabilitas.
Untuk solusi tambahan terkait masalah ini, lihat Hot key ... terdeteksi.
Python: Global Interpreter Lock (GIL)
Jika kode Python Anda memanggil kode C/C++ menggunakan mekanisme ekstensi Python, periksa apakah kode ekstensi merilis Global Interpreter Lock (GIL) Python di bagian kode yang intensif secara komputasi yang tidak mengakses status Python. Jika
GIL tidak dirilis dalam jangka waktu yang lama, Anda mungkin melihat pesan error
seperti: Unable to retrieve status info from SDK harness <...> within allowed time
dan SDK worker appears to be permanently unresponsive. Aborting the SDK.
Library yang memfasilitasi interaksi dengan ekstensi seperti
Cython,
dan
PyBind
memiliki primitif untuk mengontrol status GIL. Anda juga dapat merilis GIL secara manual dan
memperolehnya kembali sebelum mengembalikan kontrol ke penafsir Python menggunakan
makro Py_BEGIN_ALLOW_THREADS dan Py_END_ALLOW_THREADS. Untuk mengetahui informasi selengkapnya, lihat Status Thread dan Global Interpreter Lock dalam dokumentasi Python.
Anda mungkin dapat mengambil stacktrace thread yang menyimpan GIL pada worker Dataflow yang sedang berjalan sebagai berikut:
# SSH into a running Dataflow worker VM that is currently a straggler, for example:
gcloud compute ssh --zone "us-central1-a" "worker-that-emits-unable-to-retrieve-status-messages" --project "project-id"

# Install nerdctl to inspect a running container with ptrace privileges.
wget https://github.com/containerd/nerdctl/releases/download/v2.0.2/nerdctl-2.0.2-linux-amd64.tar.gz
sudo tar Cxzvvf /var/lib/toolbox  nerdctl-2.0.2-linux-amd64.tar.gz
alias nerdctl="sudo /var/lib/toolbox/nerdctl -n k8s.io"

# Find a container running the Python SDK harness.
CONTAINER_ID=`nerdctl ps | grep sdk-0-0 | awk '{print $1}'`

# Start a shell in the running container.
nerdctl exec --privileged -it $CONTAINER_ID /bin/bash

# Inspect python processes in the running container.
ps -A | grep python
PYTHON_PID=$(ps -A | grep python | head -1 | awk '{print $1}')

# Use pystack to retrieve stacktraces from the python process.
pip install pystack

pystack remote --native $PYTHON_PID

# Find which thread holds the GIL and inspect the stacktrace.
pystack remote --native $PYTHON_PID | grep -iF "Has the GIL" -A 100

# Alternately, use inspect with gdb.
apt update && apt install -y gdb
gdb --quiet \
  --eval-command="set pagination off" \
  --eval-command="thread apply all bt" \
  --eval-command "set confirm off" \
  --eval-command="quit"  -p $PYTHON_PID
Dalam pipeline Python, pada konfigurasi default, Dataflow mengasumsikan bahwa setiap proses Python yang berjalan di worker menggunakan satu inti vCPU secara efisien. Jika kode pipeline mengabaikan batasan GIL, misalnya dengan menggunakan library yang diimplementasikan dalam C++, elemen pemrosesan mungkin menggunakan resource dari lebih dari satu core vCPU, dan worker mungkin tidak mendapatkan resource CPU yang cukup. Untuk mengatasi masalah ini, kurangi jumlah thread pada worker.
Penyiapan DoFn yang berjalan lama
Jika Anda tidak menggunakan Portable Runner, panggilan yang berjalan lama ke DoFn.Setup dapat
menyebabkan error berikut:
Timed out waiting for an update from the worker
Secara umum, hindari operasi yang memakan waktu di dalam DoFn.Setup.
Error sementara saat memublikasikan ke topik
Saat tugas streaming Anda menggunakan mode streaming setidaknya sekali dan memublikasikan ke sink Pub/Sub, error berikut akan muncul di log tugas:
There were transient errors publishing to topic
Jika tugas Anda berjalan dengan benar, error ini tidak berbahaya, dan Anda dapat mengabaikannya. Dataflow otomatis mencoba ulang pengiriman pesan Pub/Sub dengan penundaan backoff.
Tidak dapat mengambil data karena ketidakcocokan token untuk kunci
Error berikut berarti item pekerjaan yang sedang diproses telah dialokasikan ulang ke worker lain:
Unable to fetch data due to token mismatch for key
Hal ini paling sering terjadi selama penskalaan otomatis, tetapi dapat terjadi kapan saja. Pekerjaan apa pun yang terpengaruh akan dicoba lagi. Anda dapat mengabaikan error ini.
Masalah dependensi Java
Class dan library yang tidak kompatibel dapat menyebabkan masalah dependensi Java. Jika pipeline Anda mengalami masalah dependensi Java, salah satu error berikut mungkin terjadi:
NoClassDefFoundError: Error ini terjadi saat seluruh class tidak tersedia selama runtime. Hal ini dapat disebabkan oleh masalah konfigurasi umum atau ketidakcocokan antara versi protobuf Beam dan proto yang dihasilkan klien (misalnya, masalah ini).NoSuchMethodError: Error ini terjadi saat class di classpath menggunakan versi yang tidak berisi metode yang benar atau saat tanda tangan metode berubah.
NoSuchFieldError: Error ini terjadi saat class di classpath menggunakan versi yang tidak memiliki kolom yang diperlukan selama runtime.FATAL ERROR in native method: Error ini terjadi saat dependensi bawaan tidak dapat dimuat dengan benar. Saat menggunakan uber JAR (shaded), jangan sertakan library yang menggunakan tanda tangan (seperti Conscrypt) dalam JAR yang sama.
Jika pipeline Anda berisi kode dan setelan khusus pengguna, kode tersebut tidak boleh berisi versi library yang beragam. Jika Anda menggunakan library pengelolaan dependensi, sebaiknya gunakan BOM LibraryGoogle Cloud .
Jika Anda menggunakan Apache Beam SDK, untuk mengimpor BOM library yang benar, gunakan beam-sdks-java-io-google-cloud-platform-bom:
Maven
<dependencyManagement>
  <dependencies>
    <dependency>
      <groupId>org.apache.beam</groupId>
      <artifactId>beam-sdks-java-google-cloud-platform-bom</artifactId>
      <version>BEAM_VERSION</version>
      <type>pom</type>
      <scope>import</scope>
    </dependency>
  </dependencies>
</dependencyManagement>
Gradle
dependencies {
    implementation(platform("org.apache.beam:beam-sdks-java-google-cloud-platform-bom:BEAM_VERSION"))
}
Untuk mengetahui informasi selengkapnya, lihat Mengelola dependensi pipeline di Dataflow.
InaccessibleObjectException di JDK 17 dan yang lebih baru
Saat Anda menjalankan pipeline dengan Java Platform, Standard Edition Development Kit (JDK) versi 17 dan yang lebih baru, error berikut mungkin muncul di file log worker:
Unable to make protected METHOD accessible:
    module java.MODULE does not "opens java.MODULE" to ...
Masalah ini terjadi karena mulai Java versi 9, opsi Java Virtual Machine (JVM) modul terbuka diperlukan untuk mengakses internal JDK. Di Java 16 dan versi yang lebih baru, opsi JVM modul terbuka selalu diperlukan untuk mengakses internal JDK.
Untuk mengatasi masalah ini, saat Anda meneruskan modul ke pipeline Dataflow untuk dibuka, gunakan format MODULE/PACKAGE=TARGET_MODULE(,TARGET_MODULE)* dengan opsi pipeline jdkAddOpenModules. Format ini memungkinkan akses ke library yang diperlukan.
Misalnya, jika errornya adalah module java.base does not "opens java.lang" to
unnamed module @..., sertakan opsi pipeline berikut saat Anda menjalankan pipeline:
--jdkAddOpenModules=java.base/java.lang=ALL-UNNAMED
Untuk mengetahui informasi selengkapnya, lihat dokumentasi class DataflowPipelineOptions.
Error saat melaporkan progres item kerja
Untuk pipeline Java, jika Anda tidak menggunakan Portable Runner, Anda mungkin melihat error berikut:
Error reporting workitem progress update to Dataflow service: ...
Error ini disebabkan oleh pengecualian yang tidak tertangani selama update progres item pekerjaan, seperti selama pemisahan sumber. Umumnya, jika kode pengguna Apache Beam menampilkan pengecualian yang tidak tertangani, item tugas akan gagal, sehingga menyebabkan pipeline gagal.Namun, pengecualian di Source.split akan disembunyikan, karena bagian kode tersebut berada di luar item tugas. Akibatnya, hanya log error yang dicatat.
Error ini biasanya tidak berbahaya jika hanya terjadi sesekali. Namun,
pertimbangkan untuk menangani pengecualian dengan baik di dalam kode Source.split Anda.
Error konektor BigQuery
Bagian berikut berisi error konektor BigQuery umum yang mungkin Anda alami dan langkah-langkah untuk menyelesaikan atau memecahkan masalah error tersebut.
quotaExceeded
Saat menggunakan konektor BigQuery untuk menulis ke BigQuery menggunakan streaming insert, throughput tulis lebih rendah dari yang diharapkan, dan error berikut mungkin terjadi:
quotaExceeded
Throughput yang lambat mungkin disebabkan oleh pipeline Anda yang melebihi kuota streaming insert BigQuery yang tersedia. Jika demikian, pesan error terkait kuota dari BigQuery akan muncul di log worker Dataflow (cari error quotaExceeded).
Jika Anda melihat error quotaExceeded, untuk menyelesaikan masalah ini:
- Saat menggunakan Apache Beam SDK untuk Java, tetapkan opsi sink BigQuery
ignoreInsertIds(). - Saat menggunakan Apache Beam SDK untuk Python, gunakan opsi
ignore_insert_ids.
Setelan ini membuat Anda memenuhi syarat untuk mendapatkan throughput streaming insert BigQuery sebesar satu GB per detik, per project. Untuk mengetahui informasi selengkapnya tentang peringatan terkait penghapusan duplikat pesan otomatis, lihat dokumentasi BigQuery. Untuk meningkatkan kuota streaming insert BigQuery lebih tinggi dari satu GBps, kirimkan permintaan melalui konsolGoogle Cloud .
Jika Anda tidak melihat error terkait kuota di log worker, masalahnya mungkin karena parameter terkait penggabungan atau pengelompokan default tidak memberikan paralelisme yang memadai untuk penskalaan pipeline Anda. Anda dapat menyesuaikan beberapa konfigurasi terkait konektor BigQuery Dataflow untuk mencapai performa yang diharapkan saat menulis ke BigQuery menggunakan streaming insert. Misalnya, untuk Apache Beam SDK for Java, sesuaikan
numStreamingKeys agar sesuai dengan jumlah maksimum worker dan pertimbangkan
untuk meningkatkan insertBundleParallelism guna mengonfigurasi konektor BigQuery agar
menulis ke BigQuery menggunakan lebih banyak thread paralel.
Untuk konfigurasi yang tersedia di Apache Beam SDK untuk Java, lihat BigQueryPipelineOptions, dan untuk konfigurasi yang tersedia di Apache Beam SDK untuk Python, lihat transformasi WriteToBigQuery.
rateLimitExceeded
Saat menggunakan konektor BigQuery, error berikut akan terjadi:
rateLimitExceeded
Error ini terjadi jika terlalu banyak permintaan API BigQuery yang dikirim dalam durasi singkat. BigQuery memiliki batas kuota jangka pendek. Pipeline Dataflow Anda mungkin melebihi kuota tersebut untuk sementara. Dalam skenario ini, permintaan API dari pipeline Dataflow Anda ke BigQuery mungkin gagal, yang dapat menyebabkan error rateLimitExceeded di log worker.
Dataflow akan mencoba ulang kegagalan tersebut, sehingga Anda dapat mengabaikan error ini dengan aman. Jika Anda yakin bahwa pipeline Anda terpengaruh oleh error rateLimitExceeded, hubungi Cloud Customer Care.
Error lain-lain
Bagian berikut berisi berbagai error yang mungkin Anda alami dan langkah-langkah untuk menyelesaikan atau memecahkan masalah error tersebut.
Tidak dapat mengalokasikan sha384
Tugas Anda berjalan dengan benar, tetapi Anda melihat error berikut di log tugas:
ima: Can not allocate sha384 (reason: -2)
Jika tugas Anda berjalan dengan benar, error ini tidak berbahaya, dan Anda dapat mengabaikannya. Image dasar worker VM terkadang menghasilkan pesan ini. Dataflow secara otomatis merespons dan mengatasi masalah yang mendasarinya.
Ada permintaan fitur untuk mengubah tingkat pesan ini dari WARN menjadi
INFO. Untuk mengetahui informasi selengkapnya, lihat Menurunkan level log error peluncuran sistem Dataflow ke WARN atau INFO.
Terjadi error saat melakukan inisialisasi pemeriksaan plugin dinamis
Tugas Anda berjalan dengan benar, tetapi Anda melihat error berikut di log tugas:
Error initializing dynamic plugin prober" err="error (re-)creating driver directory: mkdir /usr/libexec/kubernetes: read-only file system
Jika tugas Anda berjalan dengan benar, error ini tidak berbahaya, dan Anda dapat mengabaikannya. Error ini terjadi saat tugas Dataflow mencoba membuat direktori tanpa izin tulis yang diperlukan, dan tugas tersebut gagal. Jika tugas Anda berhasil, berarti direktori tersebut tidak diperlukan, atau Dataflow telah mengatasi masalah yang mendasarinya.
Ada permintaan fitur untuk mengubah tingkat pesan ini dari WARN menjadi
INFO. Untuk mengetahui informasi selengkapnya, lihat Menurunkan level log error peluncuran sistem Dataflow ke WARN atau INFO.
Objek tersebut tidak ada: pipeline.pb
Saat mencantumkan tugas menggunakan opsi JOB_VIEW_ALL, error berikut akan terjadi:
No such object: BUCKET_NAME/PATH/pipeline.pb
Error ini dapat terjadi jika Anda menghapus file pipeline.pb dari file staging untuk tugas.
Melewati sinkronisasi pod
Tugas Anda berjalan dengan benar, tetapi Anda melihat salah satu error berikut di log tugas:
Skipping pod synchronization" err="container runtime status check may not have completed yet"
Atau:
Skipping pod synchronization" err="[container runtime status check may not have completed yet, PLEG is not healthy: pleg has yet to be successful]"
Jika tugas Anda berjalan dengan benar, error ini tidak berbahaya, dan Anda dapat mengabaikannya.
Pesan container runtime status check may not have completed yet muncul
saat kubelet Kubernetes melewati sinkronisasi pod karena
menunggu runtime container diinisialisasi. Skenario ini terjadi karena
berbagai alasan, seperti saat runtime container baru saja dimulai atau
sedang dimulai ulang.
Jika pesan menyertakan PLEG is not healthy: pleg has yet to be
successful, kubelet akan menunggu generator peristiwa siklus proses pod (PLEG)
menjadi responsif sebelum menyinkronkan pod. PLEG bertanggung jawab untuk
menghasilkan peristiwa yang digunakan oleh kubelet untuk melacak status pod.
Ada permintaan fitur untuk mengubah tingkat pesan ini dari WARN menjadi
INFO. Untuk mengetahui informasi selengkapnya, lihat Menurunkan level log error peluncuran sistem Dataflow ke WARN atau INFO.
Rekomendasi
Untuk panduan tentang rekomendasi yang dihasilkan oleh Insight Dataflow, lihat Insight.